Control de calidad automático para datos fiables
|
7
minuto de lectura

Su dashboard matutino está en verde, pero la tendencia de ingresos parece incorrecta. Un feed programado llegó tarde, una columna cambió de tipo o un sistema de origen alteró la distribución de un campo. El pipeline se completó correctamente, así que la comprobación de estado habitual pasó. Cuando alguien nota el impacto de negocio, los analistas ya han compartido cifras poco fiables y los ingenieros están rastreando el problema hacia atrás.
La revisión manual no puede seguir el ritmo del volumen y la variedad de los pipelines modernos. El control de calidad automático cambia el modelo operativo: vigila los datos de forma continua, identifica desviaciones relevantes, aplica las reglas esenciales y entrega a las personas adecuadas evidencias sobre las que actuar. Las consecuencias de dejar estos fallos sin detectar se describen en este resumen sobre las consecuencias de la mala calidad de datos.
Tabla de contenidos
Introducción: por qué la calidad de datos se rompe sin automatización
De la inspección a la operación continua
La decisión de diseño central
Qué significa realmente el control de calidad automático
El fundamento estadístico
Qué vigila el sistema
Cómo funcionan las comprobaciones automatizadas, de las reglas a la IA
Validación basada en reglas
Umbrales estadísticos
Detección con IA y aprendizaje automático
Elegir el tipo de comprobación adecuado para cada señal
Llevar la automatización a la operación continua
Mantener el cómputo cerca de los datos
Conectar tiempo, estructura y significado
Beneficios que puede medir y notar en el día a día
Qué cambia para el equipo
Dónde aporta valor el control de calidad automático en la práctica
Finanzas
Sanidad
Telecomunicaciones
Sector público
Cuándo automatizar y cómo empezar con digna
Lista de adopción
Introducción: por qué la calidad de datos se rompe sin automatización
Un equipo de datos puede revisar algunas tablas críticas tras una entrega, confirmar que una transformación se ejecutó y pasar a la siguiente tarea. Ese proceso detecta fallos evidentes, como una tabla vacía o un job roto. No detecta de forma fiable un desplazamiento gradual en la actividad de clientes, una fuente que llega tarde o un valor de apariencia válida que ya no tiene sentido de negocio.
El problema no es que falten pruebas. Los entornos modernos combinan warehouses, lakes, sistemas de streaming, feeds de proveedores, herramientas de transformación y dashboards. Cada capa puede parecer sana mientras el resultado pierde fiabilidad. Una ejecución correcta del pipeline demuestra que el código se ejecutó, no que los datos sigan representando el negocio.
De la inspección a la operación continua
La industria manufacturera ofrece una analogía útil. Una inspección final puede retirar productos defectuosos, pero los sensores repartidos por la línea identifican la deriva del proceso antes de que se acumulen defectos. Los equipos de datos necesitan el mismo bucle de realimentación. En lugar de tratar la calidad como una puerta al final del pipeline, pueden monitorizar registros, comportamiento de entrega, estructura, métricas de negocio y actividad de la plataforma como parte de la operación diaria.
Ese cambio también clarifica la propiedad. Un ingeniero de datos puede tener que investigar un cambio de esquema, un analista explicar un movimiento inusual de un KPI y un responsable de gobernanza demostrar que un control se ejecutó. El control de calidad automático debería conectar esas tareas en lugar de crear otro informe aislado.
La decisión de diseño central
Automatizar no significa sustituir cada regla por un modelo. Algunas señales deben aprenderse del comportamiento histórico, como el volumen normal o el tiempo de entrega esperado. Otras deben seguir siendo deterministas, como un campo obligatorio, un estado permitido o una restricción regulatoria.
La pregunta práctica es por tanto precisa: ¿qué condiciones debe aprender el sistema estadísticamente y cuáles debe aplicar de forma exacta? La respuesta determina si la automatización reduce el ruido o genera más alertas.
Qué significa realmente el control de calidad automático
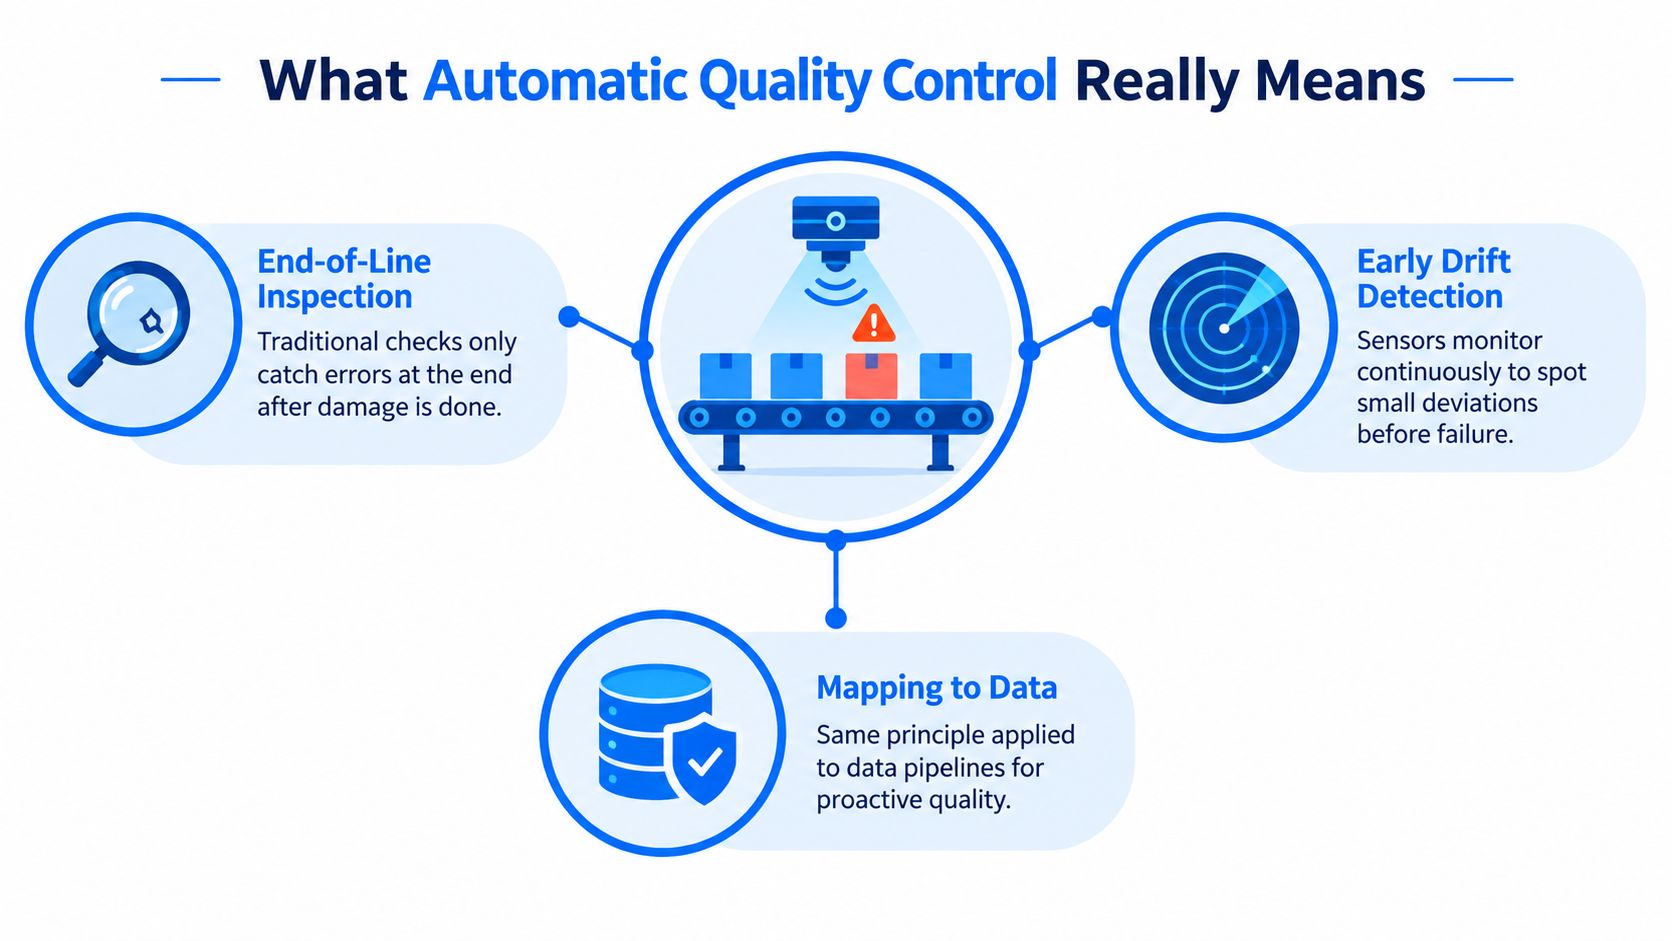
Piense en una cinta transportadora con piezas idénticas. Un sensor registra temperatura, peso y posición mientras una cámara revisa la superficie. El sistema no espera a la última caja embalada para descubrir un problema. Compara las lecturas actuales con el comportamiento esperado, señala movimientos inusuales y puede detener o desviar el proceso antes de que pasen más piezas defectuosas.
La calidad de datos funciona igual. Un sistema de monitorización observa tablas y pipelines, establece cómo es el comportamiento normal y contrasta los datos entrantes con esa línea base. También puede aplicar validaciones explícitas cuando la organización tiene una regla que debe cumplirse siempre.
El control de calidad automático es el uso continuo de software para observar el comportamiento de los datos, aplicar requisitos de calidad definidos, detectar desviaciones significativas y enviar la evidencia a las personas o sistemas responsables de actuar.
El fundamento estadístico
El control estadístico de procesos (SPC) ofrece una base útil. Usa gráficos de control y datos de medición para distinguir la variación normal de la variación por causa especial, es decir, un cambio que sugiere que algo inusual ha entrado en el proceso. En un proceso con distribución normal, un límite de control de 3 sigma sitúa la probabilidad de que una pieza buena caiga fuera de la banda en torno a 1 entre 1.000, mientras que un límite de 6 sigma la reduce a cerca de 1 entre 1.000.000 (investigación sobre SPC y detección automatizada).
La lección no es que cada tabla necesite una regla de seis sigma. La lección es que los sistemas de calidad deben detectar la deriva pronto en vez de depender solo de la inspección final. Una línea base da contexto al sistema. Sin contexto, un umbral puede señalar la estacionalidad habitual o pasar por alto un cambio relevante.
Qué vigila el sistema
El control de calidad automático cubre varias capas de comportamiento:
Calidad del registro: valores obligatorios, formatos válidos, rangos, valores de referencia, duplicados y relaciones de negocio.
Puntualidad del pipeline: si los datos llegan cuando los usuarios y los procesos posteriores lo esperan.
Estabilidad del esquema: si se añaden, eliminan, renombran o cambian de tipo las columnas.
Comportamiento de negocio: si los ingresos, las transacciones, la actividad de clientes u otro KPI se salen de los patrones esperados.
Comportamiento de la plataforma: si las cargas, la disponibilidad, el consumo o las métricas de rendimiento cambian de forma inesperada.
Una sola prueba no puede cubrir todo esto. El sistema operativo combina mediciones, reglas, historial, propiedad, alertas y contexto de remediación. Esa combinación es lo que convierte las pruebas en control continuo.
Cómo funcionan las comprobaciones automatizadas, de las reglas a la IA
Tres familias de comprobaciones cubren la mayoría de diseños de control de calidad automático. No compiten en todas las situaciones: cada una responde a una pregunta distinta, y las mejores implementaciones asignan cada señal al método que se ajusta a su riesgo.
Validación basada en reglas
Las comprobaciones deterministas son explícitas y repetibles. Una regla puede exigir un identificador de cliente, rechazar una cantidad negativa, restringir un estado a una lista de referencia aprobada o verificar que un timestamp sigue un formato requerido. Si la condición falla, el resultado es claro: el registro o el conjunto de datos incumple un requisito declarado.
Las reglas son especialmente valiosas para la lógica de negocio, los controles de auditoría y los compromisos contractuales. Además constituyen buena evidencia, porque un responsable puede explicar exactamente qué pasó, qué falló y por qué. Su límite es el mantenimiento: una regla no puede inferir una línea base cambiante si nadie la actualiza, y una regla demasiado amplia genera trabajo operativo innecesario.
Umbrales estadísticos
Las comprobaciones estadísticas preguntan si una medición se ha alejado de forma inusual de su comportamiento establecido. La medición puede ser el volumen de filas, la densidad de nulos, la distribución de valores o el tiempo de entrega. Las bandas de control se adaptan a patrones que un umbral fijo trataría incorrectamente.
El sistema sigue necesitando una configuración meditada. Una métrica de negocio puede variar según el día de la semana, el ciclo de entregas o el periodo de reporting. Una línea base que ignore esos patrones alertará en exceso; una demasiado permisiva pasará por alto un problema real.
Detección con IA y aprendizaje automático
La detección con IA es útil cuando los datos tienen relaciones complejas o cuando escribir reglas a mano resultaría poco práctico. Un modelo puede aprender los patrones de un conjunto de datos y señalar desviaciones en volumen, distribución o valores. Eso no hace que el resultado sea automáticamente correcto: el modelo necesita suficiente historial, monitorización adecuada y un proceso de revisión de falsos positivos.
Un ejercicio de benchmarking con perfiles oceánicos muestra por qué importa la selección de pruebas. Los investigadores evaluaron 60 comprobaciones automatizadas distintas y concluyeron que elegir un subconjunto óptimo era necesario porque las distintas reglas de calidad intercambian sensibilidad por exceso de alertas (benchmarking de comprobaciones automáticas de calidad). Más pruebas no generan automáticamente más calidad: pueden generar fatiga de alertas si el equipo no distingue una señal relevante de la variación habitual.
Elegir el tipo de comprobación adecuado para cada señal
Familia de comprobación | Mejor para | Puntos fuertes | Precauciones |
|---|---|---|---|
Validación basada en reglas | Campos obligatorios, formatos, rangos, listas de referencia y restricciones de negocio | Resultado claro de aprobado o fallido, lógica explicable, evidencia sólida de auditoría | Requiere mantenimiento cuando cambian los requisitos de negocio |
Umbrales estadísticos | Volumen, distribuciones, comportamiento de nulos y patrones de entrega | Se adapta al comportamiento observado y resalta la deriva | Puede alertar en exceso si la estacionalidad o la línea base se entienden mal |
Detección con IA | Patrones sutiles, multivariantes o cambiantes entre conjuntos de datos | Encuentra comportamientos difíciles de expresar como reglas individuales | Necesita gobernanza, revisión y controles frente a decisiones opacas |
La estrategia correcta no es escribir menos reglas, sino decidir qué señales merecen aplicación exacta, cuáles necesitan umbrales adaptativos y cuáles se benefician de la detección aprendida. Para una explicación práctica de la detección de anomalías en pipelines, consulte cómo detecta la IA las anomalías de datos.
Llevar la automatización a la operación continua
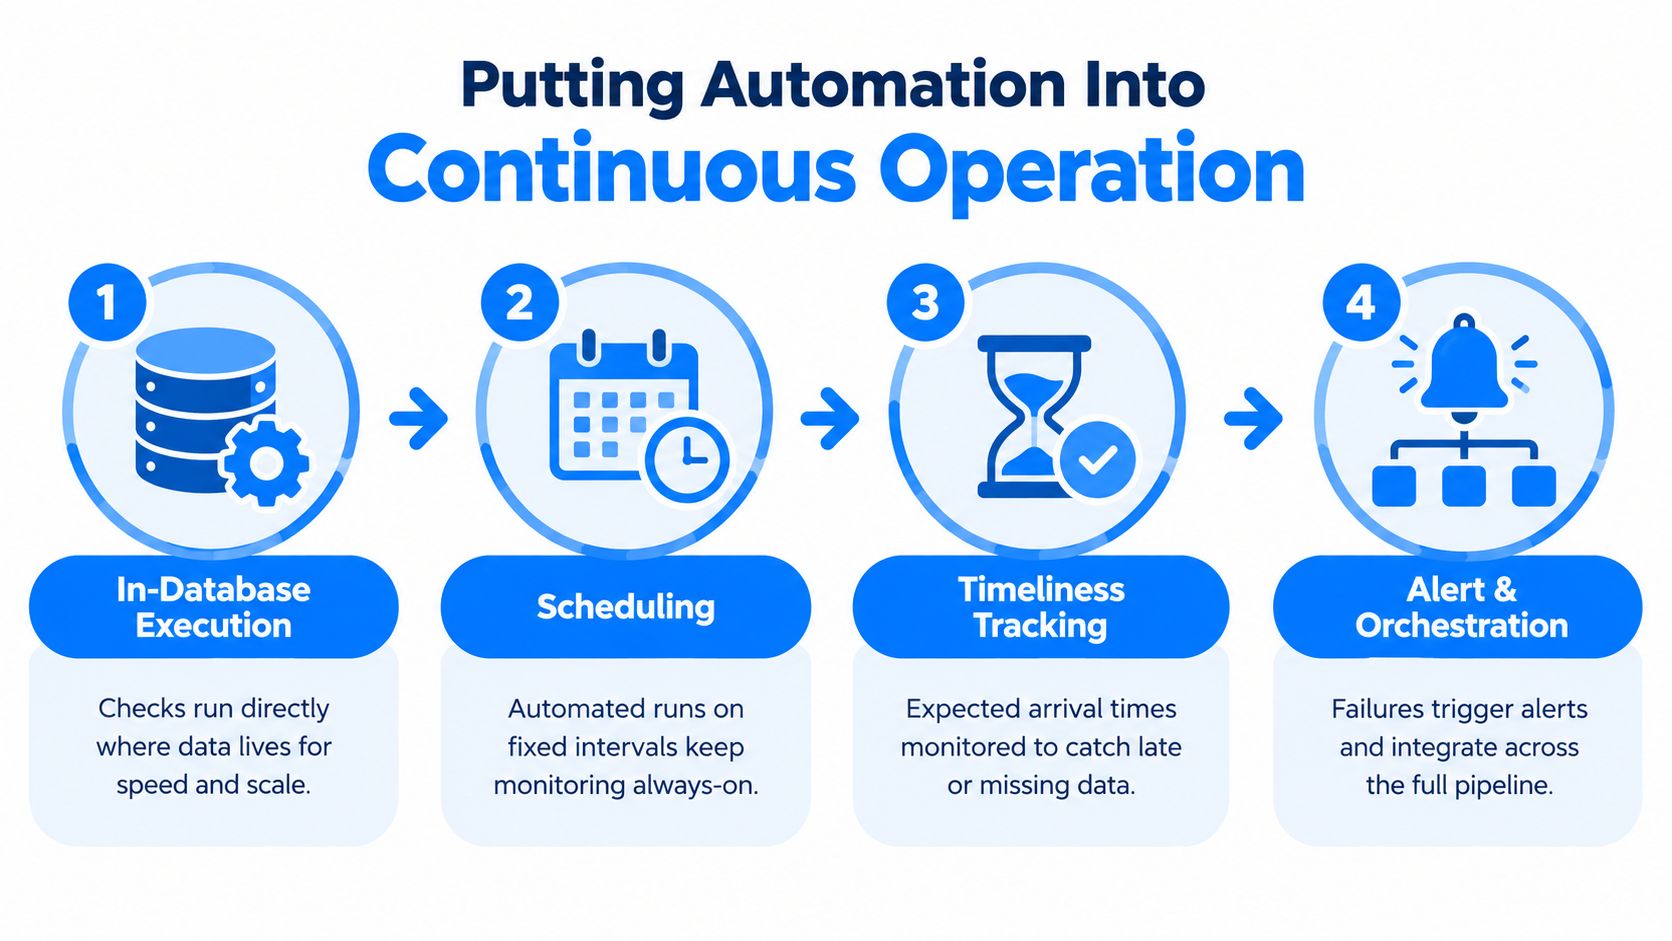
Un conjunto de comprobaciones solo resulta útil cuando funciona como bucle operativo. Ese bucle debe observar los datos donde ya residen, ejecutarse con una periodicidad fiable, comparar el comportamiento real con el esperado y dirigir los fallos a un responsable con contexto suficiente para reaccionar.
Mantener el cómputo cerca de los datos
La ejecución in-database permite calcular métricas y analizar dentro de la base de datos del cliente. Los datos permanecen en su sitio, lo que reduce movimientos innecesarios y apoya los requisitos de privacidad y gobernanza. Este enfoque es especialmente relevante cuando los datos de producción no pueden copiarse a un servicio externo de monitorización.
El diseño sigue necesitando controles de acceso, registro de actividad y una separación clara entre los metadatos de monitorización y los registros sensibles. La ejecución local no sustituye a la gobernanza: le da una base más sólida, porque la organización puede definir dónde se calcula y qué evidencia sale del entorno.
Conectar tiempo, estructura y significado
Un bucle de monitorización fiable combina distintas formas de evidencia:
Programe la observación. Intervalos fijos o eventos del pipeline aseguran que las comprobaciones se ejecuten sin que nadie tenga que recordarlo.
Controle la entrega esperada. La monitorización de puntualidad aprende el comportamiento de llegada y señala datos tardíos, ausentes o adelantados.
Detecte el cambio estructural. El seguimiento de esquema identifica columnas añadidas o eliminadas y cambios de tipo antes de que fallen los consumidores posteriores.
Vigile las métricas de negocio. La monitorización de KPIs conecta el comportamiento técnico de los datos con resultados que los responsables de negocio reconocen.
Enrute el incidente. Las alertas deben incluir el activo afectado, la condición fallida, el cambio observado y la persona o equipo responsable.
Los datos de encuesta apuntan a una brecha de estrategia. SYNQ encontró que el «conocimiento insuficiente sobre cómo probar bien» era el principal reto de calidad de datos, mientras que la gran mayoría de los equipos dependía sobre todo de las pruebas integradas de su herramienta de transformación y solo alrededor del 10 % usaba IA con frecuencia en sus flujos de calidad (encuesta de referencia de calidad de datos de SYNQ). Eso sugiere que los equipos necesitan guía operativa, no otra biblioteca de pruebas.
Un dashboard compartido, un catálogo de datos, un planificador y un flujo de colaboración pueden convertir una alerta en un incidente gestionado. Los ingenieros revisan la evidencia técnica, los analistas ven el impacto de negocio y los interesados siguen el estado sin sacar datos de producción del entorno del cliente. Hay más orientación práctica sobre validación y controles continuos en reglas de validación y calidad de datos continua.
Beneficios que puede medir y notar en el día a día
El beneficio más útil del control de calidad automático no es el número de comprobaciones configuradas, sino la reducción de la incertidumbre en el trabajo ordinario. Los equipos detectan la deriva antes de que la muestre una actualización del dashboard, ven si un feed tardío causó un hueco en un informe y distinguen un pipeline roto de un cambio real del negocio.
Los sistemas industriales de visión muestran el valor de inspeccionar de forma continua en lugar de muestrear solo al final. Las revisiones de control de calidad basado en visión integrado con PLC describen sistemas que capturan la imagen de cada producto, clasifican defectos en tiempo real y permiten una inspección del 100 % a velocidad de línea. Una integración reportada alcanzó cerca del 96,2 % de exactitud, con 95,4 % de precisión, 96,8 % de exhaustividad y un F1 de 96,1 % (revisión de control de calidad industrial basado en visión).
Qué cambia para el equipo
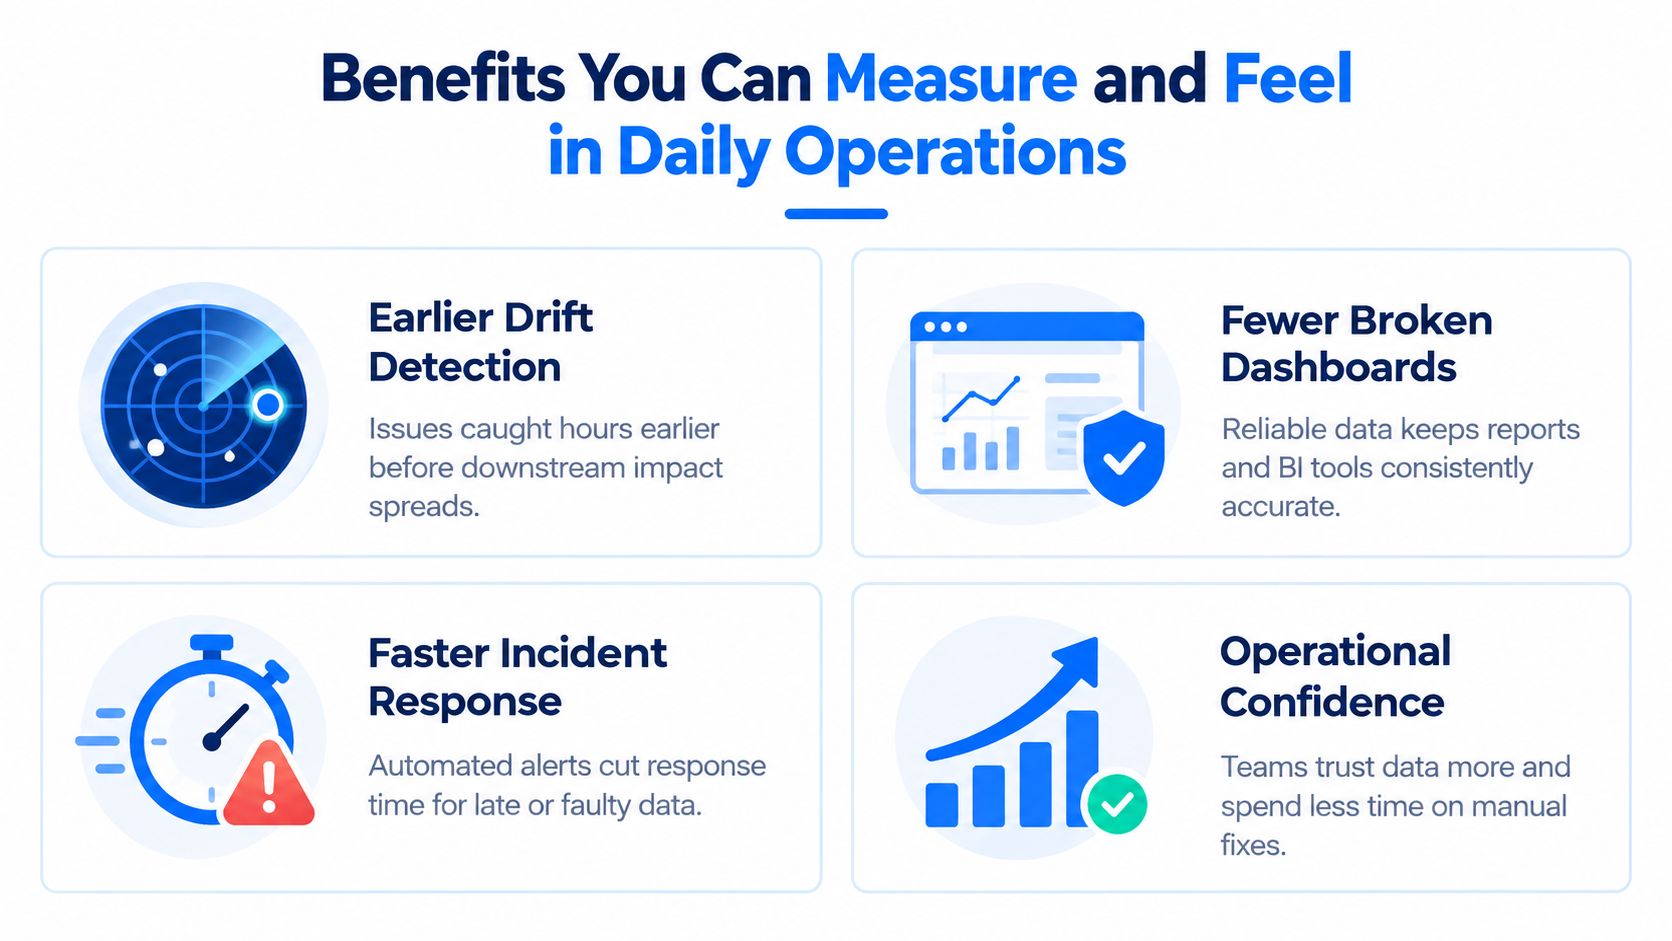
La detección temprana de la deriva da a los ingenieros tiempo para investigar una fuente o una transformación antes de que los consumidores posteriores multipliquen el impacto. Una pequeña desviación se convierte en un evento visible en lugar de una suposición oculta.
Menos dashboards rotos es consecuencia de monitorizar tanto los datos como la estructura. Un dashboard puede seguir técnicamente disponible mientras muestra información obsoleta o distorsionada; las señales de calidad ayudan a distinguirlo.
Respuesta más rápida a cargas ausentes proviene del seguimiento de la entrega esperada. En lugar de esperar a que un analista note un informe vacío, el sistema identifica que un conjunto de datos no ha llegado dentro de su patrón normal.
Evidencia de cumplimiento más sólida procede de controles deterministas, historial de ejecución, propiedad y resultados documentados. Los auditores y los responsables de negocio necesitan algo más que un estado en verde: necesitan saber qué se ejecutó y qué ocurrió.
Para quienes exploran el papel de los datos predictivos en QA, el principio general es parecido: el comportamiento histórico ayuda a anticipar riesgos de calidad, pero las señales predictivas necesitan vías de acción claras. La automatización favorece el control de costes, la fiabilidad de los modelos y la confianza en la analítica solo cuando las alertas se entienden y alguien asume la respuesta.
El resultado práctico es confianza. Los equipos dedican menos tiempo a comprobar si los datos existen y más a decidir qué significan. Ese beneficio desaparece si cada alerta es ruidosa, duplicada o no está conectada con un equipo responsable, así que el ajuste y la propiedad siguen formando parte del sistema de calidad. Hay más contexto sobre estos resultados operativos en los beneficios de la calidad de datos.
Dónde aporta valor el control de calidad automático en la práctica
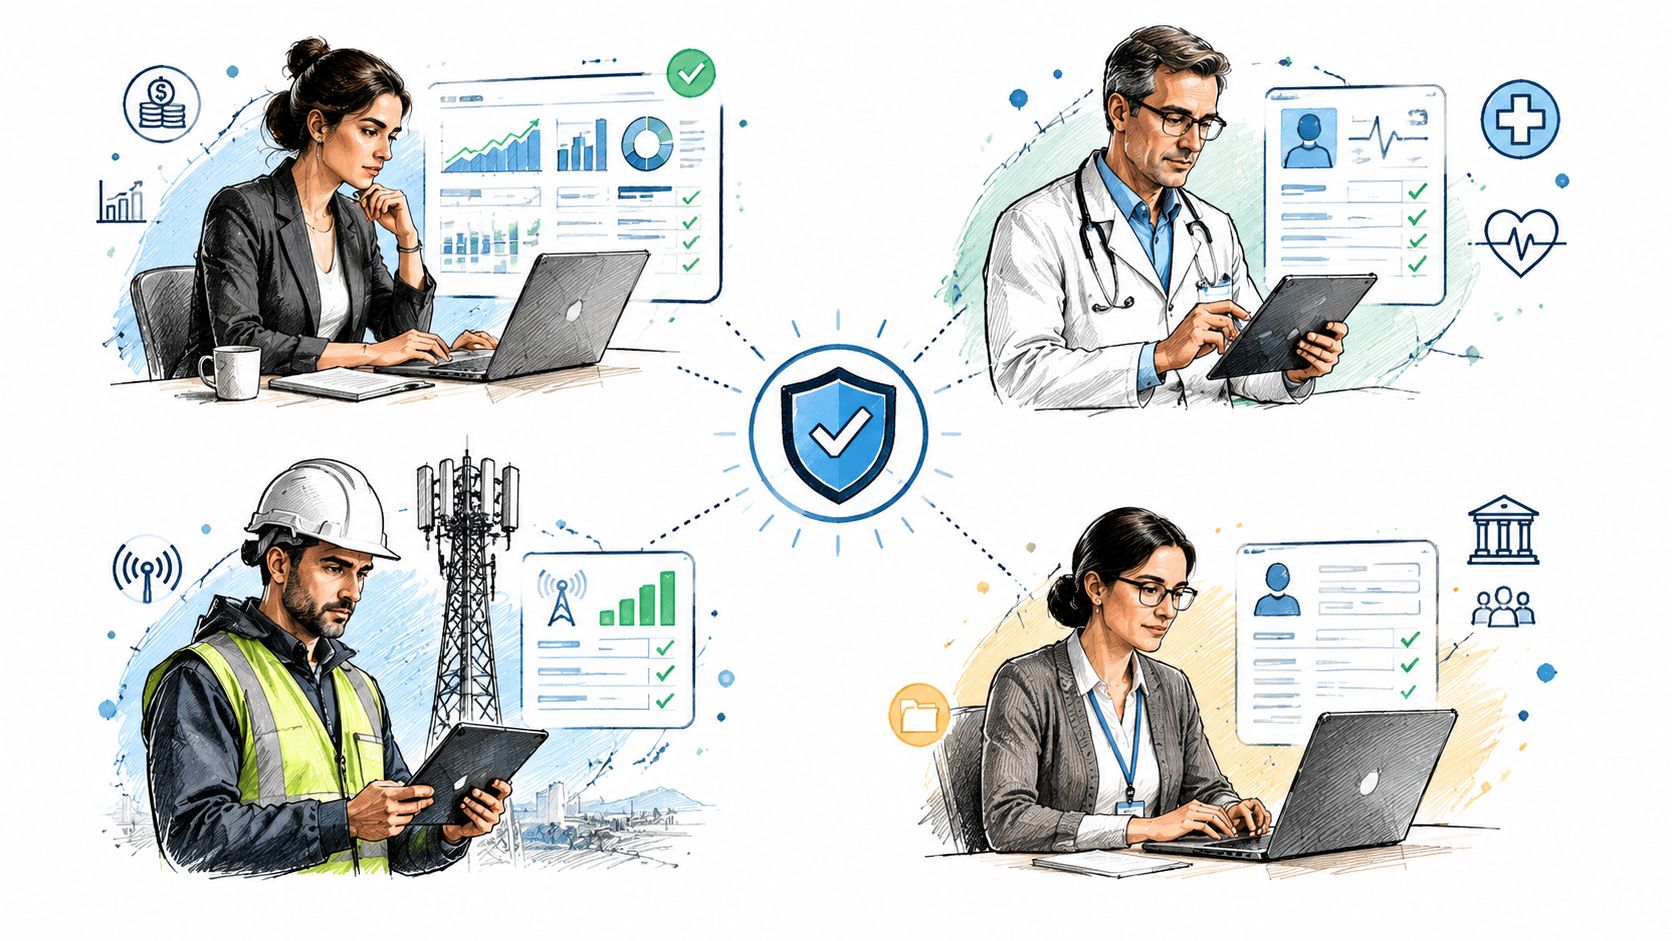
La misma arquitectura de control se comporta de forma distinta según el sector porque los riesgos difieren. Un equipo financiero puede preocuparse por el reporting regulatorio y la integridad de las transacciones. Una organización sanitaria priorizará la fiabilidad de los datos clínicos y la privacidad. Un operador de telecomunicaciones vigilará eventos de clientes de gran volumen, mientras que un organismo público necesitará registros consistentes y trazables para auditorías.
Finanzas
Un feed de riesgo llega cada mañana y alimenta informes usados por finanzas y cumplimiento. Un job completado no garantiza que el feed contenga los registros esperados ni que un cambio en el origen no haya alterado un campo crítico. La monitorización de puntualidad detecta una llegada tardía, la validación determinista aplica las reglas de transacción y el seguimiento de esquema revela un cambio estructural antes de que el reporting se rompa.
Conclusión práctica: empiece por los conjuntos de datos que sostienen decisiones regulatorias, de riesgo o financieras, y asigne responsables explícitos a cada control.
Sanidad
Un equipo de operaciones clínicas combina información de varios sistemas. Un campo ausente puede afectar a la interpretación, mientras que un cambio estructural puede perturbar una aplicación posterior sin producir un error evidente en el pipeline. La validación continua y la monitorización de esquema permiten identificar esas situaciones manteniendo el cómputo dentro del entorno controlado de la organización.
Conclusión práctica: separe el tratamiento de datos sensibles de la evidencia de monitorización y defina qué controles requieren prueba determinista.
Telecomunicaciones
Una plataforma de telecomunicaciones procesa eventos de clientes y operativos a gran volumen. Los responsables de negocio necesitan saber si un movimiento inesperado refleja comportamiento real de clientes o un problema del pipeline. Monitorizar las métricas de negocio junto con la disponibilidad de datos y la carga de la plataforma ayuda a investigar la capa correcta.
Conclusión práctica: combine la monitorización de KPIs con la observabilidad de plataforma para contrastar movimientos inusuales con evidencia operativa.
Sector público
Los datos públicos suelen circular entre departamentos y sistemas con modelos de propiedad distintos. Un programa de control debe garantizar consistencia, trazabilidad y evidencia lista para auditoría en lugar de depender de comprobaciones informales en equipos aislados.
Conclusión práctica: documente la regla, la ejecución, el resultado y el responsable de cada conjunto de datos crítico.
En entornos regulados, la arquitectura de despliegue importa tanto como la detección. digna puede ejecutarse dentro de la nube privada, la VPC o el centro de datos del cliente, con cómputo in-database, de modo que las organizaciones limitan el movimiento de datos manteniendo una visión compartida de incidentes, tendencias y estado.
Cuándo automatizar y cómo empezar con digna
Empiece por el riesgo, no por el catálogo de funcionalidades más amplio. Un conjunto de datos crítico con expectativas de entrega frecuentes y varios consumidores merece atención antes que una tabla de bajo impacto que apenas se usa.
Use cuatro preguntas para fijar el primer alcance:
Impacto en decisiones: ¿qué decisión de negocio, clínica, financiera o de servicio público depende de estos datos?
Visibilidad del fallo: ¿los usuarios notarían un fallo de inmediato o podría permanecer oculto?
Complejidad operativa: ¿los datos atraviesan varios pipelines, responsables o plataformas?
Presión de gobernanza: ¿la privacidad, el cumplimiento o la auditoría exigen evidencia?
Un primer proyecto sensato aborda un problema de alto impacto, como la detección de anomalías o la puntualidad. Amplíe cuando el equipo entienda la calidad de las alertas, la propiedad y la remediación. Mantenga el despliegue modular, añadiendo validación determinista, seguimiento de esquema, monitorización de negocio u observabilidad de plataforma donde el riesgo lo justifique.
Lista de adopción
Ejecute en local: mantenga el cómputo dentro de la nube, la VPC o el centro de datos de la organización cuando mover datos genere riesgo.
Use la base de datos: prefiera el cálculo de métricas in-database cuando la seguridad y la escala lo exijan.
Separe señales aprendidas y fijas: deje que las líneas base identifiquen comportamiento inusual mientras las reglas deterministas hacen cumplir las obligaciones.
Registre la evidencia: guarde el control, el contexto de ejecución, el resultado, el responsable y el historial de resolución.
Conecte el flujo de trabajo: integre las alertas con el planificador, el catálogo, los dashboards y el proceso de colaboración.
Revise las falsas alarmas: trate el ajuste de alertas como una responsabilidad de ingeniería continua.
Un enfoque de implementación de calidad de datos bien acotado ayuda a convertir estas decisiones en un modelo operativo. El objetivo no es automatizar pruebas por sí mismas, sino hacer de la calidad un proceso continuo y transparente en el que ingenieros y responsables de negocio puedan confiar.
digna ofrece monitorización modular de anomalías, validación, puntualidad, cambios de esquema, métricas de negocio y comportamiento de la plataforma dentro del entorno del cliente. Visite digna para evaluar un punto de partida acotado y ver cómo encaja el control de calidad automático continuo en su ecosistema de datos.
Vea cómo lo hace digna en la práctica: monitorización automatizada de la calidad de datos allí donde residen sus datos.
Preguntas frecuentes
¿Qué es el control de calidad automático para datos?
El control de calidad automático es la comprobación continua de conjuntos de datos sin que una persona la desencadene. Combina validación basada en reglas para requisitos que puede enunciar con exactitud, umbrales estadísticos para tolerancias medibles y aprendizaje automático que señala desviaciones respecto al comportamiento aprendido de cada conjunto de datos.
¿En qué se diferencia del control manual?
La inspección manual muestrea de forma periódica y depende de quién esté disponible para mirar. La automatización observa cada carga frente a una línea base, así que la cobertura no varía según el turno y el tiempo de detección baja de días a minutos, que es lo que determina cuánto daño causa un problema aguas abajo.
¿Cuándo usar reglas y cuándo detección con IA?
Use reglas cuando el requisito pueda escribirse: una columna no debe ser NULL, un valor debe cumplir un formato, una tabla debe llegar antes de una hora límite. Use detección estadística y de IA para todo lo que no pueda enumerar de antemano, como una caída de volumen, un cambio de distribución o una carga que se retrasa un poco más cada noche.
¿El control de calidad automático obliga a copiar datos a otra plataforma?
No debería. Mantener el cómputo cerca de los datos significa que solo salen métricas y metadatos del entorno, algo decisivo allí donde la residencia de datos, la privacidad o la regulación sectorial limitan dónde pueden procesarse los datos de producción.
¿Cómo se empieza a automatizar el control de calidad de datos?
Empiece por los conjuntos de datos cuyo fallo tiene consecuencias reales, deje que el sistema aprenda su comportamiento normal y automatice las comprobaciones que su equipo ya hace a mano. Amplíe la cobertura cuando las alertas sean fiables: la adopción falla más por el ruido de alertas que por la falta de funcionalidades.