Tipos de datos de Snowflake: referencia para el diseño de esquemas
|
8
minuto de lectura
El consejo más difundido sobre un tipo de datos de Snowflake también es incompleto: elija el tipo que describa el valor con mayor precisión. La corrección semántica importa, pero los esquemas de producción no funcionan en el vacío. Un tipo cambia cómo se comportan los predicados, con qué eficacia Snowflake puede podar micro-particiones, cómo comparan valores los joins, cuánto cómputo consumen los dashboards y cómo interpretan la deriva las herramientas de observabilidad.
Una columna VARIANT puede preservar con elegancia un payload en evolución y, aun así, forzar extracciones y conversiones repetidas en rutas críticas de reporting. Un timestamp puede representar el significado de negocio correcto y aun así crear un comportamiento confuso según la zona horaria de sesión. Una definición numérica o de cadena demasiado amplia acepta los datos de hoy y hace menos útil la monitorización de mañana. Un buen diseño de esquema equilibra corrección, rendimiento, coste y visibilidad operativa.
Tabla de contenidos
Por qué la elección del tipo de datos en Snowflake va más allá del modelado
La precisión puede generar fricción operativa
La observabilidad empieza con tipos estables
Tipos de datos numéricos y de cadena explicados
Coma fija frente a coma flotante
Los tipos de cadena son flexibles, no un permiso para ser descuidado
Tipos de fecha, hora y timestamp para datos temporales
Ajustar el tipo al contrato del evento
El comportamiento de zona horaria también afecta al filtrado
Tipos de datos semiestructurados y estructurados
Los tipos estructurados hacen visibles los contratos
Un patrón híbrido funciona bien
Reglas de casting y conversión que debe conocer
Patrones seguros y atajos peligrosos
Cómo afectan los tipos de datos al rendimiento y al coste de las consultas
La poda y el clustering dependen del tipo
Perfile la carga de trabajo real
Buenas prácticas de diseño de esquemas para cargas de producción
Diseñar según el rol de la tabla
Hacer deliberada la evolución del esquema
Errores habituales con los tipos de datos y cómo corregirlos
La aceptación silenciosa sigue siendo un fallo
Conectar los tipos de datos con la calidad de datos y la observabilidad
Construir la monitorización en torno al comportamiento de los tipos
Referencia rápida de todos los tipos de datos de Snowflake
Por qué la elección del tipo de datos en Snowflake va más allá del modelado
Un tipo de datos de Snowflake forma parte de su diseño de ejecución, no solo de su diccionario de datos. La elección determina si un filtro puede usar un predicado simple y predecible o debe inspeccionar contenido anidado, convertir valores en tiempo de ejecución o reconciliar representaciones incompatibles entre tablas. Esas operaciones afectan al trabajo de escaneo y pueden hacer que un dashboard bien escrito sea más lento de lo que sugiere su SQL.
El historial de versiones de Snowflake deja clara esta visión más amplia. El soporte de Boolean se introdujo solo para cuentas aprovisionadas después del 25 de enero de 2016, un hito útil en la historia de tipos de la plataforma, mientras que el modelo actual incluye tipos temporales como DATE, DATETIME y tipos de intervalo, junto a las familias escalar, semiestructurada y estructurada. La plataforma ha pasado del almacenamiento básico de valores a un sistema de tipos pensado para cargas analíticas modernas, así que las decisiones de tipo merecen un tratamiento arquitectónico. La referencia de tipos de datos de Snowflake documenta esa evolución.
La precisión puede generar fricción operativa
El tipo más expresivo no es automáticamente el mejor tipo de producción. En cargas de BI y observabilidad de alto volumen, una representación más simple puede facilitar el filtrado, el clustering, los joins y la validación. Eso no significa elegir un tipo menos preciso cuando se requiere exactitud. Significa separar la semántica de negocio de la complejidad de representación innecesaria.
Por ejemplo, un identificador de evento que siempre es un entero no debería convertirse en un valor de coma flotante solo porque un fichero de origen etiquete todos los campos como numéricos. A la inversa, un importe financiero no debería convertirse a un tipo aproximado por comodidad. La decisión correcta preserva el significado necesario y evita trabajo que las consultas y los controles posteriores no necesitan.
Regla práctica: trate cada revisión de tipos como una revisión de modelado y también de ejecución. Pregunte qué significa la columna, cómo se filtrará, cómo se unirá y cómo se monitorizará su calidad.
La observabilidad empieza con tipos estables
Los sistemas de monitorización necesitan distribuciones consistentes, comportamiento de nulos, rangos y metadatos estructurales. Si un valor se mueve entre representaciones de cadena, número y timestamp entre cargas, una alerta de calidad puede describir el síntoma sin revelar la causa. Un tipo nativo estable da a las reglas de validación y a las líneas base de anomalías una señal más clara.
Para equipos que diseñan un estándar de warehouse más amplio, la guía de esquemas Snowflake de digna es un buen complemento al trabajo de modelado. El principio es simple: elija tipos que sigan siendo fiables tanto para los consumidores como para los sistemas que vigilan a esos consumidores.
Tipos de datos numéricos y de cadena explicados
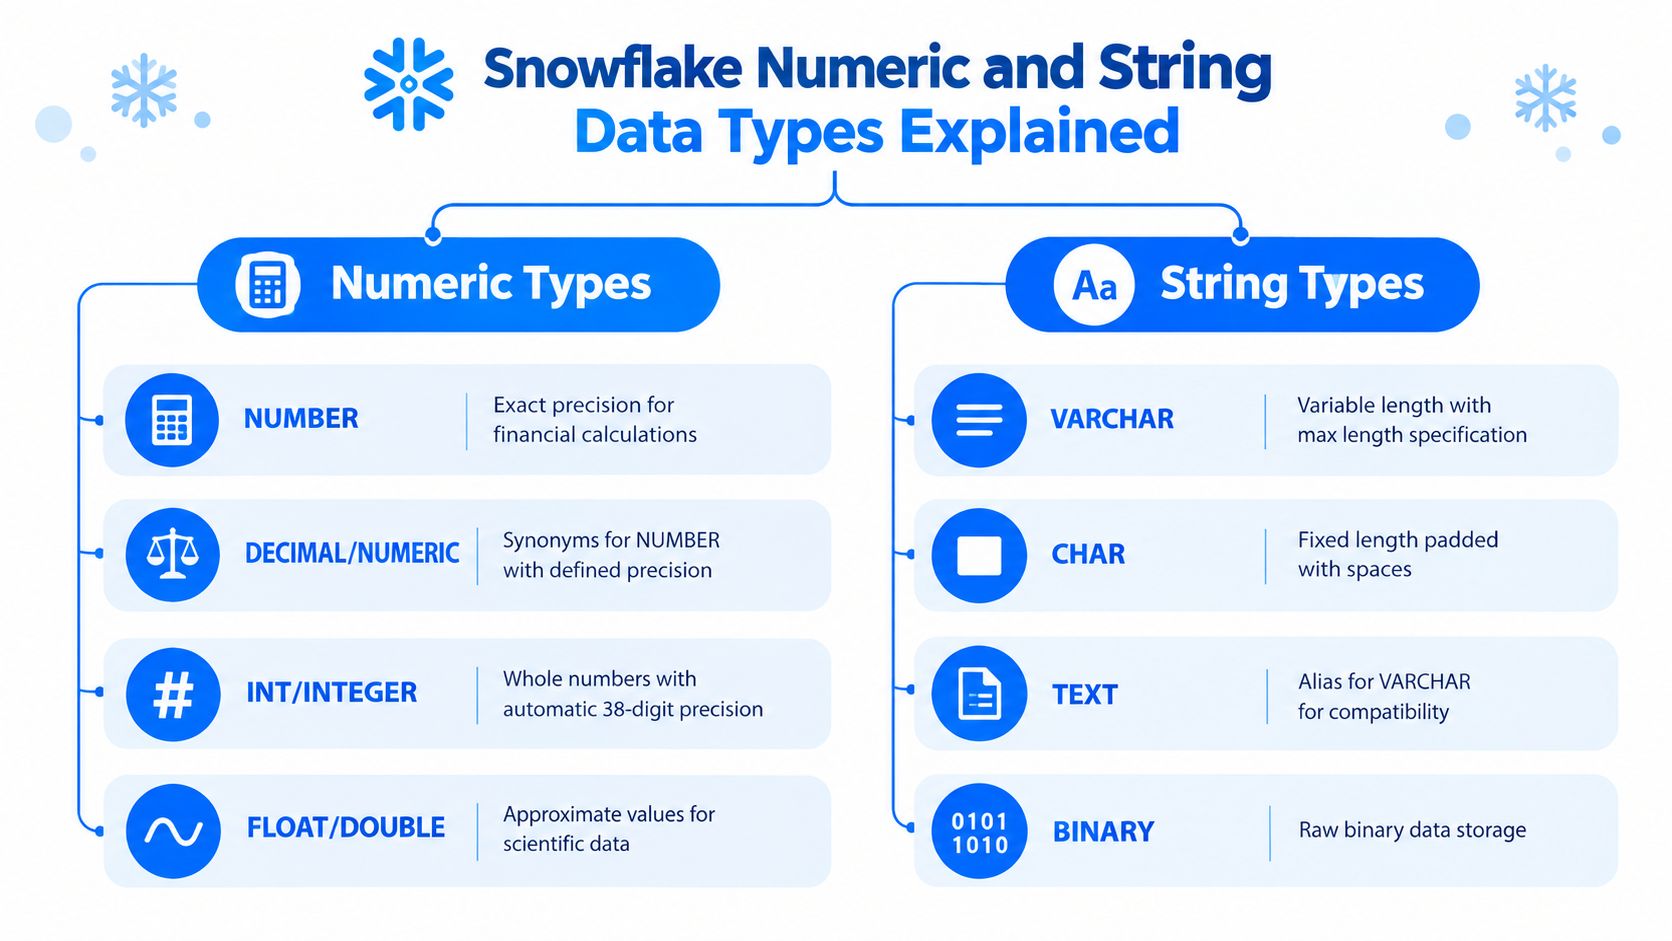
Las decisiones sobre tipos numéricos y de cadena parecen sencillas hasta que una tabla se convierte en dependencia compartida. Snowflake admite números de coma fija mediante NUMBER, DECIMAL y NUMERIC. Esos nombres representan la misma familia de coma fija, donde la precisión describe el número total de dígitos y la escala los dígitos tras la coma decimal.
Use tipos de coma fija para valores en los que la exactitud importa, como precios, saldos, tasas y magnitudes medidas que deben cuadrar. Los alias enteros, incluidos INT, INTEGER, BIGINT, SMALLINT, TINYINT y BYTEINT, son nombres cómodos para casos con números enteros. Snowflake también admite FLOAT, FLOAT4, FLOAT8, DOUBLE, DOUBLE PRECISION y REAL para valores aproximados de coma flotante. Encajan en mediciones y cálculos científicos donde la aproximación es aceptable, no en campos contables que deben cuadrar con exactitud.
Coma fija frente a coma flotante
Una revisión práctica del esquema debería responder a tres preguntas:
¿El valor necesita comparación exacta? Elija un tipo de coma fija cuando importen la igualdad, la conciliación o la auditabilidad.
¿El valor representa una aproximación científica? Un tipo de coma flotante puede ser adecuado cuando pequeñas diferencias de representación son aceptables.
¿El valor se unirá o filtrará con frecuencia? Mantenga ambos lados de la relación en formas nativas compatibles en lugar de convertir un lado dentro de cada consulta.
Los alias mejoran la compatibilidad con herramientas y convenciones SQL existentes, pero no eliminan la necesidad de documentar el rango y la precisión previstos. Una columna definida para identificadores enteros debe tener un contrato claro, aunque el alias de Snowflake elegido admita más valores.
Los tipos de cadena son flexibles, no un permiso para ser descuidado
VARCHAR es el tipo de cadena de longitud variable de Snowflake. STRING y TEXT son alias orientados a la compatibilidad, mientras que CHAR y CHARACTER representan semántica de longitud fija. La longitud declarada debería reflejar el contrato que quiere aplicar, pero Snowflake almacena las cadenas de forma eficiente con independencia del máximo declarado. Eso hace cómoda una declaración amplia, aunque debilita lo que comunica el esquema y resta utilidad al profiling.
Para un código de cliente, un estado o una categoría de sistema origen, un contrato VARCHAR documentado es más fácil de validar que un campo sin restricciones. Para descripciones libres, la flexibilidad suele importar más que un límite estrecho. La distinción es operativa: el tipado estricto detecta pronto las entradas incorrectas, mientras que el tipado flexible reduce la fricción de ingesta y traslada más responsabilidad a la validación y la monitorización.
Un patrón habitual en producción es cargar identificadores en bruto como cadenas solo cuando la inconsistencia del origen lo exige, y normalizarlos después en columnas numéricas o temporales nativas en una capa curada. No obligue a cada analista posterior a repetir la misma conversión.
Tipos de fecha, hora y timestamp para datos temporales
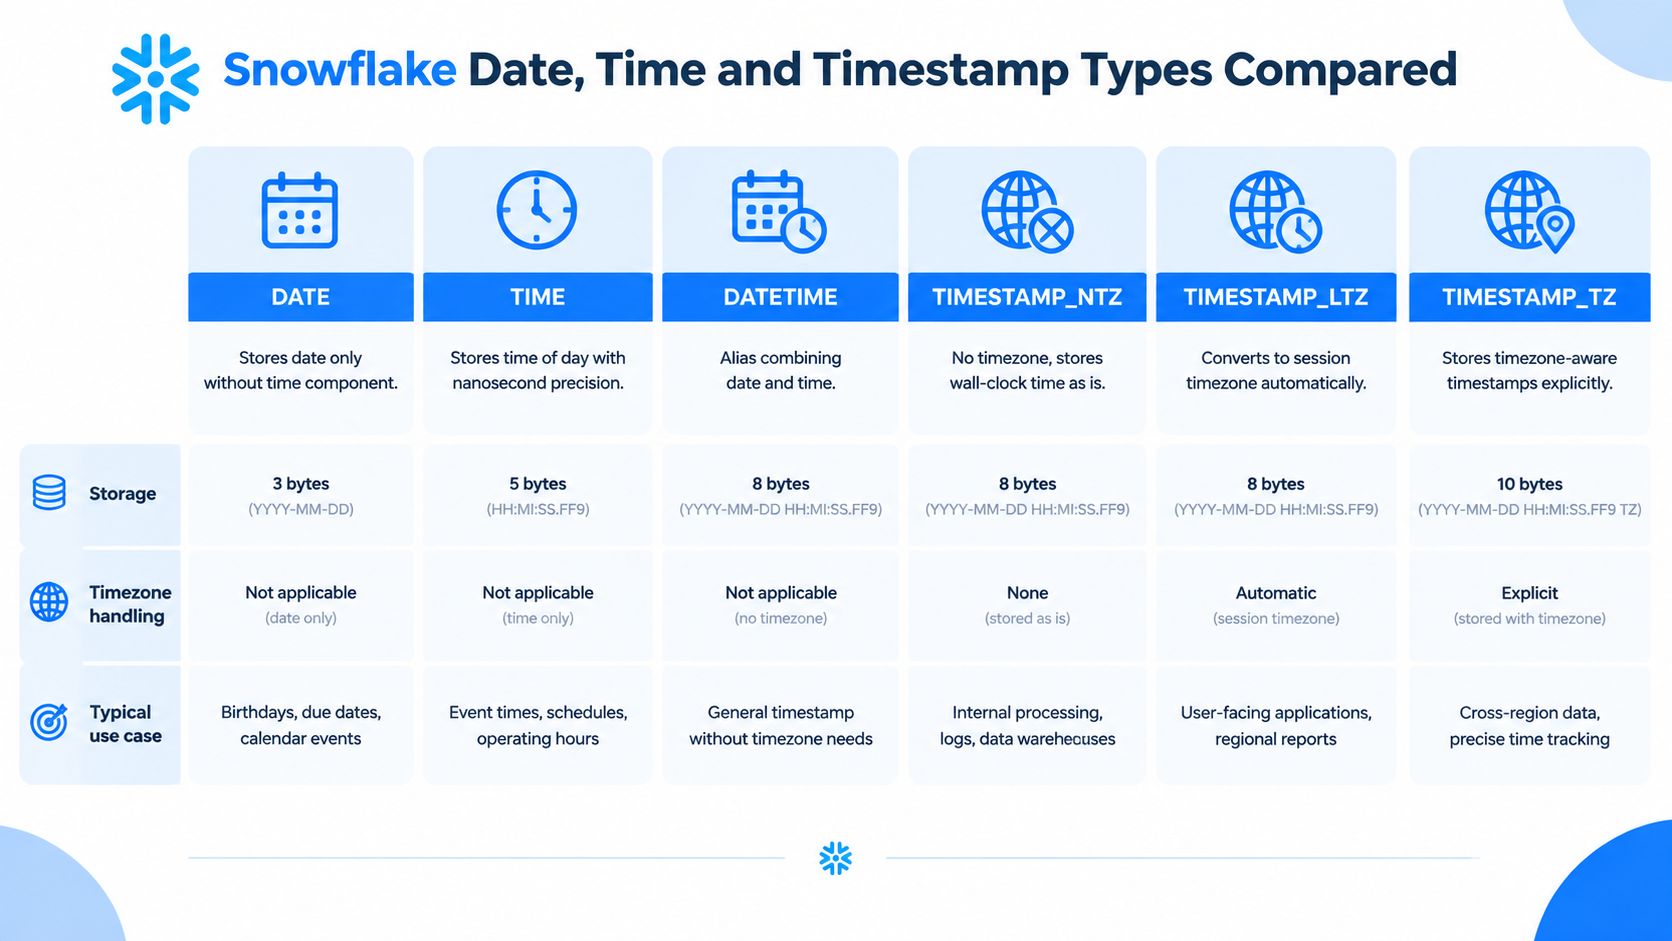
El modelado temporal falla cuando el reloj de una columna no está definido. Snowflake ofrece DATE para fechas de calendario, TIME para horas del día y DATETIME para fecha y hora combinadas. Su familia TIMESTAMP incluye TIMESTAMP_NTZ, TIMESTAMP_LTZ y TIMESTAMP_TZ. La elección afecta a joins, filtros, comportamiento de clustering y a si los controles de calidad pueden identificar un evento desplazado.
TIMESTAMP_NTZ almacena un timestamp de reloj de pared sin semántica de zona horaria. Úselo cuando el origen ya haya normalizado los valores y la ausencia de significado de zona sea intencionada. Se vuelve arriesgado cuando los usuarios comparan valores de distintas regiones como si representaran el mismo instante. TIMESTAMP_LTZ muestra un timestamp en la zona horaria de la sesión, lo que facilita la presentación localizada pero puede producir fechas visibles distintas para usuarios distintos. TIMESTAMP_TZ conserva el comportamiento con zona horaria y suele ser mejor cuando el desplazamiento o la zona de origen tienen significado de negocio.
Ajustar el tipo al contrato del evento
Use DATE para fechas de factura, de reporting o de servicio cuando la hora del día sea irrelevante. Use TIME para horarios y ventanas operativas diarias. Use un timestamp para eventos, registros de ingesta, transiciones de estado y límites de dimensiones de cambio lento.
Las tablas de historia necesitan una convención documentada para los campos de inicio y fin de vigencia. La documentación de historia point-in-time de Snowflake describe campos como _effective_start_timestamp y _effective_end_timestamp, donde las tablas de historia conservan los registros de cambio y las tablas snapshot mantienen los mejores valores conocidos actuales. El mismo diseño permite reconstruir cuándo pasó a ser válido un valor en lugar de mostrar solo su estado actual. La documentación de datos históricos de Snowflake describe un ejemplo de ACS en el que las estimaciones a 5 años usan 60 meses de datos recogidos. Para una explicación más amplia de este patrón, consulte las prácticas de datos históricos en Snowflake.
El comportamiento de zona horaria también afecta al filtrado
La visualización dependiente de la sesión puede crear desplazamientos aparentes de fecha durante una investigación y hacer que las reglas de monitorización reporten falsas anomalías. Estandarice la ingesta, haga explícita la conversión en el momento de la presentación y conserve la zona horaria o el desplazamiento de origen cuando formen parte del contrato del evento.
La elección del tipo también afecta al comportamiento físico. Una expresión de timestamp envuelta en conversiones repetidas dificulta razonar sobre el filtrado y la poda, mientras que unas columnas de evento consistentes dan al clustering y al diagnóstico de consultas una señal más clara. Valide la representación elegida con filtros representativos e inspeccione el comportamiento de las consultas en lugar de suponer que una variante de timestamp siempre rinde mejor. La lección de producción es directa: semántica temporal, poda, clustering y observabilidad pertenecen a la misma conversación sobre el esquema.
Tipos de datos semiestructurados y estructurados
La familia semiestructurada de Snowflake gira en torno a VARIANT, OBJECT y ARRAY. VARIANT puede contener un valor de otro tipo de datos de Snowflake, incluidos OBJECT o ARRAY. OBJECT representa pares clave-valor, mientras que ARRAY representa colecciones ordenadas. Snowflake agrupa estos tipos porque pueden combinarse en estructuras jerárquicas, aunque su documentación señala que, en sentido estricto, OBJECT es el tipo semiestructurado con las características de un verdadero tipo semiestructurado. La documentación de tipos semiestructurados de Snowflake explica esa distinción.
VARIANT resulta valioso en las fronteras de ingesta. Las APIs, los flujos de eventos y los payloads de proveedores suelen evolucionar más rápido que los contratos de las tablas curadas. Preservar la forma original permite a los ingenieros inspeccionar atributos nuevos sin bloquear el proceso de carga. El coste aparece después, cuando los analistas extraen rutas, convierten valores, aplanan arrays o unen campos anidados repetidamente sin una proyección relacional estable.

Los tipos estructurados hacen visibles los contratos
Snowflake también admite tipos estructurados ARRAY, OBJECT y MAP con tipado fijo de elementos o de clave-valor. Estos tipos estructurados pasaron a estar disponibles de forma general el 31 de mayo de 2024, según la documentación de tipos de datos estructurados de Snowflake. Un array estructurado declara el tipo de elemento, mientras que los objects y maps estructurados definen los tipos que contienen en lugar de dejar los valores como contenido VARIANT sin restricciones.
Esa distinción mejora la gobernanza. Los consumidores pueden descubrir si un campo es numérico, textual, temporal o de otro tipo admitido sin inferirlo fila a fila. Además da a la lógica de validación un contrato más firme y puede simplificar expresiones de consulta repetidas.
Snowflake expone metadatos para la introspección. ELEMENT_TYPES en INFORMATION_SCHEMA o ACCOUNT_USAGE puede identificar los tipos de elemento de arrays estructurados, mientras que FIELDS expone los tipos de clave y valor de objects y maps estructurados. Use esas vistas en las comprobaciones de esquema en lugar de confiar solo en la documentación de la aplicación.
Un patrón híbrido funciona bien
Mantenga los payloads en bruto y en evolución en VARIANT y extraiga después los atributos estables y consultados con frecuencia a columnas nativas o valores estructurados. Use FLATTEN cuando los arrays anidados necesiten análisis por filas. Snowflake documenta FLATTEN como una función de tabla que produce una vista lateral del contenido VARIANT, OBJECT o ARRAY, lo que la hace central en las transformaciones de datos anidados. La guía de consulta de datos semiestructurados cubre ese enfoque.
Las capacidades recientes de formatos abiertos también refuerzan la necesidad de tratar la elección de tipo como diseño de gobernanza y rendimiento. La revisión de funcionalidades de 2026 describe el soporte GA de VARIANT para tablas Delta Direct y las capacidades de Iceberg v3, incluidos VARIANT, row lineage, deletion vectors y tipos geoespaciales. La flexibilidad crece, así que los equipos necesitan reglas más firmes sobre dónde termina la flexibilidad y empieza un contrato curado.
Reglas de casting y conversión que debe conocer
El casting es donde un diseño de ingesta permisivo se encuentra con un contrato analítico estricto. Snowflake puede convertir entre muchas familias de tipos, pero la conversión implícita no sustituye a un contrato de datos explícito. Una conversión puede fallar, cambiar la escala, alterar el formato o producir un valor que parece válido aunque ya no represente el origen con precisión.
Tipo de origen | Tipo de destino | Tipo de conversión | Nivel de riesgo | Notas |
|---|---|---|---|---|
Numérico | Cadena | Conversión explícita o contextual | Medio | Conviene revisar el formato y las comparaciones posteriores |
Cadena | Número | Conversión explícita | Alto | Caracteres inválidos o escala inadecuada pueden provocar fallos |
Cadena | Fecha o timestamp | Conversión explícita | Alto | El formato de entrada y las suposiciones de zona horaria deben coincidir |
Ruta | Escalar nativo | Extracción y conversión explícitas | Alto | Las rutas ausentes, nulas o de tipos mixtos requieren tratamiento |
Numérico | Numérico con menor escala | Conversión explícita | Alto | Se puede perder precisión o detalle decimal |
Cadena |
| Parseo o conversión | Medio | Trate los payloads malformados como entrada rechazada o en cuarentena |
Use TRY_CAST o la función de conversión TRY_ correspondiente cuando registros de origen defectuosos no deban abortar una transformación completa. Un resultado nulo sigue necesitando un control. Cuente las conversiones fallidas, conserve el valor original cuando importe la auditabilidad y derive los registros inválidos a revisión en lugar de aceptarlos.
Patrones seguros y atajos peligrosos
Una extracción segura hace visible el destino esperado, por ejemplo convirtiendo una ruta numérica conocida de un valor VARIANT en un entero o número de coma fija solo tras comprobar su presencia y su forma. Un patrón peligroso convierte dentro de un predicado de join sin comprobar si ambos orígenes usan la misma representación. Ese enfoque puede ocultar deriva de origen y añadir trabajo repetido en tiempo de ejecución.
Las conversiones de cadena a fecha merecen especial cautela. Defina el formato aceptado en la ingesta, rechace los valores ambiguos y haga explícito el tratamiento de zona horaria. La conversión de número a cadena también exige disciplina cuando el valor resultante se convierte en clave, porque las diferencias de formato pueden romper la igualdad aunque los números subyacentes sean equivalentes.
Los equipos que reciben ficheros planos de Amazon pueden aplicar el mismo principio: perfilar las columnas de origen antes de cargar, definir los tipos de destino de forma deliberada y mantener observables los fallos de conversión. La ingesta basada en ficheros suele exponer representaciones inconsistentes que un esquema de aterrizaje laxo puede ocultar.
Cómo afectan los tipos de datos al rendimiento y al coste de las consultas
Una semántica correcta no garantiza consultas eficientes. Snowflake almacena los datos de tabla en micro-particiones y registra metadatos que permiten excluir particiones de un escaneo. Las columnas nativas de fecha, timestamp y numéricas suelen dar a los predicados un camino más claro hacia esos metadatos que las expresiones que extraen valores anidados y los convierten fila a fila.
Un tipo amplio no es automáticamente caro, ni un tipo estrecho automáticamente rápido. La forma de la carga de trabajo determina el equilibrio. Conserve la representación de origen cuando aporte contexto de negocio y exponga además columnas específicas y fuertemente tipadas para los filtros, joins y agregaciones recurrentes de los dashboards. Ese diseño reduce el trabajo de conversión repetido sin descartar la evidencia original.
La poda y el clustering dependen del tipo
Las claves de clustering deberían coincidir con los patrones de filtrado recurrentes y mantener un orden útil en toda la tabla. Las representaciones de timestamp inconsistentes debilitan ese beneficio. Envolver una clave de clustering en una conversión también puede limitar la poda, igual que unir un identificador almacenado como cadena en una tabla con uno numérico en otra.
Entre las mejoras recientes de Snowflake figuran la poda en tiempo de ejecución para ciertos filtros TIMESTAMP_TZ y una optimización de consultas capaz de reconocer formas de plan coincidentes en lugar de solo texto idéntico. Estas capacidades mejoran la ejecución en las cargas aplicables, pero no compensan tipos ambiguos, predicados cargados de conversiones o claves de join inconsistentes.

Perfile la carga de trabajo real
Use Query Profile para inspeccionar bytes escaneados, particiones escaneadas, comportamiento de filtros, joins, conversiones y operaciones de flatten. Ejecute la misma consulta de negocio contra una columna nativa y contra una expresión anidada o convertida repetidamente. Después separe la causa: el tipo, la calidad del clustering, la forma del predicado o una proyección innecesaria.
Los cambios de tipo también afectan a la observabilidad. Una conversión puede aumentar el trabajo de escaneo mientras enmascara la deriva del origen, y una columna de cadena ampliada puede dejar pasar formatos inválidos a modelos posteriores. Combine el análisis de Query Profile con la monitorización de uso, coste y rendimiento de Snowflake de digna para comprobar si un despliegue cambió el consumo del warehouse, el comportamiento de las consultas o las señales de calidad de datos. La decisión de ingeniería sigue siendo suya, pero la monitorización debería hacer visible su efecto operativo.
Buenas prácticas de diseño de esquemas para cargas de producción
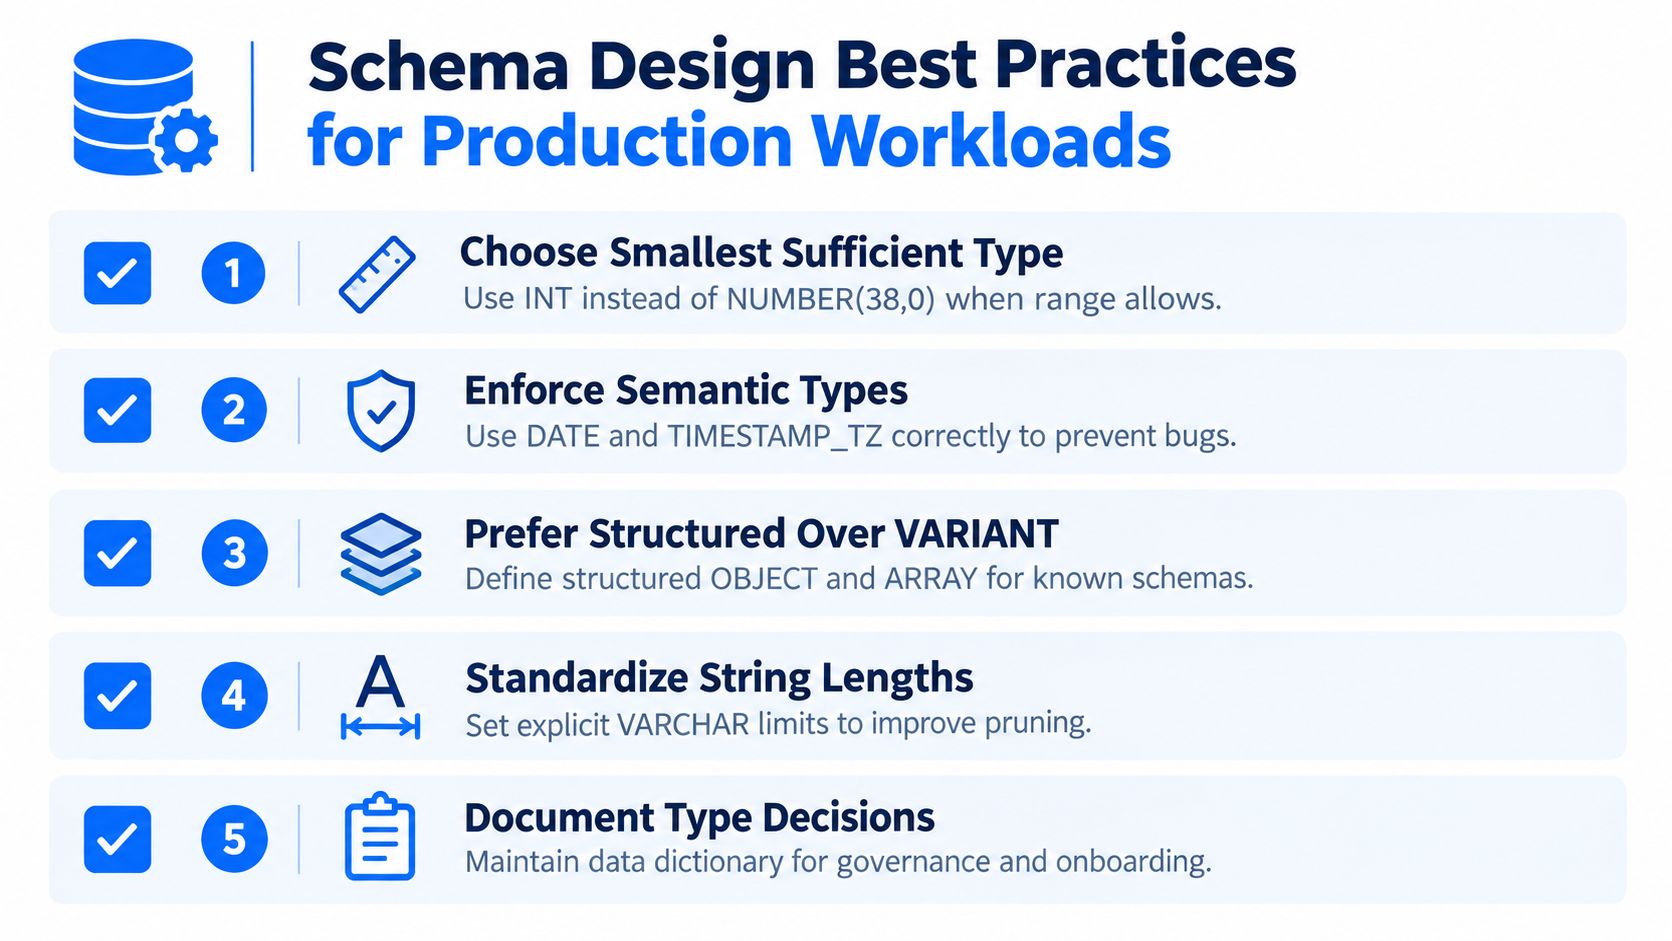
Un esquema de producción debería decir a los usuarios qué significan los valores y ayudar a la plataforma a procesarlos con eficiencia. Empiece por el tipo nativo más pequeño que sea suficiente, pero no reduzca rango ni precisión para que una definición parezca más pulcra. Un identificador entero, una medida financiera exacta, un timestamp de evento y un payload en bruto necesitan contratos distintos.
Diseñar según el rol de la tabla
Las tablas de hechos se benefician de claves nativas, medidas exactas y timestamps que soporten los filtros de ventana temporal habituales. Las tablas de dimensiones necesitan identificadores estables, cadenas descriptivas y límites de vigencia explícitos cuando importa la historia. Los flujos de eventos suelen necesitar un timestamp de ingesta, un timestamp de evento, un identificador de origen y un payload en bruto, con diferencias cuidadosamente documentadas entre esos relojes.
Use VARIANT en el borde cuando la estructura de origen esté evolucionando. Extraiga campos a columnas tipadas cuando los analistas los filtren, unan, agreguen o validen de forma repetida. Los tipos estructurados OBJECT, ARRAY y MAP son una opción intermedia cuando importa la jerarquía pero se conocen los tipos de elemento y de clave-valor.
Hacer deliberada la evolución del esquema
Una columna nueva puede ser retrocompatible, mientras que cambiar una columna de cadena a timestamp puede romper vistas, tests, extracciones y líneas base de monitorización. Guarde los metadatos del esquema, revise los cambios de tipo como migraciones y pruebe consultas representativas antes de promocionar.
Una lista de revisión debería incluir:
Contrato semántico: ¿qué representa el valor y qué significa un nulo?
Comportamiento del predicado: ¿qué filtros y joins usarán la columna?
Controles de calidad: ¿qué comprobaciones de rango, formato, unicidad o relación deben ejecutarse?
Ruta de evolución: ¿qué ocurre cuando el origen añade, elimina o cambia un campo?
Impacto en consumidores: ¿qué modelos, dashboards, exportaciones y alertas dependen del tipo?
Documente la decisión en un diccionario de datos, no solo en el código de migración. El material de diseño de esquemas de digna puede complementar esa revisión manteniendo a la vista los aspectos estructurales y operativos.
Errores habituales con los tipos de datos y cómo corregirlos
Un fallo conocido empieza con un campo de negocio solo de fecha cargado como timestamp. Un dashboard lo convierte a la zona horaria de sesión del usuario y los registros cercanos a medianoche aparecen en el día natural contiguo. La solución es modelar una fecha de negocio real como DATE, o preservar el instante del evento con una convención explícita de zona horaria cuando la hora importe de verdad.
Otro fallo aparece en pipelines financieros que usan valores de coma flotante para importes que requieren conciliación exacta. Pequeñas diferencias de representación afloran entonces en agrupaciones, igualdades o cuadres de saldo. Sustituya el tipo aproximado por una definición de coma fija adecuada, haga el backfill con cuidado y compare resultados antiguos y nuevos antes de cambiar a los consumidores.
La aceptación silenciosa sigue siendo un fallo
Un campo VARCHAR demasiado amplio puede absorber identificadores malformados, mayúsculas mezcladas y formatos inesperados hasta que un join posterior deja de coincidir. Defina el contrato de destino, normalice en la frontera curada y monitorice los valores rechazados o no parseables en lugar de dejar que desaparezcan en una columna de cadena genérica.
VARIANT genera otro tipo de degradación. La tabla carga correctamente, pero cada consulta importante extrae rutas, convierte valores o aplana arrays una y otra vez. Mueva las rutas estables a columnas tipadas, conserve el payload en bruto para trazabilidad y use Query Profile para verificar que la transformación redujo el escaneo innecesario.
Estos problemas son más fáciles de prevenir que de reparar. Pruebe sus supuestos de tipo con nulos representativos, valores malformados, límites de zona horaria, formatos numéricos mixtos y cambios de esquema antes de la primera carga en producción.
Conectar los tipos de datos con la calidad de datos y la observabilidad
Los sistemas de observabilidad solo pueden monitorizar el contrato que expone el esquema. Una columna numérica nativa da a una regla de monitorización un rango y una distribución con significado. Un timestamp con convención declarada permite comprobaciones de consistencia temporal. Un object estructurado expone los campos esperados con más claridad que un payload sin restricciones cuya forma cambia de fila en fila.
La deriva de tipos es especialmente importante porque puede parecer una anomalía de negocio. Un origen que cambia un identificador de numérico a cadena puede crear de repente una tasa de nulos en una conversión posterior. Un cambio de formato de timestamp puede desplazar las métricas de frescura o hacer que los registros caigan fuera de las ventanas esperadas. Una ruta anidada nueva puede ser evolución valiosa del origen, o indicar un cambio de payload que ningún consumidor ha probado.
Construir la monitorización en torno al comportamiento de los tipos
Entre los controles útiles están:
Seguimiento de conversiones fallidas: contar los valores que no superan las conversiones seguras y conservar muestras para el diagnóstico.
Consistencia temporal: comprobar la hora del evento frente a la de ingesta, los límites de vigencia y el orden esperado.
Deriva estructural: detectar columnas y campos anidados añadidos, eliminados o con tipo cambiado.
Comprobaciones de distribución: vigilar nulos, rangos, cardinalidad y cambios inesperados de categoría.
Comportamiento de consultas: observar el volumen escaneado, la variación de tiempos de ejecución y los cambios de carga tras las migraciones de esquema.
Una plataforma de calidad de datos debería conectar estas señales en lugar de tratarlas como alertas aisladas. digna ofrece validación de datos in-database, detección de anomalías, monitorización de puntualidad y capacidades de Schema Tracker que identifican cambios estructurales, incluidas modificaciones de tipo de datos, manteniendo la ejecución dentro del entorno del cliente. Para equipos que formalizan la cobertura de reglas, esta guía sobre reglas de validación y calidad de datos continua es una referencia práctica.
El objetivo no es alertar ante cualquier diferencia de esquema. Es distinguir una migración aprobada de una ruptura accidental del contrato y mostrar qué tablas, métricas y consumidores están expuestos.
Referencia rápida de todos los tipos de datos de Snowflake
Use esta tabla al revisar una columna o al redactar un estándar de esquema. Los alias siguientes son útiles para la compatibilidad, pero el contrato semántico previsto debería permanecer explícito.
Familia | Tipos | Características clave | Uso habitual |
|---|---|---|---|
Numérico exacto |
| Precisión y escala de coma fija | Valores financieros, medidas exactas |
Numérico entero |
| Alias enteros para números completos | Claves, recuentos, valores de secuencia |
Numérico aproximado |
| Valores aproximados de coma flotante | Mediciones científicas o aproximadas |
Cadena |
| Semántica de texto de longitud variable o fija | Códigos, etiquetas, descripciones |
Binario |
| Almacenamiento binario en bruto | Datos codificados u orientados a bytes |
Temporal |
| Valores temporales de fecha, hora o combinados | Fechas de negocio y calendarios |
Timestamp |
| Distinto comportamiento de zona horaria y de visualización por sesión | Eventos, ingesta, periodos de vigencia |
Lógico |
| Valores verdadero o falso | Indicadores y marcas de estado |
Semiestructurado |
| Contenido jerárquico flexible | JSON en bruto y payloads en evolución |
Estructurado |
| Tipado fijo de elementos o de clave-valor | Datos anidados gobernados |
Geoespacial |
| Modelado de datos espaciales | Análisis geográfico y geométrico |
El modelo de tipos nativo de Snowflake separa los tipos escalares primitivos de los semiestructurados y estructurados. La referencia completa de tipos de datos de Snowflake documenta además superficies de metadatos como ELEMENT_TYPES y FIELDS, útiles cuando las comprobaciones automatizadas necesitan inspeccionar contenido estructurado.
Un buen valor por defecto es aterrizar con flexibilidad los datos de origen inciertos, curar en tipos nativos las rutas de acceso recurrentes y revisar cada cambio de tipo por su impacto en poda, compatibilidad con consumidores y monitorización. Ese enfoque mantiene la corrección semántica sin producir un esquema que solo parece limpio sobre el papel.
digna ayuda a los equipos de datos a conectar los cambios de esquema de Snowflake con validación, detección de anomalías, puntualidad y monitorización estructural dentro de su propio entorno. Si está estandarizando tipos de datos de Snowflake y quiere detectar la deriva antes de que rompa dashboards o pipelines posteriores, visite digna para evaluar la plataforma en su flujo de observabilidad.
Vea cómo lo hace digna en la práctica: monitorización de la calidad de datos dentro de Snowflake.
Preguntas frecuentes
¿Qué tipo de datos de Snowflake debo usar para los números?
Use NUMBER de coma fija (o sus alias DECIMAL y NUMERIC) para valores que deban ser exactos, como importes y cantidades. Reserve FLOAT y DOUBLE para trabajo científico o estadístico donde la aproximación sea aceptable, porque la coma flotante introduce diferencias de redondeo que afloran al agregar y al comparar.
¿Cuál es la diferencia entre VARCHAR y STRING en Snowflake?
Son sinónimos: STRING, TEXT y VARCHAR se corresponden con el mismo tipo de longitud variable, y Snowflake almacena solo los caracteres que realmente escribe, así que declarar una longitud generosa no cuesta almacenamiento. Declarar una longitud realista sigue mereciendo la pena por motivos operativos: documenta el contrato y hace visibles los valores inesperados en lugar de aceptarlos en silencio.
¿Cuándo debo usar VARIANT en lugar de tipos estructurados?
Use VARIANT donde el payload evolucione de verdad y no pueda controlar al productor, normalmente en la capa de aterrizaje. Use columnas tipadas explícitas para los contratos de los que depende el reporting. El patrón híbrido —aterrizar en VARIANT y proyectar columnas tipadas aguas abajo— mantiene flexible la ingesta sin trasladar el coste de extracción y conversión a cada consulta.
¿Cómo afectan los tipos de datos de Snowflake al rendimiento y al coste de las consultas?
Los tipos determinan lo bien que funcionan la poda de micro-particiones y el clustering, y si los predicados necesitan conversión antes de comparar. Convertir una columna dentro de una cláusula WHERE suele impedir la poda, de modo que Snowflake escanea muchos más datos de los necesarios y la consulta consume más créditos para la misma respuesta.
¿Cómo afectan los tipos de datos a la monitorización de la calidad de datos?
Los tipos estables y específicos hacen que la desviación signifique algo: la monitorización puede comparar distribuciones, tasas de nulos y rangos de valores frente a un contrato conocido. Los tipos demasiado permisivos aceptan valores malformados sin protestar, así que los problemas permanecen invisibles hasta que alguien cuestiona una cifra en un informe.


