Detección de anomalías en datos categóricos explicada
|
7
minuto de lectura

Usted ya conoce el modo de fallo. El panel está tranquilo, las comprobaciones numéricas están limpias y el modelo que funcionaba bien la semana pasada empieza a devolver resultados absurdos porque un campo categórico cambió de una forma que nadie advirtió. Aparece un nuevo código de estado, se reasigna una categoría de producto o un proveedor empieza a enviar una etiqueta de país diferente, y la avería solo se manifiesta cuando el sistema posterior ya ha tomado malas decisiones.
Por eso la detección de anomalías en datos categóricos necesita su propio manual de actuación. En los espacios categóricos, la señal suele residir en los valores poco frecuentes, las combinaciones inesperadas y los cambios en las frecuencias conjuntas, no en la distancia respecto a una media ni en un gran salto numérico. La tarea práctica consiste en detectar esos cambios con la suficiente antelación para que los ingenieros de datos, los analistas y los responsables de los modelos puedan actuar antes de que se erosione la confianza.
Índice
Por qué fallan los algoritmos estándar con las variables categóricas
Adaptaciones de aprendizaje automático para distribuciones complejas
Gestión de variables de alta cardinalidad y de la deriva del esquema
Los riesgos ocultos de los cambios en los datos categóricos
Los peores incidentes rara vez empiezan con un fallo estrepitoso. Un pipeline sigue funcionando, el número de filas parece normal y lo único que ha cambiado es una etiqueta que a nadie se le ocurrió supervisar. Entonces un modelo empieza a clasificar a los clientes de forma extraña porque la combinación de categorías que aprendió ya no coincide con la realidad de producción.
Las anomalías categóricas son diferentes de los valores atípicos numéricos. Una anomalía numérica puede ser un valor muy alejado de la media, pero una anomalía categórica suele ser un nivel, o una combinación de niveles entre campos, que aparece con una frecuencia inusualmente baja respecto a la población de referencia. Por eso la categoría en sí importa menos que la frecuencia con la que aparece y la forma en que coincide con otros campos, que es la lógica central descrita en la literatura sobre detección de anomalías categóricas en relación con los patrones de contingencia dispersos y la rareza de los valores conjuntos capítulo de Springer sobre detección de anomalías categóricas.
Un fallo en producción suele empezar con un pequeño cambio de etiqueta
Un equipo financiero puede ver el mismo volumen de transacciones, pero un código de estado de pago cambia de forma y las reglas posteriores dejan de corresponderse con el proceso subyacente. Un equipo sanitario puede seguir recibiendo reclamaciones de aspecto válido mientras un campo empieza a contener un nuevo valor codificado que la antigua lógica de validación nunca aprendió. En ambos casos, las cifras se mantienen estables el tiempo suficiente para ocultar el problema.
Por eso los equipos deben vigilar los cambios categóricos como una señal de primer orden. Una distribución de categorías puede derivar sin que ningún campo individual parezca extremo por sí solo, y un patrón conjunto puede ser anómalo aunque cada campo individual parezca normal. El riesgo práctico es que un panel sencillo transmita una falsa sensación de estabilidad.
Como ejemplo práctico del problema de supervisión más amplio, los patrones de deriva de datos tratados en la visión general de digna sobre la detección de la deriva de datos encajan directamente en esta perspectiva de cambios de categoría. La lección operativa es sencilla: si cambia el espacio de etiquetas, también cambia el mundo del modelo.
Regla práctica: si un campo categórico puede cambiar su significado de negocio sin que cambie el volumen de filas, debe formar parte de sus comprobaciones de anomalías.
Por qué fallan los algoritmos estándar con las variables categóricas
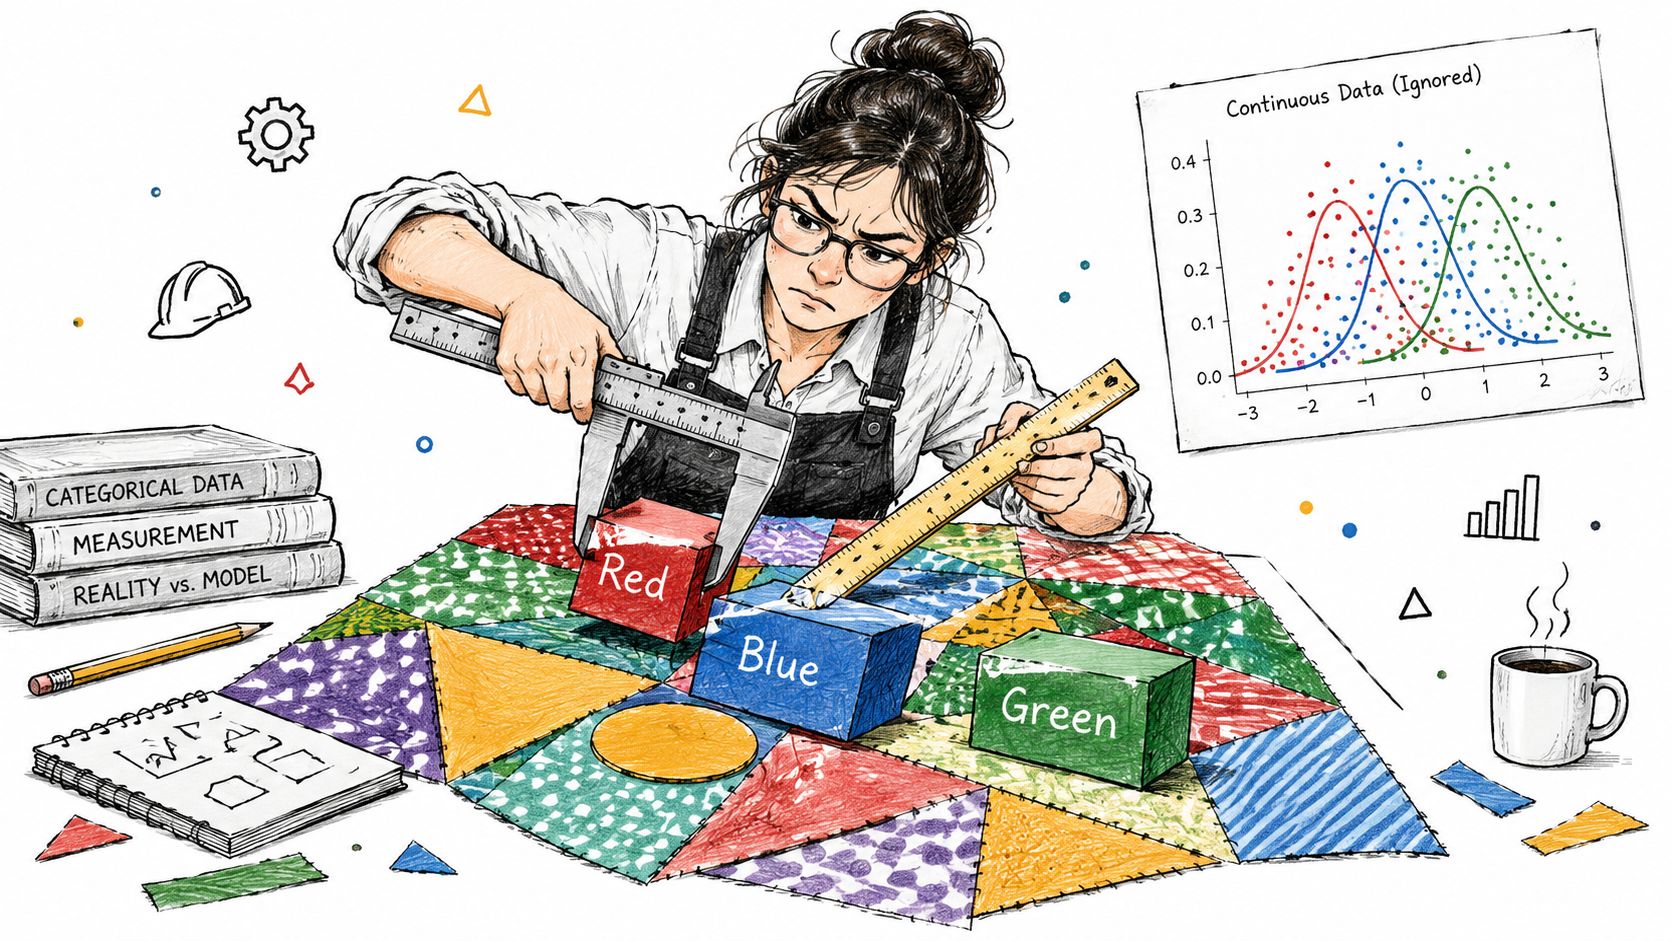
La mayoría de las herramientas de anomalías numéricas presuponen una geometría que los datos categóricos no tienen. La distancia euclidiana funciona para puntos en un espacio continuo, pero un código de país, un tipo de transacción o el estado de una reclamación no están «cerca» ni «lejos» en ningún sentido ordinal significativo. Tratar las etiquetas como coordenadas convierte un problema discreto en uno numérico ficticio.
Este desajuste importa sobre todo cuando la cardinalidad es alta. A medida que las variables categóricas se vuelven más granulares, las tablas de contingencia se vuelven dispersas y la señal útil se desplaza hacia intersecciones poco frecuentes en lugar de grandes magnitudes. La literatura de referencia señala que los métodos clásicos de anomalías suelen presuponer datos continuos, razón por la cual las variables categóricas se traducen con frecuencia a atributos continuos antes de la detección, aunque esa traducción puede borrar precisamente la estructura que se necesita inspeccionar estudio de CEUR sobre métodos de detección de anomalías.
Los patrones de contingencia dispersos son donde se producen los fallos de detección
Un código de país por sí solo puede parecer normal. Un tipo de pago por sí solo puede parecer normal. Una clase de dispositivo por sí sola puede parecer normal. Pero la combinación de esos tres campos puede ser lo bastante rara como para merecer atención, y los métodos basados en la distancia numérica a menudo la pasan por alto porque se centran en la magnitud en lugar de en la coocurrencia.
Por eso las variables categóricas de alta cardinalidad causan problemas. La codificación one-hot puede disparar la dimensionalidad, los umbrales basados en la desviación estándar pierden sentido y las puntuaciones Z no le dicen si un código nuevo es inusual o simplemente nuevo. En la práctica, los equipos necesitan métodos que puntúen la rareza, comparen distribuciones y respeten la naturaleza discreta de los datos.
Un modelo mental mejor parte de la frecuencia, no de la distancia
Piense en términos de soporte de categoría, frecuencia condicional y recuentos observados frente a esperados. Si un nivel de categoría es habitual en los datos históricos pero desaparece de repente, eso puede ser relevante. Si un nivel poco frecuente pasa de repente a ser dominante, también puede serlo. El método debe reflejar esa lógica en lugar de forzar los datos a adoptar una forma geométrica que nunca tuvieron.
El reconocimiento estadístico de patrones para campos categóricos es el enfoque adecuado aquí, porque trata las etiquetas como etiquetas, no como números disfrazados. Esa es la diferencia entre un pipeline que señala cambios reales de categoría y otro que solo produce ruido matemático.
Líneas base estadísticas y puntuación por frecuencia
Empiece con una línea base que refleje cómo es lo normal para cada campo categórico. Para una columna estable, esa línea base suele ser la distribución histórica de frecuencias de cada nivel de categoría, más las frecuencias conjuntas relevantes para el proceso de negocio. Si los datos son estacionales o dependen del flujo de trabajo, compare elementos equivalentes en lugar de suponer que una única línea base global sirve para todo.
Compare los recuentos observados con los esperados
La prueba de chi cuadrado es una forma estándar de comparar las frecuencias de categoría observadas con una distribución de referencia para detectar la deriva categórica, y la guía sobre la deriva de datos en streaming la describe como adecuada para cambios en campos como códigos de estado o categorías de producto guía de Conduktor sobre la deriva de datos. El PSI también es útil para convertir el cambio de distribución en un nivel de gravedad operativo. La misma guía establece umbrales de PSI inferiores a 0,1 para una deriva mínima, de 0,1 a 0,25 para una deriva moderada que requiere investigación y superiores a 0,25 para una deriva significativa que exige una acción inmediata.
Valor de PSI | Gravedad de la deriva | Acción recomendada |
|---|---|---|
Inferior a 0,1 | Deriva mínima | Supervisar y mantener activa la línea base |
De 0,1 a 0,25 | Deriva moderada | Investigar el origen de la categoría y el impacto posterior |
Superior a 0,25 | Deriva significativa | Tratar como urgente y revisar los cambios en el pipeline o en el negocio |
Utilice la entropía para hacerse una idea rápida de la imprevisibilidad
La entropía es útil porque indica lo dispersa que está una distribución de categorías. Una entropía baja significa que los datos se concentran en unos pocos niveles. Una entropía más alta significa que la distribución está más mezclada, lo que puede indicar una nueva fuente, un cambio de negocio más amplio o una integración previa desordenada.
Eso no convierte a la entropía en un detector completo por sí sola. Es una señal de perfilado, no un veredicto. Úsela para detectar cuándo un campo categórico se ha vuelto más o menos predecible y, después, confírmelo con comprobaciones basadas en recuentos o con una puntuación de frecuencias conjuntas.
Para los equipos que necesitan una forma estructurada de conectar el perfilado con la detección, las técnicas de perfilado de datos ofrecen el contexto de apoyo adecuado. Y si necesita una explicación clara de cómo la significación estadística le ayuda a decidir si merece la pena actuar ante un cambio, la guía sobre significación para responsables de crecimiento es una lectura complementaria útil.
Mantenga el flujo de trabajo lo bastante sencillo para operarlo
Perfile primero la columna. Genere recuentos por categoría, la tasa de nulos y una vista top-k de los niveles que aparecen con más frecuencia.
Compare con una línea base. Utilice chi cuadrado o PSI cuando la cuestión sea un cambio de distribución.
Compruebe los patrones conjuntos. Si la distribución marginal parece correcta, inspeccione las combinaciones entre campos.
Escale según la gravedad. Un cambio pequeño puede supervisarse, pero un cambio fuerte requiere revisión humana.
No se trata de sustituir el aprendizaje automático. Se trata de no saltar directamente a la complejidad antes de que las pruebas estadísticas más sencillas hayan hecho su trabajo.
Adaptaciones de aprendizaje automático para distribuciones complejas
Algunos problemas categóricos son demasiado complejos para resolverlos solo con comprobaciones de frecuencia sencillas. Implican muchos campos, reglas de negocio cambiantes e interacciones que aparecen en combinaciones de categorías en lugar de dentro de una sola columna. En los pipelines de producción, eso suele significar que se necesitan modelos capaces de aprender la estructura a partir de datos dispersos y de alta cardinalidad sin ocultar los problemas operativos subyacentes.
Los embeddings ayudan cuando la cardinalidad se vuelve inmanejable
Los embeddings categóricos asignan niveles de alta cardinalidad a representaciones densas que otros detectores pueden utilizar. Esto ofrece a los equipos una forma de introducir la estructura de las categorías en autoencoders, isolation forests o modelos similares, una vez que las etiquetas en bruto se han transformado en un espacio latente aprendido. Un estudio sobre seguros de salud citado en la literatura reciente utilizó explícitamente embeddings categóricos para variables de alta cardinalidad, detectores no supervisados y SHAP en un flujo de trabajo que no se había utilizado antes en ese contexto, lo que demuestra lo activo que sigue siendo este espacio de diseño estudio de PubMed sobre variables categóricas de alta cardinalidad.
La cuestión práctica no es si los embeddings resultan elegantes. Es si conservan las señales de categoría que la codificación one-hot pierde en espacios de variables dispersos.
Compare las familias de modelos habituales
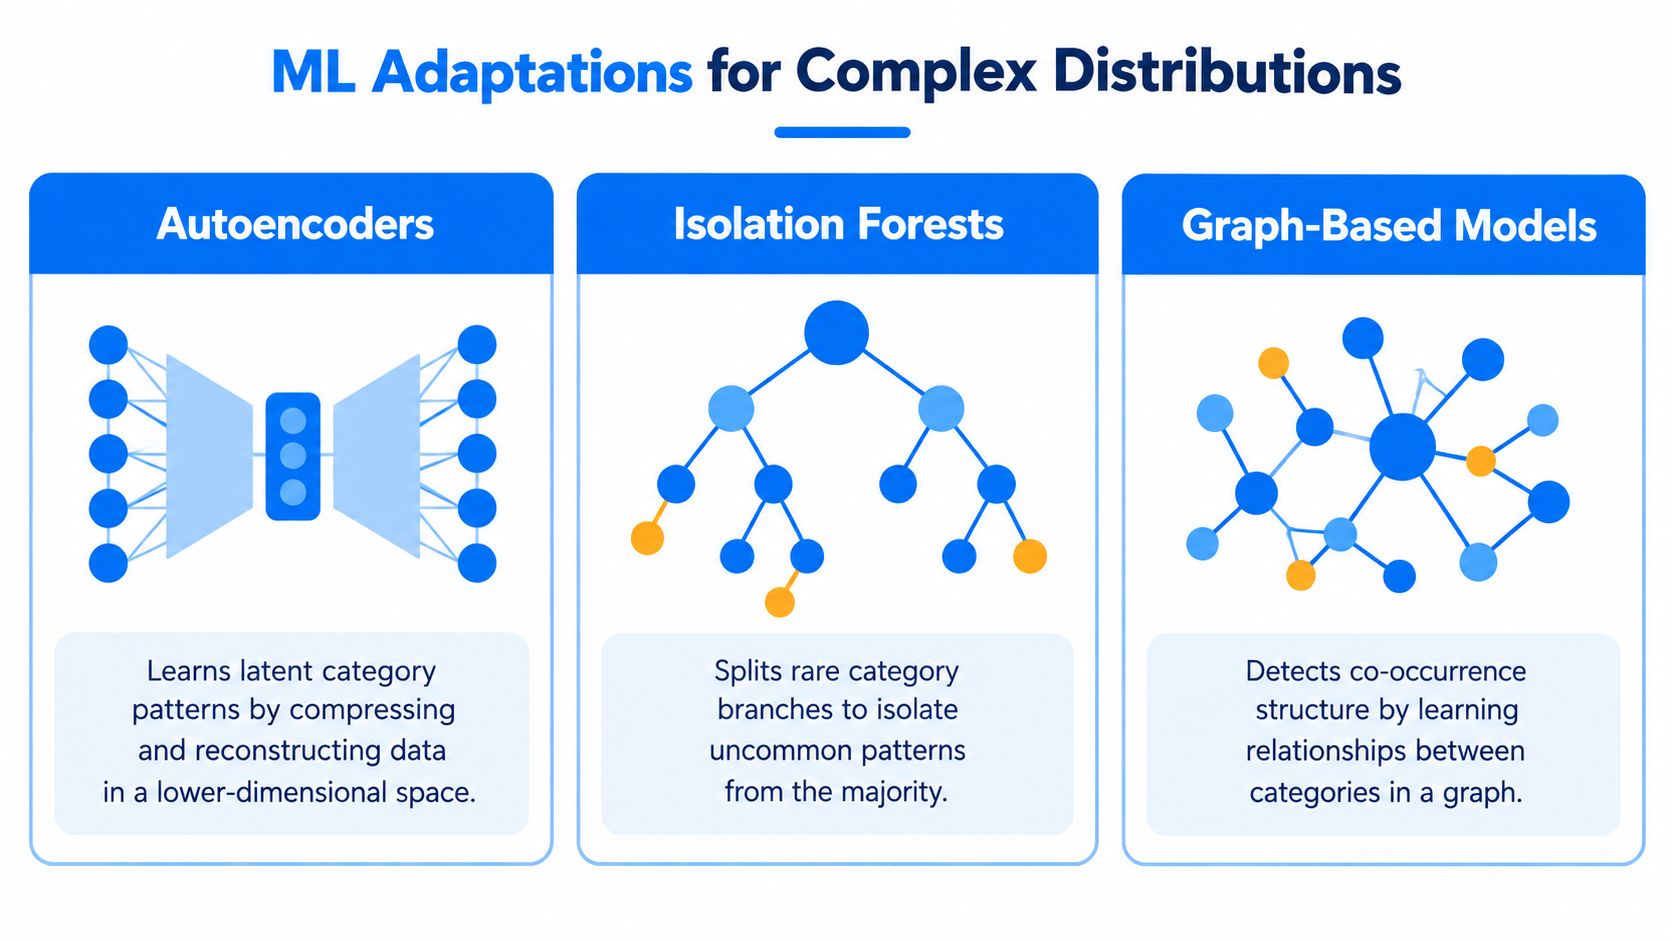
Los autoencoders funcionan bien cuando las categorías siguen patrones latentes estables y se desea que el error de reconstrucción ponga de manifiesto las anomalías.
Los Isolation Forests resultan útiles cuando los embeddings o el feature hashing les proporcionan una superficie numérica sobre la que realizar particiones.
Los modelos basados en grafos son importantes cuando la estructura de coocurrencia aporta más señal que cualquier campo individual.
Los conjuntos de datos categóricos reales no son ejemplos de manual. El repositorio ADBenchmarks enumera 14 conjuntos de datos categóricos ampliamente utilizados, entre ellos Census con 299.285 filas y CoverType con 581.012 filas, lo que recuerda que los métodos deben escalar tanto en dimensionalidad como en tamaño de muestra repositorio de conjuntos de datos categóricos de ADBenchmarks. El conjunto de referencia también muestra que el rendimiento puede variar drásticamente entre conjuntos de datos complejos.
Elija el modelo en función del modo de fallo
Si el problema son unos pocos cambios de categoría evidentes, empiece con pruebas estadísticas. Si se trata de una estructura sutil de valores conjuntos, utilice un modelo que aprenda las interacciones. Si el campo es enorme y disperso, los embeddings pueden servir de puente entre las categorías en bruto y una detección utilizable. Como punto de partida práctico, consulte esta guía sobre la detección de anomalías en datos con Python.
Gestión de variables de alta cardinalidad y de la deriva del esquema
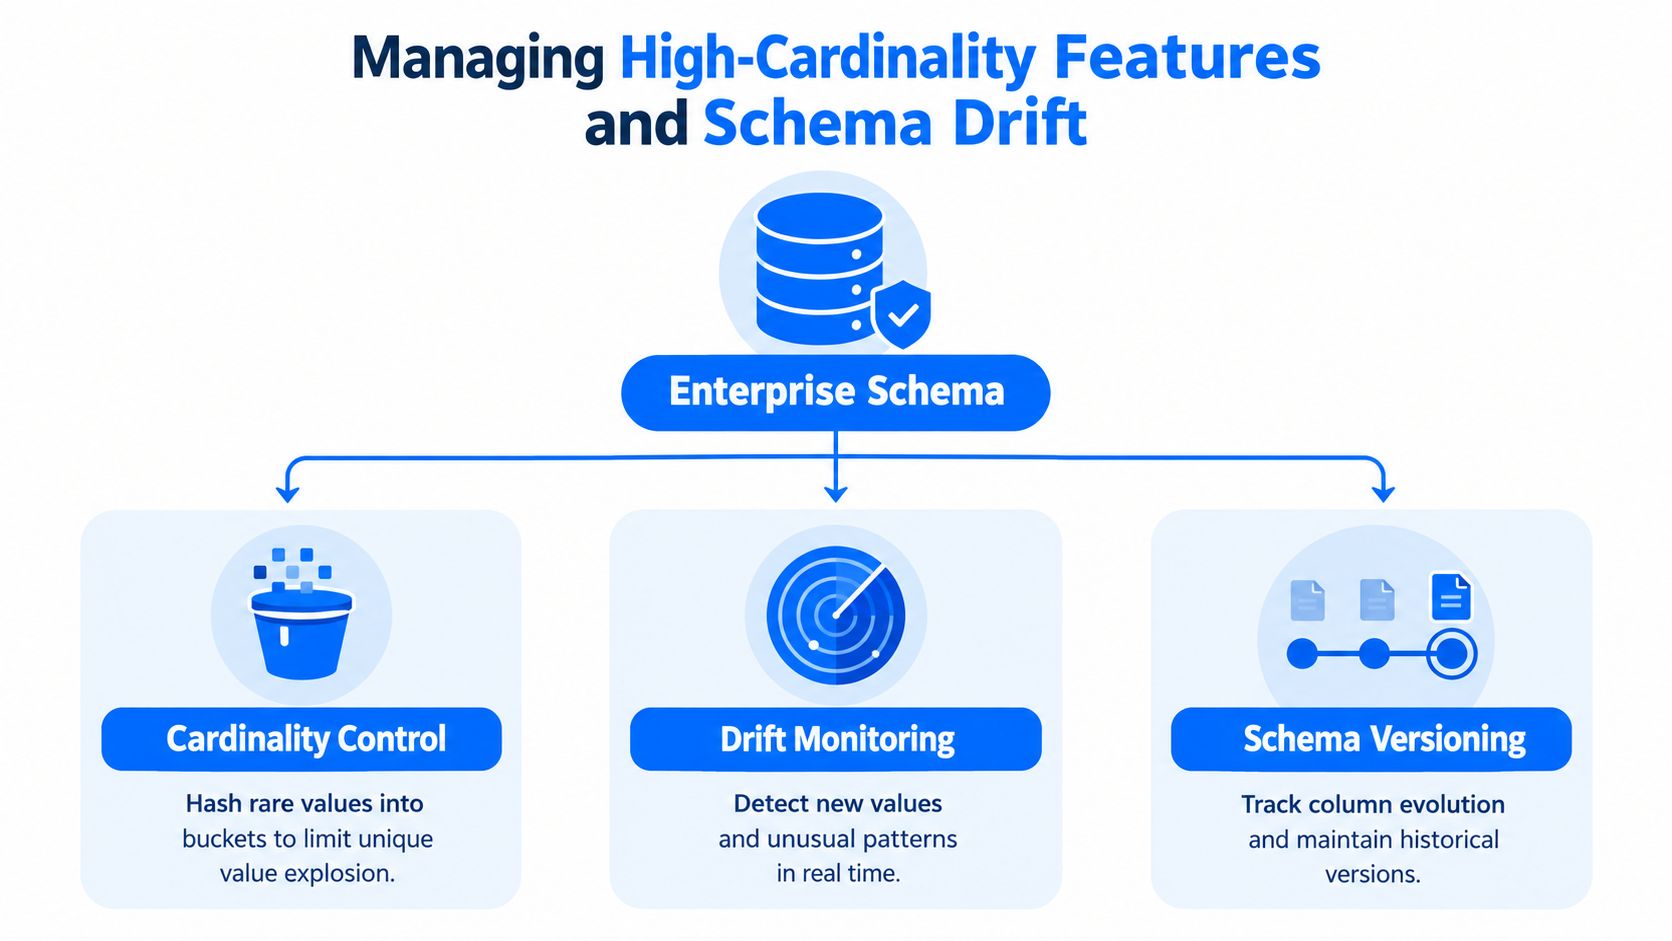
Una tabla de clientes puede parecer estable durante meses y, de repente, un nuevo código de región, código de producto o sistema de origen empieza a llenar la misma columna con valores que su línea base nunca ha visto. Ahí es donde la supervisión de alta cardinalidad se complica, porque el espacio de categorías es disperso y el esquema que lo rodea a menudo cambia al mismo tiempo.
Trate la estructura y la distribución como comprobaciones independientes
Un diseño de referencia para la detección de la deriva de esquemas y atributos recomienda dos líneas base para cada tabla supervisada: una huella estructural y un perfil estadístico diseño de detección de la deriva de esquemas y atributos. La huella estructural detecta columnas añadidas o eliminadas y cambios de tipo. El perfil estadístico recoge, por columna, la proporción de nulos, el número de valores distintos, los límites numéricos cuando procede y un histograma top-k de categorías para los campos codificados. Para un análisis más detallado de lo que se rompe cuando cambia la estructura, consulte la deriva del esquema explicada.
Esta separación importa en producción. Un valor nuevo puede ser un cambio de negocio válido, mientras que una columna renombrada o un tipo modificado pueden invalidar la línea base antes de que cualquier comprobación de distribución resulte útil.
Reduzca el ruido sin ocultar los valores poco frecuentes
Las categorías poco frecuentes aportan señal, pero también generan ruido de alertas. El hashing, la agrupación en intervalos y la agrupación controlada pueden estabilizar la superficie de supervisión, siempre que no se fusionen demasiado pronto significados de negocio distintos. Si aparece un código de producto poco frecuente, el pipeline debe registrarlo primero y después decidir si pertenece a un grupo existente.
Supervise primero el cambio de esquema y después decida si el cambio de categoría es una anomalía real o una nueva normalidad.
La trazabilidad es la cuestión central en los sistemas regulados. Los equipos deben poder mostrar qué cambió, por qué se señaló y qué línea base produjo la decisión. Vincule la deriva del esquema y la deriva categórica en el mismo flujo de trabajo para que los analistas no acaben con tickets separados para una misma avería subyacente.
Mantenga sencillo el modelo operativo
Una configuración práctica suele constar de tres pasos. Detectar categorías nuevas o eliminadas. Comparar la distribución actual con la línea base aprendida. Versionar el esquema para que el historial de cambios siga siendo explicable más adelante. Eso basta para detectar la mayoría de los fallos relacionados con categorías sin inundar al equipo de falsos positivos.
Compromisos de implementación y herramientas empresariales
Un pipeline propio en Python para la detección de anomalías categóricas es perfectamente viable. Lo difícil es mantenerlo fiable cuando crece el número de tablas, evolucionan los esquemas y la lógica de alertas debe satisfacer al mismo tiempo los requisitos de gobernanza, seguridad y auditoría.
El código propio da control, pero también trabajo de mantenimiento
Una pila desarrollada a medida puede utilizar pandas, scikit-learn o un perfilado basado en SQL para la capa estadística, y eso está bien para un alcance reducido. El problema es lo que ocurre después de las primeras tablas. Tiene que gestionar usted mismo las líneas base, los umbrales, la programación, el historial, la responsabilidad, el enrutamiento de incidentes y la explicabilidad, y cada una de esas piezas puede convertirse en un punto de fallo independiente.
TensorFlow Data Validation es una opción de código abierto práctica cuando se desean comprobaciones de deriva entre lotes y medidas de distancia categórica, ya que detecta la deriva entre intervalos de datos consecutivos y mide la deriva de las variables categóricas con la distancia L-infinito guía de TensorFlow Data Validation. Funciona bien cuando el pipeline ya está estandarizado y el equipo puede permitirse asumir la orquestación que lo rodea.
La elección de plataforma importa cuando la seguridad y la gobernanza no son negociables
La ejecución dentro de la base de datos es importante porque mantiene los datos en su sitio y reduce los movimientos innecesarios entre sistemas. Esto es especialmente relevante en entornos financieros, sanitarios, de telecomunicaciones y del sector público, donde la soberanía de los datos y los controles de acceso condicionan la arquitectura. La investigación de IBM sobre IA semántica en Db2 apunta en la misma dirección, ya que plantea acercar el análisis a la base de datos como una forma de reducir los riesgos de privacidad, cumplimiento normativo e incoherencia, manteniendo juntas la información estructurada y la no estructurada IBM Research sobre SQL Data Insights Pro.
Ahí es donde plataformas como digna encajan en el panorama operativo como una opción entre otras. Se ejecuta en el propio entorno del cliente, realiza las comprobaciones dentro de la base de datos y combina métodos estadísticos con aprendizaje automático para la detección de anomalías en campos categóricos, lo que la hace relevante cuando los equipos necesitan una supervisión continua sin construir cada componente desde cero.
Elija en función de la carga operativa, no solo de la calidad del detector
El mejor detector no sirve de nada si el pipeline que lo rodea se viene abajo. Si su equipo necesita una forma limpia de supervisar cientos de tablas, conservar el historial de esquemas y evitar mover datos sensibles, la decisión sobre las herramientas depende tanto del modelo de ejecución como de la elección del algoritmo. Unos precios transparentes y estables según el uso también importan cuando se intenta prever cómo escalará un programa de supervisión con el número de tablas y el uso.
Cómo crear un flujo de supervisión listo para producción
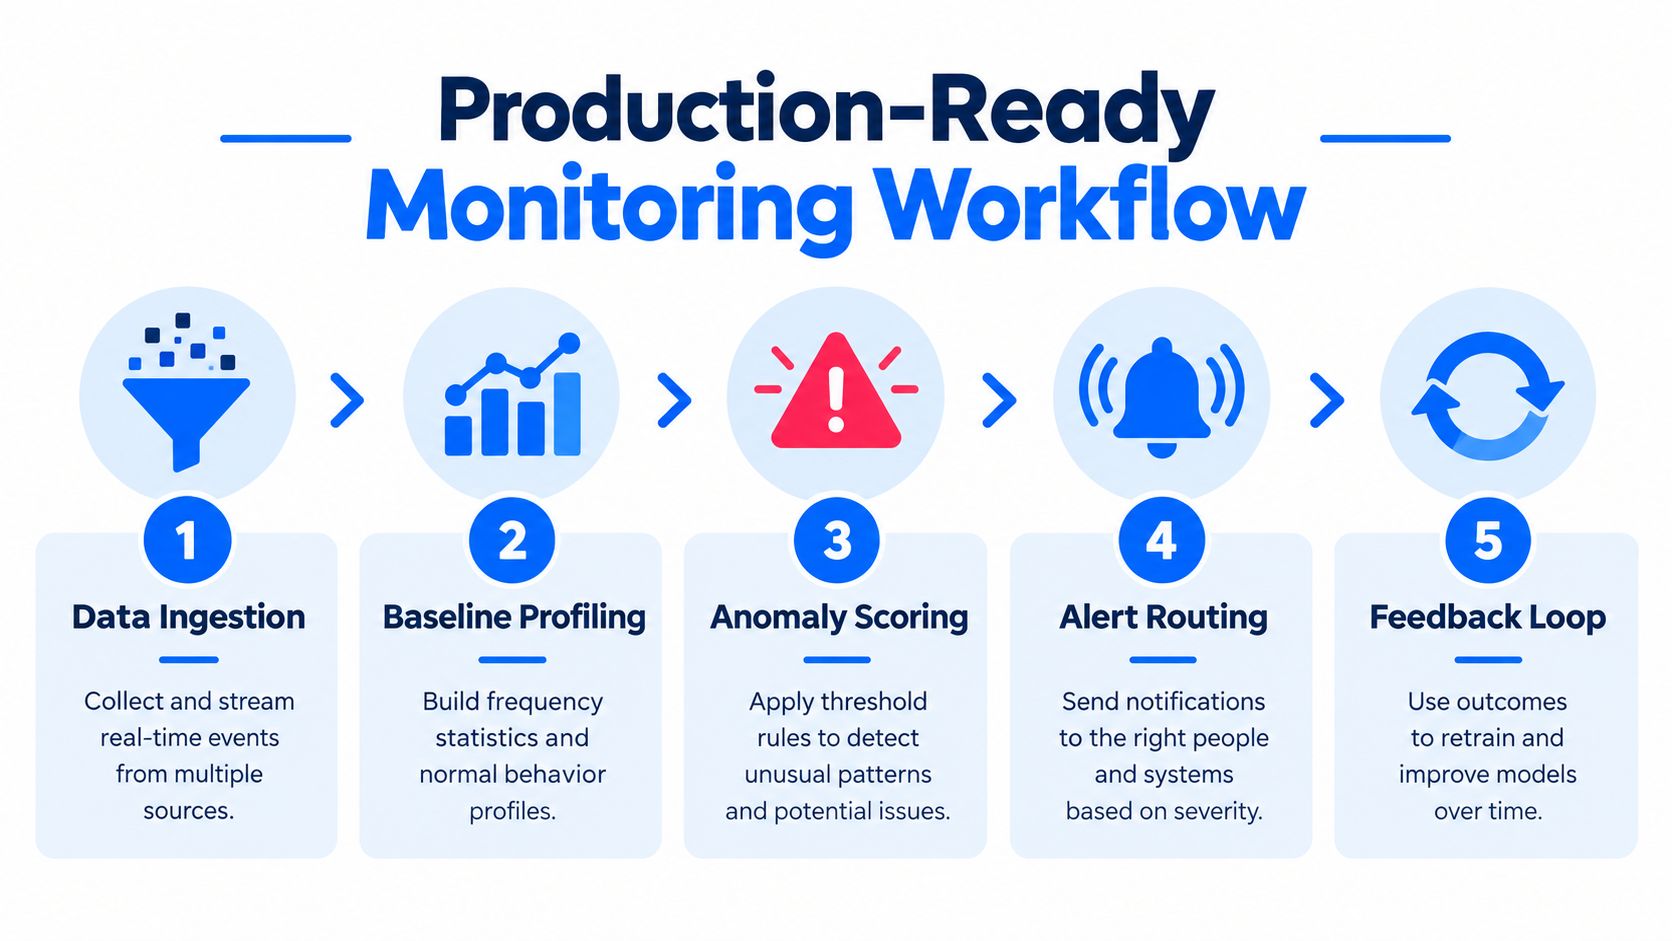
Un flujo de producción para la detección de anomalías categóricas debería ser aburrido en el mejor sentido. El pipeline ingiere los datos, perfila las distribuciones de categorías, puntúa las anomalías, dirige las alertas al responsable adecuado y devuelve el resultado a la línea base para que el sistema siga aprendiendo. Si falta alguna de esas piezas, el detector se convierte en un script puntual en lugar de en un control operativo.
Construya el flujo en torno a la responsabilidad
Empiece por definir qué tablas y campos categóricos son críticos para el negocio. Después, asigne responsables que puedan interpretar una alerta en su contexto, porque la respuesta adecuada ante una categoría nueva no siempre es la misma que ante un esquema roto. Sin responsables, las alertas se convierten en ruido.
Una alerta útil le dice a alguien exactamente qué cambió, dónde cambió y qué línea base se ha incumplido.
A continuación, mantenga la línea base local para cada tabla y campo, no global para todo el almacén de datos. El comportamiento categórico suele ser específico de cada dominio, por lo que un campo de un sistema no puede juzgarse con las mismas expectativas que un campo con un nombre similar en otro lugar. Esto es especialmente cierto cuando los códigos, las jerarquías de productos y los valores de estado difieren según el sistema de origen.
Haga que el ciclo de retroalimentación forme parte del detector
Cada revisión debería actualizar el sistema de algún modo, aunque el resultado sea «esto era lo esperado». Eso puede significar ajustar los umbrales, añadir una nueva categoría permitida o cambiar la lógica de agrupación de los niveles poco frecuentes. Si la línea base nunca aprende, el mismo falso positivo volverá mañana.
El último paso es sencillo, pero fácil de omitir. Integre las comprobaciones categóricas en la misma ruta operativa que el resto de su pila de observabilidad de datos para que no queden aisladas del linaje previo, de los paneles posteriores ni de las entradas de los modelos. Así es como la detección de anomalías en datos categóricos se convierte en un control duradero en lugar de en una tarea de limpieza periódica.
Si necesita una detección de anomalías categóricas que encaje en pipelines empresariales reales, digna está diseñado para supervisar el comportamiento de los datos, detectar cambios de esquema y ejecutar comprobaciones en su propio entorno sin sacar los datos de él. Visite digna para ver cómo se aplica este enfoque a su almacén de datos, su data lake o su pila de pipelines, especialmente si se enfrenta a categorías dispersas, deriva y alertas de producción que deben llegar rápidamente al equipo adecuado.
Si prefiere no construir a mano el ciclo de línea base, puntuación y alertas descrito anteriormente, digna Data Anomalies ejecuta esa supervisión dentro de la base de datos, en su propio entorno.
Preguntas frecuentes
¿Qué es una anomalía categórica?
Una anomalía categórica es un nivel, o una combinación de niveles entre campos, que aparece con una frecuencia inusualmente baja respecto a la población de referencia. A diferencia de un valor atípico numérico, se trata de la frecuencia con la que una categoría aparece y coincide con otras, de modo que un país, un tipo de pago y una clase de dispositivo pueden ser poco frecuentes en conjunto aunque cada uno parezca normal.
¿Por qué no funciona la distancia euclidiana con los datos categóricos?
Las etiquetas, como los códigos de país o los estados de las reclamaciones, no tienen una geometría significativa, por lo que la distancia respecto a una media no dice nada sobre ellas. La codificación one-hot de campos de alta cardinalidad dispara la dimensionalidad y hace que las tablas de contingencia sean dispersas, mientras que las puntuaciones Z no pueden indicar si un código nuevo es inusual o simplemente nuevo.
¿Cómo detecto la deriva en una columna categórica?
Compare las frecuencias de categoría observadas con una línea base histórica mediante una prueba de chi cuadrado, o cuantifique el cambio con el índice de estabilidad de la población (Population Stability Index). Un PSI inferior a 0,1 indica una deriva mínima, entre 0,1 y 0,25 requiere investigación y cualquier valor superior a 0,25 es una deriva significativa que exige una acción inmediata.
¿Cómo debo tratar las variables categóricas de alta cardinalidad en la detección de anomalías?
Los embeddings categóricos asignan muchos niveles a representaciones densas que pueden utilizar los autoencoders o los isolation forests. Para la supervisión, mantenga dos líneas base por tabla: una huella estructural para las columnas añadidas, eliminadas o con cambio de tipo, y un perfil estadístico con la proporción de nulos, el número de valores distintos y un histograma top-k de categorías.
¿Qué debe incluir un flujo de supervisión de anomalías categóricas en producción?
Debe ingerir los datos, perfilar las distribuciones de categorías, puntuar las anomalías, dirigir las alertas a responsables designados y devolver los resultados de las revisiones a la línea base. Mantenga las líneas base locales para cada tabla y campo, y permita que cada revisión ajuste los umbrales o las categorías permitidas para que el mismo falso positivo no vuelva a aparecer.


