7 listas de palabras vacías (stop words) para búsqueda y NLP
|
7
minuto de lectura

Eliminar las palabras comunes no es una ventaja universal. Una palabra vacía puede ser ruido en un flujo de trabajo y una señal vital en otro, por lo que la configuración adecuada de listas de palabras vacías depende de lo que se intente mejorar: la relevancia de las búsquedas, las variables de NLP, el procesamiento nativo en la base de datos o el significado de los textos de un dominio. Los sistemas de recuperación históricos trataban las listas de palabras vacías como un atajo de indexación, no como una regla general, y los pipelines modernos siguen enfrentándose al mismo dilema, porque eliminar los términos comunes puede reducir los índices y acelerar el procesamiento, pero también perjudicar las búsquedas de frases y las consultas críticas para el negocio (historia de las palabras vacías y dilemas en la recuperación de información). La regla práctica es sencilla: mida la relevancia, la calidad del modelo y los resultados de calidad de datos posteriores antes y después del filtrado, y documente cada adición o exclusión personalizada.
En los textos en inglés, las palabras vacías suelen constituir una parte importante del lenguaje corriente, lo que convierte la decisión en una cuestión operativa, no estética. Las recomendaciones de NVIDIA resumen estudios que muestran que un texto típico en inglés contiene aproximadamente entre un 30 y un 40 % de palabras vacías, lo que significa que las decisiones de filtrado pueden cambiar de forma considerable el tamaño del índice, la velocidad de procesamiento y el comportamiento del modelo (recomendaciones de NVIDIA sobre palabras vacías). Por eso conviene leer los siete recursos siguientes en función de la tarea, no de la marca. Algunos están pensados para NLP general, otros para motores de búsqueda, otros para aprendizaje automático y otros para el tratamiento de texto nativo en la base de datos, donde los datos deben permanecer en su sitio.
Índice
1. Palabras vacías en inglés de NLTK
Úselo cuando el texto respalde un flujo de supervisión
2. Palabras vacías nativas de Snowflake
Mantenga el tratamiento de texto del almacén de datos cerca de los datos
3. Palabras vacías de Apache Lucene
Use Lucene cuando el comportamiento de búsqueda importe más que el NLP general
4. Palabras vacías predeterminadas de spaCy
Use spaCy cuando el significado dependa de la gramática y el contexto
5. Diccionarios personalizados de palabras vacías en PostgreSQL y BigQuery
Construya los diccionarios pensando en la auditoría y la reutilización
6. Listas de palabras vacías específicas del sector
Trate el vocabulario del dominio como parte del diseño de controles
7. Palabras vacías en inglés de scikit-learn
Úselo como punto de partida para las variables de texto
Comparativa de 7 listas de palabras vacías
Elija la lista que preserve el significado
1. Palabras vacías en inglés de NLTK
NLTK es un buen punto de partida cuando la tarea es NLP de uso general en Python. Su lista de palabras vacías en inglés se utiliza ampliamente en el preprocesamiento porque ofrece a los equipos una forma rápida de eliminar términos de relleno antes de la tokenización, el análisis de frecuencias o la clasificación de textos. Para los equipos de digna, esto la hace útil cuando las descripciones de reglas de negocio en lenguaje natural, las etiquetas de metadatos o las notas de incidentes necesitan una limpieza antes de la validación o del análisis de anomalías. No se trata de fiarse para siempre de la lista predeterminada, sino de obtener rápidamente una base legible.
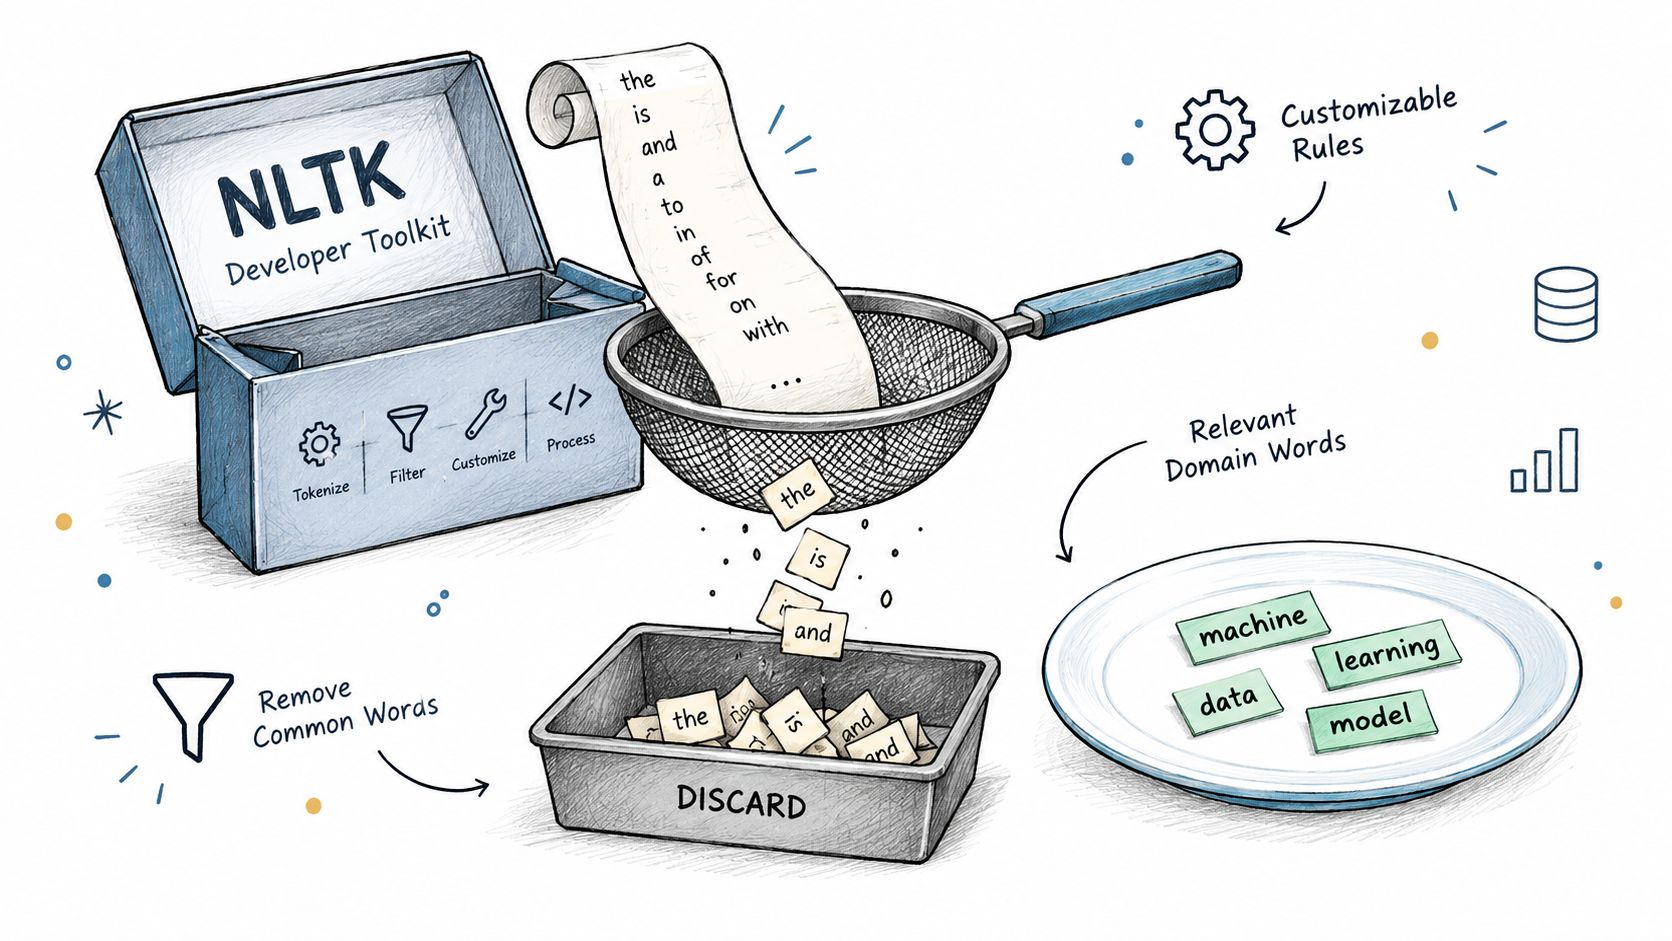
NLTK funciona mejor cuando se trata como un borrador de lista, no como una política definitiva. Si su equipo de calidad de datos ve términos como credit, patient o subscriber en textos de reglas recurrentes, esas palabras pueden tener más significado del que presupone una lista genérica en inglés. Una lista personalizada suele ser la opción más segura en servicios financieros, sanidad o telecomunicaciones, porque el lenguaje del dominio puede ser más importante que el relleno gramatical.
Úselo cuando el texto respalde un flujo de supervisión
Un uso práctico es filtrar las descripciones de reglas en lenguaje natural en las indicaciones de digna sobre limpieza de datos, donde el objetivo es separar la sintaxis de la señal antes del análisis. La misma lista puede ayudar a limpiar notas de linaje o resúmenes de incidentes antes de agruparlos o contarlos. También puede reducir el ruido en los campos de texto libre que los analistas utilizan para clasificar los problemas de datos.
Regla práctica: empiece con la lista predeterminada y añada o elimine términos solo después de probarla con su propio vocabulario de reglas de negocio.
Conserve los términos del dominio: mantenga las palabras que cambian de significado en su sector, aunque sean comunes en el inglés general.
Pruebe antes de implantar: compare el texto filtrado y sin filtrar con muestras reales de incidentes y reglas.
Documente cada cambio: anote cada adición personalizada para que la lógica de validación sea coherente entre los equipos.
2. Palabras vacías nativas de Snowflake
Snowflake entra en la conversación cuando el procesamiento de texto tiene que permanecer dentro del almacén de datos. El tratamiento nativo de palabras vacías encaja con el trabajo de datos en la nube porque evita sacar el texto a una pila de NLP externa solo para eliminar términos comunes. En las implantaciones de digna en Snowflake, esto se alinea con la ejecución dentro de la base de datos, ya que el texto permanece cerca de los registros, del linaje y de los metadatos del esquema que se inspeccionan.
Esto es importante en los flujos de observabilidad. Si una descripción del catálogo de datos o una nota de incidente se procesa donde ya reside, los equipos evitan orquestación adicional y simplifican la pista de auditoría. En la práctica, el caso de uso más sólido es filtrar los metadatos redactados por personas que acompañan a los esquemas, porque el contexto que los rodea suele importar tanto como la lista de tokens en bruto.
Snowflake también recuerda que las palabras vacías no son solo una cuestión de NLP. Pueden formar parte de la misma lógica del almacén de datos que da soporte a la búsqueda de texto, la clasificación de incidentes y la revisión de cambios de esquema. Cuando el mismo entorno alimenta tanto el almacenamiento como el análisis, una lista nativa de palabras vacías pasa a formar parte del modelo operativo en lugar de ser un paso de preprocesamiento oculto en un notebook.
Mantenga el tratamiento de texto del almacén de datos cerca de los datos
Para los equipos que supervisan los cambios en el catálogo, este diseño está en línea con las indicaciones de digna para Snowflake, especialmente cuando el panel debe mostrar qué ha cambiado sin exportar texto sensible. Una tabla de búsqueda personalizada suele ser el complemento adecuado cuando el texto del almacén de datos incluye términos de negocio que las listas predeterminadas eliminarían. Este enfoque también facilita el control de versiones entre entornos.
Utilice primero el filtrado nativo: mantenga la transformación dentro de Snowflake cuando los datos ya residan allí.
Complemente con términos de negocio: añada una capa específica del dominio para el vocabulario regulado o técnico.
Revise los cambios de versión: examine las actualizaciones de palabras vacías antes de que afecten a las reglas o búsquedas guardadas existentes.
3. Palabras vacías de Apache Lucene
Lucene es la opción más precisa cuando la tarea es la indexación para búsquedas. Su lista de palabras vacías en inglés es compacta y está ajustada para la recuperación de información, lo que la hace muy adecuada para la búsqueda en catálogos, la consulta de linaje y la recuperación de metadatos a gran escala. Este tipo de lista suele ser mejor cuando el objetivo es una búsqueda rápida y focalizada en lugar de un análisis lingüístico amplio.
El inconveniente es fácil de pasar por alto. Una lista más pequeña puede ser excelente para el rendimiento, pero la relevancia de las búsquedas depende de cómo consultan los usuarios sus datos. Un término que parece trivial en un corpus genérico puede ser importante en el nombre de una tabla, la descripción de un esquema o el título de un incidente. Si sus usuarios buscan frases exactas, eliminar los términos equivocados puede hacer que el sistema parezca menos preciso aunque el índice sea más pequeño.
Use Lucene cuando el comportamiento de búsqueda importe más que el NLP general
Lucene encaja en situaciones en las que muchas personas buscan en la misma superficie de metadatos, como un catálogo de datos con miles de tablas. En las implantaciones de digna, esto es especialmente relevante para la exploración de esquemas y linaje, donde la velocidad de búsqueda y la calidad de la clasificación forman parte de la experiencia de usuario. Cuanto más limpio sea el índice, más fácil será mostrar rápidamente el objeto correcto.
Lucene rinde mejor cuando las palabras vacías se tratan como una herramienta de ajuste de búsquedas, no como un paso genérico de limpieza.
Por eso las indicaciones de digna sobre búsquedas con comodines forman parte del mismo flujo de trabajo. La búsqueda con comodines y el filtrado de palabras vacías afectan a partes distintas de la recuperación, pero en la práctica interactúan cuando los usuarios escriben nombres parciales, frases mixtas o etiquetas de metadatos con ruido. Si la superficie de búsqueda es importante desde el punto de vista operativo, pruébela con registros de consultas reales antes de estandarizar la lista.
4. Palabras vacías predeterminadas de spaCy
spaCy encaja mejor cuando el pipeline necesita una cobertura lingüística más amplia y un procesamiento lingüístico más riguroso. Su conjunto predeterminado de palabras vacías en inglés es más amplio que las listas orientadas a búsquedas, y además ofrece recursos de palabras vacías para muchos idiomas. Esto es importante cuando el texto se analiza sintácticamente, se lematiza y se examina, no solo se tokeniza.
Para los usuarios de digna, la prueba práctica es si el lenguaje sigue transmitiendo señales de riesgo en las reglas de calidad de datos, los resúmenes de incidentes y las descripciones de esquemas. La explicación de una regla puede depender de la redacción, por ejemplo de si un campo es obligatorio solo en determinadas condiciones. En ese contexto, eliminar las palabras comunes de forma demasiado agresiva puede borrar la lógica que los analistas necesitan inspeccionar.
Use spaCy cuando el significado dependa de la gramática y el contexto
spaCy funciona bien para extraer conceptos clave de las descripciones de incidentes y detectar patrones recurrentes en el texto de las reglas. También es adecuado para equipos que necesitan un tratamiento coherente entre idiomas o una configuración centralizada para un marco de calidad de datos más amplio. En entornos regulados, esa coherencia puede importar tanto como la calidad bruta del modelo.
El mejor patrón es ampliar la lista predeterminada solo después de probarla con texto real. En finanzas, puede que términos como credit y debit deban conservarse. En sanidad, patient y drug pueden ser demasiado importantes para eliminarlos. En telecomunicaciones, subscriber puede ser una señal fundamental y no un relleno.
Buena práctica: utilice conjuntamente el pipeline lingüístico de spaCy y sus palabras vacías, y después decida si el vocabulario del dominio necesita una capa de exclusión independiente.
Este enfoque está en línea con las indicaciones de digna sobre datos históricos cuando el texto de las reglas de negocio debe seguir siendo interpretable para analistas y auditores.
5. Diccionarios personalizados de palabras vacías en PostgreSQL y BigQuery
Los diccionarios nativos de la base de datos son la opción adecuada cuando el procesamiento de texto tiene que permanecer dentro de la plataforma. La búsqueda de texto completo de PostgreSQL y las funciones de texto configurables de BigQuery permiten a los equipos situar las reglas de palabras vacías más cerca de los datos, lo que reduce el movimiento de datos y facilita la trazabilidad de la gobernanza. Para los equipos que ya trabajan con esos sistemas, esta ubicación suele determinar el diseño.
El compromiso es sencillo: el tratamiento de las palabras vacías pasa de ser una limpieza lingüística general a un control de la plataforma. Un equipo sanitario puede mantener los términos clínicos en un diccionario y eliminar el inglés genérico en otro. Un equipo de servicios financieros puede documentar cada cambio por motivos de cumplimiento normativo. El valor no está solo en el filtrado, sino en mantener la política de texto alineada con el entorno en el que se consulta el texto.
Construya los diccionarios pensando en la auditoría y la reutilización
En las implantaciones de digna, las listas nativas de la base de datos encajan bien con el modelo de ejecución dentro de la base de datos. También respaldan flujos de trabajo repetibles para las descripciones de cambios de esquema, el texto de las reglas de negocio y los metadatos del catálogo que, de otro modo, se copiarían en herramientas independientes. Esto los hace más fáciles de auditar y de mantener alineados entre entornos. Para flujos de trabajo específicos de BigQuery, la página de digna sobre calidad de datos en BigQuery es un punto de referencia útil, mientras que los equipos de PostgreSQL pueden utilizar la página de digna sobre calidad de datos en PostgreSQL para mantener el filtrado y la validación en el mismo flujo operativo.
Separe por dominio: utilice diccionarios distintos para el texto operativo, regulado y analítico.
Registre los cambios formalmente: versione las modificaciones de los diccionarios para que las revisiones y las reversiones sean sencillas.
Pruebe con texto representativo: valide con descripciones reales, no con ejemplos de juguete.
La principal ventaja es el control. Los equipos saben qué reglas están activas, dónde se ejecutan y cómo influyen en los resultados. Esto es importante porque eliminar la palabra equivocada puede dañar la relevancia de las búsquedas o difuminar el significado de negocio, sobre todo cuando el mismo término tiene un peso distinto en los flujos de base de datos, análisis y cumplimiento normativo.
6. Listas de palabras vacías específicas del sector
Las listas genéricas fallan antes en los sectores regulados. Una palabra que parece poco importante en el inglés corriente puede ser fundamental para los informes financieros, la seguridad del paciente o la supervisión de KPI de telecomunicaciones. Por eso las listas de palabras vacías específicas del sector no consisten tanto en eliminar más palabras como en preservar los términos que tienen significado de negocio.
Los servicios financieros suelen necesitar que términos como debit, credit, transaction y settlement sigan siendo visibles. Los equipos sanitarios a menudo necesitan que patient, diagnosis, treatment y medication sobrevivan al filtrado. Los equipos de telecomunicaciones pueden depender de palabras como subscriber, churn, revenue y arpu para una supervisión precisa. En cada caso, una lista de palabras vacías equivocada puede difuminar la señal que necesitan los operadores.
Trate el vocabulario del dominio como parte del diseño de controles
La gobernanza es importante en este punto. Los equipos de cumplimiento normativo deberían revisar la lista, porque la decisión de conservar o eliminar un término puede afectar a las pistas de auditoría, a la interpretación de los KPI y a la detección de anomalías. Si una regla de negocio o un umbral de supervisión depende de la terminología del dominio, esa palabra no debería eliminarse a la ligera del análisis.
Si una palabra común cambia la interpretación de una métrica regulada, no es una palabra vacía para su caso de uso.
Este principio encaja de forma natural con las indicaciones de digna sobre gobernanza financiera, ya que los equipos financieros a menudo necesitan un control estricto de la terminología, la validación y la posibilidad de revisión. La misma lógica se extiende a los datos sanitarios y del sector público, donde la trazabilidad puede importar tanto como la comodidad.
7. Palabras vacías en inglés de scikit-learn
scikit-learn pertenece a la capa de aprendizaje automático, no a la de búsqueda. Sus palabras vacías en inglés están diseñadas para la extracción de variables, lo que las convierte en una base razonable para la vectorización, la clasificación y las variables de texto relacionadas con anomalías. Si la tarea consiste en convertir notas de incidentes o descripciones de esquemas en variables, esta es la lista que encaja en el pipeline.
La gran ventaja es la compatibilidad. Las palabras vacías de scikit-learn se integran perfectamente en los flujos de ML con Python, sobre todo cuando los equipos crean variables TF-IDF u otras representaciones dispersas. Para los usuarios de digna, esto las hace útiles en el aprendizaje de líneas base, el análisis estadístico de patrones y la clasificación basada en modelos del texto que acompaña a los eventos de calidad de datos.
Úselo como punto de partida para las variables de texto
La clave es pensar como quien construye modelos, no como un ingeniero de búsqueda. Un pipeline de aprendizaje automático suele beneficiarse de la eliminación del relleno de alta frecuencia, pero el valor depende de si los términos restantes mejoran la predicción, la agrupación o la detección de la deriva. Si los términos son demasiado agresivos, el modelo puede perder distinciones útiles. Si son demasiado laxos, las variables siguen teniendo ruido.
Por eso la mejor práctica es empezar con la lista base y añadir términos del dominio solo después de comprobar el comportamiento del modelo con ejemplos reales de su entorno. Una nota de cambio de esquema en una empresa puede utilizar un lenguaje que es genérico en otra, y la lista debe reflejar esa diferencia.
Utilice primero una base: mantenga la lista predeterminada antes de introducir términos personalizados.
Alinéela con la vectorización: combínela con TF-IDF u otros métodos similares de extracción de variables.
Revise los resultados del modelo: compruebe si los términos eliminados cambiaron las predicciones, no solo el recuento de tokens.
Comparativa de 7 listas de palabras vacías
Elemento | Complejidad de implementación 🔄 | Requisitos de recursos ⚡ | Resultados esperados 📊 & calidad ⭐ | Casos de uso ideales 💡 | Ventajas principales ⭐ |
|---|---|---|---|---|---|
Palabras vacías en inglés de NLTK | Baja, lista sencilla; fácil de personalizar | Bajos, paquete de Python ligero | Impacto moderado; reduce el ruido pero requiere ajustes, ⭐⭐⭐ | Preprocesamiento de NLP general, limpieza de metadatos | Código abierto, ampliamente adoptada, fácil personalización |
Palabras vacías nativas de Snowflake | Baja, configuración nativa, configuración mínima | Mínimos, dentro de la base de datos, sin dependencias externas, alto rendimiento | Altos para el filtrado dentro del almacén de datos; rápido y favorable a la gobernanza, ⭐⭐⭐⭐ | digna en Snowflake; filtrado y tokenización de texto dentro de la base de datos | Sin movimiento de datos, rendimiento optimizado, mantiene los datos en su sitio |
Palabras vacías de Apache Lucene | Baja, se integra fácilmente en pilas de búsqueda | Bajos, lista pequeña, sobrecarga mínima | Altos para la relevancia de las búsquedas y la eficiencia de indexación, ⭐⭐⭐⭐ | Búsqueda de texto completo, optimización de índices a gran escala (ES/Solr) | Lista muy compacta, mejora la velocidad de búsqueda y reduce el tamaño del índice |
Palabras vacías predeterminadas de spaCy | Media, requiere instalar spaCy y sus modelos | Medios, Python + modelos de NLP; más capacidad de cálculo | Altos para tareas lingüísticas y filtrado basado en entidades, ⭐⭐⭐⭐ | NLP avanzado, análisis de la complejidad de reglas de negocio, análisis semántico | Seleccionada, integrada en el pipeline de NLP, personalizable en tiempo de ejecución |
Diccionarios personalizados de PostgreSQL & BigQuery | Media–alta, configuración específica de cada base de datos y permisos de administrador | Recursos dentro de la base de datos; requiere conocimientos de DBA | Altos para un procesamiento conforme y escalable dentro del almacén de datos, ⭐⭐⭐⭐ | Entornos regulados, diccionarios personalizados por tabla o esquema | Totalmente personalizable en la base de datos, sin dependencias externas, favorable a la auditoría |
Listas de palabras vacías específicas del sector (finanzas, sanidad, telecomunicaciones) | Alta, requiere conocimientos del dominio y mantenimiento continuo | Medios, equipos, posibles costes de proveedores o licencias | Precisión de dominio muy alta; reduce los falsos positivos, ⭐⭐⭐⭐⭐ | Detección de anomalías en sectores regulados, validación de reglas, supervisión de KPI | Preserva los términos críticos, mejora la precisión de la detección y el cumplimiento normativo |
Palabras vacías en inglés de scikit-learn | Media, integrada en pipelines de ML | Medios, pila de ML en Python (TF-IDF, modelos) | Altos para la extracción de variables de ML y la preparación de modelos, ⭐⭐⭐⭐ | Detección de anomalías basada en ML, ingeniería de variables, flujos de trabajo TF-IDF | Optimizada para ML, reproducible, funciona con las herramientas de scikit-learn |
Elija la lista que preserve el significado
La mejor elección de listas de palabras vacías depende de la tarea que tenga entre manos. Use Lucene cuando la prioridad sea una indexación de búsqueda focalizada. Use NLTK o spaCy para NLP general en Python, sobre todo cuando limpie metadatos, textos de incidentes o descripciones de reglas. Use scikit-learn cuando el texto alimente un modelo, no un cuadro de búsqueda. Use diccionarios nativos de la base de datos cuando el procesamiento deba permanecer en su sitio. Añada ampliaciones específicas del sector siempre que los términos de negocio aporten señal y las listas genéricas la borren.
El flujo de selección debe seguir siendo práctico. Pruebe la precisión, la exhaustividad, la relevancia de las búsquedas, el comportamiento del modelo y los resultados de calidad de datos posteriores antes de estandarizar nada. Después, versione la lista, revise los cambios y mantenga las palabras críticas del dominio fuera del conjunto de palabras vacías, a menos que haya demostrado que no importan en sus datos.
Esa disciplina es precisamente la razón por la que la gestión de palabras vacías forma parte de la misma conversación que la observabilidad y la validación. Si una palabra cambia la clasificación de las búsquedas, los resultados del modelo o la interpretación de los incidentes, pertenece a la gobernanza, no a una lista predeterminada. Mantenga la política cerca de las personas responsables de los datos y actualícela cuando cambie el vocabulario del negocio.
digna ayuda a los equipos a mantener esa disciplina dentro del mismo entorno en el que ya residen los datos. Sus módulos de calidad de datos, seguimiento de esquemas, supervisión de la puntualidad y detección de anomalías facilitan probar las reglas de texto con datos operativos reales en lugar de hacer conjeturas. Visite digna si desea conectar las decisiones sobre palabras vacías con la supervisión, la validación y la observabilidad dentro de la base de datos en una sola plataforma.
Si su filtrado de palabras vacías se ejecuta dentro del almacén de datos, como recomienda la sección anterior sobre Snowflake, la supervisión de la calidad de datos para Snowflake puede ejecutarse en el mismo lugar, de modo que las reglas de texto y las tablas que describen se comprueban sin exportar datos.
Preguntas frecuentes
¿Para qué sirve una lista de palabras vacías?
Una lista de palabras vacías indica a un motor de búsqueda o a un pipeline de NLP qué palabras comunes debe descartar antes de la indexación o el análisis. Un texto típico en inglés contiene entre un 30 y un 40 % de palabras vacías, por lo que la lista que elija puede cambiar de forma considerable el tamaño del índice, la velocidad de procesamiento y el comportamiento del modelo.
¿Qué lista de palabras vacías debo usar para la indexación de búsquedas?
Apache Lucene es la opción más adecuada cuando la tarea es la indexación de búsquedas. Su lista en inglés es compacta y está ajustada para la recuperación de información, lo que la hace idónea para la búsqueda en catálogos y la consulta de metadatos. Pruébela primero con registros de consultas reales, porque eliminar los términos equivocados puede perjudicar las búsquedas de frases exactas.
¿Cuál es la diferencia entre las palabras vacías de NLTK, spaCy y scikit-learn?
Cada biblioteca se orienta a una tarea distinta. NLTK es una base rápida para NLP general en Python, spaCy ofrece un conjunto predeterminado más amplio y muchos idiomas para pipelines que tienen en cuenta la gramática, y la lista de scikit-learn está diseñada para la extracción de variables, como la vectorización TF-IDF, cuando el texto alimenta un modelo y no un cuadro de búsqueda.
¿Debo eliminar como palabras vacías términos específicos del dominio como credit o patient?
Por lo general, no. Las listas genéricas pueden eliminar términos con significado de negocio, como debit, credit y settlement en finanzas, patient y diagnosis en sanidad, o subscriber, churn y ARPU en telecomunicaciones. Si una palabra común cambia la interpretación de una métrica regulada, para usted no es una palabra vacía.
¿Cómo personalizo una lista de palabras vacías de forma segura?
Empiece con una lista predeterminada y añada o elimine términos solo después de comparar el texto filtrado y sin filtrar con muestras reales. Mida la relevancia, la calidad del modelo y los resultados posteriores, documente cada cambio personalizado y versione los diccionarios, como los de PostgreSQL o BigQuery, para que las revisiones y las reversiones sigan siendo sencillas.


