Diseño e implementación de un dashboard de monitorización de KPI
|
6
minuto de lectura

La mayoría de los consejos sobre un dashboard de monitorización de KPI empiezan por el lugar equivocado. Los equipos se obsesionan con los estilos de gráfico, las paletas de colores y las cuadrículas de diseño, y luego se sorprenden cuando los stakeholders dejan de confiar en los números. En entornos empresariales, los dashboards no suelen fallar porque se vean mal, sino porque los datos que los alimentan cambian de forma, quedan desactualizados o se alejan de la definición de negocio que todos creían estar usando.
Un dashboard puede ser visualmente limpio y operativamente peligroso al mismo tiempo. Si un equipo de finanzas, un flujo de CRM y un modelo de marketing calculan el mismo KPI de forma distinta, el gráfico puede parecer impecable mientras la decisión que respalda ya está comprometida. Por eso una monitorización fiable empieza por la confianza, no por la decoración, y por eso los mejores dashboards se comportan menos como cuadros de mando y más como sistemas de control.
Índice de contenidos
Por qué fallan la mayoría de los dashboards de monitorización de KPI
Seleccionar métricas que impulsen acciones de negocio reales
Mantener la gobernanza de métricas y la integridad semántica
Por qué fallan la mayoría de los dashboards de monitorización de KPI
El modo de fallo más común es sencillo. Los equipos construyen un dashboard que parece completo y luego asumen que la presencia de gráficos significa que la métrica subyacente es estable. En realidad, un dashboard de monitorización de KPI suele volverse frágil en el momento en que cambian los datos de origen, se modifica una transformación o se reescribe una regla de negocio sin que nadie actualice la capa de definiciones.
Una vista atractiva puede ocultar problemas operativos profundos. Uno de los ejemplos más claros es la brecha entre lo que ven los usuarios y lo que realmente hace el pipeline de datos. Si el dashboard se alimenta de un ciclo de recarga nocturna con historial conservado, como en la guía pública de KPI del condado de Los Ángeles, ya está funcionando como un sistema operativo y no como un informe estático, porque el valor proviene de la continuidad, el historial y la actualización controlada, no solo de la presentación (guía de usuario de los dashboards de KPI del condado de Los Ángeles).
La deriva silenciosa es lo que rompe la confianza
La deriva silenciosa es peor que un gráfico roto porque no se anuncia. Un gráfico con datos faltantes parece sospechoso, pero un gráfico con una lógica ligeramente errónea suele parecer lo bastante normal como para pasar la revisión. Ese es el peligro en los entornos empresariales, sobre todo cuando distintos equipos calculan el mismo KPI a partir de sistemas de origen diferentes.
La confianza muere mucho antes de que el gráfico parezca roto.
La respuesta práctica es tratar el dashboard como un producto monitorizado, no como un artefacto estático. Eso significa vigilar a la vez las entradas, la definición y el patrón de uso. El uso importa porque el valor de un dashboard suele medirse por si los usuarios previstos lo abren durante un periodo determinado, y las guías de adopción suelen seguir los usuarios activos semanales, la tasa de retorno entre semanas, el volumen de exportaciones y el número de veces que se cita en revisiones de negocio (guía de adopción de dashboards).
Un dashboard al que nadie vuelve suele estar diciéndole algo. O los datos están desactualizados, o las definiciones son confusas, o el diseño oculta la señal tras demasiado ruido. Para una perspectiva práctica de calidad, una referencia interna útil es por qué los problemas de datos siguen generando conflictos y cómo mejorar la calidad de los datos, porque los conflictos sobre los datos suelen ser, en realidad, conflictos de confianza, propiedad o linaje.
Seleccionar métricas que impulsen acciones de negocio reales
Un dashboard lleno de métricas de vanidad es peor que una pantalla en blanco. Crea la ilusión de control mientras deja a los operadores sin nada que cambiar. Seleccione KPI que se correspondan con una consecuencia de negocio, un umbral y un responsable con nombre.
Empiece por la decisión, no por el gráfico. Pregúntese qué acción debería producirse si el KPI se mueve, quién debería tomarla y cuán grande debe ser el cambio para que merezca atención. Si esas tres respuestas no están claras, la métrica pertenece a un informe, no a un dashboard de monitorización.

Construya la métrica en torno a la decisión
Un KPI útil hace tres cosas. Refleja un resultado de negocio en lugar de actividad bruta. Tiene una zona de advertencia y una zona crítica. Y tiene además un responsable humano que puede actuar cuando la métrica cruza una línea.
Esa estructura coincide con las recomendaciones prácticas para la gestión por excepción, en la que cada KPI tiene un objetivo, un umbral de advertencia y un umbral crítico. También ayuda a limitar la vista principal a unos 5 a 10 KPI para que el dashboard no se convierta en un backlog visual (buenas prácticas de dashboards de KPI de Domo). No se trata de minimizar la información. Se trata de mantener la atención disponible para las anomalías que merecen una acción.
Regla práctica: si una métrica no desencadena una respuesta, no es un KPI de monitorización, es un valor de referencia.
Los OKR y los KPI cumplen funciones distintas. Un OKR describe una dirección o un objetivo. Un KPI comprueba si el sistema se comporta como se espera. La guía para líderes sobre OKR frente a KPI ayuda a los equipos a separar la aspiración del control operativo.
La propiedad importa tanto como la propia métrica. Las guías sobre dashboards de KPI en tiempo real recomiendan límites estáticos ligados al impacto en el negocio, además de un responsable, para que un descenso conduzca a una escalada y no a una observación pasiva (guía de dashboards de KPI en tiempo real). Si se supera un umbral y nadie sabe quién es responsable de la respuesta, el dashboard solo está documentando el fallo.
Para los equipos que desarrollan informes de calidad junto con la monitorización, el enfoque de digna para los informes de calidad de datos resulta útil porque prioriza la evidencia estructurada frente a la interpretación libre. Eso importa cuando el KPI afecta a auditorías, finanzas u operaciones reguladas.
Diseñar layouts para la gestión por excepción
Los mejores dashboards permanecen en silencio hasta que algo cambia. Las métricas estables deben quedar en segundo plano, y el diseño debe dirigir la atención hacia las pocas señales que requieren acción. Ese enfoque encaja con la forma de trabajar de los equipos de operaciones: sesiones cortas, bajo presión y con poca tolerancia al ruido.
La gestión por excepción funciona porque nadie puede revisar cincuenta indicadores y darles el mismo peso. El diseño tiene que jerarquizar las señales antes de que el usuario las vea. Unos umbrales claros, unas métricas estables atenuadas y un único estado de fallo evidente hacen ese trabajo por el lector.

Diseñe para la atención selectiva
Coloque en la vista principal solo los indicadores operativamente más importantes y lleve los diagnósticos de apoyo a niveles más profundos. Así evita que el dashboard se convierta en un muro de mosaicos del mismo peso en el que nada destaca.
La fatiga de alertas es el compromiso que hay que vigilar. Si cada métrica se trata como una emergencia, ninguna se escucha. Los umbrales de advertencia y de aviso urgente dan sentido a la señal cuando por fin salta una alerta, y el equipo responde con más cuidado porque la escalada es concreta.
Un buen diseño también hace visible la estabilidad. Cuando un KPI se mantiene dentro de su banda objetivo, esa información es útil, porque indica al equipo dónde no debe invertir tiempo. Las guías empresariales plantean lo mismo de otra forma, ya que las definiciones ocultas, las actualizaciones desfasadas y la falta de responsables son modos de fallo habituales en una vista principal saturada (buenas prácticas de dashboards de KPI de Domo).
Una estructura práctica separa la vista por urgencia.
Capa superior: los KPI que requieren revisión inmediata cuando cruzan un umbral.
Capa intermedia: contexto de tendencias y comparaciones de apoyo.
Capa inferior: drill-downs, linaje y diagnóstico.
Esa jerarquía funciona bien con los flujos internos de calidad, sobre todo cuando un equipo utiliza los dashboards de calidad de datos de digna como capa de diagnóstico bajo las métricas orientadas al negocio. El dashboard se convierte entonces en una vía hacia la investigación en lugar de un callejón sin salida.
Implementar alertas y controles de observabilidad de datos
Un KPI es tan fiable como el pipeline que lo alimenta. Por eso las alertas deben empezar por debajo de la capa de negocio, donde la frescura, el esquema, el volumen y las tasas de nulos pueden comprobarse antes de que los datos erróneos lleguen al dashboard de la dirección. Cuando esos controles están implantados, la plataforma de monitorización deja de ser un teatro reactivo y empieza a funcionar como un sistema de gestión de incidentes.
El patrón más sólido que he visto es una cadena de control que sigue a los datos a lo largo de cada etapa. Primero, enumere las etapas del pipeline. Después, defina los modos de fallo, como archivos que faltan, duplicados, schema drift o cargas desactualizadas. A continuación, codifique las comprobaciones como consultas ejecutables y conserve los resultados para que cada ejecución deje un registro histórico.
Convierta las comprobaciones en evidencia de incidentes
El historial de comprobaciones importa porque permite a los equipos ver líneas de tendencia, no solo fallos. Una alerta puntual le dice que algo se ha roto hoy. Un historial almacenado le dice si el problema es recurrente, si se está extendiendo o si se desplaza entre etapas. Es una base mucho más útil para la escalada.
La capa de observabilidad también debe corresponderse directamente con pilares de control conocidos. La observabilidad de datos suele organizarse en torno a la frescura, la distribución, el volumen, el esquema y el linaje, que se corresponden con las comprobaciones de puntualidad, la detección de anomalías, las comprobaciones de completitud, la detección de cambios estructurales y el seguimiento de la procedencia (pilares de la observabilidad de datos). En la práctica, esos pilares son más fáciles de gestionar cuando las comprobaciones son explícitas y están vinculadas a responsables.
Un buen conjunto de controles es concreto. Las guías sobre monitorización de la calidad de datos recomiendan comprobaciones de frescura, volumen de filas, schema drift, nulos en columnas obligatorias, unicidad de la clave primaria y valores o rangos aceptados, ejecutadas en la ingesta, después de la transformación y de nuevo en la tabla de servicio, con comprobaciones bloqueantes en cada ejecución y trabajos de conciliación diarios (buenas prácticas de calidad de datos). Esa es también la mentalidad adecuada para los sistemas de KPI, porque el dashboard nunca debería ser el primer lugar donde se hagan visibles los datos defectuosos.
Asigne cada hallazgo a un responsable con nombre. Si nadie rinde cuentas, la alerta se convierte en ruido.
La monitorización de esquemas merece un tratamiento aparte, porque los cambios estructurales pueden romper la lógica aguas abajo incluso cuando el número de filas parece correcto. La investigación sobre sistemas de observabilidad describe alertas que se disparan cuando cambian los metadatos de las tablas de origen, de modo que las estructuras añadidas, eliminadas o modificadas se detectan antes de que se rompan los supuestos de los informes (investigación sobre la monitorización de cambios de esquema). Ese control es especialmente importante en finanzas, sanidad, telecomunicaciones y sector público, donde el coste de un error silencioso en los informes es mucho mayor que el de una comprobación ruidosa.
Una referencia interna práctica para esta capa es la observabilidad de datos de digna, ya que esa categoría incluye puntualidad, validación, detección de anomalías y seguimiento de esquemas en una única vista operativa.
Adaptar las vistas a los distintos equipos de stakeholders
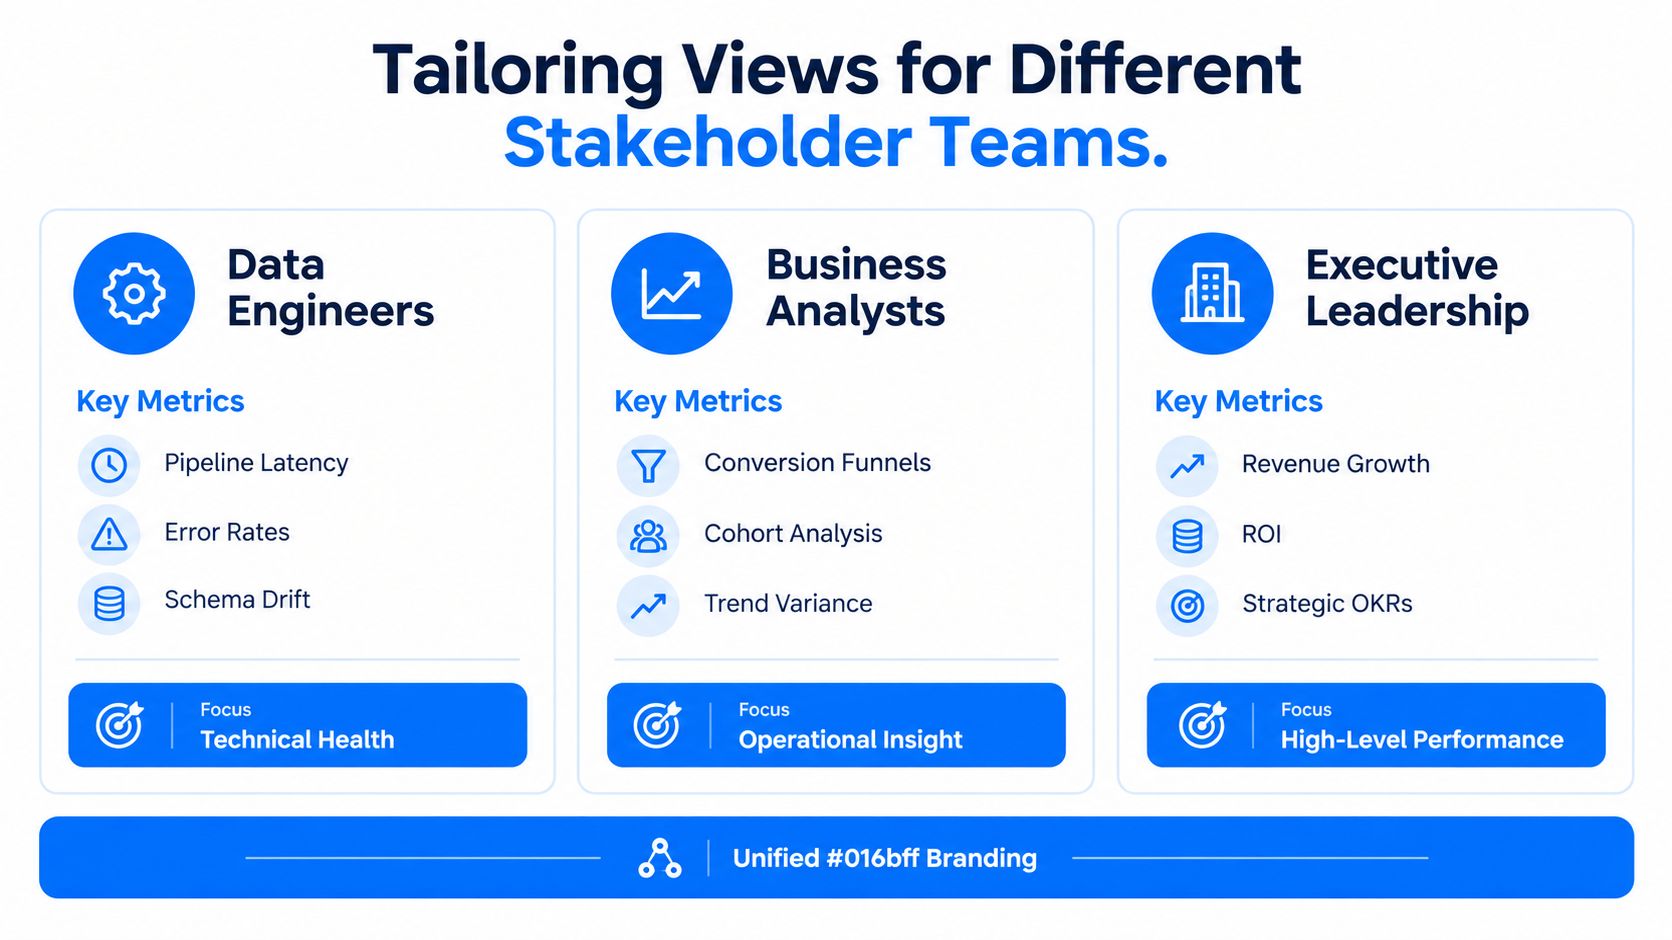
Un único dashboard rara vez sirve para todos los stakeholders. Los ingenieros de datos necesitan señales de fallo, los analistas necesitan contexto y los directivos necesitan una vista breve que respalde las decisiones sin obligarles a filtrar el ruido del pipeline. Si da a los tres grupos la misma pantalla, los usuarios técnicos se pierden los detalles que necesitan y los usuarios de negocio quedan sepultados bajo el desorden.
El mejor patrón es una única capa de métricas gobernada con vistas específicas por rol encima. Así las definiciones de KPI permanecen alineadas y cada equipo ve el nivel de detalle sobre el que puede actuar.
Ingeniero, analista, directivo
Los ingenieros de datos necesitan señales de salud técnica. Necesitan ver si las cargas llegan tarde, si los esquemas han cambiado, si fallan comprobaciones o si se ha roto un supuesto de linaje. Su vista debe exponer el pipeline, no solo el resultado de negocio. Si la métrica servida es errónea, necesitan un camino rápido de vuelta al origen.
Los analistas de negocio necesitan un contexto que puedan explicar. Las tendencias, las variaciones y los patrones operativos importan, pero no un muro de ruido de infraestructura. Necesitan suficiente detalle de linaje y definición para explicar por qué se ha movido el KPI, sin tener que reconstruir la métrica desde cero.
Los directivos necesitan una imagen compacta del rendimiento. Quieren un pequeño conjunto de indicadores que muestre si el negocio va por buen camino, se está desviando o está bajo presión. Si exportan el resumen a diapositivas y lo reconstruyen en otro lugar, la vista directiva no está sosteniendo la decisión.
El uso específico por rol es una señal mejor que el recuento genérico de tráfico. Si la vista de ingeniería se ignora durante los incidentes, si los analistas siguen exportando una métrica depurada a hojas de cálculo o si los directivos esquivan el dashboard en favor de un resumen aparte, la vista no se ajusta al trabajo que se supone que debe hacer.
Una forma útil de estructurar las vistas es sencilla.
Ingenieros: latencia del pipeline, schema drift, comprobaciones fallidas, roturas de linaje.
Analistas: variación de tendencias, patrones de cohortes, contexto de la métrica, explicación de excepciones.
Directivos: un resumen acotado de la salud del negocio, con un estado claro de los umbrales.
Una referencia práctica para construir este tipo de configuración basada en roles es la analítica self-service de digna. El self-service solo funciona cuando la capa gobernada que hay debajo es lo bastante fiable como para que distintos usuarios extraigan datos de ella sin recrear la métrica en su propia hoja de cálculo.
Mantener la gobernanza de métricas y la integridad semántica
El dashboard más peligroso es el que parece correcto mientras calcula algo equivocado. Eso ocurre cuando las definiciones de KPI derivan entre los sistemas de finanzas, marketing, CRM u operaciones, y nadie comprueba de forma continua si la misma etiqueta sigue significando el mismo cálculo. En ese punto, el gráfico no es una fuente de verdad, sino una fuente de confusión.
La gobernanza de métricas es la capa que falta en muchos programas de dashboards. Los equipos suelen dedicar todo su esfuerzo al diseño y a los umbrales, y dejan la capa semántica sin monitorizar. Eso crea un hueco en el que un KPI puede permanecer visualmente estable mientras cambia la lógica subyacente, que es exactamente como se cuelan el riesgo de auditoría y el riesgo en la toma de decisiones.
Gobierne la definición, no solo la visualización
Una estrategia de monitorización seria necesita una forma de detectar la deriva de las definiciones. Eso implica seguir las disputas sobre la fuente de verdad, los datos desactualizados, los cambios en transformaciones aguas arriba y los desajustes de lógica de negocio antes de que se propaguen por los informes. Esto es especialmente importante en entornos regulados, donde una lógica de KPI incoherente puede generar problemas de cumplimiento mucho antes de que una tendencia visual resulte sospechosa.
La medida práctica es tratar las definiciones de métricas como activos de producción. Versiónelas, documéntelas y vigile cuándo un consumidor aguas abajo deja de coincidir con el cálculo oficial. No es un problema de visualización, es un problema de integridad semántica.
Diversas guías independientes ya han advertido sobre métricas contradictorias, disputas sobre la fuente de verdad, datos desactualizados y falta de contexto operativo, lo que apunta a la misma conclusión: el problema de fondo es la gobernanza, no el marco del dashboard. Para las empresas, el riesgo es mayor porque distintos equipos pueden extraer el mismo KPI de sistemas diferentes y no darse cuenta de que discrepan hasta que una revisión de negocio o una auditoría lo pone de manifiesto. Una referencia interna útil sobre este tema es la capa semántica de dbt de digna, porque la capa semántica es donde las definiciones coherentes se mantienen unidas o se desmoronan.
El estándar práctico es sencillo.
Defina el KPI una sola vez.
Rastree dónde se reutiliza.
Genere una alerta cuando cambie su significado.
Documente el responsable que aprueba el cambio.
Cuando esa disciplina está implantada, el dashboard se vuelve lo bastante creíble para el uso operativo. Sin ella, incluso la interfaz más limpia no es más que una forma muy pulida de propagar ambigüedad.
Si quiere construir un dashboard de monitorización de KPI que detecte la deriva silenciosa, y no solo gráficos bonitos, trabaje con digna. Sus capacidades de calidad y observabilidad de datos ayudan a los equipos a monitorizar la frescura, la validación, los cambios de esquema y las métricas de negocio dentro de su propio entorno. Visite digna para ver cómo encaja en una plataforma de monitorización gobernada.
Cuando los KPI del dashboard son métricas de negocio como ingresos, pedidos o número de transacciones, la misma lógica de excepciones puede aplicarse a las propias métricas: la monitorización de negocio de digna aprende el patrón normal de cada métrica y señala un cambio antes de que llegue a la vista directiva.
Preguntas frecuentes
¿Cuántos KPI debe mostrar un dashboard de monitorización de KPI?
Limite la vista principal a entre 5 y 10 KPI aproximadamente. Cada uno debe tener un objetivo, un umbral de advertencia, un umbral crítico y un responsable designado. Las tendencias y los diagnósticos de apoyo van en capas más profundas, para que las pocas señales que exigen acción no queden enterradas entre mosaicos del mismo peso.
¿Por qué la gente deja de confiar en los dashboards de KPI?
Normalmente no es porque los gráficos se vean mal. La confianza se erosiona cuando los datos quedan desactualizados, los esquemas cambian aguas arriba o los equipos calculan el mismo KPI de forma distinta en los sistemas de finanzas, CRM y marketing. La deriva silenciosa es el verdadero peligro, porque un número ligeramente erróneo sigue pareciendo lo bastante normal como para pasar la revisión.
¿Qué es la gestión por excepción en el diseño de dashboards?
Es un enfoque de diseño en el que las métricas estables permanecen visualmente discretas y solo los KPI que cruzan un umbral captan la atención. Una capa superior contiene las métricas que requieren revisión inmediata, una capa intermedia aporta contexto de tendencia y una capa inferior ofrece drill-downs y linaje para el diagnóstico.
¿Qué comprobaciones de datos deben ejecutarse antes de que un KPI llegue al dashboard?
Compruebe la frescura, el volumen de filas, el schema drift, los nulos en columnas obligatorias, la unicidad de la clave primaria y los rangos de valores aceptados. Ejecútelas en la ingesta, después de la transformación y de nuevo en la tabla de servicio, y almacene cada resultado para que los problemas recurrentes o crecientes se hagan visibles con el tiempo.
¿Cómo se evita que la definición de un KPI derive entre equipos?
Trate las definiciones de métricas como activos de producción. Defina cada KPI una sola vez, versiónelo y documéntelo, rastree todos los lugares donde se reutiliza y genere una alerta cuando un cálculo aguas abajo deje de coincidir con el oficial. Un responsable designado debe aprobar cada cambio en la definición.


