Contar las líneas de un archivo: métodos rápidos para cualquier sistema operativo
|
5
minuto de lectura

Está mirando un archivo de log, una exportación CSV o una entrada de pipeline, y el recuento tiene un desfase de uno. El archivo parece correcto en su editor, pero el script dice otra cosa, y ese pequeño desajuste puede romper una carga, una comprobación de validación o un control de despliegue.
El motivo no suele ser una herramienta averiada, sino un problema de definición. Contar las líneas de un archivo parece sencillo hasta que los finales de línea, la ausencia de un salto de línea final, las convenciones de Windows y Unix y la elección de la codificación empiezan a cambiar lo que significa «una línea».
Índice
La trampa oculta en los recuentos de líneas sencillos
Un patrón de fallo habitual aparece cuando un pipeline de datos espera un recuento de registros limpio y llega un archivo sin salto de línea final. El editor muestra una última fila, pero el recuento de la línea de comandos no coincide. Esa diferencia basta para disparar una falsa alarma en un trabajo de importación o hacer que una comprobación de actualidad parezca errónea.
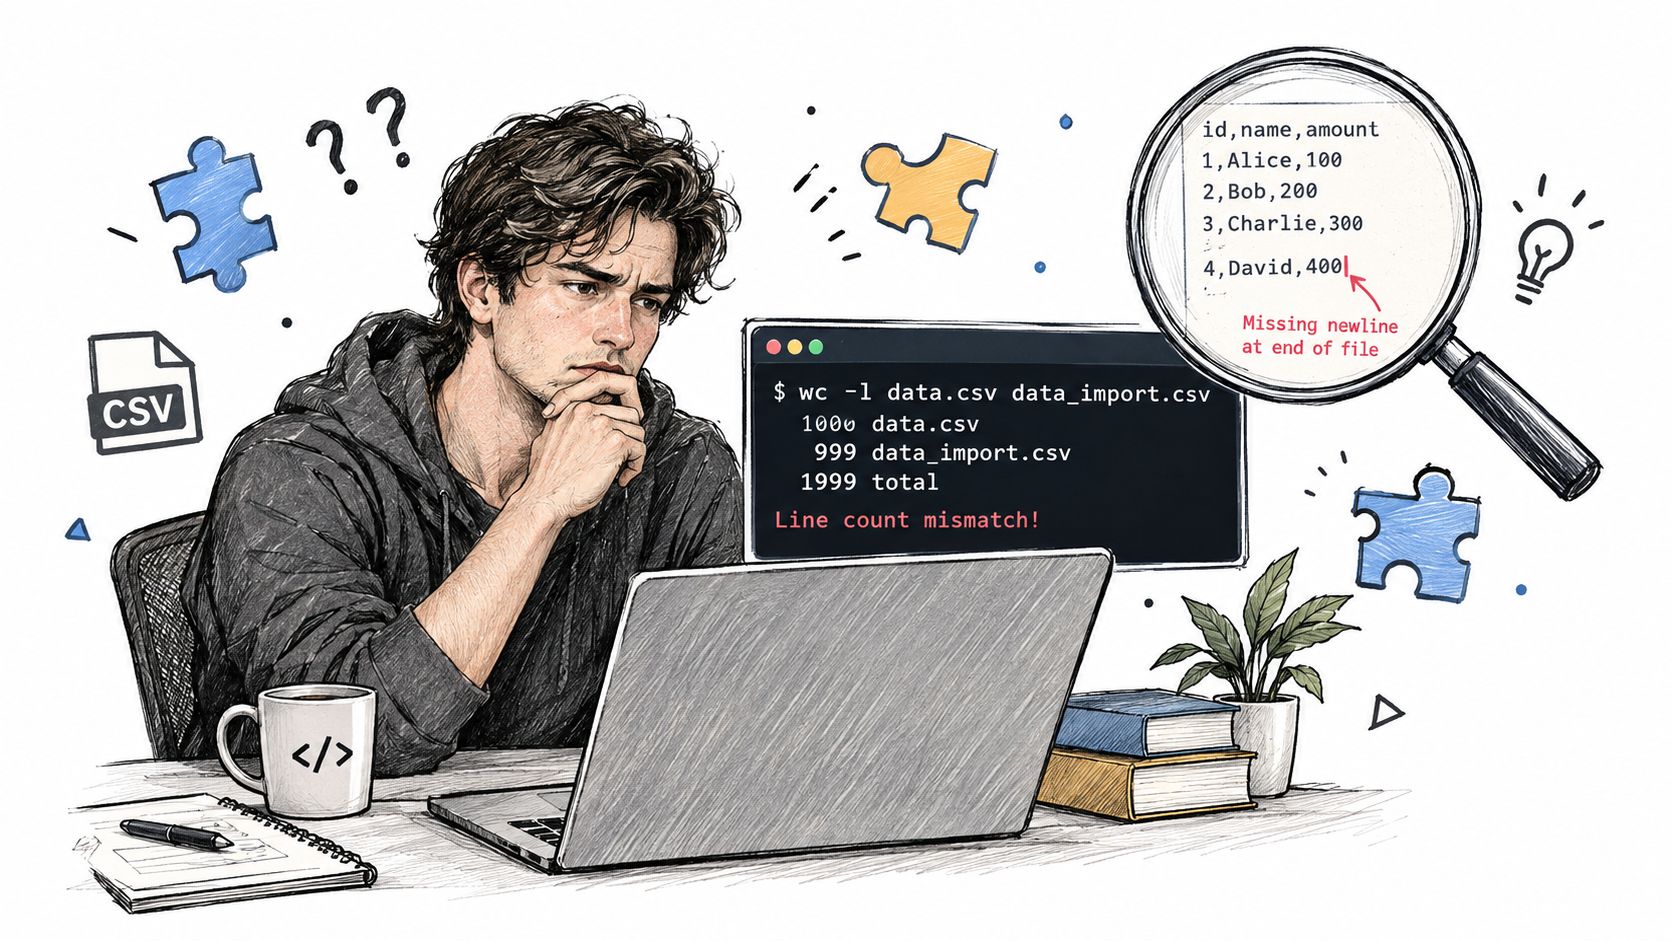
El problema de fondo es que las herramientas suelen contar caracteres de salto de línea, no lo que las personas consideran filas visuales. GNU wc -l se comporta así y no cuenta una línea parcial final si el archivo termina sin salto de línea, por lo que un archivo de una sola línea puede indicar 0 líneas en ese caso límite (manual de wc de GNU). Esa misma división semántica explica por qué la pregunta no es solo «qué comando es el más rápido», sino «qué debe significar el recuento».
Regla práctica: si el recuento alimenta una automatización, decida de antemano si le importan los saltos de línea físicos o los registros lógicos.
Esa distinción importa en archivos generados, logs y feeds que no se editan a mano. Un parser puede considerar que la última fila existe aunque falte un salto de línea, mientras que un contador del shell puede no hacerlo. En el trabajo de calidad de datos, ese desajuste forma parte de la misma conversación que las reglas de validación y la completitud de los registros, y por eso una comprobación estructurada como el enfoque de digna para la validación de datos y la calidad continua es un mejor modelo mental que «simplemente contar las filas».
Contar líneas en Linux y macOS
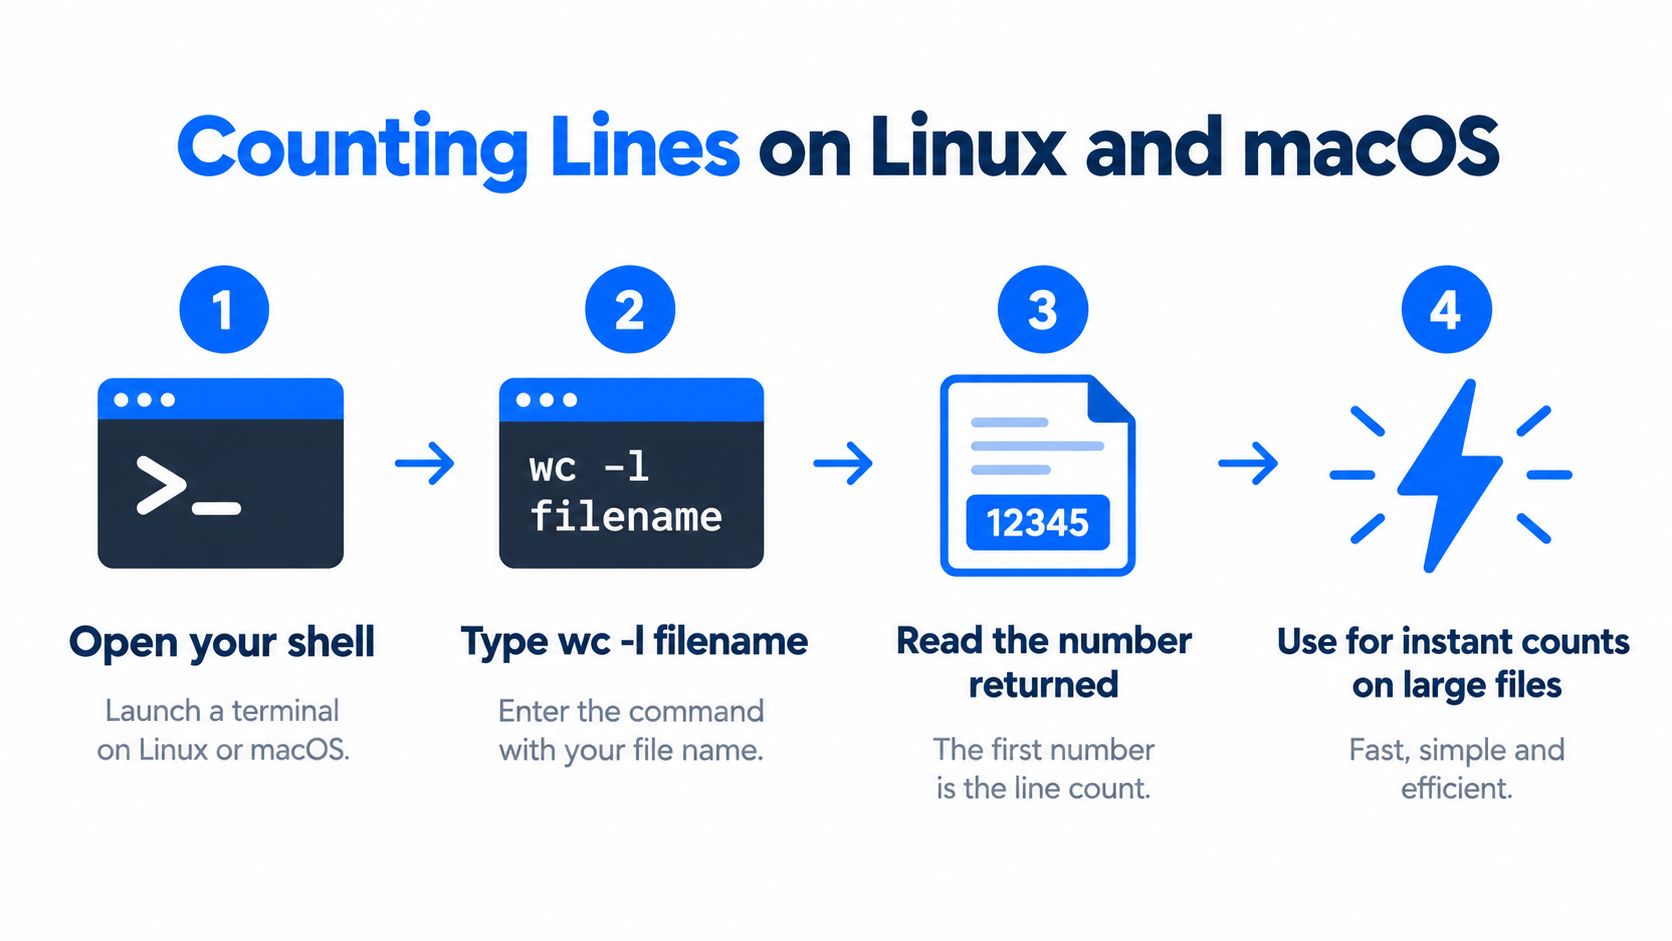
En Linux y macOS, empiece con wc -l. El comando forma parte del procesamiento de texto de Unix desde hace mucho tiempo y sigue siendo la opción más rápida para recuentos de líneas simples, porque es sencillo, nativo del shell y fácil de usar en scripts.
Los comandos que debe ejecutar
Utilice esta forma cuando quiera el nombre del archivo en la salida:
wc -l filename
Utilice esta otra cuando solo quiera el número:
wc -l < filename
La segunda forma es más limpia para scripts porque omite el nombre del archivo y devuelve solo el recuento. Las páginas de manual actuales definen wc como un comando que imprime recuentos de saltos de línea, palabras, bytes y caracteres, y la herramienta también ofrece totales cuando se le pasan varios archivos. Los ejemplos de procesamiento de texto de Red Hat muestran el mismo estilo de recuento directo en el shell, incluido grep -c '.' /usr/share/dict/words, que devuelve 479.826 líneas coincidentes (ejemplos de procesamiento de texto de Red Hat).
Cuando la velocidad importa
Para recuentos totales simples, wc -l suele ser la respuesta correcta porque recorre directamente los flujos de bytes. En una prueba de rendimiento con un archivo sintético de 110 MB / 10.000.000 de líneas, wc -l < big.txt terminó en 0,13 s frente a 0,33 s de awk 'END{print NR}' big.txt, por lo que AWK fue unas 2,5 veces más lento en esa prueba (detalles de la prueba). Utilice awk cuando necesite filtrado o lógica por archivo. Quédese con wc -l cuando solo necesite el recuento.
Hábito operativo: utilice primero
wc -ly cambie a AWK solo cuando el recuento forme parte de una transformación más amplia.
En los trabajos de ingesta de archivos, mantenga el recuento junto a las comprobaciones de la zona de aterrizaje y la validación de registros, sobre todo si los datos pasan por el pipeline de ingesta de datos de digna. Se trata de eliminar la ambigüedad antes de que el archivo avance hacia los sistemas posteriores.
Contar líneas en Windows y PowerShell
Windows ofrece dos vías prácticas: PowerShell y CMD. PowerShell es la más limpia para contar líneas porque trabaja con el contenido de los archivos como objetos, mientras que CMD sigue dependiendo de trucos de texto antiguos que funcionan pero son difíciles de automatizar.
Primero, PowerShell
El recuento básico es:
(Get-Content "file.txt").Count
Para obtener una salida apta para pipelines, utilice:
(Get-Content "file.txt" | Measure-Object -Line).Lines
La documentación de PowerShell indica que Get-Content devuelve por defecto el contenido del archivo como una matriz de cadenas delimitadas por saltos de línea, mientras que -Raw devuelve el archivo completo como una sola cadena conservando los saltos de línea; si el delimitador no existe, Get-Content puede devolver el archivo completo como un único objeto sin delimitar (documentación de Get-Content de PowerShell, documentación de PowerShell 5.1). Esto importa porque el recuento puede cambiar según PowerShell trate el archivo como una colección de líneas o como un único bloque de texto.
CMD cuando no hay otra opción
CMD no tiene un equivalente directo de wc -l. La solución habitual es:
find /c /v "" file.txt
La salida incluye el nombre del archivo y cierto formato, así que sirve para comprobaciones rápidas pero resulta incómoda en scripts. Si necesita el recuento en una automatización, envuélvalo en un bucle for /f, aunque PowerShell sigue siendo la mejor opción.
Regla general: utilice PowerShell para los scripts y recurra a CMD solo cuando la máquina esté bloqueada y no haya nada más disponible.
Si está creando automatizaciones en Windows y necesita una comprobación de calidad básica antes de una validación más profunda, el recuento de líneas suele ser la primera prueba de bajo coste. Una plataforma como digna puede encajar ahí como una opción de observabilidad a nivel de conjunto de datos, porque sigue la evolución del número de filas a lo largo del tiempo en lugar de tratar cada archivo como un caso aislado.
Contar líneas con Python en archivos grandes
Python es una buena opción cuando el archivo es grande, la plataforma varía o el recuento de líneas forma parte de un trabajo más amplio. La trampa es cargar todo el archivo en memoria cuando solo necesita un recuento.
Utilice lecturas binarias con búfer
Abra el archivo en modo binario, léalo en bloques de 64 KiB o más, cuente los bytes \n y añada una línea más solo cuando el archivo no esté vacío y no termine en \n. Así se evita la E/S carácter a carácter, que es lenta en cualquier lenguaje. Una prueba de rendimiento en C mostró que fgetc/fputc tardaba 5,90 s en una pasada de 150 MB, mientras que fread/fwrite por bloques de 65.536 bytes tardaba 0,63 s (notas de la prueba en C), que es el mismo cuello de botella que evita el bucle de Python al leer bloques de 64 KiB.
Por qué gana el enfoque por bloques
El recorrido binario es portable, pero la semántica sigue importando. El recuento de saltos de línea mide los saltos de línea físicos, por lo que los \r\n de Windows, la ausencia de saltos de línea finales y los saltos de línea incrustados dentro de los registros pueden cambiar el resultado si espera filas lógicas en lugar de líneas de texto en bruto. El modo binario de Python y bytes.count mantienen ese comportamiento explícito, y la regla del salto de línea es la misma que se trata en la guía de File::CountLines.
En las comprobaciones de pipelines, las estadísticas estructuradas de filas suelen ser más útiles que los recuentos puntuales. Una herramienta que supervisa la evolución del número de filas a lo largo del tiempo, como el enfoque de observabilidad de digna basado en la detección de anomalías, resulta adecuada cuando importa más detectar una carga incompleta que el comando exacto utilizado para hacerlo.
Casos límite y trampas semánticas
El recuento a nivel de bytes no es universal. Las codificaciones no compatibles con ASCII, como UTF-16 o UTF-32, pueden hacer fallar un recuento de líneas ingenuo, y las convenciones de salto de línea difieren entre Unix y Windows. Un archivo también puede contener registros que parecen completos en un editor pero que se comportan de otra forma cuando una herramienta lee los bytes en bruto.
GNU grep -c cuenta las líneas coincidentes, y su comportamiento orientado a líneas puede variar cuando el último byte no es un salto de línea (manual de GNU grep). Esto importa en los pipelines donde el recuento forma parte de la validación y no es solo una comprobación rápida.
La codificación lo cambia todo
Los enfoques carácter a carácter no son adecuados para archivos grandes. El problema práctico no es solo la velocidad, sino la interpretación. UTF-16 y UTF-32 almacenan el texto de formas que hacen poco fiables los recorridos simples de bytes, por lo que una herramienta que solo presupone saltos de línea de tipo ASCII puede devolver una respuesta errónea.
Python le da más control en este caso, pero el enfoque más seguro sigue dependiendo del formato del archivo y de cómo se generó. En el almacenamiento estructurado, el número de filas puede formar parte del propio formato y no de la capa de texto, y por eso los pipelines basados en Parquet necesitan comprobaciones distintas de las de los archivos de texto plano.
Las convenciones de salto de línea no son intercambiables
Unix utiliza \n, Windows suele utilizar \r\n, y el mismo archivo puede tratarse de forma distinta según la herramienta. Get-Content de PowerShell devuelve por defecto el texto delimitado por saltos de línea como cadenas, mientras que -Raw mantiene el archivo como una sola cadena, de modo que la forma de la salida cambia el método de recuento (documentación de Get-Content de PowerShell).
Si está comprobando archivos generados, esa diferencia importa más que el nombre del comando. Un recuento correcto para el texto en bruto puede ser incorrecto para los registros lógicos.
Esa es la trampa. Contar las líneas de un archivo solo es sencillo cuando la codificación, la convención de salto de línea y el modelo de registros coinciden.
Elegir el método adecuado para sus necesidades
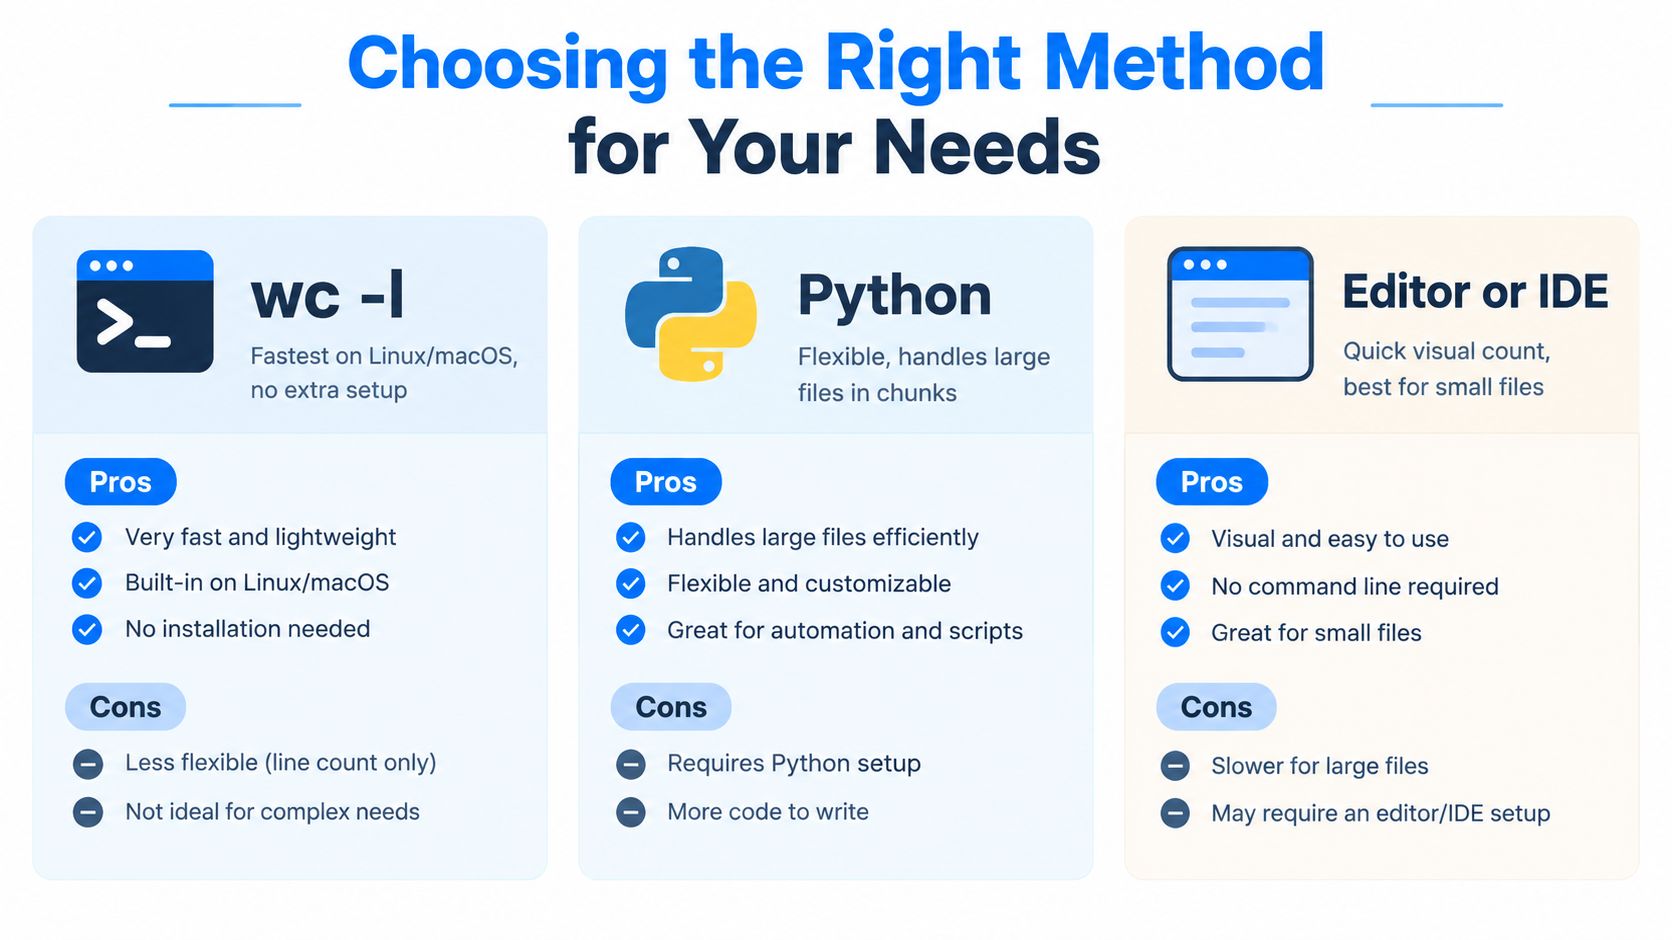
El mejor método es el que se ajusta a la plataforma, al tamaño del archivo y al significado del recuento. En Linux y macOS, wc -l es la opción predeterminada para un total en bruto. En Windows, PowerShell es la opción nativa del shell más limpia y, para trabajos programáticos, Python le da control sobre el búfer y el tratamiento de los casos límite.
Criterios de decisión rápidos
Utilice
wc -lcuando esté en Linux o macOS y necesite el recuento simple más rápido sin lógica adicional.Utilice PowerShell cuando esté en Windows y quiera un resultado que pueda canalizar al resto de un script.
Utilice Python cuando el archivo sea grande, la codificación sea incierta o el recuento requiera un tratamiento personalizado.
Utilice un editor o un IDE cuando el archivo sea pequeño y solo necesite una comprobación visual.
La diferencia práctica es sencilla. wc -l es el contador en bruto más rápido, PowerShell es la opción de shell más natural en Windows y Python es la vía de escape más segura cuando la semántica importa más que la comodidad. Para los flujos de trabajo en equipo, una capa de observabilidad de datos como la plataforma de monitorización modular de digna puede situarse por encima de estas comprobaciones puntuales y reunir en un solo lugar el número de filas, las anomalías y el comportamiento de llegada de archivos.
Si está cansado de perseguir a posteriori los problemas de desfase de uno en los archivos, utilice digna para supervisar los datos que hay detrás de esos recuentos y detectar cargas vacías o incompletas antes de que lleguen a los sistemas posteriores. Visite digna para ver cómo encajan sus comprobaciones de validación, detección de anomalías y puntualidad en un pipeline de datos en producción.
Cuando un recuento de líneas es en realidad un indicador de cuántos registros han llegado, digna Data Anomalies sigue la evolución del número de filas en la base de datos a lo largo del tiempo y señala las cargas vacías o incompletas que un wc -l puntual nunca compararía con el historial.
Preguntas frecuentes
¿Cómo cuento las líneas de un archivo en Linux o macOS?
Utilice wc -l filename para imprimir el recuento junto con el nombre del archivo, o wc -l < filename para devolver solo el número en scripts. En una prueba de rendimiento con un archivo de 10.000.000 de líneas, wc -l terminó en 0,13 s frente a 0,33 s de awk, así que reserve awk para la lógica de filtrado.
¿Por qué wc -l muestra una línea menos que mi editor?
Porque wc -l cuenta caracteres de salto de línea, no filas visuales. Si un archivo termina sin salto de línea final, la última línea parcial no se cuenta, por lo que un archivo de una sola línea puede llegar a indicar 0 líneas. Decida de antemano si la automatización necesita saltos de línea físicos o registros lógicos.
¿Cómo cuento las líneas de un archivo con PowerShell?
Ejecute (Get-Content "file.txt").Count para un recuento básico, o (Get-Content "file.txt" | Measure-Object -Line).Lines para obtener una salida apta para pipelines. Get-Content devuelve por defecto cadenas delimitadas por saltos de línea, mientras que -Raw devuelve una sola cadena, por lo que la forma elegida cambia cómo ve PowerShell las líneas del archivo.
¿Cuál es el equivalente de wc -l en CMD de Windows?
CMD no tiene un equivalente directo de wc -l, y la solución habitual es find /c /v "" file.txt. Su salida incluye el nombre del archivo y formato adicional, por lo que sirve para comprobaciones rápidas pero es difícil de automatizar si no se envuelve en un bucle for /f. PowerShell es la mejor opción para scripts.
¿Cuál es la forma más rápida de contar las líneas de un archivo grande con Python?
Abra el archivo en modo binario, léalo en bloques de 64 KiB y cuente los bytes de salto de línea, sumando uno solo cuando el archivo no esté vacío y carezca de salto de línea final. Las lecturas por bloques evitan la lenta E/S carácter a carácter: una prueba de rendimiento en C tardó 0,63 s por bloques frente a 5,90 s carácter a carácter.


