Qué significa federado en datos e IA
|
5
minuto de lectura

Federado significa que los datos permanecen en su origen mientras modelos, políticas o consultas compartidos operan sobre sistemas independientes. En informática y en el trabajo con datos, esta idea apareció pronto en las bases de datos federadas y, más tarde, en el aprendizaje federado, donde el hilo conductor sigue siendo el mismo: control local con acceso coordinado.
Lo que confunde a muchos es que «federado» parece sencillo, pero se usa en el ámbito gubernamental, la identidad, las bases de datos, la gobernanza y la IA para referirse a cosas relacionadas con compromisos muy distintos. Por eso importa más una definición práctica que un eslogan.
Índice
El verdadero significado de los sistemas federados
Federado significa que partes independientes colaboran sin ceder la propiedad a un único lugar central. En tecnología, esto suele implicar que una organización mantiene los datos, la identidad o el procesamiento cerca del origen y luego conecta esas partes mediante reglas, estándares o capas de coordinación compartidos. El término se utiliza en las bases de datos federadas desde finales de los años setenta y los ochenta, y a finales de los ochenta y principios de los noventa ya se entendía como una forma de integrar sistemas autónomos en una única vista lógica preservando el control local graphapp.ai.
Una analogía útil es una red de bancos locales. Cada sucursal gestiona sus propias cuentas, pero todas acuerdan estándares de compensación para que los clientes puedan mover dinero entre entidades sin que cada banco se fusione en un único libro mayor gigante. La federación funciona igual en datos e IA: primero la autonomía local y después las reglas compartidas.
Regla práctica: si el sistema de origen sigue siendo propietario de los datos o de la decisión, y otra capa solo coordina el acceso o la agregación, probablemente se trata de un diseño federado.
Cuatro ámbitos, una palabra confusa
El problema es que la palabra abarca contextos muy diferentes. El uso de diccionario incluye la federación política, la federación de identidades y la computación o búsqueda federada, mientras que la federación de identidades significa específicamente vincular la identidad de un usuario entre sistemas separados mediante atributos y reglas de inicio de sesión acordados Merriam-Webster. Por eso una conversación sobre gobierno federado, inicio de sesión federado y analítica federada puede dar la impresión de que cada persona habla de algo distinto.
En la práctica, el ancla útil es esta: los sistemas federados se coordinan entre partes independientes sin centralizarlas por completo. Esa definición encaja con las bases de datos federadas, el aprendizaje federado y la gobernanza federada, aunque cada uno aplique el patrón de forma distinta. También explica por qué los detalles de implementación importan más que la etiqueta.
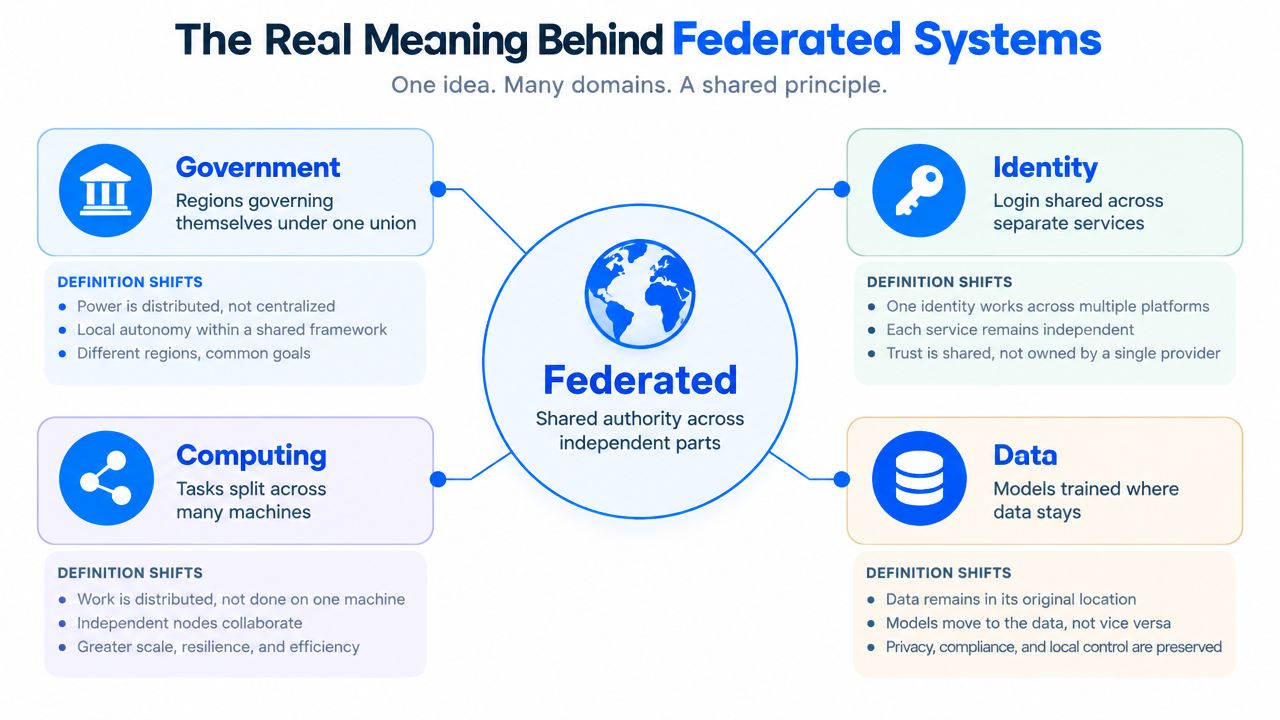
Para los equipos que construyen plataformas de datos modernas, la relación entre la federación y la elección de arquitectura se aclara al compararla con otros enfoques. Una buena introducción a los compromisos de diseño relacionados es entender el data mesh en las arquitecturas modernas, porque ambos patrones se preocupan por la autonomía, la gobernanza y los estándares compartidos.
Arquitecturas de datos centralizadas frente a federadas
La arquitectura de datos centralizada lleva los datos a un data warehouse o data lake común y espera que los pipelines, el modelado y la gobernanza se realicen allí. La arquitectura federada mantiene los datos donde ya residen y utiliza un servidor federado o una capa de acceso para coordinar consultas y respuestas entre las fuentes. La descripción de IBM de los sistemas federados es clara en cuanto a la mecánica: un servidor federado, una o varias fuentes de datos y aplicaciones cliente cooperan para que una sola sentencia SQL pueda acceder a datos repartidos entre múltiples fuentes IBM.
La diferencia no es solo técnica: cambia quién controla qué. En un esquema centralizado, el equipo de plataforma suele convertirse en el cuello de botella de la integración, los estándares y el acceso. En un modelo federado, los equipos de dominio conservan la propiedad, mientras que la empresa define las reglas de interoperabilidad, las expectativas de metadatos y los límites de seguridad. Ese cambio explica por qué las arquitecturas federadas aparecen en entornos regulados y con múltiples dominios.
Conclusión operativa: los diseños centralizados optimizan el control y la consolidación, mientras que los federados optimizan la autonomía y la coordinación controlada.
Comparativa entre arquitectura federada y centralizada
Dimensión | Centralizada | Federada |
|---|---|---|
Ubicación de los datos | Se trasladan a un data warehouse o data lake compartido | Se mantienen en los sistemas de origen |
Propiedad | Equipo de plataforma o equipo central de datos | Equipo de dominio o de origen |
Coordinación del acceso | Acceso directo al almacén central | Consultas enrutadas a través de una capa de coordinación |
Estilo de integración | Consolidar primero, usar después | Acceso in situ, agregación bajo demanda |
Gobernanza | Aplicación centralizada | Estándares compartidos con ejecución local |
El enfoque federado surgió porque las grandes organizaciones chocaron con los límites de un modelo basado en un único pipeline gigante. A medida que se acumulan equipos, sistemas y restricciones de cumplimiento, una única zona de aterrizaje puede resultar cara de mantener y difícil de alinear con los requisitos de residencia de datos. Eso no significa que la centralización sea un error, sino que el equilibrio cambia cuando un solo equipo no puede, de forma realista, ser responsable de cada conjunto de datos y de cada política.
Si evalúa la diferencia desde el punto de vista de la calidad de datos, la distinción también se refleja en los controles operativos. Esta comparativa de los compromisos de calidad entre plataformas de datos federadas y centralizadas resulta útil cuando la pregunta no es tanto «¿cuál parece más limpia?» como «¿qué estructura podemos gobernar?»
Cómo funciona el aprendizaje federado sin mover datos
El aprendizaje federado es el uso moderno de federado con el que la mayoría de los equipos de analítica se encuentra primero. Entrena modelos en dispositivos remotos o centros de datos aislados manteniendo los datos localizados, y utiliza un servidor central para coordinar rondas de entrenamiento repetidas y agregar las actualizaciones del modelo procedentes de participantes distribuidos revisión en arXiv. Los registros en bruto permanecen en el teléfono, el sistema hospitalario o la instalación. Lo que se mueve es la señal de actualización, no el conjunto de datos.
Este flujo de trabajo es importante porque cambia la forma de las conversaciones sobre privacidad y cumplimiento. En lugar de copiar datos sensibles en un único entorno de construcción de modelos, cada participante aprende localmente y aporta solo lo necesario para la agregación. Por eso el aprendizaje federado se plantea a menudo para teléfonos, hospitales y otros entornos en los que el movimiento de datos está estrictamente controlado.
La secuencia práctica
El entrenamiento local comienza en cada cliente con los datos que ya están allí.
Las actualizaciones del modelo se envían a un coordinador, no el conjunto de datos en bruto.
La agregación se realiza de forma centralizada y produce un modelo global refinado.
El modelo actualizado vuelve para otra ronda local.
Este patrón reduce los movimientos innecesarios, pero no simplifica el proceso. Los distintos dispositivos pueden tener diferente capacidad de cómputo, fiabilidad de red o calidad de datos. La sobrecarga de coordinación pasa a formar parte del diseño, y los calendarios de entrenamiento importan más que en un pipeline de ML centralizado tradicional.
Regla general: el aprendizaje federado es, ante todo, un modelo de coordinación y, en segundo lugar, una funcionalidad de privacidad.
El aspecto operativo cobra aún más importancia cuando los equipos intentan supervisar la deriva o el comportamiento del modelo entre muchos participantes. Si sigue la estabilidad de un modelo en un entorno distribuido, las prácticas de detección de deriva de modelos ayudan a delimitar qué cambios se pueden observar sin fingir que el sistema es estático.
Modelos de gobernanza federada para datos empresariales
La gobernanza federada es la versión organizativa de la misma idea. Un órgano central establece políticas, estándares y controles compartidos para toda la organización, mientras que las unidades de negocio aplican esas reglas dentro de sus propios dominios Atlan. Este reparto es útil cuando la empresa necesita coherencia, pero los dominios siguen necesitando margen para gestionar sus propios pipelines, definir reglas de datos locales y gestionar excepciones específicas del dominio.
La distinción clave es la autoridad. La gobernanza federada no significa que todas las decisiones estén descentralizadas, ni tampoco que los equipos centrales controlen al detalle cada conjunto de datos. Significa que el centro define las barreras de protección y los dominios operan dentro de ellas. En la práctica, esto suele incluir metadatos compartidos, controles de seguridad y estándares de calidad, además de una responsabilidad clara sobre su aplicación.
Dónde funciona el modelo y dónde se resiente
La gobernanza federada suele encajar en organizaciones con varias unidades de negocio, datos regulados o líneas de propiedad complejas. También es más adecuada cuando los equipos locales conocen los datos mejor de lo que jamás podría conocerlos un grupo central de plataforma. El coste es la sobrecarga de coordinación, porque las políticas deben interpretarse de forma coherente entre dominios, no solo redactarse una vez.
Deja de funcionar cuando la capa central de políticas es vaga o cuando los equipos de dominio trabajan de forma aislada. Entonces se obtiene lo peor de ambos mundos: un reglamento central que nadie usa y prácticas locales que nadie puede auditar. Por eso la gobernanza federada necesita una responsabilidad compartida, no solo un organigrama que diga «central más local».
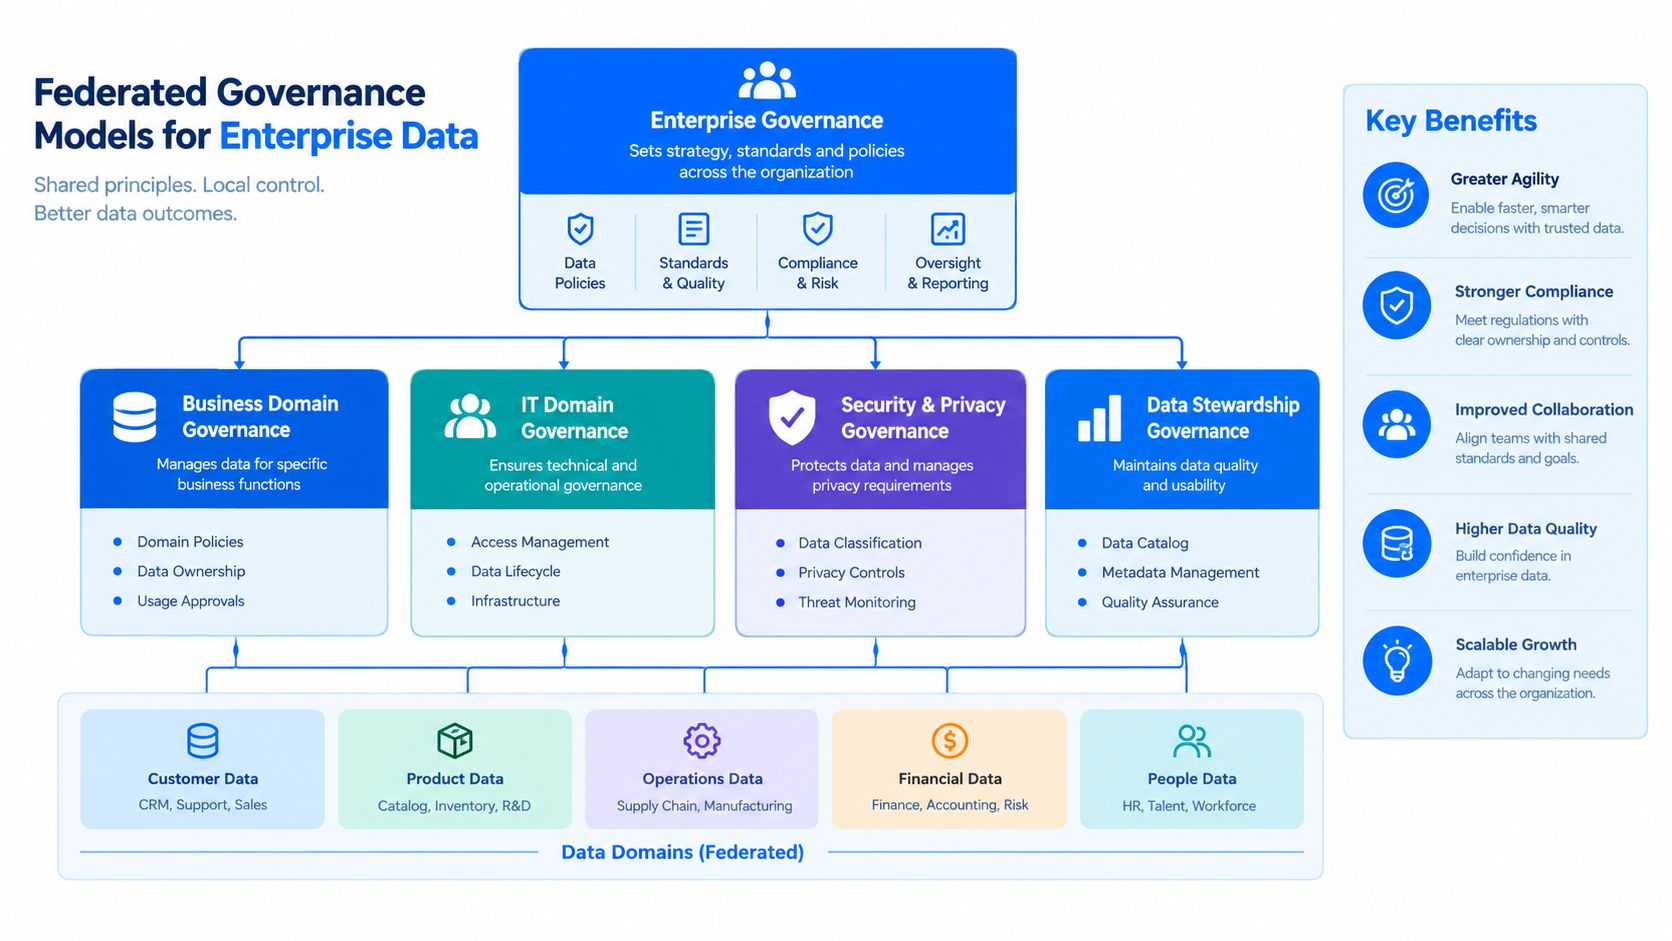
Para los equipos que formalizan este modelo operativo, la guía de gobernanza de datos federada resulta más útil cuando se combina con decisiones concretas sobre propiedad, escalado y evidencias de calidad. Sin esas piezas, «federado» se convierte en una etiqueta sin mecanismo de aplicación.
Por qué federado no significa automáticamente privado
El mito más persistente es que los sistemas federados son privados por defecto. No lo son. El NIST señala que, incluso en el aprendizaje federado, se puede extraer información de las actualizaciones del modelo o del propio modelo entrenado, lo que significa que el aprendizaje federado reduce la exposición pero no elimina el riesgo para la privacidad NIST.
Esta es la parte que muchas explicaciones omiten. Que los datos en bruto permanezcan en local es un control importante, pero no es toda la historia de la seguridad. La investigación independiente y las orientaciones regulatorias describen el mismo mecanismo: los clientes mantienen los datos en bruto en el dispositivo o en sus instalaciones, realizan el cálculo localmente y envían solo actualizaciones específicas para su agregación, a veces con privacidad diferencial añadida para reducir fugas CACM. Es mejor que enviar todos los registros a un conjunto de entrenamiento central, pero sigue dejando abiertos los riesgos de fuga en las actualizaciones, de inversión del modelo y de coordinación.
Qué deben asumir los equipos regulados
La arquitectura federada debe tratarse como una estrategia de reducción del movimiento de datos, no como una garantía general de privacidad. Si trabaja en finanzas, sanidad, telecomunicaciones o el sector público, eso significa que sigue necesitando controles de acceso, auditabilidad y salvaguardas criptográficas en torno a la ruta de actualización. El diseño ayuda con la residencia y la autonomía, pero no sustituye a la ingeniería de seguridad.
Para los equipos centrados en el lado del cumplimiento de esa ecuación, proteger la privacidad de sus datos es un recordatorio útil de que las protecciones de privacidad siguen necesitando controles por capas, no ilusiones. La misma lógica se aplica a los sistemas federados, donde la superficie de ataque cambia de forma en lugar de desaparecer.
Los sistemas federados a menudo desplazan el riesgo, no lo eliminan. Los despliegues más sólidos asumen que las actualizaciones del modelo también son activos sensibles.
Si su organización intenta alinear la arquitectura con requisitos de residencia o soberanía, el cumplimiento de la soberanía de datos pasa a formar parte de la conversación sobre el diseño, no a ser una ocurrencia tardía. La pregunta nunca es solo dónde residen los datos en bruto, sino también quién puede inferir qué a partir del sistema que los rodea.
Cuándo tienen sentido las arquitecturas federadas
Las arquitecturas federadas tienen más sentido cuando equipos independientes necesitan conservar la propiedad de sus datos sin dejar de participar en un modelo operativo compartido. Encajan bien cuando importan la privacidad, la soberanía o la autonomía de los dominios, porque las fuentes independientes mantienen el control mientras ofrecen un acceso interoperable mediante políticas, API o algoritmos compartidos MIT. Ese es el valor central: coordinación sin consolidación total.
También encajan cuando los pipelines centralizados se han convertido en cuellos de botella. Si cada nueva fuente de datos necesita que el mismo equipo central la ingiera, la modele, la apruebe y la publique, la plataforma empieza a frenar al negocio. Un modelo federado puede aliviar esa presión, pero solo si la empresa está dispuesta a invertir en estándares, metadatos, seguridad y supervisión de la calidad entre dominios.
Utilice diseños federados cuando
Varios dominios necesitan la propiedad: cada equipo mantiene el control de sus propios datos y su propia lógica.
La residencia de los datos importa: no puede, o no debería, trasladar todos los datos a una sola plataforma.
Los pipelines centrales están sobrecargados: el equipo de plataforma dedica más tiempo a la coordinación que a facilitar el trabajo de otros.
Importan tanto la autonomía como el cumplimiento: el negocio necesita toma de decisiones local dentro de unas barreras de protección globales.
Un enfoque puramente centralizado sigue teniendo sentido para conjuntos de datos más pequeños, cargas de trabajo de un solo dominio u organizaciones que aún no tienen la madurez de gobernanza necesaria para coordinarse entre dominios. Si hay un solo equipo, una sola carga de trabajo y un solo modelo de seguridad, la federación puede añadir más proceso que valor. El compromiso estructural es sencillo: centralizar para simplificar, federar para lograr una independencia controlada.
digna proporciona calidad y observabilidad de datos dentro del propio entorno del cliente, lo que la hace relevante cuando los equipos federados necesitan evidencias de dominios separados sin llevarlo todo a un único lugar. Si está evaluando una arquitectura federada y necesita visibilidad sobre anomalías, cambios de esquema, puntualidad y validación en todos los dominios, visite digna y descubra cómo encaja la plataforma en ese modelo operativo.
Cuando los dominios federados mantienen sus datos en su lugar pero siguen necesitando evidencias de calidad compartidas, la observabilidad de plataformas de datos que se ejecuta dentro de su propio entorno puede supervisar cada fuente allí donde reside en lugar de copiarla en un almacén central.
Preguntas frecuentes
¿Qué significa federado en datos e IA?
Federado significa que los datos permanecen en su origen mientras modelos, políticas o consultas compartidos operan sobre sistemas independientes. Cada parte conserva la propiedad y el control local, y una capa de coordinación se encarga del acceso o la agregación. La idea se remonta a las bases de datos federadas de finales de los años setenta y los ochenta y hoy sustenta el aprendizaje federado.
¿Cuál es la diferencia entre una arquitectura de datos federada y una centralizada?
La diferencia fundamental es dónde residen los datos y quién es su propietario. La arquitectura centralizada traslada los datos a un data warehouse o data lake compartido gestionado por un equipo central, mientras que la federada mantiene los datos en los sistemas de origen y enruta las consultas a través de una capa de coordinación, como un servidor federado, y los equipos de dominio conservan la propiedad.
¿Cómo funciona el aprendizaje federado sin mover datos?
El aprendizaje federado entrena un modelo localmente en cada cliente, ya sea un teléfono, un sistema hospitalario o una instalación. Solo las actualizaciones del modelo viajan a un coordinador, que las agrega en un modelo global refinado y lo devuelve para otra ronda local. Los registros en bruto nunca salen de su ubicación original.
¿Es privado por defecto el aprendizaje federado?
No. El NIST señala que todavía se puede extraer información de las actualizaciones del modelo o del propio modelo entrenado, por lo que el aprendizaje federado reduce la exposición sin eliminar el riesgo. Los equipos regulados de finanzas, sanidad, telecomunicaciones o el sector público siguen necesitando controles de acceso, auditabilidad y salvaguardas criptográficas en torno a la ruta de actualización.
¿Cuándo debería una organización utilizar una arquitectura federada?
Opte por la federación cuando varios dominios necesiten la propiedad de sus datos, las normas de residencia de datos impidan la consolidación o los pipelines centrales se hayan convertido en un cuello de botella. Para conjuntos de datos más pequeños, cargas de trabajo de un solo dominio o equipos sin la madurez de gobernanza necesaria para coordinarse entre dominios, un enfoque puramente centralizado suele añadir menos proceso y sigue siendo la opción más sencilla.


