Was ist Datenqualitätsmanagement: Ein praktischer Leitfaden für 2026
|
9
min. Lesezeit

Datenqualitätsmanagement ist die kontinuierliche Praxis der Messung, Überwachung und Verbesserung der Eignung von Daten über ihren gesamten Lebenszyklus hinweg, unter Verwendung von Dimensionen wie Genauigkeit, Vollständigkeit, Timeliness, Konsistenz, Gültigkeit und Eindeutigkeit. In einer Branchenumfrage aus dem Jahr 2024, die von Precisely zusammengefasst wurde, messen und kommunizieren nur etwa 25 % der Unternehmen konsequent Datenqualitätsmetriken, und der durchschnittliche Reifegrad lag bei 56 von 100, was ein typisches Unternehmen auf Stufe 3, Etabliert, von 5 einordnet. Preciselys Zusammenfassung der Trends im Datenqualitätsmanagement 2024
Diese Lücke ist leicht zu erkennen, wenn Sie jemals erlebt haben, wie ein Finanzteam einem Umsatz-Dashboard vertraut hat, das fehlerhaft war. Ein Staging-Schema verliert eine Spalte, Rückerstattungen werden doppelt gezählt, der Vorstand erhält eine falsche Zahl, eine Lieferantenbeziehung wird beschädigt und drei Tage gehen bei der Abstimmung verloren. Das Problem war kein Mangel an Bereinigungsaufwand. Es war das Fehlen eines lebendigen Kontrollsystems.
Inhaltsverzeichnis
Wie sich Datenqualitätsmanagement zu einer Disziplin entwickelte
Der Lebenszyklus der Datenqualität von der Quelle bis zum Verbraucher
Häufige Fallstricke und Best Practices, die tatsächlich funktionieren
Eine Arbeitsdefinition, die Sie noch heute nutzen können
Ein Datenteam kann auf ein sauberes Dashboard starren und trotzdem den Kern der Sache verpassen. Datenqualitätsmanagement ist das Betriebsmodell, das Daten von der Quelle bis zum Verbraucher gebrauchstauglich hält. Es erkennt Fehler frühzeitig, misst sie jedes Mal auf dieselbe Weise und behebt die Grundursache, anstatt einen fehlerhaften Datensatz aufzuhübschen, nachdem sich der Schaden bereits ausgebreitet hat.
Eine praktische Definition ist direkt: DQM ist Prävention, Erkennung und Behebung über den gesamten Datenlebenszyklus hinweg. Wenn ein Plattformteam Datensätze erst bereinigt, nachdem sich Analysten beschweren, betreibt es Schadensbegrenzung. Wenn es Regeln, Aktualitätsprüfungen, Verantwortlichkeiten und Alarmierungen in die Produktionspipelines integriert, managt es die Qualität.
Das Fehlermuster ändert sich mit der Pipeline. Ein Marketing-Attributionsjob kann eine Schema-Abweichung erleiden, das falsche Feld zuordnen und Werbeausgaben in das falsche Kanalmodell leiten. Ein Modell zur Zählung von Abonnements kann zulassen, dass doppelte Schlüssel die Anzahl der aktiven Nutzer künstlich aufblähen, was Produkt- und Finanzteams in eine Debatte darüber verwickelt, welche Zahl nun stimmt. Beide Fälle gehören zur gleichen Problemklasse: Qualitätskontrollen fehlten dort, wo sich die Daten bewegten.
Praktische Regel: Wenn ein Datenproblem erst manuell behoben werden kann, nachdem die Verbraucher es bemerkt haben, kommt der Qualitätsprozess zu spät.
Für eine prägnante Referenz auf dieselbe operative Sichtweise stellt dignas Übersicht zur Datenqualität das Thema klar dar. Der Rest dieses Leitfadens setzt diese Definition in Kontrollen um, die Sie in der Produktion ausführen können.
Wie sich Datenqualitätsmanagement zu einer Disziplin entwickelte
Datenqualität wurde früher oft wie eine lästige Aufräumarbeit behandelt – etwas, das man tat, nachdem ein Bericht verdächtig aussah. Dieses Modell bricht zusammen, sobald sich Pipelines vervielfachen, Datenprodukte Teamgrenzen überschreiten und jede manuelle Korrektur mehr Verzögerung verursacht als das Problem selbst. Die Antwort der Branche war ein Wandel hin zu governance, wiederholbarer Messung und Rechenschaftspflicht, weil die Kosten des Abwartens kontinuierlich steigen.
Die wirtschaftlichen Argumente für diesen Wandel sind alt, aber nach wie vor überzeugend. Die MIT Sloan Management Review berichtete über Schätzungen, wonach schlechte Daten in den meisten Unternehmen 15 % bis 25 % des Umsatzes verschlingen können, und eine im Artikel zitierte Zusammenfassung bezifferte den jährlichen Verlust der US-Wirtschaft auf 3,1 Billionen Dollar. Frühere Richtlinien nutzten auch die heute vertraute Kostenleiter von 1 $ zur Vermeidung eines Datensatzfehlers, 10 $ zur Behebung nach dem Eintritt in ein System und 100 $ zur Korrektur, nachdem er ein nachgelagertes Ereignis verursacht hat. MIT Sloan Management Review über die Kosten schlechter Daten
Diese Logik machte DQM von einer Bereinigungsaufgabe zu einer Disziplin des gesamten Lebenszyklus. Richtlinien von Behörden und Industrie behandeln Datenqualität heute als etwas, das man bei der Erfassung, Speicherung, Verarbeitung, Verteilung und Archivierung überwacht, wobei mit jeder Übergabe Standards und Verantwortlichkeiten verknüpft sind. Wenn eine Schemaänderung, eine verzögerte Einspeisung oder eine fehlerhafte Regel Dashboards und regulatorische Berichte ungültig machen können, reicht eine Bereinigung nach dem Laden nicht mehr aus.
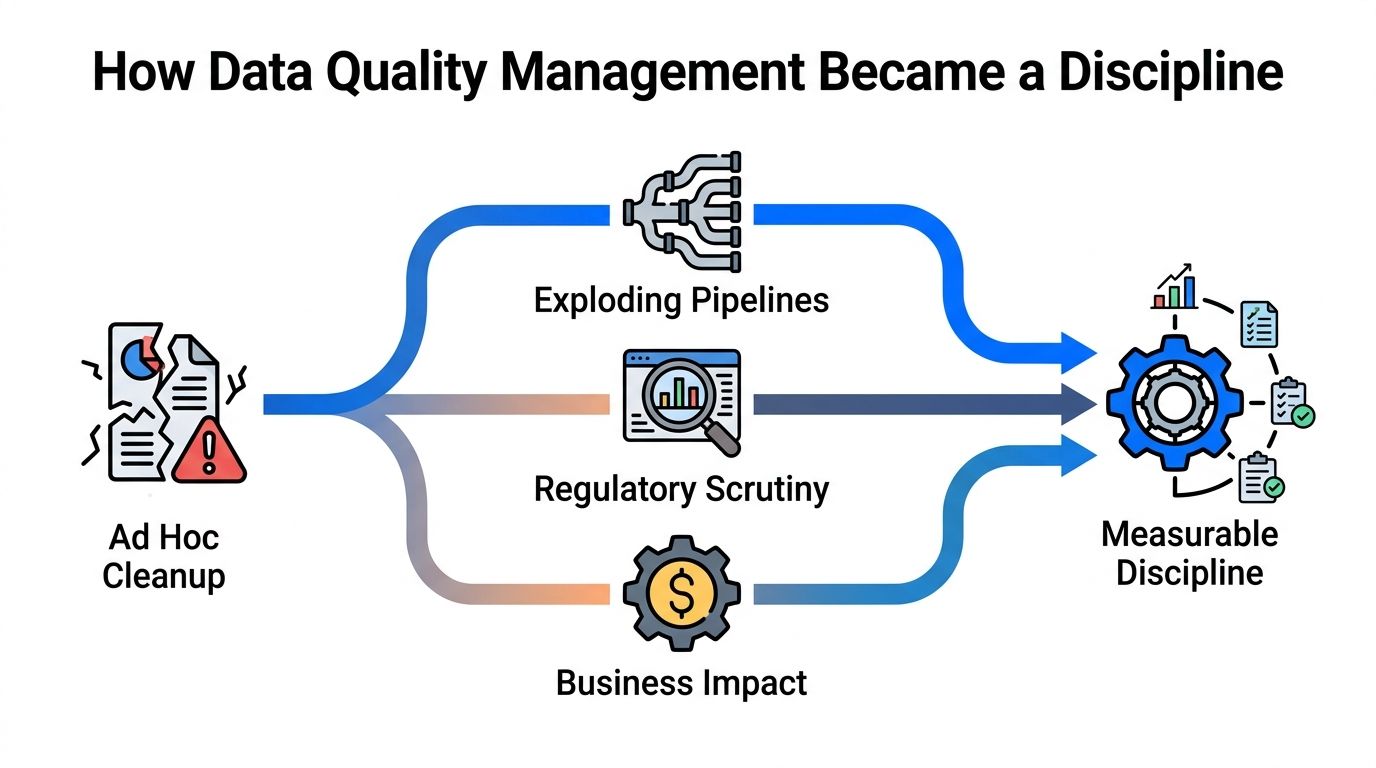
Was sich in der Praxis geändert hat
Reaktive Bereinigung: Teams beheben sichtbare Fehler erst, wenn sich Benutzer beschweren.
Gesteuerte Überwachung: Teams definieren Kontrollen, Verantwortlichkeiten und Eskalationspfade, bevor sich Fehler ausbreiten.
Unternehmensdisziplin: Teams messen die Qualität, kommunizieren sie und behandeln Abweichungen als betriebliches Risiko.
Der Reifegriffsprung ist wichtig, weil er den Ort der Arbeit verändert. Anstatt Analysten mit der Suche nach schlechten Daten zu beauftragen, machen starke Programme die Qualität nahe an der Pipeline sichtbar, wo die Behebung günstiger und der Schadensradius kleiner ist.
Die sechs Dimensionen, die Datenqualität definieren
Die sechs Dimensionen sind nützlich, weil sie sich verschiedenen Fehlermustern zuordnen lassen. Ein Datensatz kann genau sein und dennoch zu spät ankommen, oder vollständig, aber inkonsistent mit einem nachgelagerten System. Wenn Sie Qualität als eine einzige, vage Kennzahl behandeln, verpassen Sie den tatsächlichen Fehler.
Dimension | Beispiel für ein Fehlermuster | Operative Prüfung |
|---|---|---|
Genauigkeit | Ein Adress-Geocoder liefert die richtige Stadt, aber die falsche Postleitzahl | Abgleich mit einer vertrauenswürdigen Quelle und Validierung auf Feldebene |
Vollständigkeit | Ein | Prüfung auf Pflichtfelder, befüllte Felder geteilt durch erforderliche Felder |
Timeliness | Ein täglicher Feed trifft erst nach dem morgendlichen Standup ein, sodass das SLA technisch erfüllt, aber betrieblich nutzlos ist | Aktualitätsüberwachung gegen das erwartete Lieferzeitfenster |
Konsistenz | Dieselbe Kunden-ID verweist im CRM und in der Abrechnung auf unterschiedliche Datensätze | Systemübergreifender Abgleich und referenzielle Prüfungen |
Gültigkeit | Ein Status-Enum akzeptiert einen Tippfehler, der hätte abgelehnt werden müssen | Schemabeschränkung oder regelbasierte Validierung gegen zulässige Werte |
Eindeutigkeit | Doppelte Zeilen blähen die Anzahl der monatlich aktiven Nutzer auf | Deduplizierungsregel, Eindeutigkeitsbeschränkung für Schlüssel, Dublettenprüfung |
Wie man die Dimensionen in der Produktion liest
Genauigkeit prüft, ob ein Wert der Realität entspricht. Wenn ein Geocoder die richtige Stadt, aber die falsche Postleitzahl ermittelt, liegt das Problem nicht an der Formatierung, sondern an einer Diskrepanz zwischen dem Datensatz und dem realen Objekt, das er beschreibt. Das erfordert in der Regel einen Abgleich mit einer Single Source of Truth und nicht eine hübschere Transformation.
Vollständigkeit bezieht sich darauf, ob die für einen Anwendungsfall benötigten Daten vorhanden sind. Das sauberste operative Maß ist einfach: ausgefüllte Pflichtfelder geteilt durch die Gesamtzahl der Pflichtfelder. Das verlagert die Diskussion von der Intuition hin zur tatsächlichen Abdeckung. Eine tiefergehende Aufschlüsselung der Qualitätsdimensionen von BatchData ist nützlich, wenn Sie Definitionen teamübergreifend vergleichen möchten, und dignas Leitfaden zu den Dimensionen ist eine praktische interne Referenz für Implementierungsteams.
Timeliness hat eine konkrete Bedeutung. Behördenrichtlinien definieren sie als die Zeit zwischen dem Ende des Zeitraums, auf den sich die Daten beziehen, und dem Zeitpunkt, an dem sie zur Erfüllung der Benutzeranforderungen zur Verfügung stehen. Zudem wird betont, dass Daten zeitnah sind, wenn sie dann verfügbar sind, wenn sie erwartet und benötigt werden. Behördenrichtlinien zur Datenqualität
Gültigkeit ist die Einhaltung von Regeln. Es ist kein Gefühl, sondern die Frage, ob ein Datensatz einem vordefinierten Format, Typ oder einer Geschäftsregel entspricht. Der Leitfaden zu Datenqualitätsdimensionen von Dagster drückt dies explizit aus, weshalb Validierungsregeln nah an der Pipeline angesiedelt sein sollten.
Konsistenz und Eindeutigkeit sind die Bereiche, in denen systemübergreifende Probleme sichtbar werden. Ein Datensatz kann lokale Prüfungen bestehen und dennoch von der Abrechnung abweichen, während Dubletten Gesamtzahlen und das Vertrauen in diese Zahlen gleichzeitig künstlich in die Höhe treiben können.
Der Lebenszyklus der Datenqualität von der Quelle bis zum Verbraucher
Ein einzelner Kundendatensatz kann Ihnen zeigen, wo Qualitätsarbeit hingehört. Er beginnt in einer SaaS-API, landet in der Ingestion, durchläuft Staging und Transformation und wird schließlich für Analysten, Anwendungen und Modelle bereitgestellt. Jede Phase benötigt eine andere Kontrolle, da ein Fehler flussaufwärts entstehen und erst flussabwärts sichtbar werden kann.

Wo die Kontrollpunkte hingehören
Bei der Landung fängt die Schemavalidierung schwerwiegende Strukturänderungen ab, bevor sie sich ausbreiten können. Bei der Ingestion zeigen Ihnen Aktualitätsprüfungen (Freshness Checks), ob ein Feed eingetroffen ist, als die Benutzer ihn erwartet haben – was weitaus wichtiger ist als ein generisches Signal „Ladevorgang erfolgreich“. Im Staging fangen Vollständigkeitsaudits fehlende Pflichtwerte ab, bevor Transformationen die Lücken schwerer nachvollziehbar machen.
Bei der Transformation vergleicht der Genauigkeitsabgleich abgeleitete Daten mit der Single Source of Truth. Hier treten meist fehlerhafte Joins, veraltete Referenztabellen oder falsche Geschäftsregeln zutage. Vor der Bereitstellung verhindern Konsistenzregeln und die Erzwingung von Eindeutigkeit, dass widersprüchliche oder doppelte Datensätze die Verbraucherschicht erreichen.
Data-Governance-Rollen gliedern sich in diese Übergaben ein, anstatt außerhalb davon zu stehen. Ein Data Steward besitzt die Definitionen und den Eskalationskontext, ein Engineer baut die Prüfungen in die Pipeline ein und ein Analyst bemerkt, ob die gelieferten Daten für die jeweilige Fragestellung geeignet sind. dignas Übersicht über Daten-Ingestion-Pipelines passt hervorragend in dieses Muster, da der Lebenszyklus nur dann funktioniert, wenn die Kontrollpunkte nah an den Daten liegen und nicht nachträglich aufgepfropft werden.
Datenqualität verbessert sich, wenn jede Übergabe ein Signal erzeugt, nicht nur eine Datei.
Das wichtigste mentale Modell ist, dass der Lebenszyklus kreisförmig verläuft. Beschwerden auf Verbraucherseite, Abweichungen in Dashboards und Modellfehler sollten in die Quellverträge (Data Contracts) zurückfließen und nicht nur in einer Support-Warteschlange landen. Tritt dasselbe Problem zweimal auf, gehört die Kontrolle weiter nach oben verlagert.
Datenqualitätsmanagement trifft auf Observability
DQM und Observability sind keine getrennten Diskussionen mehr. Klassische Datenqualitätsprüfungen konzentrieren sich auf bekannte Regeln, während Observability das Laufzeitverhalten auf unbekannte Abweichungen, plötzliche Schemaänderungen, seltsame Verschiebungen der Null-Raten und Aktualitätsfehler überwacht. Die Schnittmenge ist der Bereich, in dem moderne Plattformen den größten Unterschied machen.
Die sinnvolle Aufteilung ist unkompliziert. Validierung sagt Ihnen, ob ein Datensatz eine Geschäftsregel erfüllt. Observability sagt Ihnen, ob sich das Verhalten des Datensatzes in einer Weise verändert hat, die Aufmerksamkeit verdient. Eine Plattform, die beides leistet, kann einen fehlerhaften Statuscode, eine verspätete Partition und eine plötzliche Schwankung der Zeilenanzahl abfangen, ohne dass jedes Team dieselben Kontrollen mühsam von Hand erstellen muss.
Was zu überwachen ist und wie man es umsetzt
Dimension | Observability-Signal | Ausführungsmuster |
|---|---|---|
Genauigkeit | Abweichung beim Abgleich, fehlerhafte Referenzwerte | In-Database-Prüfungen an Transformationsgrenzen |
Vollständigkeit | Anstieg der Null-Rate, fehlende erforderliche Spalten | Statistisches Profiling auf Landing-Tabellen |
Konsistenz | Systemübergreifende Abweichung, Auswirkungen auf die Lineage | Mit Lineage verknüpfte Regelprüfungen, die an die Verantwortlichen weitergeleitet werden |
Timeliness | Verspätete Ankunft, fehlendes Laden, vorzeitige Lieferung | Aktualitätsüberwachung gegen gelernte Zeitpläne |
Gültigkeit | Formatverletzungen, ungültige Enums, Bereichsüberschreitungen | Deterministische Validierung im Warehouse oder in der Pipeline |
Eindeutigkeit | Zunahme doppelter Schlüssel, wiederholte Datensätze | Deduplizierungsprüfungen vor der Bereitstellung |
Eine Plattform wie dignas Modul für Data Observability ist in diesem Modell sinnvoll, da sie Anomalieerkennung, Aktualitätsüberwachung, Schema-Tracking und Validierung in einem operativen Ablauf kombiniert. Auch die Architekturentscheidung ist wichtig. Die Ausführung von Prüfungen direkt in der Datenbank (In-Database) belässt die Daten an Ort und Stelle, reduziert Datenbewegungen und funktioniert bei datenschutzsensiblen Workloads besser, als Stichproben in ein separates Tool zu exportieren.
Der Kompromiss ist real. Stichprobenbasierte Prüfungen sind einfacher zu starten, können aber Randfälle übersehen und blinde Flecken in Pipelines mit hohem Datenaufkommen verursachen. Die In-Database-Ausführung ist besser, wenn Ihnen Aktualität, Datenresidenz oder die Vermeidung von Duplikaten sensibler Datensätze außerhalb der Warehouse-Grenzen wichtig sind.
Implementierung von Datenqualitätsmanagement in der Praxis
Eine DQM-Einführung funktioniert am besten, wenn sie klein anfängt und Vertrauen aufbaut. Das erste Ziel sollten die umsatzkritischsten Datensätze sein – diejenigen, die in Vorstands-Dashboards, Abrechnungen, Risikoanalysen, Kundenberichte oder Modelle einfließen, auf deren Basis schnell gehandelt wird. Eine breite Abdeckung klingt beeindruckend, führt aber meist nur zu fehleranfälligen Alarmen und einer halbfertigen Kontrollbibliothek.
Ein Einführungsmuster, das nicht ins Stocken gerät
Wählen Sie zuerst die kritischen Datensätze aus. Beginnen Sie dort, wo ein Fehler dem Unternehmen schaden würde, und nicht dort, wo die Tabelle am einfachsten zu testen ist.
Weisen Sie jedem Datensatz Dimensionen zu. Wenden Sie nicht jede Prüfung überall an. Ein transaktionaler Feed erfordert vielleicht mehr Fokus auf Timeliness und Eindeutigkeit, während ein Referenzdatensatz strengere Konsistenz- und Gültigkeitsregeln benötigt.
Setzen Sie Schwellenwerte, die laut genug sind, um aufzufallen. Wenn ein Alarm das Verhalten nicht ändert, ist er nur Rauschen.
Integrieren Sie Prüfungen in die CI für Transformationen. Ein fehlerhafter Contract sollte eine fehlerhafte Änderung blockieren, bevor sie die Produktion erreicht.
Nutzen Sie Private Deployment für sensible Daten. Wenn PII (personenbezogene Daten) oder Residenzregeln gelten, muss die Steuerungsebene diese Einschränkungen respektieren.
Die Architekturentscheidungen, die sich auszahlen
Das stärkste Muster besteht darin, Prüfungen direkt im Warehouse oder Lakehouse anzusiedeln, sodass Qualitätssignale dort berechnet werden, wo die Daten bereits liegen. Das hält die Latenz niedrig und vermeidet unnötige Datenbewegungen. Bei Verteilungen, die sich im Laufe der Zeit verschieben, funktioniert die Anomalieerkennung in der Regel besser als statische Regeln, da sich echte Daten zu schnell verändern, als dass feste Schwellenwerte dauerhaft nützlich bleiben könnten.
Das Schema-Tracking sollte direkt neben diesen beiden Kontrollen angesiedelt sein. Upstream-Teams ändern Spaltennamen, Datentypen und -strukturen häufiger, als ihnen bewusst ist – und genau so scheitern nachgelagerte Jobs, ohne dass ein sichtbarer Vorfall im Quellsystem protokolliert wird. dignas Implementierungsansatz deckt sich mit diesem Muster, da er Überwachung, Validierung und Schema-Abweichungen als ein einziges Betriebsmodell anstelle von drei separaten Tools behandelt.
Das Ziel sind nicht mehr Prüfungen. Es sind weniger Überraschungen bei klarerer Verantwortlichkeit.
Überprüfen Sie Fehlalarme (False Positives) in regelmäßigen Abständen. Wenn das Team die Hälfte der Alarme ignoriert, hat das Programm bereits an Glaubwürdigkeit verloren. Gutes Qualitäts-Engineering schafft einen Kreislauf, in dem Regeln verfeinert, Verantwortliche klar zugewiesen und zukünftige Releases durch jeden Vorfall verbessert werden.
Häufige Fallstricke und Best Practices, die tatsächlich funktionieren
Die meisten DQM-Programme scheitern nicht am Mangel an Tools. Sie scheitern, weil das Programm zu einer Alarmfabrik wird. Wenn jede Anomalie jemanden alarmiert, unabhängig von Schweregrad oder Zuständigkeit, ist der erste Monat extrem laut und der zweite wird schlicht ignoriert.
Ein weiterer häufiger Fehler ist, nur Zeilenanzahlen zu messen. Eine Tabelle kann das richtige Volumen aufweisen und dennoch plausible, aber falsche Werte, verspätete Datensätze oder widersprüchliche Definitionen enthalten. Der Fehler bleibt verborgen, weil die Metrik zu grob war, um ihn zu erfassen.
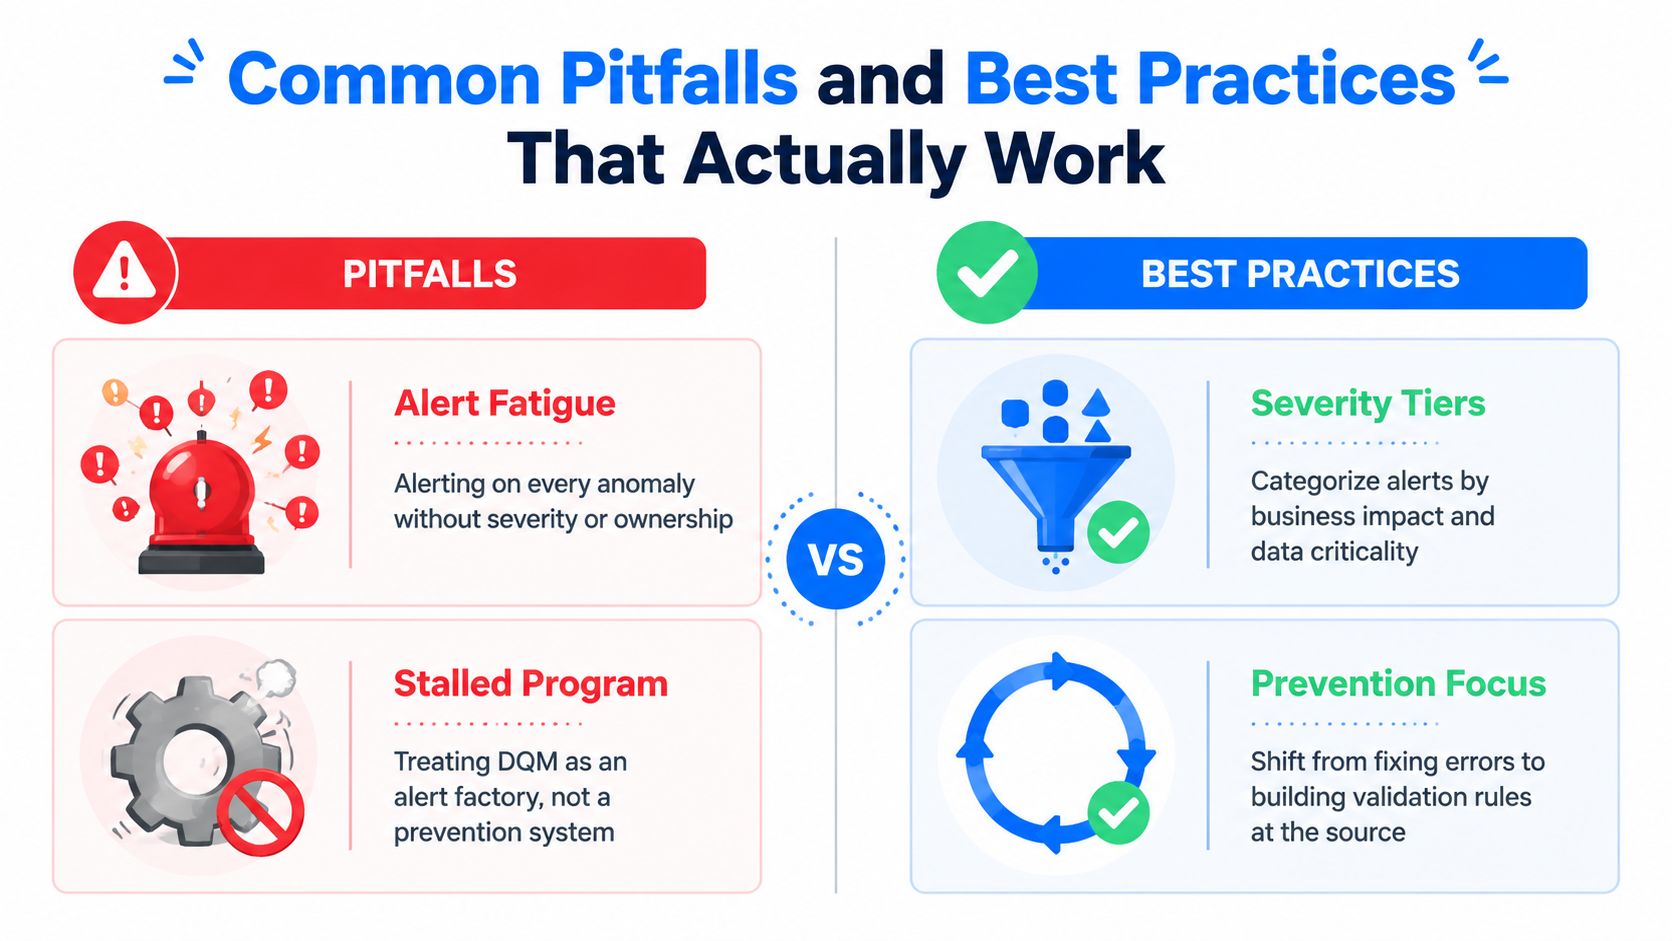
Was zu vermeiden ist
Alles alarmieren: Wenn Schweregrad und Zuständigkeit fehlen, schaltet das Team irgendwann ab.
Mit allen Tabellen gleichzeitig beginnen: Eine breite Abdeckung ohne geschäftliche Priorisierung erzeugt nur Rauschen.
Kopierte Schwellenwerte verwenden: Was für einen Datensatz funktioniert, kann für einen anderen völlig falsch sein.
Bereinigung als Gesamtlösung betrachten: Prävention ist weitaus wichtiger als die nachträgliche Schadensbegrenzung.
Qualitäts-Scores als unumstößliche Wahrheit behandeln: Ein Qualitäts-Score ohne Kontext kann das tatsächliche Fehlermuster verschleiern.
Was sich tatsächlich bewährt
Nachhaltige Programme konzentrieren sich auf kritische Datenprodukte und nicht auf das gesamte Warehouse. Sie definieren Service-Level-Ziele (SLOs), leiten Fehler an die verantwortlichen Personen weiter und überprüfen die Ergebnisse gemeinsam mit den Domain Stewards, sodass die Kontrollen das Geschäft widerspiegeln und nicht nur das Schema. Sie verfolgen zudem operativ relevante Kennzahlen wie die Rate unentdeckter Fehler, das Vorfallvolumen, die Erkennungszeit, die Behebungszeit, die Einhaltung der Aktualität und die betroffenen nachgelagerten Datensätze.
Die größte Verbesserung habe ich dadurch erlebt, dass Regeln versioniert, bekannte Ausnahmen dokumentiert und Prüfungen entfernt wurden, die niemals eine Aktion auslösen. Das hält das System effizient. Die richtige Balance ist Prävention bei der Ingestion gepaart mit Erkennung während der Transformation und Bereitstellung, da keine einzelne Schicht alles abfangen kann.
Häufig gestellte Fragen zum Datenqualitätsmanagement
Wie unterscheidet sich DQM von der Datenbereinigung? Die Bereinigung behebt einen bestimmten fehlerhaften Datensatz. DQM etabliert kontinuierliche Kontrollen zur Prävention, Erkennung, Messung, Verantwortlichkeit und Behebung über den gesamten Lebenszyklus hinweg. Das eine ist eine Reparaturaufgabe, das andere ein Betriebsmodell.
In welcher Beziehung steht DQM zu Data Governance? Governance definiert die Richtlinien, Standards und Eskalationspfade. DQM liefert die Prüfungen, Metriken und Workflows, die diese Regeln in der Produktion durchsetzen.
Wer ist für die Datenqualität verantwortlich? Stewardship und Qualitäts-Engineering leisten einen Großteil der täglichen Arbeit, aber die Letztverantwortung liegt meist beim Domain- oder Datenprodukt-Eigentümer. Plattformteams sollten wiederverwendbare Werkzeuge bereitstellen, und die Eigentümer der Quellsysteme sollten für die an der Quelle entstehenden Fehler verantwortlich sein.
Wie sollte der ROI gemessen werden? Beginnen Sie mit einer Baseline für Fehler, Vorfälle, manuellen Aufwand und geschäftliche Auswirkungen. Verfolgen Sie dann die Reduzierung von Nacharbeiten, schnellere Erkennung, schnellere Behebung, weniger nachgelagerte Fehler und bessere Wiederverwendbarkeit. Wenn Sie einen verhinderten Vorfall einer automatisierten Kontrolle zuordnen können, tun Sie das. Wenn nicht, halten Sie die Messung ehrlich und qualitativ, anstatt Zahlen zu erfinden.
Der einfachste Weg anzufangen, ist immer noch der beste. Wählen Sie einen geschäftskritischen Datensatz, definieren Sie Regeln für die Zwecktauglichkeit, platzieren Sie Prüfungen dort, wo Daten eintreffen und sich verändern, weisen Sie Verantwortliche für die Behebung zu und erweitern Sie das System erst, wenn der erste Workflow seinen Wert bewiesen hat. Das hält DQM in der Praxis verankert, anstatt es zu einem reinen Präsentationskonzept verkommen zu lassen.

Wenn Sie ein Datenqualitätsprogramm aufbauen, das in echten Pipelines funktionieren muss, bietet digna Teams die Möglichkeit, Validierung, Anomalieerkennung, Aktualitätsüberwachung und Schema-Tracking in ihrer eigenen Umgebung auszuführen. Besuchen Sie digna, wenn Sie eine Plattform suchen, die auf In-Database-Kontrollen, Private Deployment und Produktionsüberwachung setzt, anstatt auf nachträgliche Schadensbegrenzung.
Häufig gestellte Fragen
Wie lautet die Arbeitsdefinition von DQM?
Prävention, Erkennung und Behebung über den Datenlebenszyklus. Diese dreiteilige Definition ist brauchbarer als eine Liste von Dimensionen, weil sie die drei Orte benennt, an denen eine Kontrolle sitzen kann, statt der Eigenschaften, die sie misst.
Wie reif ist die typische Organisation?
In einer 2024 von Precisely zusammengefassten Umfrage messen und kommunizieren nur rund 25 % der Unternehmen Datenqualitätskennzahlen konsequent, und der durchschnittliche Reifegrad lag bei 56 von 100, was die typische Organisation auf Stufe 3 von 5, Established, setzt.
Wann ist ein Qualitätsprozess zu spät?
Wenn sich ein Datenproblem erst von Hand beheben lässt, nachdem Konsumenten es bemerkt haben. Dann dokumentiert der Prozess Fehler, statt sie zu verhindern, unabhängig von seiner behaupteten Abdeckung.
Was ist das ökonomische Argument für den Wandel?
Die MIT Sloan Management Review berichtete Schätzungen, nach denen schlechte Daten bei den meisten Unternehmen 15 % bis 25 % des Umsatzes aufzehren können. Zahlen dieser Größenordnung haben DQM von einer Aufräumaufgabe zu einer Lebenszyklusdisziplin gemacht.
Welche drei Praxisstufen gibt es?
Reaktive Bereinigung, bei der Teams sichtbare Fehler nach Beschwerden beheben; gesteuertes Monitoring, bei dem Teams Kontrollen, Verantwortung und Eskalation definieren, bevor sich Defekte ausbreiten; und Unternehmensdisziplin, bei der Teams Qualität messen, kommunizieren und Drift als operatives Risiko behandeln.



