Data Quality vs. Data Governance: Ein praktischer Leitfaden
|
8
min. Lesezeit

Ein CFO öffnet am Dienstagmorgen ein Umsatz-Dashboard und sieht eine Schwankung von 14 % über Nacht. Bis zum Mittagessen haben drei Teams bereits drei verschiedene Erklärungen parat. Das Data Engineering macht eine Upstream-Schemaänderung verantwortlich, die niemand dokumentiert hat, die Analytics-Abteilung beschuldigt das Governance-Gremium, eine Definition genehmigt zu haben, die niemand liest, und der Eigentümer des Quellsystems behauptet, der Anbieter habe ein Release eingespielt. Das ist meistens der Moment, in dem die Leute anfangen, die Begriffe Datenqualität und Data Governance so zu verwenden, als wären sie austauschbar, obwohl der Fehler selten so einfach gestrickt ist.
Der schnellste Weg, das Problem zu entwirren, besteht darin, governance als das Kontrollsystem und Qualität als die messbare Ausgabe zu betrachten. Governance definiert, wer Eigentümer der Daten ist, welche Regeln gelten, wie Änderungen genehmigt und wie Probleme gelöst werden. Die Qualität sagt Ihnen, ob die Daten für die Verwendung geeignet sind. Beide sind miteinander verknüpft, aber sie sind nicht dasselbe, und sie zu verwechseln ist der Grund, warum Teams am Ende glänzende Richtlinien und kaputte Dashboards haben.
Kriterium | Data Governance | Datenqualität |
|---|---|---|
Kernfrage | Wer entscheidet über die Daten, kontrolliert sie und verantwortet sie | Sind die Daten für den vorgesehenen Verwendungszweck geeignet |
Hauptausgabe | Richtlinien, Eigentümerschaft, Lineage, Zugriffsregeln, Eskalationspfade | Gemessene Datensätze, validierte Regeln, Anomaliewarnungen, Scores |
Was verwaltet wird | Entscheidungsrechte und Workflows | Verhalten des Datensatzes und Integrität auf Datensatzebene |
Bester Beleg | Abdeckung, Akzeptanz, Audit-Bereitschaft, MTTR | Genauigkeit, Vollständigkeit, Timeliness, Konsistenz, Validität, Eindeutigkeit |
Typisches Scheitern | Richtlinientheater ohne Durchsetzung | Gute Prüfungen ohne Eigentümerschaft oder Behebungspfad |
Diese Unterscheidung ist in regulierten Umgebungen, in KI-Programmen und in der gewöhnlichen operativen Berichterstattung von Bedeutung. Sie erklärt auch, warum viele Teams nach einem Vorfall eine einfache Frage nicht beantworten können: War das Problem eine fehlerhafte Kontrolle oder war die Kontrolle in Ordnung und die Daten selbst schlecht? Ein guter Weg, den Unterschied zu verstehen, ist der praktische Rahmen in wie man die Infrastruktur-Governance automatisiert, der verdeutlicht, dass Kontroll-Design und operative Ausführung nicht dieselbe Aufgabe sind.
Inhaltsverzeichnis
Warum diese beiden Begriffe immer wieder verwechselt werden
Ein fehlerhaftes Dashboard bringt beide Begriffe in dasselbe Meeting. Der Finanzleiter möchte die korrigierte Zahl, das Plattform-Team möchte die Quelle zurückverfolgen, und jede Seite greift nach dem Begriff, der die eigene Arbeit weniger fehlerhaft erscheinen lässt. Governance wird beschuldigt, wenn eine Definition unklar ist. Die Qualität wird beschuldigt, wenn eine Metrik falsch ist. Das Problem ist oft die fehlende Übergabe zwischen beiden.
Diese Verwirrung entsteht, weil die Art des Scheiterns nicht immer offensichtlich ist. Eine Definitionsänderung ohne Genehmigung ist ein Governance-Problem, während eine stabile Definition, die unvollständige Zeilen lädt, ein Qualitätsproblem ist. Eine Kontrolle kann schwach sein, und die Daten können dennoch sauber genug sein, um Prüfungen zu bestehen. Das Gegenteil ist ebenfalls der Fall. Deshalb streiten Teams oft über Symptome anstatt über die Kontrollebene im Vergleich zur gemessenen Ausgabe.
Praktische Regel: Wenn die Frage lautet, wer die Regel genehmigt hat, denken Sie an governance. Wenn die Frage lautet, ob die Daten die Regel erfüllt haben, denken Sie an Qualität.
Die Unterscheidung ist in der operativen Arbeit von Bedeutung, nicht nur in Richtlinien-Präsentationen. Governance ist das Kontrollsystem, also die Gesamtheit der Entscheidungen und Genehmigungen, die bestimmen, wie sich Daten verhalten sollen. Qualität ist der Messwert auf dem Instrument, der Beleg dafür, dass sich die Daten so verhalten. Aus diesem Grund ist wie man die Infrastruktur-Governance automatisiert auch ein nützlicher Referenzpunkt, da es das Kontroll-Design von der täglichen Ausführung trennt.
Warum die Verwirrung in der Praxis fortbesteht
Teams begegnen Governance meist durch Katalogeinträge, Genehmigungsworkflows, Zugriffsprüfungen, Lineage-Diagramme und Treffen zur Eigentümerschaft. Sie begegnen Qualität durch fehlgeschlagene Prüfungen, veraltete Ladevorgänge, doppelte Datensätze und Geschäftsanwender, die fragen, warum sich derselbe KPI innerhalb einer Woche zweimal geändert hat.
Diese Überschneidung verleitet zu einer Abkürzung, die jedoch riskant ist. Governance kann auf dem Papier ausgereift aussehen, während die Qualität schwach bleibt, da Richtlinien Daten nicht von alleine bereinigen. Qualitätswerkzeuge können ebenfalls beeindruckend aussehen, während die Governance vage bleibt, da Prüfungen ohne Eigentümerschaft lediglich schnellere Warnungen erzeugen. Das Ergebnis ist aus regulierten Programmen und der KI-Arbeit bekannt, wo zwar eine Kontrolle existieren mag, aber niemand sagen kann, ob sie auch durchgesetzt wird.
Der sauberste Weg, die Begriffe zu trennen, besteht darin, bei jedem Datenproblem eine Frage zu stellen. Geht es hier um die Regeln und Verantwortlichkeiten rund um die Daten oder geht es um den beobachteten Zustand der Daten selbst? Die Antwort sagt Ihnen, ob Sie sich Governance-Kontrollen, Qualitätsmessungen oder beides ansehen müssen. Für Teams, die den Kontrollumfang mit Compliance-Grenzen vergleichen, ist digna compliance vs governance ein nützlicher Ausgangspunkt.
Definition von Data Governance und Datenqualität
Eine regulierte Kundentabelle kann auf zwei verschiedene Arten fehlerhaft sein. Die Stewards wissen vielleicht nicht, wer eine Schemaänderung genehmigt hat, oder die Datensätze sind unvollständig und inkonsistent, obwohl der Genehmigungspfad sauber ist. Das sind unterschiedliche Probleme, die auch unterschiedliche Kontrollen erfordern.
Governance ist das Kontrollsystem
Data Governance is das System aus Richtlinien, Rollen, Entscheidungsrechten und Workflows, das bestimmt, wer Datenbestände definieren, ändern, darauf zugreifen und sie außer Kraft setzen darf. In der Praxis umfasst dies Eigentümerschaft, Genehmigungen, Klassifizierung, Lineage-Erwartungen, Zugriffsregeln, Eskalationspfade und Deaktivierungsregeln. Das Ziel ist eine wiederholbare Entscheidungsfindung, die auditiert und durchgesetzt werden kann, und nicht ein Richtlinienordner, der ungenutzt auf einem gemeinsamen Laufwerk liegt.
Diese Kontrollebene benötigt auch ausführbare Prüfungen. Wenn eine Richtlinie besagt, dass ein Datensatz einer bestimmten Spezifikation folgen muss, muss die Plattform diese Anforderung testen und nicht nur dokumentieren. Für Teams, die diese Kontrollebene aufbauen, ist dignas Übersicht über Data Governance eine nützliche Referenz dafür, wie Richtlinien, Eigentümerschaft und Durchsetzung in einem einzigen Programm zusammenpassen. Die Norm ISO 8000-51:2023 weist in dieselbe Richtung, da sie sich auf den Austausch von Governance-Richtlinienerklärungen und auf automatisierte Konformitätstests gegen die von diesen Richtlinien referenzierten Datenspezifikationen konzentriert, wie im offiziellen ISO-Standarddatensatz beschrieben.
Qualität is der Messwert des Instruments
Datenqualität ist die gemessene Eignung von Daten für ihren vorgesehenen Verwendungszweck. Teams bewerten diese in der Regel anhand von Vollständigkeit, Genauigkeit, Konsistenz, Timeliness, Validität und Eindeutigkeit. Das Messvokabular in ISO 8000 behandelt Qualität als etwas, das man innerhalb von Qualitätsmanagementprozessen und -systemen bewertet, und nicht nur als etwas, das man abstrakt diskutiert, wie in der Übersicht zum ISO 8000-Messstandard dargelegt.
Dieser Rahmen ist wichtig, da Qualität kontextabhängig ist. Bei einer Abrechnungstabelle kommt es vielleicht am meisten auf Genauigkeit und Vollständigkeit an. Ein Streaming-Ereignis-Feed legt möglicherweise mehr Wert auf Timeliness und Validität. Eine Kunden-Stammdatentabelle erfordert vielleicht Eindeutigkeit und Konsistenz. Derselbe Datensatz kann zudem gut verwaltet sein und dennoch Qualitätsprüfungen nicht bestehen, wenn vorgelagerte Systeme fehlerhafte Werte senden.
Governance fragt: „Wer besitzt die Regel und den Ausnahmepfad?“ Qualität fragt: „Haben die Daten die Regel in diesem Datensatz genau jetzt erfüllt?“
Bei einer realen Plattformeinführung betrachte ich Governance als die Kontrollebene und Qualität als das beobachtbare Ergebnis. Wenn ein Team beide verbinden möchte, sind die Muster in wie man die Infrastruktur-Governance automatisiert weiterhin nützlich, weil sie die Diskussion in Richtung durchsetzbarer Kontrollen, Eigentümerschaft und testbarer Ergebnisse lenken. Dieselbe Unterscheidung zeigt sich auch in digna-Modulen, in denen Governance-Kontrollen und Qualitätsprüfungen separat zugeordnet werden sollten, damit Teams sehen können, welche Kontrolle welches Ergebnis beeinflusst.
Direkter Vergleich anhand von Kriterien
Eigentümerschaft und Artefakte machen die Grenze deutlich
Der einfachste Weg, Data Governance vs. Datenqualität zu trennen, besteht darin, zu vergleichen, was jede Seite besitzt. Governance besitzt das Entscheidungs-Framework. Die Qualität besitzt das beobachtete Verhalten der Daten. Dieser Unterschied zeigt sich in den Artefakten, die jedes Team erstellt, im Rhythmus, in dem sie arbeiten, und in der Fehlerart, die sie verhindern wollen.
Kriterium | Data Governance | Datenqualität |
|---|---|---|
Hauptziel | Etablierung von Verantwortlichkeit, Rückverfolgbarkeit und Richtlinienkontrolle | Nachweisen, dass Daten für die Verwendung geeignet sind |
Hauptverantwortlicher | Data-Governance-Leiter, Domain Steward oder Kontrollverantwortlicher | Datenqualitäts-Leiter, Dateningenieur oder Datensatz-Eigentümer |
Kernartefakte | Richtlinien, Glossare, Lineage, Zugriffsregeln, Stewardship-Workflows | Schwellenwerte, Validierungsregeln, Anomaliewarnungen, Behebungstickets |
Messbare Metriken | Katalogabdeckung, Richtlinienabdeckung, Lineage-Abdeckung, Abschluss von Zugriffsprüfungen, MTTR | Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Validität, Eindeutigkeit, Anomalieraten |
Rhythmus | Programm- und Kontrollrhythmus, oft monatlich oder vierteljährlich | Kontinuierliche oder nahezu Echtzeit-Überwachung |
Häufige Fehlerart | Kontrollen existieren, werden aber nicht durchgesetzt | Probleme werden erkannt, aber nicht schnell genug verhindert oder behoben |
Tool-Kategorie | Katalog, Richtlinien-Engine, Stewardship-Workflow, Lineage-Management | Validierungs-Engine, Observability, Profiling, Regelüberwachung |
Der Grenzfall ist wichtig. Eine Beschränkung auf Spaltenebene ist sowohl eine Governance-Regel als auch eine Qualitätsprüfung. Eine Richtlinie, die besagt, dass „dieses Feld nicht null sein darf“, gehört zur Governance, weil sie die Regel definiert, und sie gehört zur Qualität, weil sie an Datensätzen gemessen werden kann. Dasselbe gilt für eine Klassifizierungsregel für sensible Daten. Governance legt den Standard fest, Qualität verifiziert, ob die Daten ihn erfüllen.
Warum Governance-Metriken und Qualitätsmetriken nicht dasselbe sind
Governance-Frameworks konzentrieren sich oft darauf, ob das Kontrollsystem implementiert ist, und nicht darauf, ob jeder Datensatz perfekt ist. Deshalb sind Metriken auf Programmebene wie Katalogabdeckung, Richtlinienabdeckung, Lineage-Abdeckung und der Abschluss von Zugriffsprüfungen von Bedeutung. Sie zeigen, ob das Unternehmen die Kontrollebene aufgebaut und durchgesetzt hat.
Qualitätsmetriken setzen eine Ebene tiefer an. Sie zeigen, ob sich die Daten selbst korrekt verhalten. Ein Team kann die Governance-Metriken verbessern, indem es Richtliniendatensätze hinzufügt und Workflows genehmigt, während Daten immer noch verspätet eintreffen, Dubletten auftreten und nachgelagerte Berichte fehlerhaft sind. Diese Lücke ist genau der Grund, warum ausgereifte Programme beide Ebenen zusammen verfolgen.
Als Faustregel gilt: Governance beweist Kontrolle, Qualität beweist Eignung. Die Governance-Ebene ist das Betriebsmodell. Die Qualitätsebene ist der Beleg dafür, dass das Modell vertrauenswürdige Daten liefert. Für eine praktische Betrachtung der Qualitätsdimensionen selbst sind die Dimensionen der Datenqualität einfacher zu verstehen, wenn sie mit dem tatsächlichen Verhalten von Datensätzen verknüpft werden, anstatt sie als abstrakte Ideale zu behandeln.
Wie Governance-Kontrollen die Qualität tatsächlich verbessern
Eine Kontrolle ändert das Verhalten nur, wenn sie die Quelle erreicht
Die Kausalkette ist einfach, wenn man den Fachjargon weglässt. Ein benannter Dateneigentümer ändert die Zuständigkeit für den Datensatz. Ein Stewardship-Workflow ändert, wer Ausnahmen prüft. Ein Glossar ändert, wie Teams ein Feld interpretieren. Eine Lineage-Vorgabe ändert, wie schnell man einen Fehler bis zu seiner Quelle zurückverfolgen kann. Dies sind Governance-Inputs, und sie verbessern die Qualität nur dann, wenn sie das System beeinflussen, in dem Daten erstellt, verschoben oder transformiert werden.
Ein definierter Eigentümer für Kundendaten kann die Vollständigkeit verbessern, weil jemand für fehlende Felder und veraltete Datensätze verantwortlich ist. Eine Lineage-Anforderung kann die Ursachenanalyse bei einem Qualitätsabfall verkürzen, da das Team den fehlerhaften Wert durch Transformationen hindurch zurückverfolgen kann, anstatt zu raten. Eine kontrollierte Umsatzdefinition kann schleichende Metrik-Abweichungen stoppen und die Konsistenz sichern, weil Finanzen und Analytics mit derselben genehmigten Bedeutung arbeiten.
Die Lücke entsteht, wenn Governance bei der Dokumentation aufhört
Viele Programme geraten in dieser Phase ins Stocken. Richtlinien werden unterzeichnet. Stewardship-Gremien werden gebildet. Tools werden angeschafft. Das Dashboard fällt trotzdem aus, weil die Governance Regeln verfasst hat, die das Quellsystem nie erreicht haben, und die Qualitätsprozesse das Chaos erst entdeckten, als es sich bereits nachgelagert verbreitet hatte.
Das ist die Lücke zwischen Governance und Qualität. Eine Governance, die am Entstehungspunkt nicht durchgesetzt wird, verkommt zur reinen Dokumentation. Eine Qualitätssicherung, die Probleme nur erkennt, wird zu einem verspäteten Alarm. Keines von beiden reicht allein aus. Ausgereifte Teams benötigen sowohl einen Kontrollpfad, der vorhersehbare Fehler verhindert, als auch einen Messpfad, der Restrisiken abfängt.
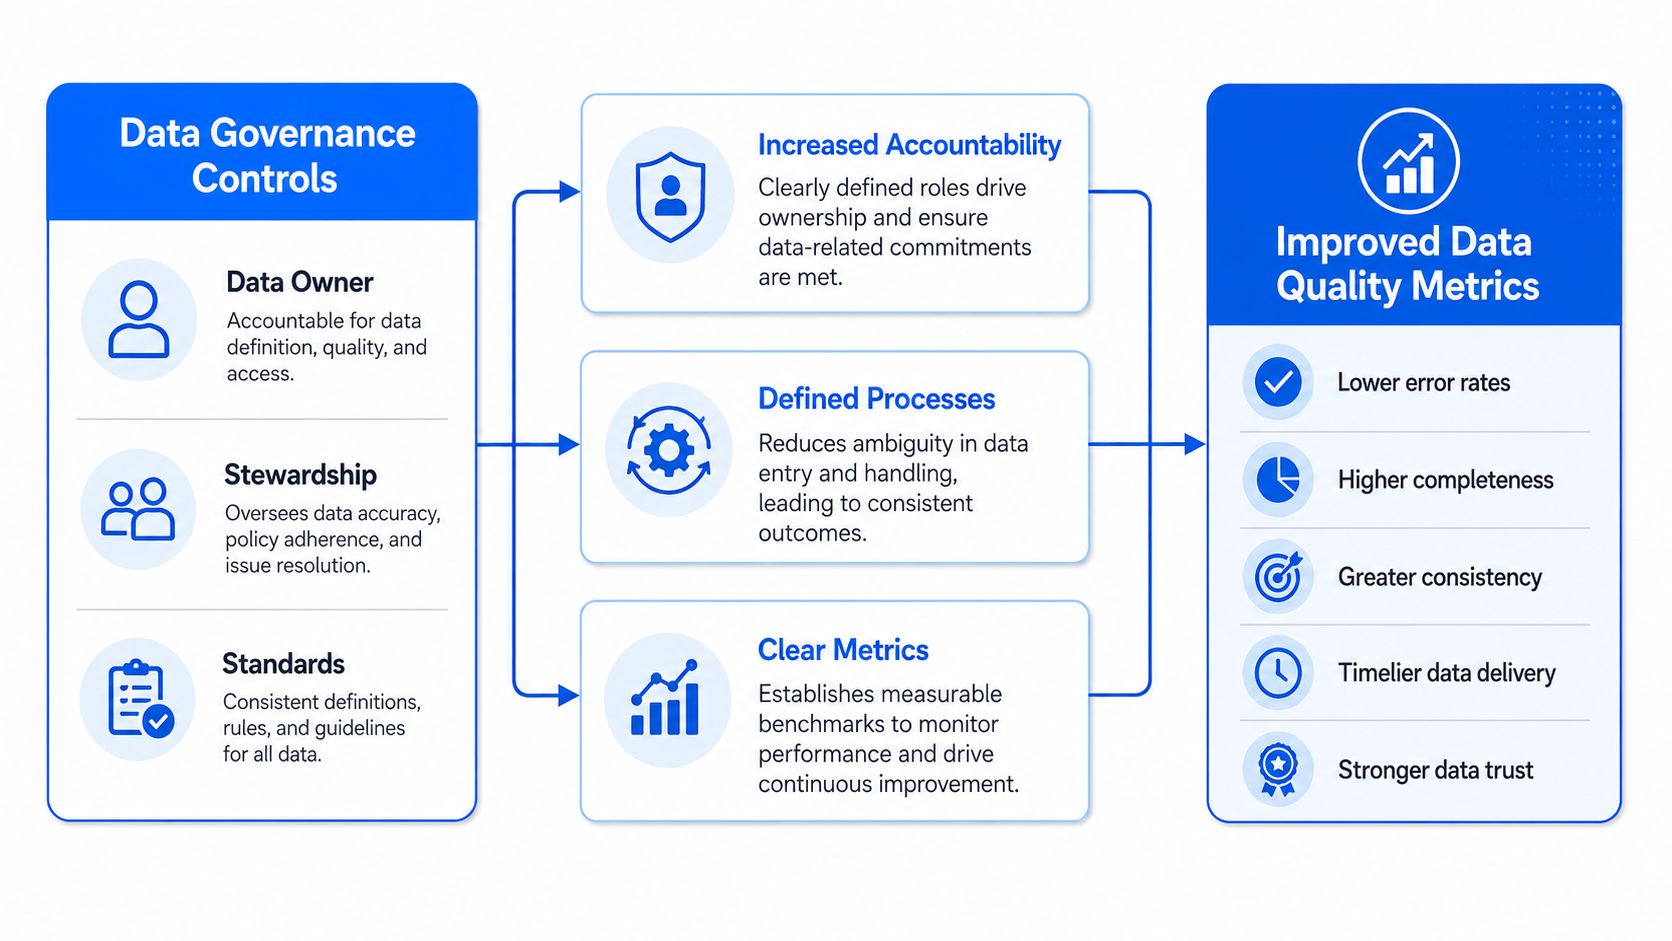
Wenn der Eigentümer nicht nah genug an der Quelle sitzt, wird Governance zur Zeremonie. Wenn die Prüfungen nicht in eine Behebung einfließen, wird Qualität zu bloßem Rauschen.
Das ist auch der Grund, warum viele Governance-Reifegradkurven stagnieren. Mehr Richtlinienseiten führen nicht automatisch zu saubereren Daten. Eine bessere Governance ändert Ergebnisse nur dann, wenn sie eine Durchsetzungsschleife, klare Eigentümerschaft und einen schnellen Weg von der Fehlererkennung zur Behebung schafft. Für Implementierungsmuster, die die Kontrollebene mit der operativen Ebene verbinden, ist das Framework in wie man Data Governance implementiert ein nützlicher Referenzpunkt.
Implementierung beider Programme zusammen
Beginnen Sie mit den Grundlagen zu Eigentümerschaft, Glossar und Katalog
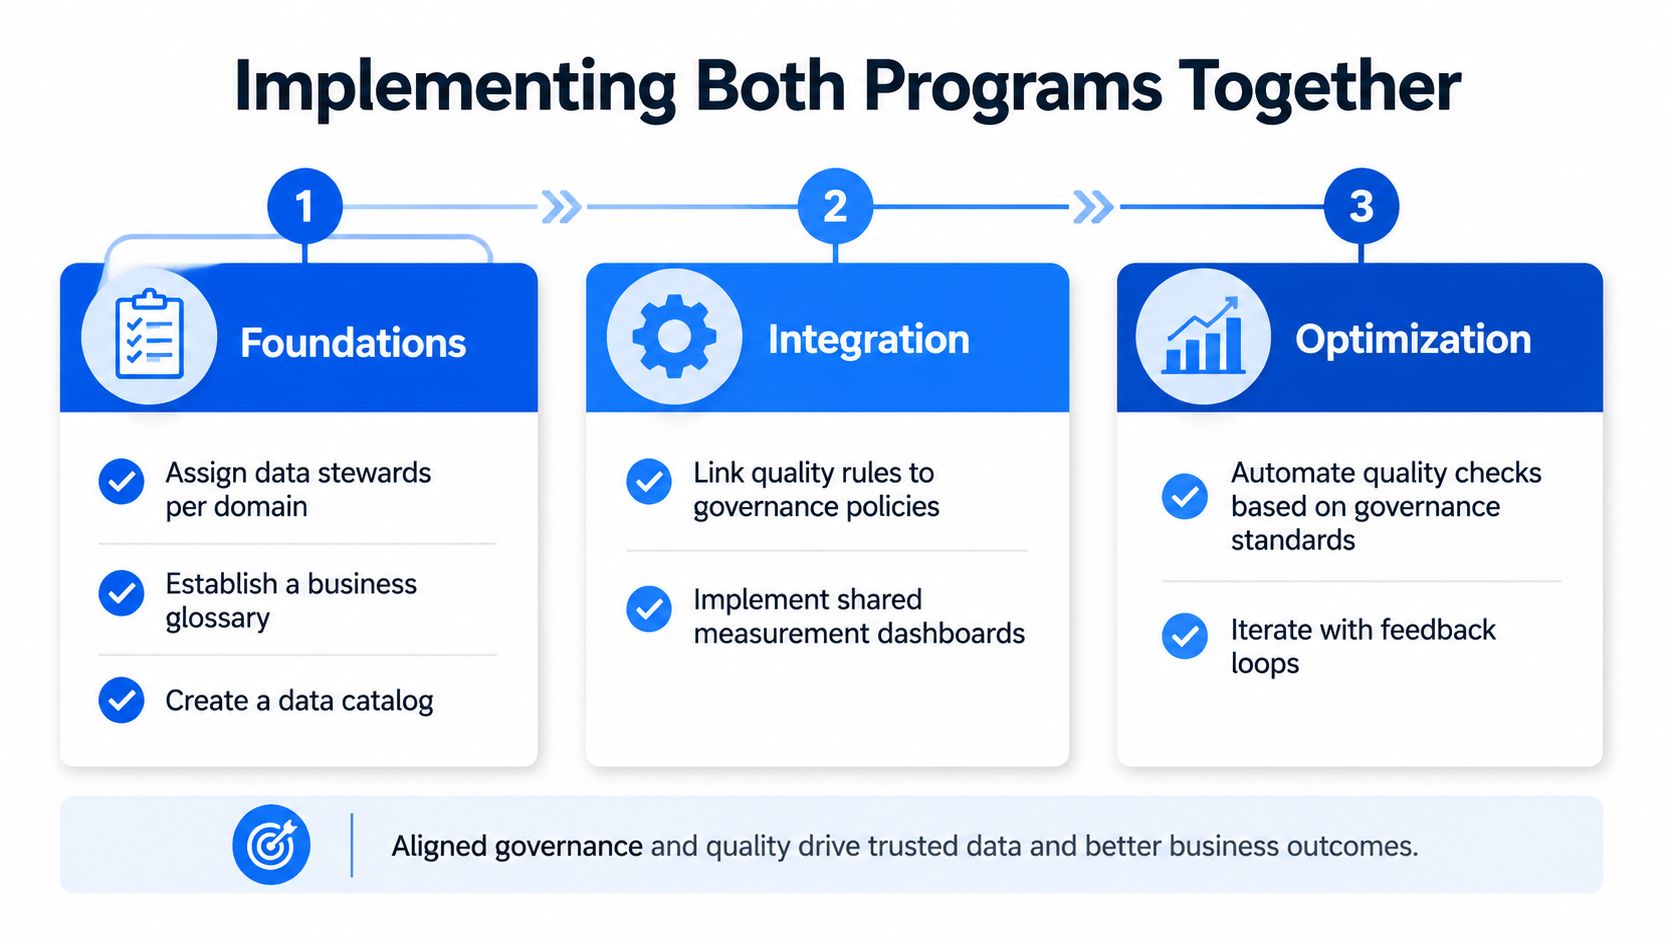
Die erste Phase ist einfache Arbeit, und sie zahlt sich normalerweise aus. Weisen Sie Daten-Stewards nach Domänen zu, definieren Sie ein kontrolliertes Vokabular und registrieren Sie die wichtigsten Bestände in einem Katalog mit beschreibenden Metadaten. Ohne diese Grundlagen streiten sich die Teams bei jedem fehlerhaften Bericht über Namen, Definitionen und Zuständigkeiten.
Eine saubere Einführung beginnt in der Regel mit folgender Abfolge:
Benennen Sie Stewards nach Domänen. Legen Sie explizit fest, wer für Finanz-, Kunden-, Produkt- oder Betriebsdaten verantwortlich ist.
Definieren Sie Gold-Records. Entscheiden Sie, welches System oder welche Tabelle die Referenz ist, wenn nachgelagerte Kopien voneinander abweichen.
Veröffentlichen Sie das Glossar. Verknüpfen Sie Geschäftsberiffe mit technischen Feldern, damit die Leute aufhören, dieselben Wörter unterschiedlich zu verwenden.
Katalogisieren Sie die Bestände. Registrieren Sie wichtige Datensätze, Eigentümer und Beschreibungen, damit Benutzer die richtige Quelle schneller finden können.
Fügen Sie die Durchsetzung hinzu und automatisieren Sie dann die Messung
Sobald das Fundament steht, fügen Sie Klassifizierung, Lineage und Richtliniendurchsetzung hinzu. Sensible Felder sollten gekennzeichnet, Verträge dokumentiert und die Lineage dort erfasst werden, wo sich die Daten bewegen. Dies verleiht der Governance an dem Punkt, an dem Daten erstellt und geändert werden, Durchsetzungskraft, während Qualitätsprüfungen auf einer bekannten Eigentümerschaft basieren können, anstatt auf anonymen Warnungen.
Der nächste Schritt ist die Automatisierung. Qualitätsprüfungen sollten Timeliness, Schema-Drift und Regelverstöße überwachen, ohne darauf zu warten, dass jemand eine Stichprobe manuell prüft. Die SLA-Überwachung gehört ebenfalls hierher, da „frisch genug“ eine Geschäftserwartung und nicht nur eine technische Anforderung ist. Wenn Qualitätsvorfälle auftreten, sollte das System diese an den Steward oder Eigentümer weiterleiten und sie nicht in einer Warteschlange liegen lassen.
Schließen Sie den Kreis mit Berichterstattung und Behebung
Die letzte Phase ist diejenige, die zu viele Teams überspringen. Das Executive-Reporting sollte Vertrauens-KPIs, Vorfalltrends und den offenen Behebungsrückstand aufzeigen. Der Rückkopplungspfad von Qualitätsproblemen zurück in die Governance hält die Richtlinienebene ehrlich. Wenn eine Richtlinie wiederholt Ausnahmen erzeugt, muss sie überarbeitet werden. Wenn ein Datensatz immer wieder an derselben Regel scheitert, muss die Kontrolle verschärft werden.
Ein nützlicher operativer Ablauf ist einfach. Stewards zuweisen, Gold-Records definieren, Daten klassifizieren, Lineage kodifizieren, SLAs festlegen, Prüfungen automatisieren, vierteljährlich berichten und Erkenntnisse in die Richtlinien zurückführen. Diese Abfolge bewährt sich, weil sie Kontrolle und Messung verbindet, anstatt sie als separate Arbeitsströme zu behandeln.
Wo eine Plattform wie digna ins Spiel kommt
Eine Engine für Kontrollen und Messungen
Viele Teams flicken einen Katalog, ein Qualitätswerkzeug und einen separaten Observability-Stack zusammen und verbringen dann Monate damit, nicht zusammenpassende Metadaten abzugleichen. Eine einzige In-Database-Plattform kann diese Reibungsverluste beseitigen, wenn sie Governance und Qualität im selben Workflow vereint. In digna lassen sich die relevanten Module sauber auf beide Ebenen abbilden, was wichtig ist, da derselbe Datensatz, derselbe Eigentümer und dieselbe Vorfallshistorie nicht in drei voneinander getrennten Systemen leben sollten.
Hier ist die praktische Aufteilung.
digna-Modul | Rolle in der Governance | Rolle in der Qualitätssicherung |
|---|---|---|
Data Catalog | Registriert Bestände, Eigentümerschaft und Kontext | Hilft Teams, Prüfungen auf den richtigen Datensatz einzugrenzen |
Data Lineage | Zeigt Abhängigkeiten und Transformationspfade | Beschleunigt die Ursachenanalyse bei fehlgeschlagenen Prüfungen |
Data Classification | Markiert sensible oder regulierte Felder | Steuert, welche Regeln und Monitore gelten |
Data Dictionary | Standardisiert die geschäftliche Bedeutung | Reduziert Unklarheiten in der Validierungslogik |
Policy Enforcement | Wendet Zugriffs- und Handhabungsregeln an | Verhindert Regelverstöße, bevor sie sich ausbreiten |
Data Contracts | Dokumentiert die erwartete Struktur und das Verhalten | Definiert die Bedingungen, die Prüfungen verifizieren sollten |
Data Observability | Unterstützt die operative Sichtbarkeit | Verfolgt Verhalten, Aktualität und Drift |
Data Quality Rules | Kodiert Governance-Erwartungen | Validiert Datensätze und Geschäftslogik |
Validation | Setzt geschäftliche und technische Regeln durch | Erzeugt Erfolgs- oder Fehlernachweise |
Anomaly Detection | Warnt bei ungewöhnlichem Verhalten | Zeigt unerwartete Änderungen ohne manuelle Regeleinrichtung auf |
SLA Monitoring | Misst die Einhaltung von Zusagen bezüglich der Timeliness | Kennzeichnet Verzögerungen, fehlende Ladevorgänge und Verletzungen der Aktualität |
Automated Quality Scoring | Bietet eine Ergebnissicht auf den Zustand der Kontrollen | Fasst die Eignung von Daten im Zeitverlauf zusammen |
Der nützliche Teil ist nicht die Modulliste an sich. Es ist die Tatsache, dass Governance-Metadaten und Qualitätsmessungen in derselben Engine und derselben Datenbank leben. So kann eine fehlgeschlagene Metrik in einem einzigen Arbeitsablauf direkt auf die maßgebliche Richtlinie und den verantwortlichen Eigentümer zurückgeführt werden. Das ist der Unterschied dazwischen, Tickets über Teams hinweg zu jagen, oder den Kreis an einem einzigen Ort zu schließen.
Wenn Sie eine breitere Observability-Perspektive wünschen, hilft die Übersicht über Data Observability zu verstehen, wie das Laufzeitverhalten, und nicht nur statische Metadaten, Teil des Vertrauensbetriebs wird. Für Teams, die sich entscheiden müssen, wo sie anfangen sollen, ist eine Plattform, die beide Ebenen abdeckt, oft einfacher zu operationalisieren als eine lose Sammlung von Einzellösungen.
In welche Disziplin man zuerst investieren sollte
Passen Sie den Startpunkt an den aktuellen Schmerzpunkt an
Teams mit geringem Reifegrad sollten mit den Governance-Grundlagen beginnen. Eigentümerschaft, Lineage und Katalog-Grundlagen geben ihnen eine Struktur, bevor sie Qualitätswerten hinterherjagen, die sie nicht erklären können. Teams, die sich einer aktiven regulatorischen Prüfung unterziehen müssen, benötigen in der Regel zuerst Qualitätskontrollen, da sie prüfbare Belege dafür benötigen, dass sich die Daten wie erwartet verhalten. Teams, die sich auf KI oder fortgeschrittene Analysen vorbereiten, sollten Governance und Qualität parallel aufbauen, da das Vertrauen in Modelle sowohl von der Kontrolle als auch von der Eignung abhängt.
Die Abwägung ist einfach. Wenn Sie Governance überspringen, erhalten Sie vereinzelte Qualitätserfolge, die nicht skalierbar sind. Wenn Sie Qualität überspringen, erhalten Sie ein ausgefeiltes Framework ohne messbare Ergebnisse. Die meisten Organisationen benötigen beides, aber die Reihenfolge sollte sich nach dem Problem richten, das sie zu lösen versuchen.
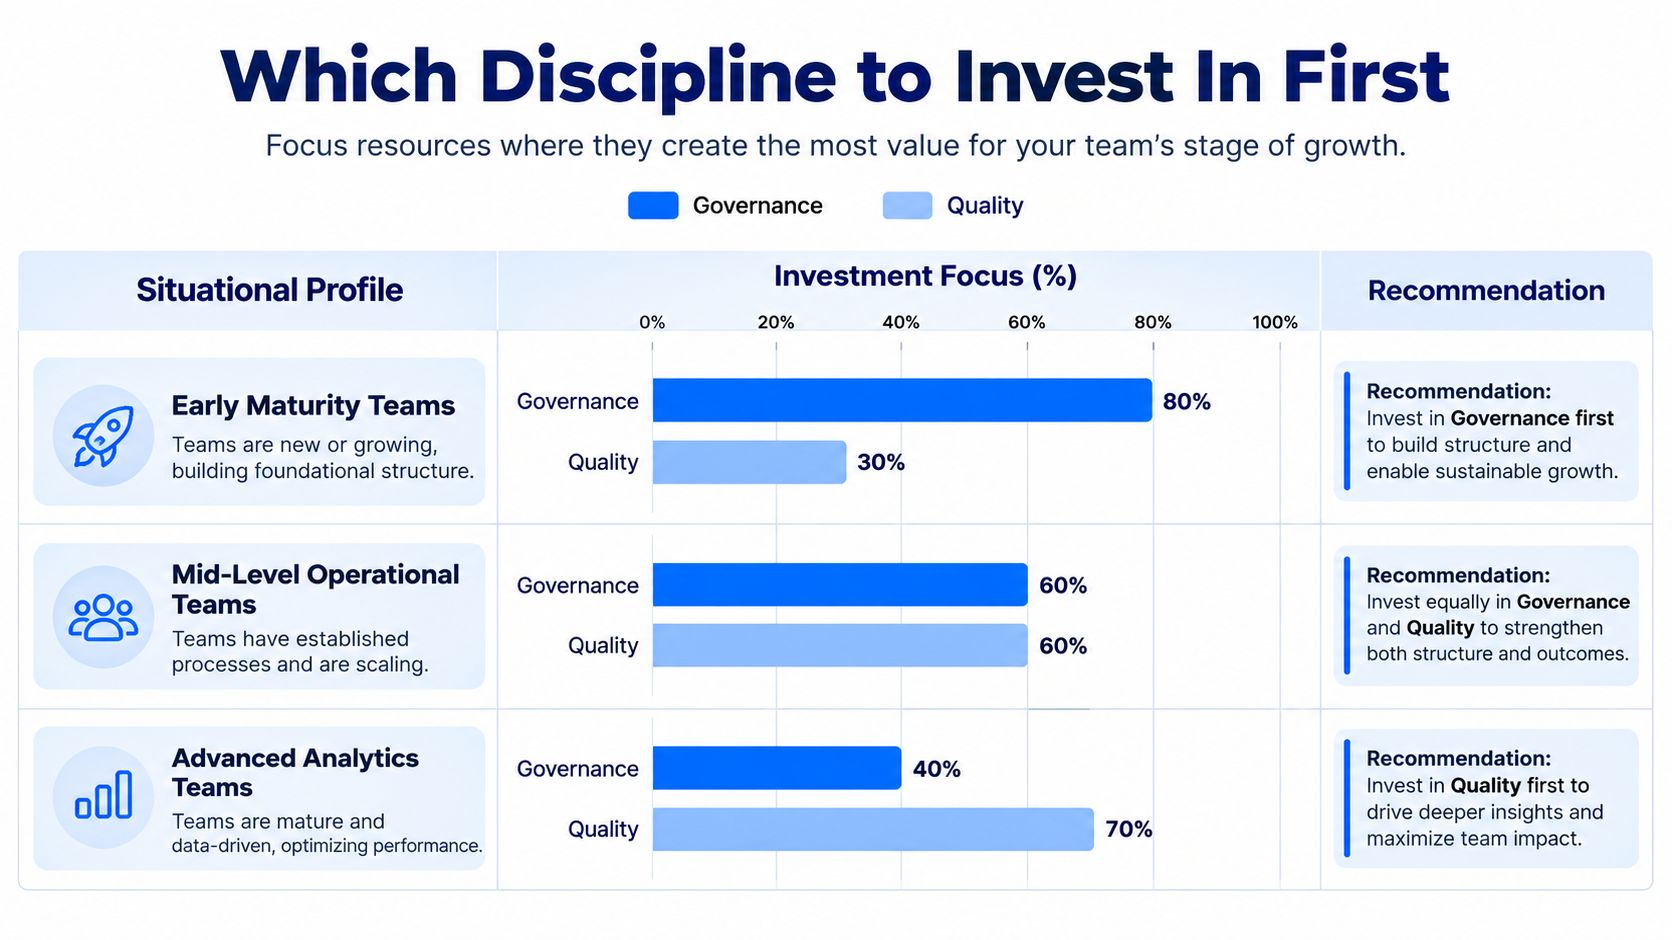
Eine einfache Entscheidungsheuristik bewährt sich in der Praxis. Wenn der Schmerz in der Verwirrung über die Eigentümerschaft liegt, beginnen Sie mit Governance. Wenn der Schmerz in fehlerhaften Belegen liegt, beginnen Sie mit Qualitätskontrollen. Wenn der Schmerz in der KI-Bereitschaft liegt, tun Sie beides zusammen und halten Sie die Kontrollen und Messungen im selben operativen Kreislauf.
digna bietet Teams einen zentralen Ort, um diese Kreisläufe innerhalb ihrer eigenen Umgebung zu verwalten – mit Modulen für Katalogisierung, Lineage, Klassifizierung, Richtliniendurchsetzung, Validierung, Anomalieerkennung und SLA-Überwachung. Wenn Sie versuchen, Governance-Kontrollen mit messbaren Ergebnissen der Datenqualität zu verbinden, ohne unzusammenhängende Tools zusammenzuflicken, besuchen Sie digna und prüfen Sie, wie eine einzige In-Database-Plattform in Ihren Daten-Stack passt.
Häufig gestellte Fragen
Wie trennt man beide am schnellsten?
Behandeln Sie Governance als Kontrollsystem und Qualität als messbare Ausgabe. Governance beantwortet, wer entscheidet, steuert und für Daten einsteht; Qualität beantwortet, ob die Daten für ihren Zweck geeignet sind.
Was produziert jede Disziplin?
Unterschiedliche Artefakte. Governance produziert Richtlinien, Verantwortung, Lineage, Zugriffsregeln und Eskalationswege. Qualität produziert gemessene Datensätze, validierte Regeln, Anomalie-Alerts und Bewertungen. Die Ausgaben zu verwechseln führt dazu, dass ein Team eines hat und beides annimmt.
Was steuert jede von beiden?
Governance steuert Entscheidungsrechte und Abläufe, Qualität steuert Datensatzverhalten und Integrität auf Satzebene. Diese Teilung erklärt, warum ein Governance-Programm gesund sein kann, während Produktionsdaten es nicht sind, und warum auch der umgekehrte Fall vorkommt.
Was gilt jeweils als Nachweis?
Für Governance: Abdeckung, Nutzung, Auditbereitschaft und MTTR. Für Qualität: Genauigkeit, Vollständigkeit, Aktualität, Konsistenz, Validität und Eindeutigkeit. Nach dem falschen Nachweis zu fragen ist der Grund, warum Review-Termine so oft ohne Schluss enden.
Worin sollte man zuerst investieren?
In den derzeit sichtbaren Fehler. Eine Finanzchefin, die über Nacht 14 % Schwankung im Umsatz-Dashboard sieht, hat ein Qualitätssymptom, und die schnellste Entwirrung beginnt damit, die Ausgabe zu messen, bevor man das Kontrollsystem darum herum neu baut.



