Data Quality vs. Data Governance: Ein praktischer Leitfaden für 2026
|
6
min. Lesezeit

Gängige Ratschläge behandeln Datenqualität und Data Governance wie separate Arbeitsströme und wundern sich dann, warum Teams immer noch in fehlerhaften Dashboards, inkonsistenten Definitionen und Audit-Rauschen ertrinken. In der Praxis erleben Käufer dies nicht auf diese Weise. Sie erleben ein einziges operatives Problem, das Datenvertrauen, und sie benötigen die Regeln, die Messungen und die Durchsetzung, um innerhalb der Pipeline zusammenzuarbeiten.
Diese Aufteilung ist wichtig, da Governance auf dem Papier existieren kann, während die Qualität in der Produktion zusammenbricht. Eine weltweite Umfrage aus dem Jahr 2024 ergab, dass 64% der Befragten die Datenqualität als ihre größte Herausforderung bei der Datenintegrität nannten, während 51% Data Governance nannten und 71% angaben, dass ihr Unternehmen bereits über ein Governance-Programm verfügt (Precisely). Das ist das Kernmuster in modernen Datenstacks: Die Richtlinienakzeptanz steigt, aber der operative Schmerz zeigt sich immer noch auf Datensatz- und Pipeline-Ebene.
Inhaltsverzeichnis
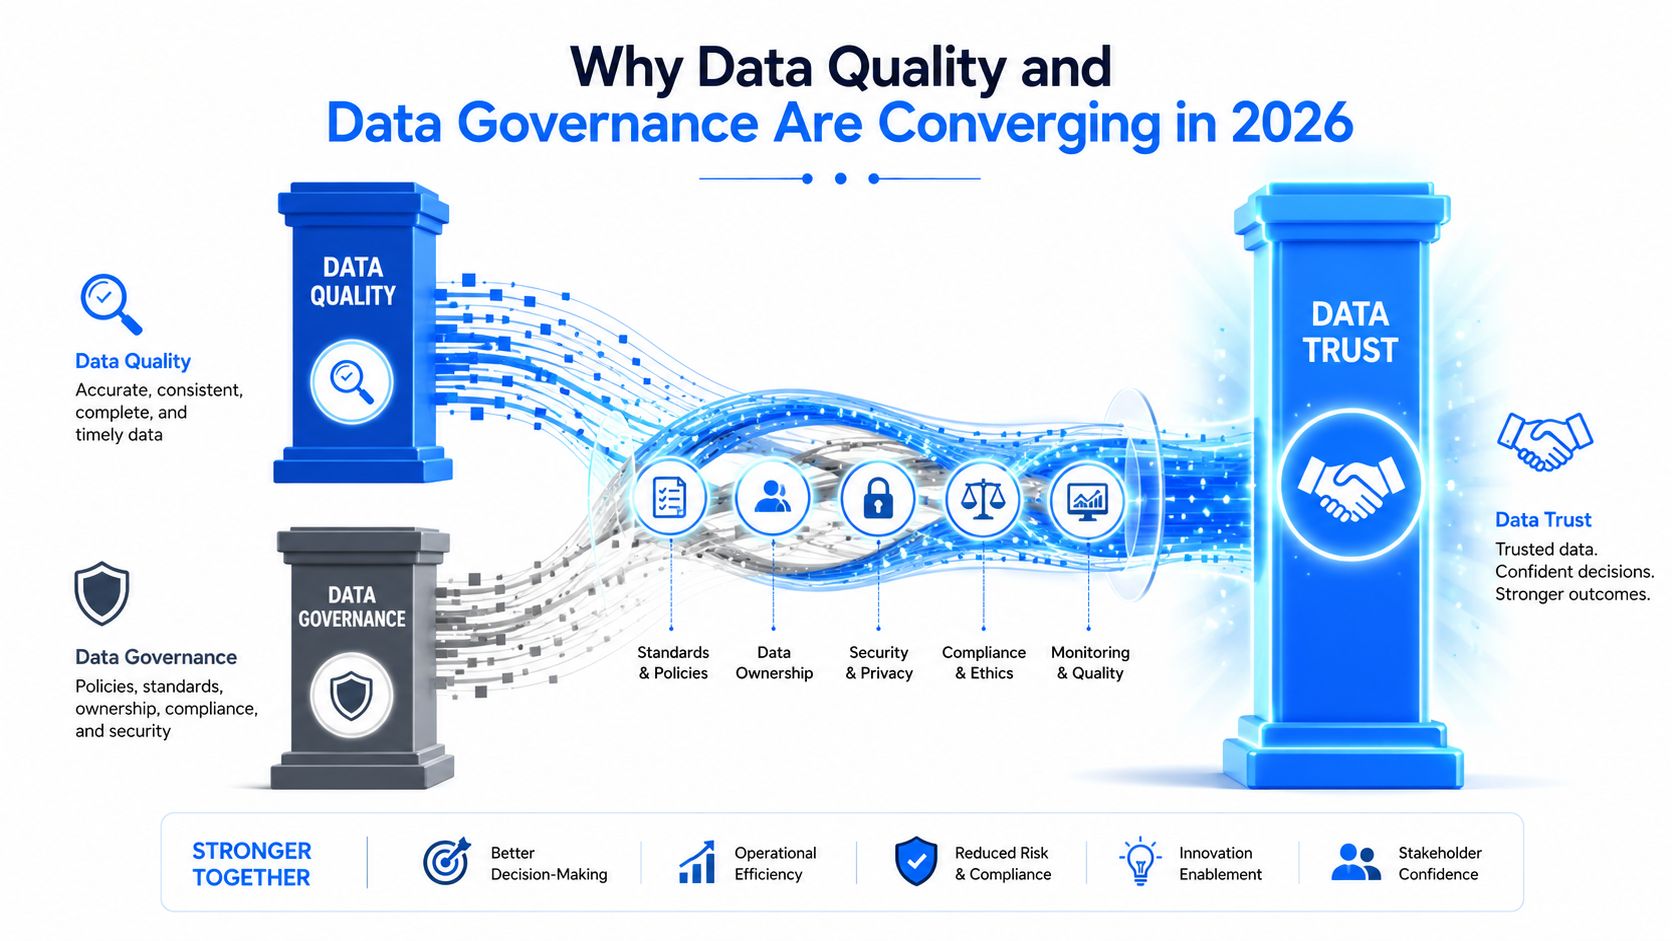
Warum Datenqualität und Data Governance im Jahr 2026 konvergieren
Implementierungsschritte, Checklisten und die passende Tool-Landschaft
Warum Datenqualität und Data Governance im Jahr 2026 konvergieren
Die alte Sichtweise besagt, dass Datenqualität bei Ingenieuren und Analysten angesiedelt ist, während Data Governance bei Richtlinienteams und Stewards liegt. Das klingt auf dem Papier sauber, bricht aber in sich zusammen, sobald sich eine Pipeline ändert, ein zertifizierter Datensatz ein Dashboard für die Geschäftsführung speist oder ein KI-Workflow von einem Feld abhängt, das zur Laufzeit von niemandem validiert wurde.
Die Marktbeweise deuten auf Konvergenz hin, nicht auf Trennung. In derselben Umfrage von 2024 nannten 64% der Unternehmen Datenqualität als ihre größte Herausforderung bei der Datenintegrität und 51% nannten Data Governance, während 62% angaben, dass mangelnde Governance das Haupthindernis für die KI-Bereitschaft sei (Bigeye-Trendberichterstattung). Das zeigt Ihnen, dass Käufer nicht nach zwei unzusammenhängenden Toolsets suchen. Sie versuchen, ein einziges Zuverlässigkeitsproblem über Kataloge, Pipelines und nachgelagerte Entscheidungen hinweg zu lösen.
Governance ist nur wichtig, wenn sie das Verhalten ändert
Eine Richtlinie, die die Pipeline nie erreicht, ist ungenutztes Beiwerk. Eine Überprüfung, die ohne jeglichen Eigentümerkontext fehlschlägt, ist nur Rauschen. Die Konvergenz im Jahr 2026 wird durch die Tatsache vorangetrieben, dass Unternehmen Governance als messbares Signal benötigen, nicht als statische Dokumentationsebene.
Praktische Regel: Wenn eine Regel nicht dort durchgesetzt werden kann, wo sich Daten bewegen, verringert sie das Risiko nicht.
Aus diesem Grund rücken Lineage, Richtliniendurchsetzung und kontinuierliche Validierung jetzt näher zusammen. Standards wie ISO 8000 verknüpfen Datenqualität explizit mit Data Governance, Datenqualitätsmanagement und Reifegradbewertung und betonen, dass Qualität durch Beschreibung, Herkunft und verlustfreien Austausch messbar und verifizierbar sein muss (ISO 8000-1). Die praktische Konsequenz ist einfach: Richtlinien müssen im selben operativen System ausgedrückt werden, das fehlende Felder, veraltete Ladevorgänge und Schema-Drift abfängt.
Für Teams, die Observability- und Governance-Programme vergleichen, wird die Grenze oft klarer, wenn man sich Kontrollen im Vergleich zu Signalen ansieht. Der Unterschied zwischen diesen beiden zeigt sich in der Praxis im Leitfaden für Data Observability vs. Datenqualität, wo die Frage weniger lautet „Welches Team ist dafür verantwortlich?“ sondern vielmehr „Wo wird die Kontrolle ausführbar?“
Was Datenqualität in der Praxis tatsächlich bedeutet
Datenqualität ist kein Gefühl und kein Katalogfeld. Sie ist der messbare Zustand eines Datensatzes zu einem bestimmten Zeitpunkt, bewertet danach, ob die Datensätze konkrete Regeln erfüllen. Die operativen Dimensionen, auf die es am meisten ankommt, sind Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Eindeutigkeit und Gültigkeit.
Die Microsoft-Leitlinien für Cloud-Scale Analytics bieten nützliche Arbeitsdefinitionen für diese Dimensionen. Sie behandeln Vollständigkeit als den Anteil von Nicht-Null- und Nicht-Leerwerten, Eindeutigkeit als den Anteil von nicht-duplizierten Werten, Konsistenz als Musterkonformität, Gültigkeit als Referenzabgleich und Genauigkeit als erfolgreiche Reproduktion der beabsichtigten Werte (Microsoft-Leitfaden für Cloud-Scale Analytics). Staatliche Leitlinien trennen zudem Timeliness von den anderen Dimensionen ab, indem sie sich darauf konzentrieren, ob die Daten den Zeitraum widerspiegeln, den sie repräsentieren, und ob die Verzögerung vor der Bereitstellung für die Nutzung angemessen ist (staatliches Datenqualitäts-Framework).
Sechs Kerndimensionen in der Praxis
Dimension | Fehlerbeispiel | Erkennungsmethode |
|---|---|---|
Genauigkeit | Eine Kundenadresse ist falsch gespeichert | Abgleich mit einer vertrauenswürdigen Quelle oder einem nachgelagerten System |
Vollständigkeit | Ein Pflichtfeld bleibt leer | Nicht-Null-Regel oder Prüfung der Rate fehlender Felder |
Konsistenz | Zwei Tabellen stimmen beim gleichen Statuscode nicht überein | Feldübergreifende oder tabellenübergreifende Data Validation |
Timeliness | Ein Umsatz-Feed trifft zu spät für den Abschluss ein | Aktualitätsprüfung gegen die erwartete Ankunftszeit |
Eindeutigkeit | Die gleiche Rechnung erscheint doppelt | Duplikaterkennung auf dem Business Key |
Gültigkeit | Ein Wert liegt außerhalb des zulässigen Formats oder Referenzsatzes | Schema-, Regex- oder Referenzvalidierung |
Die Richtlinie der University of Oklahoma listet Genauigkeit, Vollständigkeit, Konsistenz, Timeliness und Gültigkeit auf und beschreibt ausgefüllte Regeln als eine Möglichkeit, Stewards auf verdächtige Datensätze aufmerksam zu machen, die eine Behebung erfordern (OU-Datenqualitätsrichtlinie). Das ist der entscheidende Punkt. Qualität lebt in Regeln, Prüfungen, Baselines und Ausnahmen, nicht in der Dokumentation allein.
Wenn Sie dies in ein Betriebsmodell integrieren, benötigen Engineering-Verantwortliche in der Regel eine eher implementierungsorientierte Referenz als ein Glossar. Ein nützlicher Leitfaden für Engineering-Verantwortliche kann Teams dabei helfen, darüber nachzudenken, wo Qualitätsprüfungen in das Data-Warehouse- und Pipeline-Design gehören. Das richtige mentale Modell ist strukturelle Qualität plus semantische Qualität. Die strukturelle Qualität fragt, ob ein Feld existiert, korrekt typisiert ist und pünktlich eintrifft. Die semantische Qualität fragt, ob der Wert für den Geschäftsprozess, den er darstellt, Sinn ergibt.
Für eine tiefergehende Aufschlüsselung, wie diese Dimensionen den täglichen Kontrollen zugeordnet werden, ist der Leitfaden zu den Dimensionen der Datenqualität ein praktischer Begleiter. Wichtig ist es, das Vokabular operativ zu halten. SLAs, Data Contracts und Observability-Signale sind nur dann von Bedeutung, wenn sie auf ein Verhalten auf Datensatzebene hinweisen, das Sie testen können.
Was Data Governance in der Praxis tatsächlich bedeutet
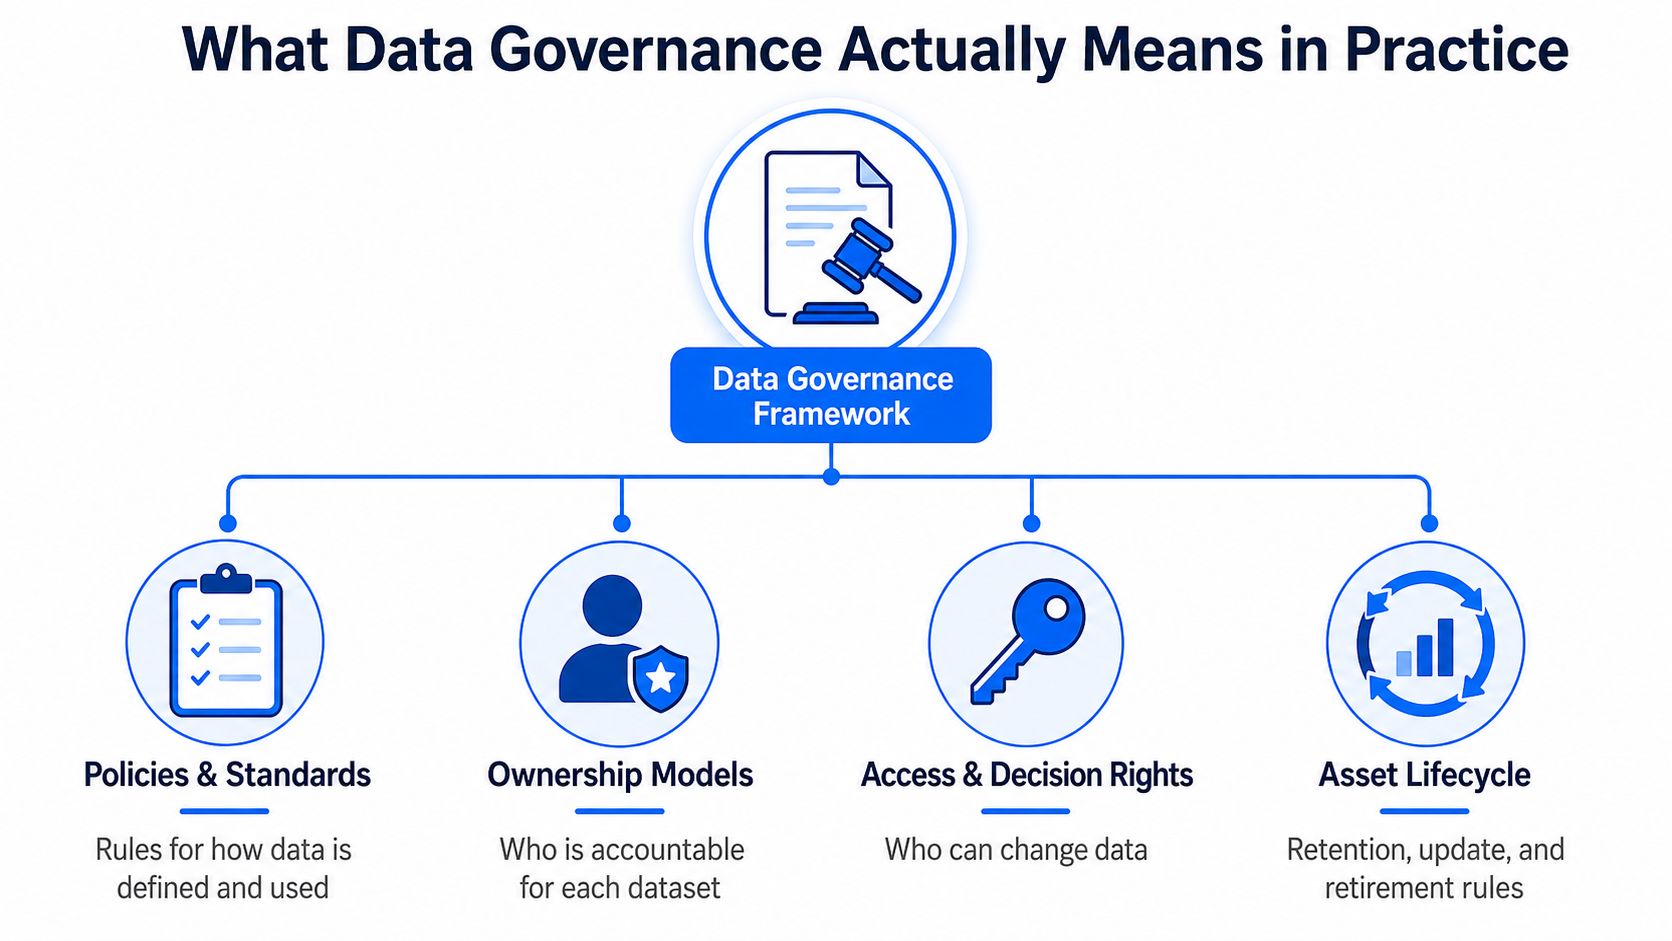
Data Governance ist das Kontrollsystem rund um Daten – die Richtlinien, Eigentumsmodelle, Standards und Entscheidungsrechte, die bestimmen, wer Datenbestände definieren, ändern, darauf zugreifen und sie außer Kraft setzen darf. Während die Qualität fragt, ob ein Datensatz vertrauenswürdig ist, fragt die Governance, ob das Unternehmen die Kontrolle, Rechenschaftspflicht und Richtliniendurchsetzung über den gesamten Bestand hinweg nachweisen kann.
In der Praxis wird dies zu einer Reihe von Artefakten, auf die man sich beziehen kann. Ein Katalogeintrag benennt das Asset. Ein Glossarbegriff definiert die geschäftliche Bedeutung. Eine Stewardship-Zuweisung macht jemanden verantwortlich. Eine Zugriffsrichtlinie definiert, wer das Asset sehen oder nutzen darf. Eine Aufbewahrungsregel legt fest, wie lange es verbleibt. Ein Data Contract legt die Bedingungen fest, unter denen sich Produzenten und Konsumenten darauf verlassen können.
Dokumentation ist nicht dasselbe wie Kontrolle
Die Kluft zwischen Alibi-Governance und funktionierender Governance ist riesig. Ein Katalog voller Begriffe verhindert keinen fehlerhaften Ladevorgang. Eine vierteljährliche Überprüfung fängt keine Schemaänderung ab, die um 7 Uhr morgens einen Finanzbericht unbrauchbar macht. Moderne Käufer erwarten zunehmend, dass Governance als durchsetzbare Ebene und nicht als Dokumentenbibliothek funktioniert.
Governance wird real, wenn sie den Zugriff, die Definitionen und die Lebenszyklus-Entscheidungen regelt, die Teams in der Produktion tatsächlich spüren.
Deshalb sind Lineage und Policy-as-Code so wichtig. Ein Governance-Modell, das nicht zeigen kann, woher ein Feld stammt, wer es genehmigt hat und welche Regeln dafür gelten, ist für moderne Cloud- und KI-Stacks zu schwach. Der praktische Bezugspunkt ist oft die domänenbasierte Eigenverantwortung, bei der eine Finanz-, Kunden- oder Produktdomäne explizite Stewards und Überprüfungspfade hat, anstatt eines generischen Unternehmenskomitees.
Wenn Sie Governance-Ansätze in regulierten Umgebungen vergleichen, ist der Bridge Global Leitfaden zur Data Governance im Gesundheitswesen ein nützliches Beispiel dafür, wie Zugriffs-, Rechenschafts- und Lebenszyklusregeln in einem realen Branchenkontext aussehen. Dieselbe Logik gilt auch außerhalb des Gesundheitswesens, nur mit anderen Domänengrenzen und Nachweisanforderungen.
Für die Strategiearbeit ist der Leitfaden zur Data-Governance-Strategie nützlich, weil er den Fokus auf das Betriebsmodell und nicht auf Slogans legt. Governance ist am stärksten, wenn sie die Spielregeln festlegt und dann durch prüfbereite Nachweise belegt, dass diese Regeln auch eingehalten werden. Das ist die Trennlinie zwischen einem Programm, das man nur erwähnt, und einer Kontrollebene, auf die man sich verlässt.
Datenqualität vs. Data Governance im direkten Vergleich
Der schnellste Weg, die beiden zu trennen, ist der Vergleich ihres Verhaltens im realen Betrieb. Governance definiert die Grenzen, Qualität prüft die Bytes. Governance beantwortet, wer das Asset besitzt und welche Regeln gelten, während Qualität beantwortet, ob die Daten diese Regeln bei diesem Durchlauf bestanden haben.
Dimension | Data Governance | Datenqualität |
|---|---|---|
Umfang | Definitionen, Richtlinien, Lineage, Zugriff, Lebenszyklus | Messung, Validierung, Anomalieerkennung, Behebung |
Verantwortlichkeit | Stewardship-Gremien, CDO-geführte Programme, Domänenverantwortliche | Analytics Engineers, Datenplattform-Teams, Pipeline-Verantwortliche |
Primäre Metriken | Katalogabdeckung, Richtlinienabdeckung, Lineage-Abdeckung, Abschluss von Zugriffsüberprüfungen, prüfbereite Nachweise | Aktualität, Vollständigkeit, Gültigkeit, Eindeutigkeit, Genauigkeit, Duplikatsrate, Rate fehlender Felder |
Tool-Kategorie | Kataloge, Lineage-Graphen, Richtlinien-Engines, Zugriffstools | Data Observability, Profiling, Validierungs-Frameworks, Vertragstests |
Rhythmus | Periodische Überprüfungszyklen, oft vierteljährlich oder jährlich bei Richtlinienänderungen | Kontinuierlich, eingebettet in CI/CD und Pipeline-Durchläufe |
Governance beginnt in der Regel mit Fragen zur Designzeit. Wer darf die Tabelle ändern. Was gilt als Source of Truth. Welche Domänen benötigen eine Genehmigung, bevor ein Feld außer Kraft gesetzt wird. Qualität beginnt zur Laufzeit. Ist der Datensatz eingetroffen, hat er die Validierung bestanden, hat sich die Verteilung verschoben, hat der Ladevorgang sein Zeitfenster verpasst.
Ein häufiger Fehler ist es, von Governance-Tools Qualitätsarbeit zu verlangen. Ein Katalog kann Ihnen den Eigentümer einer Tabelle nennen, und ein Lineage-Graph kann die Auswirkungen aufzeigen, aber keiner von beiden beweist, dass die Rechnungs-ID heute Abend eindeutig ist. Die in den Forschungsnotizen erwähnte Banken-Fallstudie zeigt das komplementäre Muster deutlich. Governance-Mechanismen wie Leistungsmessung, Compliance-Überwachung und Schulungen halfen, Datenqualitätsprobleme zu mindern, aber die eigentliche Qualitätsarbeit hing immer noch von operativen Prüfungen ab, nicht von Metadaten allein (White Rose Forschung).
Wo die Überschneidung tatsächlich liegt
Die Überschneidung liegt bei SLAs, Data Contracts und dem Incident Management. Governance definiert die Erwartung, Qualität setzt sie durch, und beide werden in denselben Eskalationspfad gezogen, wenn ein Asset ausfällt. In einem ausgereiften Stack ist die Grenze zwar sichtbar, aber nicht starr.
Der praktische Unterschied zeigt sich auch in den Nachweisen. Governance liefert Richtlinieneinträge, Lineage-Verläufe und Zugriffsgenehmigungen. Qualität liefert Erfolgsquoten, Fehleranzahlen und das Alter ungelöster Probleme. Das eine ist eine Kontrollebene, das andere eine Erkennungsebene, und moderne Teams benötigen beide.
Rollen, Metriken und Prozesse, die beide verbinden
Die sauberste Brücke zwischen Governance und Qualität schlagen die Person, die die Definition besitzt, und die Person, die den Test schreibt. Ein Data Steward entscheidet, wie ein akzeptabler Wert aussieht. Ein Analytics Engineer oder Data Engineer codiert diese Entscheidung als ausführbare Regel. Ein Data Product Owner bleibt für die vollständige Zuverlässigkeit des Domänen-Datensatzes verantwortlich. Das Plattform-Team stellt die gemeinsame Monitoring-Ebene bereit.
Diese Arbeitsteilung ist wichtig, da die Aufgaben sich in unterschiedlichen Geschwindigkeiten bewegen. Die Governance-Arbeit umfasst das Erstellen von Richtlinien, die Kataloganreicherung, die Lineage-Verifizierung, Zertifizierungen von Zugriffen und die Überprüfung regulierter Prozesse. Die Qualitätsarbeit umfasst Schemaüberprüfungen, statistisches Profiling, Anomalie-Scoring, Aktualitätsüberwachung und die Triagierung von Vorfällen. Es sind separate Aufgaben, aber sie benötigen dieselbe Asset-Identität.
Das Bindeglied ist der Vertrag
Ein Data Contract ist der Punkt, an dem die beiden Disziplinen ohne Ausflüchte aufeinandertreffen. Governance spezifiziert den Vertrag, Qualität setzt ihn durch, und die Plattform misst, ob der Vertrag eingehalten wird. Die KPIs sollten diese gemeinsame Realität widerspiegeln, wobei Vertragskonformitätsrate, mittlere Zeit bis zur Erkennung (MTTD) und mittlere Zeit bis zur Behebung (MTTR) in einer einzigen Executive-Ansicht des Datenvertrauens zusammengefasst werden.
Praktische Regel: Wenn ein Steward einen Schwellenwert definiert, sollte die Pipeline diesen automatisch testen und der On-Call-Pfad sollte wissen, wer das Asset besitzt.
Ein einfaches, praktisches Beispiel verdeutlicht dies. Ein Steward legt einen Nullwert-Schwellenwert für customer.email fest. Ein Analytics Engineer wandelt diesen Schwellenwert mithilfe eines Frameworks wie Soda oder dbt in einen Test um. Die Plattform sendet einen Slack-Alarm, öffnet ein Jira-Ticket und verknüpft beides mit dem verwalteten Asset im Katalog. Das ist nicht nur ein Alarmierungs-Workflow. Das ist ausführbar gewordene Governance.
Wenn Sie eine Referenz auf Rollenebene für diese Aufteilung suchen, bietet der Leitfaden für Rollen und Verantwortlichkeiten in der Datenqualität genau die richtige operative Formulierung. Er ist besonders nützlich, wenn Teams entscheiden, welche Verantwortlichkeiten bei Stewards, Engineers und Plattform-Eigentümern liegen.
Die wichtige Schlussfolgerung ist, dass Governance-Metriken und Qualitätsmetriken nicht miteinander konkurrieren. Sie ergänzen sich. Governance beweist, dass die Kontrollumgebung existiert; Qualität beweist, dass die Kontrollen schlechte Daten abfangen, bevor sie in Berichte, Modelle oder Vorstandsunterlagen einfließen.
Ein reales Szenario, in dem beide eine Rolle spielen
Ein monatlicher Umsatzabschluss ist einer der schnellsten Wege, den Unterschied zwischen Richtlinie und Ausführung aufzuzeigen. Die Finanzdomäne ist zertifiziert. Die Umsatztabelle hat einen dokumentierten Eigentümer. Die Lineage lässt sich von Stripe über das Data Warehouse bis zu Tableau nachverfolgen. Der Zugriff ist auf eine namentlich genannte Gruppe beschränkt. Auf der Qualitätsseite gibt es einen Eindeutigkeitstest auf invoice_id, ein Aktualitäts-SLA von 4 Stunden und eine Prüfung auf Nicht-Nullwerte bei settlement_amount.
Dann ändert Stripe die Struktur seiner API. Das Feld settlement_amount fällt aus dem Feed weg. Die Aktualität verzögert sich auf 6 Stunden. Die Eindeutigkeitsprüfung schlägt fehl, da im Zuge eines Wiederholungsversuchs doppelte Rechnungs-IDs eintreffen. Nichts davon ist abstrakt. Es ist genau die Art von Fehler, die mitten im Abschluss auftritt.
Wie der Vorfall beide Ebenen durchläuft
Das Observability-Tool sendet eine Warnmeldung an den diensthabenden Analytics Engineer. Der Lineage-Graph zeigt, dass das nachgelagerte Umsatz-Dashboard betroffen ist. Da das Asset zertifiziert ist, wird auch der Data Steward benachrichtigt. Der Vorfall wird im Governance-Katalog mit Eigentümer, Schweregrad und Behebungszeitplan protokolliert. Nach der Behebung aktualisiert das Post-Mortem den Vertrag und fügt eine Prüfung auf Schema-Drift hinzu.
Diese Abfolge ist wichtiger als die einzelnen Alarme. Die Qualität hat den Fehler gefunden. Die Governance bestimmte, wer sich darum kümmern musste, wie der Nachweispfad aussehen musste und wie sich der Status des Assets änderte, während das Problem offen war.
Das operative Risiko ist nicht theoretisch. Eine doppelte Rechnung blähte den ARR um 1,2 Prozent auf, was ohne Eingreifen an den Vorstand berichtet worden wäre. In einem Finanz-Workflow ist das genau der Grund, warum die Disziplinen nicht getrennt werden können. Die eine schützt die Messung. Die andere schützt den Rechenschaftspfad darum herum.
Eine kurze Checkliste für eine solche Pipeline ist unkompliziert.
Eigentümerschaft bestätigen: Weisen Sie den Steward und den technischen Eigentümer vor dem nächsten Abschluss zu.
Den Vertrag binden: Erfassen Sie erforderliche Felder, Aktualitätsfenster und Eindeutigkeitsregeln.
Den Alarmierungspfad einrichten: Stellen Sie sicher, dass Warnmeldungen Vorfälle erstellen, nicht nur Benachrichtigungen.
Mit Lineage verknüpfen: Zeigen Sie, welches Dashboard, welches Modell oder welcher Bericht das Asset nutzt.
Behebung aufzeichnen: Protokollieren Sie die Korrektur, die Nachweise und die Vertragsaktualisierung im verwalteten System.
Teams, die dies gut machen, streiten sich nicht mehr darüber, ob das Problem ein Governance- oder ein Qualitätsproblem war. Sie behandeln es als einen einzigen Vorfall mit zwei Kontrollflächen.
Implementierungsschritte, Checklisten und die passende Tool-Landschaft
Die richtige Implementierungsreihenfolge ist im besten Sinne unspektakulär. Beginnen Sie mit den Assets, auf die es ankommt, definieren Sie die Verantwortlichkeiten und automatisieren Sie die Prüfungen, bevor Sie Zeit in den Feinschliff von Richtlinientexten investieren. Wenn die Kontrollen in der Produktion nicht existieren, wird Sie das Governance-Framework später nicht retten.
Fünf Phasen, die zusammenwirken
Kritische Datenbestände inventarisieren. Identifizieren Sie die Tabellen, Feeds, Metriken und Modelle, die sich auf Berichte, den Betrieb oder die KI auswirken.
Eigentümerschaft und SLAs definieren. Weisen Sie Stewards, technische Eigentümer, Aktualitätserwartungen und Eskalationspfade zu.
Automatisierte Qualitätsprüfungen einrichten. Fügen Sie Validierungen, Anomalieerkennung, Schema-Tracking und Aktualitätsüberwachung hinzu.
Governance-Richtlinien kodifizieren. Erfassen Sie Zugriffsregeln, Lineage-Erwartungen, Lebenszyklus-Entscheidungen und Zertifizierungskriterien.
Feedbackschleifen einbetten. Leiten Sie Vorfälle in den Katalog, aktualisieren Sie Verträge nach der Behebung und überprüfen Sie Ausnahmen routinemäßig.
Starter-Checkliste für den ersten Rollout
Vollständigkeit der Metadaten: Jedes kritische Asset hat einen Eigentümer, eine Beschreibung, eine Domäne und eine Konsumentengruppe.
Schema Validation: Strukturänderungen werden erkannt, bevor nachgelagerte Konsumenten Schaden nehmen.
Lineage-Erfassung: Jedes wichtige Feld kann bis zu seiner Quelle und seinen Hauptkonsumenten zurückverfolgt werden.
Zugriffsüberprüfungen: Namentlich genannte Benutzer und Gruppen werden nach einem wiederholbaren Zeitplan mit den Richtlinien abgeglichen.
Incident-Routing: Warnmeldungen öffnen nachverfolgbare Vorfälle, die mit dem verwalteten Asset und dem aktuellen SLA verknüpft sind.
Wenn Käufer Plattformen vergleichen, achten sie meist auf fünf Dinge mehr als auf Marketingversprechen. Lineage-Tiefe, Präzision der Anomalieerkennung, Richtliniendurchsetzung, Katalogabdeckung und Time-to-Value sagen Ihnen mehr als generische Feature-Listen. Die folgende Tabelle stellt diese Kriterien den Tools gegenüber, die typischerweise evaluiert werden.
Evaluierungskriterium | Traditionelles Qualitätstool | Governance-Katalog | digna |
|---|---|---|---|
Lineage-Tiefe | Meist eingeschränkt oder extern | Stark bei Dokumentation und Beziehungen | Umfasst lineage-sensitives operatives Monitoring innerhalb der Kundenumgebung |
Präzision der Anomalieerkennung | Gut, wenn Regeln manuell angepasst werden | Keine Kernfunktion | KI-gestütztes Erlernen von Baselines und kontinuierliche Anomalieerkennung |
Richtliniendurchsetzung | Meist indirekt | Stark bei Richtliniendefinition und Genehmigungen | Unterstützt Validierung, Schema-Tracking und Aktualitätsüberwachung in der Ausführungsebene |
Katalogabdeckung | Oft minimal | Starke Metadatenabdeckung | Umfasst Scheduler, Katalog, Integrationen und Kollaborationsfunktionen |
Time-to-Value | Schnell für eine begrenzte Auswahl an Prüfungen | Langsamer bei der Ausgestaltung von Kontrollen | Laut Produktunterlagen in weniger als zwei Stunden installiert und liefert erste Erkenntnisse |
Für Teams, die Optionen vergleichen, ist der Leitfaden zur Implementierung von Datenqualität eine nützliche Hilfe, um über die Reihenfolge des Rollouts und die operative Eignung nachzudenken. Die wichtigste Entscheidung ist nicht, ob Sie zuerst „Qualität“ oder „Governance“ kaufen. Es geht darum, ob Ihr Schmerzpunkt eher in der Kontrolle zur Designzeit oder in der Zuverlässigkeit zur Laufzeit liegt.
Wenn Ihr größtes Problem die Klarheit von Richtlinien, Audit-Nachweise und die Eigenverantwortung über viele Domänen hinweg ist, ist ein Governance-First-Fundament sinnvoll. Wenn Ihr größtes Problem fehlerhafte Feeds, veraltete Dashboards und unruhige Pipelines sind, ist eine Quality-First-Instrumentierung der schnellere Gewinn. Die meisten Unternehmen benötigen am Ende einen integrierten Stack, da dieselben kritischen Datenbestände sowohl Kontrolle als auch Erkennung erfordern. Genau hier fügt sich eine Plattform wie digna ein, da sie Anomalien, Aktualität, Validierung und Schemaänderungen in der eigenen Umgebung des Kunden überwacht und gleichzeitig den Governance-Nachweispfad rund um diese Prüfungen unterstützt.
Wenn Sie versuchen, Governance in etwas zu verwandeln, das Ihre Pipelines durchsetzen können, bietet Ihnen digna einen praktischen Weg, dies zu tun, ohne die Kontrolle von der Erkennung zu trennen. Besuchen Sie digna, um zu sehen, wie die Funktionen für Data Validation, Schema-Tracking, Aktualitätsüberwachung und Observability in einen einzigen operativen Workflow für Datenvertrauen passen.
Häufig gestellte Fragen
Warum konvergieren Qualität und Governance 2026?
Weil Organisationen brauchen, dass Governance zu einem messbaren Signal wird statt zu einer statischen Dokumentenschicht. Die alte Aufteilung stellte Qualität zu Engineers und Analystinnen und Governance zu Policy-Teams und Stewards, und diese Trennung lässt Governance auf dem Papier bestehen, während Qualität im Produktivbetrieb zusammenbricht.
Was zeigen die Umfragedaten?
Eine globale Umfrage von 2024 fand, dass 64 % der Befragten Datenqualität als größte Herausforderung für Datenintegrität nannten, 51 % Data Governance und 71 % angaben, ihre Organisation habe bereits ein Governance-Programm. Ein Programm zu haben und Kontrolle zu haben sind erkennbar zweierlei.
Wie hängt Governance mit KI-Reife zusammen?
Unmittelbar. In derselben Umfrage von 2024 nannten 62 % fehlende Governance als Haupthindernis für KI-Reife, womit Governance in der Liste der Blockaden noch vor Modellwahl und Werkzeugen steht.
Wann senkt eine Governance-Regel tatsächlich Risiko?
Nur wenn sie dort durchgesetzt werden kann, wo Daten sich bewegen. Eine Richtlinie, die nie die Pipeline erreicht, ist Regalware, und deshalb rücken Lineage, Richtliniendurchsetzung und kontinuierliche Validierung heute näher zusammen als früher.
Stützen Normen diese Konvergenz?
Ja. ISO 8000 verbindet Datenqualität ausdrücklich mit Data Governance, Datenqualitätsmanagement und Reifegradbewertung und betont, dass Qualität durch Beschreibung, Provenienz und verlustfreien Austausch messbar und überprüfbar sein muss.



