Qualitätskontroll-Datensatz: praktischer Entwurfsleitfaden
|
8
min. Lesezeit

Ihr Dashboard sieht in Ordnung aus, bis die Buchhaltung den Monat abschließt und fragt, warum der Umsatz zu hoch ausgewiesen ist. Die Pipeline ist nicht abgestürzt. Das Warehouse ist nicht ausgefallen. Ein Transformationsschritt hat Zeilen mit leerer customer_id verworfen, und jede nachgelagerte Aggregation lief weiter, als wäre nichts geschehen.
Solche Fehlschläge sind der Grund, warum Teams mehr brauchen als verstreute Tests und Alarm-E-Mails. Sie brauchen einen Qualitätskontroll-Datensatz, der wie ein operatives Gedächtnis der Pipeline wirkt: was geprüft wurde, wie „normal“ aussieht, was sich geändert hat, wer das Problem verantwortet und wie man einen echten Vorfall von Rauschen unterscheidet.
Viele Teams wissen bereits, dass sie Daten validieren sollten. Die schwierigere Frage ist, wo man Aufwand investiert. Manche Datensätze brauchen fortlaufendes Schema-Tracking und Frischeschwellen. Andere brauchen ein paar strenge Geschäftsregeln und gelegentliche manuelle Durchsicht. Jede Tabelle gleich zu behandeln erzeugt meist Regelwildwuchs, Alarmmüdigkeit und blinde Flecken an den wichtigsten Stellen.
Inhaltsverzeichnis
Echte Beispiele für Qualitätskontroll-Datensätze in der Praxis
Wie Sie einen Qualitätskontroll-Datensatz für Ihre Pipelines entwerfen
Verbreitete Irrtümer, die Datenqualitätsprogramme untergraben
Was ein Qualitätskontroll-Datensatz tatsächlich ist
Ein Qualitätskontroll-Datensatz entsteht meist nach einem schmerzhaften Vorfall. Ein verbreitetes Muster ist ein Finanz-Dashboard, das den Umsatz weit über den Ist-Zahlen meldet, weil vorgelagerte Datensätze falsch gefiltert, dupliziert oder nur teilweise geladen wurden. Beim Einlesen merkt es niemand, weil die Pipeline weiterhin „erfolgreich“ meldet.
Ein Qualitätskontroll-Datensatz ist die strukturierte, abfragbare Aufzeichnung darüber, wie Sie solche Fehlschläge erkennen und diagnostizieren. Er ist nicht bloß eine Tabelle mit Testergebnissen. Er enthält die Kontrollen rund um die Daten: Validierungsregeln, erwartete Basislinien, prüfenswerte Stichproben und Auditmetadaten, die sagen, was wann geschah.
Wo er im Stack sitzt
Teams verwechseln ihn oft mit benachbarten Artefakten.
Er ist keine rohe Validierungsprotokollierung. Logs sagen Ihnen, dass eine Prüfung lief. Sie bewahren meist nicht genug Kontext, um historisches Verhalten zu vergleichen oder Drift zu untersuchen.
Er ist kein Datenkatalog. Ein Katalog sagt, was ein Datensatz ist, wem er gehört und vielleicht, woher er kam. Er speichert in der Regel keine Bestanden-/Fehlgeschlagen-Historie oder Anomaliebelege.
Er ist keine Test-Fixture. Fixtures helfen Entwicklerinnen, Transformationen unter kontrollierten Bedingungen zu prüfen. Ein Qualitätskontroll-Datensatz lebt neben dem Produktionsbetrieb und entwickelt sich mit ihm.
Am saubersten denkt man es so: Die Pipeline erzeugt Geschäftsdaten, und der Qualitätskontroll-Datensatz erzeugt Nachweise über die Vertrauenswürdigkeit dieser Daten.
Praktische Regel: Wenn Ihr Team nicht an einer Stelle beantworten kann „was hat sich geändert, wann begann es, und war es ein Regelverstoß oder eine Verhaltensverschiebung?“, haben Sie wahrscheinlich noch keinen echten Qualitätskontroll-Datensatz.
Warum er lebendig bleiben muss
Das ist kein einmaliges Governance-Ergebnis. Es ist ein lebendiges operatives Gut. Normungsarbeit hat Datenqualität in Richtung ausdrücklicher Merkmale und messbarer Kontrollen geschoben. ISO/IEC 25012 und ISO/IEC 25024 etablierten sowohl ein allgemeines Qualitätsmodell als auch quantitative Maße, weshalb moderne Teams zunehmend „die Daten beschreiben“ von „die Qualität messen“ trennen.
Diese Unterscheidung zählt in der Produktion. Daten ändern ihre Form. Vorgelagerte Systeme benennen Felder um. Die Quelllatenz verschiebt sich nach einem Anbieter-Rollout. Ein nützlicher Qualitätskontroll-Datensatz muss diese Änderungen aufnehmen, statt nach der ersten Umsetzung zu versteinern.
Wenn Sie eine knappe Grundlage zur breiteren Disziplin brauchen, ist diese Übersicht zu Datenqualität eine gute Ergänzung zum hier beschriebenen Betriebsmodell.
Kernbestandteile eines Qualitätskontroll-Datensatzes
Ein Qualitätskontroll-Datensatz wird nützlich, wenn er Erkennung von Diagnose trennt. Die Erkennung sagt, dass etwas falsch ist. Die Diagnose sagt warum, wo und wer handeln sollte. Die meisten gescheiterten Umsetzungen leisten nur den ersten Teil.
Die fünf Bestandteile, die zählen
Jeder operative Entwurf, dem ich traue, enthält fünf Schichten.
Bestandteil | Zweck | Typische Speicherung |
|---|---|---|
Metadatenschicht | Benennt Verantwortliche, SLA, Lineage-Verweis, Kritikalität und Eskalationsweg | Katalogtabelle, Kontrollschema, Governance-Speicher |
Validierungsregeln | Erzwingen Schemabedingungen, Nullbarkeit, Geschäftslogik und zulässige Formate | Versionierter Code plus Regeltabelle |
Statistische Basislinien | Erfassen erwartetes Verhalten wie Verteilungen, Null-Muster, Volumen und Kardinalität | Kennzahlentabellen im Warehouse oder Observability-Speicher |
Referenzstichproben | Bewahren Goldstandard-Datensätze, Sonderfälle und bekannte Fehlbeispiele zur Durchsicht | Eigene Stichprobentabellen oder kuratierte Prüfmengen |
Prüfpfade | Speichern zeitgestempelte Ergebnisse, Driftdifferenzen, Vorfälle und Lösungsnotizen | QC-Historientabellen, Vorfallssystem, Observability-Schicht |
Was jede Schicht leistet
Die Metadatenschicht verankert die Verantwortung. Scheitert eine Prüfung und niemand weiß, wem der Datensatz gehört oder welcher nachgelagerte Prozess davon abhängt, hat der Alarm begrenzten Wert.
Die Schicht der Validierungsregeln fängt deterministische Fehlschläge. Verletzungen des Primärschlüssels, unzulässige Zustandsübergänge, kaputte Datumsformate und unmögliche Werte gehören hierher. Hier beginnt auch schema-bewusste Logik zu zählen, besonders bei verschachtelten oder sich entwickelnden Strukturen. Ein Verständnis verschiedener Schematypen und Änderungsmuster hilft, brüchige Regeln zu vermeiden, die bei jedem neuen Feld im Quellsystem brechen.
Die Schicht der statistischen Basislinien fängt Verhalten, das harte Regeln zwar besteht, aber nicht mehr normal ist. Eine Tabelle kann gültig und dennoch verdächtig sein, wenn die Kategorienverteilung unerwartet schwankt, Dubletten zunehmen oder eine Quelle später eintrifft als üblich.
Warum ein fehlender Bestandteil die übrigen schwächt
Bei Referenzstichproben und Prüfpfaden sparen viele Programme. Das rächt sich meist.
Ohne Referenzstichproben können Engineers Sonderfälle nicht schnell prüfen oder die heutigen fehlerhaften Datensätze mit früher bekannten Fehlermustern vergleichen.
Ohne Prüfpfade beginnt jeder Vorfall bei null. Teams verlieren die Historie darüber, wann der Drift begann, ob dasselbe Problem wiederkehrte und ob das Nachjustieren von Schwellen die Lage verbessert oder verschlechtert hat.
Eine Prüfung, die nur „fehlgeschlagen“ sagt, ist kaum besser als gar keine Prüfung. Betreiberinnen brauchen Nachweise, nicht bloß einen Status.
Die stärksten Umsetzungen behandeln den Qualitätskontroll-Datensatz als kleines operatives Modell der Pipeline selbst: Regeln, Kennzahlen, Beispiele und Historie an einem abfragbaren Ort.
Wichtige Qualitätsdimensionen, die Sie überwachen müssen
Ein einzelner Validator deckt Fehlermuster in der Produktion nicht ab. Qualität bricht entlang verschiedener Achsen, und jede Achse braucht eigene Kontrolllogik.
Unabhängige Leitlinien zur Datensatz-QC behandeln Genauigkeit, Vollständigkeit, Konsistenz, Eindeutigkeit und Timeliness als getrennte Kontrolldimensionen, weil ein Datensatz vollständig und dennoch falsch, aktuell und dennoch inkonsistent oder strukturell intakt und dennoch veraltet sein kann. Dieselben Leitlinien empfehlen zudem, deterministische Prüfungen mit statistischer Durchsicht auf Anomalien, Fehlwerte und Schemastabilität zu verbinden, weil viele Fehlschläge sich zuerst als Verschiebungen in Häufigkeiten oder Latenz zeigen statt als offensichtliche Defekte auf Zeilenebene, wie in diesem Leitfaden zu Datensatz-Qualitätsprüfungen dargelegt.

Sechs Dimensionen, sechs Fehlermuster
Genauigkeit heißt, der Wert entspricht der Wirklichkeit oder einer vertrauenswürdigen Quelle. Abstimmungen gegen Buchungssummen, Systeme der Wahrheit oder freigegebene Referenzdaten gehören hierher.
Vollständigkeit fragt, ob erforderliche Datensätze und Felder vorhanden sind. Null-Spitzen, Teilladungen und fehlende Partitionen tauchen meist hier zuerst auf.
Konsistenz prüft, ob dieselbe Geschäftsentität über Systeme hinweg gleich dargestellt wird. Abweichende Währungscodes und widersprüchliche Statusbezeichnungen sind verbreitete Beispiele.
Eindeutigkeit schützt vor Doppelzählung und Identitätskollisionen. Doppelte Ereignisse und wiederholte Transaktions-IDs können die Berichterstattung verderben.
Gültigkeit erzwingt Format- und Domänenerwartungen. Ein Feld kann vorhanden und eindeutig und dennoch ungültig sein, wenn es Muster-, Bereichs- oder Aufzählungsregeln verletzt.
Timeliness prüft, ob Daten eintrafen, wenn das Geschäft es erwartet. Ein technisch korrekter Datensatz kann unbrauchbar bleiben, wenn er zu spät für Berichte oder Entscheidungen kommt.
Timeliness braucht eine echte Schwelle
Bei der Frische scheitert vage Überwachung oft. Ein praktisches Modell ist schwellenbasiert: Vergleichen Sie den jüngsten Zeitstempel im Datensatz mit der aktuellen Zeit und alarmieren Sie, wenn der Abstand das definierte SLA überschreitet. Ein Beispiel aus der Data Observability beschreibt das als Frischeprüfung, bei der eine stündliche Tabelle verletzt wird, sobald der Verzug die erlaubte Schwelle übersteigt.
Das ist weit nützlicher, als etwas „zu spät“ zu nennen, ohne eine Uhr dranzuhängen.
Wenn Sie eine gesonderte Referenz dazu wollen, wie diese Dimensionen auf operative Prüfungen abbilden, lohnt es sich, diesen Leitfaden zu Dimensionen der Datenqualität griffbereit zu halten.
Echte Beispiele für Qualitätskontroll-Datensätze in der Praxis
Am leichtesten versteht man einen Qualitätskontroll-Datensatz, wenn man anschaut, was er speichert, sobald Teams ihn als lebendiges Gut statt als statische Checkliste nutzen.
Beispielmuster aus der Produktion
Beispiel | Qualitätsdimension | Gespeicherte Artefakte | Operatives Signal |
|---|---|---|---|
Durchsicht eines annotierten Trainingssatzes | Genauigkeit | Label-Provenienz, Prüfer-IDs, Kennzeichen für Uneinigkeit, Konsensstatus, stichprobenhafte Expertenprüfungen | Systematischer Drift der Labelnden oder mehrdeutige Klassen |
Feed einer Ereignis-Schema-Registry | Gültigkeit und Schemaintegrität | Spaltenänderungen, Zeitstempel, Urheber, Kompatibilitätsnotizen, vorheriger Schema-Snapshot | Brechende Feldumbenennung, Typänderung oder stiller Drift |
Dashboard zum Frische-SLA | Timeliness | Erwartete Ankunftsfenster, tatsächliche Einlesezeiten, Verletzungshistorie, Quellstatus | Chronische Verspätung, verpasste Ladevorgänge, instabile Quelllieferung |
Gelabelte Daten brauchen einen eigenen QC-Eintrag
Annotierte Datensätze sind ein starkes Beispiel, weil Teams oft annehmen, Labels seien nach der Kuratierung „fertig“. Sind sie nicht. Eine NeurIPS-Arbeit berichtete eine durchschnittliche Fehlerrate von 3,4 % bei Labels über Evaluationsmengen in zehn Benchmark-Datensätzen, genug, um Modellauswahl und Benchmark-Ranking zu beeinflussen, gemäß der NeurIPS-Arbeit zu Datensätzen und Benchmarks.
Deshalb verfolgen gute Qualitätskontroll-Datensätze für gelabelte Daten die Provenienz der Prüfenden, Anzahl der Uneinigkeiten, stichprobenhafte Expertenkontrollen und Annahmekriterien nach Risikostufe. Dieselbe Arbeit nennt auch Abläufe, die 10–20 % der Daten erneut prüfen, um die Übereinstimmung in Kontexten mit höherem Einsatz zu verbessern.
Wenn Labels das Modellverhalten treiben, ist Uneinigkeit kein Rauschen zum Verstecken. Sie ist ein Qualitätssignal zum Speichern und Untersuchen.
Schemahistorie sollte abfragbar sein
Bei Ereignisströmen und gemeinsam genutzten Warehouse-Tabellen ist Schemadrift oft der Vorfall vor dem Vorfall. Ein Produzent benennt ein Feld um. Eine nachgelagerte Transformation läuft weiter, gibt aber plötzlich Nullwerte aus. Ein Dashboard bricht später, weit weg von der Ursache.
Ein nützlicher Qualitätskontroll-Datensatz speichert Schema-Snapshots über die Zeit, dazu wer was änderte und ob die Änderung rückwärtskompatibel war. Damit wird aus „gestern ist etwas kaputtgegangen“ eine Abfrage: Was änderte sich vorgelagert vor dem Bruch?
Frische verdient ein eigenes Artefakt
Auch die Timeliness-Überwachung funktioniert besser, wenn ein eigener Datensatz dahintersteht. Statt eines binären Alarms speichern Sie erwartete Ankunftsfenster, tatsächliche Ankunftszeitstempel und die Verletzungshistorie je Quelle. So können Teams einmalige Verzögerungen von chronischer Quellinstabilität trennen und die Eskalation nach Wirkung anpassen.
Wie Sie einen Qualitätskontroll-Datensatz für Ihre Pipelines entwerfen
Teams entwerfen das meist rückwärts. Sie beginnen mit einem Werkzeug, erzeugen jede Prüfung, die ihnen einfällt, und ertrinken dann in Alarmen. Die bessere Reihenfolge beginnt bei der geschäftlichen Wirkung.
Beginnen Sie beim Schadensradius, nicht bei der Anzahl der Datensätze
Inventarisieren Sie Ihre kritischen Datensätze und ordnen Sie sie nach den nachgelagerten Folgen, falls sie schlecht werden. Umsatzrealisierung, regulatorische Berichterstattung, Vorstands-Dashboards und in Produktionsentscheidungen genutzte Modellmerkmale stehen höher als Tabellen für gelegentliche Analysen.
Legen Sie je Stufe fest, welche Dimensionen am meisten zählen und was Warnung gegenüber Verletzung bedeutet. Weisen Sie nicht jedem Datensatz denselben Maßstab zu. Eine Referenzdimensionstabelle braucht vielleicht strikte Gültigkeit und gelegentliche manuelle Durchsicht. Ein Strom von Kundenereignissen braucht womöglich fortlaufende Überwachung von Eindeutigkeit, Schema und Timeliness.
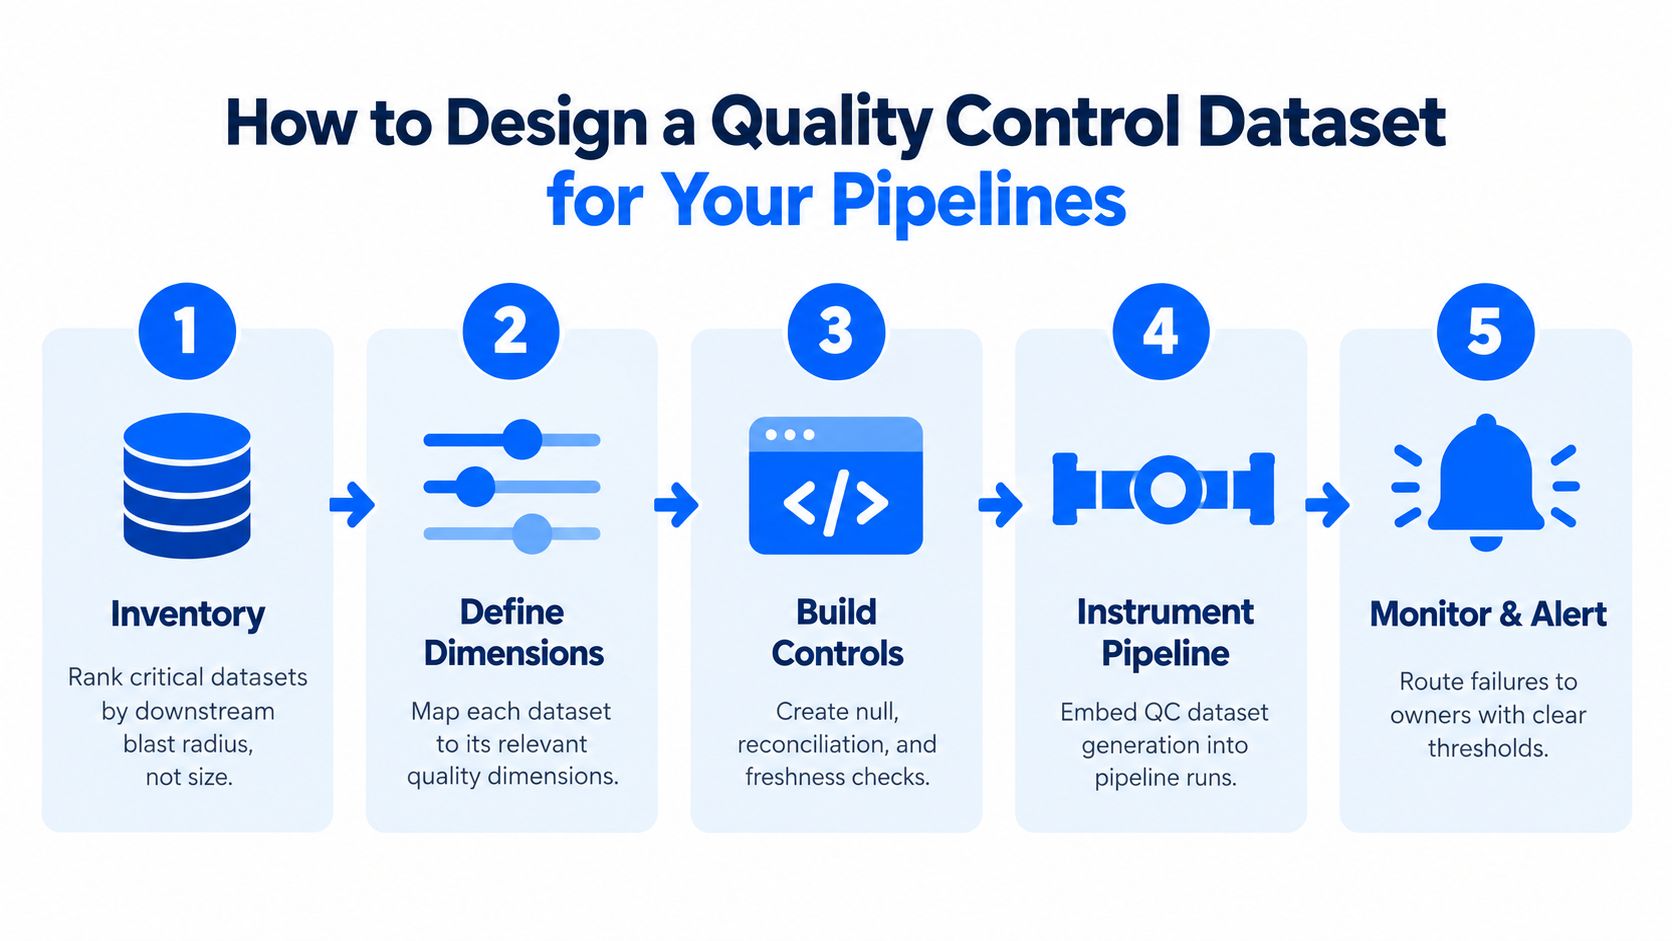
Passen Sie die Kontrolle zum Fehlermuster
Nutzen Sie für verschiedene Dimensionen verschiedene Validierungsstrategien.
Deterministische Regeln wirken am besten bei Schemakonformität, Nullbarkeit, zulässigen Bereichen und Geschäftslogik.
Statistische Basislinien wirken besser bei Volumen, Verteilungsänderungen, Kardinalitätsschwankungen und ungewöhnlichen Fehlwerten.
Anomalieprüfung hilft, wenn Verhalten sich ändert, die genaue Regel aber nicht im Voraus vollständig festgelegt werden kann.
Speichern Sie Regeln nach Möglichkeit als Code. Die Regel sollte mit der Transformationslogik versioniert werden, die sie schützt. Binden Sie außerdem jede Regel an eine Datensatzkennung, Verantwortliche und einen Eskalationsweg. Eine scheiternde Kontrolle ohne Verantwortung wird zum Slack-Gespenst, das alle ignorieren.
Schreiben Sie Ergebnisse in den QC-Datensatz selbst
Der Qualitätskontroll-Datensatz sollte nicht nur Prüfungen definieren. Er sollte auch deren Ergebnisse speichern.
Halten Sie mindestens fest:
Ausführungskontext: Lauf-ID der Pipeline, Datensatzname, Umgebung, Zeitstempel
Kontrollergebnis: bestanden, Warnung, fehlgeschlagen, übersprungen
Nachweise: beanstandete Zeilen, zusammenfassende Kennzahlen, Driftdifferenzen oder Schema-Diff
Operative Metadaten: Verantwortliche, Schweregrad, Ticket-Link, Lösungsnotiz
Eine Plattform kann helfen, wenn sie zu Ihrer Umgebung passt. So richtet etwa dignas Ansatz zu Datenvalidierung und kontinuierlichen Qualitätsprüfungen deterministische Validierungen an laufender Überwachung aus, statt sie als getrennte Programme zu behandeln.
Halten Sie Governance an den Betrieb gebunden
Ein Qualitätskontroll-Datensatz überlebt Personalwechsel nur, wenn ihn jemand pflegt. Ergänzen Sie einen Prüfrhythmus, Ausmusterungskriterien für veraltete Regeln und eine Rückkopplung nach Vorfällen. Feuert eine Prüfung ständig ohne handlungsfähiges Ergebnis, überarbeiten oder entfernen Sie sie. Ist ein Vorfall durchgerutscht, gießen Sie diese Lektion in eine neue Kontrolle oder Basislinie.
Gewohnheit für Betreiberinnen: Jeder wesentliche Datenvorfall sollte mit einer Frage enden: Was sollte sich der Qualitätskontroll-Datensatz merken, damit das nächste Mal leichter zu erkennen ist?
Den richtigen Überwachungsansatz je Datensatz wählen
Überwachungsstrategie ist keine Reifeleiter. Sie ist eine Triage-Entscheidung. Die richtige Antwort hängt von Risiko, Geschwindigkeit und den Kosten des Scheiterns ab.
Ein aktueller Branchenbericht fand, dass 61 % der Organisationen weiterhin auf manuelle Prüfungen oder SQL-basierte Validierung setzen, 27 % eine dedizierte Observability-Plattform nutzen und 31 % begrenzte Sicht auf die Pipeline-Gesundheit als größte Herausforderung nennen, gemäß dem Trendbericht 2025 zu Datenqualität und Observability von Integrate.io. Das deckt sich mit dem, was viele Teams erleben. Die Frage ist meist nicht, ob QC zählt. Es geht darum, wo sich Automatisierung auszahlt.
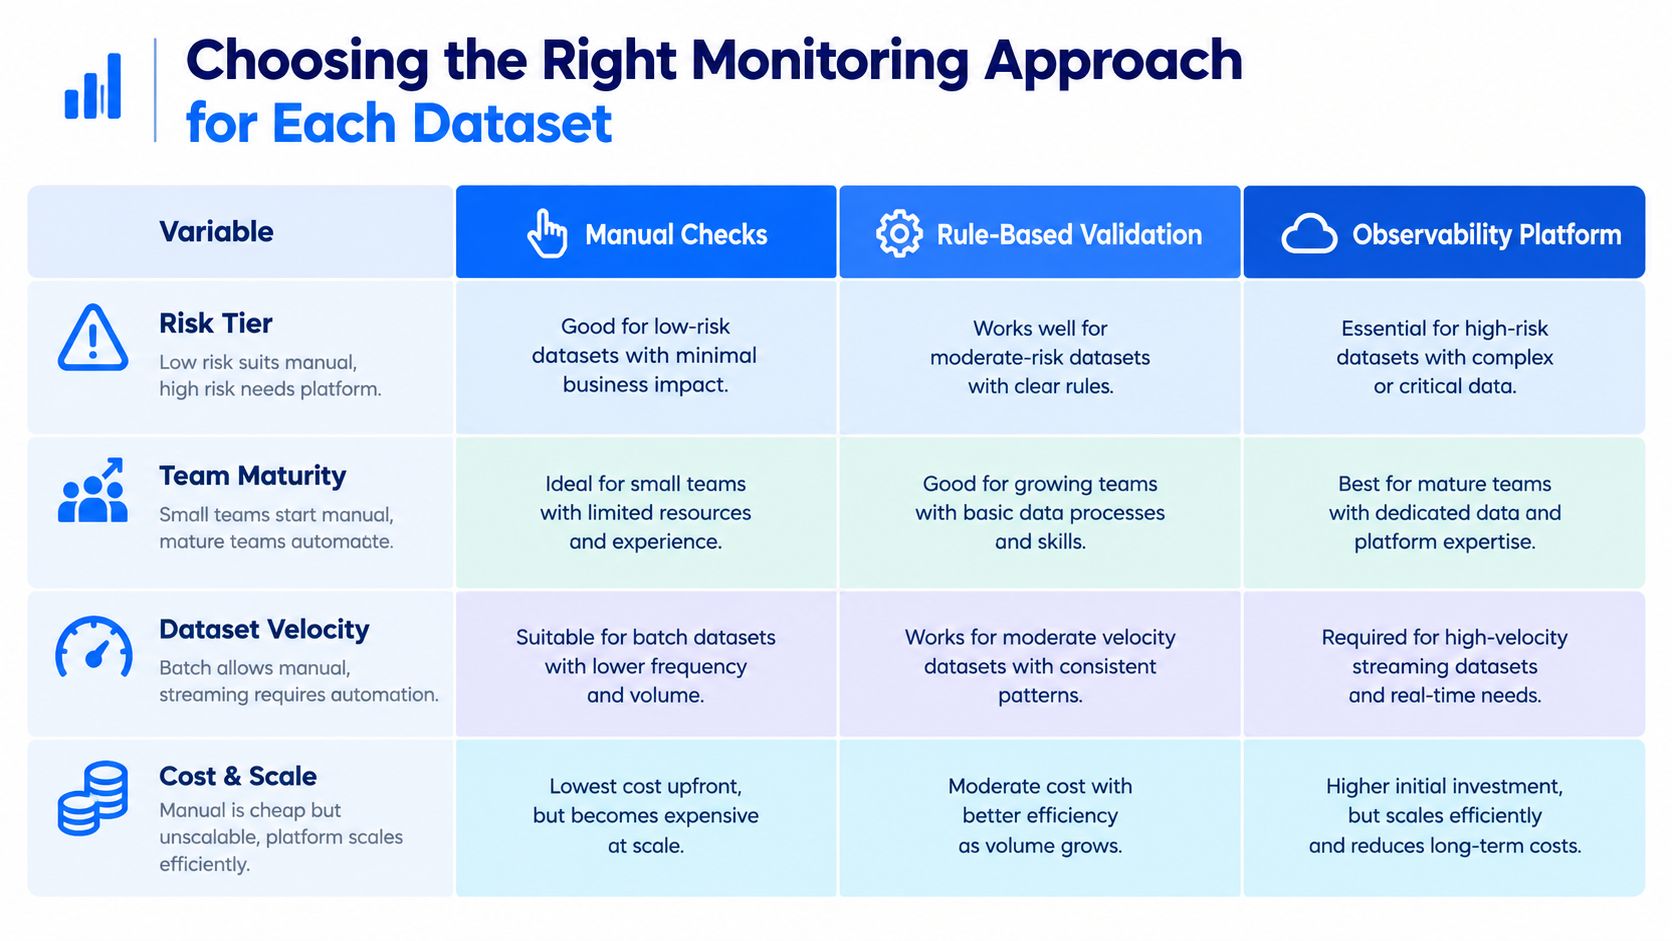
Wann welcher Ansatz passt
Manuelle Prüfungen ergeben weiterhin Sinn für Referenzdaten mit geringem Volumen, rechtliche Zuordnungen und Abläufe, in denen menschliches Urteil mehr zählt als Tempo. Sie versagen, sobald Daten sich häufig ändern oder Vorfälle schnelle Reaktion brauchen.
Regelbasierte Validierung deckt einen großen Teil wichtiger Pipelines ab. Sie funktioniert gut, wenn das Geschäft klare Bedingungen definieren kann und das Engineering-Team Regeln nah am Transformationscode hält.
Observability-Plattformen verdienen ihren Platz bei schnellen, mehrquelligen Systemen mit großem Schadensradius. Dort brauchen Sie Basislinien, Frischeüberwachung, Schema-Tracking, Lineage-Kontext und zentrale Alarmierung.
Eskalationssignale, auf die Sie achten sollten
Ziehen Sie einen Datensatz im Überwachungsstapel nach oben, wenn Sie Muster wie diese sehen:
Steigende Fehlalarme: Schwellen sind für das aktuelle Verhalten zu starr
Häufiges manuelles Löschen von Bränden: Engineers verbringen zu viel Zeit mit wiederkehrenden Problemen
Beschwerden über veraltete Daten: Stakeholder verlieren Vertrauen, weil das Team Verspätung zu spät erkennt
Verantwortung über mehrere Teams: Fehlschläge überschreiten Produzenten- und Konsumentengrenzen und brauchen gemeinsamen Kontext
Für Teams, die Observability-Optionen bewerten, ist diese Übersicht zu Data Observability nützlich, weil sie das Problem um operative Sichtbarkeit rahmt statt um allgemeines Monitoring.
Verbreitete Irrtümer, die Datenqualitätsprogramme untergraben
Die meisten schwachen Programme scheitern nicht daran, dass es Teams gleichgültig wäre. Sie scheitern, weil die Betriebsannahmen falsch sind.
Die Annahmen, die Ärger machen
Irrtum | Operative Wirklichkeit | Korrigierende Maßnahme |
|---|---|---|
Mehr Regeln verbessern immer die Qualität | Regelwildwuchs erzeugt Rauschen und verdeckt wichtige Fehlschläge | Kontrollen nach Risiko und Handlungsfähigkeit priorisieren |
Einmalige Kuratierung reicht | Datenverhalten ändert sich mit Quellen, Schemata und Nutzung | Schwellen und Basislinien planmäßig überprüfen |
Observability ersetzt Governance | Werkzeuge zeigen Vorfälle, weisen aber keine Verantwortung zu | Verantwortliche, Schweregrade und Behebungswege festlegen |
QC-Datensätze sind nur für ML | Analytik, Finanzen und regulatorische Pipelines leiden unter denselben Fehlermustern | Das Modell über operative Datendomänen hinweg anwenden |
Qualität gehört allein dem Datenteam | Produzenten und Fachverantwortliche definieren viele kritische Erwartungen | Verantwortung nach Datensatz und Kontrolltyp teilen |
Warum sich diese Überzeugungen halten
„Mehr Regeln hinzufügen“ klingt sicher, weil es konkret wirkt. In der Praxis begraben zu viele geringwertige Prüfungen die wenigen, die das Geschäft schützen. Teams hören auf, Alarmen zu trauen, und echte Vorfälle verschwimmen mit dem Hintergrundrauschen.
„Einmaliges Aufräumen“ ist eine weitere Falle. Schon die Schemaevolution lässt statische Kontrollen verfallen. In operativen Umgebungen muss Schema-Tracking fortlaufend sein. Dignas Dokumentation beschreibt etwa fortlaufende Überwachung von Tabellenschemata, Spalten und Datentypen mit Vergleichen gegen frühere Snapshots und Alarmen über Dashboard, API, E-Mail, Slack oder Webhooks. Das ist das richtige Denkmodell, selbst wenn Sie ein anderes Werkzeug nutzen.
Was stattdessen funktioniert
Das haltbare Muster ist enger und strenger.
Wählen Sie weniger Prüfungen mit klaren Verantwortlichen.
Frischen Sie Basislinien auf, wenn sich das Quellverhalten ändert.
Behandeln Sie Vorfälle als Eingabe für den Kontrollentwurf.
Halten Sie Nachweise im QC-Datensatz, nicht vergraben in Chat-Verläufen.
Ein Qualitätsprogramm wird glaubwürdig, wenn Betreiberinnen erkennen können, welche Fehlschläge zählen, wer reagiert und wie das System aus dem Vorfall lernt.
Alles zusammenführen und nächste Schritte
Ein tragfähiges Betriebsmodell hat vier Schichten. Beginnen Sie mit den Qualitätsdimensionen, die für jeden Datensatz zählen. Unterlegen Sie diese Dimensionen mit strukturellen Bestandteilen wie Regeln, Basislinien, Stichproben und Prüfhistorie. Wählen Sie einen Überwachungsansatz, der zu Risiko und Änderungsrate des Datensatzes passt. Schließen Sie dann die Schleife, indem Sie Vorfälle in aktualisierte Schwellen, neue Regeln oder ausgemusterte Prüfungen verwandeln.
Das klingt schwerer, als es ist. In einem Sprint kann ein Team kritische Datensätze inventarisieren, sie nach nachgelagerter Wirkung ordnen, für jeden eine kleine Menge Kontrollen definieren und Fehlschläge in bestehende Vorfallskanäle leiten. Beginnen Sie zuerst mit deterministischen Prüfungen. Ergänzen Sie statistische Basislinien, sobald das Team genug Historie hat, um zu wissen, wie normal aussieht.

Der erste Schritt muss nicht ehrgeizig sein. Wählen Sie diese Woche drei Datensätze. Halten Sie für jeden Verantwortliche, eine Vollständigkeitserwartung und eine Frischeschwelle fest. Die aktuelle Richtung der US-Bundesdatengemeinschaft ist hier ein nützliches Signal: Der Bericht der American Statistical Association von 2025 argumentiert, Behörden sollten leicht verfügbare Qualitätskennzahlen bereitstellen, historische Daten und Metadaten bewahren sowie Zitierweisen und Identifikatoren vereinheitlichen, wie in dem Bericht The Nation's Data at Risk 2025 beschrieben. Das ist dieselbe operative Disziplin, die starke Datenteams im Privatsektor brauchen.
Die Teams, die sich am schnellsten verbessern, versuchen nicht, alles auf einmal zu überwachen. Sie machen einen kritischen Datensatz messbar und wiederholen dann das Muster.
digna gibt Teams einen Weg, Datenqualität und Observability innerhalb der eigenen Umgebung zu betreiben, mit Ausführung in der Datenbank, sodass das Monitoring-SQL im Warehouse läuft und nur Ergebnisse und Metadaten in der Observability-Schicht liegen, wie in dignas Praktiken für Datenpipelines beschrieben. Wenn Sie einen Qualitätskontroll-Datensatz bauen und Schema-Tracking, Timeliness-Überwachung, Validierung und Anomalieerkennung brauchen, ohne sensible Produktionsdaten zu bewegen, besuchen Sie digna.
Ein QC-Datensatz hält fest, was Ihre Prüfungen fanden; Data Platform Observability sorgt dafür, dass diese Prüfungen weiterlaufen und auffallen, wenn sie stoppen.
Häufig gestellte Fragen
Was ist ein Qualitätskontroll-Datensatz?
Ein lebendiger Datensatz, der die Ergebnisse Ihrer Qualitätsprüfungen festhält und neben den überwachten Pipelines sitzt, nicht in ihnen. Er muss lebendig bleiben, weil ein veralteter QC-Eintrag ein System beschreibt, das es nicht mehr gibt, und das ist schlimmer als gar keiner.
Was sind seine Kernbestandteile?
Fünf: die Prüfungen selbst, die Ergebnisse, die sie erzeugen, die Schemahistorie, der Frischeeintrag und die Governance-Metadaten, die jede Kontrolle an Verantwortliche binden. Fehlt eines, schwächen sich die übrigen — Ergebnisse ohne Schemahistorie etwa können nicht erklären, warum eine Prüfung zu scheitern begann.
Welche Qualitätsdimensionen sollte er überwachen?
Sechs Dimensionen bilden sechs unterschiedliche Fehlermuster ab, und Timeliness ist jene, die eine echte Schwelle braucht statt eines vagen Gefühls von „aktuell“. Ein Feed, der technisch vorliegt, aber vier Stunden hinter seinem Entscheidungsfenster, ist bereits gescheitert, auch wenn jeder Wert darin korrekt ist.
Wie entscheiden Sie, welche Datensätze abgedeckt werden?
Beginnen Sie beim Schadensradius, nicht bei der Anzahl der Datensätze. Eine Tabelle, die regulatorische Berichte oder eine kundenseitige Zahl speist, verdient Kontrollen vor einer Tabelle, die niemand abfragt, so groß sie auch sei. Passen Sie dann die Kontrolle zum Fehlermuster, statt überall dieselben generischen Prüfungen anzuwenden.
Welche Irrtümer untergraben diese Programme?
Der Glaube, eine erfolgreich beendete Pipeline bedeute korrekte Daten, und dass mehr Prüfungen gleich mehr Abdeckung seien. Das Eingangsbeispiel zeigt es: Eine Transformation verwarf still Zeilen mit leerer customer_id, und jede nachgelagerte Aggregation lief weiter, als wäre nichts geschehen.



