10 Methoden der Datenqualitätskontrolle, die funktionieren
|
9
min. Lesezeit

Ein einzelnes Regelwerk schützt keine moderne Datenlandschaft. Deterministische Checks finden ungültige Datensätze, erkennen aber nicht zwangsläufig einen Volumeneinbruch, der völlig plausibel aussieht. Ein statischer Schwellenwert kann eine saisonale Spitze als Incident melden, während ein Liefermonitor zwar eine fehlende Ladung erkennt, aber nicht sagt, ob die eingetroffenen Datensätze gültig sind. Strukturelle Kontrollen, Verhaltenssignale, Geschäftskennzahlen, Plattform-Telemetrie und menschliche Zusammenarbeit decken jeweils eine andere Fehlerart auf.
Die praktische Antwort ist nicht, sich zwischen Testing und Observability zu entscheiden. Teams brauchen sich ergänzende Kontrollebenen, die über Ingestion, Transformation, Speicherung und Nutzung hinweg zusammenspielen. Dieses Prinzip folgt der allgemeinen Entwicklung der Qualitätskontrolle, von Walter A. Shewharts Kontrollkarten aus dem Jahr 1924, die normale Streuung von Streuung mit besonderer Ursache trennen, bis zu modernen Methoden, die Dimensionen wie Vollständigkeit, Aktualität und Konsistenz messen. Die Geschichte der statistischen Qualitätskontrolle zeigt, warum auffälliges Verhalten eine Untersuchung verdient, während Datenqualitätsdimensionen eine gemeinsame Sprache dafür liefern, was „gut“ bedeutet.
Die 10 Methoden der Datenqualitätskontrolle unten sind als Kontroll-Stack aufgebaut. Beginnen Sie mit expliziten Regeln, ergänzen Sie gelernte und statistische Signale, überwachen Sie Lieferung und Struktur, schützen Sie sensible Daten mit der richtigen Architektur und verbinden Sie dann technische Incidents mit geschäftlichen Auswirkungen und Team-Workflows. Ein Praxisbeispiel finden Sie in diesem Leitfaden zur Validierung von Social-Pipeline-Daten.
Inhaltsverzeichnis
2. Datenvalidierung auf Datensatzebene anhand von Geschäftsregeln
3. Timeliness- und Datenankunfts-Monitoring mit Berechnung der erwarteten Lieferzeit
4. Erkennung von Schema-Änderungen und strukturelles Monitoring
9. Umfassende Data-Observability-Dashboards und kollaboratives Monitoring
10. Modulare Architektur für Qualitätskontrolle mit schnellem Deployment
Vergleich in 10 Punkten: Methoden der Datenqualitätskontrolle
1. KI-gestützte Anomalieerkennung mit Baseline-Learning
KI-gestützte Anomalieerkennung sucht nach Verhalten, das vom normalen Muster eines Datensatzes abweicht. Statt Engineers für jede Tabelle einen Schwellenwert schreiben zu lassen, lernt das System eine Baseline aus historischem Volumen, Verteilungen, Kategorien oder anderen Observability-Metriken. Das macht den Ansatz nützlich für Datensätze mit Saisonalität, Wachstum, unregelmäßiger Nachfrage oder Zusammenhängen, die für eine feste Regel zu komplex sind.
Das Modul Data Anomalies von digna ist für genau diese Art von Monitoring ausgelegt. Im Finanzumfeld kann ein unerwarteter Rückgang des Transaktionsvolumens auftreten, bevor ein Abgleich scheitert. Im Gesundheitswesen kann ein ungewöhnliches Muster bei Patientenaufnahmen oder eine auffällige Verteilung von Laborergebnissen eine Untersuchung rechtfertigen. In der Telekommunikation kann eine Veränderung im Netzwerkverkehr auf eine Verschlechterung des Dienstes oder ungewöhnliche Nutzung hindeuten. Das sind Erkennungssignale, kein automatischer Beweis für ein geschäftliches Problem, daher muss ein Verantwortlicher die Ursache weiterhin prüfen.
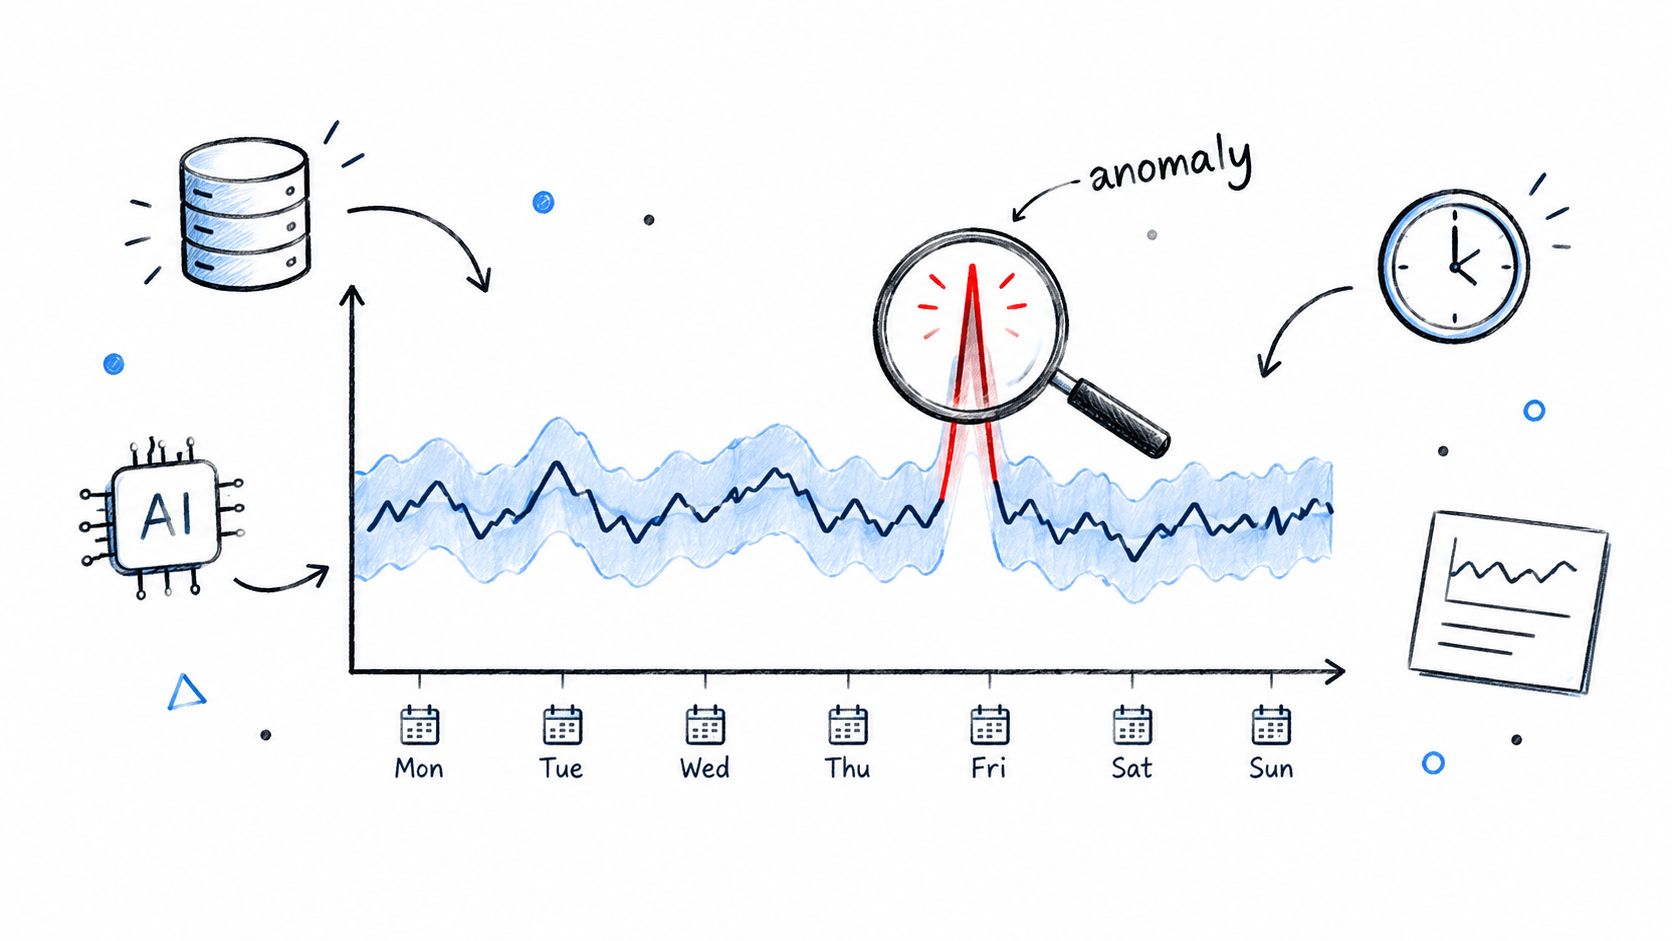
Die Baseline erklärbar machen
Sammeln Sie genug repräsentative Historie, bevor Sie Alerts als handlungsrelevant behandeln. Ein neuer Datensatz, eine Übernahme, ein Produktlaunch oder eine Quellmigration kann eine alte Baseline irreführend machen. Ergänzen Sie geschäftlichen Kontext wie Kalenderereignisse, geplante Kampagnen und Zuständigkeiten für Quellen und prüfen Sie frühe Alerts gemeinsam mit Fachexperten, um die Sensitivität abzustimmen.
Praxisregel: Nutzen Sie Anomalieerkennung, um zu finden, wofür niemand eine Regel geschrieben hat, und beweisen Sie dann mit deterministischer Validierung, was fehlgeschlagen ist.
Die Anomalieerkennung für kategoriale Daten von digna ist besonders relevant, wenn eine Verschiebung im Kategorienmix wichtiger ist als eine einfache Zeilenzahl. Teams können diesen Ansatz mit Wisely AI solutions kombinieren, wenn sie breitere Unterstützung bei der KI-Einführung brauchen.
2. Datenvalidierung auf Datensatzebene anhand von Geschäftsregeln
Validierung auf Datensatzebene beantwortet eine präzise Frage: Erfüllt diese Zeile die Regeln, die sie nutzbar machen? Sie prüft einzelne Datensätze gegen Pflichtfelder, zulässige Werte, Wertebereiche, Formate, Beziehungen und Geschäftslogik. Anders als ein aggregiertes Anomaliesignal kann sie genau den Datensatz, die Regel und das Ergebnis benennen, die eine Korrektur erfordern.
Typische Regelarten sind Not-Null-, Eindeutigkeits-, Datentyp-, Wertebereichs-, Format-, referenzielle Integritäts- und Geschäftslogik-Checks. Leitlinien zur Datenvalidierung beschreiben, wie Teams diese Kontrollen über Datenbank-Constraints, Schema-Validierung und automatisierte Tests durchsetzen. Ein Finanzinstitut validiert etwa Transaktionslimits und Anforderungen an Gegenparteien. Ein Gesundheitssystem prüft Patientenkennungen und Diagnosecodes. Eine Behörde verifiziert Lizenzangaben oder Felder zur Leistungsberechtigung.
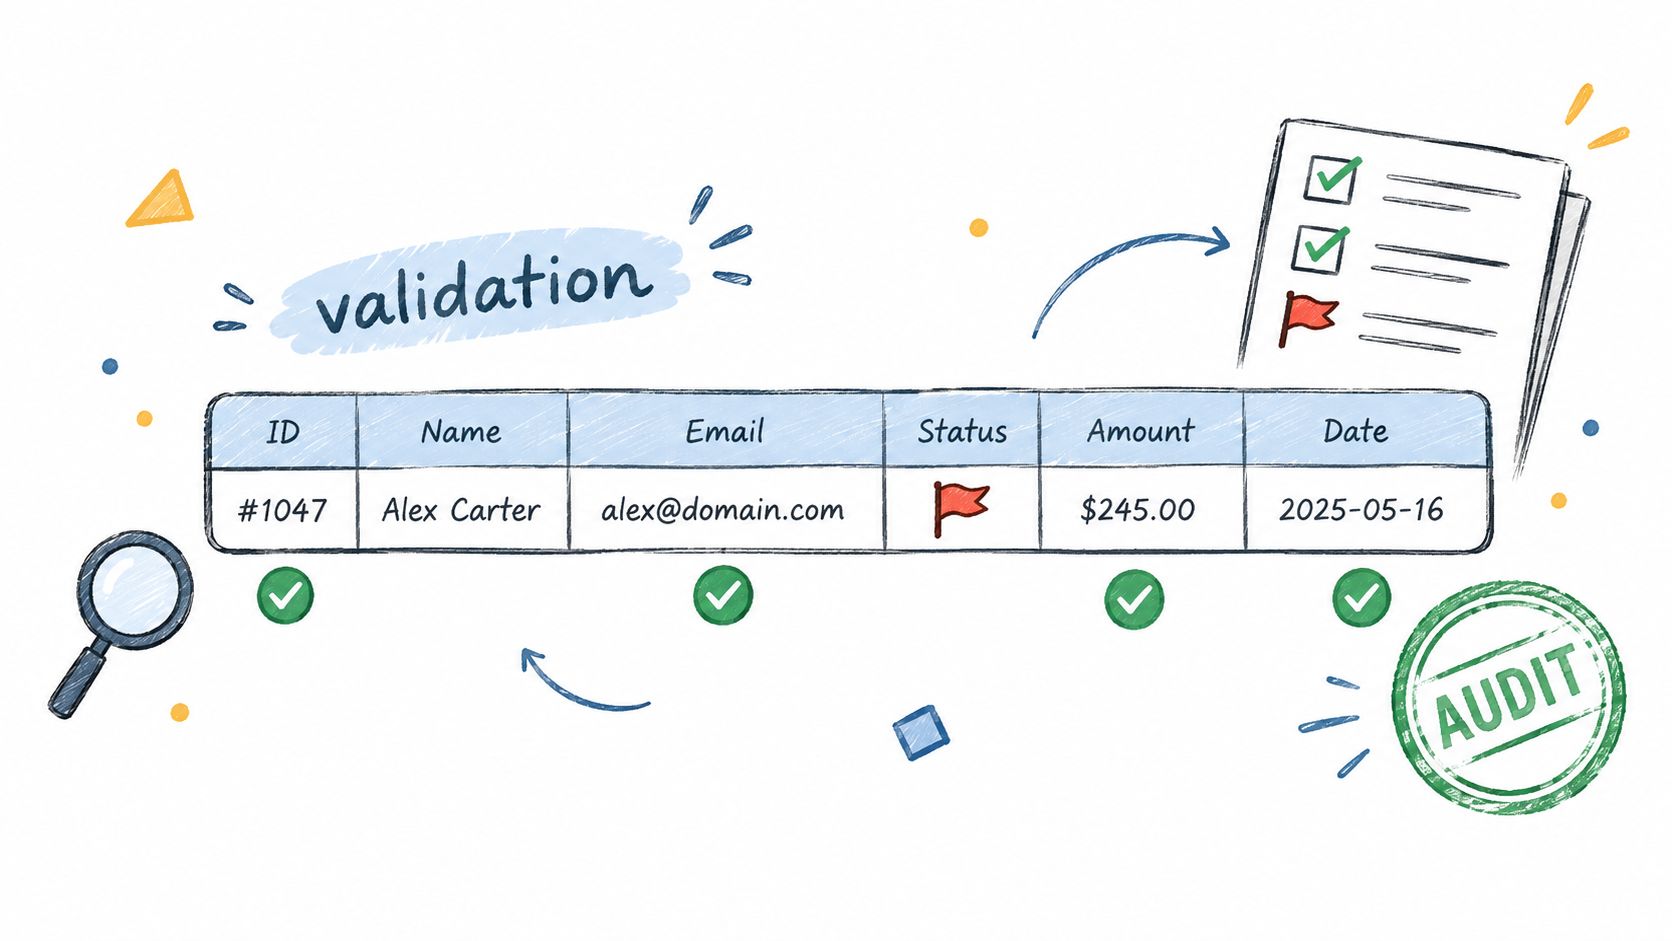
Fehler nachvollziehbar machen
Validieren Sie nicht von Anfang an jedes Feld gleich gründlich. Priorisieren Sie Datensätze, die regulatorisches Reporting, Zahlungen, klinische Entscheidungen, Kundenidentität oder Management-KPIs betreffen. Fachverantwortliche sollten festlegen, was „gültig“ bedeutet, denn ein technisch zulässiger Wert kann trotzdem gegen eine betriebliche Vorgabe verstoßen.
Versionieren Sie die Regeln und bewahren Sie Nachweise über bestandene und fehlgeschlagene Prüfungen auf. So können Engineers einen Fehler in der Quelle von einer bewussten Richtlinienänderung unterscheiden, und Governance-Teams erhalten einen Audit-Trail.
Datenvalidierungsregeln und kontinuierliche Datenqualität bei digna unterstützen eigene Validierungslogik mit Ausführung in der Datenbank und nachvollziehbaren Regelergebnissen. Der Preis dafür ist Wartungsaufwand. Regeln sind für bekannte Bedingungen zuverlässig, erkennen aber keine unbekannte Verschiebung, solange niemand sie als Regel formuliert oder die Validierung mit Anomalieerkennung kombiniert.
3. Timeliness- und Datenankunfts-Monitoring mit Berechnung der erwarteten Lieferzeit
Ein Datensatz kann vollständig und gültig sein und trotzdem unbrauchbar, weil er zu spät ankam. Timeliness-Monitoring vergleicht tatsächliche Ankünfte mit dem erwarteten Lieferverhalten und erkennt verspätete Ladungen, fehlende Dateien, verfrühte Lieferungen und eine schleichende Verschlechterung der Quellperformance. Es schützt Dashboards, nachgelagerte Modelle, Abgleiche und operative Abläufe, die darauf angewiesen sind, dass Daten zu einem bestimmten Zeitpunkt verfügbar sind.
Ein Bankteam kann mit einem Timeliness-Monitor einen fehlenden nächtlichen Batch erkennen, bevor das Morgenreporting läuft. Eine Gesundheitseinrichtung kann verspätete Patienteninformationen untersuchen, bevor sie die Koordination stören. Ein Telekommunikationsanbieter kann verfolgen, ob Nutzungs- oder Abrechnungsdaten innerhalb des erwarteten Zeitfensters ankommen. Das Modul Timeliness von digna berechnet die erwartete Lieferzeit aus beobachteten Mustern, statt jede Quelle so zu behandeln, als folge sie demselben Zeitplan.
Verzögerung von Ausbleiben unterscheiden
Ein einziger Monitor sollte nicht für Quellen mit unterschiedlichem Lieferrhythmus zuständig sein. Legen Sie Erwartungen pro Quelle, Tabelle oder Workload fest und verbinden Sie Alerts mit Incident-Management und Rufbereitschaft. Ein Alert, der ohne Verantwortlichen in einem Dashboard liegt, ist nur ein verzögerter Entdeckungsmechanismus.
Kombinieren Sie Ankunfts-Monitoring mit Volumen-Monitoring. Eine Datei, die pünktlich, aber ohne Datensätze ankommt, ist ein anderer Fehler als eine Datei mit dem erwarteten Volumen, die zu spät kommt. Verfolgen Sie auch das Liefermuster über die Zeit, denn eine Pipeline, die sich schleichend verspätet, braucht womöglich Aufmerksamkeit, bevor sie eine formale Frist verpasst.
Die Definition und Monitoring-Leitlinien zur Datenaktualität bieten einen nützlichen Rahmen, um Frische, Liefererwartungen und operative Reaktion voneinander zu trennen. Der wichtigste Zielkonflikt ist die Strenge der Alerts. Feste Zeitfenster sind leicht zu erklären, gelernte Erwartungen passen sich besser an den realen Betrieb an, müssen aber überprüft werden, wenn sich Zeitpläne ändern.
4. Erkennung von Schema-Änderungen und strukturelles Monitoring
Schema-Drift erzeugt Fehler, die Checks auf Zeilenebene womöglich nie sehen. Ein Lieferant kann ein Feld hinzufügen, eine Spalte entfernen, einen Datentyp ändern oder einen Constraint anpassen und trotzdem Datensätze schicken, die einzeln betrachtet plausibel wirken. Nachgelagerte Transformationen, Reports und Modelle können dann lautstark scheitern oder, schlimmer noch, mit einer veränderten Interpretation weiterlaufen.
Schema-Monitoring vergleicht die eingehende Struktur mit einer freigegebenen, vertraglich vereinbarten Baseline. Es kann Änderungen über Kennzahlen wie die Spalten-Abweichungsrate oder einen zusammengesetzten Schema-Ähnlichkeitswert quantifizieren und strukturelle Änderungen so für automatisierte Alerts nutzbar machen. Schema-Drift-Metriken beschreiben diesen Ansatz, strukturelle Abweichungen zu messen, statt jede Änderung als gleich schwerwiegend zu behandeln.
Den Alert mit Auswirkungen hinterlegen
Eine zusätzliche optionale Spalte kann ein geringes Risiko sein. Eine entfernte Kennung oder eine Typänderung in einem regulatorischen Feed kann einen sofortigen Stopp erfordern. Dokumentieren Sie Tabellenabhängigkeiten, damit der Alert die betroffenen ETL-Jobs, semantischen Modelle, Dashboards und Datenprodukte benennen kann, statt Engineers blind ermitteln zu lassen.
Die Erklärung zu Schema-Drift von digna beschreibt das operative Risiko unangekündigter Strukturänderungen. Der Schema Tracker erkennt hinzugefügte oder entfernte Spalten und geänderte Datentypen. Kombinieren Sie die Erkennung mit einem Freigabeprozess für Änderungen und automatisierten Kompatibilitätstests. Monitoring allein sagt Ihnen, dass sich die Struktur geändert hat. Governance entscheidet, ob die Änderung erlaubt, in Quarantäne gestellt oder eskaliert wird.
5. Statistische Analyse und Trendanalyse von Datenmetriken
Statistische Analyse untersucht, wie sich Qualitäts- und Geschäftskennzahlen über die Zeit verhalten. Sie kann schleichende Drift, veränderte Volatilität, ungewöhnliche Verteilungen und Muster aufdecken, die eine einzelne Bestanden/Nicht-bestanden-Regel übersieht. Gleitende Durchschnitte, Standardabweichungsanalyse und Trendzerlegung sind sinnvolle Optionen, doch die Methode muss zur Metrik passen. Ein stetiger Messwert, eine kategoriale Verteilung und eine Ereigniszählung verhalten sich statistisch nicht gleich.
Ein Finanzteam analysiert etwa die Umsatzvolatilität, während eine Gesundheitseinrichtung Aufnahmeraten, Behandlungsvolumen oder Ergebniskennzahlen untersucht. Ein Telekommunikationsteam kann auf einen schleichenden Anstieg abgebrochener Anrufe oder ein verändertes Churn-Muster achten. Das Modul Data Analytics von digna ist für die historische Analyse von Observability-Metriken und Geschäftsverhalten gedacht und hilft Teams zu klären, ob eine Veränderung isoliert auftritt oder Teil eines Trends ist.
Repräsentative Historie verwenden
Eine Baseline aus einem auffälligen Zeitraum kann zu falschen Schlüssen führen. Schließen Sie bekannte Ausfälle, Migrationen und Sonderereignisse aus, wenn sie keinen normalen Betrieb darstellen, oder annotieren Sie sie, damit Analysten das Ergebnis richtig einordnen können. Fachwissen bleibt unverzichtbar, denn statistische Auffälligkeit ist nicht dasselbe wie fachliche Fehlerhaftigkeit.
Für Anomalie-Alerts bieten Konfidenzintervalle und rollierende Abweichungsregeln besser begründbare Grenzen als willkürliche feste Limits. Ein dokumentierter Ansatz löst einen Alert aus, wenn eine Metrik das 99-%-Konfidenzintervall für denselben Tag des Vorjahres verlässt oder mehr als 3 Standardabweichungen von einem rollierenden Durchschnitt abweicht. Beispiele für statistische Anomalieerkennung veranschaulichen diese Techniken.
Der Zielkonflikt liegt in der Interpretierbarkeit. Statistische Methoden erkennen Muster effizient, doch Teams brauchen klare Erklärungen und Ereigniskontext, bevor sie eine Pipeline blockieren oder an die Geschäftsleitung eskalieren. Einen verwandten analytischen Ansatz beschreibt die Datentrendanalyse von digna.
6. Metrikberechnung und Analyse direkt in der Datenbank
Qualitäts-Monitoring erfordert keinen Export von Produktionsdaten an einen externen Dienst. Bei der Ausführung in der Datenbank werden Metriken berechnet, Checks ausgeführt und Analysen durchgeführt, und zwar direkt im Warehouse, Lake oder in der Datenbank des Kunden. Diese Architektur reduziert Datenbewegungen und unterstützt Governance-Anforderungen, nach denen sensible Datensätze in der Infrastruktur des Unternehmens bleiben müssen.
Ein Finanzinstitut kann Compliance-Validierungen auf regulierten Daten ausführen, ohne sie anderswohin zu kopieren. Eine Gesundheitseinrichtung kann die Qualität von Patientendaten bewerten und geschützte Informationen dabei in ihrer kontrollierten Umgebung halten. digna führt Anomalie-, Validierungs-, Timeliness- und verwandte Checks innerhalb der Kundendatenbanken aus, sodass die Monitoring-Ebene Daten prüfen kann, ohne die zugrunde liegenden Datensätze an sich zu ziehen.
Performance ebenso schützen wie Datenschutz
Die Ausführung in der Datenbank verlagert Verantwortung in die Datenbankumgebung. Monitoring-Abfragen brauchen passende Berechtigungen, am besten reinen Lesezugriff, und müssen so gestaltet sein, dass Qualitätschecks nicht mit Produktions-Workloads konkurrieren. Planen Sie aufwendiges Profiling oder historische Analysen in Zeiten geringerer Last und messen Sie Abfragelaufzeit und Ressourcenverbrauch als Teil des Monitoring-Designs.
Daten an Ort und Stelle zu lassen, reduziert die Angriffsfläche, ersetzt aber weder Zugriffskontrolle noch Query-Governance noch Performance-Tests.
Der Zielkonflikt liegt in Portabilität und Betriebskomplexität. Ein Check, der in einem Warehouse gut funktioniert, braucht in einem anderen womöglich Optimierung, vor allem wenn sich Tabellengrößen, Partitionierung oder Workload-Muster unterscheiden. Teams sollten Abfragepläne testen, wo sinnvoll inkrementell rechnen und auch die Last des Monitorings selbst überwachen.
7. Monitoring von Business-KPIs und operativen Kennzahlen
Technische Qualitätssignale sind wichtig, weil sie Entscheidungen und Abläufe beeinflussen. Business-Monitoring verbindet die zugrunde liegenden Daten mit Kennzahlen wie Umsatz, Transaktionsvolumen, Kundenaktivität, Conversion, Behandlungsergebnissen, Churn oder Netzverfügbarkeit. Eine unerwartete KPI-Veränderung kann ein Datenproblem aufdecken, bevor ein technischer Verantwortlicher einen fehlgeschlagenen Test bemerkt, während eine technisch einwandfreie Pipeline trotzdem ein Geschäftsergebnis liefern kann, das untersucht werden muss.
Ein Finanzteam sieht vielleicht eine unerwartete Veränderung bei Umsatz oder Transaktionsvolumen. Ein Gesundheitsdienstleister überwacht Aufnahmezahlen und operative Ergebnisse. Ein Telekommunikationsanbieter verfolgt Churn, den durchschnittlichen Umsatz pro Nutzer oder die Netzverfügbarkeit. Das sind nicht automatisch Datenfehler. Ein echtes Marktereignis kann eine echte KPI-Bewegung auslösen, deshalb sollte Business-Monitoring eine Untersuchung anstoßen, statt eine Ursache festzustellen.
Eskalation vor dem Alert vereinbaren
Wählen Sie die entscheidungskritischsten Kennzahlen aus und definieren Sie das erwartete Verhalten gemeinsam mit den Verantwortlichen. Halten Sie fest, wer einen Alert erhält, welche Nachweise benötigt werden und ab wann das Problem zu einem geschäftlichen Incident wird. Bewegt sich der KPI, verfolgen Sie ihn rückwärts über Aktualität, Volumen, Schema, Validierung, Quelle und Plattformsignale.
Geschäftskennzahlen helfen auch bei der Priorisierung. Ein fehlgeschlagener Check auf einer ungenutzten Entwicklungstabelle sollte nicht mit einem kleineren Fehler konkurrieren, der ein regulatorisches Reporting betrifft. Das stärkste Setup verknüpft KPI-Anomalien mit Lineage und technischem Kontext, sodass Analysten und Engineers denselben Incident aus unterschiedlichen Blickwinkeln untersuchen können.
Business Monitoring von digna kombiniert die Analyse geschäftlicher und operativer Kennzahlen mit den übergreifenden Qualitätssignalen, die für eine Ursachenanalyse nötig sind. Der praktische Zielkonflikt ist die Zuständigkeit. Fachbereiche müssen helfen, Bedeutung und Wesentlichkeit zu definieren, sonst raten Engineers, welche Veränderungen zählen.
8. Observability für Datenplattform und Workloads
Checks auf Datensatzebene zeigen, dass Daten falsch sind. Plattform-Observability hilft zu erklären, warum. Sie beobachtet Workload-Verhalten, Ressourcenverbrauch, Verfügbarkeit, Abfrageperformance, Joblaufzeiten und Änderungen an der Infrastruktur, die Daten bewegt und speichert. Diese Systemsicht erkennt Fehler, die in einer einzelnen Tabelle nicht sichtbar sind.
Ein ETL-Job dauert vielleicht länger, weil ein Warehouse unter Last steht. Eine plötzliche Workload-Spitze kann doppelte Pipelines oder eine ineffiziente Transformation offenlegen. Eine Plattformänderung kann viele Datensätze gleichzeitig betreffen, selbst wenn der letzte Validierungslauf jeder einzelnen Tabelle bestanden wurde. Diese Signale helfen Teams, einen Fehler in der Quelle von einem Kapazitätsproblem, einer Konfigurationsänderung oder einem Workload-Ungleichgewicht zu unterscheiden.
Signale korrelieren, nicht vermengen
Legen Sie das normale Plattformverhalten fest und korrelieren Sie Abweichungen dann mit Datenqualitäts-Incidents. Beginnen mehrere Aktualitäts-Alerts, nachdem der Ressourcenverbrauch gestiegen ist, kann Plattform-Telemetrie die Untersuchung Richtung Infrastruktur lenken. Ändert sich eine Quelle, während die Plattform stabil bleibt, verdienen Quelle oder Transformation genauere Aufmerksamkeit.
Halten Sie Plattform-Incidents und Datenfehler auseinander. Eine langsame Abfrage bedeutet nicht automatisch schlechte Daten, und eine gültige Tabelle beweist nicht, dass die Plattform gesund ist. Getrennte Zuständigkeiten können die Reaktion verbessern, sofern das Incident-System die Beziehungen zwischen Workload, Pipeline, Datensatz und geschäftlicher Auswirkung erhält.
Data Platform Observability von digna überwacht Plattformzustand, Workload-Verhalten, Verbrauch, Verfügbarkeit und performancebezogene Signale. Der Zielkonflikt ist die Breite. Mehr Telemetrie kann mehr Rauschen erzeugen, daher sollten Teams festlegen, welche Plattformänderungen sofortiges Handeln erfordern und welche in die Kapazitätsplanung oder ein Engineering-Review gehören.
9. Umfassende Data-Observability-Dashboards und kollaboratives Monitoring
Eine Kontrolle, die nur ein einziger Spezialist interpretieren kann, skaliert nicht über eine Datenorganisation hinweg. Kollaboratives Monitoring führt Validierungsergebnisse, Anomaliesignale, Timeliness, Schema-Änderungen, KPIs, Plattformzustand, Zuständigkeiten und Incident-Historie in gemeinsamen operativen Ansichten zusammen. Data Engineers brauchen technische Details, Analysten brauchen Kontext zu Kennzahlen, Governance-Teams brauchen Nachweise und Führungskräfte eine kompakte Sicht auf Zuverlässigkeit und Auswirkungen.
Das Dashboard sollte sich an diesen Entscheidungen orientieren, statt standardmäßig jede verfügbare Metrik anzuzeigen. Ein Engineer braucht vielleicht die fehlgeschlagene Regel, die Quellpartition, die Abfrage und die Lineage. Ein Analyst braucht den betroffenen KPI, den Aktualitätsstatus und die fachliche Definition. Eine Governance-Verantwortliche braucht den Owner, die Lösungshistorie und den Nachweis, dass eine Kontrolle wie erwartet gelaufen ist.
Alert-Müdigkeit gezielt reduzieren
Fassen Sie zusammengehörige Alerts zu Incidents zusammen, unterdrücken Sie Duplikate und zeigen Sie das wertvollste Signal zuerst. Ergänzen Sie Drill-down-Ansichten für die Untersuchung, halten Sie die Startansicht aber auf das fokussiert, was Handlungsbedarf hat. Feedback der Nutzer ist selbst eine operative Kontrolle. Wenn Teams eine Kategorie von Alerts regelmäßig wegklicken, ändern Sie Schwellenwert, Routing oder Kontrolldesign.
Integrieren Sie das Dashboard in die Kommunikations- und Incident-Management-Tools des Teams. Weisen Sie Datensätzen und Regeln Verantwortliche zu, dokumentieren Sie Behebungsschritte und bewahren Sie den Entscheidungsverlauf auf. So wird aus einer Visualisierungsebene ein System für Zusammenarbeit.
digna bietet ein nutzerzentriertes Dashboard für Engineers, Analysten und Stakeholder mit gemeinsamer Sicht auf Incidents, Trends und Status. Der Zielkonflikt ist die Governance des Dashboards selbst. Ohne klare Definitionen und Zuständigkeiten kann eine zentrale Ansicht zu einem überfüllten Katalog ungelöster Signale werden statt zu einem Entscheidungswerkzeug.
10. Modulare Architektur für Qualitätskontrolle mit schnellem Deployment
Das wirksamste Datenqualitätsprogramm wächst meist in Schichten, statt als eine große Implementierung anzukommen. Eine modulare Architektur erlaubt es einem Team, mit der Fehlerart zu beginnen, die den größten Schaden verursacht, nachzuweisen, dass die Kontrolle funktioniert, und angrenzende Abdeckung hinzuzufügen, ohne das Betriebsmodell zu ersetzen. Eine Finanzorganisation beginnt vielleicht mit Validierung und Anomalieerkennung und ergänzt dann Timeliness und Schema-Monitoring. Ein Team im Gesundheitswesen startet mit Qualitätsmanagement und bindet später klinische Ergebniskennzahlen an. Ein Telekommunikationsanbieter etabliert zuerst Plattform-Observability, bevor er auf Kontrollen auf Datensatzebene ausweitet.
Kontrollen nach Risiko priorisieren
Beginnen Sie mit einem Data-Quality-Assessment, das kritische Datensätze, Nutzer, Verantwortliche und bekannte Incidents identifiziert. Wählen Sie das erste Modul auf Basis von Belegen aus, nicht danach, welche Funktion sich am leichtesten vorführen lässt. Ein Problem mit fehlenden Ladungen verlangt nach Timeliness-Monitoring. Ein defekter Lieferanten-Feed verlangt nach Schema-Tracking. Ein fehlerhaftes Feld zur Leistungsberechtigung verlangt nach Validierung auf Datensatzebene.
Planen Sie eine Ausbau-Roadmap über 6 bis 12 Monate, mit Meilensteinen, die an Abdeckung und Fehlerbehebung geknüpft sind statt nur an die Installation. Sichern Sie sich das Sponsoring der Data Governance, stellen Sie interne Integrationskapazität bereit und nutzen Sie branchenspezifische Vorlagen nur als Ausgangspunkt. Frühe Erfolge sollten eine breitere Einführung finanzieren, statt isolierte Vorführungen zu bleiben.
Auf Abdeckung bauen: Ergänzen Sie Kontrollen, die unterschiedliche Fehlerarten aufdecken, nicht drei Varianten desselben Tests.
Die modulare Plattform von digna enthält ab der ersten Modulauswahl einen Scheduler, einen Datenkatalog, Integrationen und Funktionen für die Zusammenarbeit. Zu den Deployment-Optionen gehören Private Cloud und On-Premises-Installation in der Cloud, der VPC oder dem Rechenzentrum des Kunden. Der Zielkonflikt ist Disziplin. Modulare Lizenzierung und modulares Deployment können die Einstiegshürde senken, doch Teams brauchen weiterhin ein gemeinsames Kontrollmodell, konsistente Zuständigkeiten und eine klare Regel, wann aus einem Alert eine Behebungsaufgabe wird.
Vergleich in 10 Punkten: Methoden der Datenqualitätskontrolle
Methode | Implementierungsaufwand 🔄 | Ressourcenbedarf ⚡ | Erwartete Ergebnisse 📊 | Ideale Einsatzszenarien 💡 | Wichtigste Vorteile ⭐ |
|---|---|---|---|---|---|
KI-gestützte Anomalieerkennung mit Baseline-Learning | Mittel bis hoch; erfordert ML-Pipelines und Model Ops | Mittel bis hoch; braucht historische Daten und Rechenleistung | Hoch ⭐⭐⭐; erkennt neue und subtile Abweichungen früh | Komplexe Zeitreihen, saisonale Geschäftskennzahlen | Adaptive Baselines; weniger Fehlalarme |
Datenvalidierung auf Datensatzebene anhand von Geschäftsregeln | Niedrig bis mittel; Erstellung und Pflege von Regeln | Niedrig bis mittel; Regel-Engine und fachlicher Input | Hoch ⭐⭐⭐; deterministisches Bestanden/Nicht bestanden mit Audit-Trails | Regulatorische Compliance, Transaktionsintegrität | Nachvollziehbare Verstöße; präzise Ansatzpunkte für die Behebung |
Timeliness- und Datenankunfts-Monitoring mit Berechnung der erwarteten Lieferzeit | Niedrig bis mittel; Scheduling + Musterlernen | Mittel; historische Ankunftsprotokolle und Integration | Hoch ⭐⭐⭐; schnelle Erkennung verspäteter/fehlender Ladungen | ETL-Pipelines, SLA-kritische Datenlieferungen | Vorausschauende Alerts bei Pipeline-Ausfällen |
Erkennung von Schema-Änderungen und strukturelles Monitoring | Niedrig; kontinuierliches Schema-Tracking & Mapping | Niedrig bis mittel; Metadaten- und Abhängigkeitskatalog | Hoch ⭐⭐⭐; verhindert Ausfälle in nachgelagerten Systemen | Lieferanten-Feeds, ETL-Jobs, schemaabhängige Systeme | Strukturelle Alerts in Echtzeit und Versionshistorie |
Statistische Analyse und Trendanalyse von Datenmetriken | Mittel; statistische Modelle und Interpretation | Mittel; historische Metriken und Zeit von Analysten | Hoch ⭐⭐⭐; Trend-Insights und Frühwarnsignale | Aggregierte Geschäftskennzahlen, Erkennung von Volatilität | Statistische Einblicke mit Kontext; erkennt schleichende Verschiebungen |
Metrikberechnung und Analyse direkt in der Datenbank | Mittel; datenbankspezifische Abfragen und Optimierungen | Niedrig bis mittel; nutzt vorhandene Datenbankressourcen | Hoch ⭐⭐⭐; sichere Checks in Echtzeit mit wenig Datenbewegung | Umgebungen mit sensiblen Daten, compliance-orientierte Organisationen | Datenresidenz bleibt gewahrt; weniger Datenbewegung |
Monitoring von Business-KPIs und operativen Kennzahlen | Mittel; KPI-Definition, Mapping und Dashboards | Mittel; Input der Stakeholder und BI-Tools | Hoch ⭐⭐⭐; verknüpft Datenprobleme mit geschäftlichen Auswirkungen | Management-Dashboards, OKR-Tracking, Betriebs-Monitoring | Verbindet Datenqualität mit Geschäftsergebnissen |
Observability für Datenplattform und Workloads | Hoch; integriert Telemetrie aus mehreren Komponenten | Hoch; Plattform-Telemetrie, Logs und Tools | Hoch ⭐⭐⭐; ganzheitliche Einblicke in Plattformzustand und Kosten | Plattformbetrieb, Kapazitätsplanung, Kostenoptimierung | Erkennt Infrastrukturprobleme, die viele Datensätze betreffen |
Umfassende Data-Observability-Dashboards und kollaboratives Monitoring | Mittel bis hoch; UX, rollenbasierte Ansichten und Integrationen | Mittel; teamübergreifende Akzeptanz und Tools | Hoch ⭐⭐⭐; schnellere Reaktion auf Incidents und bessere Abstimmung | Funktionsübergreifende Teams, die gemeinsamen Kontext brauchen | Zentrale Sicht; baut Silos ab; rollenbasierte Einblicke |
Modulare Architektur für Qualitätskontrolle mit schnellem Deployment | Anfangs niedrig bis mittel; Planung für modularen Ausbau | Anfangs niedrig; wächst mit den Modulen (Abrechnung pro Tabelle) | Hoch ⭐⭐⭐; schneller Time-to-Value und iterativer Rollout | Schrittweise Einführung, Branchenvorlagen, schnelle Pilotprojekte | Schnelles Deployment; schrittweiser Ausbau; geringeres Anfangsrisiko |
Einen Kontroll-Stack aufbauen, keine Checkliste
Welche Methoden der Datenqualitätskontrolle richtig sind, hängt davon ab, welchen Fehler Sie abfangen müssen. Datensatzvalidierung ist die stärkste erste Antwort, wenn die Anforderung explizit ist, etwa eine Kennung, die nicht null sein darf, ein zulässiger Wert, ein gültiger Wertebereich, eine passende Referenz oder eine Geschäftsregel, die für jeden Datensatz gelten muss. Sie liefert konkrete Nachweise und ermöglicht gezielte Behebung, kann aber nicht jedes unbekannte Muster erkennen.
Anomalieerkennung und statistische Analyse decken Verhaltensänderungen ab. Baseline-Learning ist nützlich, wenn normales Verhalten mit Saisonalität, Wachstum oder Kategorienmix schwankt. Statistische Analyse hilft Teams, Trends, Volatilität und Verteilungsänderungen über die Zeit zu verstehen. Keiner der beiden Ansätze sollte Daten ohne Kontext automatisch blockieren. Eine legitime Kampagne, Übernahme, Migration oder ein betriebliches Ereignis kann auffällig aussehen, daher brauchen Verantwortliche eine Möglichkeit, erwartete Änderungen zu erklären und freizugeben.
Timeliness-Monitoring adressiert die Zuverlässigkeit der Lieferung. Es zeigt Teams, dass eine Quelle zu spät, zu früh oder gar nicht wie erwartet angekommen ist. Kombinieren Sie es mit Volumen-Checks, um eine fehlende Ladung von einer leeren oder unvollständigen zu unterscheiden. Schema-Tracking behandelt strukturelle Drift, darunter hinzugefügte oder entfernte Spalten und Änderungen von Datentypen. Der Schweregrad sollte von nachgelagerten Abhängigkeiten abhängen. Eine harmlose Erweiterung und eine Breaking Change an einer Kennung sollten nicht dieselbe Reaktion auslösen.
Architektur zählt, wenn Governance, Datenschutz oder Vorgaben zur Datenresidenz Datenbewegungen einschränken. Ausführung in der Datenbank erlaubt Teams, Metriken zu berechnen und Checks dort auszuführen, wo die Daten bereits liegen, erfordert aber weiterhin Zugriffskontrolle, Abfrageoptimierung und Workload-Monitoring. Der Kontroll-Stack braucht auch Kontext. Business-Monitoring zeigt, ob eine technische Änderung Umsatz, Transaktionen, Betrieb, klinische Ergebnisse oder eine andere Entscheidungskennzahl betrifft. Plattform-Observability hilft, Ressourcen-, Workload-, Verfügbarkeits- und Performancebedingungen zu erkennen, die den Incident erklären könnten.
Die operative Ebene entscheidet, ob aus Erkennung Verbesserung wird. Weisen Sie kritischen Datensätzen Verantwortliche zu, dokumentieren Sie fachliche Definitionen, verbinden Sie Alerts mit dem Incident-Management und bewahren Sie Nachweise über bestandene und fehlgeschlagene Prüfungen zusammen mit der Regelversion auf, die sie erzeugt hat. Nutzen Sie harte Fail-Kontrollen für Verstöße, die die nachgelagerte Nutzung unsicher machen, und weiche Anomalie-Alerts dort, wo vor dem Handeln eine Untersuchung nötig ist. Legen Sie Konformitätsschwellen für explizite Kontrollen fest und nutzen Sie Konfidenzintervalle oder gelernte Baselines, wo sich das Verhalten über die Zeit ändert.
Ein sinnvoller Rollout beginnt mit kritischen Datensätzen statt mit der gesamten Landschaft. Erfassen Sie deren Nutzer und Fehlerhistorie, wählen Sie die erste Kontrolle für die risikoreichste Lücke und vereinbaren Sie einen Verantwortlichen und einen Reaktionsweg, bevor Sie Alerts aktivieren. Ergänzen Sie dann komplementäre Methoden, etwa Validierung mit Timeliness, Anomalieerkennung mit Schema-Monitoring und Geschäftskennzahlen mit Plattform-Telemetrie. digna unterstützt diesen modularen Ansatz mit Anomalieerkennung, Validierung, Timeliness, Schema-Tracking, Ausführung in der Datenbank, Business-Monitoring und Plattform-Observability.
Das Programm sollte wachsen, wenn Teams zeigen können, dass Kontrollen zuverlässig laufen, Incidents beim richtigen Verantwortlichen ankommen und die Behebung den vorgelagerten Prozess verbessert. So wird Datenqualität zu operativer Infrastruktur statt zu einem periodischen Audit oder einer langen Checkliste, die niemand mehr ansieht.
digna bietet eine Enterprise-Plattform für Datenqualität und Data Observability, die in der Umgebung des Kunden läuft und Validierung, Anomalieerkennung, Timeliness, Schema-, Business- und Plattform-Monitoring kombiniert. Bauen Sie damit sich ergänzende Kontrollebenen rund um kritische Datensätze auf, lernen Sie die modulare Plattform über digna kennen und planen Sie Ihr erstes Deployment rund um die Fehlerart, die am meisten zählt.
Wenn Sie entscheiden, welche Ebene Sie zuerst einführen, zeigt die digna Lösung für Datenqualitätsmanagement, wie Validierung, Anomalieerkennung, Timeliness und Schema-Tracking als getrennte Module in Ihrer eigenen Datenbank laufen. So können Sie mit einer Kontrolle starten und die übrigen ergänzen, während die Abdeckung wächst.
Häufig gestellte Fragen
Was sind die wichtigsten Methoden der Datenqualitätskontrolle?
Die wichtigsten Methoden sind Anomalieerkennung, Validierung auf Datensatzebene, Timeliness-Monitoring, Erkennung von Schema-Änderungen, statistische Trendanalyse, Berechnung in der Datenbank, KPI-Monitoring, Plattform-Observability, gemeinsame Dashboards und ein modularer Rollout. Jede Methode erkennt eine andere Fehlerart, deshalb empfiehlt der Beitrag, sie als sich ergänzende Ebenen zu kombinieren, statt sich auf ein einziges Regelwerk zu verlassen.
Was ist der Unterschied zwischen Datenvalidierung und Anomalieerkennung?
Validierung beweist, dass eine bestimmte Zeile gegen eine bekannte Regel verstoßen hat, während Anomalieerkennung Verhalten meldet, das von einer gelernten Baseline abweicht. Regeln liefern den genauen Datensatz und einen Audit-Trail, übersehen aber unbekannte Verschiebungen wie einen plausibel wirkenden Volumeneinbruch. Das praktische Muster: Unerwartetes mit Anomalieerkennung finden, Fehler dann mit Validierung belegen.
Wie legt man Schwellenwerte für statistische Datenqualitäts-Alerts fest?
Nutzen Sie Konfidenzintervalle oder rollierende Abweichungsregeln statt willkürlicher fester Grenzen. Ein dokumentierter Ansatz löst einen Alert aus, wenn eine Metrik außerhalb des 99-%-Konfidenzintervalls für denselben Tag des Vorjahres liegt oder sich um mehr als 3 Standardabweichungen von einem rollierenden Durchschnitt entfernt. Schließen Sie Ausfälle und Migrationen vorher aus der Baseline-Historie aus.
Warum die Aktualität von Daten überwachen, wenn sie bereits validiert sind?
Weil ein Datensatz vollständig und gültig, aber trotzdem nutzlos sein kann, wenn er erst nach dem Morgenreport ankommt. Timeliness-Monitoring vergleicht tatsächliche Ankünfte pro Quelle mit den erwarteten Lieferzeiten, und in Kombination mit Volumen-Checks lässt sich eine verspätete Datei von einer unterscheiden, die pünktlich, aber leer ankam.
Wo sollte ein Team bei der Einführung von Datenqualitätskontrollen beginnen?
Beginnen Sie mit einem Data-Quality-Assessment der kritischen Datensätze und wählen Sie dann die erste Kontrolle für die risikoreichste Lücke: Timeliness bei fehlenden Ladungen, Schema-Tracking bei defekten Lieferanten-Feeds, Validierung bei fehlerhaften Feldern. Der Beitrag empfiehlt, den Ausbau über 6 bis 12 Monate zu planen, mit Meilensteinen, die an Abdeckung und Fehlerbehebung geknüpft sind.


