Data Quality Compliance: Ein Audit-Leitfaden für 2026
|
7
min. Lesezeit

Schlechte Datenqualität kostet Unternehmen im Schnitt 12,9 Millionen USD pro Jahr laut dem in Marktstudien zitierten Benchmark, und das noch bevor es um den Audit-Befund, das Remediation-Ticket oder den Bericht geht, dem niemand vertraut. In regulierten Umgebungen ist dieser Kostenfaktor kein Effizienzproblem mehr, sondern ein Kontrollproblem: Dieselben fehlerhaften Datensätze, die Analysten ausbremsen, schwächen auch regulatorische, finanzielle und prüfungsrelevante Nachweise.
Ich habe dieses Muster immer wieder in Data Warehouses und Data Pipelines gesehen, die von außen in Ordnung wirkten. Die Berichte stimmten mit den Zahlen des Vormonats überein, die Alerts waren laut, aber vertraut, und dann legte eine Compliance-Prüfung das Kernproblem offen: Niemand konnte belegen, wie die Daten validiert, nachverfolgt oder verteidigt worden waren. Genau diese Lücke behandelt dieser Leitfaden: Wie aus kontinuierlichen Datenqualitätsprüfungen Audit-Nachweise werden, die einer genauen Prüfung standhalten.
Inhaltsverzeichnis
Von periodischen Audits zu kontinuierlichen Compliance-Kontrollen
Datenqualitätsdimensionen auf regulatorische Standards abbilden
Warum regelbasierte Validierung für moderne Compliance nicht ausreicht
Fallstudie: 9000 manuelle Regeln durch KI-gestützte Observability ersetzen
Warum Data Quality Compliance Chefsache ist
Ein schwacher Kontroll-Stack für Daten erzeugt ein Risiko auf Vorstandsebene, lange bevor daraus ein Audit-Befund wird. Ein vielzitierter Benchmark beziffert die durchschnittlichen Kosten schlechter Datenqualität auf 12,9 Millionen USD pro Jahr, und dieselbe Studie schätzt die Verluste für die US-Wirtschaft auf bis zu 3,1 Billionen USD jährlich Zusammenfassung der Marktstudie. Diese Zahlen sind wichtig, weil sie zeigen, wie schnell Validierungslücken zu einem finanziellen Risiko werden und nicht nur zu Aufräumarbeit für das Datenteam.
Die operativen Kosten zeigen sich zuerst im Kontrollzentrum. Wenn Umsatzberichte auf inkonsistenten Datensätzen beruhen, wenn Audit-Aufzeichnungen unvollständig sind oder wenn Teams nicht erklären können, wie eine Kennzahl zustande kam, ist das kein Tooling-Problem mehr, sondern ein Ownership-Problem. Dieselbe Studie bringt schlechte Datenqualität damit in Verbindung, dass 31 % des Unternehmensumsatzes negativ beeinflusst werden, und gibt an, dass Datenteams bis zu 80 % ihrer Zeit mit dem Bereinigen und Aufbereiten von Daten verbringen statt mit deren Analyse Zusammenfassung der Marktstudie. Das trifft Aufsicht und Umsetzung gleichermaßen.
Faustregel: Wenn ein Datensatz nicht validiert, nachverfolgt und verteidigt werden kann, ist das Dashboard reine Kosmetik.
Die nächste Bruchlinie ist die Messung. Eine Branchenumfrage ergab, dass 59 % der Unternehmen die Datenqualität überhaupt nicht messen Zusammenfassung der Marktstudie. In regulierten Branchen wie Finanzdienstleistungen, Gesundheitswesen, Telekommunikation und öffentlicher Verwaltung führt diese Lücke zu Reibung im Audit, denn ungemessene Daten lassen sich nicht konsistent verteidigen, wenn jemand Nachweise verlangt.
Für Teams, die ihre Ausgangsbasis definieren, bietet was Data Compliance in der Praxis bedeutet einen guten Einstieg. Rechtliche und operative Verantwortliche sind außerdem auf Governance- und Compliance-Verfahren angewiesen, denn das eigentliche Versagen ist selten ein einzelnes fehlerhaftes Feld. Es ist das Fehlen eines Kontrollsystems, das belegen kann, wie Daten geprüft, korrigiert und aufbewahrt wurden.
Wie schlechte Datenqualität Compliance-Verstöße auslöst
Compliance-Verstöße sehen selten wie ein sauberer Systemausfall aus. Meist zeigen sie sich als inkonsistente Berichte, eine verpasste Meldefrist oder ein Audit Trail, der nicht belegen kann, dass die Zahlen geprüft wurden. Deshalb sind sie so schwer früh zu erkennen. Teams bemerken das Problem oft erst, wenn jemand fragt, wie eine Kennzahl entstanden ist, lange nachdem die Drift in der Pipeline begonnen hat.
Der regulatorische Druck ist längst real. Die Übersicht zur digitalen Regulierung weist darauf hin, dass der EU Data Governance Act seit dem 24. September 2023 gilt und dass Unternehmen, die bereits am 23. Juni 2022 Datenvermittlungsdienste erbrachten, bis zum 24. September 2025 Zeit hatten, die einschlägigen Vorgaben für Vermittler umzusetzen. Governance ist keine interne Präferenz mehr. Sie wird gesetzlich festgeschrieben, und schwache Datenkontrollen werden zum rechtlichen Risiko.
Wo die Fehler meist beginnen
Der Fehlerpunkt ist oft operativ, nicht technisch. Eine Kontrolle bricht an der Übergabe zwischen Quellsystemen, ein Team verwendet abweichende Definitionen, oder die manuelle Validierung gilt als ausreichend, weil das monatliche Review normalerweise durchgeht. In derselben Regulierungsübersicht gaben in einer Umfrage 58 % der Unternehmen an, dass schlechte Datenqualität erhebliche Compliance-Probleme verursacht habe, und 45 % berichteten von schwachen oder inkonsistenten Data-Governance-Frameworks.
Datenqualität wird zum Compliance-Problem, wenn niemand zeigen kann, dass die Kontrolle zum richtigen Zeitpunkt, auf den richtigen Daten und mit dem richtigen Ergebnis gelaufen ist.
Die geschäftlichen Auswirkungen folgen demselben Muster. die geschäftlichen Auswirkungen schlechter Datenqualität zeigt, wie fehlerhafte Daten über die Analytik hinaus in operative Entscheidungen gelangen, wo Fehler schwerer zu verteidigen und schwerer rückgängig zu machen sind. Eine weitere Marktstudie, die in derselben Regulierungsübersicht zitiert wird, besagt, dass 78 % der Großunternehmen in den vergangenen 12 Monaten erhebliche Datenqualitätsprobleme hatten und 54 % angaben, dass diese Probleme Umsatz, regulatorische Compliance oder operative Effizienz direkt beeinträchtigt hätten. Wenn die Eingangsdaten instabil sind, sind es auch die Compliance-Nachweise.
Von periodischen Audits zu kontinuierlichen Compliance-Kontrollen
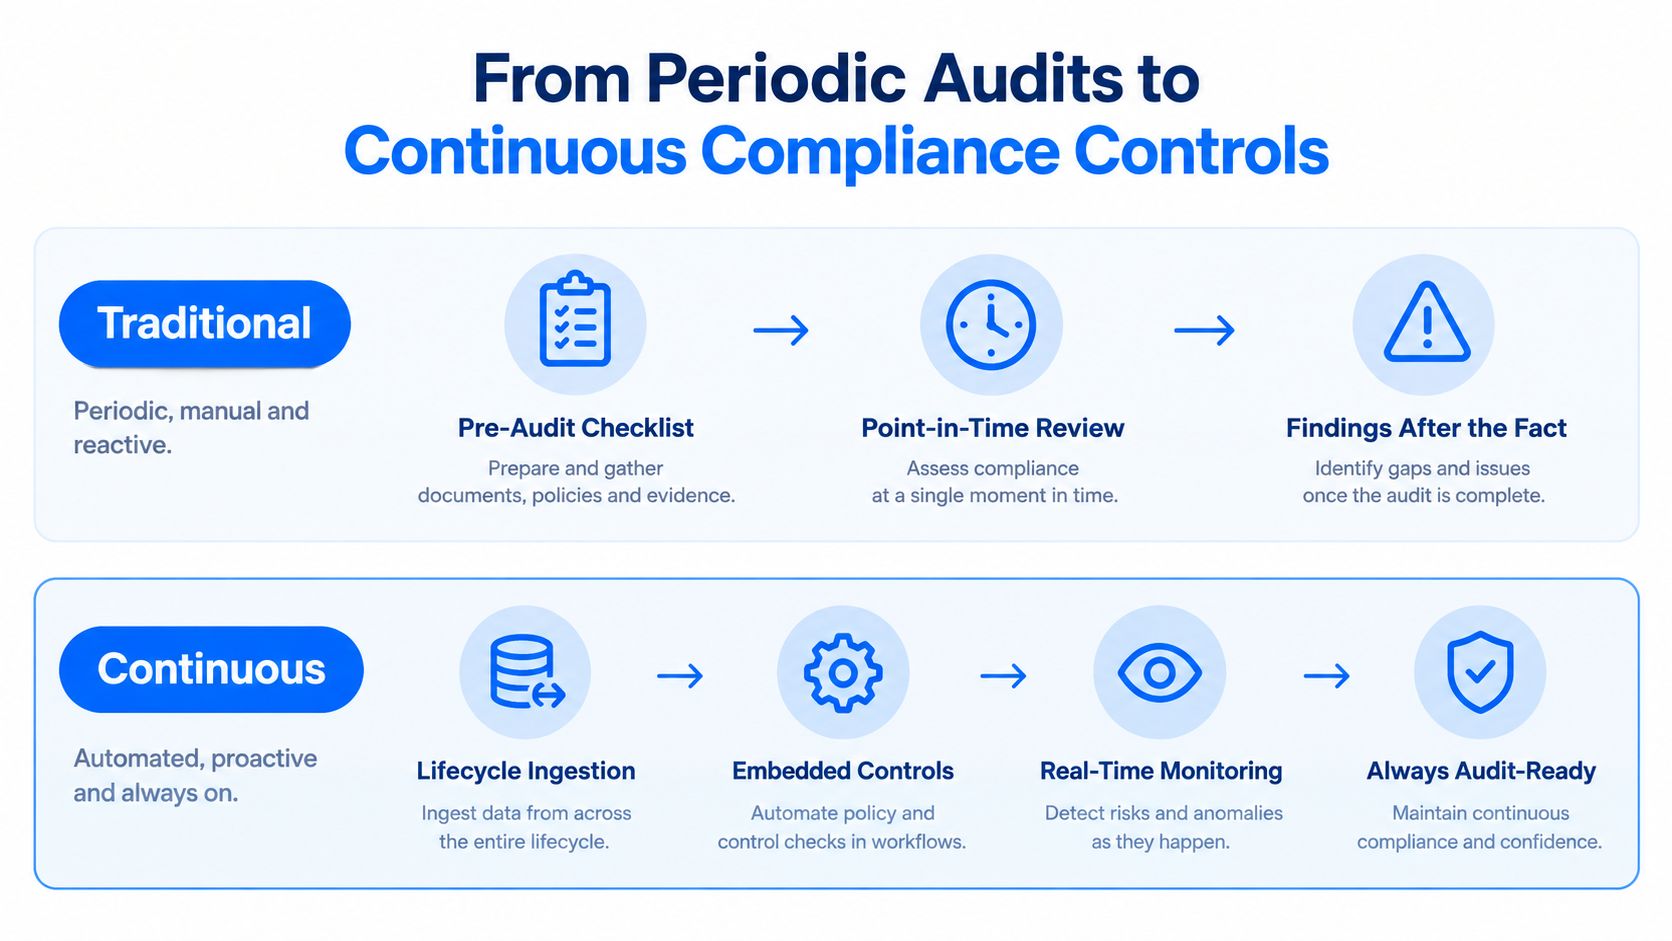
Periodische Audits sind weiterhin wichtig, aber als einzige Verteidigungslinie sind sie zu langsam. Bis ein Audit eine defekte Prüfung findet, sind die fehlerhaften Daten bereits durch Ingestion, Transformation und Reporting gewandert. Deshalb beruht moderne Data Quality Compliance auf kontinuierlichen Kontrollen, die in den gesamten Lebenszyklus eingebettet sind, und nicht auf einem Review einmal pro Quartal.

Der Wandel klingt abstrakt, bis man ihn auf die Arbeit abbildet, die Ihr Team ohnehin erledigt. Kontinuierliches Monitoring überwacht Aktualität, Vollständigkeit und strukturelle Änderungen, während die Daten fließen. Automatisierte Validierung wendet jedes Mal dieselbe Logik an. Das ist wichtig, weil Prüfer sich weniger dafür interessieren, ob eine Regel existiert, als dafür, ob sie konsequent durchgesetzt wurde. Die Lineage-Dokumentation schließt den Kreis, indem sie zeigt, woher die Daten kamen, wie sie sich verändert haben und welche Prüfungen sie durchlaufen haben.
Was sich operativ ändert
In einem periodischen Modell ist Governance etwas, worauf man sich vorbereitet. In einem kontinuierlichen Modell ist Governance etwas, das die Plattform jeden Tag erzeugt. Dieser Unterschied verringert die Lücke zwischen Kontrolldesign und Kontrollbetrieb, weil die Nachweise im normalen Verarbeitungsprozess entstehen, statt im Nachhinein rekonstruiert zu werden.
Faustregel: Wenn eine Kontrolle nur während der Audit-Vorbereitung existiert, ist sie keine Kontrolle, sondern eine Gedächtnisstütze.
Das Beste an diesem Modell ist, dass es zum Verhalten regulierter Pipelines passt. Daten kommen verspätet an, Schemas driften, und Quellsysteme ändern sich ohne große Vorwarnung. Wenn die Prüfungen in den Workflow eingebettet sind, sieht das Team diese Fehler früh genug, um sie zu beheben, bevor sie zu Fehlern im Reporting werden.
Ein nützliches Umsetzungsmuster besteht darin, diese Prüfungen automatisch in das Compliance-Reporting einzuspeisen. Genau hier wird Automatisierung des Compliance-Reportings operativ relevant. Sie spart die manuelle Aufbereitung, die Antworten auf Audit-Anfragen normalerweise verzögert.
Datenqualitätsdimensionen auf regulatorische Standards abbilden
Compliance-Frameworks und Data-Engineering-Teams verwenden für dasselbe Problem oft unterschiedliche Begriffe. Eine Aufsichtsbehörde fragt, ob der Datensatz zweckmäßig ist, ein Engineer fragt, ob die Spalte die Validierung bestanden hat. Die Lücke schließt sich, wenn man Qualitätsdimensionen auf anerkannte Standards abbildet, statt beides als getrennte Diskussionen zu behandeln.
Die Data Quality Guidance der kanadischen Regierung definiert neun Dimensionen: Zugänglichkeit, Genauigkeit, Kohärenz, Vollständigkeit, Konsistenz, Interpretierbarkeit, Relevanz, Zuverlässigkeit und Aktualität Leitfaden der kanadischen Regierung. Das australische Nationalarchiv nennt ISO 8000-110:2021 als globalen Standard für Datenqualität und Unternehmensstammdaten und führt gängige Dimensionen wie Genauigkeit, Vollständigkeit, Konsistenz, Integrität, Aktualität, Eindeutigkeit/Deduplizierung und Gültigkeit auf Leitfaden des australischen Nationalarchivs.
Womit Prüfer tatsächlich arbeiten können
Diese Frameworks sind wichtig, weil sie Teams eine Sprache geben, die sich direkt auf Kontrollen abbilden lässt. Wenn eine Richtlinie verlangt, dass Kundendaten genau und aktuell sein müssen, kann das technische Team das in Validierungsregeln, Latenzprüfungen und Abgleichslogik übersetzen. Wenn die Richtlinie verlangt, dass die Daten zuverlässig sein müssen, sollten die Nachweise zeigen, wie und wann sie geprüft wurden.
Der Data Governance Primer der U.S. Administration for Community Living besagt, dass Unternehmensdaten regelmäßig gegen definierte Qualitätsstandards geprüft werden sollten, und nennt Datenzugriff, Datendefinition, Datenschutzrichtlinien, Sicherheitsstandards und Datenqualitätsstandards als Governance-Themen ACL Primer. Die Regierung von New South Wales ergänzt ein nützliches operatives Detail: Datenqualitätsmanagement ist ein kontinuierlicher Prozess über den gesamten Datenlebenszyklus, und Behörden sollten Anforderungen definieren, die an den geschäftlichen Bedarf gekoppelt sind, einschließlich Standards für Verfügbarkeit, Metriken und Ziele NSW-Modul zur Datenqualität.
Diese Kombination ist das praktische Modell. Standards definieren die Dimensionen, Governance definiert die Verantwortung, und der Betrieb definiert, wie die Nachweise entstehen.
Für Teams, die diese Kategorien in eine funktionierende Kontrolllandkarte überführen, ist Dimensionen der Datenqualität ein hilfreicher Bezugspunkt. Am einfachsten lässt sich prüfen, was man klar benennen kann.
Warum regelbasierte Validierung für moderne Compliance nicht ausreicht
Regelbasierte Validierung hat nach wie vor ihren Platz, stößt aber schnell an Grenzen, sobald Pipelines größer, schneller und stärker voneinander abhängig werden. Fest codierte Prüfungen funktionieren, wenn das Datenmodell stabil ist und Ausnahmen selten sind. Sie funktionieren schlecht, wenn sich das Schema ändert, Quellsysteme sich weiterentwickeln oder dieselbe Regel an einem halben Dutzend Stellen gepflegt werden muss.
Das eigentliche Problem ist die Wartung
Eine Regel kann Ihnen sagen, dass etwas fehlgeschlagen ist. Sie kann nicht sagen, ob der Fehler im Kontext relevant ist, ob sich die Struktur der Daten geändert hat oder ob dasselbe Verhalten für eine Quelle normal und für eine andere verdächtig ist. Deshalb landen Teams bei Alert Fatigue, fragilen SQL-Skripten und Kontrollen, die sich von der Realität entfernen. Die operativen Kosten sind nicht nur Laufzeit-Overhead, sondern Wissensverlust, wenn ein Engineer geht und die Regellogik mit ihm.
Die Compliance-Lücke ist größer als Genauigkeit, Vollständigkeit und Aktualität. Jüngste regulatorische Entwicklungen verlangen Nachweise, nicht nur Regeln. Das heißt nachweisbare Lineage, Rückverfolgbarkeit, dokumentierte Quellen für Trainingsdaten und messbare Qualitätsmetriken. Die Hochrisiko-Anforderungen des EU AI Act betonen die Dokumentation von Quellen, Transformationen und Nutzung der Trainingsdaten, während das ETSI-Framework von 2026 18 Datenqualitätsmetriken formalisiert, darunter Nutzbarkeit, Lineage, Rückverfolgbarkeit und Aktualität Überblick über Regulierung und Standards.
Ein statisches Regelwerk kann belegen, dass eine Bedingung geprüft wurde. Es kann nicht belegen, dass das gesamte Kontrollumfeld vertrauenswürdig geblieben ist.
Hier kommt Observability ins Spiel. Kontinuierliches Monitoring erkennt Drift, achtet auf Kontextänderungen und bewahrt die operativen Aufzeichnungen, die Prüfer brauchen. Außerdem hilft es Teams, die typische Falle zu vermeiden, Compliance als Checkliste statt als lebendiges Kontrollsystem zu behandeln.
Für Data Warehouses, die noch auf handgebaute Validierungen setzen, gibt es einen direkten Vergleich unter manuell definierte technische Datenqualitätsregeln. In der Praxis lautet die Frage nicht, ob es Regeln geben sollte, sondern ob sie allein ausreichen. Das tun sie meistens nicht.
Audit-taugliche Nachweise durch kontinuierliches Monitoring
Ob ein Audit bestanden wird oder nicht, hängt oft am Nachweis. Wenn eine Validierungsprüfung stattgefunden hat, es aber keine dauerhafte Aufzeichnung von Datensatz, Regeleinstellungen, Zeitstempel und Ergebnis gibt, ist die Kontrolle schwer zu verteidigen. Deshalb behandle ich audit-taugliche Nachweise als vorrangiges Designziel und nicht als Nebeneffekt.
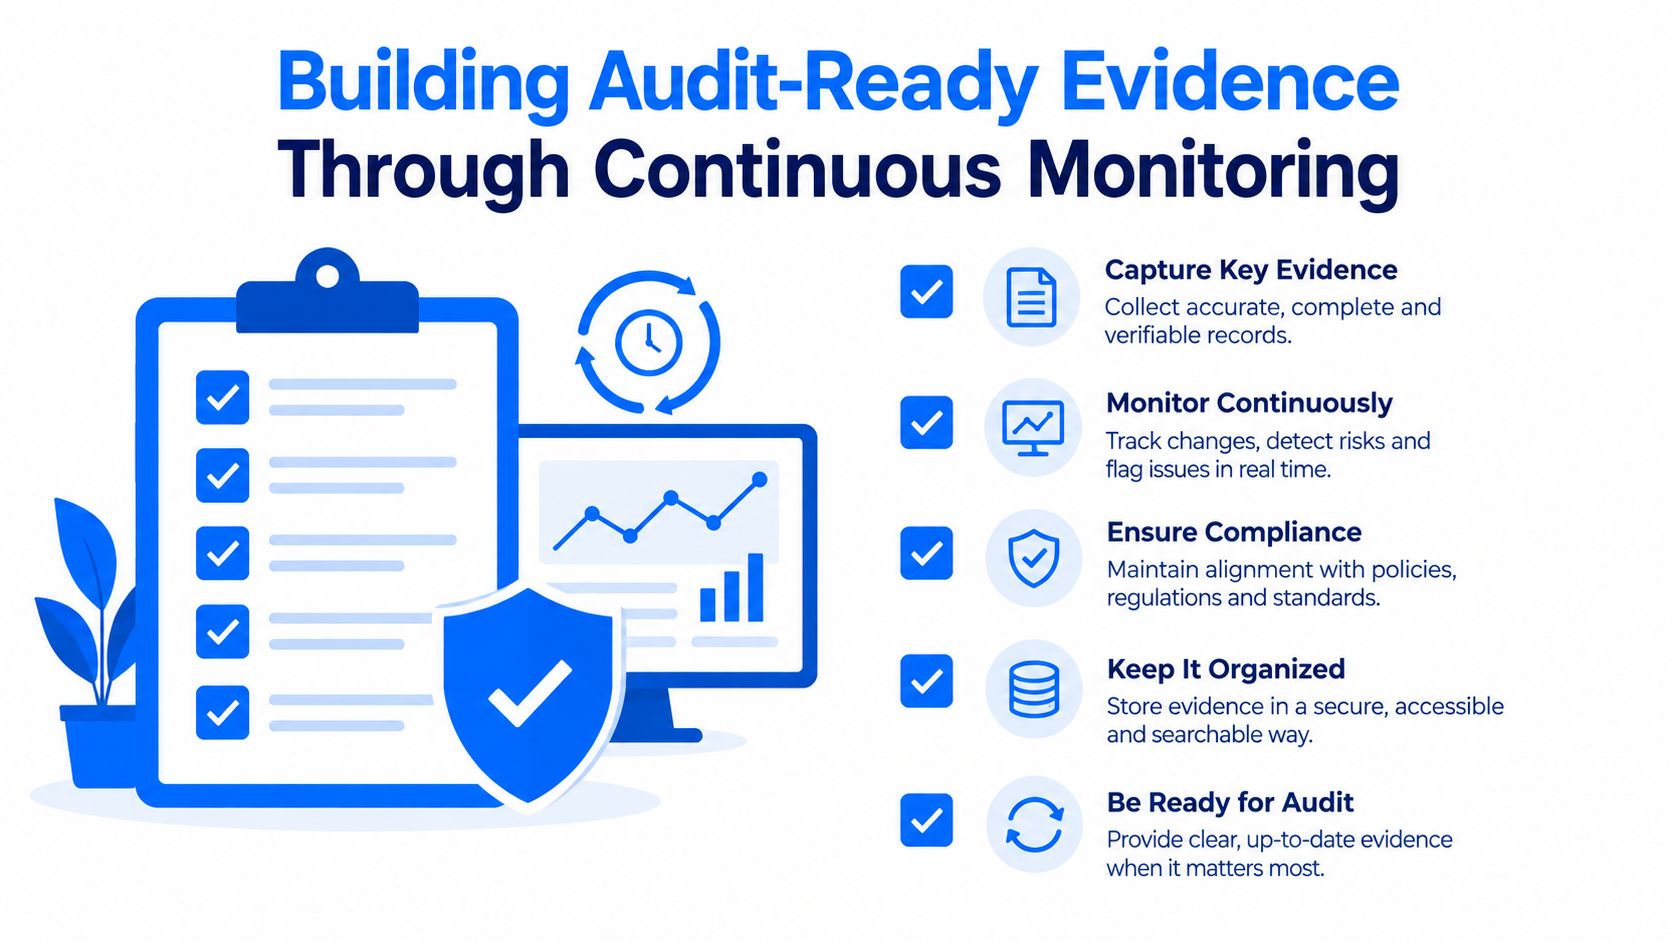
Das praktische Muster ist einfach. Protokollieren Sie jedes Validierungsereignis unveränderlich, und machen Sie das Log so granular, dass es die Fragen beantwortet, die Prüfer tatsächlich stellen. Dazu gehören Identität des Datensatzes, Identität der Spalte, Regelparameter, Zeitstempel, Ergebnis (bestanden/fehlgeschlagen), Fehleranzahl und Lösungsverlauf Leitfaden zu Audit Trails. Sobald das vorhanden ist, können Teams rekonstruieren, was geprüft wurde, wann die Prüfung lief und wie sich die Kontrolle vor und nach Regeländerungen verhalten hat.
Was diese Nachweise Ihnen bringen
Sie verkürzen Untersuchungen, wenn Schema Drift oder verspätet eintreffende Daten das nachgelagerte Reporting beeinträchtigen. Außerdem bleiben historische Schwellenwerte erhalten. Das ist wichtig, wenn sich eine Regel ändert, das Audit-Team aber trotzdem wissen muss, was unter der vorherigen Einstellung passiert ist. In regulierten Pipelines ist das der Unterschied zwischen „wir glauben, es war in Ordnung“ und „hier ist der genaue Kontrollstatus zum damaligen Zeitpunkt“.
Der technische Nutzen ist genauso wichtig. Wenn Validierungsergebnisse konsistent protokolliert werden, können Teams die Qualität im Moment der Validierung quantifizieren, statt erst nachdem die Daten bereits weitergeflossen sind. Das beschleunigt die Ursachenanalyse erheblich, weil die Nachweise auf das konkrete Kontrollereignis verweisen und nicht auf ein vages Symptom in der Pipeline.
Der unterstützende Workflow muss die Auslieferung nicht verlangsamen. Richtig umgesetzt läuft er innerhalb der Pipeline, speichert die Kontrollaufzeichnung zusammen mit dem Ereignis und exportiert sie bei Bedarf, wenn Compliance sie anfordert. Diesem Modell vertraue ich, weil es sowohl operativem Druck als auch einer Audit-Prüfung standhält.
Für Teams, die sehen möchten, wie das in der Praxis aussieht, gibt es außerdem ein Demo-Video.
Fallstudie: 9000 manuelle Regeln durch KI-gestützte Observability ersetzen
ITSV, das IT-Rückgrat der österreichischen Sozialversicherung, ist ein gutes Beispiel, weil die Größenordnung eine echte Entscheidung erzwang. Das Team steuerte die Datenqualität im Data Warehouse mit 9000 handgeschriebenen Regeln, und dieses Modell passte weder zum Volumen noch zum Wartungsaufwand. Die Umgebung verarbeitete 50 GB pro Tag aus mehr als 30 Quellen in mehr als 500 Strukturen, was ständiges Nachjustieren der Regeln untragbar machte Details zur Fallstudie.
Das alte Setup zeigte die üblichen Symptome. Wissen ging verloren, wenn Mitarbeitende das Unternehmen verließen, die Dokumentation hinkte den Regeln hinterher, und kein Team war wirklich durchgängig für das Framework verantwortlich. Über 140 Alerts pro Tag füllten die Postfächer, die meisten wurden ignoriert, weil ihre Bedeutung unklar war, und nur 25 % der relevanten Datenqualitätsfälle waren abgedeckt Details zur Fallstudie.
Was sich mit den neuen Kontrollen geändert hat
Bereits im September 2021 begann ITSV, das regelbasierte Framework durch digna Data Anomalies und digna Data Timeliness zu ersetzen. Die Analyse blieb in der eigenen Infrastruktur von ITSV, was den Datenschutzanforderungen entsprach, und das Team musste weder Schwellenwerte justieren noch Regeln manuell pflegen. Data Timeliness lernte die Ankunftsmuster und meldete verspätete oder fehlende Daten, während Data Anomalies das normale Verhalten im gesamten Data Warehouse lernte und Abweichungen meldete Details zur Fallstudie.
Das ist wichtig, weil es in diesem Fall nicht wirklich um einen Tool-Wechsel geht. Es geht darum, fragile Wartungsarbeit durch Observability zu ersetzen, die Nachweise erzeugt. Die Kontrollen ließen sich leichter verteidigen, weil sie kontinuierlich und nachvollziehbar waren, und das Team gewann Zeit zurück, die zuvor in die Sichtung von Fehlalarmen geflossen war.
Ich habe ähnliche Migrationen aus einem Grund funktionieren sehen: Sie verlagern die Verantwortung vom menschlichen Gedächtnis auf das Systemverhalten. Die Kontrollen hängen nicht davon ab, dass sich jemand erinnert, welche Regel im letzten Quartal hätte aktualisiert werden sollen. Sie laufen, protokollieren und eskalieren selbstständig.
Data Quality Compliance teamübergreifend operationalisieren
Selbst starke Observability schließt keine Governance-Lücke. Der schwierigste Teil von Data Quality Compliance ist oft die Verantwortung, weil die Fehler meist zwischen Teams liegen und nicht innerhalb eines Systems. Aktuelle Umfragedaten zeigen, dass 44 % der Befragten die Verantwortung auf mehrere Teams verteilt sehen, 61 % sich weiterhin auf manuelle Prüfungen oder SQL-basierte Validierung verlassen und nur 14 % SLAs unternehmensweit durchsetzen, obwohl 39 % SLAs für zentrale Pipelines verfolgen Umfragebericht.
Das zeigt, wo die Arbeit liegt. Das Problem ist nicht, dass Teams Qualität egal wäre. Sie haben die Verantwortung verteilt, ohne die Durchsetzung mitzuverteilen. Wenn niemand die Kontrolle durchgängig verantwortet, werden Alerts informell gesichtet, Incidents aus Gewohnheit weitergeleitet und Audit-Nachweise zu spät zusammengestellt.
Ein praxisnahes Betriebsmodell
Beginnen Sie mit einer namentlich benannten verantwortlichen Person für jeden kritischen Datensatz und legen Sie dann fest, was gemessen wird, wie oft geprüft wird und wohin Incidents gehen, wenn die Prüfung fehlschlägt. Machen Sie das Logging unveränderlich, halten Sie die Lineage am Datensatz und sorgen Sie für einen expliziten Eskalationspfad. Wenn ein Kontrollfehler keiner Person zugewiesen werden kann, ist die Kontrolle noch nicht operativ.
Eine zweite Anforderung ist Konsistenz über Teams hinweg. Engineering, Analytics und Governance müssen dieselben Definitionen für Aktualität, Vollständigkeit und Schemaänderungen verwenden. Wenn eine Gruppe über eine Metrik berichtet, während eine andere eine abweichende Interpretation desselben Felds validiert, wirkt der Audit Trail nur so lange stimmig, bis jemand nachfragt.
Faustregel: Compliance wird erst dann kontinuierlich, wenn Verantwortung, Monitoring und Eskalation so weit automatisiert sind, dass sie eine hektische Woche überstehen.
Eine Option für Teams, die ein solches Betriebsmodell aufbauen, ist digna. digna überwacht das Datenverhalten in der eigenen Umgebung des Kunden und unterstützt Validierung, Timeliness-Monitoring, Schema-Tracking und audit-taugliche Nachweise. Wenn Ihr Ziel ist, Kontrollen leichter verteidigen zu können, ohne Ihr Team in eine manuelle Regelfabrik zu verwandeln, lohnt sich ein Blick darauf, wie die Plattform zu Ihrem Data Warehouse und Ihrem Pipeline-Stack passt.
Wenn Sie sehen möchten, wie der Ansatz mit gelernten Baselines aus dem ITSV-Fall funktioniert, ohne Schwellenwerte zu schreiben oder zu justieren, zeigt digna Data Anomalies, wie das normale Verhalten über alle Tabellen hinweg modelliert und Abweichungen automatisch gemeldet werden.
Häufig gestellte Fragen
Was ist Data Quality Compliance?
Data Quality Compliance bedeutet, belegen zu können, dass regulierte Daten validiert, nachverfolgt und verteidigt und nicht nur geprüft wurden. Der Beitrag argumentiert, dass eine Kontrolle nur zählt, wenn Nachweise zeigen, dass sie zum richtigen Zeitpunkt, auf den richtigen Daten und mit dem richtigen Ergebnis gelaufen ist, statt erst während der Audit-Vorbereitung rekonstruiert zu werden.
Warum reichen regelbasierte Datenqualitätsprüfungen für Compliance nicht aus?
Fest codierte Regeln belegen, dass eine Bedingung geprüft wurde, können aber nicht zeigen, dass das gesamte Kontrollumfeld vertrauenswürdig geblieben ist. Sie brechen, wenn Schemas driften und sich Quellen ändern, erzeugen Alert Fatigue und verlieren Wissen, wenn Engineers gehen. Regulierungen wie der EU AI Act und die 18 Datenqualitätsmetriken von ETSI verlangen inzwischen auch Lineage und Rückverfolgbarkeit.
Was sollte ein Audit Trail für die Datenvalidierung enthalten?
Jedes Validierungsereignis sollte unveränderlich protokolliert werden, mit Identität des Datensatzes, Identität der Spalte, Regelparametern, Zeitstempel, Ergebnis (bestanden oder fehlgeschlagen), Fehleranzahl und Lösungsverlauf. Mit dieser Aufzeichnung können Teams genau rekonstruieren, was gelaufen ist und wie sich eine Kontrolle vor und nach der Änderung eines Schwellenwerts oder einer Regel verhalten hat.
Welche Datenqualitätsdimensionen lassen sich auf regulatorische Standards abbilden?
Die kanadische Data Quality Guidance nennt neun Dimensionen, darunter Genauigkeit, Vollständigkeit, Kohärenz, Zuverlässigkeit und Aktualität. ISO 8000-110:2021, zitiert vom australischen Nationalarchiv, ergänzt Integrität, Eindeutigkeit und Gültigkeit. Wer diese Dimensionen auf Validierungsregeln, Latenzprüfungen und Abgleichslogik abbildet, gibt Prüfern und Engineers ein gemeinsames Vokabular.
Wie hat ITSV 9000 manuelle Datenqualitätsregeln ersetzt?
Ab September 2021 ersetzte ITSV sein Framework aus handgeschriebenen Regeln durch digna Data Anomalies und Data Timeliness, die in der eigenen Infrastruktur laufen. Das Data Warehouse nimmt täglich 50 GB aus mehr als 30 Quellen auf, und das alte Setup erzeugte über 140 Alerts pro Tag, deckte aber nur 25 % der relevanten Fälle ab.


