KI-reife Daten: von Rohdaten zu vertrauenswürdiger KI
|
8
min. Lesezeit

Ein KI-Projekt sieht oft bis zu dem Moment gesund aus, in dem es Produktionsdaten berührt.
Das Team hat eine Modellidee, Budget, eine Cloud-Umgebung und Leute, die Pipelines bauen können. Dann bremst die Arbeit. Felder bedeuten in verschiedenen Systemen Verschiedenes. Die Schemaänderung von gestern hat eine Feature-Tabelle gebrochen. Labels stammen aus einem manuellen Prozess, dem niemand ganz traut. Die Daten existieren, doch niemand kann mit Zuversicht sagen, ob sie für Retrieval, Vorhersage oder automatisiertes Handeln sicher sind.
Genau dort merken viele Teams, dass nicht die Modellwahl sie blockiert hat. Es war die Datenreife.
Eine globale Umfrage von 2024 hat diese Lücke deutlich erfasst. Nur 12 % der Organisationen sagten, ihre Daten hätten ausreichende Qualität und Zugänglichkeit für eine wirksame KI-Umsetzung, obwohl 60 % angaben, KI sei ein zentraler Einfluss auf Datenprogramme geworden, ein Plus von 46 % gegenüber 2023. Dieselbe Umfrage ergab, dass 64 % Datenqualität als ihre größte Herausforderung der Datenintegrität nannten, während 77 % ihre Datenqualität als durchschnittlich oder schlechter bewerteten (globale Forschung zur KI-Reife).
Inhaltsverzeichnis
Einführung: Warum KI-Projekte vor dem Modell ins Stocken geraten
Bereit wofür? Eignung für Ihren KI-Anwendungsfall definieren
Wie Observability-Plattformen Daten zur Laufzeit KI-reif halten
Einführung: Warum KI-Projekte vor dem Modell ins Stocken geraten
In vielen Datenteams spielt sich ein vertrautes Muster ab. Das Produkt will einen Support-Copiloten. Risiko will Anomalieerkennung. Der Betrieb will Prognosen. Engineering bekommt den Stack schnell genug zusammen, doch der erste ernsthafte Test legt das Problem offen. Niemand ist sich einig, welche Tabelle maßgeblich ist, ob der letzte Ladevorgang vollständig war oder ob die Labels das Geschäftsergebnis widerspiegeln, das das Modell lernen soll.
Deshalb ist KI-reife Daten eine nützlichere Formulierung als „saubere Daten“. Sauberkeit klingt nach einmaliger Hygieneaufgabe. Reife ist strenger. Sie fragt, ob ein Datensatz für eine bestimmte KI-Aufgabe taugt, unter den aktuellen Betriebsbedingungen, mit genug Vertrauen, um Entscheidungen zu tragen.
Wenn Sie Modellexperimente im Notebook gut abschneiden und beim Anschluss an Live-Systeme scheitern sahen, kennen Sie dieses Problem bereits. Der Fehlschlag ist meist kein Rätsel. Er steckt in doppelten Entitäten, veralteten Eingaben, undokumentierten Transformationen oder brüchigen Übergaben zwischen Teams. Eine praktische Grundlage beginnt damit zu verstehen, warum Datenqualität für eine Organisation zählt, doch KI legt die Latte höher, weil die Daten für Menschen und Maschinen funktionieren müssen.
Der Stillstand beginnt meist weiter oben
Viele Teams stellen nicht die falsche Frage. Sie stellen eine zu breite: „Sind unsere Daten bereit für KI?“ Das klingt vernünftig, verdeckt aber die wichtigen Details. Bereit für die Suche über Dokumente ist etwas anderes als bereit für Bedarfsprognosen. Bereit für einen Assistenten mit Mensch im Kreis ist etwas anderes als bereit für einen Agenten, der Aktionen auslöst.
KI-Projekte scheitern selten daran, dass Daten fehlen. Sie scheitern daran, dass die vorhandenen Daten für genau den gebauten Ablauf nicht vertrauenswürdig genug sind.
Diese Unterscheidung ändert, wie Sie Reife bewerten. Sie hören auf, Volumen als Beweis zu nehmen. Sie beginnen, Eignung, Nachvollziehbarkeit und Laufzeitsicherheit zu prüfen.
Vertrauen muss den Kontakt mit Live-Systemen überstehen
Historische Qualitätsprüfungen zählen, reichen aber nicht. Ein Trainingsdatensatz kann gut vorbereitet aussehen und dennoch unsicher werden, sobald Schemata sich ändern, Ladevorgänge zu spät kommen oder vorgelagerte Logik sich unangekündigt verschiebt. In der Praxis lebt KI-Reife an zwei Orten zugleich:
Vorbereitungsqualität heißt, der Datensatz ist ausreichend definiert, validiert und dokumentiert, um genutzt zu werden.
Laufzeitvertrauen heißt, Sie können erkennen, wenn dieser Status nicht mehr gilt.
Das ist die lohnende Brille. Nicht „Haben wir viele Daten?“, sondern „Können diese Daten dieses KI-Verhalten heute tragen, mit Kontrollen, die Drift erkennen, bevor das Modell danach handelt?“
Was KI-reife Daten wirklich bedeuten
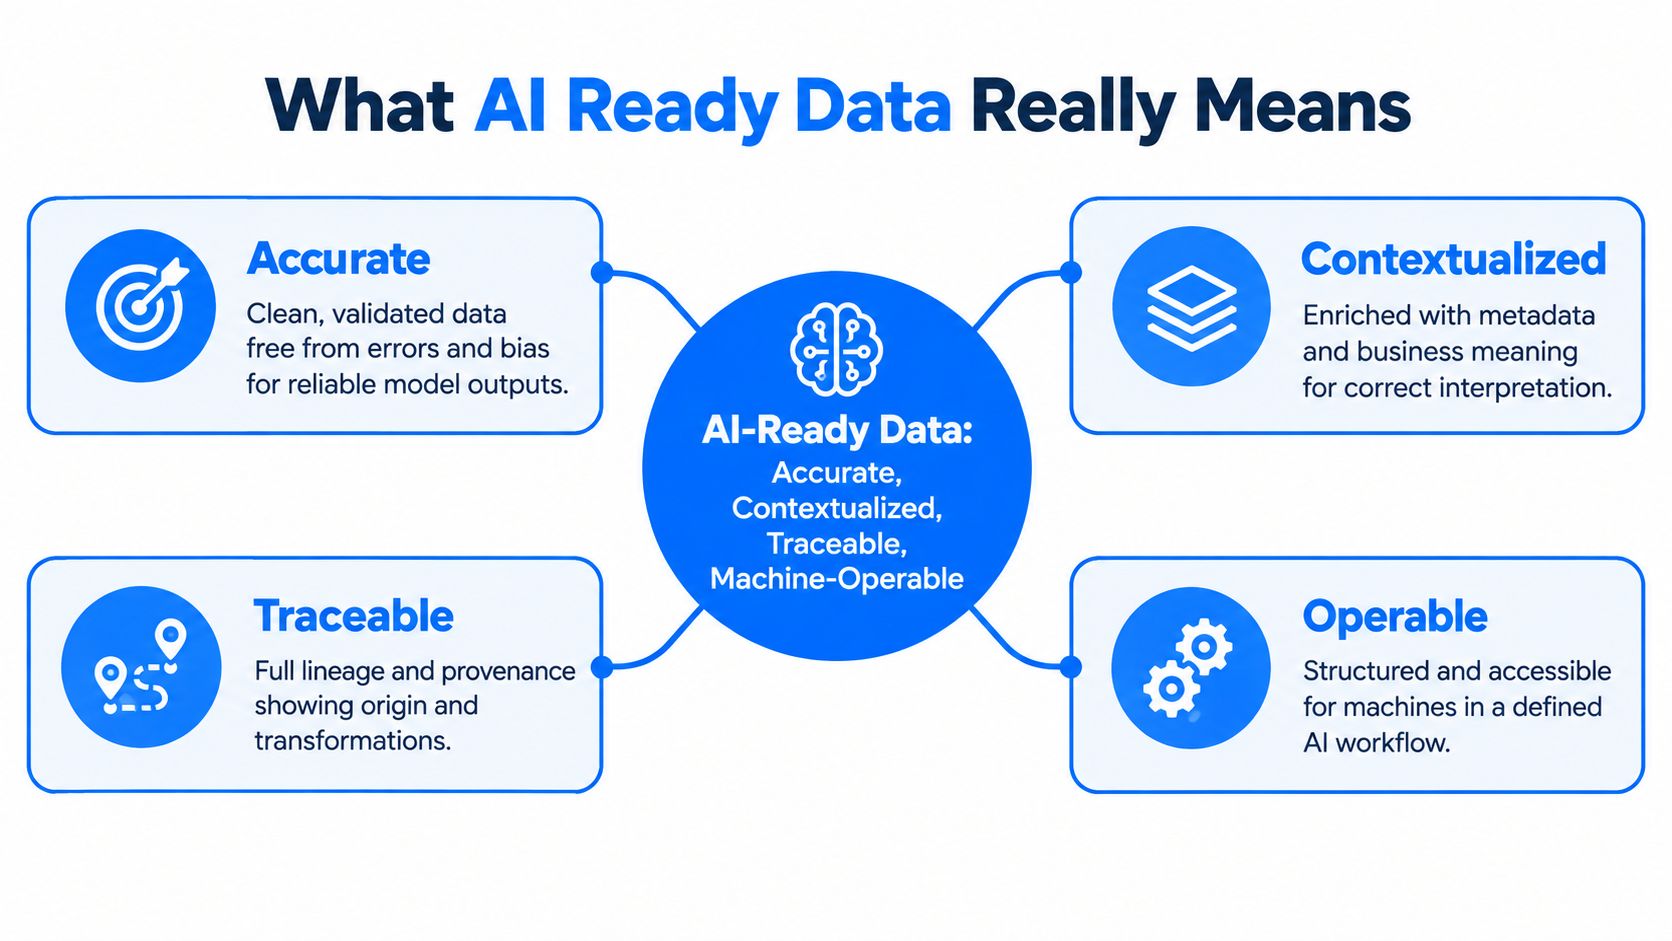
KI-reife Daten sind nicht bloß Daten mit weniger Nullwerten und saubereren Werten. Es sind Daten, die eine Maschine für einen definierten Ablauf deuten, zurückverfolgen und korrekt nutzen kann.
Ein Küchenvergleich hilft. Rohe Zutaten im Kühlschrank sind nicht dasselbe wie für ein Rezept vorbereitete Zutaten. Sie mögen Zwiebeln, Tomaten und Gewürze haben, doch das heißt nicht, dass das Essen fertig ist. Jemand muss noch waschen, schneiden, abmessen, beschriften und alles für genau das gekochte Gericht ordnen. Mit Daten ist es genauso. Speicherung ist keine Reife. Reife heißt, der Datensatz wurde für eine bestimmte Art von Berechnung vorbereitet.
Genau ist nur die erste Schicht
Beginnen Sie mit der Wertequalität, und das sollten Sie. Schlechte Werte brechen Modelle auf offensichtliche Weise. Falsche Zeitstempel verzerren Sequenzmerkmale. Doppelte Kundinnen blähen die Exponierung auf. Inkonsistente Labels vergiften Trainingsziele. Wenn Sie eine solide Auffrischung der Bestandteile dahinter brauchen, sind die Dimensionen der Datenqualität die richtige Grundlage.
Doch Genauigkeit allein macht Daten nicht KI-reif. Eine völlig gültige Spalte scheitert dennoch, wenn das Modell nicht erkennen kann, was sie bedeutet, woher sie kam oder ob sie auf die aktuelle Aufgabe zutrifft.
Kontext macht aus Werten ein nutzbares Signal
Daten werden nützlicher, wenn sie Metadaten tragen, die Maschinen parsen können, nicht bloß Kommentare, die Menschen lesen. Unabhängige Leitlinien der UN-Statistikgemeinschaft und der britischen Regierung betonen, dass KI-reife Datensätze maschinenlesbare Metadaten, Qualitätssicherung, interoperable Formate und Governance-Kontrollen brauchen. Das UN-Rahmenwerk hebt maschinell verwertbare Metadaten, Qualitätskontrolle, offene Lizenzierung, verantwortungsvollen KI-fähigen Zugang und strukturierte Zusammenarbeit hervor. Die britische Leitlinie von 2026 sagt, ein KI-reifer Datensatz müsse Standards für technische Optimierung, Genauigkeit, Vollständigkeit, Konsistenz, Metadaten, laufende Qualitätsüberwachung und Rechtskonformität erfüllen (Leitlinien von UN und UK zu KI-reifen Daten).
Das klingt abstrakt, bis Sie es auf Engineering-Arbeit übertragen:
Fachliche Bedeutung sagt dem Modellierungsteam, was ein Feld darstellt.
Technische Metadaten sagen Systemen, wie sie es parsen und verknüpfen.
Nutzungskontext sagt nachgelagerten Nutzerinnen, wann der Einsatz angemessen ist.
Nachvollziehbar und maschinell bedienbar heißt produktionssicher
Ein Fachartikel von 2026 beschreibt KI-reife Daten als Daten, die von strukturierten Metadaten gestützt werden, welche automatisierte Auffindbarkeit, semantische Angleichung, Provenienzverfolgung und reproduzierbare rechnerische Nutzung ermöglichen. Er hält außerdem fest, dass Metadaten auf Datensatzebene beigefügt und von Maschinen parsebar sein müssen, weil Interoperabilität und Nachvollziehbarkeit davon abhängen (Fachdiskussion zu strukturierten Metadaten und Provenienz).
Praktische Regel: Behandeln Sie Metadaten, Lineage und Provenienz als Teil des Vertrags über die Modelleingaben, nicht als optionalen Governance-Papierkram.
Das ist die Kerndefinition, die ich in der Plattformarbeit nutze: KI-reife Daten sind genau, kontextualisiert, nachvollziehbar und maschinell bedienbar für eine bestimmte KI-Aufgabe. Fehlt eines dieser Stücke, mag das Modell dennoch laufen. Verlässlich wird es nicht.
Die sechs Säulen, die Daten KI-reif machen
Eine praktische Checkliste geht über „sauber und gesteuert“ hinaus. Sechs Säulen sind nützlich, weil sie sowohl Modellleistung als auch operatives Vertrauen abdecken.
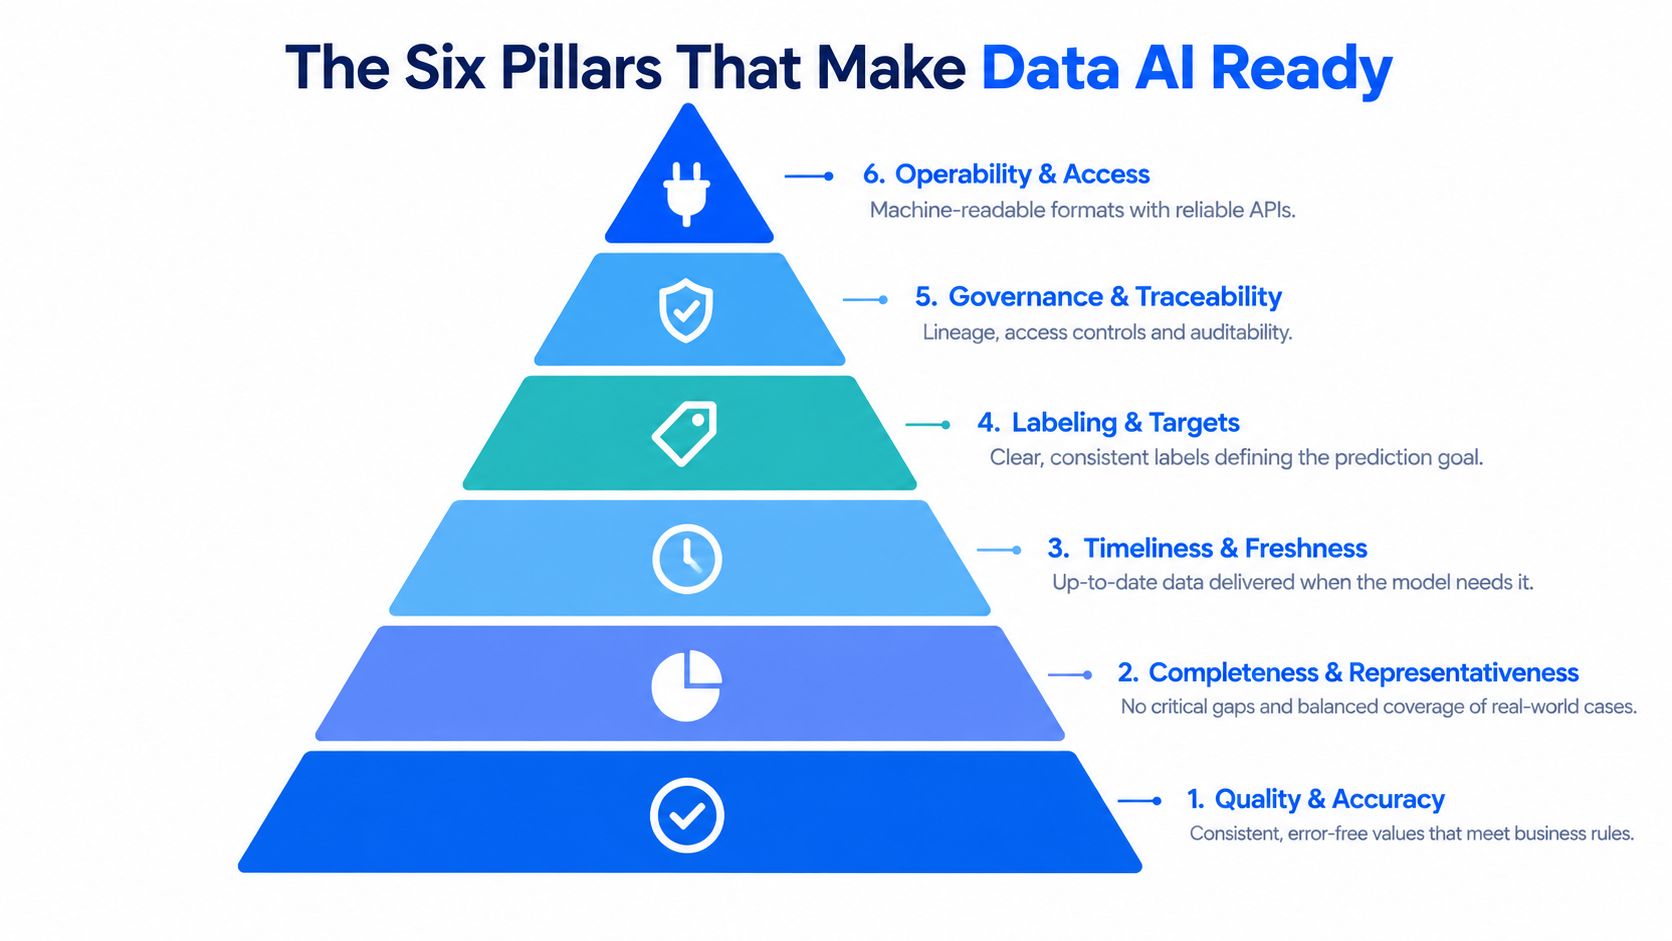
Qualität und Genauigkeit
Beginnen Sie bei den Werten selbst. Sind Datensätze gültig? Sind Formate konsistent? Gehorchen Datumswerte, Identifikatoren und kategoriale Felder den Geschäftsregeln?
Das ist nicht bloß Lehrmeinung des Datenmanagements. Empirische Forschung untersuchte sechs Datenqualitätsdimensionen über 19 verbreitete Machine-Learning-Algorithmen für Klassifikation, Regression und Clustering, ausdrücklich um Leistung über Datenqualität zu erklären. Eine spätere Arbeit zu datenzentrierter KI griff sechs Dimensionen erneut auf: konsistente Repräsentation, Vollständigkeit, Merkmalsgenauigkeit, Zielgenauigkeit, Eindeutigkeit und Ausgewogenheit der Zielklassen (Forschung zu Datenqualitätsdimensionen und ML-Ergebnissen).
Die praktische Folge ist einfach. Dubletten, falsch etikettierte Ziele und inkonsistente Repräsentationen verändern das Modellverhalten.
Vollständigkeit und Repräsentativität
Ein vollständiger Datensatz muss die Welt, der Ihr Modell begegnen wird, noch nicht abbilden. Genau hier stolpern Teams oft. Sie prüfen Zeilenzahlen und Null-Raten und stellen dann fest, dass das Modell bei seltenen, aber wichtigen Fällen schwächelt.
Repräsentativität fragt, ob die Daten die Ereignisse, Nutzenden, Sonderfälle und Betriebsbedingungen enthalten, die das KI-System bewältigen muss. Wenn Sie einen Support-Klassifikator auf wohlgeformten Tickets trainieren, die Produktion aber Abkürzungen, kopierte Logs und mehrsprachigen Text enthält, ist Ihre saubere Stichprobe nicht repräsentativ genug.
Eine nützliche Unternehmens-Checkliste enthält oft:
Abdeckung von Sonderfällen, die dem Geschäft wichtig sind, nicht nur des üblichen Pfads
Ausgewogene Beispiele, wenn ein Klassenungleichgewicht das Training verzerren würde
Quellenvielfalt, wenn dieselbe Entität über zersplitterte Systeme auftaucht
Timeliness und Frische
Manche Daten sind korrekt und dennoch unbrauchbar, weil sie zu spät kommen. Das zählt für KI mehr, als viele Teams erwarten.
Ein Empfehlungsmodell auf Basis des gestrigen Bestands schlägt womöglich nicht verfügbare Artikel vor. Ein Betrugssignal auf verzögerten Transaktionen wird genau dann weniger nützlich, wenn Tempo zählt. Bei Retrieval-Systemen kann veraltetes Wissen gefährlicher sein als fehlendes, weil die Ausgabe weiterhin zuversichtlich klingt.
Frische ist keine Fußnote im SLA. Für viele KI-Abläufe ist sie Teil der Korrektheit.
Labeling und Integrität der Zielgröße
Trainingslabels verdienen eine eigene Säule, weil sie bestimmen, worauf das Modell hin optimiert. Wenn Teams uneins sind, was „abgewandert“, „genehmigt“ oder „hohes Risiko“ heißt, kodiert das Modell diese Mehrdeutigkeit.
Gutes Labeling geht nicht nur um Konsistenz. Es geht auch um operative Passung. Die Zielgröße muss die Entscheidung abbilden, die das Geschäft stützen will. Sonst wird das Modell hervorragend darin, einen Stellvertreter vorherzusagen, den niemand nutzen sollte.
Governance und Nachvollziehbarkeit
Wenn eine Modellausgabe erklärt werden muss, brauchen Teams Lineage schnell. Welches Quellsystem lieferte den Wert? Welche Transformationen veränderten ihn? Wer hat den Datensatz für diese Nutzung freigegeben?
Ein Rahmenwerk für Datenqualität im Unternehmen ist hier nützlich, weil Governance praktisch wird, wenn sie an konkrete Kontrollen geknüpft ist: Eigentum, Zugriffsregeln, Validierungsnachweise und Lineage-Historie. Ohne Nachvollziehbarkeit ist selbst ein starker Datensatz schwer zu prüfen und schwer zu vertrauen.
Bedienbarkeit und Zugang
Die letzte Säule wird oft unterschätzt. Daten können hochwertig sein und dennoch scheitern, weil sie in unhandlichen Formaten, schlecht dokumentierten Speichermustern oder brüchigen Übergaben festsitzen.
Bedienbarkeit heißt, die Daten liegen in maschinenlesbaren Formaten vor, sind über stabile Schnittstellen erreichbar und so strukturiert, dass Pipelines sie verlässlich konsumieren. Produktionstechnisch hören Schemata, APIs, Tabellen und Metadatendienste auf, bloße Installation zu sein, und werden selbst Teil der KI-Reife.
Bereit wofür? Eignung für Ihren KI-Anwendungsfall definieren
Eine generische Reife-Checkliste zerfällt in dem Moment, in dem Sie verschiedene KI-Aufgaben vergleichen.
Ein Retrieval-System braucht durchsuchbare Dokumente, eine Chunking-Strategie, Metadaten-Tags und Provenienz. Ein Prognosemodell braucht stabile Zeitreihen, konsistente Granularität und vertrauenswürdige Zeitstempel. Ein autonomer Ablauf braucht noch stärkere Kontrollen, weil er auf Basis der Daten ohne menschliche Prüfung handeln kann.
Gartner sagt das direkt. Führungskräfte müssen zuerst definieren, was als KI-reife Daten gilt, und diese Daten müssen für den Anwendungsfall repräsentativ sein, einschließlich Sonderfällen, Ausreißern und unerwarteten Mustern, die zum Trainieren oder Betreiben des Modells nötig sind. Dieselbe Erörterung merkt an, dass Organisationen Größe oft mit zweckdienlicher Signalqualität verwechseln, während aktuelle Leitlinien durchsuchbare, kontextreiche und vertrauenswürdige Daten über strukturierte, unstrukturierte und Streaming-Bestände hinweg betonen (Gartner zur Definition KI-reifer Daten nach Anwendungsfall).
Mehr Daten beantworten nicht die richtige Frage
Teams sagen oft: „Wir haben reichlich Daten.“ Das mag stimmen und trotzdem irrelevant sein.
Die bessere Frage lautet: Welcher Fehlschlag würde diesem KI-System am meisten schaden? Fasst das System Richtliniendokumente zusammen, sind veraltete Fassungen ein großes Risiko. Bewertet es Kreditereignisse, zählen Provenienz und Freigabestatus mehr als reines Textvolumen. Treibt es einen operativen Agenten an, rücken Laufzeitfrische und Berechtigungsgrenzen ins Zentrum.
KI-Anwendungsfall | Wichtigste Reifekriterien | Häufiger Fehlschlag, wenn sie fehlen |
|---|---|---|
Retrieval über Dokumente | Durchsuchbare Metadaten, Provenienz, Versionierung, Zugriffskontrollen | Das System ruft veraltete oder kontextarme Inhalte ab |
Prädiktive Modellierung | Repräsentative Abdeckung, Integrität der Zielgröße, Konsistenz, Vollständigkeit | Das Modell lernt verzerrte Muster und übersieht wichtige Fälle |
Entscheidungsunterstützung in Echtzeit | Frische, Timeliness, stabile Schemata, Zugriff mit geringer Latenz | Die Ausgabe spiegelt verspätete oder unvollständige Ereignisse |
Autonome Abläufe | Governance, Nachvollziehbarkeit, Richtlinienkontrollen, Änderungserkennung | Das System ergreift unsichere Maßnahmen auf Basis unvertrauenswürdiger Eingaben |
Kritische Datenelemente nutzen, um die Checkliste zu gewichten
Vielen Teams hilft es, kritische Datenelemente zu definieren, bevor sie Modelle abstimmen. Nicht jedes Feld verdient dieselben Kontrollen. Eine Kundennummer in einem Deduplizierungsablauf zählt anders als ein beschreibendes Kommentarfeld in einer semantischen Suche.
Ein praktischer Weg, die Eignung zu bewerten, sind drei Fragen:
Welche genaue Entscheidung oder Ausgabe hängt von diesen Daten ab?
Welches Fehlerverhalten ist am wenigsten akzeptabel?
Welche Felder, Metadaten und Aktualisierungswege treiben dieses Risiko?
Sobald Sie diese beantworten, hört Reife auf, ein Schlagwort zu sein, und wird zur technischen Spezifikation.
Wie Sie Daten in der Praxis für KI vorbereiten
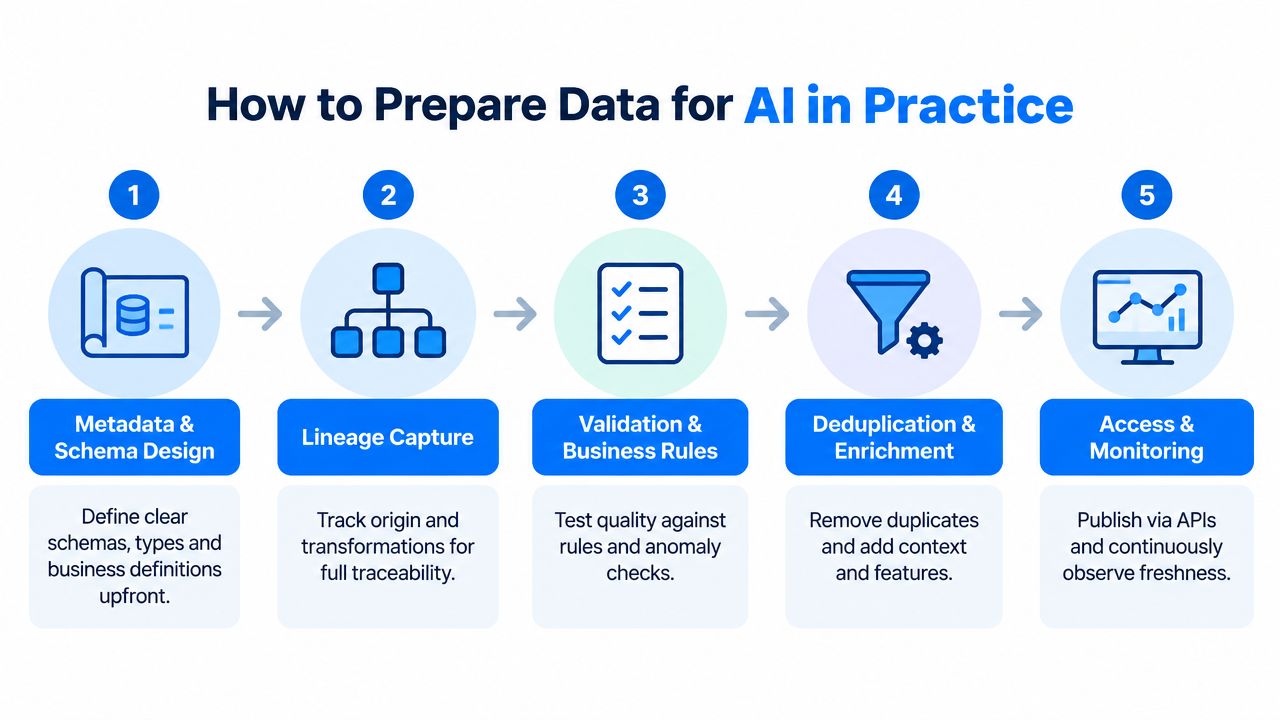
Vorbereitung funktioniert am besten als zusammenhängender Ablauf, nicht als Haufen isolierter Aufräumaufgaben. Die Reihenfolge zählt, weil frühe Entwurfsentscheidungen bestimmen, wie viel Vertrauen Sie später bewahren können.
Beginnen Sie mit Schemata und Metadaten
Bevor Sie Werte validieren, definieren Sie, was der Datensatz sein soll. Das heißt Feldnamen, Typen, fachliche Definitionen, Eigentum, freigegebene Nutzung und Aktualisierungserwartungen. Ändert ein Feld seine Bedeutung ohne Namensänderung, arbeitet jedes nachgelagerte Modell nun mit stillem Risiko.
Gute Metadaten sollten menschliche und maschinelle Fragen beantworten. Eine Person sollte die fachliche Bedeutung verstehen. Eine Pipeline sollte Struktur, Beziehungen und Nutzungsbeschränkungen automatisch parsen können.
Lineage erfassen, solange Transformationen sichtbar sind
Lineage lässt sich am leichtesten in dem Moment festhalten, in dem Daten sich bewegen, nicht Monate später bei einem Audit. Verfolgen Sie, woher die Daten kamen, welche Joins und Filter sie berührten und welcher Job oder welche Person sie in eine KI-Bereitstellungsschicht befördert hat.
Der schnellste Weg, Vertrauen in ein Modell zu verlieren, ist, eine verdächtige Ausgabe zu entdecken und keinen sauberen Weg zurück zu den Quelldatensätzen zu haben.
Das verlangt kein riesiges Governance-Programm. Es verlangt Disziplin beim Pipeline-Entwurf, bei der Transformationsprotokollierung und bei der Registrierung von Datensätzen.
Geschäftsregeln prüfen, bevor Sie das Training skalieren
Sobald Definitionen und Lineage bestehen, wenden Sie regelbasierte Prüfungen an. Validieren Sie IDs, erzwingen Sie erlaubte Bereiche, bestätigen Sie referenzielle Integrität und prüfen Sie Labels wo möglich gegen die Quellwahrheit.
Kümmern Sie sich dann um die Probleme, die oft überproportional auf Modelle wirken:
Deduplizierung: Entfernen oder versöhnen Sie Datensätze, die dieselbe Entität widersprüchlich beschreiben.
Prüfung der Fehlwerte: Trennen Sie akzeptable Nullwerte von solchen, die einen kaputten Feed anzeigen.
Labelprüfung: Prüfen Sie, ob Zielwerte dem operativen Ergebnis entsprechen, das Ihnen wichtig ist.
Prüfung der Klassenbalance: Sehen Sie nach, ob wichtige Kategorien fehlen, selten oder verzerrt sind.
Den Datensatz anreichern, ohne die Quellwahrheit zu verdecken
Feature-Anreicherung ist nützlich, kann aber die Provenienz verwischen, wenn Teams abgeleitete Felder nicht klar kennzeichnen. Halten Sie Rohfelder, standardisierte Felder und konstruierte Merkmale getrennt. Das erleichtert die Fehlersuche, wenn Modellverhalten schwer erklärbar wird.
Zugangspfade und Monitoring-Haken veröffentlichen
Ein vorbereiteter Datensatz sollte auffindbar und konsumierbar sein. Das heißt meist eine stabile Tabelle, eine API oder ein dokumentierter Bereitstellungspfad mit klarer Verantwortung.
Es heißt auch, den Datensatz vor dem Deployment zu instrumentieren und nicht nach dem ersten Vorfall. Wenn Sie Änderungen an Timeliness, Struktur oder Werteverhalten nicht beobachten können, ist der Datensatz nicht bereit für produktive KI.
Wie Observability-Plattformen Daten zur Laufzeit KI-reif halten
Vorbereitung bringt einen Datensatz an die Startlinie. Observability hält ihn dort.
Das zählt besonders in regulierten oder datenschutzsensiblen Umgebungen, in denen Teams Daten nicht an externe KI-Werkzeuge exportieren dürfen. Unabhängige Branchenberichte rahmen KI-reife Daten zunehmend als Daten, die auffindbar, gesteuert, sicher und über zersplitterte Systeme hinweg nutzbar sind, wobei Laufzeitvertrauen für die KI-Skalierung im Unternehmen zentral wird, besonders in Finanzwesen, Gesundheitswesen, Telekommunikation und öffentlichem Sektor (IBM zu vertrauenswürdigen und gesteuerten KI-reifen Daten).

Wie Laufzeitvertrauen in der Praxis aussieht
Zur Laufzeit fragen Sie nicht mehr, ob der historische Datensatz bei der Vorbereitung gut aussah. Sie fragen, ob die heutige Eingabe noch den Bedingungen entspricht, unter denen das Modell oder der Agent als sicher gilt.
Das verlangt meist mehrere Kontrollen im Zusammenspiel:
Frischeüberwachung, um verspätete, fehlende oder unerwartet frühe Ladevorgänge zu erkennen
Schema-Tracking, um strukturelle Änderungen zu erkennen, bevor nachgelagerte Systeme scheitern
Validierungsprüfungen, um Geschäftsregeln auf Live-Datensätzen durchzusetzen
Verhaltensüberwachung, um ungewöhnliche Verschiebungen in Werteverteilungen oder Zeilenmustern zu erkennen
Eine Plattform wie dignas Software für Data Observability ist ein Beispiel für dieses Muster. Sie läuft innerhalb der Kundenumgebung, berechnet Prüfungen in der Datenbank und verbindet Anomalieerkennung, Timeliness-Überwachung, Validierung und Schema-Tracking, ohne dass der Anbieter auf Produktionsdaten zugreifen muss. Dieses Bereitstellungsmodell zählt, wenn Daten die eigene Infrastruktur der Organisation nicht verlassen dürfen.
Die operativen Kennzahlen sind konkret
Schemadrift ist keine vage Sorge. Ein Referenzentwurf definiert einen Zähler für Schemaänderungen je Tabelle, einschließlich Hinzufügen, Entfernen, Umbenennen, Typ- und Nullbarkeitsänderungen von Spalten, und kombiniert ihn mit statistischen Driftsignalen wie Null-Anteil und Anzahl eindeutiger Werte, um strukturelle von verteilungsbezogener Änderung zu trennen (Kennzahlen für Schema- und Attributdrift).
Auch Frische ist messbar. Ein Observability-Entwurf verfolgt die Latenz der Drifterkennung als durchschnittliche Zeit zwischen dem Eintreten einer Schemaänderung und ihrer Erkennung durch das System. Er verfolgt außerdem die Datenverlustrate und die Fehlerrate der Pipeline als Anteile fehlerhafter oder verlorener Datensätze beziehungsweise gescheiterter Jobs (Überwachung von Driftlatenz und Qualitätssignalen der Pipeline).
KI-gestützte Überwachung senkt manuelle Schwellenarbeit
Manuelle Schwellen skalieren über Hunderte von Datensätzen schlecht. Bigeye gibt an, dass seine Anomalieerkennung das historische Verhalten eines Datensatzes lernt und Schwellen für jedes Datenqualitätsattribut automatisch bestimmt, wobei Standardabweichungsschwellen auf Basis des historischen Mittelwerts Alarme ohne manuellen Aufwand erzeugen (Ansatz der Anomalieerkennung von Bigeye).
Databricks beschreibt eine ähnliche Unternehmensrichtung. Sein Monitoring analysiert historische Muster automatisch, um Anomalien bei Tabellenfrische und Vollständigkeit zu erkennen, und überwacht zugleich statistische Trends und Anomalien über die Zeit in einem einheitlichen System (Lakehouse-Monitoring von Databricks).
Historische Sauberkeit hilft beim Training. Laufzeit-Observability entscheidet, ob die Live-Ausgaben der KI vertrauenswürdig bleiben.
Das ist der Wandel, den viele Teams gerade vollziehen. KI-Reife ist nicht länger bloß ein Meilenstein der Datenvorbereitung. Sie ist eine Betriebsbedingung.
Fazit: Ihr Weg zu vertrauenswürdigen, KI-reifen Daten
KI-reife Daten sind kein größerer Haufen Datensätze. Es sind Daten, die für einen bestimmten Anwendungsfall taugen und vertrauenswürdig bleiben, wenn Live-Systeme ringsum sich zu verändern beginnen.
Das heißt, zwei Disziplinen müssen zusammenkommen. Erstens Datensätze so vorbereiten, dass sie genau, kontextualisiert, nachvollziehbar und maschinell bedienbar sind. Zweitens diesen Status mit Laufzeitkontrollen halten, die veraltete Eingaben, Schemaänderungen, fehlende Datensätze und Verhaltensanomalien erkennen, bevor sie ein Modell, einen Agenten oder einen Entscheidungsfluss erreichen.
Wenn Sie Ihre eigene Umgebung bewerten, halten Sie den ersten Durchgang praktisch:
Definieren Sie den Anwendungsfall klar: Retrieval, Vorhersage, Entscheidungsunterstützung oder autonomes Handeln
Bestimmen Sie die kritischen Felder und Labels: besonders jene, die an Geschäftsrisiken hängen
Prüfen Sie Dubletten, Fehlwerte und Labelintegrität: diese brechen Modellqualität oft schneller, als Teams erwarten
Prüfen Sie Frische und Schemastabilität: besonders für Live- oder nahezu echtzeitfähige Systeme
Verlangen Sie Lineage und maschinenlesbare Metadaten: damit Teams vertrauen und prüfen können, was das Modell konsumiert
Bevorzugen Sie Observability in der eigenen Umgebung, wenn Daten nicht wandern dürfen: besonders in regulierten Kontexten
Der größte Fehler ist, Reife als einmaliges Aufräumprojekt zu behandeln. Sie kommt der Zuverlässigkeitstechnik näher. Sie richten Kontrollen ein, definieren akzeptable Betriebsbedingungen und schauen weiter hin. So werden aus Rohdaten vertrauenswürdige KI.
digna stellt eine Unternehmensplattform für Datenqualität und Data Observability bereit, die Teams hilft, KI-Daten innerhalb der eigenen Umgebung vertrauenswürdig zu halten, mit Prüfungen in der Datenbank für Anomalien, Timeliness, Validierung und Schemaänderungen. Wenn Ihre KI-Workloads ebenso sehr von Laufzeitvertrauen wie von der anfänglichen Vorbereitung abhängen, besuchen Sie digna, um zu sehen, wie dieses Betriebsmodell in der Praxis funktioniert.
Reife ist ein bewegliches Ziel, kein Zertifikat — Data Quality Management hält einen Datensatz für das Modell tauglich, das bereits von ihm abhängt.
Häufig gestellte Fragen
Was bedeuten KI-reife Daten tatsächlich?
Genauigkeit ist nur die erste Schicht. Daten sind KI-reif, wenn sie außerdem Kontext tragen, der Werte in nutzbares Signal verwandelt, und wenn sie nachvollziehbar und maschinell bedienbar sind — also ein Modell sie in der Produktion konsumieren kann, ohne dass ein Mensch sie erst zusammenstellt. Genaue, aber kontextlose Daten bremsen ein Projekt trotzdem aus.
Welches sind die Säulen der KI-Reife?
Sechs: Qualität und Genauigkeit, Vollständigkeit und Repräsentativität, Timeliness und Frische, Labeling und Integrität der Zielgröße, Governance und Nachvollziehbarkeit sowie Bedienbarkeit und Zugang. Die Labelintegrität überspringen Teams am häufigsten, und eine verdorbene Zielspalte entwertet alles, was darauf trainiert wurde.
Warum geraten KI-Projekte ins Stocken, obwohl sie gesund aussahen?
Weil der Stillstand weiter oben beginnt, nicht im Modell. Ein Projekt wirkt in Ordnung, bis es Produktionsdaten berührt und Vertrauen den Kontakt mit Live-Systemen überstehen muss — späte Feeds, verschobene Schemata, unrepräsentative Stichproben. Das Modell ist meist der letzte Ort, an dem das Problem entsteht.
Sind mehr Daten die Antwort auf KI-Reife?
Nein. Mehr Daten beantworten nicht die richtige Frage. Reife ist Eignung für einen bestimmten Anwendungsfall, der nützliche Schritt ist also, kritische Datenelemente zu bestimmen und die Checkliste auf sie hin zu gewichten, statt das Volumen über Felder auszuweiten, die kein Modell konsumiert.
Wie halten Sie Daten zur Laufzeit KI-reif?
Reife verfällt, sie braucht also Überwachung statt einer einmaligen Zertifizierung. Beobachten Sie Frische gegen das zugesagte Fenster, Schemastabilität, Verteilungsverschiebungen und Labelintegrität fortlaufend. KI-gestützte Überwachung hilft hier, weil sie die manuelle Schwellenpflege verringert, durch die statische Regeln veralten.



