KI-Governance-Plattform: Kernfunktionen und Datenkontrollen
|
6
min. Lesezeit

Der gängigste Rat zu einer KI-Governance-Plattform ist verkehrt herum. Teams sollen mit Richtlinien, Freigaben und Framework-Checklisten beginnen und darauf hoffen, dass die operative Ebene später nachkommt. In der Praxis scheitert Governance genau dann, wenn sie bei der Dokumentation stehen bleibt und nie bei den Daten, der Laufzeitumgebung und dem Nachweispfad ankommt, der belegt, dass Kontrollen auch nach dem Deployment noch funktionieren.
Eine tragfähige KI-Governance-Plattform ist kein Ordner voller Standards und keine Ticket-Warteschlange für Freigaben. Sie ist eine operative Ebene, die Verantwortlichkeiten klar, Messungen aktuell und Eskalationswege aktiv hält, während sich Modelle, Agenten und Daten-Pipelines ständig verändern. Deshalb ähneln die stärksten Umsetzungen weniger statischen Compliance-Archiven als vielmehr dauerhaften Observability-Systemen, die direkt mit Risikoentscheidungen verknüpft sind.
Inhaltsverzeichnis
Die KI-Governance-Plattform neu gedacht
Der erste Fehler besteht darin, Governance als etwas zu behandeln, das vor dem Go-live abgeschlossen ist. Das AI RMF 1.0 des NIST wurde am 26. Januar 2023 als freiwilliges, branchenübergreifendes Framework veröffentlicht, das um die Funktionen Govern, Map, Measure und Manage aufgebaut ist; am 30. März 2023 folgte ein begleitendes Playbook NIST AI RMF development. Diese Struktur ist wichtig, weil sie Governance als fortlaufendes Betriebsmodell begreift und nicht als einmalige Freigabe.
Governance muss den Produktivbetrieb überstehen
Eine Plattform, die nur Richtlinien speichert, kann nichts über das Verhalten zur Laufzeit belegen. Sie kann weder zeigen, wem ein produktives Modell gehört, welche Daten es verarbeitet hat, ob seine Ergebnisse gedriftet sind, noch wann ein menschlicher Eingriff das Ergebnis verändert hat. Genau diese Fragen stellen Aufsichtsbehörden, Prüfer und interne Risikoteams früher oder später - und sie brauchen dafür zeitgestempelte Nachweise, kein Richtlinien-PDF.
Praxisregel: Wenn sich eine Kontrolle nach dem Deployment nicht überwachen lässt, ist sie eine Absichtserklärung, keine Kontrolle.
Das Plattformmodell muss Verantwortlichkeiten sichern, Inventare aktuell halten, Vorfälle erfassen, Daten validieren und Prüfnachweise als Teil des Tagesgeschäfts aufbewahren. Für multinationale Teams bietet der freiwillige und technologieneutrale Ansatz des NIST zudem ein gemeinsames internes Kontrollmodell, das über Rechtsräume hinweg funktioniert.
Was eine Observability-Plattform in der Praxis leistet, ist hier relevant, weil KI-Governance und Observability dasselbe Fehlermuster aus unterschiedlichen Blickwinkeln adressieren. Die eine definiert Verantwortlichkeit, die andere belegt, was tatsächlich passiert ist. Eine echte Plattform muss beides leisten.
Kernfunktionen moderner KI-Governance
Die vier NIST-Funktionen zählen nur, wenn die Plattform sie in Kontrollen übersetzt, die jeden Tag greifen. Govern steht für Verantwortlichkeit, Richtlinien und Rechenschaft. Map bedeutet, Verwendungszweck, Risikoklasse, betroffene Nutzer und Abhängigkeiten zu kennen. Measure heißt, das Verhalten mit dokumentierten Methoden zu testen. Manage bedeutet eskalieren, beheben und Nachweise sichern NIST AI RMF PDF.
Was die Plattform verbinden muss
Ein ausgereiftes System verknüpft jedes produktive Modell mit seinem Verwendungszweck, der verantwortlichen Person, der Risikoklassifizierung, der Data Lineage, den Evaluationsergebnissen, bekannten Einschränkungen und dem Stand der Behebung. Diese Verknüpfung macht aus dem KI-Inventar ein operatives Register statt einer Tabelle. Ohne sie können Teams eine grundlegende Frage nicht schnell beantworten: Darf dieses Modell in seinem aktuellen Kontext weiterlaufen?
Messung ist genauso wichtig. Laut NIST kann die Messung von KI-Risiken quantitativ, qualitativ oder gemischt erfolgen und sollte Softwaretests, Leistungsbewertung, Dokumentation von Unsicherheiten, Benchmark-Vergleiche und formales Reporting umfassen. Auf Plattformebene bedeutet das versionierte Registries, reproduzierbare Evaluations-Pipelines, schwellenwertbasierte Alarme und Review-Workflows, die auch nach dem Deployment aktiv bleiben.
Eine Plattform, die nach dem Go-live nie Drift misst, wird Stabilität irgendwann mit Glück verwechseln.
Die Telemetrie im Produktivbetrieb muss Signale enthalten, auf die Governance reagieren kann, etwa Genauigkeits-Proxys, Drift-Indikatoren, Robustheitsfehler, Antwortzeiten und Override-Raten. Diese Signale sollten auf vorab festgelegte Toleranzen und Eskalationsverfahren abgebildet werden. Es geht nicht darum, noch mehr Dashboards zu bauen, sondern darum, jeden Alarm einer verantwortlichen Person und einem Reaktionsweg zuordnen zu können.
Zur Messseite, einschließlich der Frage, wie sich echter Modell-Drift von Änderungen an vorgelagerten Daten unterscheiden lässt, lesen Sie unseren Praxisleitfaden zur Erkennung von Modell-Drift.
Kontrollen für Datenqualitäts-Observability passen ganz natürlich in diese Ebene, denn Modell-Monitoring ohne Daten-Monitoring hinterlässt einen blinden Fleck. Die meisten Laufzeitfehler beginnen vorgelagert - in Datensätzen, Schemata oder bei der Aktualität der Daten - und nicht im Algorithmus selbst. Die Plattform muss beides sehen.
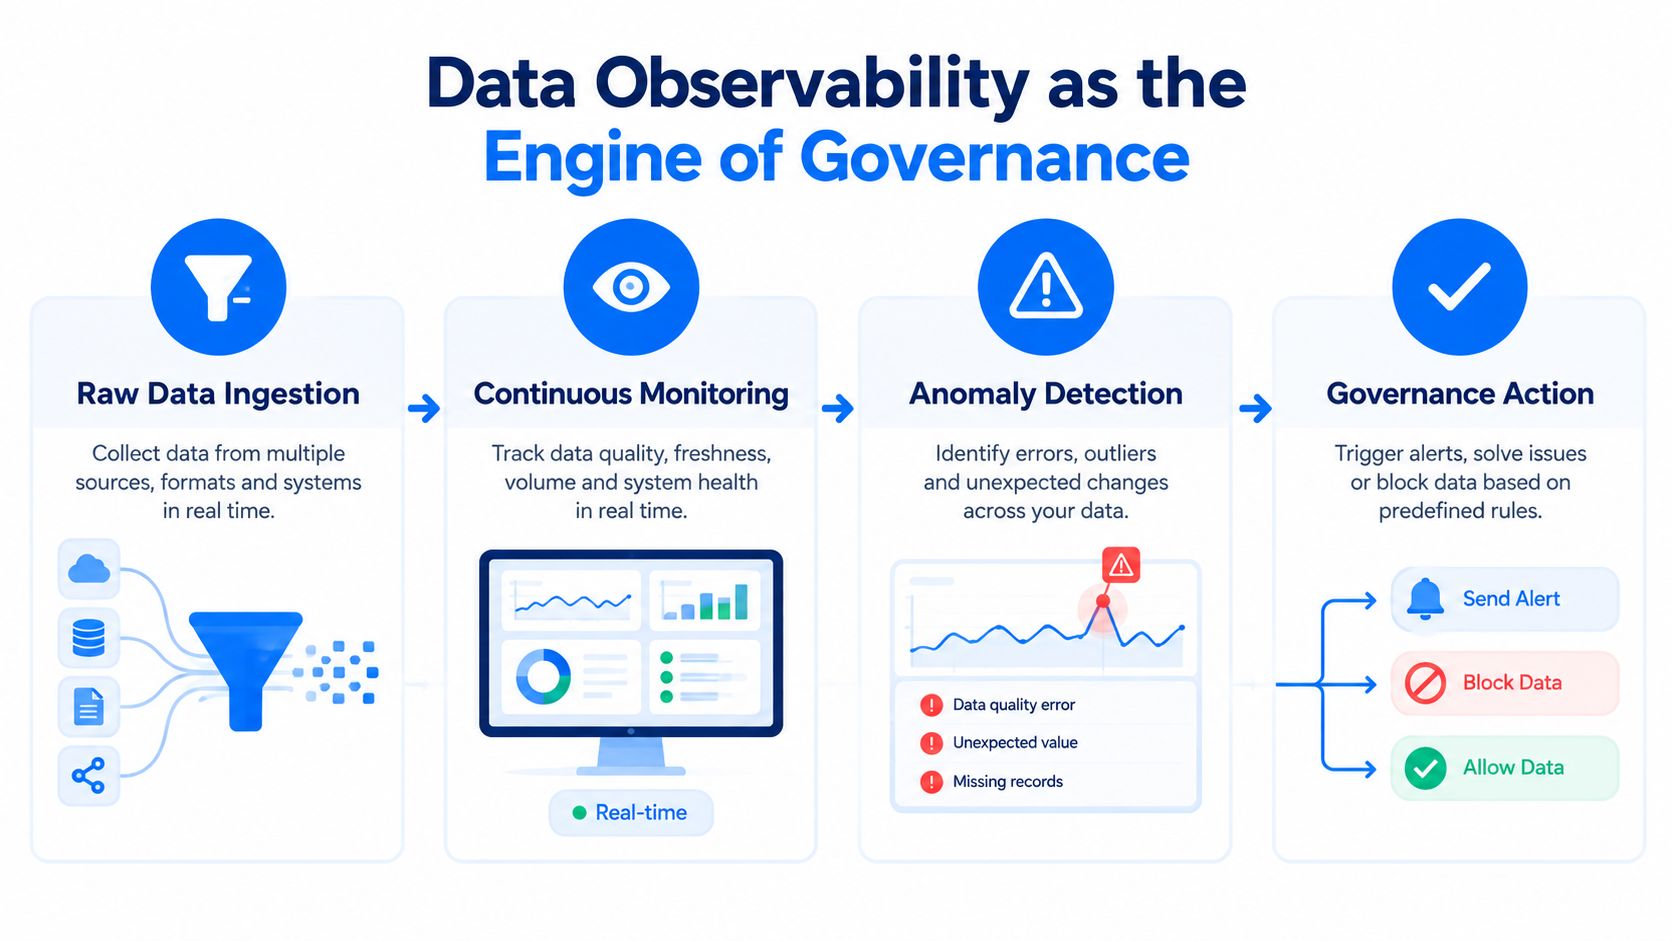
Data Observability als Motor der Governance
Am klarsten denkt man über Modellrisiken nach, wenn man nicht zuerst dem Modell die Schuld gibt. In regulierten Umgebungen beginnt der Fehler oft bei den Daten, die das Modell speisen, und zeigt sich erst später als falsche Vorhersage, fehlerhafte Entscheidung oder Lücke im Audit. Deshalb brauchen Governance-Plattformen Observability direkt in der Datenbank und nicht nur Formulare für Modell-Reviews.
Warum Änderungen an vorgelagerten Daten zählen
Artikel 16 des EU AI Act verlangt Dokumentation, Aufzeichnungen, Überwachungs- und Kontrollmechanismen, mit denen Behörden die Konformität beurteilen können; Hochrisiko-Systeme benötigen zudem eine technische Dokumentation zu Leistung, Einschränkungen, Testnachweisen und Überwachungsstrategie EU AI Act Article 16. Wenn sich die zugrunde liegenden Daten ändern und die Plattform das nicht bemerkt, veraltet die Dokumentation, selbst wenn sich der Modellcode nie geändert hat. Das ist ein Governance-Versagen und kein bloßes Ärgernis für das Datenteam.
Die praktischen Kontrollen sind unkompliziert, müssen aber kontinuierlich laufen. Schema-Tracking erkennt hinzugefügte, entfernte oder geänderte Felder, bevor nachgelagerte Reports oder Modelle sie verarbeiten. Das Monitoring der Aktualität erkennt fehlende Ladevorgänge, verspätete Lieferungen und Anomalien bei der Bereitstellung. Validierung auf Datensatzebene deckt Verstöße gegen Geschäftsregeln auf, die synthetische Benchmarks nicht zeigen. Wenn diese Prüfungen in der Umgebung des Kunden und direkt in der Datenbank laufen, bleiben die Produktivdaten, wo sie sind, und die Nachweiskette bleibt intakt.
Warum die Ausführung in der Datenbank das Nachweismodell verändert
Dieser Unterschied ist in regulierten Branchen entscheidend, vor allem wenn Governance belegen muss, was passiert ist, ohne sensible Daten in eine andere Plattform zu kopieren. Die Ausführung in der Datenbank reduziert Datenbewegungen, wahrt die Datenresidenz und hält die Kontrollnachweise näher an der Quelle. Außerdem macht sie kontinuierliche Validierung glaubwürdiger, weil die Prüfungen dort laufen, wo die Daten liegen, und nicht auf veralteten Extrakten.
Eine von der MIT Sloan Management Review zusammengefasste unabhängige Analyse schätzt, dass schlechte Daten die meisten Unternehmen zwischen 15 % und 25 % ihres Umsatzes kosten können. Gleichzeitig lagen nur 3 % der untersuchten Datenbestände in einem akzeptablen Fehlerbereich, fast 50 % der neu angelegten Datensätze enthielten kritische Fehler, und Wissensarbeiter verbringen bis zu 50 % ihrer Zeit mit routinemäßigen Datenqualitätsproblemen MIT Sloan Management Review. Diese Zahlen erklären, warum Governance operative Datensätze, Analytics-Datasets und Pipelines kontinuierlich beobachten muss.
Das Data-Observability-Framework ist wichtig, weil die Nachweiskette Quelldaten, Modellversion, Deployment-Kontext, Monitoring-Ereignisse, Vorfälle und Korrekturmaßnahmen als einen zusammenhängenden Datensatz darstellen muss. In der Praxis verhindert das, dass sich die Compliance-Dokumentation von der Realität entfernt.
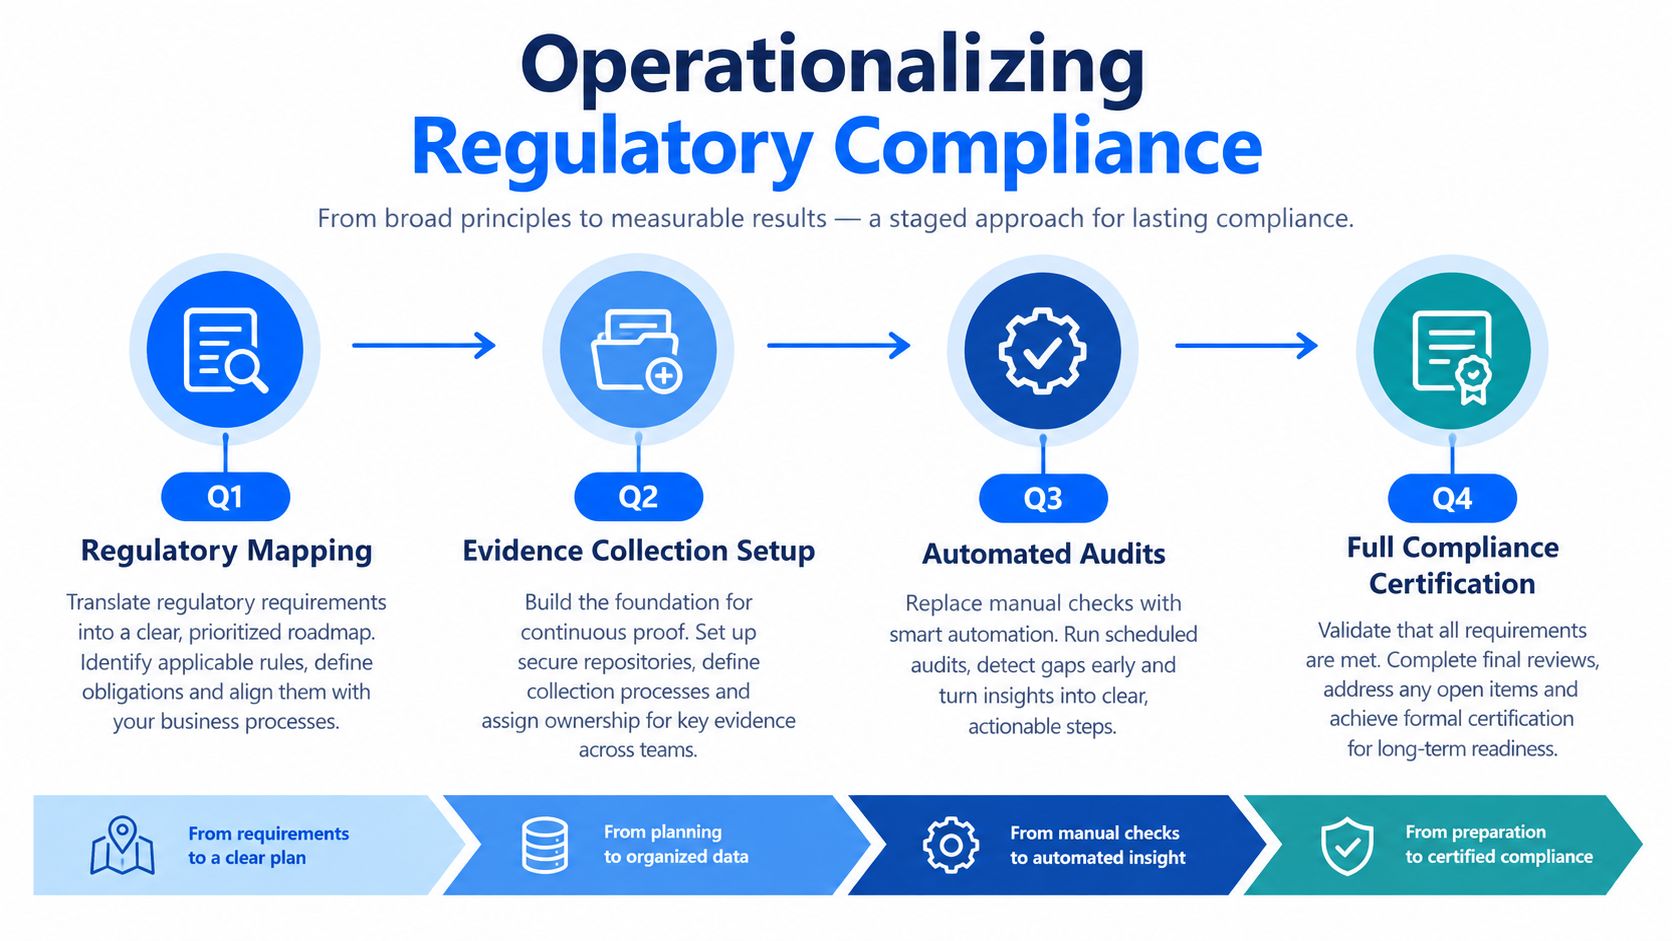
Regulatorische Compliance und Nachweise operationalisieren
Der EU AI Act macht Governance zu einer operativen Disziplin statt zu einem Richtlinienmemo. Er ist am 1. August 2024 in Kraft getreten, mit gestaffelten Pflichten, die seit dem 2. Februar 2025 und dem 2. August 2025 gelten und - je nach Pflicht und Systemklasse - ab dem 2. August 2026, 2. August 2027, 2. Dezember 2027 und 2. August 2028 greifen sollen EU AI Act timeline. Diese Abfolge zwingt Teams, Kontrollen, Nachweispfade und Zeitfenster für Neubewertungen direkt in die Plattform einzubauen.
Fristen in Kontrollschleifen verwandeln
Der praktische Ansatz besteht darin, jeden regulatorischen Meilenstein als Auslöser für einen Workflow zu behandeln. Am Anfang steht die Klassifizierung, denn die Organisation muss wissen, ob ein System ein KI-Modell mit allgemeinem Verwendungszweck, ein Hochrisiko-System oder Transparenzpflichten unterworfen ist. Die Plattform kann diese Klasse dann an die erforderliche Dokumentation, die Testnachweise und den Review-Rhythmus koppeln.
Für Hochrisiko-Systeme verlangt Artikel 10 Trainings-, Validierungs- und Testdatensätze, die relevant, hinreichend repräsentativ und so weit wie möglich fehlerfrei und im Hinblick auf den beabsichtigten Zweck vollständig sind EU AI Act Article 10. Eine Governance-Plattform braucht daher unveränderliche Datensatzversionen, Herkunftsnachweise, Ergebnisse von Datenqualitätstests, gegebenenfalls Analysen nach Untergruppen oder Szenarien sowie eine klare Änderungshistorie. Eine einmalige Bewertung übersteht keinen Drift in den vorgelagerten Daten.
Compliance wird in dem Moment brüchig, in dem Nachweise in E-Mails, Tabellen und Ad-hoc-Exporten liegen.
Das stärkere Muster ist eine Nachweiskette, die bei den Quelldaten beginnt und bei der Korrekturmaßnahme endet. Jedes Modell-Release sollte die Datensatzversion, genehmigte Gegenmaßnahmen, das Evaluationsprotokoll und den Monitoring-Status mitführen. Jeder Vorfall sollte auf den betroffenen Anwendungsfall, die vorausgegangene Daten- oder Modelländerung und die Entscheidung des verantwortlichen Teams zurückverweisen.
Teams, die einen praktischen Weg suchen, Entwickler-Workflows auf Prüfungen vorzubereiten, können mit diesem Ansatz die Audit-Bereitschaft früher in den Delivery-Prozess verlagern, bevor sich Nachweise über verschiedene Systeme verteilen. Der Vorteil: weniger Nacharbeit, wenn Governance und Engineering denselben Kontrollpfad nutzen.
Unterstützung für KI-Governance- und Compliance-Workflows gehört hierher, weil Compliance nur skaliert, wenn Nachweise im laufenden Betrieb entstehen und nicht nachträglich rekonstruiert werden. Kann die Plattform die Nachvollziehbarkeit über Daten-, Modell- und Deployment-Ereignisse hinweg nicht sichern, ist die Dokumentation vor dem nächsten Review-Zyklus bereits veraltet.
Agentische KI steuern, ohne Engpässe zu schaffen
Autonome Agenten legen den schwächsten Teil der meisten Governance-Programme offen: die Freigabe-Warteschlange. Ein zentrales Review-Gremium kann eine Handvoll Modelleinführungen bewältigen, ist aber überlastet, sobald Agenten Tools aufrufen, Aktionen verketten und ihre eigenen Ausführungspfade ändern. Die Antwort sind nicht mehr Meetings, sondern bessere Kontrolle zur Laufzeit.
Was kontinuierliche Aufsicht umfassen muss
Die minimale Telemetrie für agentische Systeme unterscheidet sich vom Monitoring statischer Modelle. Governance muss Berechtigungen, Tool-Nutzung, menschliche Eingriffe, sich ändernde Ziele und die Entscheidungsnachweise über alle Workflow-Schritte hinweg verfolgen. Außerdem muss sie risikoarme Aktionen, die automatisch ausgeführt werden dürfen, von Aktionen unterscheiden, die eine Eskalation erfordern.
Laut Deloitte verfügt nur eines von fünf Unternehmen über ein ausgereiftes Governance-Modell für autonome KI-Agenten, während eine SAP-Umfrage ergab, dass 38 % keine Human-in-the-Loop-Prozesse für die Aufsicht über Agenten haben Deloitte state of AI in the enterprise. Diese Zahlen decken sich mit dem, was viele Plattformteams in der Praxis erleben: Zu viel Review-Kapazität fließt in die Freigabe von Routinetätigkeiten, zu wenig Aufmerksamkeit in das Verhalten zur Laufzeit.
Besser ist ein Design mit schwellenwertbasierten Kontrollen. Risikoarme Aktionen laufen automatisch, solange sie innerhalb genehmigter Richtliniengrenzen bleiben. Aktionen mit höherem Risiko lösen ein menschliches Review, Protokollierung und Eskalation aus. So bleibt die Geschwindigkeit erhalten, ohne dass das Governance-Team zum dauerhaften Engpass wird.
Warum Observability zentrale Freigaben schlägt
Agentische KI verändert den Kontext schnell. Ein Workflow, der gestern sicher war, kann riskant werden, wenn sich eine Tool-Berechtigung ändert, eine Datenquelle verschiebt oder ein Ziel umformuliert wird. Klassische Freigabegremien bemerken solche Änderungen selten rechtzeitig. Observability zur Laufzeit schon, weil sie die aktuelle Konfiguration, die Dateneingänge und die daraus resultierenden Aktionen beobachtet.
Governance für Agenten funktioniert, wenn die Plattform zeigen kann, wer was getan hat, mit welchen Berechtigungen, auf welchen Daten und nach welcher Fallback-Regel.
Genau hier wird Data Observability mehr als nur ein Nice-to-have. Verarbeitet ein Agent veraltete, fehlerhafte oder unvollständige Daten, kann das Geschäftsergebnis beabsichtigt wirken und trotzdem falsch sein. Das Monitoring ungewöhnlicher Geschäftsergebnisse, Verschiebungen bei der Aktualität und Schemaänderungen liefert der Governance den Kontext, um zu entscheiden, ob der Agent weiterlaufen sollte.
Deployment und Sicherheit für regulierte Branchen
Im Finanzwesen, im Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor ist der Ort des Deployments Teil des Kontrolldesigns. Wenn eine Governance-Plattform verlangt, dass Produktivdaten die Umgebung des Kunden verlassen, steht die Architektur bereits im Widerspruch zu Anforderungen an Datenresidenz, Vertraulichkeit und Nachweise. Das sicherere Muster ist, Prüfungen in der Cloud, der VPC oder dem Rechenzentrum des Kunden auszuführen.
Warum Datenbewegung das Risiko verändert
Eine Plattform, die über externe APIs oder entfernte Verarbeitung auf Produktivdaten zugreift, übernimmt die Compliance-Last der Daten, die sie sieht. Das kann Sicherheitsprüfung, Datenschutzprüfung und Beschaffung gleichzeitig erschweren. Die Ausführung innerhalb der eigenen Umgebung hält sensible Datensätze dagegen lokal und begrenzt den möglichen Schadensradius des Governance-Tools selbst.
digna ist eine Plattformoption, die in der eigenen Umgebung des Kunden mit Berechnung direkt in der Datenbank läuft - passend zum Private-Deployment-Modell, das viele regulierte Teams voraussetzen. Entscheidend ist dabei nicht die Marke, sondern das Deployment-Muster, denn Governance-Nachweise sind nur so vertrauenswürdig wie das System, das sie erfasst hat.
Die Architektur sollte zudem modular sein. Teams brauchen selten jede Kontrolle ab dem ersten Tag, und ein erzwungener Rollout der kompletten Plattform kann die Einführung bremsen. Ein nutzungsstabiles Lizenzmodell ist hilfreich, wenn man mit einem Kontrollbereich starten und mit wachsender Reife des Programms ausbauen möchte, ohne die Beschaffung bei jedem neuen Anwendungsfall neu aufzusetzen.
Kontrollen zum Schutz von Kundendaten sind wichtig, weil Governance-Tools selbst zu Compliance-Akteuren werden können, wenn sie zu nah an Produktivdaten sitzen. In regulierten Umgebungen ist dieses Risiko nicht theoretisch - es beeinflusst, wie die Plattform bereitgestellt, geprüft und auditiert wird.
Ihre KI-Governance-Roadmap aufbauen
Der schnellste Weg aus fragmentierter Governance führt über Inventar und Telemetrie gemeinsam. Wer nur Systeme dokumentiert, übersieht das Verhalten zur Laufzeit. Wer nur das Laufzeitverhalten überwacht, übersieht Verantwortlichkeit, Klassifizierung und Zuständigkeiten. Eine ernsthafte Roadmap muss beides zusammenführen.
Beginnen Sie mit dem, was Sie belegen können
Legen Sie zunächst eine verantwortliche Person pro Anwendungsfall fest, nicht pro Modell. Erfassen Sie dann für jeden Anwendungsfall die Datenquellen, den Verwendungszweck, die Risikoklasse und den nachgelagerten Geschäftsprozess. Definieren Sie davon ausgehend, welche Nachweise vorliegen müssen, wenn das System normal läuft, wenn es driftet und wenn es ausfällt.
Fügen Sie als Nächstes die Kontrollen hinzu, die Veränderungen sichtbar machen. Schema-Monitoring erkennt strukturelle Brüche. Das Monitoring der Aktualität erkennt verspätete oder fehlende Daten. Validierungsregeln erkennen Verstöße gegen Geschäftsregeln. Incident-Workflows halten fest, was passiert ist und wer reagiert hat. Diese vier Bausteine geben der Governance eine faktische Grundlage statt einer nachträglich rekonstruierten Erzählung.
Wenn ein Governance-Review davon abhängt, dass sich Menschen daran erinnern, was passiert ist, ist das System zu schwach, um ihm zu vertrauen.
Der letzte Schritt ist das Eskalationsdesign. Probleme mit geringem Schweregrad sollten automatisch an die operativ Verantwortlichen weitergeleitet werden. Probleme mit hohem Schweregrad sollten das Deployment pausieren, ein Review eröffnen und den Nachweispfad sichern. So bleibt Governance aktiv, ohne zu einer dauerhaften manuellen Hürde zu werden.
Eine praxistaugliche KI-Governance-Plattform sollte Teams helfen, Inventare stets aktuell zu halten, Kontrollen an Regulierungen auszurichten und Änderungen zu dokumentieren, ohne in getrennten Tools suchen zu müssen. Außerdem sollte sie die technische Ebene unterstützen, die belegt, dass sich Daten und Modelle weiterhin innerhalb der Toleranzen verhalten. Diese Kombination macht Governance prüfbar, skalierbar und nützlich.
Wenn Sie von Richtliniendokumenten zu Nachweisen aus dem laufenden Betrieb kommen möchten, liefert digna Datenteams die Observability-Ebene, die KI-Governance braucht - mit Monitoring direkt in der Datenbank, Schema-Tracking, Validierung und Kontrollen der Aktualität innerhalb der Umgebung des Kunden. Wenn Sie Datennachweise mit Governance-Workflows verbinden möchten, ohne Produktivdaten zu bewegen, besuchen Sie digna und prüfen Sie, wie es in Ihren KI-Kontroll-Stack passt.
Häufig gestellte Fragen
Was ist eine KI-Governance-Plattform?
Sie ist eine operative Ebene, die Verantwortlichkeiten, Messungen und Eskalationen auch nach dem Deployment aktiv hält - kein Ordner voller Richtlinien. Sie verknüpft jedes produktive Modell mit seinem Verwendungszweck, der verantwortlichen Person, der Risikoklasse, der Data Lineage, den Evaluationsergebnissen und dem Stand der Behebung, sodass Teams belegen können, dass ihre Kontrollen im Produktivbetrieb weiterhin funktionieren.
Wie hängt das NIST AI RMF mit einer KI-Governance-Plattform zusammen?
Das im Januar 2023 veröffentlichte AI RMF 1.0 des NIST gliedert die Arbeit mit KI-Risiken in vier Funktionen: Govern, Map, Measure und Manage. Eine Plattform macht daraus tägliche Kontrollen - Verantwortlichkeit und Richtlinien, Risikoklassifizierung und Abhängigkeiten, dokumentierte Tests sowie Eskalation mit gesicherten Nachweisen.
Warum ist Data Observability für KI-Governance wichtig?
Die meisten Laufzeitfehler entstehen vorgelagert - in Datensätzen, Schemata oder verspäteten Ladevorgängen - und nicht im Modell selbst. Ändern sich die Daten unbemerkt, veraltet die Modelldokumentation, obwohl sich der Code nie geändert hat. Schema-Tracking, Monitoring der Aktualität und Validierung auf Datensatzebene halten die Nachweise aktuell.
Was verlangt der EU AI Act von Trainings- und Testdaten?
Für Hochrisiko-Systeme verlangt Artikel 10 Trainings-, Validierungs- und Testdatensätze, die relevant, hinreichend repräsentativ und so weit wie möglich fehlerfrei und vollständig sind. In der Praxis bedeutet das unveränderliche Datensatzversionen, Herkunftsnachweise, Ergebnisse von Datenqualitätstests und eine klare Änderungshistorie.
Wie können Teams agentische KI steuern, ohne sie auszubremsen?
Indem sie die zentrale Freigabe-Warteschlange durch schwellenwertbasierte Kontrollen ersetzen. Risikoarme Aktionen innerhalb genehmigter Richtliniengrenzen laufen automatisch, während Aktionen mit höherem Risiko ein menschliches Review, Protokollierung und Eskalation auslösen. Observability zur Laufzeit für Berechtigungen, Tool-Nutzung, Eingriffe und Dateneingänge zeigt, wann ein einst sicherer Workflow riskant geworden ist.


