Timestamp in Datetime umwandeln: der vollständige Leitfaden
|
6
min. Lesezeit

1700000000 ist kein Datetime, sondern ein maschineller Timestamp. Wer ihn sicher konvertieren will, bestimmt zuerst die Einheit, normalisiert auf UTC und stellt das Ergebnis dann mit explizitem Zeitzonenkontext dar - sonst wird der Datensatz verfälscht.
Ein kaputtes Dashboard um 8:05 Uhr sieht meist gar nicht kaputt aus. Das Diagramm lädt, der Batch läuft durch und der Abrechnungsexport kommt pünktlich an, aber ein Team liest Sekunden als Millisekunden, ein anderes geht von Ortszeit aus und ein drittes formatiert einen Zeitpunkt, ohne den Originalwert zu behalten. In dieser Lücke zwischen maschinellen Timestamps und menschenlesbaren Datetimes verstecken sich die meisten Produktionsprobleme.
Inhaltsverzeichnis
Warum Timestamp-Konvertierungen in der Produktion scheitern
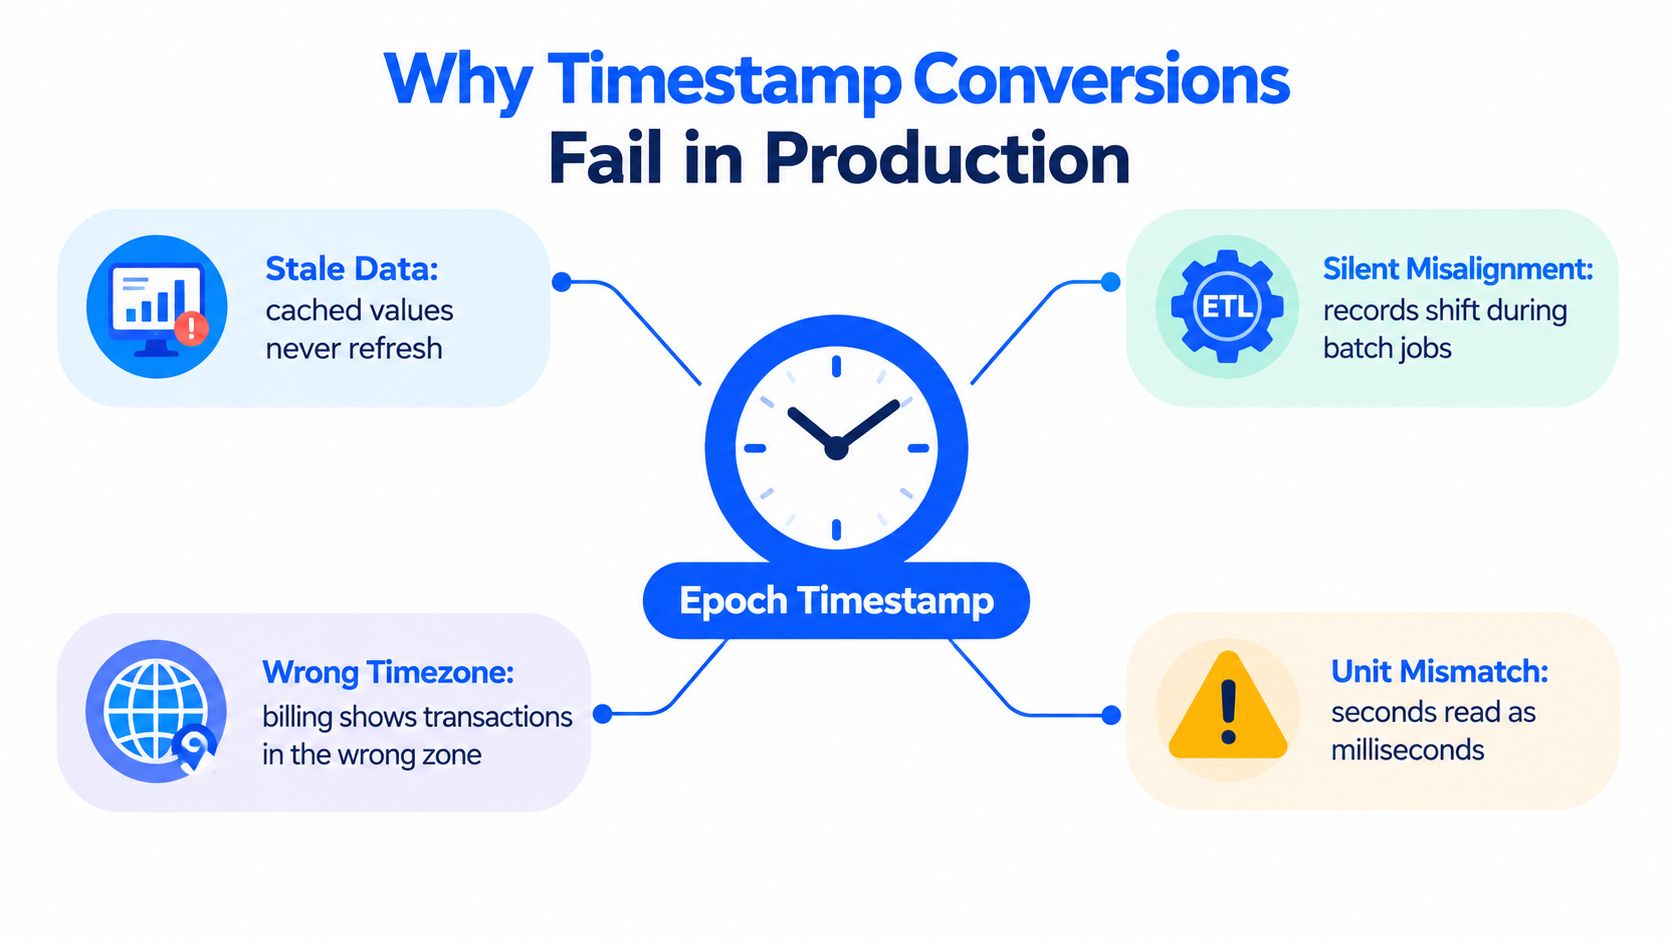
Ein Dashboard mit den Zahlen von gestern, ein ETL-Lauf, der Datensätze um einen Tag verschiebt, oder ein Abrechnungsextrakt in der falschen Region deuten meist auf dieselbe Ursache hin: eine mehrdeutige Bedeutung des Timestamps. Ein Unix-Timestamp bezeichnet einen Zeitpunkt relativ zur Unix-Epoche, also 00:00:00 UTC am 1. Januar 1970, aber die Zahl selbst sagt nicht, wie sie angezeigt werden soll. Dieselben Ziffern ergeben den falschen Moment, wenn ein System Sekunden und ein anderes Millisekunden liest oder wenn sich die lokale Zeitzone eines Servers in den Konvertierungsschritt einschleicht. Die Unix-Konvention behandelt außerdem jeden bürgerlichen Tag als genau 86.400 logische Sekunden, damit die Arithmetik einfach bleibt, doch Schaltsekunden und Zeitzonenregeln spielen weiterhin eine Rolle, sobald das Ergebnis Menschen gezeigt wird. (NASA-Referenz zu Schaltsekunden)
Was zuerst kaputtgeht
Der erste Fehler ist meist eine Einheitenverwechslung. Ein Wert, der als Sekunden zu lesen wäre, wird als Millisekunden interpretiert, und das resultierende Datetime landet nahe 1970 oder weit außerhalb des erwarteten Bereichs. Der zweite Fehler ist Zeitzonendrift: Der Timestamp wird korrekt dekodiert, aber im falschen lokalen Kontext angezeigt.
Faustregel: Behandeln Sie den rohen numerischen Wert als Quelle der Wahrheit und das formatierte Datetime als Darstellungsschicht.
Der dritte Fehler steckt im systemübergreifenden Austausch. Ein Dienst schreibt UTC, ein anderer liest einen naiven Wert als Ortszeit, und die Pipeline „funktioniert“ trotzdem, weil das Ergebnis plausibel genug aussieht, um einen kurzen Blick zu überstehen. Der vierte Fehler ist die Schaltsekunden-Policy, denn gewöhnliche POSIX-Zeit ignoriert eingefügte UTC-Sekunden und kann 23:59:60 nicht eindeutig darstellen. Das Risiko betrifft nicht nur hübsche Anzeigen. Es zeigt sich bei Abrechnungsstichtagen, Incident-Zeitleisten und jedem Datensatz, bei dem die Reihenfolge zählt. Warum frühe Pipeline-Fehler anfangs oft unsichtbar sind bietet einen nützlichen Blick auf solche stillen Fehler in benachbarten Datenflüssen.
Wie ein korrektes Denkmodell aussieht
Die richtige Reihenfolge ist einfach, aber jeder Schritt zählt. Erstens: Einheit und semantischen Vertrag bestimmen. Zweitens: auf einen absoluten Zeitpunkt normalisieren. Drittens: diesen Zeitpunkt in UTC oder einer benannten Zivilzeitzone darstellen, und zwar erst dann, wenn die Ausgabe gebraucht wird. Wer einen dieser Schritte überspringt, konvertiert keinen Timestamp mehr in ein Datetime, sondern rät.
Timestamps in gängigen Systemen konvertieren
Am sichersten sind Konvertierungen, die Einheit und Zeitzone im Code offensichtlich machen. Python, JavaScript und SQL haben jeweils eigene Standardwerte, und genau bei diesen Standardwerten beginnen Produktionsfehler. Wer konsequent auf explizite, zeitzonenbewusste Konvertierung setzt, erhält denselben Rohwert reproduzierbar über Server, Jobs und Notebooks hinweg.
Python
Die Standardbibliothek von Python bietet ein sauberes Muster: datetime.fromtimestamp(value, tz=timezone.utc) für eine UTC-bewusste Konvertierung, danach astimezone(target_zone) nur dann, wenn eine benannte lokale Zone nötig ist. Wenn Sie tz weglassen, verwendet Python die lokale Zeit der Plattform und gibt ein naives Datetime zurück - so beginnt derselbe Code sich auf verschiedenen Hosts unterschiedlich zu verhalten. Deshalb ist der explizite UTC-Schritt der sicherere Standard. Die offizielle datetime-Dokumentation beschreibt ebenfalls die Unterscheidung zwischen naiv und bewusst sowie die empfohlene Verwendung von timezone.utc. (Python-datetime-Dokumentation)
JavaScript
Date in JavaScript speichert Millisekunden seit der Unix-Epoche, daher müssen Unix-Sekunden vor der Konvertierung mit 1.000 multipliziert werden. Die Rückrichtung erfordert eine Division durch 1.000, und wenn es darauf ankommt, sollte die Bruchteilpräzision erhalten bleiben. Die andere Falle ist die Wahl des Accessors, denn eine UTC-basierte Speicherung verhindert nicht, dass lokale Accessoren über die Zeitzone des Host-Rechners lesen. Die MDN-Date-Referenz erinnert gut daran, diese Unterscheidung explizit zu halten.
SQL und Warehouse-Engines
SQL-Engines unterscheiden sich, daher ist es am sichersten, Zieltyp und Zeitzonenverhalten zu prüfen, statt anzunehmen, dass eine Engine sich wie eine andere verhält. PostgreSQL unterscheidet Timestamp-Präzisionen und unterstützt Bruchteilauflösung, während ClickHouse eigene Funktionen für Sekunden, Millisekunden und Mikrosekunden bereitstellt. In der Praxis geht es nicht darum, jeden Funktionsnamen auswendig zu kennen, sondern sicherzustellen, dass der gespeicherte Typ zur Quelleinheit passt und die Anzeigezeitzone bewusst gewählt wird. Die PostgreSQL-Dokumentation zu Datum und Zeit ist besonders hilfreich, wenn Sie über Präzision und Sekundenbruchteile nachdenken müssen. (PostgreSQL-Datums- und Zeittypen)
Für Teams, die mit verschiedenen Dateiformaten und Warehouse-Ingestion arbeiten, sind Parquet-Dateiformate wichtig, weil Timestamp-Felder oft Systeme mit unterschiedlichen Präzisionserwartungen durchlaufen. Ein Datetime, das in einer Engine korrekt aussieht, kann seine Bedeutung verlieren, wenn ein nachgelagerter Parser eine andere Einheit annimmt oder Sekundenbruchteile abschneidet.
Zeitzonenbehandlung jenseits der einfachen Konvertierung
Epochen-Dekodierung und Zeitzonenkonvertierung lösen unterschiedliche Probleme. Die Dekodierung beantwortet, welchen Zeitpunkt der Datensatz darstellt. Die Konvertierung beantwortet, wie dieser Zeitpunkt an einem bestimmten Ort und in einem bestimmten historischen Kontext erscheinen soll. Systeme, die diese Schritte vermischen, erzeugen lokale Daten, die in einer Umgebung korrekt und in einer anderen falsch aussehen. Die IANA-Zeitzonendatenbank existiert, weil sich die Zeitzonengeschichte je nach Ort und im Laufe der Zeit ändert. Sie erfasst lokale Zeitregeln und aktualisiert sie, wenn Regierungen Offsets und Sommerzeitregelungen ändern.
Warum feste Offsets scheitern
Ein fester Offset erfasst einen Moment, aber nicht die Regeln hinter diesem Moment. America/New_York ist nicht dasselbe wie UTC-5, denn die benannte Zone enthält das Sommerzeitverhalten und historische Änderungen, der Offset dagegen nicht. Wer nur den Offset speichert, verliert die Ortsidentität samt den damit verbundenen Regeländerungen.
Python handhabt das korrekt mit tzinfo, das Offset und Zonenverhalten zusammenhält. Das sicherere Muster ist, zuerst in UTC zu dekodieren und erst an der Anzeigegrenze in eine benannte Zone zu konvertieren. Einem naiven Datetime ein Zeitzonenlabel anzuhängen ist eine Neuinterpretation, keine Konvertierung.
Eine lokale Uhrzeit kann sich bei der Rückstellung auf Winterzeit wiederholen und bei der Umstellung auf Sommerzeit ganz verschwinden.
Warum JavaScript besondere Sorgfalt braucht
Das Date-Objekt von JavaScript basiert intern auf UTC, aber seine gewöhnlichen Komponenten-Accessoren verwenden die lokale Zeitzone des Host-Rechners. Ein Debug-Notebook auf einem Laptop und ein Produktionscontainer in einer anderen Region können für denselben Zeitpunkt unterschiedliche lokale Felder anzeigen. Der Timestamp ist trotzdem korrekt. Der Anzeigepfad ändert sich, und das reicht für verwirrende Bugs. Für deterministische Pipelines sollten Sie UTC-Accessoren oder eine zeitzonenbewusste Bibliothek verwenden und sich nicht auf Rechnerstandards verlassen.
Nachvollziehbarkeit gehört zur Zeitzonenbehandlung
Zeitzonenarbeit ist nicht nur Formatierung. Systeme für Finanzwesen, Gesundheitswesen oder grenzüberschreitendes Reporting müssen den ursprünglichen Zeitpunkt, die gewählte Zone und den Konvertierungsstatus gemeinsam aufbewahren - als Metadatenfelder, die mit dem Datensatz reisen, nicht daneben in einer Notebook-Notiz oder einem Ticketkommentar.
Diese Trennung ist in der Produktion entscheidend. Fehlt der ursprüngliche Zeitpunkt, können Sie nicht belegen, was empfangen wurde. Fehlt der Konvertierungsstatus, können Sie nicht erkennen, ob ein Wert normalisiert, angezeigt oder später neu interpretiert wurde.
Präzision, Einheitenerkennung und stiller Datenverlust
Eine Konvertierung von Timestamp zu Datetime kann mehr verändern als die Anzeige. Sie kann Präzision zerstören, die Ereignisreihenfolge zusammenfallen lassen und den Unterschied zwischen zwei Datensätzen verbergen, die in derselben angezeigten Sekunde, aber nicht im selben Zeitpunkt stattfanden. Deshalb muss die Einheitenerkennung als Schemavertrag behandelt werden, nicht als Schätzung anhand der Ziffernzahl. Praktiken für Genauigkeit in der Datenqualität sind hier besonders relevant, weil die falsche Präzisionswahl für nachgelagerte Systeme trotzdem „gültig“ aussieht.
Warum Ziffernzählen eine Falle ist
Eine lange Ganzzahl verrät nicht, ob die Quelle Sekunden, Millisekunden, Mikrosekunden oder Nanosekunden liefert. Ein 13-stelliger Wert kann in einem Feed Millisekunden sein, während ein anderes System eine ganz andere Skala verwendet. Wer durch 1.000 teilt, weil die Zahl „nach Millisekunden aussieht“, kann ein plausibles Datetime erzeugen, das subtil falsch ist.
PostgreSQL unterstützt Timestamp-Präzisionen von null bis sechs Nachkommastellen, was gut zeigt, warum das wichtig ist. Wenn Ihre Quelle Mikrosekunden liefert und Ihr Ziel nur sekundengenaue Werte speichert, verlieren Sie Reihenfolgeinformationen, obwohl das Ergebnis sauber dargestellt wird. Dieser Verlust kann Deduplizierung, Latenzmessung, Incident-Korrelation und Audit-Trails beeinträchtigen.
Was erhalten bleiben muss
Speichern Sie den ursprünglichen numerischen Wert. Speichern Sie die Quelleinheit. Speichern Sie die Zielpräzision. Stellen Sie das menschenlesbare Datetime erst dar, wenn diese Werte explizit sind. Wenn die Quelle Sekundenbruchteile verwendet, bewahren Sie sie in einer Form auf, die nicht über Gleitkommazahlen rundet, es sei denn, Ihr System kann diesen Verlust tolerieren.
Menschenlesbare Ausgaben sind für Menschen nützlich, können aber die operative Wahrheit verbergen, dass zwei Ereignisse verschieden waren.
Auch POSIX-artige Timestamps verdienen eine sorgfältige Formulierung. Sie sind für Arithmetik bequem, weil jeder Tag als 86.400 Sekunden behandelt wird, aber sie sind keine perfekte physikalische Uhr und zählen Schaltsekunden nicht separat. Diese Unterscheidung ist in Observability-Systemen wichtig, in denen die Pipeline womöglich „dieselbe angezeigte Sekunde“ von „demselben zugrunde liegenden Ereignis“ unterscheiden muss.
Eine produktionsreife Timestamp-Pipeline aufbauen
Eine Produktionspipeline sollte jedes Mal in derselben Reihenfolge vorgehen. Zuerst den Rohwert parsen und die Quelleinheit bestätigen. Größenordnung, Präzision und Nullbarkeit gegen den Vertrag validieren. Auf UTC normalisieren. Nur für die Darstellung in eine benannte lokale Zeitzone konvertieren. Ein explizites Format wie ISO 8601 mit Z oder Offset ausgeben. Diese Abfolge verhindert, dass derselbe Datensatz seine Bedeutung ändert, während er sich durch Dienste bewegt.

Der Workflow, der sich in der Produktion bewährt
Beginnen Sie mit dem Vertrag, bevor Sie den Formatter anfassen. Ein Timestamp-Feld sollte angeben, ob es Sekunden, Millisekunden oder eine andere Einheit enthält und ob es UTC oder eine lokale Zivilzeit darstellt. Halten Sie diese Angabe in Schemadokumentation, Pipeline-Checks und Test-Fixtures fest, damit Parser und Reviewer dasselbe beurteilen.
Normalisieren Sie den Zeitpunkt vor jeder Anzeigeformatierung. JavaScript braucht eine explizite Multiplikation oder Division rund um die Millisekunden-Speicherung von Date. Python sollte zuerst bewusste UTC-Datetimes erzeugen. SQL sollte zeitzonenbewusste Typen verwenden und stille Casts vermeiden, die von Sitzungseinstellungen abhängen. Erst danach sollten Sie in die Geschäftszeitzone konvertieren, und nur, wenn ein nachgelagerter Konsument eine lokale Darstellung braucht.
Teams, die Orchestrierungs- und Warehousing-Bausteine vergleichen, können moderne Komponenten von Datenpipelines als Referenz für die beweglichen Teile nutzen. Die praktische Regel ist einfacher: Jeder Hop sollte den Rohwert, die Quelleinheit, die Darstellungszeitzone und das Validierungsergebnis mitführen. So bleibt Fehlersuche möglich, ohne die gesamte Pipeline erneut abzuspielen.
Der ursprüngliche numerische Timestamp sollte niemals verschwinden, nur weil ein Datetime für einen Bericht dargestellt wurde. Behalten Sie beide. Das eine ist das Audit-Feld, das andere die Anzeigeschicht. Qualitätskontrollen für Datenpipelines sind am stärksten, wenn beide jeden Hop überstehen.
Konvertierungen mit Edge-Case-Tests validieren
Timestamp-Bugs zeigen sich an den Rändern. Werte, die in einer schnellen Demo gut aussehen, scheitern oft in der Produktion, daher muss die Testsuite die unangenehmen Fälle gezielt treffen. Dazu gehören null, negative Werte vor der Epoche, Sekundenbruchteile, Nullwerte, nicht numerische Strings und Timestamps nahe an Sommerzeitumstellungen. Dieselbe Suite sollte auch maximal unterstützte Daten nahe den Systemgrenzen abdecken und prüfen, dass die UTC-Accessoren von JavaScript über Umgebungen hinweg konsistent zu den lokalen Accessoren bleiben. Praktiken für Datenqualitätstests sind am stärksten, wenn sie die hässlichen Fälle prüfen, nicht nur den Happy Path.
Was zuerst getestet werden sollte
Null und Werte vor der Epoche: Bestätigen Sie, dass die Pipeline
0und negative Timestamps konsistent verarbeitet oder sie mit einem klaren Grund ablehnt.Bruchteilpräzision: Prüfen Sie, dass Mikro- oder Millisekunden die Konvertierung überstehen, wenn der Quellvertrag sie verlangt.
Momente der Zeitumstellung: Testen Sie wiederholte und übersprungene Ortszeiten, damit die Anzeigeschicht den Zeitpunkt nicht falsch beschriftet.
Null- und nicht numerische Eingaben: Bestätigen Sie, dass die Pipeline fehlerhafte Datensätze ablehnt, ohne zu raten.
Timestamps an der Obergrenze: Prüfen Sie den größten Datetime-Bereich, den Ihre Datenbank, Ihre Laufzeitumgebung oder Ihr Serialisierungsformat aufnehmen kann.
Was protokolliert werden sollte
Protokollieren Sie die Quelleinheit, die Zeitzonen-Metadaten der Quelle, den normalisierten UTC-Zeitpunkt, den Validierungsstatus und gegebenenfalls den Fehlergrund. Diese Metadaten machen Incident-Reviews reproduzierbar, besonders wenn eine Umgebung ihre Zeitzonendaten aktualisiert, während eine andere hinterherhinkt. Die IANA-Datenbank ändert sich im Laufe der Zeit, daher hängt Reproduzierbarkeit ebenso vom Versionsbewusstsein ab wie von korrektem Code.
Eine Konvertierung, die sich nicht aus Logs reproduzieren lässt, ist nicht validiert.
Eine abschließende Prüfung sollte den ursprünglichen Wert nach einem Roundtrip, sofern unterstützt, mit dem dargestellten Datetime vergleichen. Ändert sich der zurückgegebene Zeitpunkt, verliert der Konvertierungspfad noch Informationen. Wer den rohen Timestamp neben dem Datetime aufbewahrt, erleichtert Audit-Reviews erheblich, weil ein Feld den Maschinenwert bewahrt und das andere die menschenlesbare Form zeigt.
Wenn diese Timestamp-Verträge - Einheit, plausibler Wertebereich, Präzision und Nullbarkeit - bei jeder Ladung durchgesetzt werden sollen und nicht nur in Testsuiten, führt digna Data Validation sie als Regeln direkt in Ihrer Datenbank aus.
Häufig gestellte Fragen
Wie wandle ich in Python einen Unix-Timestamp in ein Datetime um?
Verwenden Sie datetime.fromtimestamp(value, tz=timezone.utc) für ein UTC-bewusstes Datetime und rufen Sie astimezone() mit einer ZoneInfo-Zone wie America/New_York erst auf, wenn Sie eine lokale Anzeige brauchen. Ohne tz nutzt Python die lokale Zeit des Hosts und liefert ein naives Datetime, sodass Ergebnisse je nach Server abweichen.
Warum zeigt mein konvertierter Timestamp ein Datum im Jahr 1970?
Ein Datum nahe 1970 bedeutet fast immer eine Einheitenverwechslung: Ein Wert in Sekunden wurde als Millisekunden gelesen, sodass der Zeitpunkt kurz nach der Unix-Epoche am 1. Januar 1970, 00:00:00 UTC, landet. Bestimmen Sie die Quelleinheit über den Schemavertrag, statt sie aus der Ziffernzahl zu erraten.
Ist America/New_York dasselbe wie UTC-5?
Nein. UTC-5 ist ein fester Offset, der einen einzelnen Moment beschreibt, während America/New_York eine benannte IANA-Zone mit Sommerzeitregeln und historischen Änderungen ist. Wer nur den Offset speichert, verliert die Ortsidentität und jede damit verbundene Regeländerung, sodass lokale Zeiten auseinanderlaufen.
Was sollte eine Timestamp-Pipeline neben dem formatierten Datetime speichern?
Bewahren Sie den ursprünglichen numerischen Wert, die Quelleinheit, die Zielpräzision, die für die Anzeige verwendete Zeitzone und das Validierungsergebnis auf. Der Rohwert ist das Audit-Feld, das Datetime nur die Darstellungsschicht - beide sollten den Datensatz durch jeden Hop der Pipeline begleiten.
Welche Grenzfälle sollten Tests für die Timestamp-Konvertierung abdecken?
Beginnen Sie mit null und negativen Werten vor der Epoche, Sekundenbruchteilen, Nullwerten und nicht numerischen Strings sowie Momenten rund um Zeitumstellungen, in denen Ortszeiten doppelt vorkommen oder fehlen. Ergänzen Sie Daten nahe den Grenzen Ihrer Datenbank oder Laufzeit und prüfen Sie, dass ein Roundtrip denselben Zeitpunkt liefert.


