Datenqualität bewerten: Ein Praxisleitfaden für Teams
|
6
min. Lesezeit

Man spürt, dass die Datenqualität nachlässt, lange bevor jemand ein Ticket erstellt. Das Dashboard wurde aktualisiert, die Pipeline meldete Erfolg, und trotzdem passen die Zahlen nicht zu Finance, Sales oder dem, was das Business erwartet hat. In diesem Moment erkennen Teams meist, dass das Problem nicht darin liegt, ob Daten angekommen sind, sondern ob man ihnen vertrauen kann.
Die meisten Teams beginnen mit Aktualitätsprüfungen und Null-Raten, weil sie sich leicht automatisieren lassen. Diese Prüfungen sind wichtig, verraten aber nicht, ob eine Spalte über Nacht ihre Bedeutung geändert hat, ob eine Quelle begonnen hat, Datensätze zu duplizieren, oder ob ein sauber wirkender Datensatz für die Entscheidung, die er stützt, trotzdem falsch ist. Deshalb muss die Bewertung der Datenqualität als diagnostischer Workflow behandelt werden, nicht als Statuslampe, und deshalb kann ein fehlerhafter Bericht auch aus einem „erfolgreichen“ Ladevorgang stammen.
Inhaltsverzeichnis
Warum die meisten Datenqualitätsprüfungen das eigentliche Problem übersehen
Ein typischer Morgen beginnt mit einer grünen Pipeline und einem roten Slack-Thread. Der Ladevorgang ist abgeschlossen, die Warehouse-Tabellen sind befüllt, und das Umsatz-Dashboard sieht auf den ersten Blick gut aus, bis jemand bemerkt, dass die Summe nicht stimmt, weil eine Quelle einen Spaltentyp geändert hat oder eine Geschäftsregel nicht mehr zum neuen Format passt. Die Pipeline ist nicht ausgefallen, wohl aber die Entscheidungsebene.
Genau diese Lücke ist der Grund, warum Pipeline-Erfolg und Datenqualität nicht dasselbe sind. Ein abgeschlossener Job beweist nur, dass Bytes bewegt wurden, nicht dass die Datensätze noch dasselbe bedeuten wie gestern. Wenn Ihre Prüfungen bei Aktualität und Null-Zählungen aufhören, entgehen Ihnen Genauigkeitsprobleme, tabellenübergreifende Widersprüche und Schema-Drift, die das nachgelagerte Reporting ohne Vorwarnung beschädigen.
Praxisregel: Wenn eine Kennzahl falsch sein kann, während sie vorhanden aussieht, braucht sie eine Qualitätsprüfung, die über die bloße Existenz hinausgeht.
Teams verbrennen sich die Finger, wenn sie Observability mit Qualitätsbewertung verwechseln. Observability sagt Ihnen, dass sich im Datenfluss etwas verändert hat, während die Bewertung fragt, ob die Daten noch für ihren Zweck geeignet sind. Der Unterschied zählt in regulierten Umgebungen und in KI-Workflows, wo technisch saubere Daten operativ trotzdem unsicher sein können.
Das beste interne Denkmodell ist einfach: vorhandene Daten sind keine vertrauenswürdigen Daten. Genau diese Linie müssen Ihre Alerts verteidigen. Wenn Sie die Lücke zwischen lauten Dashboards und umsetzbaren Kontrollen ausloten, ist diese Perspektive datenreich, aber informationsarm eine nützliche Ergänzung, weil sie genau den Fehlermodus beschreibt, mit dem viele Teams täglich leben.
Kritische Datensätze und Qualitätsdimensionen definieren
Legen Sie fest, was wichtig ist, bevor Sie eine einzige Prüfung schreiben. Nicht jede Tabelle verdient die gleiche Aufmerksamkeit, und nicht jedes Feld trägt das gleiche Risiko. Der richtige Umfang ist die Schnittmenge aus geschäftlicher Auswirkung und nachgelagerter Abhängigkeit, daher lautet die erste Frage immer: „Was geht kaputt, wenn dieser Wert falsch ist?“
In einer regulierten Landschaft würde ich den Datensatz zuerst um die kritischen Workflows herum abgrenzen und dann die Attribute identifizieren, die diese Workflows tatsächlich steuern. Das sind in der Regel Identifikatoren, Zeitstempel, Fremdschlüssel, Statusfelder, regulatorische Codes und jeder Wert, der in eine KPI, einen Bericht oder ein Modell einfließt. Sobald diese benannt sind, definieren Sie die sechs Dimensionen als messbare Anforderungen, nicht als abstrakte Ideale.
Dimension | Was sie misst | Typische Art des Schwellenwerts | Fehlerbeispiel |
|---|---|---|---|
Vollständigkeit | Pflichtwerte sind vorhanden | Streng bei Pflichtfeldern, lockerer bei optionalem Text | Eine erforderliche Kunden-ID fehlt |
Eindeutigkeit | Datensätze sind nicht dupliziert | Meist null Toleranz bei Schlüsselfeldern | Dieselbe Transaktion kommt zweimal an |
Konsistenz | Werte widersprechen sich nicht über Systeme oder Tabellen hinweg | Quellenübergreifende Abgleichsprüfungen | Der Bestellstatus unterscheidet sich zwischen Warehouse und Abrechnung |
Gültigkeit | Werte entsprechen zulässigen Formaten, Bereichen oder Regeln | Klares Bestanden oder Nicht bestanden bei definierten Mustern | Eine Steuernummer hat das falsche Format |
Genauigkeit | Werte stimmen mit vertrauenswürdigen Referenzdaten oder der Realität überein | Abgleich mit maßgeblichen Quellen | Ein Produktcode existiert, verweist aber auf den falschen Artikel |
Aktualität | Daten sind aktuell genug für ihren Verwendungszweck | Aktualitätsfenster oder Lieferzusagen | Eine tägliche Datei kommt nach dem Reporting-Stichtag an |
Die Falle besteht darin, all das zu einem einzigen Score zusammenzufassen. Ein Datensatz kann nahezu vollständig und dennoch unbrauchbar sein, wenn die gültigen Werte falsch oder veraltet sind. Deshalb sollten Schwellenwerte risikogewichtet sein, mit null Toleranz etwa bei einer ungültigen regulatorischen Kennung und etwas Flexibilität bei einem unwesentlichen beschreibenden Feld.
Ein gutes Scope-Dokument passt auf eine Seite. Wenn es nicht sagen kann, welche Tabellen wichtig sind, welche Felder kritisch sind und warum jede Dimension geprüft wird, driftet das Programm in reines Abhak-Theater ab.
Wenn Sie einen praktischen Weg brauchen, kritische Felder zu identifizieren und mit Verantwortlichkeiten zu verknüpfen, sind kritische Datenelemente der richtige Ausgangspunkt. Für Teams, die den Umfang gemeinsam mit Governance und Engineering festlegen, erspart diese Abstimmung viele spätere Diskussionen.
Die gestufte Bewertungsmethodik anwenden
Der sauberste Weg, Datenqualität zu bewerten, besteht darin, die Arbeit in eine feste Reihenfolge zu bringen, statt zu improvisieren. Die Reihenfolge zählt, weil jede Stufe die nächste speist und das Auslassen einer Stufe den ganzen Prozess zum Ratespiel macht. Beginnen Sie mit dem Profiling, definieren Sie dann Regeln, setzen Sie Schwellenwerte, führen Sie Abfragen aus und prüfen Sie die Ergebnisse.

Erst profilieren, dann vorschreiben
Profilieren Sie zuerst den Datensatz. Betrachten Sie Null-Raten, Duplikatraten, Wertebereiche, Formate und referenzielle Beziehungen, denn diese Muster zeigen Ihnen, wo die tatsächlichen Fehler liegen. Ohne diese Ausgangsbasis schreiben Sie am Ende Regeln auf Basis von Annahmen statt von Fakten.
Übersetzen Sie dann die Anforderungen in Tests, die spezifisch für die gemessene Dimension sind. Ein Datumsfeld braucht eine Formatregel und eine Bereichsregel. Ein Fremdschlüssel braucht eine referenzielle Prüfung. Ein regulatorischer Code braucht unter Umständen ein strenges Muster plus einen Abgleich mit der maßgeblichen Quelle.
Schwellenwerte setzen, die das Risiko widerspiegeln
Warn- und Fehlerschwellen sollten nicht dasselbe sein. Ein Feld, das ein Dashboard speist, verträgt vielleicht eine kleine Fehlerquote, ein Feld, das Compliance-Berichte steuert, in der Regel nicht. An dieser Unterscheidung scheitern zu viele Programme, weil sie jeden Fehler gleich behandeln.
Berechnen Sie die Ergebnisse auf Datensatz-, Feld-, Tabellen- und Domänenebene und verfolgen Sie sie im Zeitverlauf. Ein einzelner Durchlauf sagt fast nichts aus. Eine sich verschlechternde Fehlerquote zeigt Ihnen, dass sich eine Quelle geändert hat, ein Vertrag gebrochen wurde oder ein vorgelagertes Team sein Verhalten geändert hat. Hier wird die Methodik operativ statt dekorativ.
Es geht darum, den hässlichen Fall früh zu erkennen, den, bei dem ein Datensatz zu 99 % vollständig, aber dennoch wesentlich falsch ist. Wenn Sie eine Referenz für die Begriffe rund um diesen Ansatz brauchen, ist die Definition der Datenqualitätsbewertung eine hilfreiche Ergänzung.
Stichproben, Validierung und ehrliches Reporting
Ein Ergebnis ohne Kontext ist ein Risiko. Wenn Sie 100 Datensätze als Stichprobe gezogen haben, sollten Sie die Kennzahl nie so berichten, als stamme sie aus einem vollständigen Scan der Grundgesamtheit, denn die Unsicherheit ist Teil des Befunds. Bewahren Sie für jede Kennzahl Zähler, Nenner, Beobachtungszeitraum, Definition der Grundgesamtheit und Stichprobenverfahren auf und berichten Sie Konfidenzintervalle, wenn das Ergebnis aus einer Stichprobe geschätzt wird, wie es die Messleitlinien des NIST in ihrer Behandlung von Unsicherheit betonen (NIST SP 800-55).

Die Verteilung berichten, nicht nur den Score
Eine Vollständigkeitsschätzung aus 100 Stichproben-Datensätzen ist nicht dasselbe wie derselbe Prozentsatz aus 100.000 Datensätzen. Die erste kann nützlich sein, ist aber deutlich weniger stabil und viel leichter fehlzuinterpretieren. Verfolgen Sie Mittelwert, Standardabweichung, Quantile und fehlende Werte pro Segment, damit Sie sehen, wo sich das Problem häuft.
Diese Segmentierung ist wichtig, weil aggregierte Scores lokale Ausfälle verbergen. Eine Tabelle kann insgesamt gut aussehen, während ein Land, ein Quellsystem oder ein Kundensegment wegbricht. Wenn Sie die Aufschlüsselung nicht bewahren, übersehen Sie die operative Ursache und verschwenden Zeit mit Diskussionen über die Gesamtzahl.
Die typischen Fehlermodi nicht verwechseln
Gültigkeit ist nicht Genauigkeit. Ein Wert kann das richtige Format haben und trotzdem falsch sein. Verspätete Daten sind auch keine fehlenden Daten, und automatische Imputation kann die Vollständigkeit besser aussehen lassen und gleichzeitig die Nachvollziehbarkeit beschädigen.
Deshalb sollte der Bericht Unsicherheit benennen statt sie zu verstecken. Ein gutes Qualitätsergebnis sagt Ihnen, was geprüft wurde, wie es geprüft wurde, wie sicher Sie sein können und welche Teile der Grundgesamtheit Aufmerksamkeit brauchen.
Für Teams, die die Erfassungsseite dieses Workflows aufbauen, ist Bausteine zur Datenerfassung durchsuchen eine nützliche Referenz, um über Disziplin und Struktur bei Eingaben nachzudenken, besonders wenn Quellsysteme unübersichtlich sind. Das operative Problem ist meist nicht die Mathematik, sondern überhaupt vertrauenswürdige Eingaben zu bekommen.
Sie können die Prüfungen außerdem mit Datenvalidierungsregeln, Prüfungen und kontinuierlicher Datenqualität auf explizite Regeln und Prüflogik abbilden. Dort hört Reporting auf, abstrakt zu sein, und beginnt, echte Fehlerbehebung zu unterstützen.
Die richtige Mischung aus Tools und Automatisierung wählen
Gute Programme setzen nicht alles auf eine Art von Signal. Deterministische Validierung findet bekannte Fehler, KI-gestützte Anomalieerkennung findet ungewohnte Muster, und Schema- sowie Aktualitätsprüfungen fangen stille Ausfälle ab, bevor sie sich ausbreiten. Nutzen Sie alle drei, aber ordnen Sie jedes dem Problem zu, das es am besten löst.
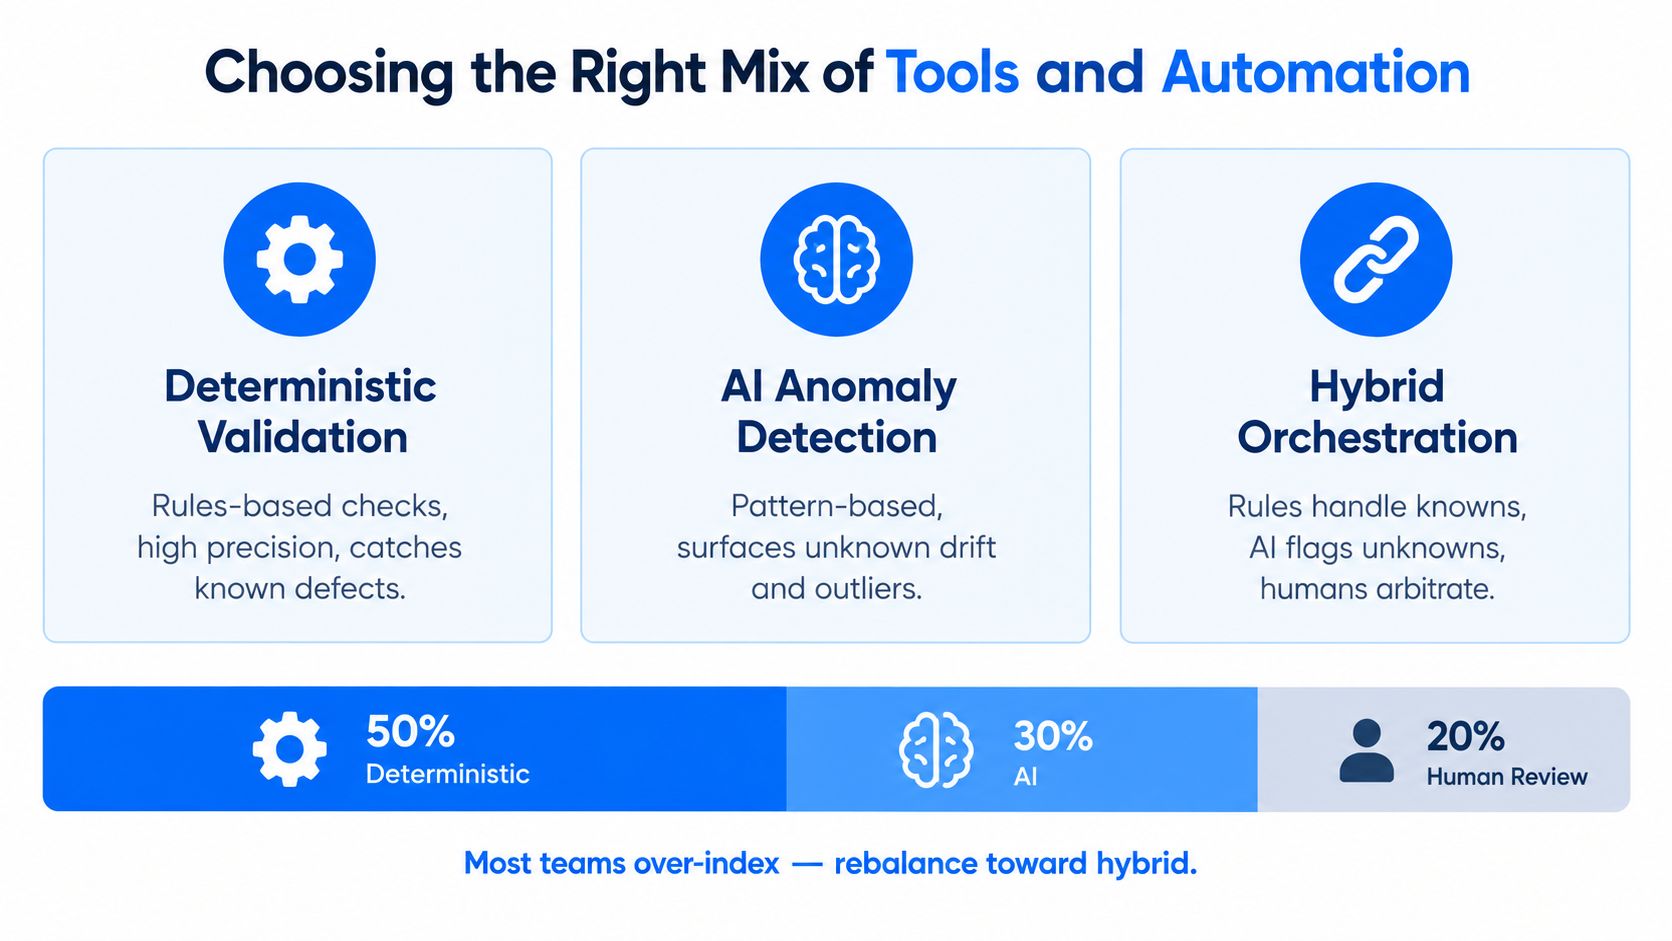
Das Signal auf den Fehlermodus abstimmen
Regelbasierte Validierung ist das richtige Werkzeug, wenn die Anforderung explizit und prüfbar ist. Wenn ein Steuercode einem Format folgen oder ein Fremdschlüssel existieren muss, schreiben Sie die Regel und machen Sie das Ergebnis reproduzierbar. Das ist der Nachweis, den Prüfer sehen wollen, und der schnellste Weg, bekannte Fehler aus Ihrer Datenlandschaft fernzuhalten.
KI-gestützte oder statistische Anomalieerkennung gehört dorthin, wo das Problem in schleichender Verhaltensänderung liegt. Eine Musterverschiebung bei Volumen, Verteilung oder Timing verletzt vielleicht keine harte Regel, kann aber dennoch auf eine geänderte Quelle, ein Problem in einem vorgelagerten Prozess oder eine gebrochene Annahme hinweisen. Gelernte Baselines schlagen in diesen Fällen statische Prüfungen, weil ein Regelwerk nicht jeden neuen Fehlermodus vorhersehen kann.
Struktur- und Liefer-Monitoring nicht vernachlässigen
Schemaänderungen und Aktualitätsprüfungen verdienen einen eigenen Platz im Stack. Eine Änderung des Spaltentyps, ein hinzugefügtes Feld oder eine verspätete Lieferung können nachgelagerte Verbraucher lahmlegen, bevor irgendeine zeilenbasierte Regel anschlägt. Diese Prüfungen sind grundlegend, ersparen aber viel Ärger in der Produktion.
Der Zielkonflikt liegt bei Governance und Platzierung. Die Ausführung in der Datenbank reduziert Datenbewegungen und hält die Kontrolle näher an den Daten, was in regulierten Umgebungen wichtig ist. Auch eine modulare Einführung hilft, weil Teams mit einem kritischen Pfad beginnen und dann erweitern müssen, statt eine riesige Plattform zu kaufen, die sie nie vollständig in Betrieb nehmen.
Sie brauchen kein einzelnes Wunderwerkzeug. Sie brauchen einen Stack, der zum Risikoprofil der Daten, zur Compliance-Last des Teams und zu den Fehlerarten passt, mit denen Ihr Unternehmen zu tun hat. Wenn Sie Anbieter vergleichen oder einen internen Standard entwickeln, sind Datenqualitätstools ein praktischer Anker für diese Bewertung.
Wenn saubere Daten nicht dasselbe sind wie sichere Daten
Ein Datensatz kann jede herkömmliche Prüfung bestehen und dennoch für die Entscheidung, die er stützt, unsicher sein. Bei KI-Arbeit wird das schnell offensichtlich, denn die Frage ist nicht nur, ob die Daten sauber sind, sondern ob sie relevant, repräsentativ und für die betroffene Gruppe angemessen sind. Artikel 10 des EU AI Act verlangt, dass Trainings-, Validierungs- und Testdaten für Hochrisikosysteme relevant, hinreichend repräsentativ, so vollständig und fehlerfrei wie möglich und statistisch angemessen für die betroffenen Gruppen und Kontexte sind (EU AI Act Artikel 10).
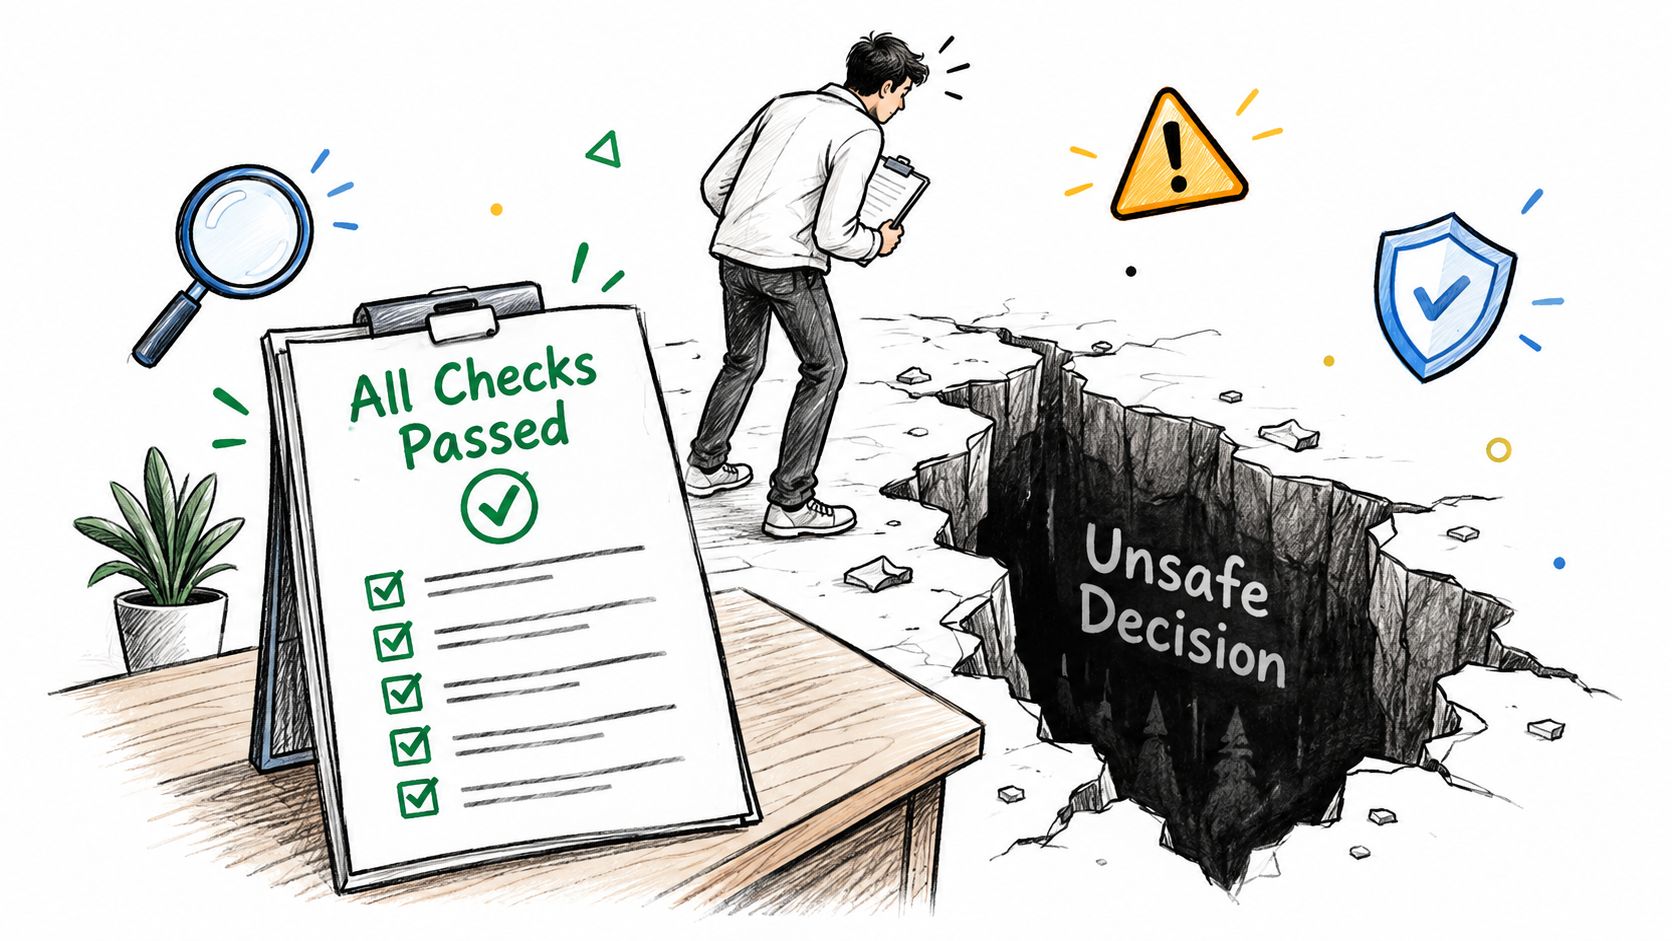
Technische Sauberkeit beweist keine Eignung für den Zweck
Das Standardmodell mit sechs Dimensionen greift hier zu kurz. Sie können vollständige, gültige, eindeutige Daten haben, die dennoch eine Minderheit unterrepräsentieren, eine relevante Region auslassen oder einen veralteten betrieblichen Kontext abbilden. Ein solcher Datensatz kann technisch einwandfrei aussehen und operativ trotzdem unsicher sein.
Die praktische Lösung besteht darin, Abdeckung von Untergruppen, Verteilungsverschiebung und Dokumentation des Verwendungszwecks in den Bewertungsnachweis aufzunehmen. Im Gesundheitswesen, in der Finanzbranche, in der Telekommunikation und im öffentlichen Sektor ist das kein theoretisches Anliegen. Aggregierte Qualitätsscores können akzeptabel aussehen, während die Abdeckung oder die Fehlerraten einzelner Gruppen inakzeptabel bleiben.
Repräsentativität als operative Anforderung behandeln
Repräsentativität muss messbar werden, sonst bleibt sie vage. Teams brauchen explizite Schwellenwerte für die Abdeckung von Untergruppen, klare Regeln dafür, wann Drift eine legitime Veränderung der Grundgesamtheit ist, und einen Nachweis, warum der Datensatz für eine bestimmte Entscheidung geeignet ist. Nur so lässt sich eine sich tatsächlich verändernde Grundgesamtheit von schädlicher Stichprobenverzerrung unterscheiden.
Hier zählt auch die Verantwortlichkeit. Jemand muss entscheiden, ob die Daten noch zum Anwendungsfall passen, nicht nur, ob die Prüfungen bestanden wurden. Wenn der Datensatz sauber, aber nicht geeignet ist, besteht die richtige Antwort darin, den Workflow anzuhalten, statt das Dashboard zu feiern.
Ergebnisse berichten und den Workflow operationalisieren
Der Bericht sollte den Stakeholdern sagen, was geprüft wurde, was fehlgeschlagen ist, wie sicher sich das Team beim Ergebnis ist und wer für den nächsten Schritt verantwortlich ist. Nehmen Sie Umfang, geprüfte Dimensionen, Schwellenwerte, Aufschlüsselungen nach Segmenten, Ergebnisse mit Unsicherheit, Stand der Fehlerbehebung und eine klar verantwortliche Person für jedes offene Problem auf. Wenn Sie eine praktische Referenz für operative Dokumentationsmuster brauchen, sind die Anleitungen von Trupeer Inc. ein nützliches Vorbild, um Prozessschritte lesbar zu machen, ohne sie zu verkomplizieren.
Den Workflow wiederholbar halten
Die zuverlässigsten Programme machen aus der Bewertung einen festen Termin im Kalender, kein einmaliges Projekt. Planen Sie wiederkehrende Bewertungen, versionieren Sie Regeln und Schwellenwerte, alarmieren Sie bei Verschlechterung und besprechen Sie die Ergebnisse regelmäßig mit den Stakeholdern. Das entspricht dem Governance-Modell von ISO 8000, bei dem Normen alle fünf Jahre überprüft werden und Qualitätskontrolle Teil des laufenden Managements ist, kein einmaliges Zertifizierungsereignis (ISO 8000-1:2022).
Checkliste für das Runbook: kritische Datensätze abgrenzen, die Daten profilieren, die Regeln definieren, Warn- und Fehlerschwellen setzen, die Abfragen ausführen, die Ergebnisse im Zeitverlauf verfolgen, Unsicherheit berichten und nach festem Kalender neu bewerten.
Vermeiden Sie Eitelkeits-Dashboards. Vermeiden Sie Alert-Fluten. Beide führen zum selben Ergebnis: Die Leute hören auf, dem Programm zu vertrauen. Ein Qualitäts-Workflow funktioniert nur, wenn die Signale konkret genug sind, um darauf zu handeln, und stabil genug, um Audit, Engineering und Analytics gleichzeitig zu unterstützen.
Wenn Sie eine Plattform suchen, die in Ihrer eigenen Umgebung läuft und Validierung auf Datensatzebene, Aktualitäts-Monitoring, Schema-Tracking und Anomalieerkennung kombiniert, ist digna eine Option, die Sie für dieses Betriebsmodell prüfen sollten. Besuchen Sie digna, um zu sehen, wie der Ansatz für Datenqualität und Observability zu kritischen Datensätzen, regulierten Landschaften und KI-fähigen Workflows passt.
Für die Seite dieses Stacks mit gelernten Baselines sehen Sie sich an, wie das Modul digna Data Anomalies Verschiebungen bei Volumen, Verteilung und Timing erkennt, die keine handgeschriebene Regel vorhergesehen hat.
Häufig gestellte Fragen
Wie bewertet man die Datenqualität Schritt für Schritt?
Bewerten Sie die Datenqualität in fester Reihenfolge: kritische Datensätze abgrenzen, die Daten profilieren, Regeln pro Dimension definieren, Warn- und Fehlerschwellen setzen, Abfragen ausführen und Ergebnisse im Zeitverlauf verfolgen. Das Profiling kommt zuerst, weil Null-Raten, Duplikate und Wertebereiche zeigen, wo die Fehler tatsächlich liegen, sodass Regeln auf Fakten statt auf Annahmen beruhen.
Welche sechs Dimensionen werden zur Messung der Datenqualität verwendet?
Die sechs Dimensionen sind Vollständigkeit, Eindeutigkeit, Konsistenz, Gültigkeit, Genauigkeit und Aktualität. Jede sollte eine messbare Anforderung mit eigener Art von Schwellenwert sein, zum Beispiel null Toleranz bei doppelten Schlüsselfeldern oder ein Aktualitätsfenster für eine tägliche Datei, die vor dem Reporting-Stichtag eintreffen muss.
Warum kann eine erfolgreiche Pipeline trotzdem schlechte Daten liefern?
Ein abgeschlossener Job beweist nur, dass Bytes bewegt wurden, nicht dass die Datensätze noch dasselbe bedeuten wie gestern. Eine Quelle kann einen Spaltentyp ändern oder Datensätze duplizieren, während der Ladevorgang grün bleibt. Prüfungen, die sich auf Aktualität und Null-Zählungen beschränken, übersehen daher Genauigkeitsprobleme, tabellenübergreifende Widersprüche und Schema-Drift.
Wie sollten Datenqualitätsergebnisse aus Stichproben berichtet werden?
Stichprobenergebnisse sollten immer ihre Unsicherheit mitführen. Bewahren Sie für jede Kennzahl Zähler, Nenner, Beobachtungszeitraum, Definition der Grundgesamtheit und Stichprobenverfahren auf und berichten Sie Konfidenzintervalle, denn eine Vollständigkeitsschätzung aus 100 Stichproben-Datensätzen ist weit weniger stabil als derselbe Prozentsatz aus 100.000 Datensätzen.
Sind saubere Daten für KI immer sicher?
Nein, saubere Daten können dennoch unsicher sein, wenn sie eine Gruppe unterrepräsentieren, eine Region auslassen oder einen veralteten Kontext abbilden. Artikel 10 des EU AI Act verlangt, dass Trainingsdaten für Hochrisikosysteme relevant und hinreichend repräsentativ sind, daher sollten Bewertungen Abdeckung von Untergruppen, Verteilungsverschiebung und Dokumentation des Verwendungszwecks ergänzen.


