So erstellen Sie eine Konfigurationsdatei, die funktioniert
|
5
min. Lesezeit

Um zu lernen, wie Sie eine Konfigurationsdatei erstellen, legen Sie die Einstellungen fest, die Ihre Anwendung benötigt, wählen ein gut lesbares Format, speichern die Datei mit der richtigen Erweiterung und validieren sie, bevor Sie etwas live schalten. Ziel ist es, das Laufzeitverhalten vom Anwendungscode zu trennen, damit Teams Umgebungen anpassen können, ohne die Codebasis zu ändern.
Inhaltsverzeichnis
Konfigurationsdateien verstehen und schnell einrichten
Eine Konfigurationsdatei schließt die Lücke zwischen Ihrem Code und der laufenden Umgebung. Anstatt Datenbank-Verbindungszeichenfolgen, API-Endpunkte, Log-Level oder Feature-Flags direkt im Quellcode festzuschreiben, speichern Sie diese extern, sodass berechtigte Teammitglieder sie unabhängig aktualisieren können.
Diese Trennung ist im Finanzwesen, im Gesundheitswesen und im öffentlichen Sektor wichtig, wo Änderungen kontrolliert, zugriffsbeschränkt und nachvollziehbar sein müssen. Sie reduziert außerdem Fehler beim Deployment, da Entwicklung, Staging und Produktion unterschiedliche Werte verwenden können, während sie denselben Anwendungscode nutzen.
Listen Sie zunächst die Einstellungen auf, ohne die die Anwendung nicht laufen kann:
Verbindungsdetails wie Datenbanknamen und Servicereferenzen
Feature-Flags, die optionales Verhalten ein- oder ausschalten
Logging-Einstellungen einschließlich Detailgrad und Ausgabeziel
Umgebungsbezeichnungen, damit die App beim Start das richtige Profil lädt
Wählen Sie das Format, das zu Ihrer Toolchain passt. YAML ist gut lesbar und bildet Hierarchien gut ab. JSON ist strikt und arbeitet reibungslos mit APIs zusammen. INI eignet sich für einfache Schlüssel-Wert-Paare. TOML bietet eine explizite Struktur ohne großen Aufwand.
Die folgende Grafik vergleicht diese vier Formate nach Lesbarkeit, Hierarchie, Unterstützung von Kommentaren und typischen Anwendungsfällen.
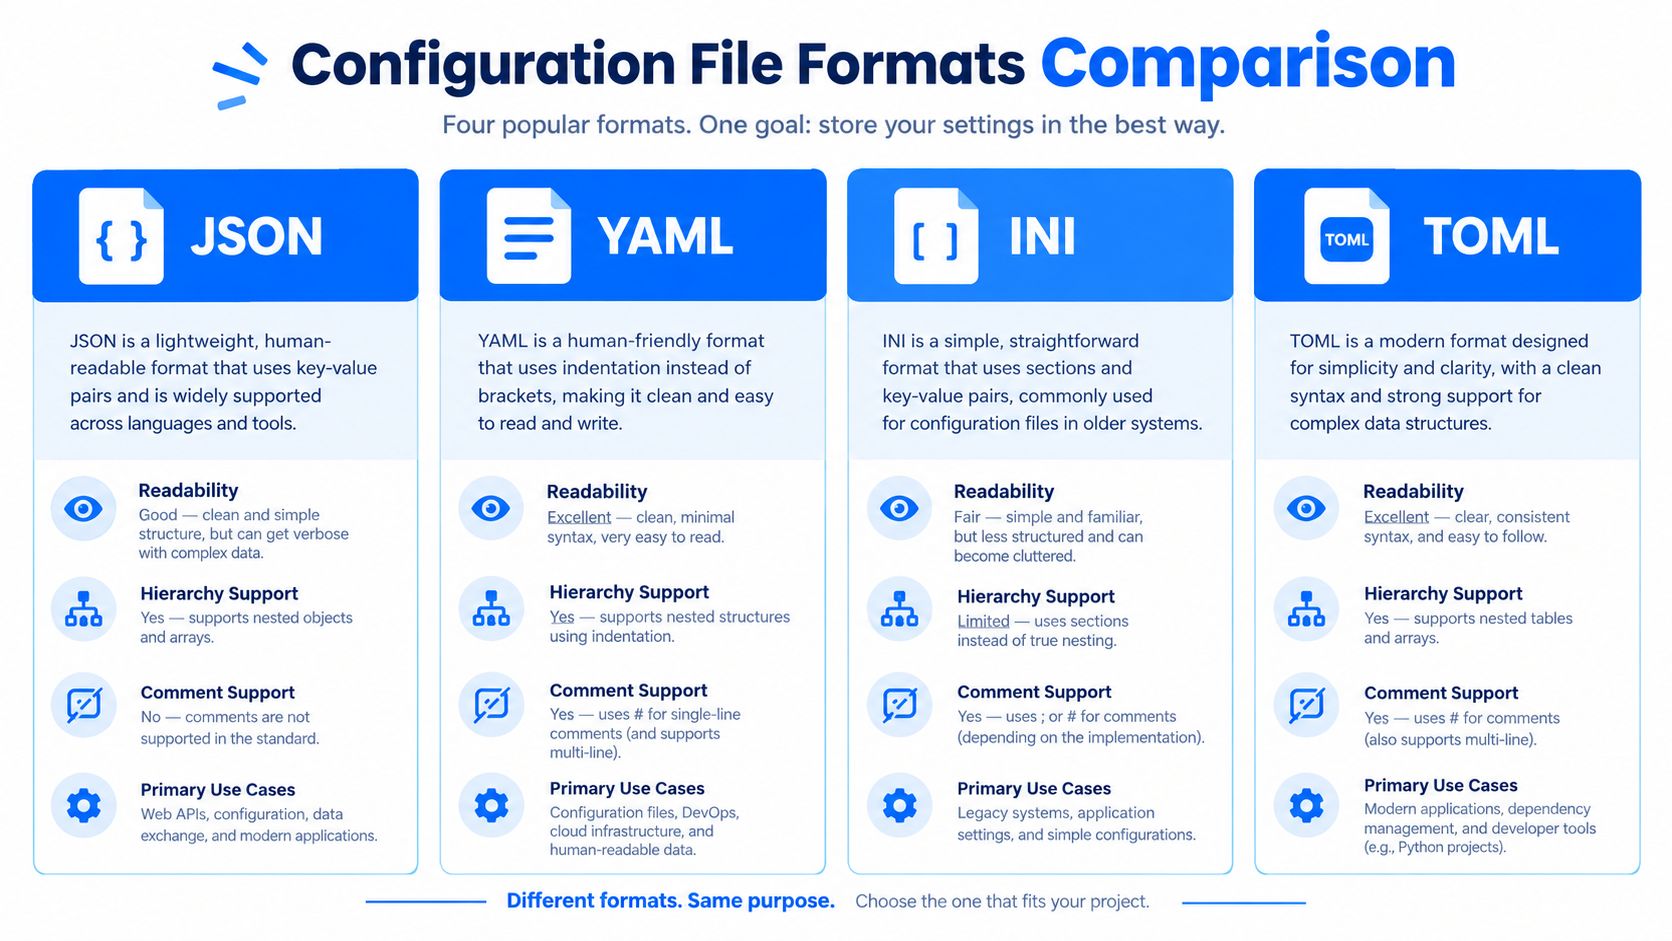
Sie werden feststellen, dass YAML und TOML auf die Bearbeitung durch Menschen ausgelegt sind, während JSON für striktes maschinelles Parsen konzipiert ist und INI für flachere, einfachere Einstellungen nützlich bleibt.
Tipp: Behandeln Sie jede Konfigurationsdatei als Eingabe, die fehlschlagen kann. Parsen und validieren Sie sie immer, bevor die Anwendung startet – gehen Sie nie davon aus, dass sie korrekt geladen wird.
Wenn Sie mit Python arbeiten und Monitoring-Workflows mit Anwendungscode verbinden möchten, finden Sie in der Dokumentation zum Python SDK von digna ein praktisches Beispiel dafür, wie Konfiguration Observability in der Praxis unterstützt.
Die Wahl des richtigen Konfigurationsformats hängt von drei Faktoren ab: was Ihre Anwendung erwartet, was Ihre Deployment-Pipeline bereits ausführt und wer die Datei in sechs Monaten pflegen wird. Entscheiden Sie nicht allein nach persönlicher Vorliebe. Wählen Sie das Format, das Ihre Toolchain zuverlässig unterstützt.

Das Format auf den Workflow abstimmen
YAML ist aus gutem Grund beliebt. Es kommt in Kubernetes-Manifesten, Docker-Compose-Setups und CI/CD-Pipeline-Definitionen vor, weil seine einrückungsbasierte Struktur leicht zu lesen ist. Allerdings kann ein einziges falsch gesetztes Leerzeichen die gesamte Datei unbrauchbar machen. Ein zusätzlicher Tabulator kann verhindern, dass ein Container startet. Einheitliche Editoreinstellungen und Linting sind daher unerlässlich.
JSON eignet sich gut, wenn Maschinen die Datei erzeugen. API-Verträge, serialisierte Payloads und automatisch generierte Einstellungen profitieren von seiner strikten Syntax. Der Nachteil: Die manuelle Bearbeitung einer großen JSON-Datei wird mühsam, und ein fehlendes Komma kann eine kryptische Parser-Fehlermeldung verursachen.
INI liegt am anderen Ende des Spektrums. Es verwendet flache Abschnitte mit einfachen Schlüssel-Wert-Paaren. Für ein kleines Desktop-Dienstprogramm oder ein schlankes Entwicklungstool ist diese Einfachheit eher ein Vorteil als eine Einschränkung.
TOML sorgt für Lesbarkeit, ohne auf Einrückung angewiesen zu sein. Abschnittsüberschriften, typisierte Werte und eine vorhersehbare Struktur machen es für moderne Tools attraktiv. Der Kompromiss liegt in der Verbreitung: Nicht jede Sprache oder Plattform bietet erstklassige TOML-Unterstützung.
Format | Am besten geeignet für | Wichtigster Aspekt |
|---|---|---|
YAML | Infrastruktur und Pipelines | Einrückungsfehler |
JSON | APIs und generierte Daten | Aufwendige Bearbeitung |
INI | Flache Anwendungseinstellungen | Begrenzte Verschachtelung |
TOML | Explizites, modernes Tooling | Weniger universelle Unterstützung |
Praxisregel: Wählen Sie das Format, das Ihr Parser, Ihre Deployment-Plattform und Ihr Wartungsteam bereits verstehen.
In Analytics-Umgebungen von Unternehmen sind YAML und JSON gängige Optionen. Sie verbinden Lesbarkeit für Menschen mit zuverlässiger Automatisierung. Beide Formate sind wertvolle Kompetenzen für Data- und Platform-Engineers. Wenn Ihre Pipelines zusätzlich spaltenorientierte Speicherformate verwenden, erfahren Sie mehr über Parquet-Dateien und ihre Struktur, bevor Sie diese Datensätze an Ihren Monitoring- oder Verarbeitungs-Stack anbinden.
Validieren Sie Ihre Konfiguration immer mit dem tatsächlichen Parser, bevor Sie sie in eine reale Umgebung übertragen. Eine Datei, die für Sie korrekt aussieht, kann dennoch fehlschlagen, wenn die Anwendung auf einen nicht unterstützten Sonderfall stößt.
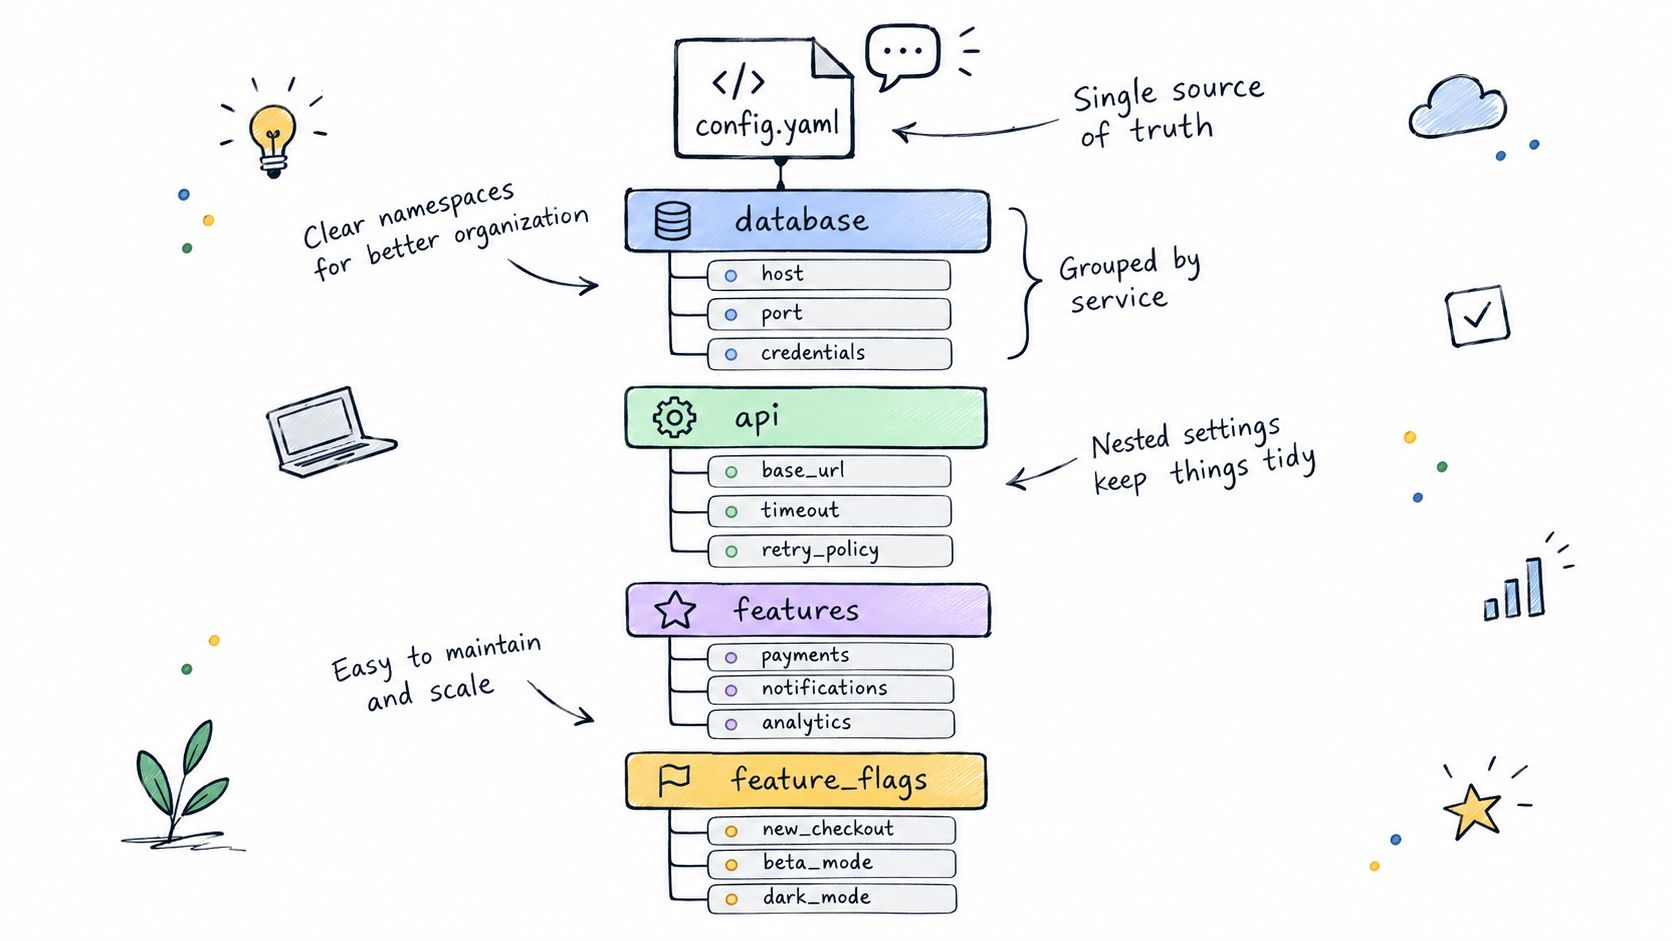
Jede zuverlässige Konfigurationsdatei beginnt mit einer ehrlichen Bestandsaufnahme. Nehmen Sie nur auf, was die Anwendung tatsächlich zum Laufen braucht – Datenbankreferenzen, Service-Endpunkte, Log-Level, Feature-Flags und ähnliche Einstellungen. Gruppieren Sie zusammengehörige Werte anschließend unter aussagekräftigen Namensräumen, anstatt sie über die gesamte Datei zu verstreuen.

Einstellungen nach Anwendungsbereichen gliedern
Angenommen, Sie konfigurieren einen Reporting-Service in YAML. Die Datei könnte so aussehen:
Wenn um 2 Uhr nachts ein Incident auftritt, zahlt sich diese Struktur aus. Wer Bereitschaft hat, findet die relevante Einstellung schnell, anstatt eine Wand aus Schlüsseln zu durchsuchen. JSON funktioniert ähnlich: Verschachteln Sie zusammengehörige Objekte und verwenden Sie durchgängig eine Einrückung von zwei Leerzeichen. INI ist anders, halten Sie das Design daher flach und setzen Sie auf klar benannte Abschnitte wie [database] und [logging].
Setzen Sie Kommentare gezielt ein. Fügen Sie sie hinzu, um einen ungewöhnlichen Timeout, einen temporären Feature-Schalter oder einen Wert zu erklären, der mit einem anderen System synchron bleiben muss. Ein Kommentar, der lediglich den Parameternamen wiederholt, erzeugt nur Rauschen. Leser brauchen die Begründung hinter einer Entscheidung, nicht ihr Echo.
Kernaussage: Eine Konfigurationsdatei sollte die betrieblichen Entscheidungen der Anwendung erklären, statt Leser zu zwingen, sie mühsam zu rekonstruieren.
Führen Sie vor dem Speichern der Datei drei kurze Prüfungen durch:
Verwenden Sie die erwartete Erweiterung – etwa
.yaml,.jsonoder.ini–, damit Tools die Datei erkennen.Halten Sie Namen einheitlich, indem Sie eine Konvention wie
timeout_secondswählen und sie überall verwenden.Trennen Sie Umgebungen, damit Entwicklung und Produktion unterschiedliche Werte verwenden können, ohne die Anwendungslogik zu ändern.
Wenn Ihre Einstellungen Datensätze oder Metadaten beschreiben, erfahren Sie mehr über Beschreibungen von Datenbankschemata, um die Terminologie Ihrer Konfiguration auf die Daten abzustimmen, die sie steuert.
Testen Sie die Datei sofort mit dem echten Parser der Anwendung. Eine Datei kann gültig aussehen und trotzdem einen nicht unterstützten Schlüssel, einen falschen Typ oder einen fehlenden Pflichtwert enthalten. Wenn Sie solche Probleme vor dem Deployment finden, bleiben Konfigurationsänderungen vorhersehbar und der Wiederherstellungsaufwand sinkt.
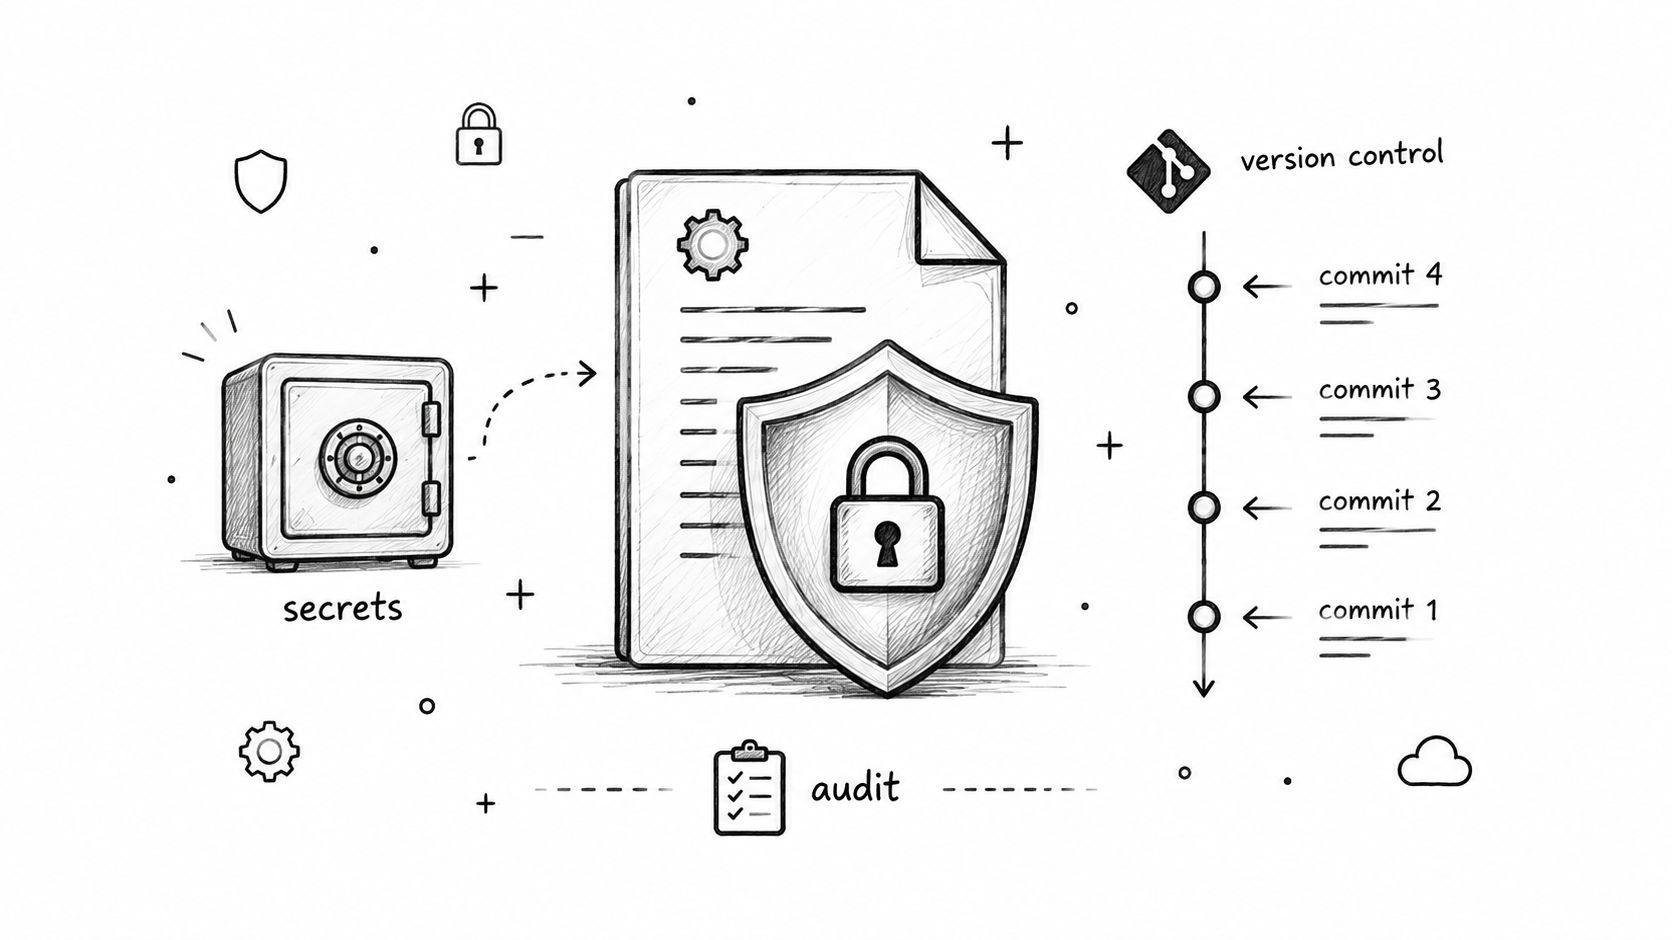
Die Verwaltung von Konfigurationen im großen Maßstab geht über die Wahl des richtigen Formats hinaus. Jede Konfigurationsdatei ohne Secrets sollte in Git liegen. Versionskontrolle gibt Teams Einblick in Änderungen, einen einfachen Rollback-Pfad und einen Audit-Trail für die Compliance.
Disziplin bei Commits ist wichtig. Kleine, fokussierte Commits mit Nachrichten wie Increase reporting timeout sind nützlicher als ein großer Commit mit miscellaneous fixes. Für Produktionsänderungen sollte ein Review per Pull Request verpflichtend sein. Wenn Sie ein Konfigurationsupdate über mehrere Services hinweg ausrollen, versehen Sie das Release mit einem Tag, damit Sie es später wiederfinden.
Secrets schützen und Änderungen validieren
Passwörter, Tokens, private Schlüssel und Verbindungszeichenfolgen gehören nicht in committete Dateien. Verweisen Sie stattdessen auf Umgebungsvariablen oder rufen Sie Secrets aus einem dedizierten Verwaltungssystem ab, das Zugriffskontrolle und Rotation bietet, ohne dass Änderungen am Anwendungscode nötig sind.
Kombinieren Sie vor dem Mergen einer Konfigurationsänderung automatisierte Prüfungen mit einem Review durch Menschen:
Parsen Sie die Datei mit derselben Bibliothek, die Ihre Anwendung verwendet, um Parsing-Probleme zur Laufzeit frühzeitig zu erkennen.
Validieren Sie das Schema, um fehlende Schlüssel, falsche Typen oder unerwartete Werte zu identifizieren.
Führen Sie einen Linter aus, um Formatierungsinkonsistenzen und Syntaxfehler zu erkennen.
Durchsuchen Sie Commits nach Secrets, bevor sie das gemeinsame Repository erreichen; Lecks aus der Historie zu entfernen ist wesentlich schwieriger, als sie zu verhindern.
Testen Sie Umgebungs-Overrides, damit Staging und Produktion die erwarteten Werte auflösen und nicht vergessene Standardwerte.
Kernaussage: Behandeln Sie Konfiguration wie Produktionscode und Secrets als eigene Sicherheitsgrenze.
Namenskonventionen verursachen bei mehr Teams Probleme als erwartet. Wählen Sie einen Stil – etwa timeout_seconds oder TIMEOUT_SECONDS – und verwenden Sie ihn konsequent über alle Services hinweg. Dokumentieren Sie erforderliche Variablen und halten Sie Umgebungs-Overrides vorhersehbar. Bewährt hat sich eine Basisdatei mit sinnvollen Standardwerten, bei der Staging- und Produktionsdateien nur die Werte überschreiben, die sich tatsächlich unterscheiden.
Zuverlässige Deployment-Kontrollen aufbauen
Richten Sie in der Pipeline ein Gate ein, das verhindert, dass ungültige Konfigurationen ins Deployment gelangen. Rollen Sie Änderungen bei kritischen Services schrittweise aus, überwachen Sie Start- und Health-Metriken genau und halten Sie einen getesteten Rollback-Pfad bereit.
Wenn Sie eine Erinnerung brauchen, warum das wichtig ist, lohnt sich die Lektüre von Cloudflares Postmortem zum Ausfall im November 2025. Es zeigt, warum generierte Konfigurationen eine eigene Validierung, Größenbeschränkungen, eine kontrollierte Verteilung und eine bewährte Wiederherstellungsversion benötigen.
Für Teams, die mit Kundendaten arbeiten, bietet digna einen Leitfaden zum Schutz von Kundendaten in Unternehmensumgebungen. Das Prinzip ist einfach: Halten Sie Konfigurationen überprüfbar, auditierbar und wiederherstellbar, während Ihre Services und Ihr Team wachsen.
Selbst eine gut strukturierte Konfiguration kann beim Parsen, Laden oder zur Laufzeit fehlschlagen. Entscheidend ist, festzustellen, ob Sie es mit einem Syntaxproblem oder einem echten Laufzeitfehler zu tun haben, und dann zuerst die passende Ebene zu testen.
Zuerst Parsing-Probleme finden
YAML scheitert häufig an inkonsistenter Einrückung, insbesondere wenn Tabulatoren und Leerzeichen in derselben Datei vorkommen. JSON scheitert typischerweise an fehlenden Anführungszeichen, einem überzähligen Komma vor einer schließenden geschweiften Klammer oder einer nicht geschlossenen Klammer.
Lassen Sie die Konfiguration durch genau den Parser laufen, den Ihre Anwendung verwendet. Integrieren Sie dann einen Linter oder Schema-Validator in Ihren Entwicklungsworkflow, damit diese Prüfungen automatisch erfolgen. Eine ungültige Struktur sollte lange vor dem Erreichen der Produktion erkannt werden.
Prüfen Sie Einrückung und Verschachtelung in YAML-Dateien.
Kontrollieren Sie Anführungszeichen, Kommas und Klammern in JSON.
Stellen Sie sicher, dass erforderliche Schlüssel und erwartete Werttypen vorhanden sind.
Achten Sie darauf, dass die Dateierweiterung dem entspricht, was Ihr Loader erwartet.
Kernaussage: Auch eine Datei, die in Ihrem Editor perfekt aussieht, braucht automatisiertes Parsen und Schema-Validierung, um vertrauenswürdig zu sein.
Laufzeitfehler untersuchen
Manchmal lässt sich eine Konfiguration fehlerfrei parsen, scheitert aber, wenn die Anwendung ihre Werte verwendet. Eine ungültige Portnummer, eine nicht unterstützte Option, eine fehlende Umgebungsvariable oder ein nicht erreichbarer Endpunkt kann den Start blockieren oder Fehler verursachen, die erst Stunden später auftreten.
Vergleichen Sie die fehlerhafte Datei zunächst mit einer bekannt funktionierenden Konfiguration und ändern Sie jeweils einen Wert, bis das Problem auftritt. Prüfen Sie anschließend die Anwendungslogs; die Fehlermeldung nennt oft den Schlüssel oder Wert, der den Fehler verursacht hat.
Prüfen Sie vor dem Übertragen in die Produktion Folgendes:
Referenzierte Services sind in der Zielumgebung verfügbar.
Overrides durch Umgebungsvariablen werden zu den erwarteten Werten aufgelöst.
Es sind keine Zugangsdaten oder Tokens im Klartext fest codiert.
Ressourcenlimits akzeptieren die konfigurierten Werte, ohne sie zu begrenzen.
Eine getestete frühere Version steht für einen Rollback bereit.
Cloudflares Bericht zum Ausfall vom 18. November 2025 unterstreicht, dass generierte Konfigurationen Größenbeschränkungen, eine kontrollierte Verteilung und eine bewährte Wiederherstellungsversion benötigen. Wer diese Details vor dem Rollout klärt, macht Deployments vorhersehbarer und schützt die Verfügbarkeit, wenn Probleme auftreten.
Konfigurationsdateien geben Datenqualitätstools einen klaren, konsistenten Betriebsplan. Definieren Sie beim Einrichten von digna Datenbank-Verbindungsreferenzen, Monitoring-Zeitpläne, Validierungsregeln und Alarmschwellen in einer eigenen Konfigurationsebene, anstatt sie über mehrere Skripte zu verteilen.
Ein Finanzteam könnte beispielsweise Transaktionstabellen prüfen, sobald neue Ladevorgänge eintreffen, ungewöhnliche Volumenänderungen markieren und verifizieren, dass regulatorische Datensätze termingerecht geliefert werden. Im Gesundheitswesen kann dieselbe Struktur die Validierung von Datensätzen, die Erkennung von Schemaänderungen und Alarme unterstützen, wenn die Lieferung klinischer Daten in Verzug gerät.
Eine praxistaugliche Konfiguration macht jede Monitoring-Entscheidung leicht auffindbar:
Verbindungseinstellungen verweisen auf die freigegebene Datenquelle, ohne Zugangsdaten preiszugeben.
Zeitpläne legen fest, wann Timeliness-Prüfungen und andere Monitoring-Jobs laufen sollen.
Schwellenwerte definieren, wann Drift, Verzögerungen oder Validierungsfehler Aufmerksamkeit erfordern.
Moduleinstellungen aktivieren oder deaktivieren Anomalieerkennung, Validierung, Timeliness oder Schema-Tracking.
Kernaussage: Ihre Konfiguration sollte beschreiben, was digna überwacht und wie es reagiert. Bewahren Sie Secrets in Umgebungsvariablen oder einem freigegebenen Secret-Manager auf, nicht in Konfigurationsdateien.
Monitoring-Einstellungen sicher und testbar halten
digna läuft in Ihrer eigenen Cloud, Ihrer VPC oder Ihrem Rechenzentrum und berechnet Metriken direkt in Ihren Datenbanken. So können Teams Daten dort belassen, wo sie sind, und gleichzeitig einheitliche Kontrollen über Warehouses, Lakes und Pipelines hinweg anwenden.
Trennen Sie Konfigurationsdateien nach Umgebung – Entwicklung, Staging und Produktion. Bevor Sie einen neuen Zeitplan oder eine neue Alarmschwelle ausrollen, testen Sie diese mit repräsentativen Daten und prüfen die daraus resultierenden Incidents. Versionieren Sie jede Änderung, damit Data Engineers nachvollziehen können, wer eine Regel geändert hat, und ohne Hektik auf eine bewährte Version zurückgehen können.
Einen genaueren Einblick, wie dies eine umfassendere Monitoring-Strategie unterstützt, erhalten Sie, wenn Sie die Integrationsmöglichkeiten von digna für Datenqualität erkunden. Dieser Ansatz hilft Teams im Finanzwesen, im Gesundheitswesen und in der Telekommunikation, Analytics- und KI-Systeme vertrauenswürdig zu halten, ohne Sicherheits- oder Audit-Anforderungen zu gefährden.
Format- und Sicherheitsfragen klären
Wenn Sie entscheiden, wie Sie eine Konfigurationsdatei erstellen, verwenden Sie JSON für strikte, maschinell erzeugte Einstellungen und YAML für gut lesbare Infrastrukturdateien. In der Praxis ist die beste Wahl meist das Format, das Ihr Parser und Ihre Deployment-Tools bereits unterstützen.
Um Secrets ohne Ausfallzeit zu rotieren, speichern Sie sie in einem Secret-Manager, veröffentlichen eine neue Version und lassen die Anwendungen die Zugangsdaten neu laden, bevor Sie die alten widerrufen.
Kernaussage: Committen Sie niemals Zugangsdaten. Falls sie offengelegt werden, widerrufen Sie das Secret sofort, entfernen es aus den aktiven Dateien und gehen davon aus, dass Ihre Git-Historie kompromittiert ist.
Validierung und Umgebungen vorhersehbar halten
Führen Sie Format-Parser, Schema-Prüfungen und Linter in CI/CD aus. Tools wie yamllint, JSON-Schema-Validatoren und plattformeigene Prüfungen können ungültige Änderungen blockieren, bevor sie die Produktion erreichen.
Dokumentieren Sie die Rangfolge klar: Kommandozeilenwerte überschreiben in der Regel Umgebungsvariablen, die wiederum die Standardwerte aus Dateien überschreiben. Erkennen Sie bei Microservices Drift, indem Sie aufgelöste Konfigurationen mit einer versionierten Baseline vergleichen.
Halten Sie stets eine bewährte Konfiguration für einen Rollback bereit. digna hilft Teams, das Verhalten von Daten und Schemaänderungen direkt in ihrer eigenen Umgebung zu überwachen.
Entdecken Sie digna auf digna.ai, um zuverlässige Datenprozesse zu unterstützen.
Häufig gestellte Fragen
Wofür wird eine Konfigurationsdatei verwendet?
Eine Konfigurationsdatei speichert Laufzeiteinstellungen außerhalb des Quellcodes, sodass berechtigte Teammitglieder sie ändern können, ohne die Codebasis anzufassen. Typische Inhalte sind Datenbank-Verbindungsdetails, Feature-Flags, Detailgrad und Ausgabeziel der Logs sowie Umgebungsbezeichnungen, die der App mitteilen, welches Profil sie beim Start laden soll.
Sollte ich YAML, JSON, INI oder TOML für eine Konfigurationsdatei verwenden?
Wählen Sie das Format, das Ihr Parser, Ihre Deployment-Plattform und Ihr Wartungsteam bereits verstehen. YAML eignet sich für Kubernetes-Manifeste und CI/CD-Pipelines, scheitert aber an einem falsch gesetzten Leerzeichen; JSON passt zu APIs und generierten Daten, INI verarbeitet flache Schlüssel-Wert-Einstellungen, und TOML bietet eine explizite Struktur bei weniger universeller Sprachunterstützung.
Wie validiere ich eine Konfigurationsdatei vor dem Deployment?
Lassen Sie sie durch genau den Parser laufen, den Ihre Anwendung verwendet, und ergänzen Sie in CI/CD eine Schema-Validierung sowie einen Linter wie yamllint oder einen JSON-Schema-Validator. Der Beitrag empfiehlt außerdem, Commits nach Secrets zu durchsuchen und Umgebungs-Overrides zu testen, damit Staging und Produktion die erwarteten Werte auflösen und nicht vergessene Standardwerte.
Gehören Passwörter und API-Schlüssel in eine Konfigurationsdatei?
Nein. Passwörter, Tokens, private Schlüssel und Verbindungszeichenfolgen gehören in Umgebungsvariablen oder einen dedizierten Secret-Manager, niemals in committete Dateien. Um ein Secret ohne Ausfallzeit zu rotieren, veröffentlichen Sie eine neue Version, lassen die Anwendungen sie neu laden und widerrufen dann die alte. Wenn ein Secret offengelegt wird, widerrufen Sie es sofort und betrachten die Git-Historie als kompromittiert.
Warum lässt sich meine Konfigurationsdatei parsen, die Anwendung schlägt aber trotzdem fehl?
Laufzeitfehler entstehen durch Werte, nicht durch Syntax: eine ungültige Portnummer, eine nicht unterstützte Option, eine fehlende Umgebungsvariable oder ein nicht erreichbarer Endpunkt. Vergleichen Sie die fehlerhafte Datei mit einer bekannt funktionierenden Konfiguration, ändern Sie jeweils einen Wert, bis der Fehler auftritt, und prüfen Sie die Anwendungslogs, die oft den verantwortlichen Schlüssel nennen.


