In-Database-Verarbeitung
|
7
min. Lesezeit

In-Database-Verarbeitung führt Analysen und Monitoring direkt in der Datenbank-Engine des Kunden aus, sodass die Daten an Ort und Stelle bleiben und der Übertragungsaufwand entfällt. Das ist vor allem dann wichtig, wenn Ihr Warehouse groß, sensibel oder beides ist, denn es geht nicht nur um Geschwindigkeit, sondern darum, ob die Prüfung dort stattfindet, wo die Daten bereits liegen.
Meist zeigt sich die Schwachstelle zuerst am Montagmorgen. Ein Dashboard ist veraltet, einem Finanzbericht fehlen Zeilen oder ein Aktualitätsalarm wird ausgelöst, nachdem Fachanwender das Problem bereits bemerkt haben – und die Ursache ist oft dieselbe: Die Daten mussten ein System verlassen, bevor sie in einem anderen analysiert werden konnten.
Inhaltsverzeichnis
Wie sich In-Database-Verarbeitung entwickelt hat und funktioniert
In-Database-Ausführung im Vergleich zu Extract-Analyze-Workflows
Branchenanwendungen, die In-Database-Zuverlässigkeit erfordern
Wenn Datenbewegungen Ihre Dashboards beeinträchtigen
Der Fehler beginnt meist ohne Vorwarnung. Ein Warehouse-Feed trifft pünktlich ein, der Extraktionsjob läuft, und die externe Engine erhält scheinbar eine saubere Kopie. Dann sorgt eine einzige vorgelagerte Verzögerung, eine fehlerhafte Spalte oder ein übergroßer Batch dafür, dass die Zahlen gerade so weit abweichen, dass das Dashboard nicht mehr den Erwartungen des Geschäfts entspricht.
Genau darin liegt der Kernvorteil der In-Database-Verarbeitung. Die Datenbank-Engine erledigt die Arbeit dort, wo die Daten bereits liegen, sodass Teams den Extraktionsschritt vermeiden, der Latenz erhöht, zusätzliche Kopien erzeugt und die Angriffsfläche vergrößert. Die historischen Argumente für dieses Modell sind seit Mitte der 1990er-Jahre konstant, doch eine breitere Verbreitung setzte erst Mitte der 2000er-Jahre ein, als sich die Analyse von externen Workstations in Enterprise Data Warehouses verlagerte und spaltenorientierte Datenbanken das Scannen und Aggregieren auf Warehouse-Seite praktikabel machten. Der historische Überblick über In-Database-Verarbeitung zeichnet diese Entwicklung klar nach.

Ein gutes Dashboard-Beispiel hilft, das Problem einzuordnen. Wenn die Kennzahl, die Sie beobachten, bereits aus Warehouse-Tabellen abgeleitet ist, schafft das Herausziehen dieser Tabellen in eine andere Engine – nur um Aktualität oder Schema-Drift zu prüfen – eine zweite Fehlerquelle. Für einen schnellen Überblick, wie Reporting-Oberflächen üblicherweise aufgebaut sind, können Sie GTM-Dashboard-Beispiele von Yalc durchsehen und vergleichen, wie operative Kennzahlen von sauberen, aktuellen Quelldaten abhängen.
Praxisregel: Wenn eine Prüfung fehlschlagen kann, weil die Daten bewegt werden mussten, leistet die Architektur bereits mehr Arbeit, als der Nutzer verlangt hat.
Deshalb betrachten moderne Observability-Plattformen zunehmend das Warehouse selbst als Ausführungsort. Eine separate Engine kann weiterhin nützlich sein, doch die Kosten für das Bewegen regulierter, volumenstarker Daten überwiegen oft den Komfort eines externen Workflows. Teams, die die Berechnung nah an den Daten halten, erreichen in der Regel eine bessere Governance-Kontrolle und vermeiden die unangenehme Lücke zwischen „die Quelle ist in Ordnung“ und „die Reporting-Kopie ist falsch“.
Wenn Sie bereits doppelte Tabellen, verzögerte Dashboards oder Abstimmungsarbeit sehen, die sich jeden Morgen wiederholt, liegt das Problem wahrscheinlich nicht in Ihrer Kennzahlendefinition. Es ist der zusätzliche Zwischenschritt.
Für ein verwandtes Fehlerbild lesen Sie, wie Datenredundanz Anomalien in Analyse- und Reporting-Systemen verursacht, denn doppelte Kopien erklären oft, warum ein Team den Zahlen vertraut und ein anderes nicht.
Wie sich In-Database-Verarbeitung entwickelt hat und funktioniert
Die Architektur entstand nicht auf einen Schlag. In-Database-Analysesysteme wurden Mitte der 1990er-Jahre kommerziell relevant und gewannen Mitte der 2000er-Jahre an Verbreitung, als Warehouse-Teams Analysen nicht länger als etwas betrachteten, das auf einer separaten Workstation stattfinden musste. Die Grundidee war einfach: die Daten an Ort und Stelle belassen, Bewegungen reduzieren und die statistische Arbeit dort ausführen, wo die Daten bereits lagen.
Ein häufig zitierter Meilenstein dieses Wandels war die Teradata-Partners-Konferenz in Orlando vom 18. bis 22. September 2005, auf der Thomas Tileston die Idee vorstellte, Data Mining durch die Kombination von SAS und Teradata innerhalb des Warehouse zu beschleunigen. Dieser Moment war bedeutsam, weil er eine Nischenoptimierung zu einem Unternehmensmuster machte. Spaltenorientierte Datenbanken, die für Analyse, Warehousing und Reporting entwickelt wurden, machten den Ansatz praktikabel, indem sie verbesserten, wie Systeme große Datensätze scannen und aggregieren.

Von der Warehouse-Beschleunigung zur datenbanknativen Analyse
Moderne Systeme führen Berechnungen heute direkt in der Datenbank-Engine aus, statt Daten in den Arbeitsspeicher zu extrahieren. Laut der Dokumentation von IBM vermeidet die Verarbeitung von Daten in der Datenbank Sicherheitsprobleme, die mit ihrer Extraktion verbunden sind, und das MADlib-Projekt beschreibt sich als SQL-basierte Bibliothek für Machine Learning, Data Mining und Statistik, die skalierbar innerhalb der Datenbank-Engine läuft – ohne Import in oder Export zu anderen Tools. Der architektonische Kern: Analyse wird zu einer Aufgabe der Datenbank, nicht eines Beiwagens.
Die analytischen In-Database-Funktionen von Teradata trieben dies hin zu einem umfassenden Bibliotheksmodell weiter, und eine zitierte Quelle nennt mehr als 200 analytische Funktionen in einer Shared-Nothing-Architektur, darunter Profiling, deskriptive Statistik und Sampling. Diese Breite ist der Grund, warum das Modell über die frühe Warehouse-Optimierung hinaus Bestand hatte und für governance-lastige Abläufe nützlich wurde.
Der praktische Kompromiss besteht weiterhin. Je mehr Logik die Datenbank übernimmt, desto stärker hängt die Performance von Query-Planung, Indizierung, Speicherlokalität und vektorisierter Ausführung ab. Eine gut abgestimmte Engine kann daraus eine Stärke machen, eine schlecht abgestimmte macht In-Database-Arbeit dagegen zum Engpass.
Die Geschichte ist wichtig, weil sie erklärt, warum dies nicht mehr experimentell ist. Teams übernehmen keinen cleveren Trick, sondern nutzen ein ausgereiftes Ausführungsmuster, das bereits von den Anforderungen im Warehouse-Maßstab geprägt wurde.
Wenn Sie moderne Speicher- und Ausführungsmuster vergleichen, ist Was ist ein Open Table Format eine nützliche ergänzende Lektüre, denn die Diskussion über offene Speicherformate überschneidet sich oft mit der Frage, wo Analysen laufen sollten.
In-Database-Ausführung im Vergleich zu Extract-Analyze-Workflows
Die entscheidende Frage ist, wo die Arbeit stattfinden sollte und was diese Wahl für Sicherheit, Latenz und operative Komplexität bedeutet.
Dimension | In-Database-Verarbeitung | Extract-Analyze-Workflow |
|---|---|---|
Datenbewegung | Die Berechnung bleibt dort, wo die Daten liegen, sodass Bewegungen minimiert werden | Daten werden vor der Analyse kopiert oder exportiert, was zusätzlichen Übertragungsaufwand verursacht |
Sicherheitslage | Daten können in der Kundenumgebung verbleiben, was bei regulierten Datensätzen hilft | Mehr Kopien und externe Übertragungen vergrößern die Angriffsfläche |
Performance-Profil | Hängt von Query-Planung, Indizierung, Speicherlokalität und Pushdown-Verhalten ab | Hängt von Übertragungsgeschwindigkeit, Staging und dem Rechenprofil der externen Engine ab |
Am besten geeignet für | Große, sensible oder latenzkritische Warehouse-Workloads | Leichtgewichtige Analysen, Ad-hoc-Exploration oder Systeme, die ohnehin Exporte vorsehen |
Betriebsrisiko | Kann die Produktion überlasten, wenn die Engine zu stark beansprucht wird | Kann von der Quelle abweichen und veraltete oder doppelte Wahrheiten erzeugen |
In-Database-Ausführung hält große oder sensible Datensätze im System of Record, sodass keine andere Engine sie über das Netzwerk lesen muss. Das ist in Unternehmensumgebungen wichtig, in denen das Quell-Warehouse bereits Anforderungen an Governance, Zugriffskontrolle und Audit erfüllt. Der Kompromiss ist nicht theoretisch. Die Datenbank-Engine hat nun mehr zu tun, sodass schlechte Ausführungspläne, schwache Indizierung oder hohe parallele Last Produktionsjobs und Observability-Prüfungen gleichzeitig verlangsamen können.
Die Leitlinien von IBM zu In-Database-Analysen stellen klar, dass das Belassen der Daten in der Datenbank Sicherheitsprobleme vermeidet, die mit ihrer Extraktion verbunden sind – deshalb findet sich dieses Modell häufig in regulierten Umgebungen. Für einen praktischen Vergleich der sichereren In-Database-Ausführung mit externen Pipelines lesen Sie den Vergleich zwischen In-Database-Ausführung und externen Pipelines.
Schema-Drift verschärft den Unterschied. Wie Redundanz Anomalien in Analyse- und Reporting-Systemen verursacht erklärt, warum zusätzliche Kopien oft widersprüchliche Versionen derselben Tatsache erzeugen. Wenn Observability, Qualitätsprüfungen oder Anomalieerkennung außerhalb des Warehouse laufen, verbringen Teams oft mehr Zeit mit dem Abgleich von Kopien als mit der Behebung des eigentlichen Problems.
Wo welcher Ansatz meist überlegen ist
In-Database ist überlegen, wenn die Daten zu sensibel sind, um bewegt zu werden, zu groß, um häufig kopiert zu werden, oder zu wichtig, um sie nicht zeitnah nach ihrem Eintreffen zu prüfen.
Extract-Analyze ist überlegen, wenn der Datensatz klein ist, die Logik experimentell ist oder das Warehouse keine zusätzliche Analyselast tragen soll.
Hybride Muster sind überlegen, wenn die Governance nah am Warehouse bleiben muss, explorative Arbeit aber eine separate Umgebung benötigt.
Benchmark-orientierte Forschung zu Warehouse-Workloads misst Antwortzeit, Durchsatz und Gesamtkosten. Echtzeit-Benchmarks testen, ob ein System eingehende Datenströme ohne Verzögerung verarbeiten kann. Das ist wichtig, weil sich Observability-Prüfungen wie latenzkritische Warehouse-Workloads verhalten und nicht wie Offline-Reporting-Jobs.
Wie digna Observability in Ihrem Warehouse ausführt
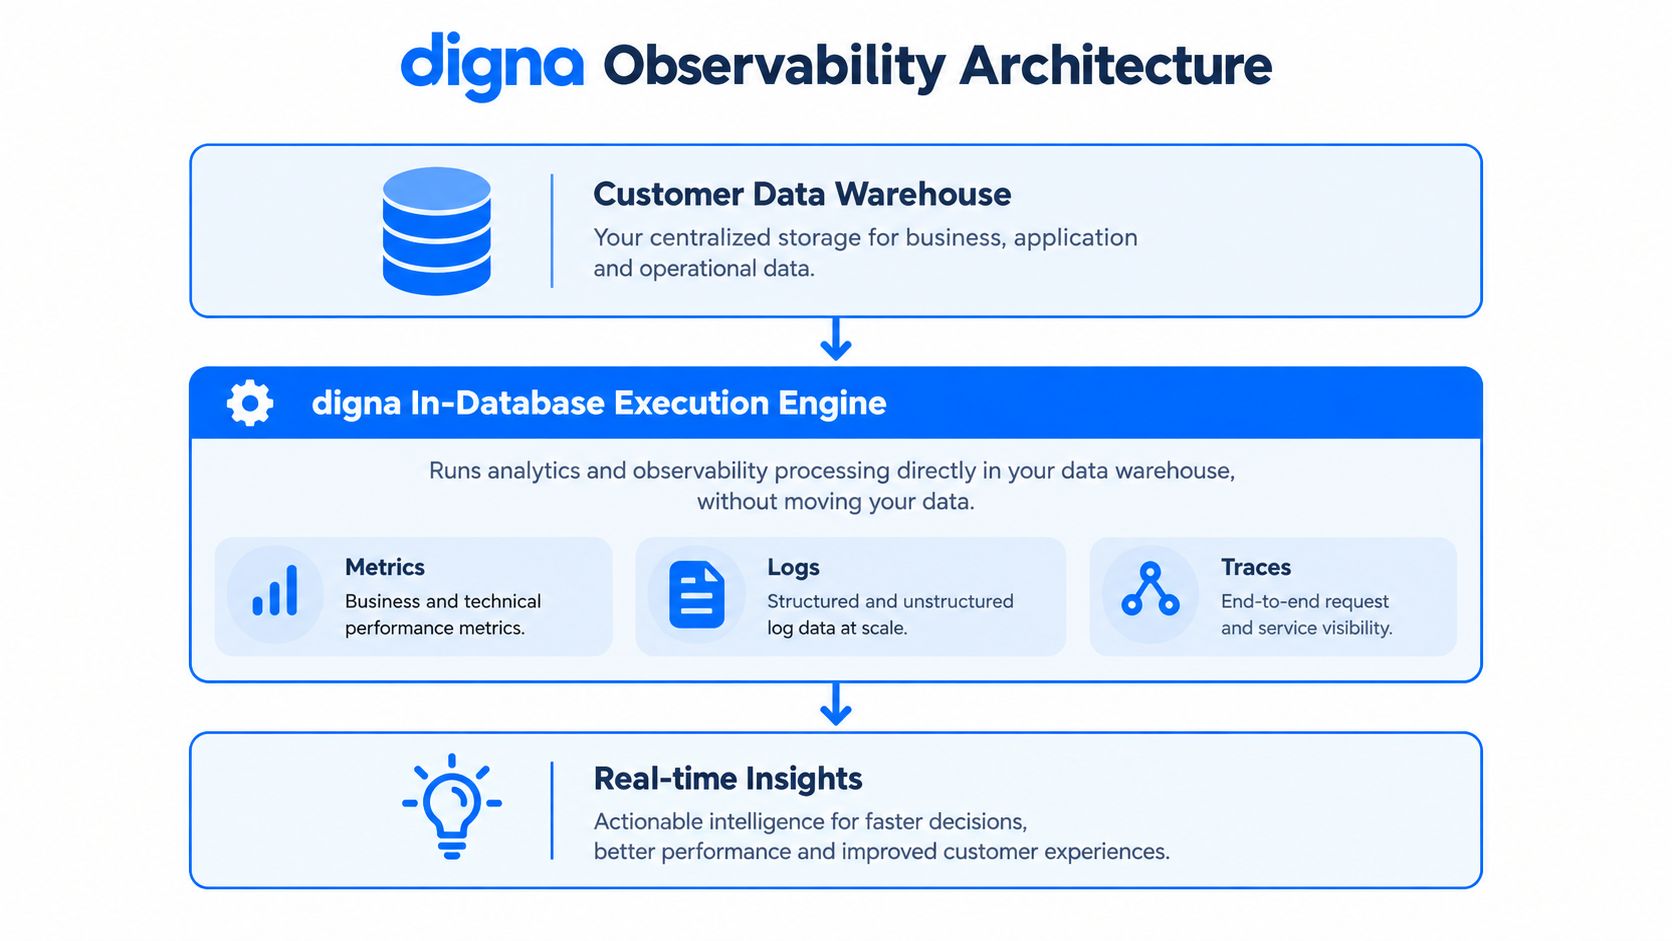
digna hält die Berechnung von Metriken in den eigenen Datenbanken des Kunden, sodass die Daten an Ort und Stelle bleiben, während die Plattform sie auswertet. Das ist die richtige Form für Teams, denen Governance an erster Stelle steht, denn die Observability-Ebene muss Produktionsdaten nicht erst an einen anderen Ort kopieren, bevor sie Aktualität, Schema oder Verhalten prüfen kann.
Das Betriebsmodell konzentriert sich auf fünf Dimensionen: Aktualität, Volumen, Schema, Verteilung und Lineage. Das sind die praktischen Mechanismen hinter der Überwachung des Datenverhaltens – nicht nur die Prüfung, ob eine einzelne Regel zu einem bestimmten Zeitpunkt erfüllt war. Ein Warehouse kann in einem Batch gesund wirken und in einem anderen dennoch abdriften, daher müssen die Prüfungen den Daten über die Zeit folgen.
Was im Warehouse passiert
Das Schema-Drift-Monitoring vergleicht das eingehende oder abgeleitete Schema mit einer erwarteten Baseline oder einem vertraglich festgelegten Schema und klassifiziert dann Hinzufügungen, Entfernungen, Umbenennungen und Datentypänderungen für eine schweregradbasierte Behandlung. Dieses Detail ist wichtig, weil eine fehlende Spalte und eine umbenannte Spalte in der Regel nicht dieselbe Reaktion erfordern. Ein strikter Alarm bei jeder Änderung erzeugt Rauschen, während gar kein Alarm nachgelagerte Systeme ungeschützt lässt.
Das Pünktlichkeits-Monitoring prüft, ob Daten planmäßig, zu früh oder zu spät eingetroffen sind, und die Anomalieerkennung lernt das Verhalten von Datensätzen, ohne dass für jeden Fall manuell Regeln eingerichtet werden müssen. Dieser Wandel von starren Regeln hin zum Lernen von Baselines macht das System im Unternehmensmaßstab praxistauglich, insbesondere wenn Feeds je nach Tag, Quelle oder Geschäftszyklus variieren.
Die In-Database-Ausführung der Plattform passt zudem gut zu einer typischen Frage in Unternehmen: Wie überwacht man Aktualität und Verstöße gegen Geschäftsregeln, ohne jeden Vorfall in ein manuell aufgebautes Wartungsprojekt zu verwandeln? Die Antwort lautet meist, das Warehouse die Berechnung übernehmen zu lassen und die Observability-Ebene das Muster interpretieren zu lassen.
Betriebsregel: Wenn ein Monitor ständige manuelle Feinabstimmung braucht, nur um ruhig zu bleiben, ist das keine Observability, sondern Alarmmüdigkeit mit zusätzlichen Schritten.
Die Dokumentation von digna beschreibt außerdem eine modulare Lizenzierung mit einer Grundgebühr plus einem Betrag pro aktiver Tabelle und Modul. Diese Struktur ist operativ relevant, weil Teams selten alle Funktionen vom ersten Tag an benötigen – sie beginnen meist mit einem Problem und erweitern, sobald sich das Muster bewährt hat.
Für Teams, die Implementierungsansätze vergleichen, sind die Prüfungen zur Entfernung von OpenDatabase ein nützliches ergänzendes Beispiel dafür, wie sich eine Inspektion auf Warehouse-Seite als kontrollierte Audit-Aktivität statt als externer Datenexport gestalten lässt.
Der praktische Gewinn ist einfach. Sie halten die Daten in der Kundenumgebung, berechnen Metriken dort, wo die Daten bereits liegen, und reduzieren die Zahl der Orte, an denen eine veraltete Kopie zur „Wahrheit“ werden kann.
Wann In-Database-Verarbeitung nicht die richtige Wahl ist
Auch das stärkste In-Database-Setup hat Grenzen. Wenn die Engine die Abfrage nicht gut planen, die Speicherlokalität nicht nutzen oder die Vorteile der vektorisierten Ausführung nicht ausschöpfen kann, wird Observability-Arbeit zur Last für die Produktion statt zu einer Schutzvorrichtung.
Die Fehlerbilder sind praktisch, nicht theoretisch
Kompatibilität ist das erste. Nicht jede Datenbank stellt dieselben analytischen Funktionen bereit, und nicht jede Umgebung erlaubt dasselbe Maß an Pushdown. Wenn die Plattform die erforderlichen Prüfungen nicht in der Engine ausführen kann, führen Teams Exporte meist durch die Hintertür wieder ein.
Konkurrierende Workloads sind das zweite. Ein Warehouse, das bereits BI und Ad-hoc-Analysen bedient, kann ausgebremst werden, wenn Observability-Jobs schlecht geplant oder zu aufwendig für die Inline-Ausführung sind. Query-Planung und Indizierung sind hier entscheidend, und „in der Datenbank belassen“ bedeutet nie „alles sofort ausführen“.
Überdimensionierung ist das dritte. Leichtgewichtige Analysen, kurzlebige Untersuchungen oder risikoarme Datensätze rechtfertigen oft nicht den Einrichtungsaufwand. In solchen Fällen kann ein einfacherer externer Workflow leichter zu betreuen und später leichter abzulösen sein, insbesondere wenn Teams bereits eine ETL-Datenpipeline haben, die die operative Last trägt.
Belassen Sie die Prüfungen nur dann bei den Daten, wenn die Engine die Arbeit bewältigen kann, ohne selbst zum Problem zu werden.
Der Kompromiss für Unternehmen ist klar. In-Database-Ausführung kann Bewegungen reduzieren und helfen, regulierte Daten in der Kundenumgebung zu halten, verlangt aber auch mehr vom Datenbank-Stack. Wenn das Team Abfrageform, Indexdesign oder Workload-Isolation nicht steuern kann, kann das Modell im großen Maßstab dennoch scheitern.
Die Entscheidung ist keine ideologische. Es kommt darauf an, ob das Warehouse die Monitoring-Last bewältigen kann, ohne neue Engpässe, neuen Abstimmungsaufwand oder neuen Kostendruck zu erzeugen. Wie bereits erwähnt, lassen sich manche Workloads besser im Warehouse abwickeln, während andere außerhalb davon sauberer laufen.
Branchenanwendungen, die In-Database-Zuverlässigkeit erfordern
Regulierte Branchen legen aus demselben Grund Wert auf dieses Muster: Sie können sich keine zweite, abdriftende Kopie der Wahrheit leisten. Teams in Finanzdienstleistung, Gesundheitswesen, Telekommunikation und öffentlichem Sektor arbeiten alle mit Daten, die sensibel, nachverfolgbar oder betrieblich zeitkritisch sind, daher muss die Prüfung ohne unnötige Bewegung erfolgen.
Finanzteams müssen Transaktions-, Risiko- und Regulierungsdaten in der Regel an Ort und Stelle prüfen. Exportiert der Monitoring-Prozess Daten in eine andere Umgebung, kann das mit Anforderungen an die Datenresidenz, Audit-Erwartungen oder internen Kontrollen kollidieren. Teams im Gesundheitswesen stehen unter einem anderen Druck: Verzögerte Ladevorgänge oder Schemaänderungen können das klinische und betriebliche Reporting verzerren, und das ist kein Problem, das man erst im Nachhinein entdecken möchte.
Telekommunikationsteams verarbeiten ständig volumenstarke Datenströme, daher muss die kontinuierliche Anomalieerkennung ohne einen schweren Export-Engpass laufen. Teams im öffentlichen Sektor benötigen Nachweise, dass die Kontrollen selbst auditierbar sind. Das macht In-Database-Ausführung attraktiv, weil der Monitoring-Nachweis nah an der regulierten Umgebung bleibt.
Die gemeinsame Einschränkung dieser Branchen
Der gemeinsame Nenner ist nicht die Branche, sondern die operative Beschaffenheit der Daten. Jede dieser Umgebungen braucht ein Monitoring, das schnell genug ist, um relevant zu sein, streng genug, um die Governance zu erfüllen, und abgegrenzt genug, um keine neuen Kopien zu erzeugen, die von der Quelle abweichen.
Deshalb ist die Abwägung zwischen Sicherheit und Komplexität wichtiger als die Definition. Wenn der Workload sensibel, volumenstark und eng mit Compliance verknüpft ist, wird In-Database-Ausführung oft eher zur praktischen Notwendigkeit als zur architektonischen Vorliebe. Ist der Workload beiläufig oder explorativ, kann derselbe Ansatz mehr Aufwand verursachen, als er wert ist.
Der aktuelle Trend in der Observability geht in dieselbe Richtung: Datenqualität und Observability werden als ein einziges datenbankzentriertes Analyseproblem statt als zwei getrennte Aufgaben behandelt. Das ist hilfreich, denn die Kernfrage in Unternehmen lautet selten „Können wir ein Problem erkennen?“, sondern vielmehr „Können wir es erkennen, ohne das System zu beschädigen, das wir schützen wollen?“
Die Entscheidung treffen: Passt In-Database zu Ihrem Stack?
Beginnen Sie bei den Daten, nicht beim Tool. Wenn der Datensatz zu sensibel ist, um die Umgebung zu verlassen, zu groß, um effizient bewegt zu werden, oder zu nah an der Quelle der Wahrheit, um Verzögerungen zu tolerieren, verdient die In-Database-Verarbeitung eine ernsthafte Prüfung.
Prüfen Sie dann den Workload. Echtzeit-Anomalieerkennung, Aktualitätsprüfungen, Schema-Drift-Monitoring und die Validierung von Geschäftsregeln profitieren alle davon, nah an der Datenquelle ausgeführt zu werden. Laufen dieselben Prüfungen nur gelegentlich oder sind sie eher explorativ als operativ, kann die Einfachheit einer externen Engine ausreichen.
Testen Sie als Nächstes die Engine selbst. Unterstützt sie die benötigten analytischen Funktionen? Kann sie Pushdown sauber ausführen? Kann sie Observability bewältigen, ohne Produktionsabfragen auszubremsen? Diese Fragen sind wichtiger als das Marketing-Etikett, denn eine Datenbank, die schlecht plant, bestraft Sie schneller als ein langsamer externer Job.
Eine kurze Entscheidungs-Checkliste
Wählen Sie In-Database-Verarbeitung, wenn die Daten reguliert sind, das Volumen hoch ist oder die Latenz eine Rolle spielt.
Bevorzugen Sie externe Analysen, wenn der Workload leichtgewichtig, vorübergehend oder noch im Wandel ist.
Validieren Sie das Verhalten der Engine vor dem Rollout, insbesondere Ausführungspläne, Indizierung und Workload-Isolation.
Behalten Sie bestehende BI-Tools bei, wo sie bereits funktionieren, denn In-Database-Ausführung erfordert nicht, den Rest des Stacks zu verwerfen.
Das größte Missverständnis ist, dass In-Database-Ausführung alles andere ersetzt. Das tut sie nicht. Sie verändert, wo die Prüfungen stattfinden, nicht aber, ob Analysten, Dashboards oder nachgelagerte Anwendungen weiterhin existieren. In der Praxis behalten die besten Bereitstellungen das Warehouse als Quelle der Wahrheit bei, nutzen die Datenbank-Engine für governance-intensive Prüfungen und vermeiden es, einen kompletten Analytics-Stack neu aufzubauen, nur um ein Aktualitätsproblem zu lösen.
Wenn Ihr aktuelles Setup mehr Zeit mit dem Kopieren als mit dem Prüfen von Daten verbringt, arbeitet die Architektur wahrscheinlich gegen Sie. Wenn Sie eine Plattform suchen, die Qualität und Observability in der Umgebung des Kunden berechnet, die Daten an Ort und Stelle belässt und modulares Monitoring für Anomalien, Pünktlichkeit, Validierung, Schemaänderungen und Geschäftskennzahlen unterstützt, besuchen Sie digna und sehen Sie, wie das In-Database-Modell zu Ihrem Warehouse und Ihren Governance-Anforderungen passt.
Da die Kompatibilität der Engine darüber entscheidet, ob Prüfungen in der Datenbank bleiben können, sollten Sie als Erstes die Liste der Datenbanken und Warehouses, mit denen digna integriert ist, für Ihren Stack prüfen.
Häufig gestellte Fragen
Was ist In-Database-Verarbeitung?
In-Database-Verarbeitung führt Analysen und Monitoring direkt in der Datenbank-Engine aus, sodass die Daten an Ort und Stelle bleiben, statt in ein externes Tool extrahiert zu werden. Das beseitigt Übertragungsaufwand, vermeidet zusätzliche Kopien und hält die Angriffsfläche kleiner – was vor allem dann zählt, wenn ein Warehouse groß, sensibel oder beides ist.
Wann hat sich In-Database-Verarbeitung durchgesetzt?
In-Database-Analysen wurden Mitte der 1990er-Jahre kommerziell relevant und fanden Mitte der 2000er-Jahre breite Verbreitung. Ein häufig zitierter Meilenstein ist die Teradata-Partners-Konferenz im September 2005, auf der die Kombination von SAS und Teradata innerhalb des Warehouse vorgestellt wurde, während spaltenorientierte Datenbanken das Scannen und Aggregieren auf Warehouse-Seite praktikabel machten.
Was ist der Unterschied zwischen In-Database-Verarbeitung und Extract-Analyze-Workflows?
In-Database-Verarbeitung rechnet dort, wo die Daten liegen, während Extract-Analyze-Workflows die Daten zunächst in eine andere Engine kopieren oder exportieren. Ersteres eignet sich für große, sensible oder latenzkritische Workloads, kann aber die Produktion überlasten; Letzteres eignet sich für leichtgewichtige oder Ad-hoc-Analysen, kann aber von der Quelle abweichen und doppelte Wahrheiten erzeugen.
Wann ist In-Database-Verarbeitung nicht die richtige Wahl?
Der Artikel nennt drei Situationen, in denen sie an Grenzen stößt: Kompatibilitätslücken, wenn der Datenbank die benötigten analytischen Funktionen oder Pushdown fehlen, konkurrierende Workloads, wenn Observability-Jobs BI-Abfragen ausbremsen, und Überdimensionierung, wenn leichtgewichtige, kurzlebige oder risikoarme Analysen den Einrichtungsaufwand innerhalb der Engine nicht rechtfertigen.
Wie nutzt digna In-Database-Verarbeitung für Data Observability?
digna hält die Berechnung von Metriken in den eigenen Datenbanken des Kunden und überwacht dort Aktualität, Volumen, Schema, Verteilung und Lineage. Die Schema-Drift-Prüfungen vergleichen die eingehende Struktur mit einer erwarteten Baseline und klassifizieren Hinzufügungen, Entfernungen, Umbenennungen und Typänderungen nach Schweregrad, während die Anomalieerkennung das Verhalten von Datensätzen ohne manuelle Regeln lernt.


