Data Governance Reifegradmodell: Stufen, Bewertung, Roadmap
|
7
min. Lesezeit
Die meisten Ratschläge zum Reifegradmodell für Data Governance beginnen am falschen Ende. Sie raten Führungskräften, ein Framework zu wählen, Richtlinien zu veröffentlichen, ein Gremium zu bilden und einen Katalog zu kaufen. Diese Reihenfolge erzeugt Papierkram, aber keine Reife.
Die meisten Unternehmen stufen sich selbst auf Stufe 3 oder Stufe 4 ein, weil sie über Richtlinien, Dashboards und ernannte Ausschüsse verfügen. Nachweislich befinden sie sich jedoch oft auf Stufe 1 oder Stufe 2. Eine Richtlinie, die niemand durchsetzt, ein Dashboard, das niemand überprüft, und ein Datenverantwortlicher, der keine Entscheidungen treffen kann, sind Anzeichen von Absicht, nicht von Fähigkeit.
Ein nützliches Reifegradmodell muss eine schwierigere Frage beantworten: Was tut die Organisation, wenn Daten fehlerhaft sind, sich ändern, sensibel werden oder in ein KI-System einfließen? Die Antwort sollte in den Eigentumsnachweisen, Qualitätskontrollen, der Datenherkunft (Lineage), den Zugriffsentcheidungen, den Workflows zur Problembehebung und der Berichterstattung an die Führungsebene sichtbar sein. Dieser Artikel behandelt den Reifegrad als operationales Bewertungssystem und nicht als Rundgang durch ein Framework.
Inhaltsverzeichnis
Warum die meisten Unternehmen ihren Governance-Reifegrad überschätzen
IBM, Gartner, CMMI DMM und Cloud-Reifegradmodelle im Vergleich
Kernbereiche, die Ihre tatsächliche Reifegradbewertung bestimmen
Verknüpfung der Reifegradbewertung mit KI-Bereitschaft und Geschäftswert
Eine praktische 90-Tage-Roadmap zur Steigerung des Governance-Reifegrads
Warum die meisten Unternehmen ihren Governance-Reifegrad überschätzen
Der häufigste Governance-Fehler besteht darin, Dokumentation mit Kontrolle zu verwechseln. Ein Unternehmen kann eine Datenrichtlinie, ein Glossar, einen Lenkungsausschuss und ein Abonnement für einen Datenkatalog haben und sich dennoch bei der Identifizierung und Behebung von Datenproblemen auf den persönlichen Einsatz Einzelner verlassen. Diese Organisation mag in einer Präsentation reif wirken, ihr operatives Verhalten bleibt jedoch reaktiv.
Die historische Entwicklung stufenweiser Governance-Modelle erklärt, warum diese Verwirrung fortbesteht. Das IBM Data Governance Council, ein Forum aus fast 55 Organisationen, das im November 2004 gegründet wurde, half dabei, die Diskussion über Enterprise Governance zu etablieren. IBM veröffentlichte sein Reifegradmodell im Oktober 2007, und Gartner führte sein Reifegradmodell für das Informationsmanagement im Unternehmen im Dezember 2008 ein. Der zeitliche Ablauf ist in dieser Geschichte des Data Governance-Reifegradmodells dokumentiert. Diese Modelle gaben Führungskräften eine Sprache für den Fortschritt an die Hand, aber viele Organisationen übernahmen die Bezeichnungen, ohne die dahinterstehenden Nachweise zu erbringen.
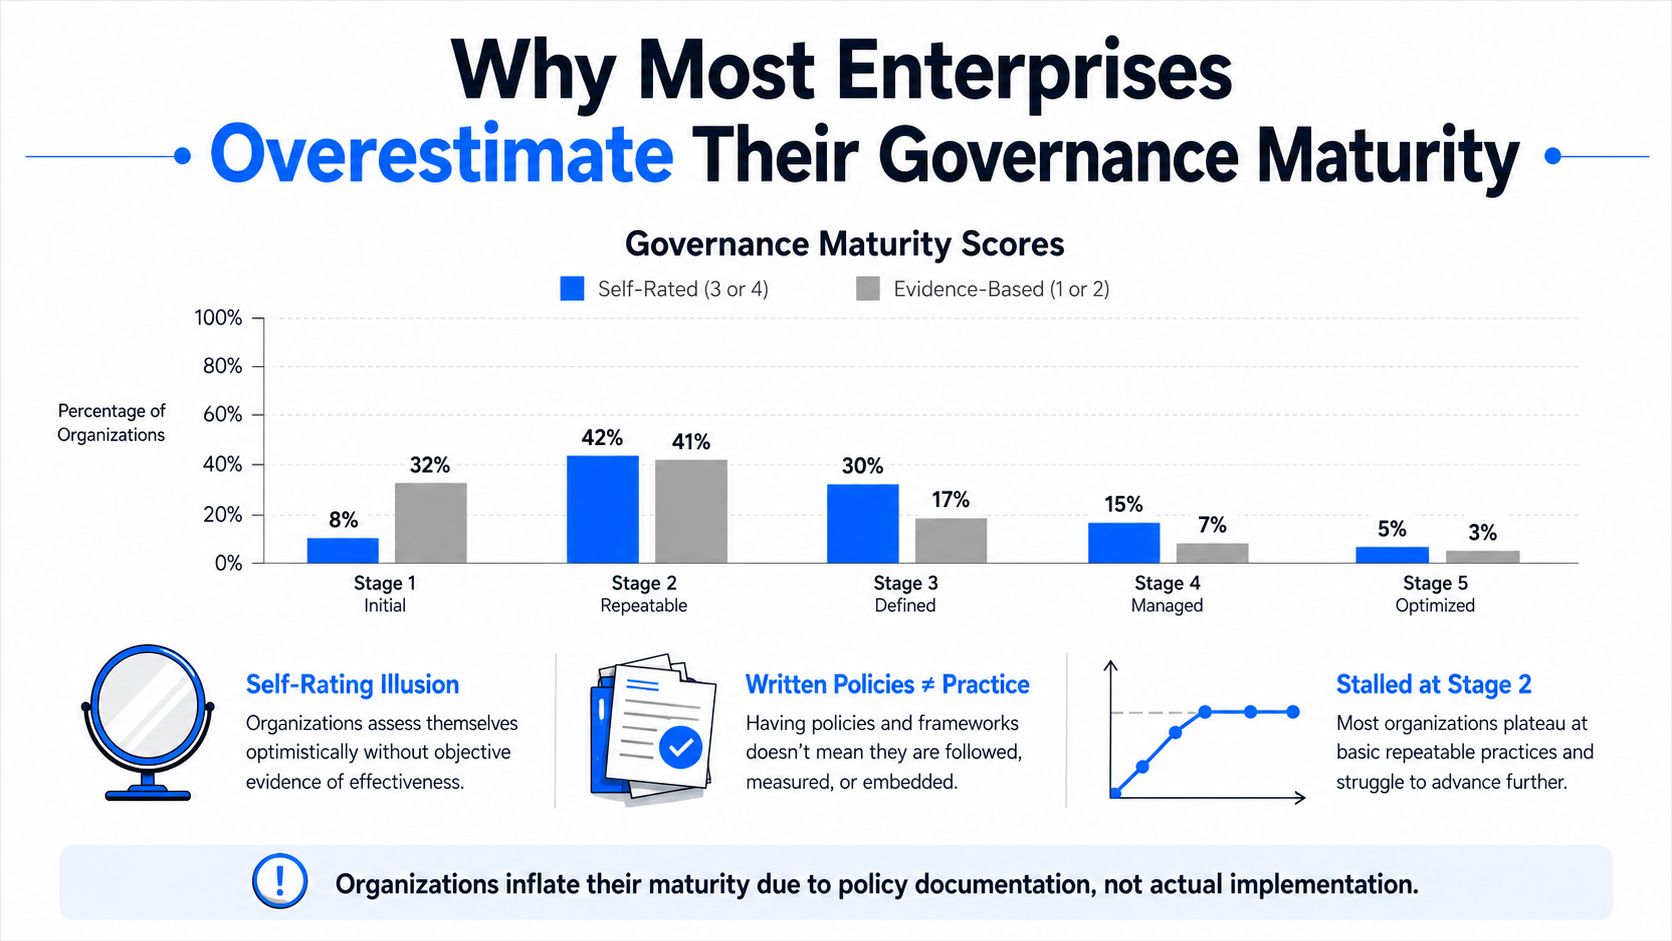
Die Illusion der Selbsteinschätzung
Eine Selbsteinschätzung fragt meist ab, ob ein Prozess existiert. Eine evidenzbasierte Überprüfung fragt hingegen, ob die Menschen ihn konsequent nutzen, ob Kontrollen ohne manuelles Eingreifen funktionieren und ob Führungskräfte auf die resultierenden Signale reagieren.
Achten Sie auf diese Warnsignale:
Richtlinien ohne Durchsetzung: Standards existieren, aber Datenpipelines können Daten veröffentlichen, die gegen diese Standards verstoßen, ohne dass eine blockierende Kontrolle oder eine dokumentierte Ausnahme greift.
Dashboards ohne Entscheidungen: Teams erstellen Qualitätsberichte, aber keine Führungskraft überprüft die Trends oder stellt Budget für die Behebung bereit.
Ausschüsse ohne Befugnisse: Eine vierteljährliche Arbeitsgruppe für Datenverwaltung diskutiert Definitionen, kann aber keine Aufgaben zuweisen, Konflikte lösen oder Ausnahmen genehmigen.
Kataloge ohne Akzeptanz: Technische Metadaten sind geladen, aber Business-Anwender fragen immer noch Kollegen, woher die Daten stammen und ob sie ihnen vertrauen können.
Praktische Regel: Bewerten Sie das Verhalten, das ein Prüfer verifizieren kann, und nicht die Fähigkeiten, die ein Programmverantwortlicher beschreiben kann.
Der richtige Ausgangspunkt ist daher eine Diagnose. Überprüfen Sie eine repräsentative Auswahl kritischer Datenbestände, verfolgen Sie Vorfälle von der Erkennung bis zum Abschluss, prüfen Sie Zugriffsentscheidungen und bitten Sie die Verantwortlichen, zu demonstrieren, wie Definitionen und Qualitätsschwellenwerte in die tägliche Arbeit einfließen. Wenn die Nachweise bei einem Richtliniendokument aufhören, bewerten Sie die Kontrolle als unreif.
Was ein Data Governance-Reifegradmodell tatsächlich misst
Ein Data Governance-Reifegradmodell ist kein Regelwerk. Es ist ein operationales Bewertungssystem dafür, wie zuverlässig eine Organisation Daten im täglichen Betrieb, bei Vorfällen, bei Änderungen und bei der Skalierung verwaltet. Die Bewertung sollte zeigen, ob Menschen, Prozesse, Metriken und Technologien Daten erzeugen, die Benutzer verstehen, auf die sie angemessen zugreifen und denen sie vertrauen können.
Fähigkeitsbasiertes Management begründete die Logik hinter der schrittweisen Einführung definierter Praktiken. Modelle im CMM-Stil wenden diese Logik auf organisatorische Fähigkeiten an, während ITIL reproduzierbares Serviceverhalten bewertet. Ein Governance-Reifegradmodell überträgt diesen Ansatz auf Daten und bietet Führungskräften eine vergleichbare Ausgangsbasis, deckt Investitionslücken auf und setzt Prioritäten über Geschäftsbereiche hinweg.
Reifegrad ist nicht gleich Compliance
Compliance prüft, ob eine geforderte Bedingung erfüllt ist. Der Reifegrad misst, ob die Organisation diese Bedingung über verschiedene Datenbestände, Teams und sich ändernde Umstände hinweg konsistent erfüllen kann. Ein Unternehmen kann ein Audit mit einer genehmigten Aufbewahrungsrichtlinie bestehen, obwohl ihm die Datenherkunft, die Verantwortlichkeiten und die Überwachung fehlen, um zu beweisen, dass die Systeme diese im täglichen Betrieb tatsächlich befolgen.
Der Reifegrad unterscheidet sich auch von einem beschreibenden Wissensbestand wie DAMA-DMBOK. DAMA-DMBOK definiert die Managementbereiche, die eine Organisation adressieren sollte. Ein Reifegradmodell bewertet, wie diese Bereiche funktionieren – von informellen Aktivitäten bis hin zu messbarer Kontrolle und kontinuierlicher Verbesserung. Es sollte auch Governance von der Frage unterscheiden, wie sich Datenqualität und Data Governance unterscheiden, da reine Qualitätsergebnisse nicht beweisen, dass Verantwortlichkeiten, Richtlinien, Zugriffe oder Entscheidungsrechte funktionieren.
Beurteilung nachweisbarer Belege
Bewertungen sollten Artefakte und operatives Verhalten beurteilen, einschließlich:
namentlich genannte Eigentümer und Verantwortliche für kritische Datenprodukte
Richtlinienkontrollen, die Verstöße blockieren, mit dokumentierten Ausnahmen
Qualitätsregeln, die mit den Produktionspipelines verknüpft sind
Problemwarteschlangen mit verantwortlichen Eigentümern und nachverfolgter Behebung
Datenherkunft (Lineage), die Auswirkungsanalysen unterstützt
Zugriffsentscheidungen, die an Rollen, Zwecke und Sensibilität gebunden sind
wiederkehrende Scorecards, die Governance-Entscheidungen auslösen
Die Bezeichnungen variieren je nach Framework. Der Test bleibt derselbe. Eine höhere Bewertung erfordert Wiederholbarkeit, Messung und institutionelle Akzeptanz. Die manuelle Behebung eines einzelnen wiederkehrenden Fehlers zeigt Engagement, kein reifes Qualitätsmanagement. Automatische Erkennung, Weiterleitung an den Eigentümer, Messung der Behebung und vorbeugende Maßnahmen zeigen eine funktionierende Kontrolle.
Bewerten Sie die Lücke bei der Ausführung direkt. Wenn Standards nur in Dokumenten existieren, während die Bereitstellungsteams sie umgehen, bleibt das Unternehmen operativ unreif – unabhängig davon, wie vollständig seine Governance-Bibliothek erscheint. Diese evidenzbasierte Bewertung ist die nützliche Grundlage für Investitionsentscheidungen und die Planung der KI-Bereitschaft.
Die fünf Stufen des Data Governance-Reifegrads erklärt
Ein fünfstufiges Modell ist nur dann nützlich, wenn jede Stufe mit Belegen hinterlegt ist. Die typische Entwicklung verläuft von Initial bzw. Ad-hoc über Entwickelt bzw. Wiederholbar, Definiert bzw. Standardisiert und Gesteuert bzw. Quantitativ bis hin zu Optimiert. Dieses Muster wird in der stufenweisen Ansicht des Data Governance-Reifegrads beschrieben.
Fähigkeitssignale nach Stufen
Stufe | Definierendes Verhalten | Beobachtbare Belege | Typisches Fehlermuster |
|---|---|---|---|
Stufe 1, Ad-hoc | Teams verwalten Daten lokal und reagieren auf Vorfälle | Keine konsistenten Verantwortlichkeiten, undokumentierte Qualitätsregeln, manuelle Untersuchungen, inkonsistente Definitionen | Brandbekämpfung wird mit Governance verwechselt |
Stufe 2, Reaktiv | Ein formelles Programm existiert, aber Kontrollen greifen erst, wenn Probleme auftreten | Benanntes Programm, grundlegende Standards, Netzwerk von Datenverantwortlichen, Vorfalltickets, wiederkehrende Eskalationen | Die Organisation dokumentiert Entscheidungen, verhindert aber keine wiederholten Fehler |
Stufe 3, Definiert | Governance-Praktiken werden im gesamten Unternehmen angewendet | Unternehmensweite Richtlinie, gemessene Service-Erwartungen, geschäftliche Definitionen, proaktives Metadatenmanagement, regelmäßige Berichterstattung | Standards existieren, aber die Umsetzung variiert je nach Bereich |
Stufe 4, Gesteuert | Governance wird gemessen und ist in die Bereitstellung integriert | Automatisierte Kontrollen, auf der Datenherkunft basierende Auswirkungsanalyse, quantifizierte Qualitätsindikatoren, kontrollierte Ausnahmen, Ergebnisberichterstattung | Teams optimieren einzelne Kennzahlen, ohne sie mit den Geschäftsergebnissen zu verknüpfen |
Stufe 5, Optimiert | Governance verbessert sich kontinuierlich durch Feedback und Automatisierung | Governance-as-Code, KI-gestützte Überwachung, kontinuierliche Anpassung, Closed-Loop-Behebung, Führungsentscheidungen basierend auf Trends | Die Optimierung verliert den Bezug zu den tatsächlichen Benutzerbedürfnissen |
Eine Organisation auf Stufe 1 kann Datenprobleme in der Regel erst erkennen, wenn ein Bericht, ein Modell oder ein operativer Prozess fehlschlägt. Eine Organisation auf Stufe 2 verfügt über ein Programm und ein Reaktionsnetzwerk, aber dieses Netzwerk hängt immer noch davon ab, dass Mitarbeiter Vorfälle bemerken und eskalieren. Aus diesem Grund verharren viele Unternehmen trotz sichtbarer Governance-Aktivitäten auf Stufe 2.
Auf Stufe 3 hat sich die Organisation von isolierten Projekten gelöst. Definitionen, Richtlinien und Service-Erwartungen gelten bereichsübergreifend, und die Teams können zeigen, wie Governance in die Bereitstellungs-Workflows einfließt. Der entscheidende Test ist hierbei Konsistenz, nicht Ambition.
Stufe 4 erfordert Automatisierung und Quantifizierung. Prüfer sollten Kontrollen in den Pipelines sehen, eine Datenherkunft, die die Änderungsanalyse unterstützt, und Qualitätsergebnisse, die mit geschäftlichen Auswirkungen verknüpft sind. Stufe 5 fügt eine kontinuierliche Verbesserung hinzu. Die Organisation passt Kontrollen anhand von Trends an, integriert Governance in die Entwicklungspraktiken und betrachtet die Überwachung als lebendige operative Fähigkeit statt als periodische Bewertung.
Eine Stufenbezeichnung ist nur dann glaubwürdig, wenn ein unabhängiger Prüfer die Bewertung anhand operativer Belege reproduzieren kann.
IBM, Gartner, CMMI DMM und Cloud-Reifegradmodelle im Vergleich
Die Auswahl des Frameworks ist weniger wichtig als die Disziplin bei der Bewertung. Das historische Modell von IBM definierte eine unternehmensweite Basis für Governance-Fähigkeiten, während der Ansatz von Gartner Dimensionen betont, die Information Governance mit Geschäftswert, Lebenszyklusmanagement, Rollen, Kennzahlen und Infrastruktur verknüpfen. Das Modell von Gartner bewertet sieben Dimensionen, darunter Vision, Strategie, Metriken, Information Governance, Organisation und Rollen, Informationslebenszyklus sowie Infrastruktur-Enablement, und erreicht einen optimierten Zustand, in dem Governance im Informationslebenszyklus verankert und automatisiert ist, wie in dieser Übersicht zum Gartner-Reifegradmodell zusammengefasst.
Das Data Management Maturity (DMM)-Modell von CMMI ist strukturell detaillierter. Es umfasst laut dieser Zusammenfassung des CMMI DMM-Frameworks fünf Reifegradstufen in 25 Prozessbereichen, die in sechs Kategorien organisiert sind. Bewertungen von Cloud-Anbietern wie Microsoft Purview, Collibra, Informatica und Atlan verpacken ähnliche Konzepte oft in produktorientierte Fragebögen und Kontrollinventare. Die Anleitung von Microsoft stellt einen vierstufigen Pfad von Ungesteuert bis Vollständig gesteuert dar, mit Kriterien wie Sponsoring durch die Geschäftsführung, definierten Verantwortlichkeiten und einem Governance-Kontrollgremium, wie in der Diskussion der National Academies zur Reifegradbewertung festgehalten.
Framework | Stufenbezeichnungen (Höchste Stufe) | Primär bewertete Dimensionen | Bewertungsstil |
|---|---|---|---|
IBM Data Governance Council | Initial bis Optimierend | Verantwortung (Stewardship), Richtlinieninfrastruktur, Risiko, Wert und organisatorische Leistungsfähigkeit | Fortschritt der unternehmensweiten Fähigkeiten |
Gartner | Bewusst oder Reaktiv bis Optimiert | Vision, Strategie, Metriken, Rollen, Lebenszyklus, Governance und Infrastruktur | Dimensionsbasierter Fortschritt im Hinblick auf das Informationsmanagement |
CMMI DMM | Strukturierte Reifegradstufen bis hin zu optimierten Fähigkeiten | Prozessbereiche, Institutionalisierung und Managementdisziplin | Detaillierte Prozessbelege über Kategorien hinweg |
Modelle von Cloud-Anbietern | Ungesteuert bis Vollständig gesteuert (oder äquivalente Bezeichnungen) | Katalogisierung, Datenherkunft, Richtlinien, Zugriff, Qualität und Plattformkontrollen | Produktbasierte Bewertung, verknüpft mit der Implementierungsfähigkeit |
Die Bezeichnungen stimmen nicht perfekt überein. Ein Unternehmen schneidet bei einem Modell, das dokumentierte Richtlinien belohnt, möglicherweise besser ab und bei einem Modell, das die Institutionalisierung von Prozessen oder automatisierte Nachweise verlangt, schlechter. Betrachten Sie jede Bewertung eines Anbieters als Ausgangspunkt, nicht als Endurteil.
Kernbereiche, die Ihre tatsächliche Reifegradbewertung bestimmen
Eine zuverlässige Bewertung bewertet Fähigkeiten separat, anstatt eine einzige, geschönte Kennzahl für das gesamte Unternehmen zu vergeben. Die nützlichsten Dimensionen sind Verantwortlichkeit und Rechenschaftspflicht, Datenqualität und Observability, Metadaten und Datenherkunft (Lineage), Datenschutz und Zugriffsverwaltung sowie KI- und Modell-Governance – eine Struktur, die sich in diesem Leitfaden für moderne Reifegraddimensionen widerspiegelt.
Fünf Nachweistests
Verantwortlichkeit und Datenverwaltung stehen an erster Stelle. Stufe 2 sieht aus wie ein gemeinsames E-Mail-Postfach und ein Netzwerk von Datenverantwortlichen, das auf Vorfälle reagiert. Stufe 4 verfügt über namentlich genannte Eigentümer mit Entscheidungsrechten, dokumentierten Eskalationspfaden und der Rechenschaftspflicht für Ergebnisse auf Datenbestandsebene. Die Unterscheidung zwischen Eigentümern und Datenverantwortlichen ist wichtig, und der Leitfaden für Data Governance-Rollen bietet nützliche Begriffe, um Befugnisse von der operativen Verwaltung abzugrenzen.
Datenqualität und Fehlerbehebung sollten anhand des Kontrollverhaltens bewertet werden. Ein reaktives Team pflegt eine Fehlerwarteschlange und untersucht Mängel erst, wenn sich Benutzer beschweren. Ein gesteuertes Team verknüpft automatisierte Regeln mit Pipelines, weist Fehler Eigentümern zu, verfolgt die Behebung und berichtet, ob wiederkehrende Mängel abnehmen.
Metadaten und Datenherkunft (Lineage) müssen über die rein technische Erfassung hinausgehen. Ein Katalog der Stufe 2 enthält Schemata und Systemdetails, aber Benutzer benötigen immer noch persönliche Erklärungen. Eine stärkere Umgebung nutzt geschäftliche Definitionen, eine Datenherkunft, die Auswirkungsanalysen unterstützt, und Belege dafür, dass Teams den Katalog bei Bereitstellungs- und Änderungsentscheidungen tatsächlich nutzen.
Datenschutz und Zugriffskontrolle entwickeln sich von der rollenbasierten Rechteverwaltung hin zu zweckgebundenem Zugriff, Sensibilitätsklassifizierung, Überprüfung von Ausnahmen und nachvollziehbaren Genehmigungen. Ein Berechtigungsmodell allein beweist nicht, dass Zugriffe bei einer Änderung der Datennutzung angemessen bleiben.
KI- und Modell-Governance deckt Schwachstellen im Fundament schnell auf. Organisationen der Stufe 2 führen möglicherweise eine inoffizielle Liste von KI-Risiken. Umgebungen der Stufe 4 verknüpfen die Modellherkunft mit kontrollierten Daten, verlangen Freigabeprozesse, überwachen die Nutzung und bewahren Nachweise über Entscheidungen auf.
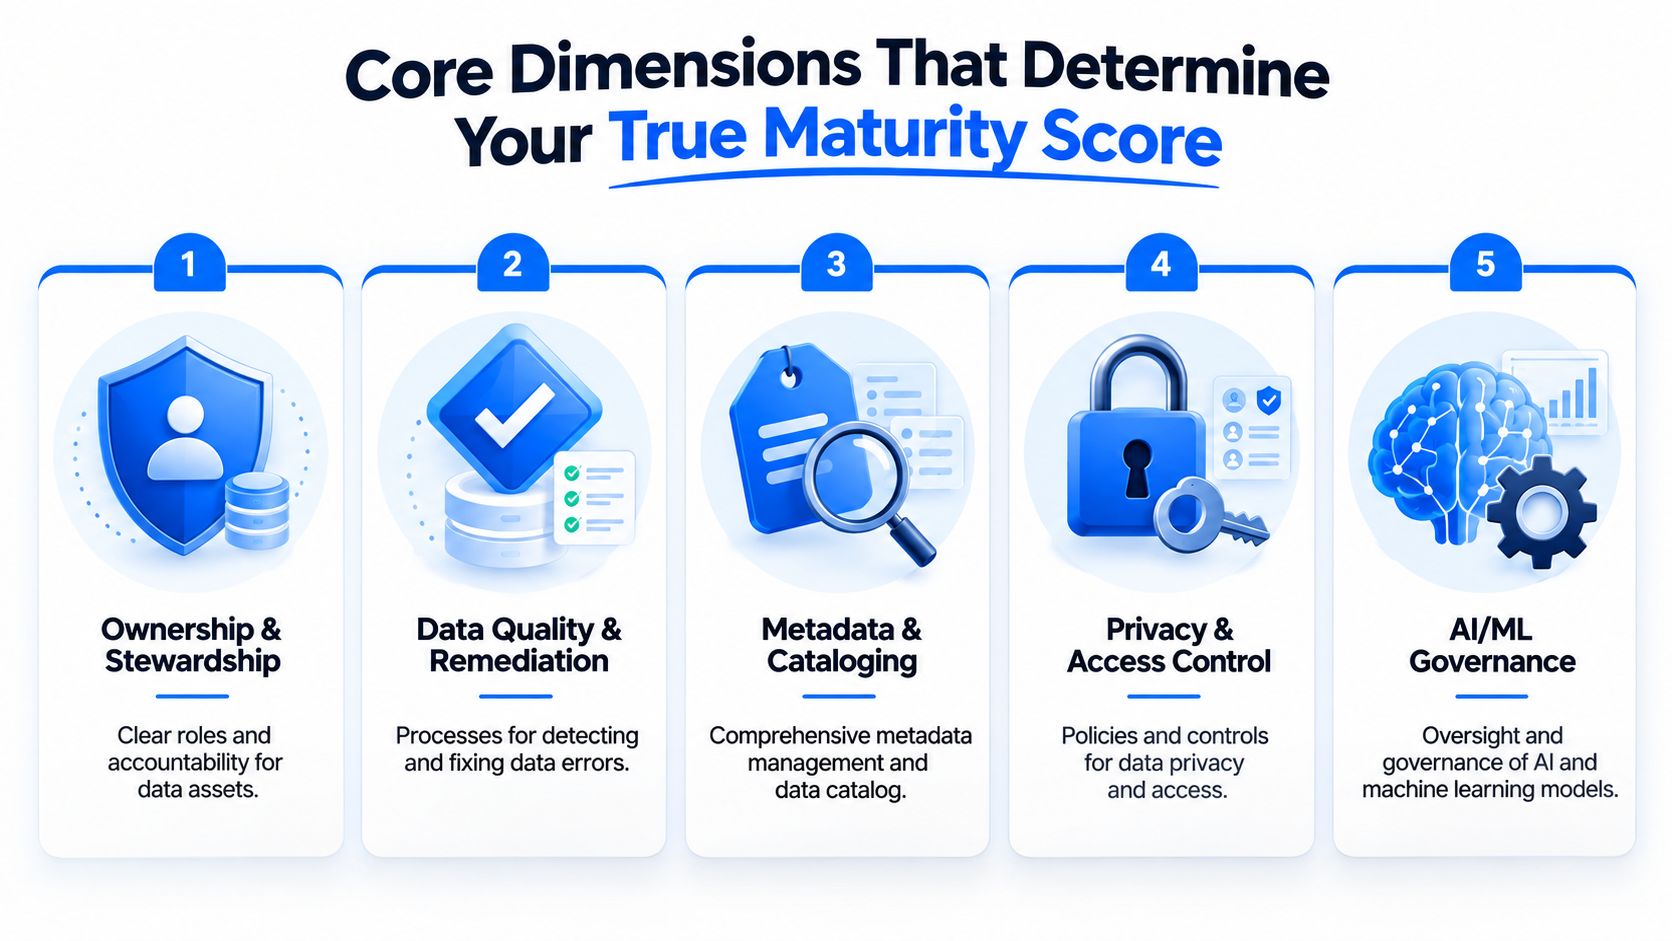
Bewerten Sie jede Dimension nach demselben Belegstandard. Gute Absichten, isolierte Tools und ein schön geschriebenes Framework bringen keine Punkte, solange sie nicht zu einem messbaren, wiederholbaren Verhalten führen.
Der schwierige Weg von reaktiv zu optimiert
Ein mittelgroßes Unternehmen kann über eine veröffentlichte Datenrichtlinie, eine Kataloglizenz und vierteljährliche Treffen zur Datenverwaltung verfügen und dennoch auf Stufe 2 operieren. Das Problem zeigt sich meist dann, wenn Entwickler eine neue Pipeline freigeben. Das Governance-Team kann zwar die erwarteten Definitionen und Qualitätsstandards beschreiben, hat aber keinen durchsetzbaren Data Contract mit dem Bereitstellungsteam. Der erste echte Test steht somit an, wenn ein nachgelagerter Bericht fehlerhaft ist.

Warum die Richtlinien- und Tool-Falle bestehen bleibt
Das Unternehmen erstellt mehr Dokumente, erweitert den Katalog und beraumt ein weiteres Gremientreffen an. Keine dieser Maßnahmen ändert etwas daran, wer für ein fehlerhaftes Datenprodukt verantwortlich ist oder was passiert, wenn ein Qualitätsschwellenwert überschritten wird.
Drei Fehlentscheidungen wiederholen sich ständig:
Governance über die Bereitstellung stülpen: Entwickler sehen Governance als Freigabewarteschlange, weil Kontrollen nicht in ihre Pipelines integriert sind.
Die Einführung des Katalogs als einmaliges Projekt behandeln: Der Katalog erhält eine erste Ladung an Metadaten, aber kein Workflow verpflichtet die Teams, Definitionen, Datenherkunft oder Verantwortlichkeiten zu pflegen.
Aktivitäten statt Ergebnisse messen: Verantwortliche zählen Meetings, registrierte Datenbestände oder abgeschlossene Schulungen, während Benutzer weiterhin auf Antworten warten und Vorfälle sich wiederholen.
Die Veränderung des Betriebsmodells
Der Schritt von Stufe 2 zu Stufe 3 erfordert Governance im täglichen Bereitstellungsprozess. Weisen Sie feste Eigentümer für Datenprodukte zu, veröffentlichen Sie geschäftsnahe Definitionen dort, wo Analysten arbeiten, und verknüpfen Sie Qualitätserwartungen mit dem Pipeline-Verhalten. Der Schritt von Stufe 3 zu Stufe 4 erfordert automatisierte Service-Levels für die Qualität, eine durch die Datenherkunft gestützte Auswirkungsanalyse und Entscheidungen, die den Kreislauf von der Erkennung bis zur Behebung schließen.
Operativer Test: Wenn eine Governance-Entscheidung weder einen Backlog-Eintrag, eine Pipeline-Kontrolle, eine Zugriffsentscheidung noch eine Produktdefinition ändert, hat sie das Betriebsmodell nicht verändert.
Das Unternehmen braucht nicht zuerst einen weiteren Reifegrad-Workshop. Es benötigt einen einzigen Bereich, in dem Eigentumsrechte, Kontrollen, Definitionen und die Fehlerbehebung so sichtbar sind, dass bewiesen werden kann, dass Governance funktionieren kann.
Verknüpfung der Reifegradbewertung mit KI-Bereitschaft und Geschäftswert
Eine Reifegradbewertung ist nur dann von Bedeutung, wenn Führungskräfte sie mit Ergebnissen verknüpfen können und die Teams an vorderster Front den Unterschied spüren. KI macht eine schwache Governance schwerer zu verbergen, da Modelle nachvollziehbare Eingaben, angemessene Zugriffe, zuverlässige Qualitätssignale und dokumentierte Entscheidungen benötigen. Eine Organisation, die auf Stufe 2 feststeckt, kann zwar generative KI-Piloten starten, die Einführung in der Produktion bleibt jedoch eingeschränkt, wenn Datenherkunft und Kontrollen nicht konsistent verifiziert werden können.
Untersuchungen aus dem Benchmark-Programm des EDM Council zeigen, dass strategische Grundlagen in allen Branchen zu den am wenigsten ausgereiften Fähigkeiten gehören: Weniger als ein Drittel der Befragten erzielt fortgeschrittene Fortschritte bei der Datenstrategie, der Datenmanagementstrategie und der Entwicklung von Business Cases. Dieselbe Quelle berichtet, dass 83 % der Organisationen mit Governance- und Compliance-Herausforderungen konfrontiert sind, die den KI-Erfolg beeinträchtigen, während Führungskräfte auf C-Level den Reifegrad um 12 % höher einschätzen als die Manager an vorderster Front. Diese Diskrepanz bedeutet meist, dass die Führungsebene ein Programm sieht, während die Manager im Alltag mit Hindernissen kämpfen.
Reifegradstufe | Signal für KI-Bereitschaft | Geschäftsergebnis | Typische Kennzahl |
|---|---|---|---|
Stufe 1 | Datenquellen und Verantwortlichkeiten sind unklar | KI-Arbeit bleibt experimentell und instabil | Nachweise ungelöster Datenabhängigkeiten |
Stufe 2 | Piloten existieren, aber Belege für Datenherkunft, Zugriff und Qualität erfordern manuelle Arbeit | Initiativen geraten vor der zuverlässigen Nutzung in der Produktion ins Stocken | Manuelle Fehlerbehebung vor dem Release erforderlich |
Stufe 3 | Eingegrenzte Anwendungsfälle haben definierte Dateneigentümer und wiederholbare Kontrollen | Teams können zielgerichtete KI-Produkte mit operativer Unterstützung bereitstellen | Zeitdauer für die Genehmigung der kontrollierten Datennutzung |
Stufe 4 | Modelleingaben, Datenherkunft, Qualität und Genehmigungen werden überwacht | KI-Operationen werden berechenbarer | Eingriffe in der Produktion und Qualitätsvorfälle |
Stufe 5 | Governance passt Kontrollen und Feedbackschleifen kontinuierlich an | KI-Überwachung wird Teil des normalen Produktmanagements | Kontinuierliche Überwachung und dokumentierte Kontrolländerungen |
Verfolgen Sie die Durchlaufzeit für neue Datenprodukte, die Fehlerraten in der regulierten Berichterstattung und den Anteil der KI-Initiativen, die ohne manuelles Eingreifen in die Produktion übergehen. Praktiken der KI-Governance und -Compliance sollten als operative Kontrollen bewertet werden, nicht als separate Compliance-Präsentation.
Eine praktische 90-Tage-Roadmap zur Steigerung des Governance-Reifegrads
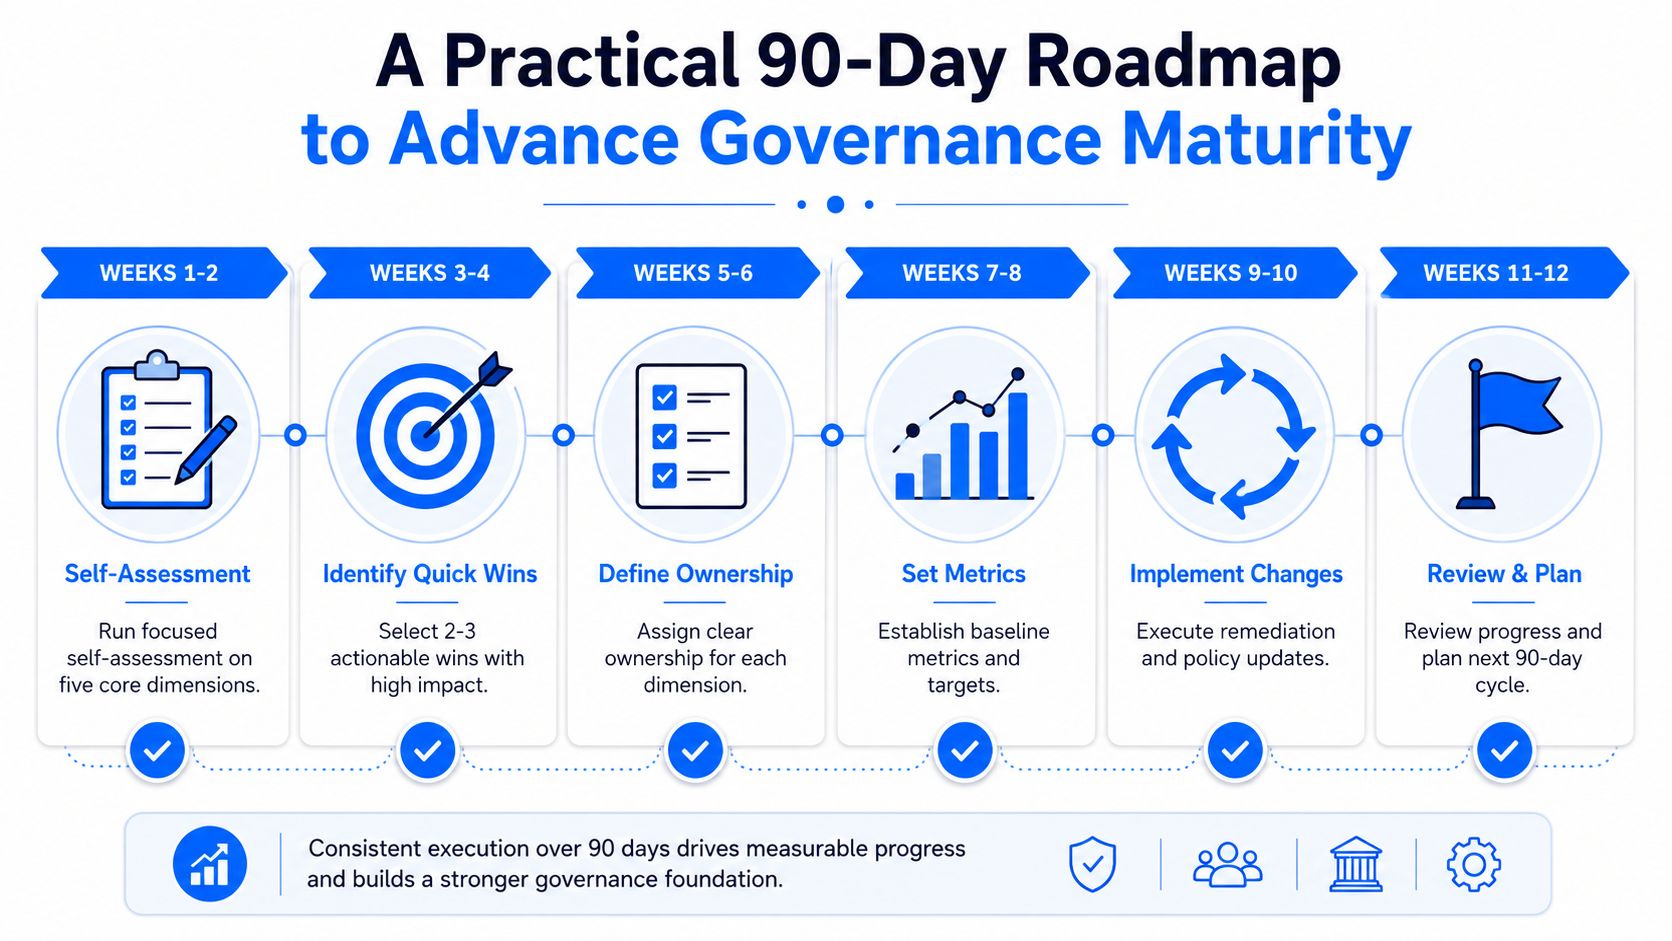
Jährliche Bewertungen erzeugen einen Bericht und verlieren dann an Dynamik. Nutzen Sie stattdessen einen 90-Tage-Zyklus mit Ergebnissen, die ein Lenkungsausschuss prüfen kann.
In den Wochen 1 und 2 bewerten Sie die fünf Kerndimensionen anhand von Belegen. Fragen Sie nicht, ob eine Richtlinie existiert. Fragen Sie, ob ein Prüfer einen Eigentümer finden, eine aktive Kontrolle beobachten, einen Datenherkunftspfad verifizieren, eine Zugriffsentscheidung prüfen und ein KI-Freigabegate identifizieren kann.
In den Wochen 3 bis 6 wählen Sie den Bereich aus, der die größten Reibungsverluste verursacht. Nennen Sie den Eigentümer, richten Sie Qualitätsregeln ein, veröffentlichen Sie ein Datenherkunfts-Diagramm und definieren Sie den Pfad zur Fehlerbehebung. Halten Sie den Rahmen so eng, dass die Teams eine Verhaltensänderung demonstrieren können.
In den Wochen 7 bis 10 etablieren Sie ein schlankes Gremium mit einer Charta, Entscheidungsrechten, Eskalationsregeln und einer veröffentlichten Scorecard. Das Gremium muss Probleme lösen und nicht bloß darüber diskutieren.
In den Wochen 11 und 12 legen Sie dem Lenkungsausschuss ein Memorandum zur Stufenentwicklung vor. Zeigen Sie den Ausgangspunkt, die gesammelten Belege, die implementierten Kontrollen, ungelöste Lücken und die nächste Investitionsentscheidung auf. Eine praktische Data Governance-Strategie sollte dieses Memorandum in den nächsten operativen Zyklus überführen.
Interne Checkliste
Beantworten Sie jede Frage mit Ja oder Nein:
Verantwortlichkeit: Gibt es für kritische Bereiche benannte Eigentümer mit Entscheidungsrechten?
Qualität: Gibt es für kritische Datenbestände dokumentierte und überwachte Service-Levels für die Qualität?
Datenherkunft (Lineage): Können Teams wichtige Daten vom Ursprung bis zur wesentlichen geschäftlichen Nutzung zurückverfolgen?
Zugriff: Kann die Organisation nachweisen, warum auf sensible Daten zugegriffen wurde und wer dies genehmigt hat?
KI-Kontrollen: Durchlaufen KI-Anwendungsfälle dokumentierte Governance-Gates vor der operativen Nutzung?
Problembehebung: Gibt es für jedes wesentliche Datenproblem einen verantwortlichen Eigentümer und einen Nachweis über die Behebung?
Wählen Sie diese Woche einen Bereich aus, nennen Sie einen Eigentümer und richten Sie eine Qualitätsregel ein. Dieser einzige Schritt schafft mehr Belege für Reife als eine weitere unternehmensweite Überarbeitung der Richtlinien.
digna hilft Governance-Teams, Reifegradansprüche in operative Belege zu verwandeln – durch In-Database-Validierung, Anomalieerkennung, Timeliness-Überwachung, Schema-Tracking und gemeinsame Transparenz bei Datenvorfällen. Besuchen Sie digna, um zu prüfen, wie die modularen Observability-Fähigkeiten messbare Qualitätskontrollen und einen solideren Weg hin zu einer KI-bereiten Governance unterstützen können.
Häufig gestellte Fragen
Warum überschätzen Unternehmen ihre Governance-Reife?
Weil sie Dokumentation mit Kontrolle verwechseln. Die meisten stufen sich auf Level 3 oder 4 ein, weil sie Richtlinien, Dashboards und benannte Gremien haben, während die Belege sie oft auf Level 1 oder 2 verorten.
Welche Frage sollte ein Reifegradmodell beantworten?
Eine härtere als die, ob ein Prozess existiert: Was tut die Organisation, wenn Daten brechen, sich ändern, sensibel werden oder ein KI-System speisen? Eine Selbsteinschätzung, die nur nach der Existenz eines Prozesses fragt, erzeugt die Selbstbewertungsillusion.
Welche Warnzeichen deuten auf ein niedrigeres Level?
Vier wiederholen sich: Richtlinien ohne Durchsetzung, wenn Pipelines standardwidrige Daten veröffentlichen können; Dashboards ohne Entscheidungen, wenn niemand Trends prüft oder Behebung finanziert; Gremien ohne Befugnis, die Definitionen diskutieren, aber keine Arbeit zuweisen können; und Kataloge ohne Nutzung, wenn Fachnutzende weiterhin Kolleginnen nach der Herkunft fragen.
Woher stammen die Stufenmodelle der Governance?
Das IBM Data Governance Council, ein Forum von fast 55 Organisationen, gegründet im November 2004, prägte die Diskussion um Unternehmens-Governance mit. Diese Herkunft erklärt, warum Stufenmodelle die Existenz von Prozessen so gut und ihre Durchsetzung so schlecht beschreiben.
Wie nutzt eine Roadmap das Modell?
Um von reaktiven zu durchgesetzten Kontrollen zu gelangen, Stufe für Stufe, statt eine Punktzahl zu erzeugen. Das nützliche Ergebnis ist eine Liste der konkreten Durchsetzungslücken, die die Organisation auf ihrem aktuellen Level halten.


