Data Product Management: Leitfaden für verlässliche Daten
|
7
min. Lesezeit
Ein Umsatz-Dashboard versagt kurz vor einem Planungsmeeting. Die Aktualisierung kam zu spät, ein vorgelagertes Feld änderte sich ohne Ankündigung, und die Zahlen passen nicht mehr zum Finanzbericht. Gleichzeitig liefert eine KI-Funktion instabile Empfehlungen, weil sich die Trainingsdaten verschoben haben. Das sichtbare Problem ist ein kaputtes Diagramm oder ein driftendes Modell. Das zugrunde liegende Problem ist, dass niemand die Daten so betrieben hat, dass Konsumenten sich darauf verlassen konnten.
Genau hier zählt Data Product Management. Ein Datenprodukt ist nicht bloß eine Tabelle, Pipeline, ein Dashboard oder Modell. Es ist ein gemanagtes Datenangebot mit definiertem Konsumenten, klarer Verantwortung, Qualitätserwartungen, Service Levels und einem Lebenszyklus, der nach dem Release weitergeht. Dieser Leitfaden baut die Idee von Grund auf und verbindet dann Rollen, Lebenszyklusentscheidungen, Zuverlässigkeits-KPIs, Governance-Workflows und Observability.
Der Ansatz passt auch natürlich neben DataOps-Praktiken für zuverlässigen Datenbetrieb, besonders wenn Engineers und Analysten Fehler erkennen müssen, bevor sie Berichte, Anwendungen oder KI-Systeme erreichen.
Inhaltsverzeichnis
Der Lebenszyklus eines Datenprodukts von der Idee bis zur Stilllegung
Governance-Workflows und Observability, die Produkte zuverlässig halten
Praxisanwendungen und nächste Schritte für Ihre Datenprodukte
Einführung: Warum Daten jetzt Produktdenken brauchen
Eine Pipeline besteht womöglich ihren ersten Liefertest und lässt dann die Teams im Stich, die von ihr abhängen. Ein Quellfeld ändert sich, eine Aktualisierung kommt zu spät, oder zwei Berichte legen dieselbe Kennzahl unterschiedlich aus. Das Ergebnis existiert weiter, doch sein Verhalten ist nicht mehr vorhersagbar.
Thoughtworks' Diskussion von 2025 fasst Daten als Produkt mit eigenem Lebenszyklus, eigenen Qualitätsstandards und Konsumentenbedürfnissen. Diese Sicht verschiebt die Frage von „Haben wir den Datensatz veröffentlicht?“ zu „Können Menschen und Systeme ihn sicher und wiederholt nutzen?“. Dieselbe Diskussion verbindet Datenproduktdisziplin mit Plattformwildwuchs: Organisationen berichten, dass sie 10–15 oder mehr Plattformen ansammeln, was Fragmentierung, doppelte Arbeit und Integrationsprobleme erzeugt. (Thoughtworks' Diskussion von 2025 zu Daten als Produkt beschreibt diese Betriebsidee und ihren Bezug zum Plattformwildwuchs.)
Dokumentation kann ebenso schnell zurückfallen. Der Leitfaden zitiert einen Product Excellence Report, wonach nur 41 % der Produktverantwortlichen ihre Roadmaps aktuell und mit den Stakeholder-Erwartungen abgestimmt halten, eine Warnung für Datenteams, deren Prioritäten, Schemata und Konsumenten sich mit der Zeit ändern.
Praxisregel: Ein Datenprodukt gewinnt Vertrauen durch verlässliches Verhalten, nicht durch einen polierten Katalogeintrag.
Dieses Verhalten verlangt operative Kontrollen. Timeliness-Prüfungen zeigen, ob die Lieferung die Erwartungen erfüllt. Validierung fängt unerwartete Werte ab. Schema-Tracking legt brechende Änderungen offen, bevor Konsumenten ihnen begegnen. Observability verbindet diese Signale, damit Engineers und Analysten sehen, ob ein Datensatz für Berichte, Anwendungen oder KI-Systeme nutzbar bleibt. Teams, die DataOps-Praktiken für zuverlässigen Datenbetrieb anwenden, können diese Prüfungen als Teil der Auslieferung behandeln statt als Notreparatur.
Produktdenken gibt der Datenarbeit damit eine Zuverlässigkeitsdisziplin: den Konsumenten definieren, die Schnittstelle betreiben und nach dem Release Nachweise bewahren.
Was Data Product Management wirklich bedeutet
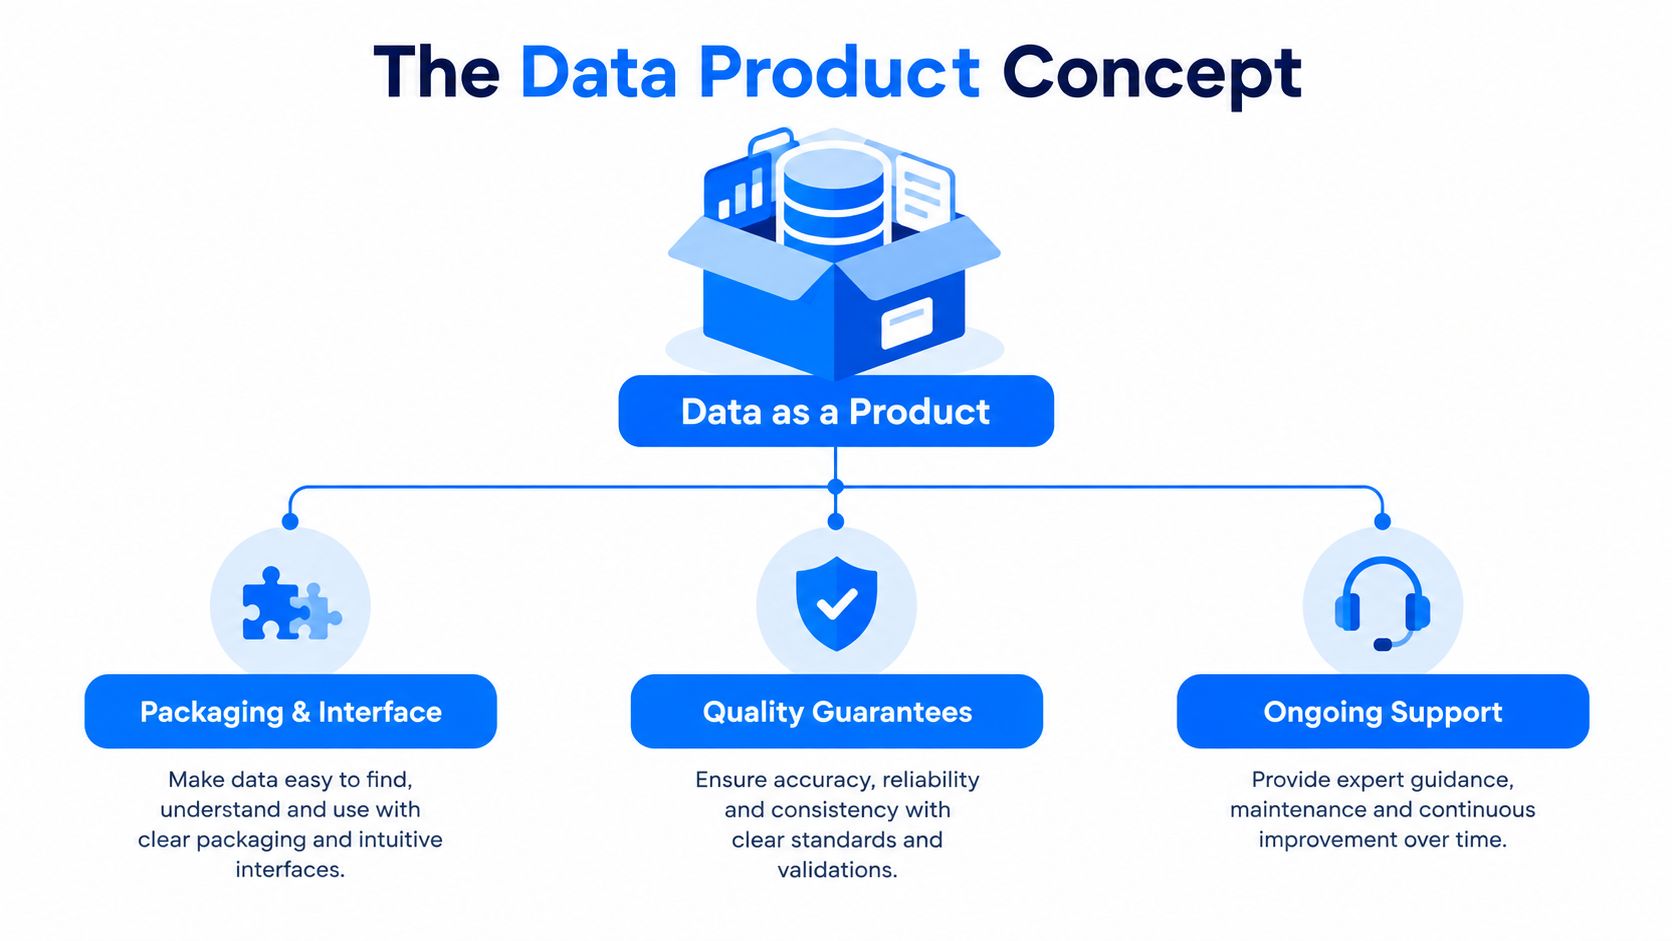
Beginnen wir mit einer vertrauten Regal-Analogie. Ein Rohdatensatz ist wie eine unbeschriftete Zutat im Lagerraum. Jemand weiß vielleicht, woher sie stammt, doch ein neuer Konsument muss dennoch fragen, was drin ist, ob es frisch ist, wie man es verwendet und wen man anspricht, wenn etwas seltsam aussieht.
Ein Datenprodukt ähnelt eher einem verpackten Artikel für den wiederholten Gebrauch. Es hat einen klaren Namen, eine Schnittstelle, Anleitungen, Qualitätserwartungen und Support. Die Verpackung kann eine gesteuerte SQL-View, eine API, ein analytisches Modell, ein Feature-Set oder ein Dashboard mit stabiler semantischer Logik sein. Das Format zählt weniger als die betriebliche Verpflichtung darum herum.
Die vier Tests für Produktdenken
Ein brauchbares Datenprodukt sollte vier Tests bestehen:
Auffindbarkeit: Konsumenten finden es über Katalog, Portal oder bekannte Schnittstelle, ohne auf persönliche Kontakte angewiesen zu sein.
Adressierbarkeit: Konsumenten wissen, wie sie darauf zugreifen, ob über einen Query-Endpunkt, eine API, eine gesteuerte Freigabe oder eine dokumentierte View.
Vertrauenswürdigkeit: Das Produkt veröffentlicht messbare Qualitätserwartungen und überwacht, ob es sie erfüllt.
Selbstbeschreibung: Metadaten erklären Definitionen, Ownership, Lineage, Sensibilität, zulässige Nutzung und bekannte Einschränkungen.
Diese Eigenschaften trennen ein Produkt von einem Projektergebnis. Ein Projekt optimiert meist auf einen definierten Umfang und einen Abschlusspunkt. Ein Produkt trägt fortlaufende Verantwortung für Relevanz, Zuverlässigkeit, Konsumentenfeedback, kontrollierte Änderung und irgendwann Stilllegung.
Die Unterscheidung wird wichtiger, je mehr Technologie-Stacks sich vermehren. Plattformwachstum kann Teams mehr Fähigkeiten geben und es zugleich erschweren, den maßgeblichen Datensatz, die aktuelle Definition oder die zuständige Verantwortung zu erkennen. Produktmanagement liefert die fehlende Disziplin. Es fragt, wer die Daten konsumiert, welche Entscheidung sie stützen, welches Service Level diese Entscheidung verlangt und wie das Team reagiert, wenn sich die Realität ändert.
Was der Product Manager tatsächlich managt
Der Manager ordnet nicht bloß Katalogfelder. Er managt ein Versprechen zwischen Produzenten und Konsumenten. Dieses Versprechen umfasst Zweck, Schnittstelle, Qualitätskontrollen, Supportweg, Roadmap und Stilllegungsbedingungen des Produkts.
Ein Produkt kann regulatorisches Reporting, Kundenoperationen, Prognosen oder einen KI-Workflow stützen. Jeder Anwendungsfall erzeugt andere Erwartungen an Aktualität, Validierung, Zugriff und Änderungssicherheit. Produktdenken macht diese Erwartungen explizit, bevor Engineers sie in Pipelines kodieren.
Eine kurze visuelle Erklärung kann Teams helfen, sich über den Unterschied zwischen einem Output und einem gemanagten Angebot zu verständigen:
Die zentrale Idee ist einfach: Daten werden zum Produkt, wenn Konsumenten sich auf ihr Verhalten verlassen können, nicht schon dann, wenn ein Team einem vorhandenen Asset ein neues Etikett gibt.
Rollen und Ownership in einem Datenproduktteam
Ein Datenproduktteam arbeitet am besten, wenn Verantwortung dem Produkt folgt statt dem Werkzeug. Der Data Product Manager verantwortet Ausrichtung und Konsumentenerfolg. Engineers bringen das Produkt zum Laufen. Analysten, Scientists, Governance-Fachleute und Plattformteams steuern unterschiedliche Fähigkeiten bei, ohne Entscheidungsrechte zu verwischen.

Verantwortung sollte sichtbar sein
Der Data Product Manager ist verantwortlich für Vision, Priorisierung, Konsumentenforschung, Roadmap und Produktergebnisse. Er übersetzt ein Geschäftsproblem in eine Produktentscheidung, entscheidet, welche Anfragen Investition verdienen, und hält Stakeholder ausgerichtet, wenn Abwägungen auftreten.
Der Data Engineer verantwortet Ingestion, Transformationszuverlässigkeit, Laufzeitverhalten und operative Abhängigkeiten. Der Analytics Engineer überführt fachliche Definitionen in gesteuerte Modelle, wiederverwendbare Kennzahlen, Tests und Dokumentation. Der Data Scientist nutzt das Produkt womöglich, um Modelle oder Entscheidungssysteme zu bauen, und gibt zugleich Rückmeldung zu Feature-Stabilität, Trainingsdaten und Modellreife.
Governance- und Plattformteams liefern Leitplanken, statt Produkt-Ownership zu ersetzen. Governance-Fachleute definieren Richtlinien, Zugriffserwartungen, Klassifizierungsregeln und Auditanforderungen. Platform Engineers stellen Infrastruktur, Deployment-Muster, Berechtigungen und Observability-Funktionen bereit, damit Produktteams sicher arbeiten können.
Eine praktische Ownership-Karte kann so aussehen:
Vision und Priorisierung: Data Product Manager, mit Input aus Domäne und Leitung.
Fachliche Definitionen: Analytics Engineer und Fachexperte, mit Produktfreigabe.
Pipeline- und Laufzeitzuverlässigkeit: Data Engineer, unterstützt von Platform Engineering.
Qualitäts- und Zugriffskontrollen: Governance-Lead und zuständiger Engineering-Verantwortlicher.
Onboarding und Feedback der Konsumenten: Product Manager, unterstützt von Analysten und Domänenverantwortlichen.
Reaktion auf Produktionsvorfälle: Benannter operativer Verantwortlicher mit dokumentierten Eskalationswegen.
Ownership wird zum Engpass, wenn ein Produkt einen Namen hat, aber niemanden mit der Befugnis, Entscheidungen zu treffen, Wartung zu finanzieren oder das Asset stillzulegen.
Dieses Problem ist in regulierten Umgebungen besonders ernst. Ein Katalog zeigt vielleicht einen Owner, doch dieser hat womöglich nicht die Befugnis, eine Schemaänderung zu genehmigen oder eine verfehlte Aktualitätsprüfung zu priorisieren. Wirksame Ownership verbindet Verantwortung mit Entscheidungsrechten, Betriebskapazität und einem klaren Support-Workflow.
Ein gemeinsames Dashboard kann Engineers, Analysten und Stakeholdern denselben Blick auf Vorfälle, Trends und Produktstatus geben, ohne Daten aus der Kundenumgebung zu bewegen. Das breitere Rollenmodell für Data Governance hilft Teams, diese Übergaben explizit zu machen, statt sie in informellen Gesprächen zu belassen.
Der Lebenszyklus eines Datenprodukts von der Idee bis zur Stilllegung
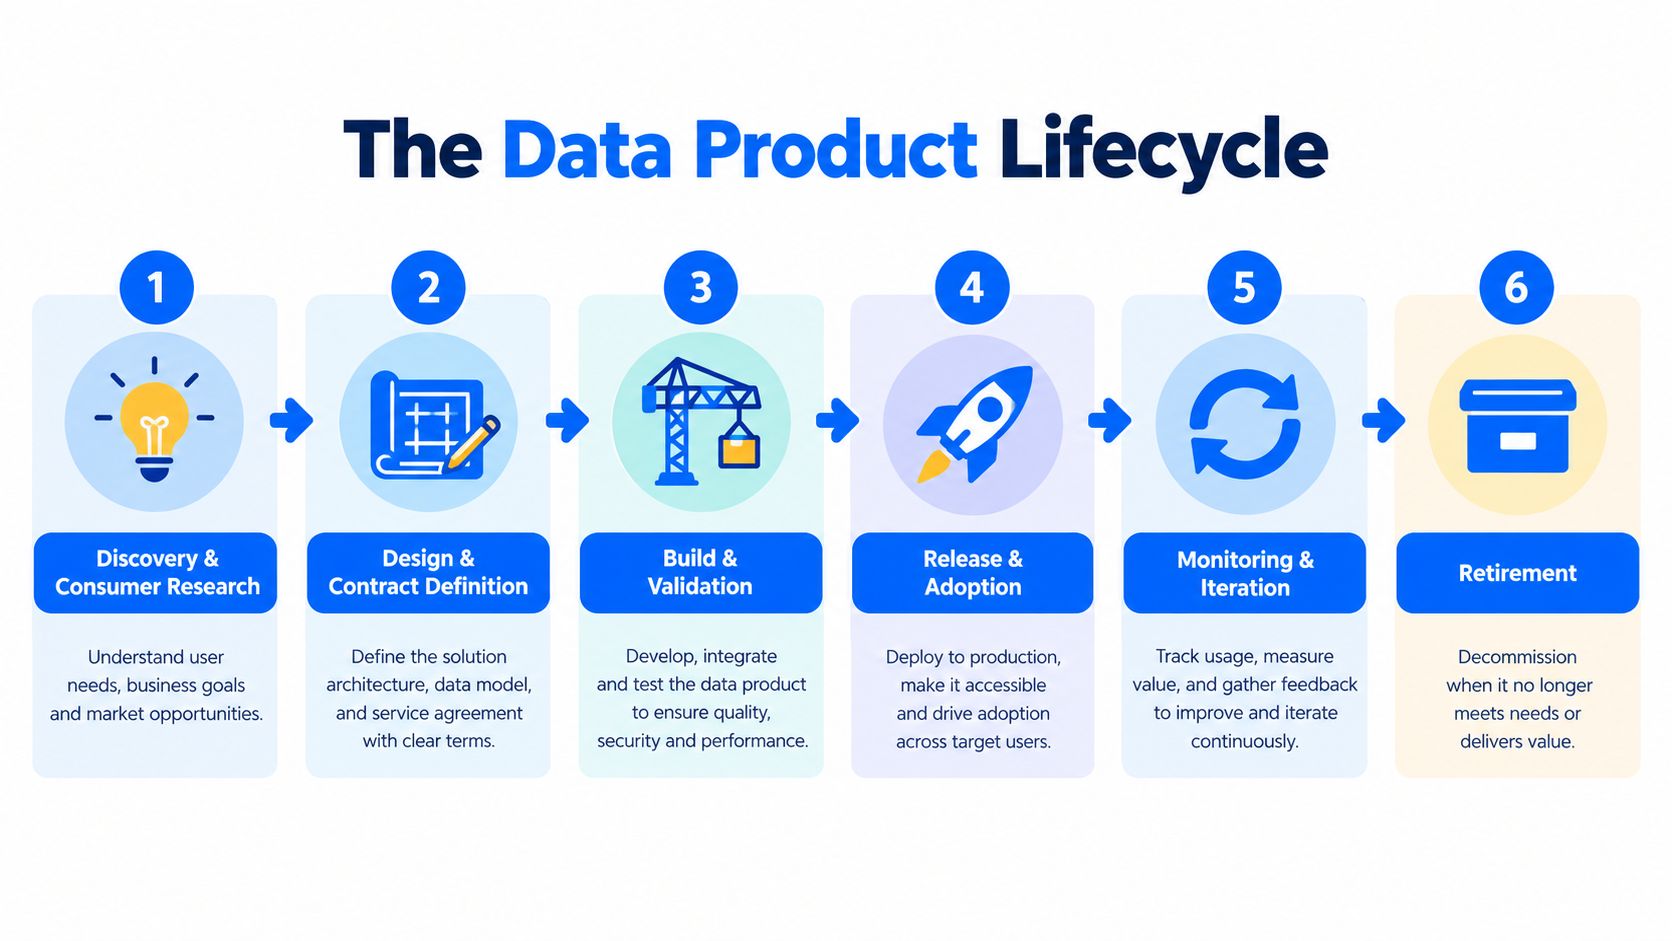
Der Lebenszyklus eines Datenprodukts beginnt vor dem Code und geht nach dem Release weiter. Jede Phase beantwortet eine andere Frage, und jedes Entscheidungstor verhindert, dass das Team ungeklärte Annahmen in die Produktion trägt.
Discovery und Konsumentenforschung
Beginnen Sie bei der Entscheidung, nicht bei der verfügbaren Quelle. Bestimmen Sie die Konsumentengruppe, das Geschäftsproblem, die Handlung, die das Produkt stützen soll, und die Folgen später oder falscher Daten. Befragen Sie Analysten, Operatoren, Anwendungsteams und Governance-Stakeholder getrennt, denn jede Gruppe sieht andere Fehlerbilder.
Ein brauchbares Discovery-Ergebnis enthält eine Problembeschreibung, eine benannte Verantwortung, erste Konsumentenreisen, Datensensibilität, erwartetes Zugriffsmuster und eine grobe Erfolgsdefinition. Können Nutzende nicht erklären, was sie mit dem Produkt tun werden, sollte das Team den Bedarf prüfen, bevor es Engineering-Kapazität bindet.
Entwurf und Vertragsdefinition
Definieren Sie als Nächstes Schnittstelle und Zusicherungen des Produkts. Dokumentieren Sie Entitäten, Kennzahlen, Feldbedeutungen, zulässige Werte, erwartetes Lieferverhalten, Zugriffskontrollen und Regeln für das Änderungsmanagement. Datenverträge sollten beschreiben, was Produzenten liefern und was Konsumenten gefahrlos annehmen dürfen.
Das Team sollte außerdem entscheiden, welche Änderungen abwärtskompatibel sind, welche eine neue Version erfordern und welche eine Benachrichtigung der Konsumenten verlangen. Analytics Engineers und Fachexperten verhindern semantischen Drift, bevor er Dashboards oder Modelle erreicht.
Bau und Validierung
Engineers setzen dann Ingestion, Transformation, Tests, Metadaten, Lineage und operative Prüfungen um. Validierung sollte nicht bis zur Schlussabnahme aufgeschoben werden. Bekannte Geschäftsregeln, strukturelle Erwartungen und Lieferverhalten brauchen Prüfungen während der gesamten Entwicklung und vor dem Release.
Ein Produkt ist nicht deshalb bereit, weil seine Abfrage Zeilen liefert. Es ist bereit, wenn das Team zeigen kann, dass die Zeilen dokumentierten Definitionen folgen, innerhalb der vereinbarten Erwartung eintreffen und eine klare Reaktion erzeugen, wenn eine vorgelagerte Abhängigkeit ausfällt.
Release und Adoption
Das Release umfasst Onboarding, Beispiele, Zugriffsanleitungen, Support-Routing und Schulung der Konsumenten. Ein technisch solides Produkt kann dennoch scheitern, wenn Nutzende die Definitionen nicht verstehen oder es nicht über ihren gewohnten Workflow erreichen.
Der Product Manager sollte frühes Feedback beobachten und zwischen einem Auffindbarkeitsproblem, einem Usability-Problem, einem Vertrauensproblem und echtem Mangel an Nachfrage unterscheiden. Jedes verlangt eine andere Reaktion.
Monitoring und Iteration
Nach dem Start prüft das Team Qualitätssignale, Vorfälle, Nutzungsmuster und Feedback. Monitoring sollte zu Backlog-Entscheidungen führen, nicht bloß zu Alert-Lärm. Brauchen Nutzende eine andere Granularität, ein anderes Lieferfenster oder eine andere Schnittstelle, sollte die Roadmap diesen Befund abbilden.
Roadmap-Disziplin zählt, weil Datenprodukte verfallen, wenn Stakeholder-Erwartungen sich bewegen, während das Produkt eingefroren bleibt. Die eingangs erwähnte Berichterstattung von 2026 verknüpft schwache Roadmap-Abstimmung mit Schwierigkeiten im Produktmanagement, was Kommunikation und Priorisierung zum Teil der Zuverlässigkeit macht statt zum Verwaltungsaufwand.
Stilllegung
Stilllegung ist eine kontrollierte Produktentscheidung. Definieren Sie den Grund, ermitteln Sie verbliebene Konsumenten, kommunizieren Sie Ersatz- oder Archivweg, bewahren Sie erforderliche Nachweise und entfernen Sie obsoleten Zugriff. Eine saubere Stilllegung hält das Portfolio verständlich und verhindert, dass Engineers Ergebnisse pflegen, die keine sinnvolle Entscheidung mehr stützen.
Erfolg mit KPIs messen, die Zuverlässigkeit belegen
Ein Produkt kann viele Konsumenten haben und dennoch unzuverlässig sein. Es kann auch anfangs wenig Adoption zeigen, weil es einen spezialisierten Workflow bedient und dabei sein Serviceversprechen erfüllt. Deshalb sollten Datenprodukt-KPIs Konsumentennutzen mit operativer Gesundheit verbinden, statt Dashboards, Tabellen oder Katalogeinträge zu zählen.
Fachliche Leitlinien empfehlen, Einhaltung von Freshness-SLAs, Ownership-Abdeckung, Abdeckung durch Datenverträge und Impact-Erkennung vor dem Deployment zu verfolgen, weil diese Größen Zuverlässigkeit mit Änderungssicherheit verbinden (Leitlinien zur Governance von Datenprodukten erläutern diesen operativen Ansatz). Governance-Rahmenwerke empfehlen zudem Größen für Adoption und Support wie Wiederverwendungsrate, Wachstum aktiver Konsumenten, Time-to-Discover, Zuordnung von Problemen zu einer benannten Verantwortung und innerhalb der SLA gelöste Fälle (Leitlinien zum Monitoring der Portfolio-Governance verbinden diese Indikatoren mit Wiederverwendung und Kontrollergebnissen).
Datenprodukt-KPIs nach Ergebnis wählen
Gewünschtes Ergebnis | Primärer KPI | Was er signalisiert |
|---|---|---|
Konsumentenvertrauen aufbauen | Einhaltung des Freshness-SLA | Ob die Lieferung die Erwartung erfüllt, auf die Konsumenten bauen |
Verantwortung sichtbar machen | Ownership-Abdeckung | Ob jedes Produkt und jedes Problem eine zuständige Verantwortung hat |
Änderungsrisiko senken | Abdeckung durch Datenverträge und Impact-Erkennung vor dem Deployment | Ob strukturelle Änderungen vor dem Release verstanden sind |
Wiederverwendung erhöhen | Wiederverwendungsrate und Wachstum aktiver Konsumenten | Ob das Produkt wiederkehrende Bedarfe über Konsumenten hinweg löst |
Auffindbarkeit verbessern | Search-to-Open oder Time-to-Discover | Ob Nutzende das Produkt effizient finden und verstehen |
Support verbessern | Zuordnung von Problemen zu einer benannten Verantwortung und Lösung innerhalb der SLA | Ob Fehler schnell von der Erkennung zur Behebung kommen |
Diese KPIs beantworten verschiedene Fragen. Aktualität sagt, ob ein Bericht oder Modell Daten rechtzeitig erhält. Ownership sagt, ob jemand handeln kann, wenn das nicht geschieht. Vertragsabdeckung zeigt, ob Konsumenten gegen strukturelle Überraschungen geschützt sind. Wiederverwendung zeigt an, dass das Produkt eine verlässliche Schnittstelle hat statt einer einmaligen Antwort.
Die Ursachenkette zählt. Wird die Lieferung unvorhersehbar, erstellen Konsumenten womöglich private Kopien. Ist Ownership unklar, bleiben Vorfälle ungelöst. Können Nutzende zertifizierte Produkte nicht schnell finden, kehren sie zu manuellen Anfragen zurück. Über die Zeit erhöhen diese Verhaltensweisen Duplikation und schwächen den Wert der Governance.
Teams können Leitlinien zur Messung von Zuverlässigkeit nutzen, um eine Scorecard rund um die tatsächlichen Konsumentenzusagen ihres Produkts zu entwerfen. Die wichtige Disziplin ist, eine kleine Menge an Größen zu wählen, die Entscheidungen auslösen. Ein KPI, der nie die Priorisierung ändert, ist ein Bericht und kein Steuerungsinstrument.
Governance-Workflows und Observability, die Produkte zuverlässig halten
Eine Reporting-Pipeline kann eine Datei pünktlich liefern und dennoch unzuverlässige Ergebnisse erzeugen. Ein umbenanntes Feld kann ein Dashboard brechen, eine plötzliche Verteilungsverschiebung kann ein Modell verzerren, und eine späte Lieferung kann Analysten mit veralteten Informationen arbeiten lassen. Governance wird nützlich, wenn ihre Regeln neben Auslieferung, Validierung und Incident Response wirken.
Data Observability funktioniert wie ein Bedienpult für ein Datenprodukt. Sie überwacht fortlaufend Systemgesundheit, Qualität, Zuverlässigkeit und Performance über Ingestion, Speicherung und Analytik hinweg. Ihre Kernsignale umfassen Aktualität, Volumen, Schema, Verteilung und Lineage, wie in Forschung zu Observability-Signalen beschrieben. Teams können außerdem Praktiken der Data Observability erkunden, um zu sehen, wie diese Signale operatives Monitoring stützen.
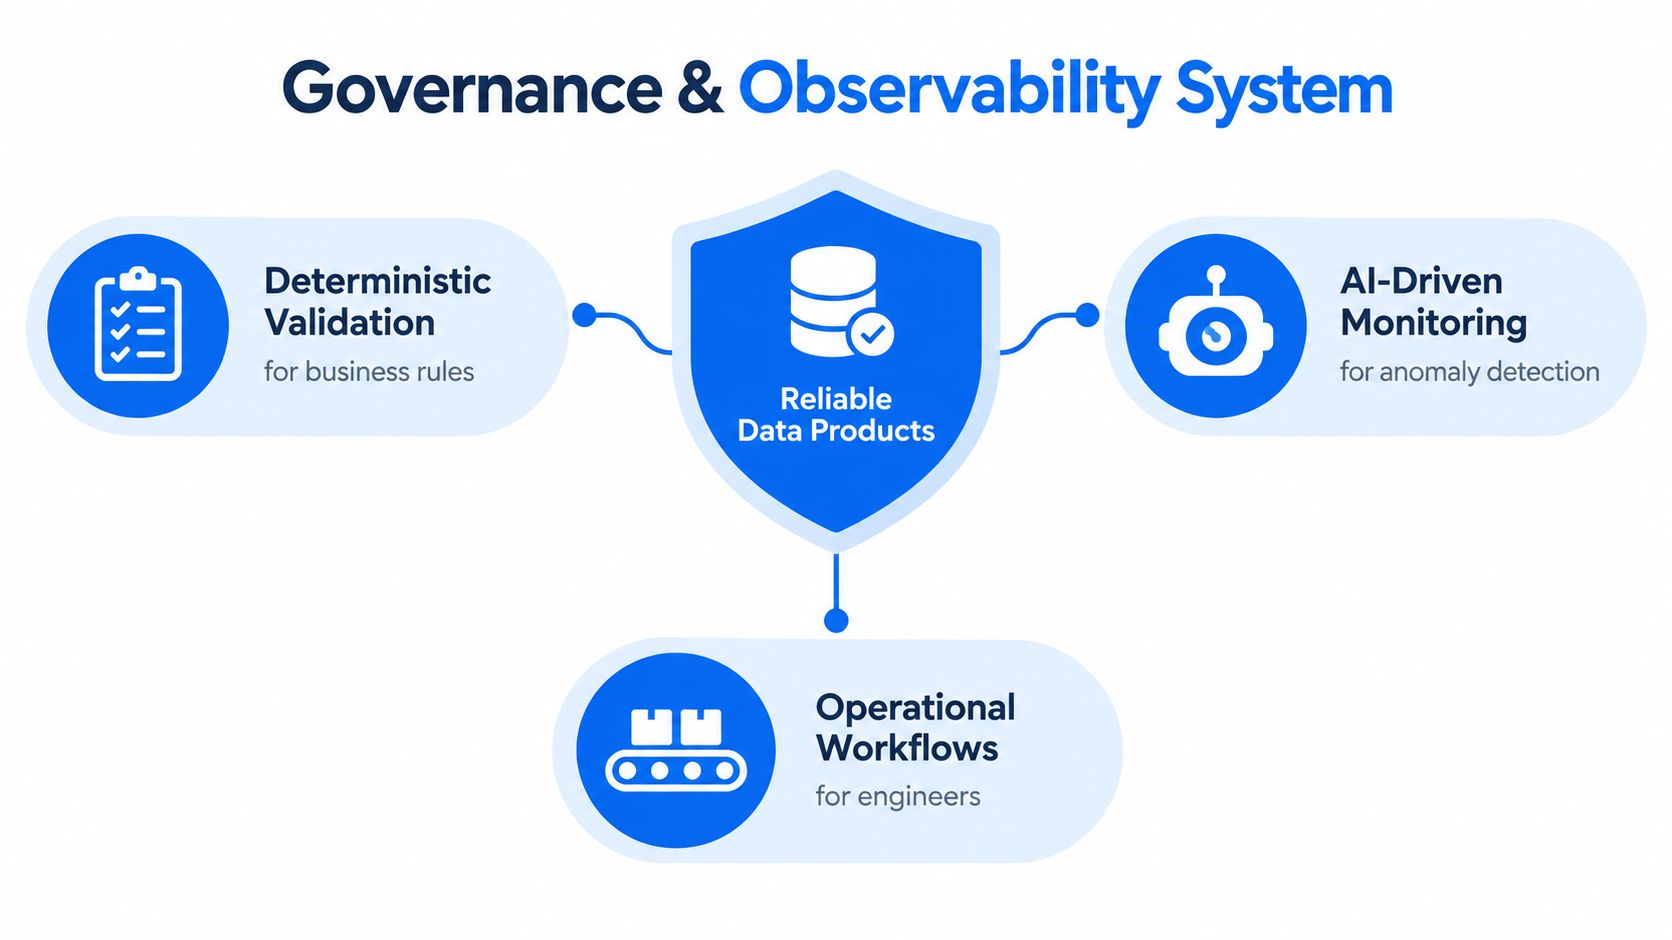
Vier Kontrollen mit unterschiedlichen Aufgaben
Deterministische Validierung prüft Regeln, die das Team bereits versteht. Zulässige Statuswerte, erforderliche Identifikatoren, Beziehungsregeln und Bedingungen für regulatorisches Reporting sind gängige Beispiele. Weil jede Prüfung auf eine definierte Regel zeigt, lässt sich ihr Ergebnis erklären und prüfen.
Anomalieerkennung sucht nach ungewohntem Verhalten, das feste Regeln übersehen können. Jede Zeile kann eine einfache Gültigkeitsprüfung bestehen, während sich die Gesamtverteilung scharf verschiebt. Baseline-Monitoring hilft Teams, ungewöhnliches Volumen, Wertemuster oder Nutzungsverhalten zu erkennen, bevor Konsumenten einen Fehler melden.
Timeliness-Monitoring misst die Lücke zwischen erwarteter und tatsächlicher Verfügbarkeit von Informationen. Der Leitfaden zu Datenqualitätskennzahlen rahmt Timeliness um Zugänglichkeit und Verfügbarkeit. Verspätung wird damit zu einer messbaren Kontrolle statt zu einer subjektiven Beschwerde.
Schema-Tracking schützt den strukturellen Vertrag des Produkts. Hinzugefügte oder entfernte Spalten, umbenannte Felder und geänderte Datentypen können Transformationen, Dashboards, Feature-Pipelines und nachgelagerte Anwendungen brechen, selbst wenn die Lieferung weiterläuft.
Ein nützliches Betriebsmuster kombiniert Validierung für bekannte Regeln, Anomalieerkennung für ungewohntes Verhalten, Timeliness-Prüfungen für Lieferrisiko und Schema-Tracking für strukturelle Änderungen. Es sollte fehlende, späte und unerwartet frühe Lieferungen festhalten und dann aus dem beobachteten Verhalten ein erwartetes Lieferfenster ableiten, wie im Qualitätsrahmenwerk für Unternehmen beschrieben.
Signale in Handeln überführen
Ein Alert wird erst nützlich, wenn jemand danach handeln kann. Jedes Ereignis braucht eine benannte Verantwortung, Schweregrad, betroffene Produkte, Abhängigkeitskontext, Eskalationsweg und Lösungsprotokoll. Bedroht eine Schemaänderung einen Konsumenten, sollte das Team betroffene Berichte, Modelle und Anwendungen bestimmen, bevor die Änderung die Produktion erreicht.
Plattformen wie digna setzen dieses Muster um, indem sie Anomalieerkennung, Validierung, Timeliness und Schema-Tracking in einer Observability-Schicht zusammenführen. Diese Anordnung gibt Engineers, Analysten und Stakeholdern einen gemeinsamen Blick auf Vorfälle, Trends und Status über Datenqualität, Business Monitoring und Plattform-Observability hinweg.
Die Betriebsschleife ist geradlinig. Governance definiert akzeptables Verhalten, Observability erkennt Abweichungen, und Workflow-Ownership macht daraus kontrollierte Behebung. Diese Disziplin macht aus wiederverwendbaren Datensätzen verlässliche Systeme für Analytik und KI.
Praxisanwendungen und nächste Schritte für Ihre Datenprodukte
In Finanzdienstleistungen braucht ein Transaktions- oder Risikodatenprodukt Validierung, Lieferverfolgung und Überwachung struktureller Änderungen, damit Reporting-Teams Fehler nicht erst nach einer Meldefrist entdecken. Im Gesundheitswesen brauchen klinische und operative Datenprodukte klare Definitionen, Timeliness-Kontrollen und nachvollziehbare Qualitätsnachweise. Telekommunikationsteams können hochvolumige Kunden- und Netzdaten auf ungewöhnliche Verschiebungen, fehlende Lieferungen und Schemaänderungen überwachen. Teams im öffentlichen Sektor können dieselbe Disziplin auf Datensätze anwenden, die Konsistenz, Prüfbarkeit und verlässlichen Zugang verlangen.
Der Unterschied zwischen Vorher und Nachher ist operativ. Vor der Produktdisziplin bemerkt ein Analyst eine seltsame Zahl, durchsucht Nachrichten, findet mehrere mögliche Verantwortliche und baut einen Bericht aus einer vertrauten Tabelle nach. Danach hat das Produkt einen dokumentierten Vertrag, automatisierte Prüfungen, eine sichtbare Verantwortung, einen Vorfallsweg und einen bekannten Reaktionsprozess.
Eine praktische Bestandsaufnahme kann mit diesen Fragen beginnen:
Konsument: Wer nutzt dieses Produkt, und welche Entscheidung stützt es?
Vertrag: Was dürfen Konsumenten über Schema, Definitionen, Zugriff und Lieferung annehmen?
Ownership: Welche Person oder welches Team darf Änderungen genehmigen und Vorfälle lösen?
Kontrollen: Decken Validierung, Anomalie-, Timeliness- und Schemaprüfungen die wichtigen Fehlerbilder ab?
Lebenszyklus: Welche Nachweise würden Verbesserung, Ersatz oder Stilllegung auslösen?
Nutzen Sie das Betriebsmodell für das Datenqualitätsteam, um zu klären, wie Produkt-, Engineering-, Analytics- und Governance-Verantwortung zusammenwirken sollten. Priorisieren Sie das Produkt, dessen Ausfall das größte Entscheidungsrisiko erzeugen würde, und machen Sie seine Zusagen beobachtbar, bevor Sie das Portfolio ausweiten.
digna hilft Datenteams, Anomalien zu überwachen, Geschäftsregeln zu validieren, Timeliness zu verfolgen, Schemaänderungen zu erkennen und Geschäfts- sowie Plattformsignale in der eigenen Umgebung zu prüfen. Besuchen Sie digna, um zu sehen, wie ein Observability-Ansatz in der Datenbank verlässliche Datenprodukte für Analytik und KI stützen kann.
Der Vertrag, den ein Datenprodukt veröffentlicht, ist nur so gut wie die Prüfungen dahinter — und genau dort führt die Brücke vom Produktdenken zum Data Quality Management.
Häufig gestellte Fragen
Was macht einen Datensatz zum Datenprodukt?
Vier Tests zu bestehen: Auffindbarkeit über Katalog oder Portal statt über persönliche Kontakte, Adressierbarkeit über einen dokumentierten Endpunkt oder View, Vertrauenswürdigkeit durch veröffentlichte und überwachte Qualitätserwartungen sowie Selbstbeschreibung durch Metadaten zu Ownership, Lineage und zulässiger Nutzung.
Wer verantwortet was im Datenproduktteam?
Der Data Product Manager verantwortet Vision, Priorisierung und Roadmap, der Data Engineer Ingestion, Transformationszuverlässigkeit und Laufzeitverhalten, Governance und Plattformteams liefern Leitplanken. Der Engpass ist ein Produkt mit Namen, aber ohne jemanden, der Wartung finanzieren oder es stilllegen darf.
Warum wird Produktdenken gerade jetzt auf Daten angewandt?
Weil Veröffentlichen bei wachsender Plattformvielfalt nicht mehr genügt. Organisationen berichten von 10 bis 15 oder mehr Plattformen, was Aufwand fragmentiert, und Thoughtworks' Diskussion von 2025 verschiebt die Frage von der Veröffentlichung des Datensatzes hin zur sicheren, wiederholbaren Nutzung durch Menschen und Systeme.
Welche KPIs belegen Zuverlässigkeit?
Einhaltung von Freshness-SLAs, Ownership-Abdeckung, Abdeckung durch Datenverträge und Impact-Erkennung vor dem Deployment für die Zuverlässigkeit, dazu Wiederverwendungsrate, Wachstum aktiver Konsumenten, Time-to-Discover und innerhalb der SLA gelöste Vorfälle für Adoption und Support.
Warum verfallen Datenprodukte nach dem Launch?
Weil Erwartungen sich bewegen, während das Produkt eingefroren bleibt. Nur 41 % der Produktverantwortlichen halten Roadmaps mit den Stakeholder-Erwartungen abgestimmt, was Roadmap-Disziplin zum Teil der Zuverlässigkeit macht und nicht zum Verwaltungsaufwand.



