Data Observability Framework: Ein praktischer Leitfaden für 2026
|
6
min. Lesezeit
Der am häufigsten gegebene Rat zu einem Data Observability-Framework ist zugleich der unvollständigste: Man solle die fünf Säulen implementieren, die Warnmeldungen verknüpfen und die Plattform als beobachtbar bezeichnen. Aktualität, Volumen, Verteilung, Schema und Lineage sind notwendige Signale, aber sie sagen niemandem, wer handeln muss, wie schnell oder ob eine Anomalie für das Unternehmen überhaupt von Bedeutung ist.
Ein Dashboard kann eine defekte Pipeline anzeigen, während Führungskräfte weiterhin fehlerhafte Zahlen erhalten. Ein echtes Framework verbindet die Erkennung mit Zuständigkeit, Governance, Incident Response und Kostenkontrolle. Dieser Unterschied wird immer wichtiger, da Data Observability zunehmend in die strategische Planung von Großunternehmen einfließt. Eine Marktstudie aus dem Jahr 2026 schätzt, dass diese Kategorie von 3,51 Milliarden USD im Jahr 2026 auf 6,03 Milliarden USD bis 2031 anwachsen wird, während eine andere ein Wachstum von 2,90 Milliarden USD im Jahr 2025 auf 8,79 Milliarden USD bis 2035 prognostiziert. Beide Schätzungen verorten den Markt bei einer jährlichen Wachstumsrate (CAGR) von etwa 11 % – ein Beleg dafür, dass Observability zu einer dauerhaften Softwarekategorie geworden ist und nicht mehr nur eine experimentelle Data-Engineering-Praxis darstellt (SNS Insider Marktanalysen).
Inhaltsverzeichnis
Warum die meisten Data Observability-Programme bei den fünf Signalen stehen bleiben
Erkennung ist nicht dasselbe wie Reaktion
Die Governance-Ebene ist das fehlende System
Was ein Data Observability-Framework tatsächlich ist
Vier Ebenen machen das Framework nutzbar
Die fünf Kernsignale und was jedes einzelne erfasst
Rollen und Governance im Framework
Verantwortlichkeit direkt im Asset verankern
Integrationspunkte über Pipelines, Warehouses und BI hinweg
Kontext in die Warehouse- und BI-Ebene übertragen
Ein vierstufiges Reifegradmodell zur Selbsteinschätzung
Vier Phasen der operationalen Reife
Eine 90-Tage-Roadmap für den Einstieg im Jahr 2026
Tag 1 bis 30: Zuständigkeiten festlegen
Tag 31 bis 60: Leichtgewichtige Erkennung hinzufügen
Tag 61 to 90: Den Regelkreis schließen
Häufige Fragen, die sich Käufer und Architekten stellen
Was sollte Eigenentwicklung vs. Kauf kosten?
Welche Anbieterfunktionen sind entscheidend?
Wie lange dauert es, bis eine sinnvolle Abdeckung erreicht ist?
Warum die meisten Data Observability-Programme bei den Silicon-Signalen stehen bleiben
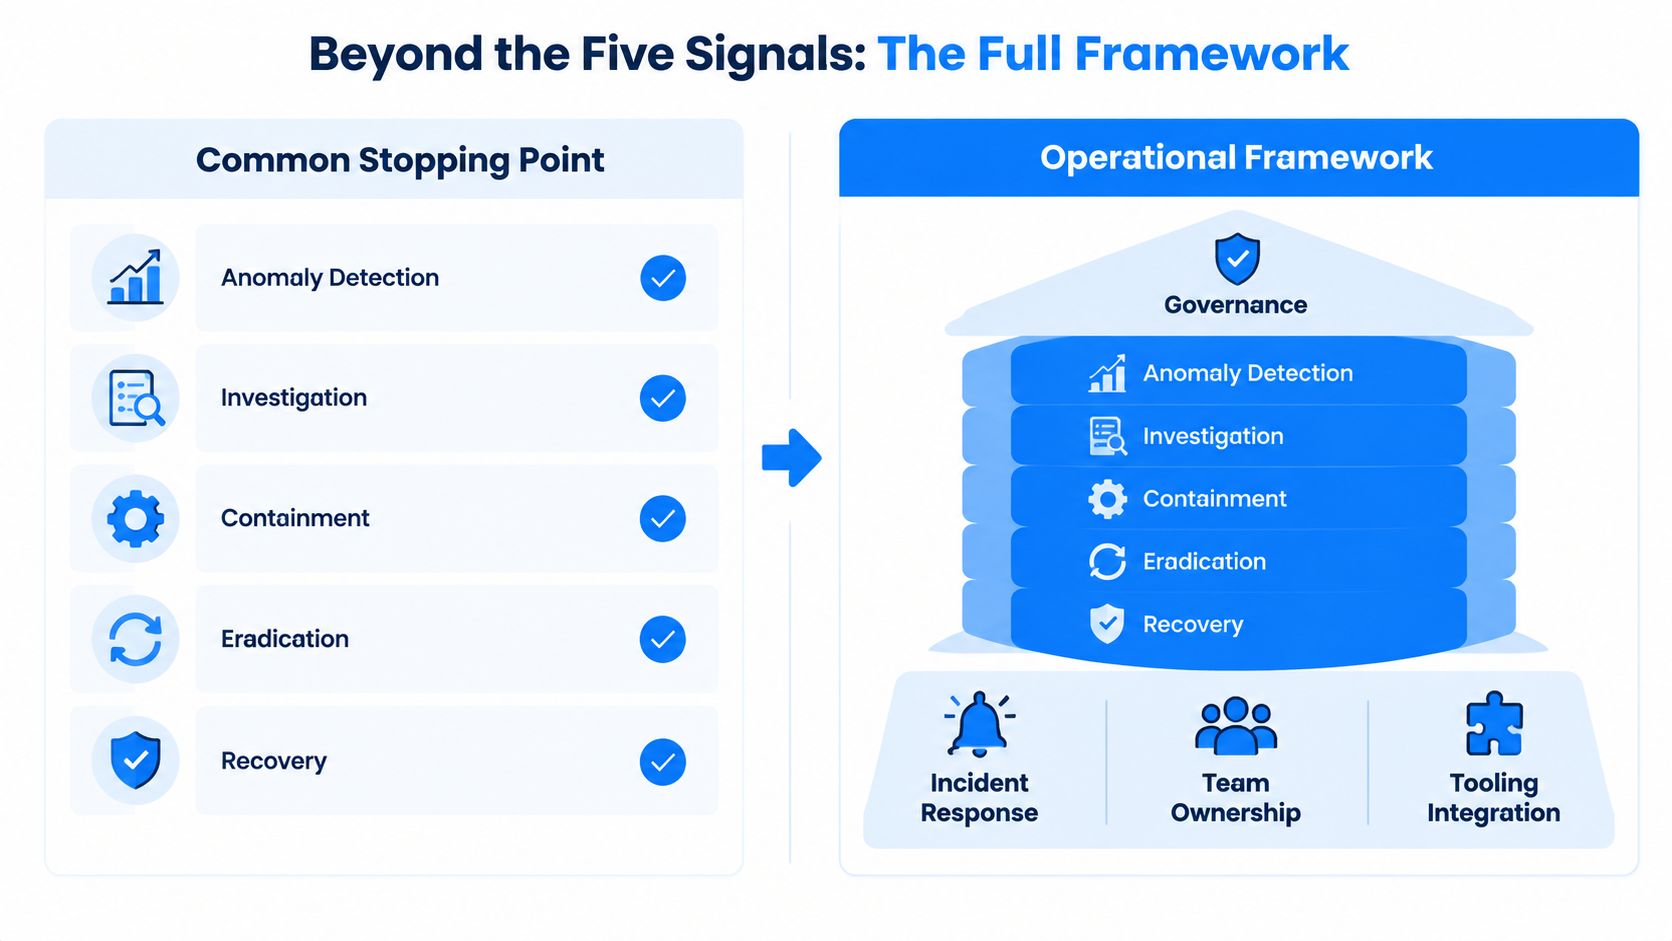
Die fünf Signale werden oft fälschlicherweise für ein fertiges Framework gehalten. Sie bilden jedoch nur die Telemetrie-Ebene. Ohne operative Disziplin führt Telemetrie lediglich zu einem gut instrumentierten Scheitern.
Aktualität, Volumen, Verteilung, Schema und Lineage können in einem Dashboard alle grün oder rot leuchten, während es der Organisation dennoch an einem namentlich benannten Verantwortlichen, einem Eskalationspfad, einer Unterdrückungsregel oder einem Runbook zur Behebung fehlt. Es folgt ein bekanntes Fehlermuster: Eine Warnung landet in Slack, niemand hat eine definierte Erwartung zur Triage, der Data-Product-Owner nimmt an, dass die Technik sich darum kümmert, und der Vorfall bleibt offen, bis ein Stakeholder eine falsche Zahl bemerkt.
Erkennung ist nicht dasselbe wie Reaktion
Ein Signal beantwortet eine einzige, eng gefasste Frage: Kam die Tabelle pünktlich an? Hat sich das Zeilenvolumen verändert? Gab es Schema-Drift? Es beantwortet jedoch nicht die operativen Fragen, die den geschäftlichen Einfluss bestimmen:
Wer ist der Eigentümer des Assets?
Wer übernimmt die Triage der Warnung?
Welche Konsumenten sind betroffen?
Welche Reaktionszeit gilt?
Sollte die Pipeline unter Quarantäne gestellt werden, einen erneuten Versuch starten oder fortfahren?
Welche wiederkehrende Ursache erfordert eine architektonische Behebung?
Diese Lücke führt dazu, dass eine signalreiche Umgebung weiterhin fehlerhafte Zahlen an Führungskräfte sendet. Die Organisation hat zwar Sichtbarkeit, aber keine Vereinbarung darüber, welche Maßnahmen diese Sichtbarkeit auslösen soll.
Eine kleinere Monitoring-Struktur kann besser funktionieren, wenn die Zuständigkeiten klar geregelt sind. Ein kritischer Datensatz mit einem dokumentierten Daten-Verantwortlichen, Service-Level-Erwartungen, einem Eskalationskanal und einem getesteten Runbook ist nützlicher als Hunderte von unbesetzten Monitoren. Das Framework bewährt sich, indem es den Weg von einer Anomalie hin zu einer verantwortlichen Handlung verkürzt.
Praktische Regel: Eine Warnmeldung ohne Verantwortlichen, Schweregrad und Reaktionspfad ist lediglich eine Benachrichtigung, kein operatives Steuerungselement.
Die Governance-Ebene ist das fehlende System
Die governance legt fest, welche Abweichungen die Arbeit unterbrechen und welche in einen Trendbericht gehören. Sie definiert Kritikalität, akzeptable Abweichungen, Wartungsfenster, Unterdrückungsregeln, Nachweisaufbewahrung und Eskalationsstufen. Sie erfasst auch, ob ein wiederkehrender Vorfall auf ein temporäres Problem der Quelle oder auf einen Designfehler in der Pipeline zurückzuführen ist.
Die Entwicklung in diesem Bereich spiegelt diese Verschiebung der Verantwortlichkeiten wider. Gartner veröffentlichte am 23. Februar 2026 seinen ersten Market Guide für Data Observability Tools und erkannte Data Observability damit als eigenständige Softwarekategorie für Unternehmen an, die Workflows zur Anomalieerkennung, Alarmierung, Lineage und Incident Response abdeckt (Diskussion von Monte Carlo über den Gartner-Leitfaden). Die entscheidende Änderung ist praktischer Natur: Unternehmen können Observability als Architektur- und governance-Funktion betrachten und nicht mehr nur als eine Sammlung von Monitoring-Skripten.
Was ein Data Observability-Framework tatsächlich ist
Eine praxisnahe Definition beginnt mit dem operativen Zweck. Gartner beschreibt Data Observability-Tools als Hilfsmittel für Organisationen, um den Zustand und die Integrität von Daten, Pipelines, Infrastruktur und finanziellen Betriebskosten in verteilten Umgebungen durch kontinuierliche Überwachung, Verfolgung, Alarmierung, Analyse und Fehlerbehebung zu verstehen (Gartners Definition von Data Observability-Tools).
Aus technischer Sicht ist ein Data Observability-Framework ein mehrschichtiges System, das Datentelemetrie in gelenktes menschliches Handeln übersetzt. Es kombiniert Erkennungssignale, kontextuelle Metadaten, zugewiesene Verantwortlichkeiten, Reaktionsprozesse und Richtlinien, die bestimmen, welche Anomalien wichtig sind und was als Nächstes geschieht. Das Framework agiert als Bindeglied zwischen Roh-Telemetrie und operativen Entscheidungen – ganz ähnlich wie ein Betriebssystem Hardware-Signale, Anwendungen, Berechtigungen und Benutzeraktionen koordiniert.

Vier Ebenen machen das Framework nutzbar
Jede herstellerunabhängige Implementierung benötigt vier Ebenen:
Signalschicht (Signal layer): Freshness, Volumen, Verteilung, Schema, Lineage sowie alle domänenspezifischen Qualitäts- oder Plattformmetriken.
Kontextschicht (Context layer): Kritikalität von Datensätzen, Data Contracts, Eigentumsverhältnisse, nachgelagerte Abhängigkeiten, jüngste Änderungen, Sensitivität und geschäftliche Nutzung.
Reaktionsschicht (Response layer): Weiterleitung von Alarmen, Erstellung von Vorfällen, Triage, Quarantäne, Behebung, Post-Incident-Reviews und Erfassung von Nachweisen.
Governance-Schicht: Richtlinien für SLAs, Schweregrade, Unterdrückung, Zugriff, Aufbewahrung, Eskalation und das Management wiederkehrender Risiken.
Die fünf Signale gehören in die erste Ebene. Sie werden erst dann operativ wirksam, wenn die anderen drei Ebenen Bedeutung und Konsequenzen liefern. Für eine prägnante Einführung zur Risikominderung mit Data Observability ist die wichtigste Erkenntnis, dass Erkennung wertvoll ist, weil sie eine frühere und fundiertere Intervention ermöglicht – und nicht, weil sie ein weiteres Dashboard hinzufügt.
Die Architektur sollte zudem zur Umgebung passen. In regulierten Branchen benötigen Teams Kontrollmechanismen, die über Cloud-, Hybrid- und On-Premises-Systeme hinweg funktionieren, Prüfungsnachweise sichern und unnötige Verschiebungen sensibler Daten vermeiden. Ein Framework kann aus vorhandenen Orchestratoren, Warehouse-Funktionen, Katalogen und Incident-Systemen zusammengestellt oder über eine dedizierte Plattform bereitgestellt werden. Das Design ist dabei wichtiger als der Name des Anbieters.
Teams, die eine Plattform evaluieren, können die Data Observability-Funktionen von digna als ein Beispiel für einen modularen Ansatz heranziehen, der Anomalieerkennung, Timeliness, Validierung und Schema-Tracking mit einer Ausführung direkt in der Datenbank verbindet.
Die fünf Kernsignale und was jedes einzelne erfasst
Die fünf Signale bilden weiterhin das richtige technische Fundament, vorausgesetzt, jedes Signal ist mit einem Fehlerszenario und einer Reaktionsrichtlinie verknüpft. Ein ausgereiftes Framework sammelt Metriken nicht einfach nur deshalb, weil sie verfügbar sind. Es wählt Messungen aus, die aussagekräftige Änderungen direkt an den Daten erkennen können.
Freshness misst den Ankunftszeitpunkt im Vergleich zu einem erwarteten Zeitplan oder SLA. Ein High-Watermark-Zeitstempel kann blockierte Jobs, verworfene Partitionen oder API-Drosselungen offenlegen, die die Datenaufnahme blockieren. Verwenden Sie Perzentile anstelle von Durchschnittswerten bei schwankenden Latenzen, da ein Durchschnittswert seltene Ausreißer am Ende der Verteilung verbergen kann, die sich auf die Nutzer auswirken. Praktische Anleitungen zur Timeliness sollten zwischen verspäteten, fehlenden und unerwartet frühen Lieferungen unterscheiden, wie in Metriken und Monitoring der Data Timeliness erläutert.
Volumen vergleicht Zeilenanzahlen, Byte-Größen oder Partitionsgrößen mit erwarteten Bereichen. Es fängt unvollständig geladene Daten, doppelte Schreibvorgänge durch erneute Versuche und unbemerkt im Hintergrund ablaufende Backfill-Schleifen ab. Ein Bereich muss normales Wachstum und Saisonalität berücksichtigen, da der Monitor sonst routinemäßige geschäftliche Veränderungen als Störsignal interpretiert.
Verteilung (Distribution) untersucht das statistische Verhalten in numerischen Feldern sowie die Häufigkeit von Kategorien in Dimensionen. Statistiken über rollierende Zeitfenster und Z-Scores können Abweichungen (Drift) aufdecken, die beim Gesamtvolumen nicht auffallen, wie etwa vorgelagerte Zuordnungsfehler oder veränderte Sensorkalibrierungen. Verteilungsprüfungen benötigen datensatzspezifische Baselines, da Produktionsmetriken saisonal, volatil, multivariat und von Systemwechseln betroffen sein können. Der BOOM-Benchmark von Datadog veranschaulicht diese Modellierungsherausforderung mit 350 Millionen Beobachtungen in 2.807 realen Produktionszeitreihen, die über mehrere Prognosehorizonte hinweg ausgewertet wurden (Datadogs Diskussion über den BOOM-Benchmark).
Schema validiert die Struktur gegen einen erwarteten Contract. Hinzugefügte oder entfernte Spalten, geänderte Datentypen und veränderte Nullbarkeiten können Transformationen beschädigen, ohne die Datenaufnahme zu stoppen. Schema-Drift ist besonders gefährlich, wenn ein Quell-Team ein Feld von „nullable“ auf „non-nullable“ ändert oder eine Spalte entfernt, die nachgelagertes SQL weiterhin erwartet.
Lineage stellt den Abhängigkeitsgraphen von der Quelle bis zur Nutzung dar. Sie legt verwaiste Datensätze, fehlerhafte Verknüpfungen nach Refactorings und nicht gemeldete vorgelagerte Abkündigungen (Deprecations) offen. Spalten-Lineage ist besonders nützlich, wenn ein geändertes Feld in eine kleine Anzahl kritischer Metriken innerhalb einer viel größeren Tabelle einfließt.
Signal | Erkanntes Fehlerszenario | Erkennungsmechanismus |
|---|---|---|
Freshness | Verspätete, fehlende, blockierte oder unerwartet frühe Datenlieferungen | Zeitstempel-Verzögerung gegenüber einem SLA, Zeitplan oder einer gelernten Baseline |
Volumen | Unvollständige Ladevorgänge, doppelte Schreibvorgänge und Backfill-Schleifen | Vergleich von Zeilenanzahl, Byte-Größe und Partitionsgröße |
Verteilung | Statistische Abweichungen, Zuordnungsfehler und Verschiebungen bei Kategorien | Statistiken über rollierende Zeitfenster, Häufigkeitsanalysen und Z-Scores |
Schema | Hinzugefügte, entfernte, typgeänderte oder vertragsverletzende Felder | Struktureller Vergleich mit registrierten Erwartungen |
Lineage | Fehlerhafte Abhängigkeiten, verwaiste Assets und verborgene Auswirkungen (Blast Radius) | Kontinuität des Abhängigkeitsgraphen und Auswirkungsanalyse |
Diese Signale lassen sich relativ einfach implementieren. Schwieriger wird es, sie zu pflegen, wenn für jede Tabelle dieselben Erwartungen gelten. Teilen Sie kritische Assets in Stufen ein, definieren Sie unterschiedliche Richtlinien für den Schweregrad und lassen Sie weniger kritische Anomalien in Berichten zusammenfassen, anstatt einen Bereitschaftstechniker zu alarmieren. Nicht die Erkennung, sondern die Governance ist der kostenintensive Teil, der Observability wirklich nützlich macht.
Rollen und Governance im Framework
Ein Framework ohne feste Zuständigkeiten ist nur ein Dashboard, auf das niemand reagiert. Das sauberste Betriebsmodell trennt Erkennung, Triage und Behebung und gestaltet die Übergabe transparent.
Data-Platform-Engineers oder Site-Reliability-Engineers betreiben in der Regel die Monitoring-Infrastruktur und erkennen technische Anomalien. Data-Product-Owner übernehmen die Triage dieser Anomalien, da sie die geschäftliche Bedeutung, die Konsumenten und das normale Verhalten des Assets verstehen. Die Behebung erfordert oft sowohl Data Engineers, die die Ingestions- oder Transformations-Pipelines reparieren, als auch Analytics Engineers, die die Metrik-Logik oder semantische Modelle korrigieren.
Verantwortlichkeit direkt im Asset verankern
RACI-Matrizen helfen bei der Einführung, verlieren nach Reorganisationen jedoch oft an Aktualität. Die Zuständigkeit sollte direkt im Data Contract oder in den Metadaten des Katalogs verankert sein, die mit dem Asset verknüpft sind. Jeder kritische Datensatz sollte mindestens Folgendes definieren:
Verantwortlicher Daten-Steward: Die Person oder das Team, die für das Datenprodukt verantwortlich ist.
Service-Erwartung: Die Erwartungen an Aktualität, Vollständigkeit und Verfügbarkeit, auf die sich die Konsumenten verlassen können.
Bereitschafts-Pfad: Der Kanal oder der Incident-Dienst, der handlungsrelevante Warnungen empfängt.
Kritikalität: Die geschäftliche Einstufung, die Schweregrad und Eskalation bestimmt.
Runbook: Die ersten Schritte zur Diagnose und Behebung.
Ein P1-Vorfall, der ein Dashboard für die Geschäftsleitung betrifft, sollte die normale Warteschlange umgehen und innerhalb von 15 Minuten bei einem definierten Bereitschaftstechniker eingehen. Diese Erwartung an die Reaktionszeit ist eine operative Richtlinie, keine Eigenschaft des Erkennungstools. Die Richtlinie muss auch festlegen, wer Daten unter Quarantäne stellen darf, wer einen Backfill genehmigt und wer mit den Konsumenten kommuniziert.
Modul | Inhaber Erkennung | Inhaber Triage | Inhaber Behebung |
|---|---|---|---|
Aktualität der Datenaufnahme | Data-Platform oder SRE | Data-Product-Owner | Data Engineer und Eigentümer der Quelle |
Schema Contract | Ingestions- oder Plattform-Team | Data-Product-Owner | Quell-Entwickler und Data Engineer |
Verteilung der Metriken | Observability-Verantwortlicher | Analytics Engineer | Analytics Engineer und Data Engineer |
Auswirkung auf die Lineage | Katalog- oder Plattform-Team | Steward und betroffene Eigentümer | Zuständige Engineering-Teams |
Incident-Workflow | SRE oder Data-Operations | Incident-Commander | Zugewiesener technischer Problemlöser |
Die typischen Fehlerstellen sind vorhersehbar. Ingestion-Ebenen haben oft keinen dauerhaften Eigentümer, Reorganisationen hinterlassen verwaiste Assets, und durch die Schnittstelle zwischen Data Engineering und Analytics Engineering bleibt semantischer Drift bestehen, weil jede Gruppe annimmt, die andere sei für die Metrik zuständig. Ein klares Rollenmodell für die Data Governance hilft hierbei, aber der Vertrag und der Eskalationspfad müssen im täglichen Betrieb auch konsequent durchgesetzt werden.
Integrationspunkte über Pipelines, Warehouses und BI hinweg
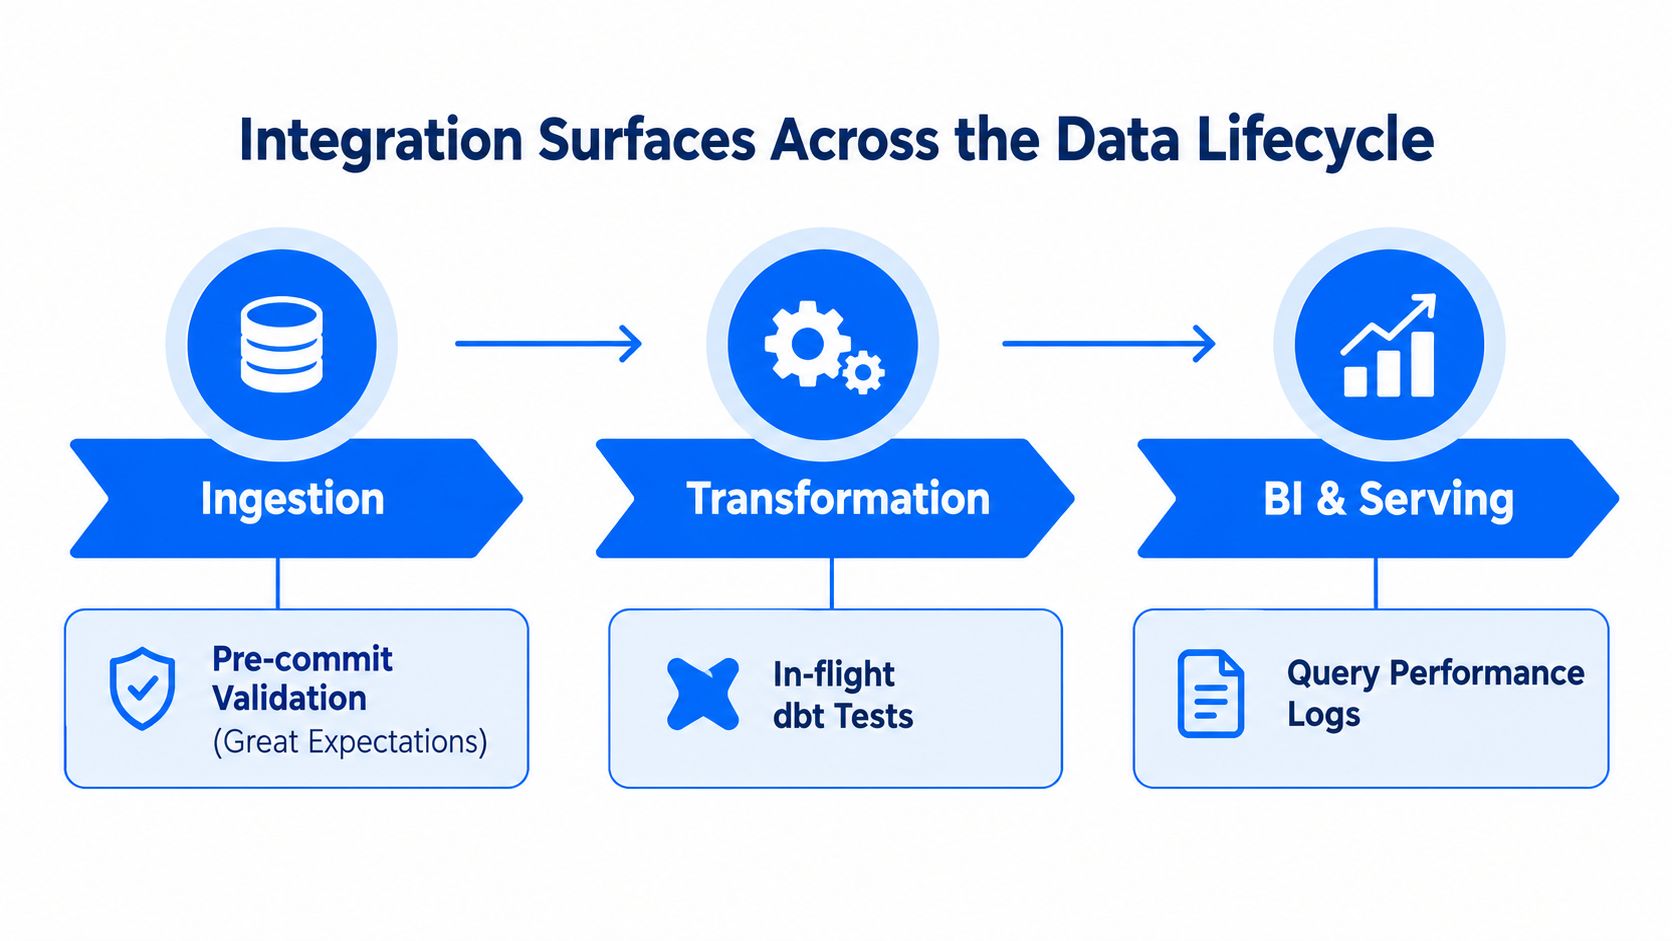
Observability funktioniert nur dort, wo Telemetriedaten erfasst werden. Ein Framework, das zwar das Warehouse überwacht, aber die Ingestion, Orchestrierung, semantischen Modelle oder Reverse-ETL-Pfade ignoriert, hat blinde Flecken, die fälschlicherweise wie Zuverlässigkeit aussehen.
Integrieren Sie bei der Ingestion eine Pre-Commit-Schema-Validierung in die Quell-Adapter und Deployment-Prüfungen. Great Expectations kann explizite Erwartungen validieren, während ein Schema-Vergleich (Diffing) eingehende Strukturen mit registrierten Verträgen abgleichen kann. Geben Sie das Ergebnis als Validierungsereignis aus, das das Asset, die Version, die geänderten Felder und den Deployment-Kontext enthält. Die darauf reagierende Warnmeldung sollte fehlerhafte Änderungen an die Quell- und nachgelagerten Eigentümer weiterleiten, bevor die neue Struktur die Produktion erreicht.
Nutzen Sie während der Transformation dbt-Tests, Airflow-Sensoren, Dagster-Asset-Checks oder Prefect-Timeouts an der Stelle, an der die Pipeline erkennt, ob eine Aufgabe abgeschlossen wurde und ob deren Ausgabe nutzbar ist. Übergeben Sie Ausführungsstatus, Dauer, Ausgabe-Zeitstempel, Zeilenanzahl und Fehlerkontext an einen gemeinsamen Telemetrie-Speicher. Ein Orchestrierungsfehler sollte einen einzigen Vorfall mit Abhängigkeitskontext erzeugen und nicht separate Warnmeldungen für jede nachgelagerte Aufgabe.
Kontext in die Warehouse- und BI-Ebene übertragen
Der Abfrageverlauf des Warehouses kann Verteilungsänderungen, ungewöhnliche Nutzungsmuster, teure Scans und Workloads aufdecken, die den erwarteten Transformationspfad umgehen. Diese Metriken sollten direkt neben den Datenintegritätssignalen abgelegt werden, damit Plattform-Teams eine Datenanomalie mit einer kürzlichen Abfrage, einem Deployment oder einer Workload-Änderung verknüpfen können.
Die BI-Ebene erfordert einen Abgleich, nicht nur den Pipeline-Status. Vergleichen Sie die Ausgaben semantischer Modelle mit den Tabellen der Single Source of Truth, validieren Sie Metrikdefinitionen und überwachen Sie, ob der Aktualisierungsstatus eines Dashboards den veröffentlichten Erwartungen entspricht. Die Geschäftslogik driftet oft ab, selbst wenn die rohen Transformationen technisch fehlerfrei bleiben.
Lineage-Integrationen mit DataHub, Atlan oder Unity Catalog machen den betroffenen Bereich (Blast Radius) schnell berechenbar. Integrieren Sie unmanaged SQL-Skripte, Reverse-ETL-Feeds in operative Systeme und Definitionen semantischer Schichten im Graphen, wo immer dies möglich ist. Ein Integrationsansatz für Data Warehouses sollte den Metrikfluss von Quellprüfungen über Transformationsereignisse bis hin zum BI-Abgleich aufrechterhalten.
Das Ziel ist eine einheitliche Incident-Timeline. Eine Schemaänderung, eine fehlgeschlagene Aufgabe, eine Volumenanomalie, ein betroffenes Dashboard, der Eigentümer und das Behebungsereignis sollten als ein zusammenhängender Datensatz erscheinen und nicht als Fragmente über Monitoring-, Katalog-, Orchestrierungs- und Chat-Tools verteilt sein.
Ein vierstufiges Reifegradmodell zur Selbsteinschätzung
Reifegradmodelle werden zu reinen Prestigeübungen, wenn sie lediglich die Installation von Tools messen, anstatt das tatsächliche operative Verhalten zu bewerten. Die entscheidende Frage auf jeder Stufe ist nicht, ob eine Funktion existiert, sondern ob das Team nachweisen kann, dass die Beteiligten konsistent darauf reagieren.
Vier Phasen der operationalen Reife
Stufe 1: Reaktiv. Stakeholder entdecken Probleme, indem sie sich über Dashboards oder Berichte beschweren. Fragen Sie sich, ob das Team die Zeit bis zur Behebung von Vorfällen (Incident Resolution Time) überhaupt misst. Wenn niemand sagen kann, wann ein Vorfall begann, wer dafür verantwortlich war oder wann er geschlossen wurde, arbeitet das Programm reaktiv – unabhängig davon, wie viele Prüfungen eingerichtet sind.
Stufe 2: Proaktiv. Automatisiertes Monitoring von Aktualität und Schema deckt kritische Pipelines ab, aber die Abdeckung bleibt unvollständig und die Zuständigkeiten sind informell. Fragen Sie sich, wie hoch der Anteil der Tier-1-Assets mit einem deklarierten SLA und einem benannten Steward ist. Erfordert die Antwort eine manuelle Recherche, verfügt das Unternehmen zwar über eine Erkennung, aber nicht über eine verlässliche Verantwortlichkeit.
Stufe 3: Operational. Signale, Lineage und Incident Response sind standardisiert. Warnmeldungen beziehen sich auf Data Contracts, Schweregradregeln und Eigentümer, während das Team die Kosten für Observability und wiederkehrende Fehler erfasst. Fragen Sie sich, ob Fehler bei nicht-kritischen Assets immer noch zu einer Flut von Warnmeldungen führen. Wenn ja, hat das Programm noch keine prioritätsbasierte Governance etabliert.
Stufe 4: Embedded. Observability ist fester Bestandteil des Data SDLC. Contract-Tests, Policy-as-Code, Schemaprüfungen und Deployment-Sperren verhindern Regressionen, bevor sie in die Produktion gelangen. Fragen Sie sich, ob Teams routinemäßig Änderungen ohne Qualitätsverluste bei der Observability veröffentlichen können. Ausgereifte Teams machen fehlerhafte Deployments schwer möglich, da Verträge und Prüfungen fest in den Bereitstellungsprozess integriert sind.
Stufe | Diagnostische Frage | Operatives Merkmal |
|---|---|---|
Reaktiv | Wird die Zeit bis zur Behebung von Vorfällen gemessen? | Stakeholder melden Fehler erst nach dem Auftreten von Problemen |
Proaktiv | Welche Tier-1-Assets haben deklarierte SLAs? | Automatische Prüfungen in kritischen Pipelines sind vorhanden |
Operational | Führen Fehler mit geringer Kritikalität immer noch zu einer Flut an Warnmeldungen? | Standardisierte Signale, Lineage, Verantwortlichkeiten und Reaktionen |
Embedded | Können Teams ohne Qualitätsverluste bei der Observability deployen? | Verträge und Richtlinien-Schranken laufen direkt im SDLC |
Teams bleiben oft auf dem Weg von der Einführung hin zur operativen Disziplin stecken. Sie kaufen ein Tool, bevor sie Assets klassifizieren, richten pauschale Schwellenwerte ein und feiern die Anzahl der Monitore, während die Zuständigkeiten unklar bleiben. Ein strukturiertes Reifegradmodell für Datenqualität ist nur dann nützlich, wenn jede Stufe Nachweise aus Vorfällen, Verträgen und dem tatsächlichen Reaktionsverhalten verlangt.
Eine 90-Tage-Roadmap für den Einstieg im Jahr 2026
Ein Team mit begrenzten Ressourcen muss nicht am ersten Tag jeden einzelnen Datensatz instrumentieren. Es benötigt einen klar umrissenen Kontrollregelkreis, der Eigentumsverhältnisse nachweist, nützliche Signale liefert und einen wiederholbaren Incident-Prozess etabliert.
Tag 1 bis 30: Zuständigkeiten festlegen
Beginnen Sie mit den 20 umsatzrelevantesten Datensätzen, von denen die Geschäftsführung, die Finanzabteilung, Kunden oder der Kernbetrieb abhängen. Weisen Sie jedem Datensatz einen verantwortlichen Eigentümer zu, dokumentieren Sie dessen Kritikalität sowie das erwartete Lieferverhalten und richten Sie einen Slack-Kanal als zentrale Anlaufstelle für Vorfälle ein. Der Kanal ersetzt zwar kein Incident-System, bietet dem Team aber einen gemeinsamen Kommunikationsweg, während der Workflow reift.
Erfassen Sie für jedes Asset die aktuellen Fehlerszenarien, nachgelagerte Konsumenten, Eskalationskontakte und ein minimales Runbook. Verzichten Sie vorerst auf ein breites Monitoring. Stellen Sie zunächst sicher, dass jede zukünftige Warnmeldung auch einen Empfänger hat.
Tag 31 bis 60: Leichtgewichtige Erkennung hinzufügen
Integrieren Sie Aktualitäts- und Volumenprüfungen in den bestehenden Orchestrator. Fügen Sie eine Schema-Diffing-Prüfung bei der Datenaufnahme hinzu und senden Sie Fehlerberichte direkt mit Angaben zu Asset, Eigentümer, erwartetem und tatsächlichem Verhalten sowie dem mutmaßlichen Abhängigkeitskontext. Führen Sie eine wöchentliche Überprüfung der Datenqualität durch, bei der ungelöste Warnmeldungen, wiederkehrende Ursachen und unberücksichtigte Monitore analysiert werden.
Vermeiden Sie pauschale Schwellenwerte. Eine feste Regel für alle Tabellen erzeugt Störsignale, da Tabellen unterschiedliche Zeitpläne, Wachstumsmuster und geschäftliche Auswirkungen haben. Beginnen Sie mit expliziten Erwartungen für kritische Datensätze und nutzen Sie historische Erfahrungswerte, wo das Verhalten variiert.
Tag 61 bis 90: Den Regelkreis schließen
Fügen Sie Lineage für kritische Spalten hinzu und definieren Sie SLOs auf Datensatzebene. Dokumentieren Sie den Unterschied zwischen automatischer Quarantäne und menschlicher Eskalation. Ein fehlerhafter Batch kann sicher unter Quarantäne gestellt werden, während eine verzögerte regulatorische Datenlieferung eine sofortige Benachrichtigung des Eigentümers und eine Kommunikation an das Business erfordert.
Die zwei typischen Fallstricke bei der Einführung sind Fluten von Warnmeldungen und verwaiste Datensätze. Unterdrücken oder aggregieren Sie Anomalien mit geringem Schweregrad und weigern Sie sich, ein Asset ohne benannten Verantwortlichen aufzunehmen. Das Ergebnis sollte ein kleines, aber vollständiges Framework sein – eine Erkennung, die direkt mit Eigentumsverhältnissen, Reaktionen, Nachweisen und Reviews verknüpft ist.
Häufige Fragen, die sich Käufer und Architekten stellen
Was sollte Eigenentwicklung vs. Kauf kosten?
Die Entscheidung hängt von den Engineering-Kapazitäten, der Integrationstiefe, der Abdeckung und den Service-Erwartungen ab. Ein Open-Source-Stack mit Tools wie Great Expectations, OpenLineage und Marquez kann die Lizenzgebühren senken, allerdings verbleiben Bereitstellung, Upgrades, Konnektoren, Metadatenqualität, Alarmweiterleitung und Incident-Workflows vollständig in der Verantwortung des eigenen Teams.
Kommerzielle Plattformen reduzieren diesen internen Arbeitsaufwand im Tausch gegen Lizenzkosten und eine gewisse Anbieterabhängigkeit. Vergleichen Sie den gesamten Betriebsaufwand und nicht nur den reinen Abonnementpreis. Berücksichtigen Sie die Entwicklungszeit, die Infrastruktur, Datenbewegungen, Sicherheitsprüfungen, den Support sowie die operativen Kosten für fehlerhafte oder unvollständige Warnmeldungen.
Die vorliegenden Umfrageergebnisse aus dem Jahr 2026 zeigen, warum dieser Abwägungsprozess genau analysiert werden sollte. Laut einer Umfrage von Grafana Labs nannten 38 % der Befragten Komplexität und Overhead als ihre größte Sorge bei der Observability, während 30 % die Flut an Warnmeldungen als Haupthindernis für eine schnellere Reaktion auf Vorfälle identifizierten (Grafana Labs Observability-Umfrage). Betrachten Sie diese Zahlen als Planungssignale und nicht als automatisches Argument für eine Eigenentwicklung oder einen Kauf.
Das Framework muss auch Kontrollmechanismen berücksichtigen, die in einer Produktdemonstration eventuell nicht direkt sichtbar sind. Fragen Sie nach, wer die Regeln pflegt, wer für fehlgeschlagene Prüfungen verantwortlich ist, wie Nachweise aufbewahrt werden und ob das Betriebsmodell auch dann funktioniert, wenn die Plattform einmal nicht verfügbar ist.
Welche Anbieterfunktionen sind entscheidend?
Evaluieren Sie den Erkennungs- und Reaktionspfad, bevor Sie das Dashboard-Design beurteilen:
Log-basierte vs. abfragebasierte Erkennung: Logs liefern Kontext zu Pipeline-Ereignissen, während Abfragen das tatsächliche Verhalten im Warehouse analysieren. Viele Infrastrukturen benötigen beides.
Spalten-Lineage: Graphen auf Tabellenebene reichen für die Auswirkungsanalyse regulierter Metriken oft nicht aus.
Native Warehouse-Unterstützung: Stellen Sie sicher, dass die Prüfungen in den Systemen, die die Daten halten, effizient ausgeführt werden.
Zuständigkeitssteuerung: Prüfen Sie, ob die Plattform Vorfälle aktiv weiterleitet und eskaliert oder lediglich Anomalien anzeigt.
Wirtschaftlichkeit: Prüfen Sie, ob sich die Preise nach Scans, Warnmeldungen, API-Aufrufen, Tabellen, Modulen oder dem Nutzungsvolumen richten.
Kontrolle über das Deployment: Private-Cloud- und On-Premises-Optionen sind wichtig, wenn Produktionsdaten die Umgebung des Kunden nicht verlassen dürfen.
Ein Dashboard ist kein Betriebsmodell. Ein Framework benötigt Erkennung, Verantwortlichkeit, Eskalation, Nachverfolgbarkeit und Reviews, die über diese Funktionen miteinander verbunden sind.
Wie lange dauert es, bis eine sinnvolle Abdeckung erreicht ist?
Eine sinnvolle Abdeckung einer mittelgroßen Infrastruktur dauert sechs bis neun Monate, nicht sechs Wochen. Erste Schritte können ausgewählte Assets schnell schützen, aber eine nachhaltige Abdeckung erfordert Klassifizierung, Verträge, Lineage, die Bereinigung von Zuständigkeiten, Reaktionsprozesse und die Integration über Ingestions-, Transformations-, Warehouse- und BI-Ebenen hinweg.
Dimension | Open-Source-Stack | Kommerzielle Plattform |
|---|---|---|
Initiale Lizenzierung | Oft gering oder kostenfrei | Abonnement- oder Plattformgebühren |
Zuständigkeit im Engineering | Hoch, einschließlich Betrieb und Wartung | Wird je nach Service mit dem Anbieter geteilt |
Anpassbarkeit | Umfassende Kontrolle über Code und APIs | Abhängig von Produktfunktionen und Erweiterungen |
Integrationsaufwand | Das Team erstellt und pflegt Konnektoren selbst | Anbieter stellt oft native Integrationen bereit |
Governance-Workflow | Meist aus separaten Komponenten zusammengestellt | Teilweise enthalten, muss jedoch verifiziert werden |
Kontrolle über das Deployment | Vollständige Kontrolle in der eigenen Infrastruktur | Abhängig vom Hosting- und Bereitstellungsmodell |
Ein maßgeschneidertes Framework eignet sich für Infrastrukturen mit speziellen Audit-Anforderungen, starker Nutzung von Dagster oder Airflow oder Data-Mesh-Grenzen, bei denen die Lineage von Standardanbietern nicht tief genug reicht. Eine kommerzielle Plattform eignet sich für Teams, die eine schnellere Integration, verlässlichen Support und eine gepflegte Betriebsebene benötigen. Treffen Sie die Entscheidung anhand der erforderlichen Kontrollen, Eigentumsverhältnisse und Reaktions-Workflows, nicht nach der optischen Attraktivität des Dashboards.
digna bietet eine modulare Plattform für Datenqualität und Observability, die innerhalb der Cloud, VPC oder des Rechenzentrums des Kunden läuft. Sie bietet In-Database-Ausführung für Anomalieerkennung, Timeliness-Monitoring, Validierung auf Datensatzebene, Schema-Tracking und Plattformmetriken. Teams, die eine geregelte Observability für regulierte Pipelines oder KI-Workloads konzipieren, können digna mit ihrer bestehenden Architektur vergleichen.
Häufig gestellte Fragen
Was ist ein Data-Observability-Framework?
Ein geschichtetes System, das Datentelemetrie in geregeltes menschliches Handeln überführt. Vier Ebenen machen es nutzbar: eine Signalebene, eine Kontextebene mit Kritikalität und Verantwortung, eine Reaktionsebene für Triage und Behebung sowie eine Governance-Ebene mit SLAs, Schweregrad, Unterdrückung und Eskalation.
Warum bleiben die meisten Programme bei den fünf Signalen stehen?
Weil Erkennung keine Reaktion ist. Aktualität, Volumen, Verteilung, Schema und Lineage können grün oder rot leuchten, während niemand Verantwortung, Eskalationsweg, Unterdrückungsregel oder Runbook benannt hat. Ein Alert ohne Verantwortung, Schweregrad und Reaktionsweg ist eine Benachrichtigung, keine operative Kontrolle.
Ist Data Observability inzwischen eine anerkannte Softwarekategorie?
Ja. Gartner veröffentlichte am 23. Februar 2026 seinen ersten Market Guide for Data Observability Tools, der Anomalieerkennung, Alerting, Lineage und Incident-Response-Workflows abdeckt. Eine Marktstudie aus 2026 schätzt ein Wachstum von 3,51 Milliarden USD im Jahr 2026 auf 6,03 Milliarden USD bis 2031.
Was erfasst jedes der fünf Signale?
Aktualität misst den Ankunftszeitpunkt gegen Zeitplan oder SLA, Volumen vergleicht Zeilenzahlen und Partitionsgrößen mit erwarteten Bereichen, Verteilung betrachtet statistisches Verhalten und Kategoriehäufigkeiten, Schema prüft die Struktur gegen einen Vertrag, und Lineage bildet den Abhängigkeitsgraphen von der Quelle bis zum Konsum ab.
Bringt ein größeres Monitoring-Setup mehr Verlässlichkeit?
Nicht von allein. Ein kleineres Setup kann besser abschneiden, wenn Verantwortung explizit ist, denn der Engpass liegt meist in der Governance und nicht in der Abdeckung. Koppeln Sie jedes Signal an einen Fehlermodus und eine Reaktionsrichtlinie, bevor Sie das nächste ergänzen.


