10 Bigeye-Alternativen für Data Observability
|
7
min. Lesezeit

Die Wahl einer Bigeye-Alternative allein auf der Grundlage der Erkennung von Datenanomalien zu treffen, wiederholt das Problem, das Käufer zu lösen versuchen. Die meisten etablierten Plattformen können ungewöhnliche Volumen, Aktualität, Schemata oder Verteilungsverhalten identifizieren. Sie unterscheiden sich deutlicher darin, wo Prüfungen ausgeführt werden, wie Teams Datensätze validieren, wie Lineage und Pipelines abgedeckt sind, wie Warnmeldungen in operative Workflows einfließen, wie die Preisgestaltung skaliert und wie viel Infrastrukturkontrolle der Kunde behält.
Diese Unterscheidung ist wichtig, da Observability-Teams immer noch viel Zeit damit verbringen, zu reagieren, nachdem Benutzer auf fehlerhafte Daten gestoßen sind. Eine Umfrage unter Datenmanagement-Verantwortlichen ergab, dass nur 7 % Datenprobleme lösen, bevor Benutzer davon betroffen sind, während 39 % ihrer Zeit zu 20–40 % mit der Behebung von Pipeline-Problemen verbringen. Dieselbe Studie ergab, dass 51 % einige Stunden und 36 % einige Tage oder länger benötigen, um einen einzelnen Vorfall zu beheben. Dies macht Prävention, Untersuchungsgeschwindigkeit und die Passgenauigkeit bei der Bereitstellung wichtiger als eine lange Funktionsliste. (CDO Magazine's summary of the Kensu report)
Der folgende Vergleich bewertet zehn Bigeye-Alternativen anhand praktischer Unternehmenskriterien: Datenstandort, Erkennung von Datenanomalien, Validierung, Timeliness, Schema-Überwachung, Bereitstellung, Preissignale und Migrationsaufwand. Er ordnet jede Option zudem den modularen Funktionen von digna zu, damit Teams eine breite SaaS-Observability-Suite von einer In-Database-Plattform unterscheiden können, die für Private-Cloud-, VPC- oder On-Premises-Betrieb konzipiert ist.
Inhaltsverzeichnis
1. digna
Wo digna am besten passt
2. Monte Carlo Data
Der Kompromiss gegenüber der In-Database-Kontrolle
3. Acceldata
Breite Abdeckung versus fokussierte Einführung
4. Anomalo
Die Erkennung von Anomalien ist nicht die gesamte Steuerungsebene
5. Soda
Wo die Eigenverantwortung für Regeln eine Rolle spielt
6. Metaplane jetzt Teil von Datadog
Schneller Start, engerer Unternehmensperimeter
7. IBM Data Observability by Databand
Die Eignung hängt von Eigenverantwortung und Beschaffung ab
8. Lightup
Automatische Aktivierung versus kontrollierter modularer Rollout
9. Telmai
Offene Formate verändern den Migrationstest
10. Kensu
Instrumentierungstiefe versus datenresidente Ausführung
Top 10 Bigeye-Alternativen: Funktionsvergleich
Machen Sie die Shortlist zu einer sicheren Migrationsentscheidung
1. digna
digna ist die stärkste Wahl, wenn Bereitstellungskontrolle und Datenresidenz neben der Observability-Abdeckung an erster Stelle stehen. Es läuft in der eigenen Umgebung des Kunden, einschließlich einer Private Cloud, VPC oder eines On-Premises-Rechenzentrums, und führt Metrikberechnungen und Prüfungen direkt in den Datenbanken des Kunden durch. Diese Architektur belässt die Produktionsdaten vor Ort, reduziert unnötige Datenbewegungen und unterstützt die governance-Anforderungen für sensible Finanz-, Gesundheits-, Telekommunikations- und Behördendaten. Die Anleitung zur In-Database-Überwachung unterstützt dieses Modell, da Prüfungen dort ausgeführt werden können, wo die Daten liegen, anstatt sensible Datensätze an andere Orte zu kopieren. (Dignas Anleitung zur Überwachung der Datenqualität)
Die Plattform kombiniert automatische Erkennung mit deterministischen Kontrollen. Data Anomalies lernt normales Verhalten und identifiziert kontinuierlich ungewöhnliche Änderungen, ohne dass Teams jede Überwachungsregel selbst schreiben müssen. Timeliness lernt erwartete Liefermuster und meldet fehlende, verspätete oder verfrühte Eingänge. Data Validation wendet Geschäftsregeln auf Datensatzebene an, während der Schema Tracker strukturelle Änderungen wie hinzugefügte oder entfernte Spalten und geänderte Datentypen erkennt. Data Analytics ergänzt dies um historische Trend- und Volatilitätsanalysen, die Teams dabei helfen, ein einmaliges Ereignis von einem sich verschlechternden Zuverlässigkeitsmuster zu unterscheiden.
Wo digna am besten passt
Das modulare Design von digna ermöglicht es einem Team, mit einer einzelnen Funktion zu beginnen und diese im Zuge der Weiterentwicklung des Betriebsmodells zu erweitern. Der Scheduler, das Datenverzeichnis, Integrationen und Kollaborationsfunktionen sind ab der ersten Modulauswahl verfügbar, und ein gemeinsames Dashboard bietet Dateningenieuren, Analysten und Stakeholdern eine einheitliche Sicht auf Vorfälle, Trends und Status. Der Anbieter gibt an, dass die Installation bis zu den ersten Erkenntnissen weniger als zwei Stunden dauert – eine Behauptung, die dennoch an den Berechtigungen, der Datenbanktopologie und den Sicherheitsprüfungen des Käufers gemessen werden sollte.
Die Preisgestaltung basiert auf einer Grundgebühr zuzüglich einer Gebühr pro aktiver Tabelle und Modul. Das Modell verzichtet auf API-, Scan-Volumen- oder Warnungs-Volumen-Gebühren, was dem Einkauf ein klareres Nutzungssignal gibt als eine Preisgestaltung, die sich mit jeder Abfrage oder Benachrichtigung ändert. Der Kompromiss besteht darin, dass eine sehr große Tabellenlandschaft eine sorgfältige Dimensionierung erfordern kann und eine private Bereitstellung die Verantwortung für Infrastruktur, Berechtigungen und Wartung auf den Kunden überträgt.
Praktische Regel: Wählen Sie digna, wenn der Verbleib der Daten in Ihrer Umgebung eine Grundvoraussetzung ist, und validieren Sie die Gesamtkosten anhand der aktiven Tabellen und ausgewählten Module vor der Vertragsunterzeichnung.
Siehe die digna Data Observability-Plattform für das Architektur- und Modulmodell.
Vorteile: In-Database-Ausführung, private Bereitstellung, KI-gestützte Überwachung von Datenanomalien und Timeliness, Validierung auf Datensatzebene, Schema-Tracking, gemeinsame Workflows und modulare Lizenzierung.
Nachteile: Die Preisgestaltung pro aktiver Tabelle und Modul erfordert eine Dimensionierung bei großen Datenbeständen, und eine private Bereitstellung verlangt interne operative Eigenverantwortung.
2. Monte Carlo Data
Monte Carlo Data ist eine umfassende Observability-Suite für Organisationen, die Warehouses, Lakes, ETL-Systeme, BI-Assets sowie KI- oder Agenten-Pipelines überwachen. Die automatisierten Monitore decken Aktualität, Volumen, Schema und Verteilung ab, während auf maschinellem Lernen basierende Anomalieerkennung Abweichungen vom erwarteten Verhalten identifiziert. Lineage auf Spalten- und Dashboard-Ebene verknüpft Vorfälle mit nachgelagerten Assets und hilft Teams, die Auswirkungen über die betroffene Tabelle hinaus abzuschätzen.
Die Plattform unterstützt auch die operative Reaktion. Incident-Triage und die Weiterleitung von Warnmeldungen an Slack, Jira und ähnliche Tools verknüpfen die Erkennung mit Zuständigkeit und Behebung. Dies macht Monte Carlo zu einem Kandidaten für große moderne Daten-Stacks mit vielen Konnektoren und etablierten Workflows. Käufer sollten überprüfen, ob die Lineage die spezifischen Spalten, Dashboards und Pipeline-Stufen erreicht, die von ihren Teams verwendet werden.

Der Kompromiss gegenüber der In-Database-Kontrolle
Das Unterscheidungsmerkmal von Monte Carlo ist die operative Breite. digna verfolgt einen anderen Ansatz, indem es Prüfungen innerhalb der Kundendatenbanken ausführt und die Erkennung von Datenanomalien mit Timeliness, Validierung, Schema-Tracking und historischen Analysen über eine modulare Benutzeroberfläche kombiniert. Die Entscheidung hängt daher vom Betriebsmodell ab: Monte Carlo eignet sich für Teams, die Lineage und Ökosystem-Abdeckung priorisieren, während digna für Teams geeignet ist, die verlangen, dass die Daten in ihrer Umgebung verbleiben.
Bereitstellung und Migration erfordern einen eigenen Machbarkeitsnachweis (Proof of Concept). Teams sollten die Konnektoren-Abdeckung, die Genauigkeit der Lineage, die Zuständigkeit für Warnmeldungen, die Validierungsregeln und den Aufwand für die Übertragung bestehender Bigeye-Monitore testen. Die Preise von Monte Carlo sind nicht öffentlich einsehbar, daher sollte der Einkauf ein Angebot basierend auf dem überwachten Umfang und den Integrationsanforderungen anfordern.
Vorteile: Breite Abdeckung von Konnektoren, End-to-End-Lineage, Incident-Workflows und Abdeckung im Unternehmensmaßstab.
Nachteile: Die Preisgestaltung erfolgt ausschließlich auf Anfrage, und der Funktionsumfang kann die unmittelbaren Anforderungen eines kleineren Teams übersteigen.
Sehen Sie sich diese Monte Carlo Alternative für Enterprise Data Observability an, um die Architektur und den modularen Ansatz mit dem breiteren Betriebsmodell von Monte Carlo zu vergleichen.
3. Acceldata
Acceldata richtet sich an heterogene Umgebungen, in denen die Datenqualität nur ein Teil der Zuverlässigkeit ist. Sein Umfang erstreckt sich über Datenplattformen, Pipelines, Jobs, Kosten und Leistung, einschließlich Cloud-, On-Premises-, Hybrid-, Hadoop- und umfassenderer Big-Data-Bestände. Das macht es besonders relevant für Plattform-Teams, die Altsysteme modernisieren, ohne jede Arbeitslast vor dem Start von Observability neu zu strukturieren.
Die Plattform organisiert Abläufe nach dem Modell Beobachten, Erkennen, Diagnostizieren und Handeln. In der Praxis sollten Käufer prüfen, wie gut dieser Workflow Qualitätssignale mit der Pipeline-Ausführung, dem Plattformverhalten, der governance und der Optimierung verknüpft. Die Data Observability Cloud von Acceldata bietet produktisierte Workflows und Dokumentation, während die hybride Positionierung einen häufigen blinden Fleck rein Cloud-nativer Tools adressiert.
Breite Abdeckung versus fokussierte Einführung
Acceldata kann eine gute Wahl für große Bestände mit mehreren Technologiegenerationen sein, aber sein Umfang kann die Bedürfnisse eines kleinen Analytics-Teams übersteigen. Die Preisgestaltung ist vertriebsgesteuert und nicht öffentlich, sodass ein Proof of Concept den Bereitstellungsaufwand, die Grenzen der Eigenverantwortung und die Kosten für die Aktivierung von Funktionen umfassen sollte, die das Team möglicherweise nicht sofort nutzt.
digna nähert sich demselben Unternehmensbedarf durch Modularität und In-Database-Ausführung. Die Module Data Anomalies, Timeliness, Data Validation, Schema Tracker und Data Analytics konzentrieren sich auf das Datenverhalten und die Zuverlässigkeit, während die Berechnungen in den Datenbanken des Kunden verbleiben. Acceldata ist der natürlichere Kandidat für die engere Auswahl, wenn Plattformleistung, Infrastruktur und governance in derselben operativen Ansicht liegen müssen. digna ist überzeugender, wenn eine kontrollierte Bereitstellung und eine schrittweise Einführung von Modulen im Vordergrund stehen.
Nutzen Sie Data Observability Tools von digna als Referenzpunkt, wenn Sie die Breite der Plattform mit fokussierter datenresitenter Überwachung vergleichen.
Vorteile: Unterstützung für Hybrid- und On-Premises-Umgebungen, breite Sichtbarkeit der Plattform und kombinierte Observability, governance sowie Optimierung.
Nachteile: Der Umfang kann für kleinere Teams zu groß sein, und die Preisgestaltung erfordert den Kontakt mit dem Vertrieb.
4. Anomalo
Anomalo ist eine KI-native Datenqualitätsplattform, die auf der automatisierten Erkennung von Vorfällen mit minimalem Regelaufwand basiert. Ihr unüberwachter Ansatz ist darauf ausgelegt, abnormales Verhalten bei strukturierten, semistrukturierten und unstrukturierten Daten zu identifizieren und anschließend die Ursachenanalyse zu unterstützen. Das macht sie attraktiv für Teams, die schnell eine Abdeckung für Anomalien wünschen, ohne eine große Bibliothek manuell erstellter Prüfungen pflegen zu müssen.
Der Fokus auf das Ökosystem ist deutlich spürbar. Tiefe Integrationen mit Databricks, Snowflake und Katalogpartnern können Einrichtungshemmnisse reduzieren, wenn diese Systeme bereits das Zentrum des Datenbestands bilden. Enterprise-Bereitstellungsoptionen und Service-Level-Agreements sind verfügbar, aber der Käufer muss dennoch zwischen der Erkennung von Anomalien und einer deterministischen Steuerung unterscheiden. Ein Modell kann zwar erkennen, dass sich ein Datensatz unerwartet geändert hat, eine geschäftskritische Regel erfordert jedoch weiterhin eine explizite Validierungsbedingung.
Die Erkennung von Anomalien ist nicht die gesamte Steuerungsebene
digna deckt denselben anforderungsarmen Anomaliestatistik-Anwendungsfall über Data Anomalies ab, fügt jedoch separate Module für Data Validation, Timeliness und den Schema Tracker hinzu. Diese Trennung ist wichtig für Teams, die sowohl erlernte Baselines als auch auditierbare Geschäftsregeln benötigen. Eine Schema-Drift-Kontrolle vergleicht beispielsweise eine eingehende Struktur mit einer Baseline oder einem Zielschema und warnt, wenn sich Spalten oder Datentypen ändern. (Praktische Anleitung zur Erkennung von Schema-Drift)
Die Preisgestaltung von Anomalo ist nicht öffentlich und erfordert den Kontakt mit dem Vertrieb. Die veröffentlichten Self-Service-Details sind ebenfalls begrenzter als die einiger SaaS-Wettbewerber, sodass die Migrationsplanung eine technische Bewertung, eine Sicherheitsprüfung und eine kaufmännische Analyse umfassen sollte, anstatt sich nur auf eine Produktdemonstration zu verlassen.
Vorteile: Minimales Schreiben von Regeln, schnelle anomaliefokussierte Einführung, Bereitstellungsoptionen für Unternehmen und starke Warehouse-Integrationen.
Nachteile: Die Preisgestaltung ist nicht öffentlich, und Teams benötigen möglicherweise zusätzliche Kontrollen für die explizite Durchsetzung von Geschäftsregeln sowie In-Database-Bereitstellungsanforderungen.
5. Soda
Soda kombiniert einen Open-Source-Einstiegsweg mit einem verwalteten Observability-Produkt. Soda Core unterstützt Prüfungen und Datenverträge als Code, einschließlich YAML-basierter Definitionen und integrierter Prüfungen, sodass Ingenieure die Validierung in die Pipeline-Entwicklung und CI/CD-Workflows integrieren können. Soda Cloud ergänzt dies um Metrik-Überwachung, historische Baseline-Erstellung, Anomalieerkennung sowie Kollaborations- und governance-Workflows.
Dieses duale Modell verändert die Migrationsfrage. Ein Team kann mit einem CLI- und Open-Source-Workflow beginnen und dann zu den verwalteten Funktionen wechseln, wenn es eine zentrale Überwachung und Zusammenarbeit benötigt. Dieser Weg kann die Herstellerabhängigkeit reduzieren, fortschrittliche Observability und governance bleiben jedoch mit dem verwalteten Cloud-Produkt verknüpft und nicht mit der Open-Source-Ebene allein.
Wo die Eigenverantwortung für Regeln eine Rolle spielt
Soda eignet sich für Teams, die möchten, dass Ingenieure Datenqualitätserwartungen nah am Code und der Orchestrierung definieren. Es ist weniger direkt auf Organisationen ausgerichtet, die eine gelernte Anomalie- und Lieferüberwachung wünschen, ohne umfangreiche Testdefinitionen pflegen zu müssen. digna bietet beide Seiten durch automatische Data Anomalies und Timeliness sowie explizite Module für Data Validation und Schema Tracker.
Aktualität (Freshness) und Timeliness sollten während der Migration separat getestet werden. Aktualität prüft, ob Datensätze innerhalb eines erwarteten Zeitfensters eingetroffen sind, während Timeliness fragt, ob die Daten innerhalb des Entscheidungsfensters nutzbar wurden. (Leitfaden zur Qualitätskontrolle von Unternehmensdaten) Diese Unterscheidung kann Lücken aufdecken, die von einem generischen „Freshness“-Monitor verborgen werden.
Die öffentliche Preisliste für Soda Cloud ist nicht verfügbar, daher benötigen Käufer ein Angebot basierend auf Quellen, Prüfungen, Benutzern und dem verwalteten Umfang.
Vorteile: Open-Source-Einstieg, Checks-as-Code, Pipeline-Einbettung und ein klarer Weg zu verwalteter Observability.
Nachteile: Fortgeschrittene Zusammenarbeit und governance erfordern Soda Cloud, und die Preisgestaltung für Cloud ist vertriebsgesteuert.
Vergleichen Sie die Betriebsmodelle in dieser Soda-Alternative für die Datenqualität im Unternehmen.
6. Metaplane jetzt Teil von Datadog
Metaplane konzentriert sich auf ein schnelles SaaS-Onboarding für moderne Daten-Stacks. Seine auf maschinellem Lernen basierende Anomalieerkennung berücksichtigt Saisonalität und Trends, während Lineage auf Spaltenebene und Auswirkungsanalysen Teams helfen, nachgelagerte Konsequenzen zu verstehen. Data-CI/CD fängt Regressionen in Pull-Requests ab, und Warnmeldungen über Slack oder Microsoft Teams verknüpfen die Erkennung mit der bestehenden Kommunikation der Ingenieure.
Die Snowflake Native App-Option stellt eine bedeutende architektonische Besonderheit dar. Sie belässt die Daten im Warehouse und ermöglicht die Bezahlung über Snowflake-Credits, was die Sicherheitsprüfung und die Beschaffung für Snowflake-zentrierte Teams vereinfachen kann. Dies ist jedoch nicht gleichbedeutend mit einer umfassenden Kontrolle der Private Cloud oder On-Premises-Umgebungen. Käufer mit heterogenen oder regulierten Umgebungen sollten testen, wie sich die Funktionstiefe außerhalb des Snowflake-Pfads verändert.
Schneller Start, engerer Unternehmensperimeter
Der dauerhaft kostenlose Einstiegsweg von Metaplane unterstützt das Experimentieren, und sein Nur-Lese-Zugriffsmodell kann anfängliche Sicherheitsdiskussionen erleichtern. Der Kompromiss liegt im Funktionsumfang. Es kann eine größere Enterprise-Suite möglicherweise nicht ersetzen, wenn Teams eine umfassende governance, mehrere Bereitstellungsmodelle oder eine tiefe Abdeckung älterer Plattformen benötigen.
Der Vergleichspunkt von digna liegt nicht allein in der Onboarding-Geschwindigkeit. Es bietet In-Database-Ausführung, Bereitstellung in der Private Cloud oder On-Premises, ein gemeinsames Dashboard und Module, die Anomalien, Timeliness, Validierung, Schemaänderungen und historische Analysen abdecken. Teams sollten die Zeit vergleichen, die benötigt wird, um eine repräsentative Quelle anzubinden, Berechtigungen zu konfigurieren, eine Warnmeldung zu untersuchen und Nachweise für die governance zu erbringen.
Ein nützlicher Ausgangspunkt ist diese Erklärung dazu, was eine Observability-Plattform macht, um die Details anschließend mit dem eigenen Warehouse und Orchestrierungs-Stack abzugleichen.
Vorteile: Schnelles Onboarding, kostenloser Einstieg, Nur-Lese-Zugriff, Lineage, CI/CD-Prüfungen und eine Snowflake-native Bereitstellungsoption.
Nachteile: Die Suite ist schlanker als die größten Enterprise-Plattformen und die Funktionen variieren je nach Datensystem.
7. IBM Data Observability by Databand
IBM Data Observability by Databand konzentriert sich auf die Zuverlässigkeit von Pipelines und Jobs. Es überwacht Jobs, verfolgt Service-Level-Agreements und warnt Teams vor Ausfällen oder Lieferrisiken in Orchestrierungs- und Warehouse-Tools. Das Support-, Beschaffungs-, Dokumentations- und Vertragskonzept von IBM kann für regulierte Unternehmen, die standardmäßig auf IBM-Dienste setzen, ausschlaggebend sein.
Bei dieser Option geht es weniger um leichtgängigen Self-Service als vielmehr darum, Observability in ein etabliertes Betriebsmodell eines Unternehmens zu integrieren. Teams sollten mit einem Beschaffungs- und Implementierungsprozess rechnen, der von internen Standards, Supportanforderungen und Integrations-governance geprägt ist. Dieser Ansatz kann für Organisationen geeignet sein, die die Verantwortlichkeit des Anbieters und die Kontinuität der Vertragsgestaltung über eine schnelle Testaktivierung stellen.
Die Eignung hängt von Eigenverantwortung und Beschaffung ab
Die Preisgestaltung ist vertragsbasiert und kann bei einigen SKUs auf Ressourceneinheiten-Lizenzen basieren. Dies macht einen direkten Vergleich schwierig, es sei denn, der Käufer definiert überwachte Jobs, Umgebungen, Benutzer, Support-Erwartungen und Verlängerungsannahmen, bevor er ein Angebot anfordert.
digna bietet einen anderen Weg. Seine modulare Lizenzierung beginnt mit einem Modul und expandiert nach aktiver Tabelle und Modul, während seine In-Database-Architektur die Analyse in der Kundenumgebung belässt. Der praktische Vergleich liegt daher zwischen einem IBM-zentrierten Pipeline-Zuverlässigkeitsmodell und einem modularen Datenqualitäts- und Observability-Modell, das Data Anomalies, Data Analytics, Timeliness, Data Validation und Schema Tracker umfasst.
IBM ist ein sinnvoller Kandidat für die engere Auswahl, wenn bestehende Support- und Beschaffungskanäle von IBM erhebliches Gewicht haben. digna verdient eine genauere Bewertung, wenn Dateningenieure und governance-Teams eine gemeinsame Benutzeroberfläche sowohl für gelerntes Verhalten als auch für explizite Qualitätskontrollen benötigen.
Vorteile: IBM-Support, Vertragsgestaltung für Großunternehmen, Dokumentation, governance-Ausrichtung und Pipeline-SLA-Überwachung.
Nachteile: Der Einstieg ist möglicherweise weniger selbstgesteuert, die Preisgestaltung ist vertriebsgesteuert und in einigen Angeboten ist eine Lizenzierung nach Ressourceneinheiten möglich.
8. Lightup
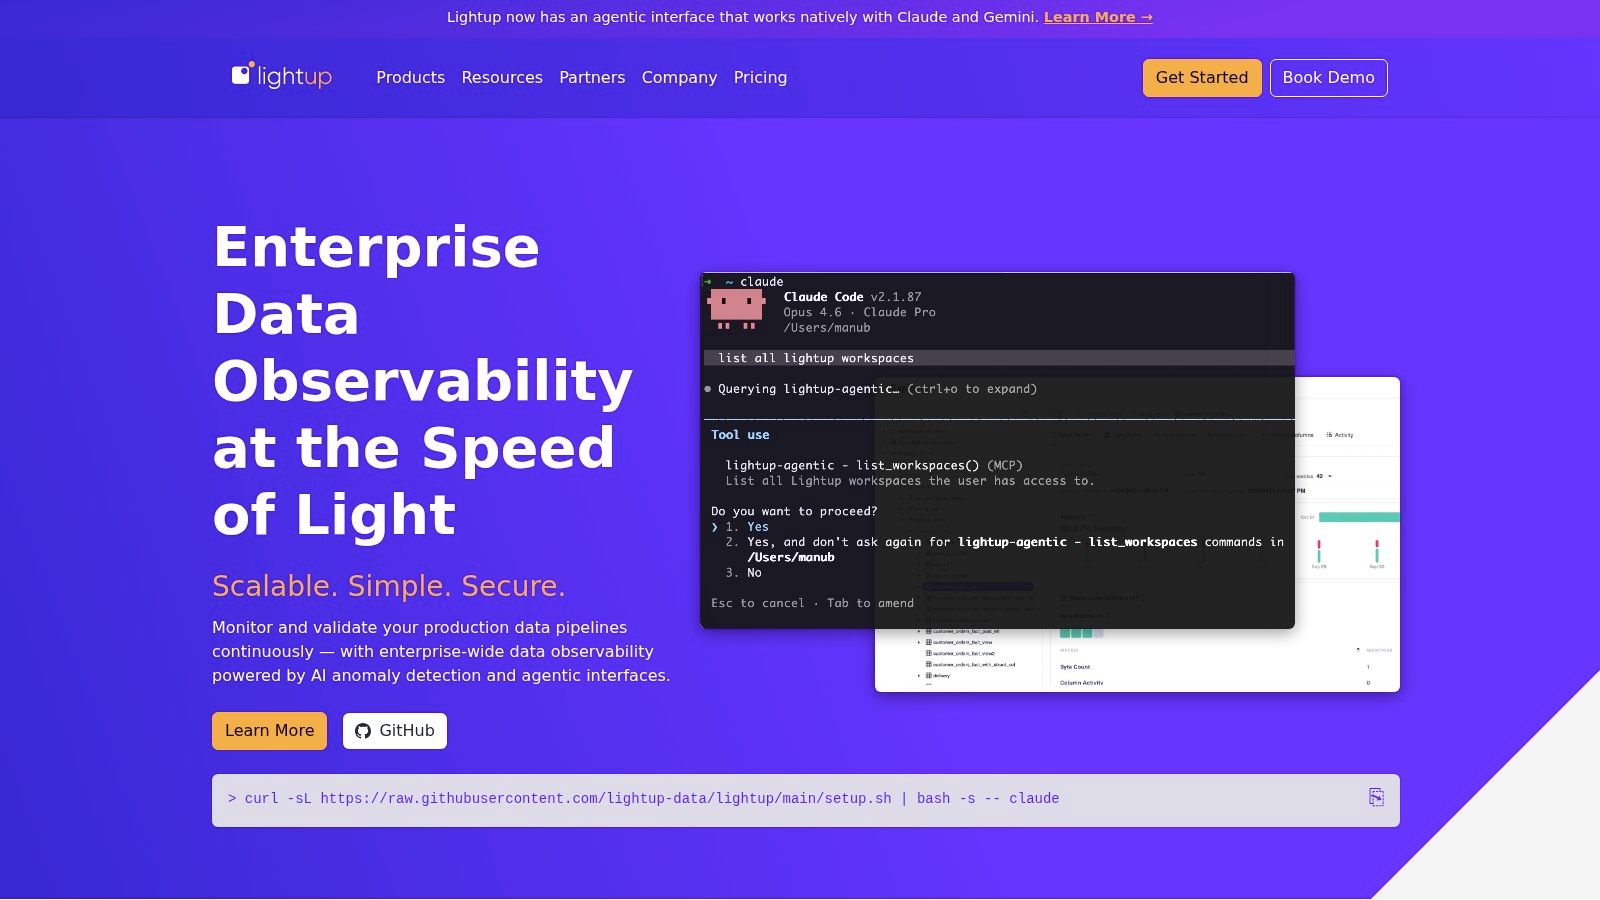
Lightup kombiniert regelbasierte Prüfungen mit KI-Anomalieerkennung, Lineage, Datenabgleich (Reconciliation) und Incident-Management. Sein Ansatz der Zero-Config Auto Metrics soll schnell eine grundlegende Abdeckung schaffen, während KI-Empfehlungen Teams helfen zu erkennen, wo zusätzliche Überwachung nützlich sein könnte. Integrationen mit Collibra, Alation, Ticket-Systemen und Warn-Tools erweitern die Plattform in governance- und Incident-Workflows.
Die Struktur der Cloud- und Enterprise-Pläne stellt Käufer vor eine wichtige Frage zur Bereitstellung anstelle einer reinen Funktionsfrage. Eine Cloud-Bereitstellung kann die operative Verantwortung verringern, während Enterprise- oder Hybrid-Optionen besser zu Datenresidenz- und Zugriffsbeschränkungen passen können. Bei der Bewertung sollte bestätigt werden, wo die Metrikberechnung stattfindet, welche Produktionsdaten die Umgebung verlassen und wie Berechtigungen verwaltet werden.
Automatische Aktivierung versus kontrollierter modularer Rollout
Die schnelle Aktivierung von Lightup kann die Zeit bis zur ersten Abdeckung verkürzen. digna bietet eine ähnliche Idee der schrittweisen Einführung durch modulare Lizenzierung, unterscheidet sich jedoch dadurch, dass Prüfungen und Metrikberechnungen direkt in den Datenbanken des Kunden ausgeführt werden. Das kann für Teams, die mit sensiblen Produktionsdaten arbeiten, wichtiger sein als die anfängliche Einrichtungsgeschwindigkeit.
Es sind keine öffentlichen Preise verfügbar, daher sollte das Angebot zwischen Plattformgebühren, überwachtem Umfang, Bereitstellungsstufe, Integrationen und Support unterscheiden. Käufer sollten auch testen, ob automatisch generierte Metriken nützliche Meldungen erzeugen oder lediglich das Rauschen an Warnungen vergrößern. Das Ziel ist nicht, jeden erdenklichen Monitor zu aktivieren, sondern Ausfälle frühzeitig zu erkennen, ohne dass Ingenieure irrelevante Ereignisse prüfen müssen.
Vorteile: Schnelle Einrichtung von Baselines, KI-Anomalieerkennung, Lineage, Datenabgleich, governance-Integrationen und Bereitstellungswege für Cloud oder Enterprise.
Nachteile: Die Preisgestaltung erfordert ein Angebot, und die Sichtbarkeit des Ökosystems ist geringer als bei den größten Marktführern.
9. Telmai
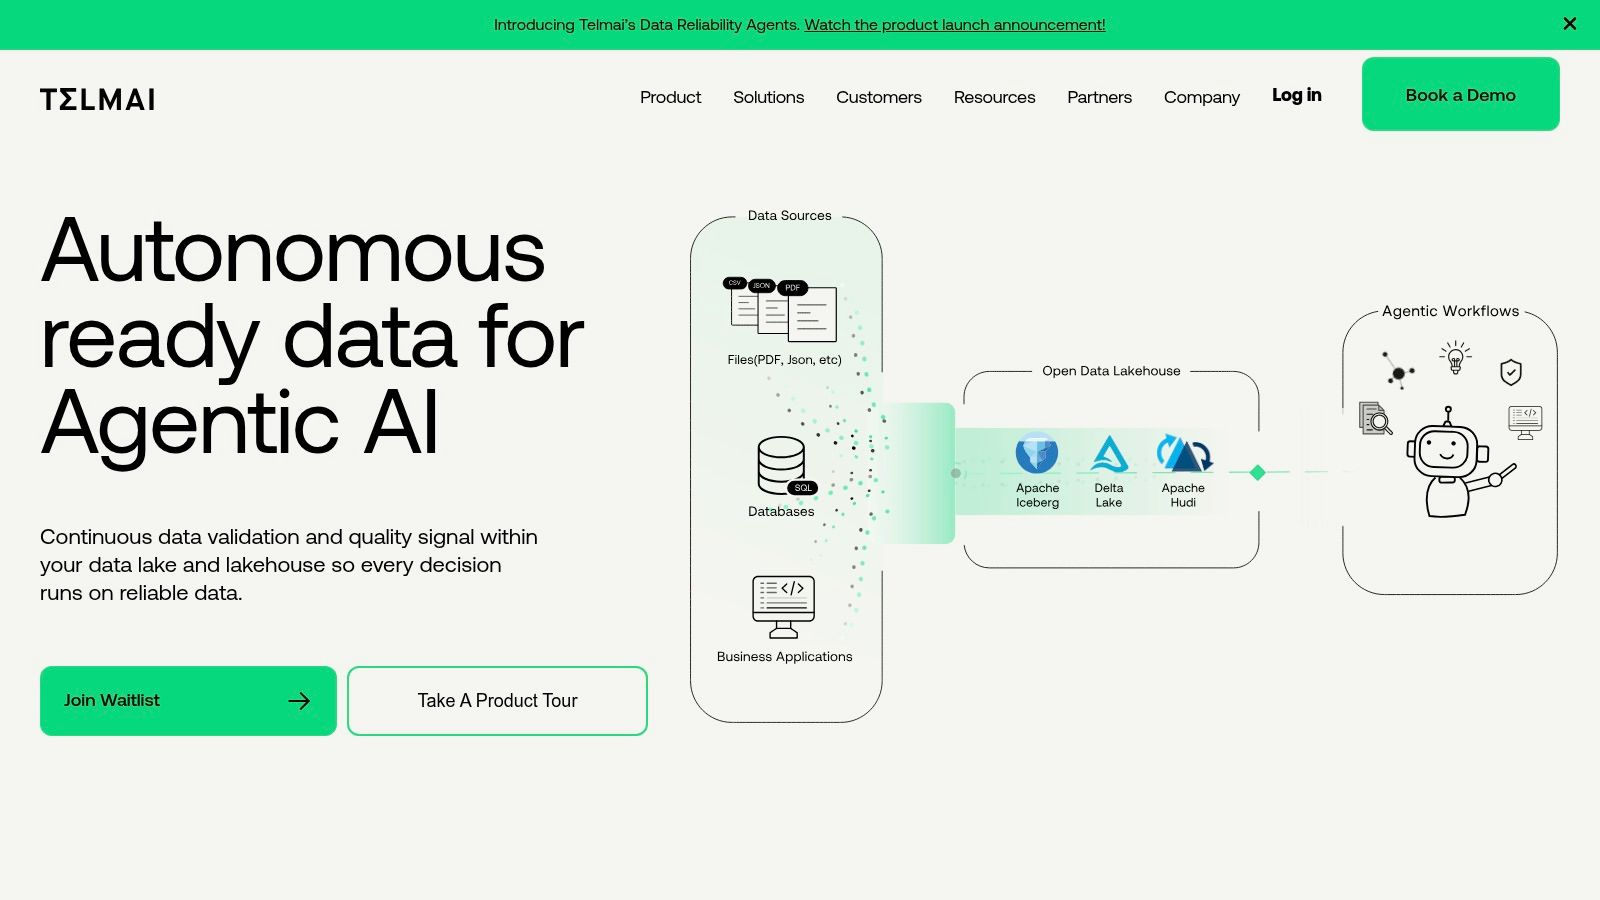
Telmai ist für offene Architekturen und Lakehouse-Umgebungen konzipiert, die auf Iceberg, Hudi oder Delta aufbauen. Seine No-Code- und Low-Code-Positionierung, regelfreie Anomalieerkennung, Drift-Überwachung, Timeliness-Prüfungen, Schema-Überwachung und Abfragen zu Vorfällen in natürlicher Sprache richten sich an Teams, die eine breite Abdeckung ohne manuelle Erstellung jedes Detektors wünschen.
Der Root-cause Investigator der Plattform zielt darauf ab, über die erste Warnmeldung hinaus eine Erklärung zu liefern. Die Verfügbarkeit im AWS Marketplace kann zudem den anfänglichen Test- oder Beschaffungsweg für Teams vereinfachen, die bereits über AWS arbeiten. Dieser Komfort entbindet jedoch nicht von der Notwendigkeit, den überwachten Umfang, die Bereitstellungsverantwortung und die Art und Weise, wie die Plattform mit offenen Tabellenformaten interagiert, zu modellieren.
Offene Formate verändern den Migrationstest
Telmai ist ein starker Kandidat, wenn die Offenheit des Lakehouse die wichtigste architektonische Anforderung ist. Die Eignung von digna ist dann am größten, wenn das Team zusätzlich In-Database-Ausführung, private Bereitstellung, Validierung auf Datensatzebene, KI-gelernte Timeliness und eine gemeinsame Benutzeroberfläche für Ingenieure, Analysten und governance-Stakeholder benötigt.
Die Praxis der Daten-Observability gruppiert im Allgemeinen Qualität, Aktualität, Lineage und Schemaänderungen als Kernsignale für die Überwachung, wobei Echtzeitprüfungen helfen, nachgelagerte Analyse- und KI-Ausfälle zu verhindern. (Forschung zu Data Observability-Signalen) Vergleichen Sie während eines POC nicht nur, ob beide Plattformen denselben Drift erkennen, sondern auch, ob jede das Problem in der bevorzugten Arbeitssprache des Teams erklären kann.
Die Preisgestaltung von Telmai ist nicht öffentlich und hängt vom überwachten Umfang und der Bereitstellung ab. Die Community-Präsenz ist ebenfalls geringer als die von länger etablierten Anbietern, weshalb Käufer die Dokumentation, die Implementierungsunterstützung und die interne Eigenverantwortung prüfen sollten.
Vorteile: Hervorragende Eignung für Lakehouses und offene Formate, regelfreie Erkennung von Datenanomalien, Untersuchung in natürlicher Sprache und Verfügbarkeit im AWS Marketplace.
Nachteile: Die Preisgestaltung ist angebotsabhängig, und die Community-Präsenz ist kleiner als bei etablierten Anbietern.
10. Kensu
Kensu verwendet bereitstellbare Agenten, um Daten in Bewegung und im Ruhezustand zu beobachten. Sein Ansatz instrumentiert Pipelines dort, wo Daten verwendet werden, und erfasst Echtzeit-Lineage-, Schema- und Qualitätsmetriken über Tools wie dbt, Databricks oder Spark, Azure Data Factory und Snowflake. Dies kann blinde Flecken in verteilten Umgebungen reduzieren, in denen ein reiner Warehouse-Monitor zwar das Ziel sieht, nicht aber den Transformationspfad, der es erzeugt hat.
Steuerungsmechanismen im Stil von Schutzschaltern (Circuit Breaker) und Incident-Workflows erweitern Kensu über die passive Benachrichtigung hinaus. Eine Community Edition und Proof-of-Concept-Optionen können Entwicklern helfen, das Instrumentierungsmodell zu bewerten, bevor sie sich für einen breiteren Rollout entscheiden. Die entscheidende Migrationsfrage ist, ob das Team in Pipelines eingebettete Agenten wünscht oder Prüfungen bevorzugt, die direkt in der Datenbank ausgeführt werden.
Instrumentierungstiefe versus datenresidente Ausführung
Kensus Modell der Beobachtung direkt an der Datennutzung kann Kontexte aufdecken, die eine reine Tabellenüberwachung übersieht. digna geht einen anderen Weg mit der In-Database-Ausführung, die die Metrikberechnung und -analyse in den Datenbanken des Kunden belässt, während Datenanomalien, Analytics, Timeliness, Validierung und Schemaänderungen über separate Module abgedeckt werden.
Die Preise von Kensu werden nicht veröffentlicht und sind in der Regel vertriebsgesteuert. Die Details auf der Website sind ebenfalls spärlicher als bei größeren Anbietern, wobei einiges Material über Dokumentationen oder professionelle Kanäle bereitgestellt wird. Die Evaluierung sollte daher eine exemplarische Implementierung, Agentenberechtigungen, das Verhalten bei Ausfällen, die Verantwortung für Upgrades und die Aufbewahrung von Nachweisen umfassen.
Vorteile: Echtzeit-Pipeline-Instrumentierung, Lineage- und Schema-Überwachung, verteilte Sichtbarkeit und Evaluierungsoptionen für die Community.
Nachteile: Die Preisgestaltung ist nicht öffentlich, und Teams müssen den operativen Aufwand für die Bereitstellung und Wartung von Agenten abwägen.
Top 10 Bigeye-Alternativen: Funktionsvergleich
Anbieter | Kernfunktionen | Alleinstellungsmerkmale | Zielgruppe | Bereitstellung & Sicherheit | Preis & Wert |
|---|---|---|---|---|---|
🏆 digna | Erkennung von Datenanomalien, Timeliness, Datensatzvalidierung, Schema Tracker, In-DB-Metriken & Analytics | ✨ In-DB-Ausführung, KI-Baseline-Lernen, modularer Rollout, schnelle Wertschöpfung ★★★★★ | 👥 Dateningenieure, BI/Analytics, governance; Finanz-/Gesundheitswesen/Telekommunikation/Behörden | Läuft in der Kundeninfrastruktur (Private Cloud/VPC/On-Prem); Anbieter greift nicht auf Produktionsdaten zu | 💰 Transparente modulare Preise: Basis + pro aktiver Tabelle/Modul; planbar, aber größenabhängig |
Monte Carlo Data | Aktualitäts-, Volumen-, Schema- & Verteilungsmonitore; Spalten-/Dashboard-Lineage; Incident-Workflows | ✨ Breite Konnektoren-/Stack-Abdeckung; starke Referenzen im Enterprise-Segment ★★★★ | 👥 Große Unternehmen mit diversen Stacks und Analytics-Teams | Cloud-/SaaS-Konnektoren für Warehouses, Lakes, ETL, BI | 💰 Angebotsbasierte Enterprise-Preise; kann für kleine Teams zu schwerfällig sein |
Acceldata | Plattform-/Pipeline-/Job-Observability, Kosten, Leistung, produktisierte Workflows | ✨ Hybrid-/On-Prem-Support + Fokus auf governance & Optimierung ★★★★ | 👥 Große, heterogene Umgebungen; Unternehmen, die Big Data modernisieren | Bereitstellungsoptionen für Cloud, On-Prem & Hybrid; Enterprise-Sicherheitskontrollen | 💰 Vertriebsgesteuerte Preise; geeignet für große Bestände |
Anomalo | Unüberwachte Erkennung von Datenanomalien, Ursachenanalyse, Integrationen (Databricks/Snowflake) | ✨ Regelfreie Erkennung, schnelle Wertschöpfung ★★★★ | 👥 Teams, die eine schnelle Erkennung von Datenanomalien ohne starre Regeln benötigen | SaaS mit Bereitstellungsoptionen für Großunternehmen; starke Cloud-Integrationen | 💰 Angebotsbasiert; Enterprise-SLAs verfügbar |
Soda | Checks/Contracts-as-Code (Soda Core OSS); Soda Cloud für Baseline-Erstellung & Warnungen | ✨ OSS-Einstieg (50+ Checks) → Migrationspfad zur verwalteten Cloud ★★★ | 👥 Entwickler/Ingenieure, die einen OSS-First-Weg und Pipeline-Einbettung bevorzugen | OSS (CLI) + verwaltete Cloud; integriert mit Warehouses & Orchestratoren | 💰 OSS kostenlos; Soda Cloud = Vertriebskontakt für Preise |
Metaplane (Datadog) | ML-Anomalieerkennung, Spalten-Lineage, Data CI/CD, Snowflake Native App | ✨ Schnelles Onboarding, dauerhaft kostenlose Stufe, Snowflake-native Option ★★★★ | 👥 Kleine bis mittlere Teams, Snowflake-fokussierte Organisationen, schnelle POCs | SaaS + Snowflake Native App (Daten verbleiben im Warehouse) | 💰 Kostenlose Stufe verfügbar; kostenpflichtige Pläne / Datadog-Preise |
IBM Data Observability (Databand) | Pipeline-/Job-Observability, SLA-Verfolgung, Orchestrierungs- & Warehouse-Integrationen | ✨ IBM-Support, Beschaffung & Eignung für regulierte Enterprise-Anforderungen ★★★ | 👥 Regulierte Unternehmen und auf IBM standardisierte Käufer | Enterprise-Bereitstellungen, IBM Support-/Produkt-Frameworks | 💰 Vertrags-/vertriebsgesteuerte Preise; Enterprise-Beschaffungsmodell |
Lightup | Regelprüfungen + KI-Anomalieerkennung, Lineage, Datenabgleich, Incident-Management | ✨ Zero-Config Auto Metrics für schnelle Abdeckung ★★★ | 👥 Teams, die eine schnelle automatische Abdeckung und Zusammenarbeit wünschen | Cloud- & Enterprise-Pläne; hybride Optionen | 💰 Angebotsbasiert; Transparenz bei Cloud- vs. Enterprise-Plänen |
Telmai | Lake-/Lakehouse-Observability (Iceberg/Hudi/Delta), Drift/Timeliness/Schema, Abfragen in natürlicher Sprache | ✨ Fokus auf offene Formate, Abfragen in natürlicher Sprache, Verfügbarkeit im AWS Marketplace ★★★ | 👥 Lakehouse-Teams, Umgebungen mit offenen Formaten, GenAI-Vorbereitung | Cloud-Bereitstellungen; Beschaffungsoption über Marketplace (AWS) | 💰 Preise nach Umfang; Vertriebskontakt erforderlich |
Kensu | Agentenbasierte Lineage, Schema- & Qualitätsmetriken, Echtzeit-Beobachtungen & Profiler | ✨ Beobachtung direkt am Ort der Datennutzung; Community-/POC-Edition ★★★ | 👥 Teams, die Echtzeit-Instrumentierung und Entwickler-Evaluierung benötigen | Agenten-Bereitstellung über Pipelines hinweg; Echtzeit-Telemetrie | 💰 Vertriebsgesteuerte Preise; Community Edition zur Evaluierung |
Machen Sie die Shortlist zu einer sicheren Migrationsentscheidung
Die richtige Bigeye-Alternative hängt weniger von der Anzahl der Monitore in einer Demo ab als davon, wie sich die Plattform in Bezug auf Ihren tatsächlichen Datenstandort, Ihr Eigenverantwortungsmodell und Ihren Incident-Prozess verhält. Die Marktnachfrage entwickelt sich in diese Richtung. Eine Marktstudie prognostiziert für die Kategorie Data Observability ein Wachstum von 3,51 Milliarden USD im Jahr 2026 auf 6,03 Milliarden USD bis 2031, bei einer erwarteten durchschnittlichen jährlichen Wachstumsrate von 11,42 % in diesem Zeitraum. (Marktstudie zur Daten-Observability 2026) Wachstum allein bestimmt zwar nicht das richtige Produkt, zeigt jedoch, dass Teams eine langfristige Entscheidung für ihre Infrastruktur treffen, anstatt nur eine temporäre Alarmierungsebene zu erwerben.
Beginnen Sie mit einer Bestandsaufnahme, nicht mit einer Anbieter-Scorecard. Listen Sie kritische Tabellen, Pipelines, Dashboards, Modelle und operative Verbraucher auf. Kennzeichnen Sie, welche Assets sensible Daten enthalten, welche Systeme in privaten Netzwerken oder On-Premises laufen und welche Arbeitslasten keine kopierten Produktionsdaten tolerieren können. Klassifizieren Sie dann die erforderlichen Kontrollen:
Erkennung von Datenanomalien: Identifizieren Sie die Verhaltensweisen, die gelernte Baselines erfordern, einschließlich Volumen, Verteilung, Geschäftsmetriken und Plattformsignale.
Timeliness-Anforderungen: Definieren Sie die erwarteten Eintreff- und Entscheidungsfenster separat. Ein Datensatz kann innerhalb eines nominalen Aktualitätsintervalls eintreffen und dennoch den Zeitpunkt verpassen, an dem ein Geschäftsprozess ihn benötigt.
Validierungsregeln: Dokumentieren Sie Geschäftslogiken auf Datensatzebene, regulatorische Kontrollen, Bedingungen für den Datenabgleich und Prüfungen, die explizit bleiben müssen und nicht bloß abgeleitet werden dürfen.
Schema-Überwachung: Legen Sie fest, wie sich hinzugefügte Spalten, entfernte Felder und Typänderungen auf nachgelagerte Verbraucher auswirken sollen.
Untersuchungs-Workflow: Messen Sie, ob ein Ingenieur von einer Warnung direkt zum betroffenen Asset, der wahrscheinlichen Ursache, dem Eigentümer und der Behebung gelangen kann, ohne zwischen isolierten Tools wechseln zu müssen.
Testen Sie die Finalisten mit repräsentativen Arbeitslasten, nicht mit einem bereinigten Datensatz. Beziehen Sie eine hochprioritäre Tabelle, eine verzögerte Pipeline, eine geplante Schemaänderung, eine unerwartete Verteilungsverschiebung und eine Regelverletzung ein. Vergleichen Sie die Qualität der Warnmeldungen, die Untersuchungszeit, den Nutzen der Lineage und den Aufwand für die Feinabstimmung der Monitore. Betrachten Sie Warnmeldungen an sich nicht als Erfolg. Zählen Sie nur die Warnmeldungen, die zu einer klaren Maßnahme führen.
Die Kostenmodellierung erfordert denselben Realismus. Einige Anbieter rechnen nach überwachtem Umfang ab, andere nutzen Ressourcen- oder Nutzungssignale, und digna verwendet eine Grundgebühr plus Preise pro aktiver Tabelle und Modul ohne API-, Scan-Volumen- oder Warnungs-Volumen-Gebühren. Bitten Sie jeden Anbieter, das Wachstum anhand Ihrer aktiven Tabellen, ausgewählten Module, Umgebungen, Integrationen und Supportanforderungen zu modellieren. Der Beleg für das unkontrollierte Anwachsen von Tool-Landschaften ist hier wichtig: 46,7 % der Unternehmen betreiben zwei bis drei Observability-Tools parallel, während sich nur 7,4 % auf eine einzige, vereinheitlichte Plattform verlassen. (Zusammenfassung der unabhängigen Observability-Umfrage) Eine Konsolidierung kann die Übersichtlichkeit der Arbeitsabläufe verbessern, aber nur, wenn der Ersatz auch die Kontrollen abdeckt, die die Teams überhaupt erst zur Nutzung ergänzender Tools gezwungen haben.
Die Modulzuordnung von digna bietet eine praktische Vergleichsgrundlage:
Data Anomalies: KI-gestütztes Lernen von Baselines und kontinuierliche Erkennung von Datenanomalien ohne manuelle Regelkonfiguration.
Data Analytics: Historische Trend-, Volatilitäts- und Statistik-Analysen zum Verständnis der Zuverlässigkeit im Zeitverlauf.
Timeliness: Durch KI gelernte Lieferpläne, erwartete Lieferzeiten, verspätete Ladungen, fehlende Daten und verfrühte Eingänge.
Data Validation: Durchsetzung von Geschäftsregeln auf Datensatzebene für Qualitäts-, Audit- und Compliance-Kontrollen.
Schema Tracker: Kontinuierliche Erkennung von hinzugefügten oder entfernten Spalten sowie von Datentypänderungen.
In-Database-Ausführung: Metrikberechnung und -analyse innerhalb der Kundendatenbanken, sodass die Daten vor Ort verbleiben.
Bereitstellungsoptionen: Installation in der Private Cloud oder On-Premises innerhalb der Cloud, der VPC oder des Rechenzentrums des Kunden.
Gemeinsames Dashboard: Eine Benutzeroberfläche für Ingenieure, Analysten, governance-Teams und andere Stakeholder.
Enthaltene Komponenten: Scheduler, Datenverzeichnis, Integrationen und Kollaborationsfunktionen ab der ersten Modulauswahl.
Modulare Lizenzierung: Starten Sie mit einem Modul und erweitern Sie nach aktiver Tabelle und Modul.
Migrationsdisziplin: Lassen Sie Bigeye und die ausgewählte Alternative lange genug parallel auf denselben repräsentativen Arbeitslasten laufen, um Erkennung, Untersuchung, Kostenverhalten und Betriebsaufwand vergleichen zu können.
Dokumentieren Sie Kriterien für einen Rollback, bevor die Migration beginnt. Legen Sie fest, was als inakzeptables Rauschen bei Warnmeldungen, verpasste Vorfälle, unerwartete Rechenleistung, fehlgeschlagene Integrationen oder unzureichende Nachweise für die governance gilt. Gehen Sie phasenweise vor, beginnen Sie mit einer begrenzten Auswahl kritischer Assets und weiten Sie den Prozess erst aus, nachdem die Verantwortlichen bestätigt haben, dass der neue Workflow funktioniert. Nehmen Sie Bigeye erst außer Betrieb, nachdem der Ersatz seine Abdeckung, Vorfallsbehandlung, Zugriffskontrollen und sein Kostenverhalten in der Produktion unter Beweis gestellt hat – und nicht bereits, wenn der Einkauf den Vertrag genehmigt hat.
Die beste Wahl kann Monte Carlo für eine breite Lineage sein, Acceldata für hybride Full-Stack-Umgebungen, Soda für Checks-as-Code, Metaplane für schnelles Onboarding moderner Stacks, Telmai für offene Lakehouse-Formate, Kensu für agentenbasierte Pipeline-Instrumentierung oder IBM Data Observability by Databand für IBM-zentrierte Enterprise-Abläufe. Die Wahl kann auf digna fallen, wenn die entscheidenden Anforderungen eine private Bereitstellung, eine datenresidente Ausführung, eine modulare Einführung, eine gelernte Erkennung von Datenanomalien und Timeliness, eine explizite Validierung und eine Schemakontrolle sind. Die Eignung hängt von der Architektur und dem Betriebsmodell ab. Daher sollte die Shortlist mit einem Belastungstest der Arbeitslasten und einer Entscheidung über die Eigenverantwortung enden, nicht mit einer generischen Rangliste.
digna kombiniert KI-gestützte Erkennung von Datenanomalien, Timeliness-Überwachung, Validierung auf Datensatzebene, Schema-Tracking, historische Analysen und In-Database-Ausführung in Ihrer eigenen Umgebung. Besuchen Sie digna, um eine modulare Bigeye-Alternative für Ihre Datenplattform, Ihre governance- und Zuverlässigkeitsanforderungen zu evaluieren.


