Total Data Quality Management (TDQM): ein Praxisleitfaden
|
8
min. Lesezeit

Ein aufsichtsrechtlicher Bericht zum Quartalsende liegt zur Prüfung bereit. Dann bemerkt die Finanzabteilung, dass Kundenklassifizierungen veraltet sind, die Analytik findet im Warehouse eine abweichende Anzahl, und das Datenteam entdeckt, dass sich ein Quellschema Tage zuvor geändert hat. Alle arbeiten bis spät, um den Bericht zu reparieren, doch der CDO steht weiterhin vor der unbequemen Frage: Warum wurde das Problem nicht vorgelagert erkannt?
Genau dieses Problem adressiert Total Data Quality Management (TDQM). Es behandelt Datenqualität als durchgängige Betriebsdisziplin und verbindet fachliche Anforderungen, technische Kontrollen, Stewardship, Monitoring und Behebung. Das Ergebnis ist keine weitere nachgelagerte Checkliste. Es ist ein wiederholbarer Weg, Fehler zu verhindern, Änderungen zu erkennen, Ursachen zu finden und die Prozesse zu verbessern, die Daten erzeugen.
Inhaltsverzeichnis
Warum Total Data Quality Management jetzt zählt
Was TDQM wirklich ist und woher es kommt
Die Denkweise vom Informationsprodukt
Die vier Phasen des TDQM-Lebenszyklus
Define
Measure
Analyze
Improve
Dimensionen, KPIs und was Sie messen
Von Audit-Momentaufnahmen zu Betriebssignalen
Eine praktische TDQM-Roadmap und häufige Fallstricke
Den Ist-Zustand bewerten
Eine kritische Domäne pilotieren
Über Domänen hinweg skalieren
Qualität in die Auslieferung einbetten
Wie moderne Plattformen TDQM zum Leben erwecken
Die Architektur hinter den Modulen
Was technisch zu prüfen ist
Branchenspezifische Aspekte in regulierten Sektoren
Eine kurze TDQM-Reife-Checkliste und die nächsten Schritte
Warum Total Data Quality Management jetzt zählt
Moderne Unternehmen haben mehr Wege denn je, Daten zu erzeugen und zu konsumieren. Cloud-Warehouses erhalten Datensätze aus SaaS-Anwendungen, operativen Datenbanken, Event-Streams, Partner-Feeds und internen Diensten. Diese Datensätze tragen dann Dashboards, aufsichtsrechtliche Meldungen, Kundenprozesse und KI-Systeme.
Ein kleiner Fehler kann durch jede Schicht wandern. Ein fehlendes Kundensegment kann eine Marketing-Zielgruppe verzerren, eine Finanzberechnung brechen oder dazu führen, dass ein Analytikmodell einen Datensatz falsch interpretiert. Eine verspätete Pipeline kann ein Dashboard gesund aussehen lassen, während es die Realität von gestern zeigt. Der technische Fehler ist womöglich lokal, doch die Geschäftswirkung verteilt sich auf alle Konsumenten.
Die zugrunde liegenden Kosten können erheblich sein. Branchenkommentare schätzen, dass schlechte Datenqualität Organisationen zwischen 20 % und 35 % des Betriebsumsatzes kosten kann, mit einer breiteren Spanne von 15 % bis 35 % für viele Organisationen, wie eine Analyse der Kosten schlechter Datenqualität zusammenfasst. Diese Zahlen sind keine universelle Finanzformel. Sie zeigen aber, warum Führungskräfte Qualitätsmängel mit operativem Risiko, Nacharbeit, verpassten Terminen und unzuverlässigen Entscheidungen verbinden müssen.
Praxisregel: Wenn ein Qualitätsproblem für einen Bericht, Prozess, ein Modell oder einen Kunden zählt, weisen Sie jemandem die Verantwortung für die Vermeidung zu, nicht nur für die Reparatur.
TDQM liefert diese Struktur über vier verbundene Phasen: Define, Measure, Analyze und Improve. Teams definieren, was „zwecktauglich“ bedeutet, messen die relevanten Dimensionen, analysieren Fehler an ihrer Quelle und verbessern sowohl Daten als auch Produktionsprozesse. Der Zyklus beginnt erneut, sobald sich Anforderungen, Systeme und Konsumenten ändern.
Ein reifes Programm bringt weniger Feuerwehreinsätze, schnellere KI-Einführungen, geringere regulatorische Exposition und mehr Vertrauen in Dashboards. Wer Qualitätsarbeit mit diesen Ergebnissen verbinden will, kann außerdem die geschäftlichen Vorteile von Datenqualität nachlesen.
Was TDQM wirklich ist und woher es kommt
Total Data Quality Management ist eine unternehmensweite Disziplin zur Planung, Messung, Überwachung und Verbesserung von Datenqualität über den gesamten Datenlebenszyklus. Sie umfasst Erzeugung, Erhebung, Speicherung, Transformation, Austausch, Nutzung und Wiederverwendung. Dieser Umfang zählt, weil ein Datensatz beim Ingest korrekt sein und nach einer Transformation, Schemaänderung, verspäteten Ladung oder schlecht gesteuerten Übergabe unzuverlässig werden kann.
Das akademische Fundament entstand aus MIT-Forschung im Jahr 1992, als das TDQM-Programm formal gestartet wurde, um Datenqualität als eigenes Forschungsfeld zu etablieren. Das Programm verankerte Datenqualitätstheorie in Statistik, Informatik, Organisationsverhalten, Rechnungswesen und Total Quality Management, wie die historische TDQM-Forschungsdokumentation festhält.
Die Denkweise vom Informationsprodukt
Ein viel zitierter Meilenstein war Richard Wangs Methodik von 1998, die Daten als Ergebnis eines Informationsfertigungsprozesses rahmte. Diese Sicht verschob die zentrale Frage von „Wie bereinigen wir diese Datei?“ zu „Wie erzeugt dieser Prozess Information, und was verlangen seine Konsumenten?“.
Ein Informationsprodukt hat Konsumenten, Owner, Qualitätserwartungen, Lieferbedingungen und Lebenszyklusphasen. Ein Kundenstammdatensatz braucht beispielsweise Eindeutigkeit fürs Marketing, Genauigkeit für die Abrechnung und Timeliness für den Servicebetrieb. Qualität ist nicht absolut. Sie hängt vom Anwendungsfall und der geschäftlichen Folge eines Fehlers ab.
TDQM ist mit benachbarten Disziplinen verwandt, aber von ihnen verschieden:
Data Governance legt Entscheidungsrechte, Richtlinien, Verantwortung und Rechenschaft fest.
Master Data Management konzentriert sich auf konsistente Kernentitäten wie Kunden, Produkte und Lieferanten.
Data Observability überwacht Verhalten und erkennt Vorfälle über Pipelines und Plattformen hinweg.
TDQM verbindet diese Praktiken zu einem System kontinuierlicher Qualitätsverbesserung.
Die DAMA-DMBOK-Referenz hilft, TDQM neben den übrigen Datenmanagement-Disziplinen zu verorten. Die wichtige Denkverschiebung ist operativ: Qualität ist kein Projekt, das nach einer Bereinigungsaktion endet. Sie ist eine Produktionseigenschaft, die sichtbar bleiben muss, während sich Systeme und KI-Konsumenten weiterentwickeln.
Die vier Phasen des TDQM-Lebenszyklus
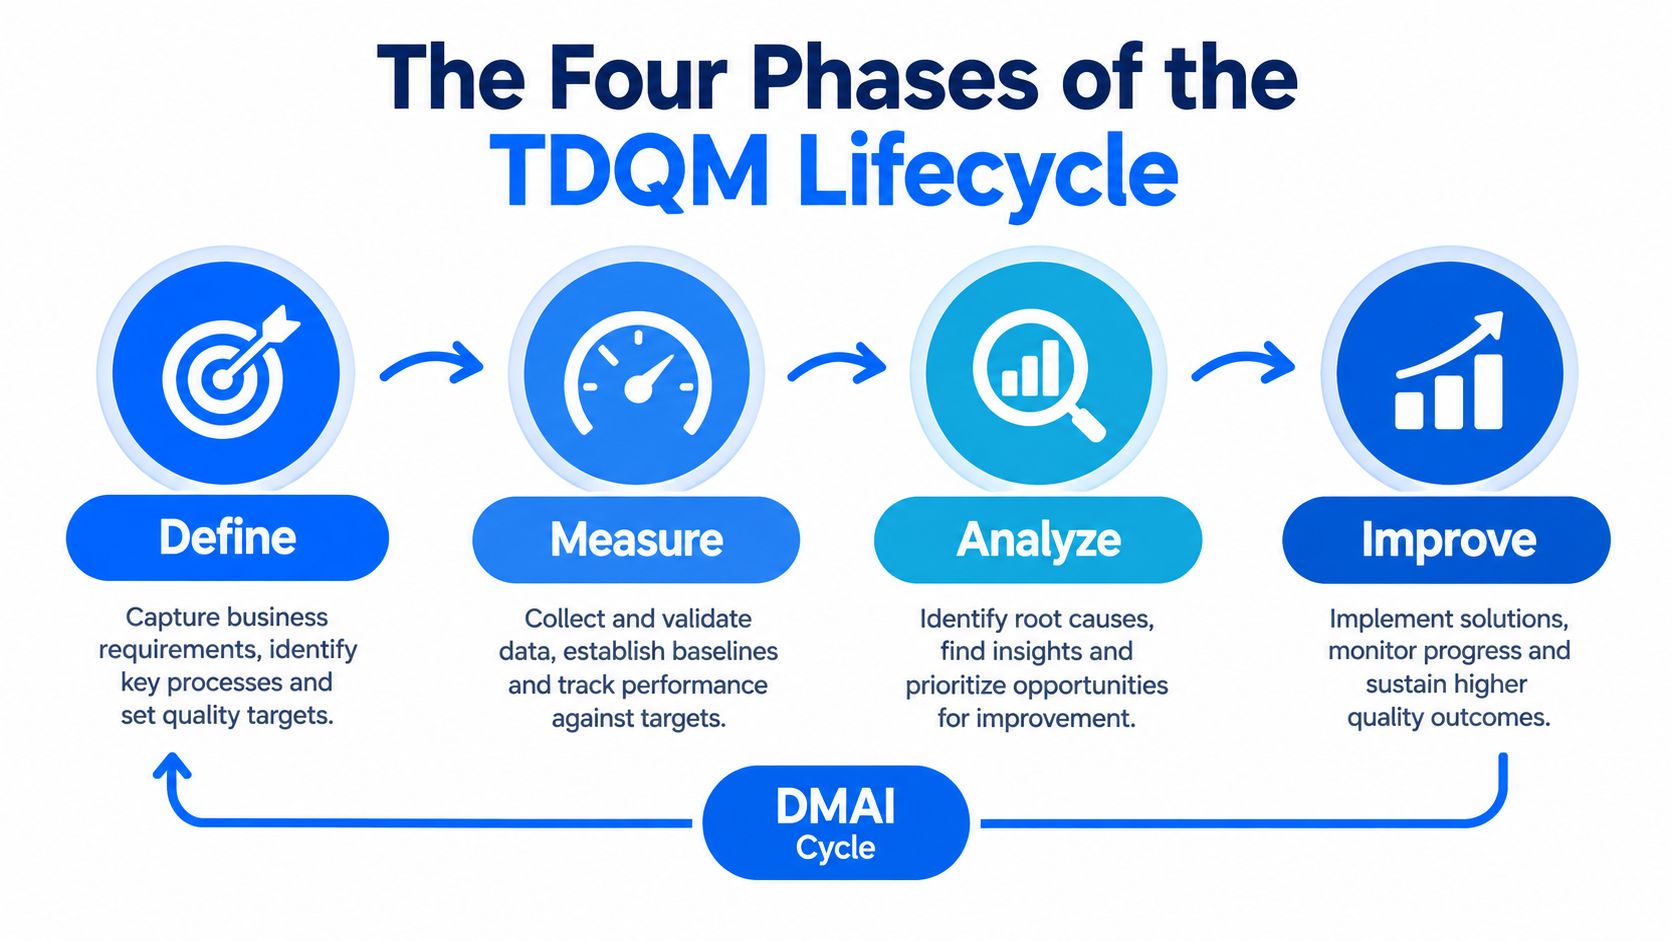
TDQMs vier Phasen bilden eine Schleife, keinen einbahnigen Projektplan. Jede Phase erzeugt Artefakte, die die nächste nützlicher machen, und die Improve-Phase führt neue Erkenntnisse zurück in Define.
Define
Beginnen Sie beim Geschäftsprozess, nicht beim Monitoring-Werkzeug. Identifizieren Sie die kritischen Datenelemente, die einen aufsichtsrechtlichen Bericht, einen Preisprozess, einen Patientenworkflow oder ein Modell tragen. Dokumentieren Sie dann, wer die Daten nutzt, was schiefgehen kann und was „akzeptabel“ für diesen Zweck bedeutet.
Ein Definitionspaket könnte enthalten:
Fachliche Anforderungen: Die Entscheidungen und Prozesse, die der Datensatz tragen muss.
Kritische Datenelemente: Felder und Beziehungen, die wesentliches Geschäftsrisiko tragen.
Qualitätsmodell: Dimensionen wie Genauigkeit, Vollständigkeit, Gültigkeit und Timeliness.
Verantwortungsmodell: Benannte Data Owner und technische Custodians.
Qualitätsziele: Regeln, Serviceerwartungen und Eskalationsbedingungen.
Das Ergebnis ist mehr als eine Feldliste. Es ist eine gemeinsame Vereinbarung zwischen Produzenten und Konsumenten.
Measure
Messung verwandelt Erwartungen in Nachweise. Teams profilieren die Daten, etablieren Baselines, testen Geschäftsregeln, überwachen Liefermuster und erfassen Lineage-Kontext. Die gewählten Maße sollten die Anforderungen aus Define widerspiegeln statt dessen, was eine Plattform zufällig anbietet.
Für einen Kundendatensatz könnte die Messung Vollständigkeit der Pflichtfelder, Dublettenquoten, akzeptierte Wertformate, referenzielle Integrität und Ankunftsverhalten umfassen. Eine Scorecard sollte Ergebnis und Geltungsbereich zeigen, einschließlich Datensatz, Partition, Zeitfenster, Owner und nachgelagerter Abhängigkeiten.
Ein praxisnaher Ansatz zur Umsetzung von Datenqualität sollte einen Regelkatalog, Metrikdefinitionen, eine Baseline-Scorecard und einen Lineage-bewussten Monitoringplan hervorbringen.
Analyze
Eine fehlgeschlagene Prüfung ist ein Symptom. Die Analyse fragt, warum sie fehlschlug und wo der Fehler in den Prozess gelangte. Ein Anstieg der Null-Rate kann von einer Änderung der Quellanwendung, einer defekten Transformation, einem vorgelagerten Geschäftsprozess oder einer legitimen Verhaltensänderung der Kunden stammen.
Ursachenanalyse sollte Regelverstöße, Anomaliemuster, Schemahistorie, Lineage und Verantwortung kombinieren. Ziel ist keine größere Ticket-Warteschlange. Ziel ist, isoliertes Rauschen von systemischen Fehlern zu trennen und den Befund dem Team zuzuweisen, das eine Wiederholung verhindern kann.
Improve
Verbesserung heißt, den Prozess zu reparieren, wo immer möglich, statt nachgelagerte Tabellen wiederholt zu flicken. Teams können die Quellvalidierung korrigieren, einen Datenkontrakt überarbeiten, eine Transformation ändern, eine präventive Kontrolle ergänzen oder einen Stewardship-Workflow aktualisieren.
Der Behebungs-Backlog sollte Fehler nach Geschäftswirkung, betroffenen Konsumenten, regulatorischer Relevanz, Wiederholung und Reparaturaufwand ordnen. Nach einer Änderung prüft das Team das Ergebnis, aktualisiert den Standard und führt die Lehre zurück nach Define.
Dimensionen, KPIs und was Sie messen
Angenommen, eine Kundenkennung trifft planmäßig ein, besteht die Validierung nicht, erscheint doppelt und widerspricht dem Abrechnungssystem. Ein einzelner „Qualitätswert“ verbirgt die daraus folgenden Entscheidungen. TDQM zerlegt das Problem in Dimensionen und verbindet jede Dimension mit einem Owner, einem Schwellenwert und einer Maßnahme.
Die sechs Kerndimensionen, die in der Unternehmenspraxis verbreitet sind, lauten Genauigkeit, Vollständigkeit, Konsistenz, Timeliness, Eindeutigkeit und Gültigkeit. IBM beschreibt diese Dimensionen und merkt an, dass Organisationen zusätzlich Nachvollziehbarkeit, Verfügbarkeit, Verlässlichkeit, Präzision oder Relevanz benötigen können, in seinem Leitfaden zu Datenqualitätsdimensionen. Ein vollständigeres Framework für Datenqualitätsdimensionen hilft, diese Bezeichnungen mit operativen Kontrollen zu verbinden.
Eine Dimension wird nützlich, wenn sie eine Entscheidung stützt. Ein Vollständigkeitswert braucht eine definierte Menge an Pflichtfeldern. Ein Genauigkeitswert braucht eine freigegebene Referenz oder eine verifizierte Quelle. Ohne diese Definitionen kann ein Dashboard Teams dafür belohnen, irrelevante Werte zu füllen, oder Vertrauen in Daten schaffen, die niemand validiert hat.
Dimension | KPI | Messmethode | Typischer Schwellenwert |
|---|---|---|---|
Genauigkeit | Trefferquote gegen vertrauenswürdige Referenz | Ausgewählte Felder mit einer freigegebenen Referenz oder verifizierten Quelle vergleichen | Nach Geschäftsrisiko und Anwendungsfall festgelegt |
Vollständigkeit | Null-Rate in Pflichtfeldern | Fehlende Werte unter den Pflichtfeldern zählen | Je kritischem Datenelement definiert |
Konsistenz | Abweichungsquote zwischen Systemen | Gemeinsame Felder und Beziehungen systemübergreifend vergleichen | Eskalieren, wenn Abweichungen einen nachgelagerten Prozess betreffen |
Timeliness | Zahl der SLA-Verletzungen | Tatsächliche Ankunft mit der vereinbarten Liefererwartung vergleichen | Null Verletzungen für zeitkritische Ergebnisse, wo machbar |
Eindeutigkeit | Dublettenquote | Identitäts- und Schlüsselabgleichsregeln innerhalb und zwischen Datensätzen anwenden | Nach Entität und Prozesstoleranz definiert |
Gültigkeit | Quote der Regelverstöße | Formate, Wertebereiche, Aufzählungen und fachliche Constraints prüfen | Je Regel und Schweregrad festgelegt |
Von Audit-Momentaufnahmen zu Betriebssignalen
Messung sollte nah am Workflow sitzen, der die Daten erzeugt oder nutzt. Pipeline-Observability kann Schema-Drift-Vorfälle, Lieferverzögerungen, Regelfehler und Verteilungsänderungen verfolgen. Governance-Scorecards können diese Signale je Domäne aggregieren, während Führungskräfte die fachliche Bedeutung brauchen, etwa betroffene Berichte, blockierte Prozesse oder ungelöste Hochrisikofehler.
Monitoring im KI-Zeitalter ergänzt eine weitere Schicht. Eine Modellpipeline kann Schemaprüfungen bestehen, während sich ihre Eingabeverteilung verschiebt, oder gültige Ausgaben aus veralteten Features erzeugen. TDQM verbindet daher klassische Regeln mit Drift-, Lineage- und Modell-Observability-Signalen. Die Plattformmodule mögen sich unterscheiden, doch die Zuordnung bleibt klar: Profiling und Validierung stützen die Dimensionen, Lineage erklärt den Geltungsbereich, Alerting startet die Untersuchung, und Scorecards stützen Governance-Entscheidungen.
Zeitbezogene Qualität braucht präzise Sprache. Eine Übersichtsarbeit von 2018 unterscheidet Aktualität von Timeliness und behandelt Schemavalidierung als eigene Kontrolle für die strukturelle Passung gegen ein konzeptionelles Modell, Anforderungen oder Quellinhalte in ihrer Übersicht zu Datenqualitätsdimensionen. Ein Datensatz kann planmäßig eintreffen und dennoch einen früheren Geschäftszustand beschreiben.
Beginnen Sie mit der kleinsten Kennzahlenmenge, die Risiko in einer kritischen Domäne offenlegt. Ergänzen Sie ein Maß erst, wenn ein Owner danach handeln kann. Schwellenwert-Alerts sollten eine Untersuchung mit Lineage und Kontext eröffnen, statt bloß zu melden, dass sich eine Zahl geändert hat.
Eine praktische TDQM-Roadmap und häufige Fallstricke
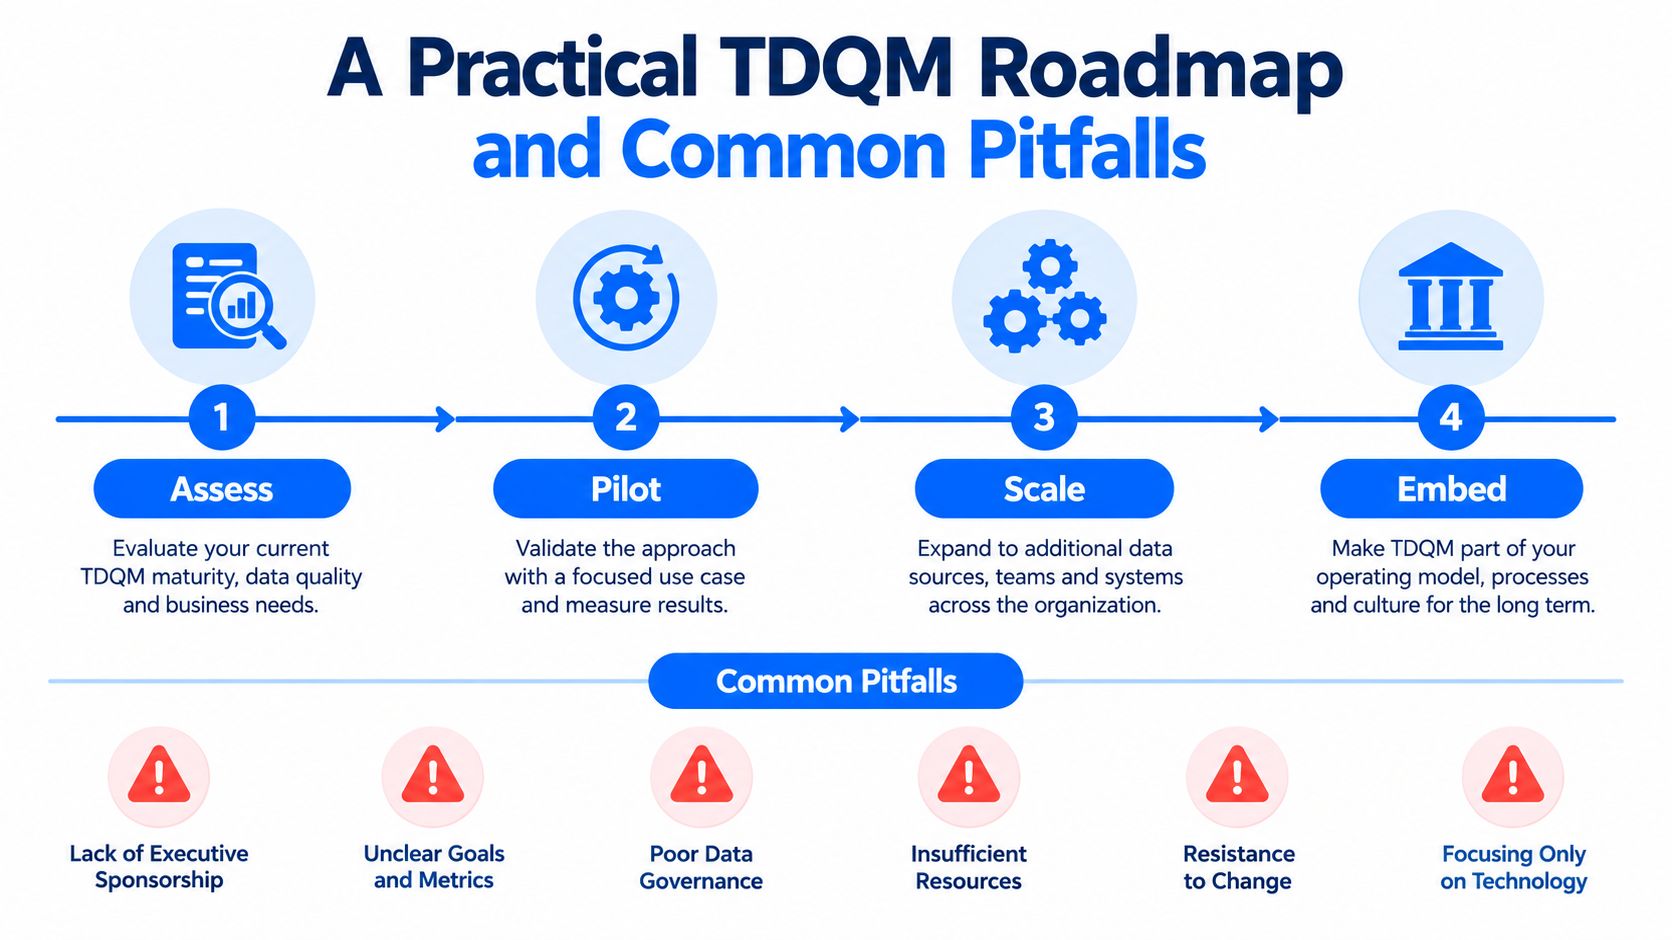
Ein tragfähiges TDQM-Programm wächst durch kontrollierte Einführung. Jede Domäne zu instrumentieren, bevor Verantwortung, Behebung und Nutzen bewiesen sind, erzeugt meist einen großen Katalog mit geringem operativem Einfluss.
Den Ist-Zustand bewerten
Beginnen Sie mit einem Inventar kritischer Datensätze, Konsumenten, Owner, bekannter Vorfälle, bestehender Regeln und Liefererwartungen. Befragen Sie Finanzen, Betrieb, Analytik, Engineering und Compliance. Das erste Ergebnis sollte eine Baseline-Scorecard sein, die zeigt, wo Qualität zählt und wo Nachweise fehlen.
Eine kritische Domäne pilotieren
Wählen Sie eine Domäne mit sichtbaren geschäftlichen Folgen und einem kooperativen Owner. Kunden-, Produkt-, Transaktions- oder Regulierungsdaten eignen sich alle, sofern das Team den Fluss von der Quelle zum Konsumenten nachvollziehen kann.
Der Pilot sollte hervorbringen:
Einen fokussierten Regelkatalog, der an fachliche Anforderungen gebunden ist.
Einen Behebungs-Backlog, geordnet nach Wirkung und Ursache.
Eine Lineage-Sicht, die betroffene Produzenten und Konsumenten zeigt.
Einen Eskalationsweg mit benannten Entscheidern.
Einen Prüftakt, um zu messen, ob Korrekturen halten.
Ein Pilot ist erfolgreich, wenn Teams lernen, Qualitätsentscheidungen zu treffen, und nicht bloß, wenn sie ein grünes Dashboard erzeugen.
Über Domänen hinweg skalieren
Sobald das Betriebsmuster funktioniert, erstellen Sie eine Charta für ein Center of Excellence, die Standards, wiederverwendbare Kontrollen, Namenskonventionen, Verantwortungserwartungen und Nachweisanforderungen definiert. Domänenteams sollten für ihre Datenprodukte verantwortlich bleiben, während die zentrale Funktion Methoden, Enablement und Konsistenz liefert.
Qualität in die Auslieferung einbetten
Der letzte Schritt macht Qualität zum Teil normaler Engineering- und Governance-Workflows. Ergänzen Sie Qualitäts-Gates in CI/CD, wo sinnvoll, prüfen Sie Datenkontrakte mit Produzenten und Konsumenten und verlangen Sie, dass Änderungsprozesse Schema-, Lineage- und Auswirkungsprüfungen einschließen.
Ein Qualitätsprogramm wird dauerhaft, wenn Teams einen Fehler erkennen, erklären, zuweisen und verhindern können, ohne auf ein Sonderprojekt zu warten.
Häufige Fallstricke untergraben ansonsten sinnvolle Programme:
Einmalige Bereinigung: Eine korrigierte Tabelle verfällt, wenn der Quellprozess unverändert bleibt.
Messung ohne Befugnis: Ein Steward ohne Einfluss auf den Produzenten kann wiederkehrendes Versagen nur dokumentieren.
Fixierung auf Genauigkeit: Genaue, aber verspätet gelieferte Daten können einen operativen oder regulatorischen Anwendungsfall dennoch scheitern lassen.
Fehlende Datenkontrakte: Produzenten und Konsumenten können sich über Felder, Formate, Lieferzeitpunkte und zulässige Änderungen uneins sein.
Schwaches Sponsoring: Teams priorisieren Qualität oft nach unten, wenn Führungskräfte sie nicht mit Geschäftsrisiko verbinden.
Tragfähige Programme zeigen wiederkehrende Verantwortungs-Reviews, schrumpfende Behebungsschlangen, schnellere Erkennung, dokumentierte Ursachen und Kontrollen, die innerhalb gewöhnlicher Lieferprozesse laufen. Initiativen, die an Schwung verlieren, erzeugen meist Berichte, ohne zu ändern, wer den zugrunde liegenden Prozess verantwortet. Hinweise zu strukturellen Ursachen finden sich unter warum Datenqualitätsprojekte scheitern und welche strukturellen Korrekturen helfen.
Wie moderne Plattformen TDQM zum Leben erwecken
TDQM wird operativ, wenn eine Plattform Anforderungen, Kennzahlen, Lineage, Erkennung, Workflows und Nachweise verbindet. Die Werkzeugauswahl sollte daher dem Betriebsmodell folgen. Eine Plattform, die Anomalien erkennt, aber keine Verantwortung zuweisen kann, verbessert womöglich die Sichtbarkeit, nicht aber die Qualität. Eine Regel-Engine ohne Lineage kann einen Fehler benennen und das Team dennoch im Unklaren lassen, wo einzugreifen ist.
TDQM-Säule | Plattformmodul | Zentrale Fähigkeit | Geschäftsergebnis |
|---|---|---|---|
Define | Katalog und Profiling | Kritische Datenelemente, Konsumenten, Owner und Baseline-Verhalten dokumentieren | Gemeinsame Qualitätserwartungen |
Measure | Timeliness und Schema-Tracking | Ankunftsmuster, strukturelle Änderungen und messbare Qualitätssignale überwachen | Frühere Erkennung von Liefer- und Kompatibilitätsrisiken |
Analyze | Anomalieerkennung und Analytik | Aktuelles Verhalten mit historischen Mustern vergleichen und ungewöhnliche Änderungen sichtbar machen | Schnellere Untersuchung und bessere Priorisierung |
Improve | Validierung und Workflow-Automatisierung | Geschäftsregeln anwenden, Befunde erzeugen und Behebung weiterleiten | Weniger wiederkehrende Fehler |
Kontrolle | Richtlinien- und Stewardship-Workflows | Verantwortung, Eskalation, Nachweise und Prüfpraktiken durchsetzen | Wiederholbare Governance |
Die Architektur hinter den Modulen
Define und Analyze profitieren von statistischem Profiling und Anomalieerkennung. Baseline-Lernen kann ungewöhnliche Volumina, Verteilungen oder Geschäftskennzahlen erkennen, ohne für jede mögliche Änderung eine Regel zu verlangen. Menschliche Prüfung bleibt wichtig, besonders wenn ein ungewöhnliches Muster ein legitimes Geschäftsereignis statt eines Fehlers abbildet.
Measure hängt von mehr als Zeilenzahlen ab. Schema-Tracking kann hinzugefügte oder entfernte Spalten und Datentypänderungen erkennen. Timeliness-Monitoring kann beobachtetes Lieferverhalten mit erwarteten Zeitplänen vergleichen, während Lineage zeigt, welche Berichte, Modelle und nachgelagerten Tabellen betroffen sein können.
Improve verlangt deterministische Kontrollen. Validierung auf Satzebene kann Geschäftsregeln durchsetzen, mehrspaltige Eindeutigkeitsprüfungen können die Entitätsintegrität schützen, und referenzielle Prüfungen können gebrochene Beziehungen aufdecken. Workflow-Automatisierung verwandelt Befunde dann in zugewiesene Behebung statt passiver Alerts.
Was technisch zu prüfen ist
Im Unternehmensmaßstab fragen Sie, ob Prüfungen in-database laufen können, ob Push-down-SQL unnötige Datenbewegung reduziert und ob die Plattform halbstrukturierte Quellen ebenso behandelt wie relationale Tabellen. Für KI-Anwendungsfälle testen Sie, ob das System Kontext für ungewöhnliche Embeddings, Dokumente, Transkripte oder modellgenerierte Ausgaben liefern kann, statt Qualität auf tabellarische Null- und Formatprüfungen zu begrenzen.
digna ist eine Plattformoption, die In-Database-Ausführung, Anomalieerkennung, Timeliness-Monitoring, Validierung, Schema-Tracking, Analytik und stewardship-orientierte Workflows in der Umgebung des Kunden vereint. Die Auswahl einer solchen Plattform ist eine Architekturentscheidung, weil sie bestimmt, wo Nachweise entstehen, wie Daten an Ort und Stelle bleiben und wie Teams Qualitätsbefunde mit dem Lebenszyklus verbinden.
Branchenspezifische Aspekte in regulierten Sektoren
Ein Qualitätsschwellenwert hat nur im Betriebskontext Bedeutung. Derselbe verspätete Datensatz kann in einer Domäne lästig und in einer anderen operativ gefährlich sein.
Branche | Wichtigste TDQM-Dimensionen | Repräsentativer KPI | Typisches Risikoszenario |
|---|---|---|---|
Finanzwesen | Genauigkeit und Gültigkeit | Abstimmungs- oder Regelverstoßquote | Ein ungültiges oder inkonsistentes Handelsattribut beeinflusst Überwachung oder Meldung |
Gesundheitswesen | Eindeutigkeit und Konsistenz | Quote doppelter Patienten und systemübergreifender Abweichungen | Doppelte Datensätze zersplittern eine Krankengeschichte oder verdecken eine Kontraindikation |
Telekommunikation | Timeliness und Konsistenz | Zahl verspäteter Ladungen und Abstimmungsausnahmen | Verspätete CDRs oder Rating-Abweichungen erzeugen Abrechnungs- und Umsatzrisiko |
Öffentlicher Sektor | Vollständigkeit und Nachvollziehbarkeit | Vollständigkeit der Pflichtfelder und Lineage-Abdeckung | Ein unvollständiger behördenübergreifender Datensatz beeinflusst Anspruch oder eine bürgernahe Entscheidung |
Im Finanzwesen kann ein Feed zur Handelsüberwachung pünktlich eintreffen und dennoch eine ungültige Instrumentenklassifizierung enthalten. Ein Abstimmungsprozess vergleicht dann Datensätze, die strukturell vorhanden, semantisch aber falsch sind. Genauigkeit und Gültigkeit verdienen Priorität, während Lineage hilft zu zeigen, wie eine gemeldete Zahl entstand. Aufsichtsbehörden werden zu Datenkonsumenten, nicht bloß zu Prüfern. Wer die breitere Bedeutung von Regulatory Compliance braucht, kann diese rechtliche Übersicht als Kontext nutzen, warum Nachweise und Kontrollverantwortung zählen.
Gesundheitsteams begegnen einem anderen Fehlermuster. Ein Patient kann mehrfach erscheinen, weil Kennungen zwischen Systemen abweichen, und eine HL7- oder FHIR-Schemaänderung kann eine Schnittstelle brechen, ohne sofort einen offensichtlichen Dashboard-Fehler zu erzeugen. Eindeutigkeit und Konsistenz wiegen daher schwer, und die Analyse muss doppelte oder abweichende Datensätze mit dem betroffenen klinischen Workflow verbinden.
Der Telekommunikationsbetrieb hängt stark am Ereigniszeitpunkt. Call Detail Records, Roaming-Daten und Rating-Eingaben können über mehrere Partnerwege eintreffen. Ein verspäteter Datensatz oder eine Abweichung zwischen Roaming-Partner und Rating-Engine kann Abstimmungsausnahmen oder Umsatzverluste erzeugen. Timeliness-Monitoring sollte mit Konsistenzprüfungen über die beteiligten Systeme kombiniert werden.
Programme des öffentlichen Sektors führen oft Daten aus Behörden mit unterschiedlichen Definitionen, Verantwortungsmodellen und Erhebungspraktiken zusammen. Unvollständige Datensätze können Anspruch, Leistungserbringung oder eine bürgernahe Entscheidung beeinflussen. Entitätsauflösung, Stammdatenkontrollen, Lineage und Audit-Trails helfen Teams zu erklären, welche Informationen ein Ergebnis trugen und woher der Datensatz stammte.
Eine kurze TDQM-Reife-Checkliste und die nächsten Schritte
Nutzen Sie dieses kompakte Modell, um Ihre aktuelle Betriebsstufe zu verorten:
Stufe 1, Reaktiv: Teams decken wenige Dimensionen ab, untersuchen nach Vorfällen und stützen sich auf informelle Verantwortung.
Stufe 2, Proaktiv: Teams messen ausgewählte kritische Datensätze in festem Takt und pflegen grundlegende Regeln und Owner.
Stufe 3, Gesteuert: Domänen nutzen Scorecards, Lineage, Behebungs-Workflows, Qualitäts-Gates und dokumentierte Standards.
Stufe 4, Kontinuierlich und KI-gestützt: Teams verbinden automatisiertes Monitoring, gelernte Baselines, Stewardship und laufende Kontrollen über strukturierte und unstrukturierte Daten hinweg.
Die nächste Grenze ist breitere Observability für Dokumente, Embeddings, Transkripte, Bilder, Audio und andere nicht-tabellarische Assets. Aktuelle Marktanalysen führen unstrukturierte Daten 2025 als erstrangiges Kriterium in Datenqualitätsbewertungen, wobei Werkzeuge diese Assets profilieren und bereinigen sollen, wie die Diskussion zu Augmented-Data-Quality-Lösungen zeigt. Fangen Sie klein an: einen kritischen Datensatz baselinen, eine Anomalieprüfung automatisieren und einen verantwortlichen Domain Owner benennen.

digna hilft Unternehmen, Datenqualität und Observability in der eigenen Umgebung zu überwachen, über Validierung, Anomalieerkennung, Timeliness-Monitoring, Schema-Tracking und In-Database-Analyse. Besuchen Sie digna, um TDQM-Prinzipien mit praktischen Kontrollen für die Datensätze zu verbinden, die Ihre Analytik- und KI-Systeme tragen.
Das Vokabular hinter den Phasen Define und Measure erklärt der Beitrag dazu, was Datenqualitätsmanagement umfasst.
Häufig gestellte Fragen
Was ist Total Data Quality Management?
TDQM ist eine durchgängige Betriebsdisziplin, die Daten als Produkt mit Kunden behandelt und fachliche Anforderungen, technische Kontrollen, Stewardship, Monitoring und Behebung verbindet, statt am Ende einer Pipeline einen Bereinigungsschritt anzuflanschen.
Welche vier Phasen hat der TDQM-Zyklus?
Define, Measure, Analyze und Improve. Define legt fest, was Tauglichkeit für ein gegebenes Informationsprodukt bedeutet, Measure instrumentiert es, Analyze findet die Ursache von Abweichungen, und Improve ändert den Prozess statt das Symptom zu flicken, dann wiederholt sich der Zyklus.
Was bedeutet die Denkweise vom Informationsprodukt?
Sie bedeutet, einen Datensatz wie etwas zu behandeln, das für einen Kunden gefertigt wird, mit Spezifikationen, einem Produktionsprozess und einem für Mängel verantwortlichen Owner. Genau diese Sicht macht vorgelagerte Prävention zur Standardreaktion statt nachgelagerter Korrektur.
Welche KPIs passen zu einem TDQM-Programm?
Solche, die sich wie Betriebssignale verhalten und nicht wie Audit-Momentaufnahmen. Ein vierteljährlicher Qualitätsprozentsatz sagt wenig; Erkennungs- und Lösungszeiten, Wiederholungsraten und der Anteil der vor einer Konsumentenmeldung erkannten Probleme zeigen, ob der Zyklus wirkt.
Woran scheitern TDQM-Programme meist?
Am Skalieren vor dem Beweis. Was funktioniert: den Ist-Zustand bewerten, eine kritische Domäne pilotieren, dann über Domänen skalieren und Qualität in die Auslieferung einbetten. Programme, die unternehmensweit starten, erzeugen Befunde ohne Owner.


