Apache Kafka Datenintegration: Ein praktischer Leitfaden
|
6
min. Lesezeit

Um 3:00 Uhr morgens lautet der Alarm in der Regel nicht „Ihre Ingestion-Architektur ist falsch“. Er besagt, dass der Consumer-Lag steigt, ein Sink-Task einen erneuten Versuch startet oder eine Downstream-Tabelle nicht mehr aktualisiert wird. Bis jemand das Problem vom Producer über Kafka bis ins Lakehouse zurückverfolgt, ist der ursprüngliche Fehler möglicherweise unter Rebalances, Retries, Schema-Mismatches und doppelten Datensätzen begraben.
Aus diesem Grund muss die Apache Kafka-Daten-Ingestion als vollständiger Lebenszyklus konzipiert sein. Kafka kann ein robustes Event-Backbone mit hohem Durchsatz bieten, aber die Produktionszuverlässigkeit hängt davon ab, was passiert, bevor Datensätze einen Broker erreichen und nachdem Consumer sie gelesen haben. Topic-Design, Partitionierung, Delivery-Semantik, Schema-Enforcement, Sink-Verhalten und Observability bestimmen alle, ob die Pipeline unter Druck korrekt bleibt.
Inhaltsverzeichnis
Die wahre Herausforderung hinter der Kafka-Ingestion
Jede frühe Entscheidung führt zu Downstream-Arbeit
Zuverlässigkeit schließt das Ende der Kurve ein
Kernarchitekturmuster für Ingestion-Pipelines
Direkter Producer-zu-Broker
Gateway oder REST-Proxy
Kafka Connect für Quell- und Sink-Integration
Streaming-ETL mit Kafka Streams oder Flink
Producer und Consumer bauen, die tatsächlich funktionieren
Die Producer-Konfiguration sollte den Vertrag ausdrücken
Consumer-Konfiguration schützt den Fortschritt
Schema-Handling und Strategien zur Fehlerbehebung
Schema-Evolution erfordert eine erzwungene Grenze
Wiederholbare und finale Fehler trennen
Delivery-Semantik im Vergleich zur Arbeitslast
Tuning von Partitionen und Batching für den Durchsatz
Benchmarking vor der Änderung der Produktionstopologie
Optimierung für die Arbeitslast, nicht für eine Checkliste
Das Downstream-Problem, über das niemand spricht
Broker-Gesundheit kann Sink-Fehler verbergen
Governance gehört auf die Exposure-Ebene
Betriebliche Gewohnheiten und eine Pre-Launch-Checkliste
Gewohnheiten, die nächtliche Benachrichtigungen verhindern
Die Woche vor dem Start
Die wahre Herausforderung hinter der Kafka-Ingestion
Der erste schwerwiegende Produktionsausfall, den ich in einer Zahlungs-Pipeline gesehen habe, begann nicht mit dem Ausfall eines Brokers. Ein Rollout der Schema-Evolution löste zum falschen Zeitpunkt ein Consumer-Rebalance aus. Ein Consumer machte keine nützlichen Fortschritte mehr, der Backlog wuchs und der nachgelagerte Lakehouse-Sink begann, doppelte Zeilen zu schreiben, da die Recovery-Logik bereits in den Speicher gelangte Arbeit erneut versuchte.
Der Broker war gesund. Die Producer-Fehlerraten sahen normal aus. Der Vorfall führte dennoch zu einem Alarm um 3:00 Uhr morgens, weil das Team die Ingestion als bloße Verbindung zwischen einer Anwendung und Kafka behandelt hatte und nicht als Kette von zustandsbehafteten Verträgen. Die praktische Definition der Daten-Ingestion ist breiter als der reine Transport, wie der data ingestion meaning guide verdeutlicht. Datensätze müssen ankommen, interpretierbar bleiben, innerhalb eines akzeptablen Fensters verarbeitet werden und ihr Ziel erreichen, ohne an Qualität zu verlieren.
Jede frühe Entscheidung führt zu Downstream-Arbeit
Der Partition Key eines Topics bestimmt die Reihenfolge und Lastverteilung. Die Partitionsanzahl begrenzt die Parallelität der Consumer und beeinflusst Rebalances. Producer-Bestätigungen und Idempotenz beeinflussen das Verhalten bei Duplikaten. Die Größe der Consumer-Gruppe wirkt sich auf die Wiederherstellungszeit aus, während das Commit- und Retry-Modell des Sinks bestimmt, ob eine At-Least-Once-Zustellung in Form von doppelten Zeilen sichtbar wird.
Diese Entscheidungen schaffen auch Abhängigkeiten außerhalb von Kafka:
Topic-Layout: Gemeinsam genutzte Topics benötigen klare Eigentumsverhältnisse, Benennungs-, Aufbewahrungs- und Schemaregeln.
Partitioning Key: Ein schlechter Schlüssel führt zu Hot Partitions oder bricht die Reihenfolgegarantie, von der ein Geschäftsprozess abhängt.
Delivery-Semantik: Ein Buchungsereignis und flüchtige Telemetriedaten sollten nicht denselben Verarbeitungsvertrag haben.
Consumer-Größenanpassung: Das Hinzufügen von Consumern über die verfügbaren Partitionen hinaus führt nicht zu mehr nutzbarer Parallelität.
Lakehouse-Schreibvorgänge: Kontinuierliche Streams können viele kleine Dateien erzeugen, was den Compaction-Aufwand erhöht und die Abfrageeffizienz beeinträchtigt – ein Kompromiss, der im guidance on delivering Kafka data to Iceberg streaming tables hervorgehoben wird.
Praktische Regel: Eine Kafka-Pipeline ist nicht deshalb gesund, weil Producer Bestätigungen erhalten. Sie ist gesund, wenn die nachgelagerten Daten vollständig, zeitnah, korrekt geformt und wiederherstellbar bleiben.
Zuverlässigkeit schließt das Ende der Kurve ein
Im Finanz- und Gesundheitswesen kann ein Datensatz, der zu spät oder mit einem geänderten Feld ankommt, ebenso schädlich sein wie ein verlorener Datensatz. Ein Zahlungsereignis ist zwar vorhanden, aber doppelt. Ein klinisches Ereignis wird zwar zugestellt, schlägt aber nach einer Schemaänderung bei der Validierung fehl. Ein betrieblicher Feed zeigt möglicherweise einen geringen Broker-Lag, während sein Sink nicht freigegebene Dateien ansammelt.
Die folgenden Abschnitte konzentrieren sich auf diese Fehlerszenarien. Das Ziel ist nicht, Bytes nach Kafka zu verschieben. Es geht darum, den nächsten nächtlichen Alarm zu verhindern, indem der gesamte Pfad entworfen wird – vom Verhalten der Quelle und der Partitionszuweisung bis hin zu Schema-governance, Sink-Commits und den Nachweisen, die Operatoren während der Wiederherstellung benötigen.
Kernarchitekturmuster für Ingestion-Pipelines
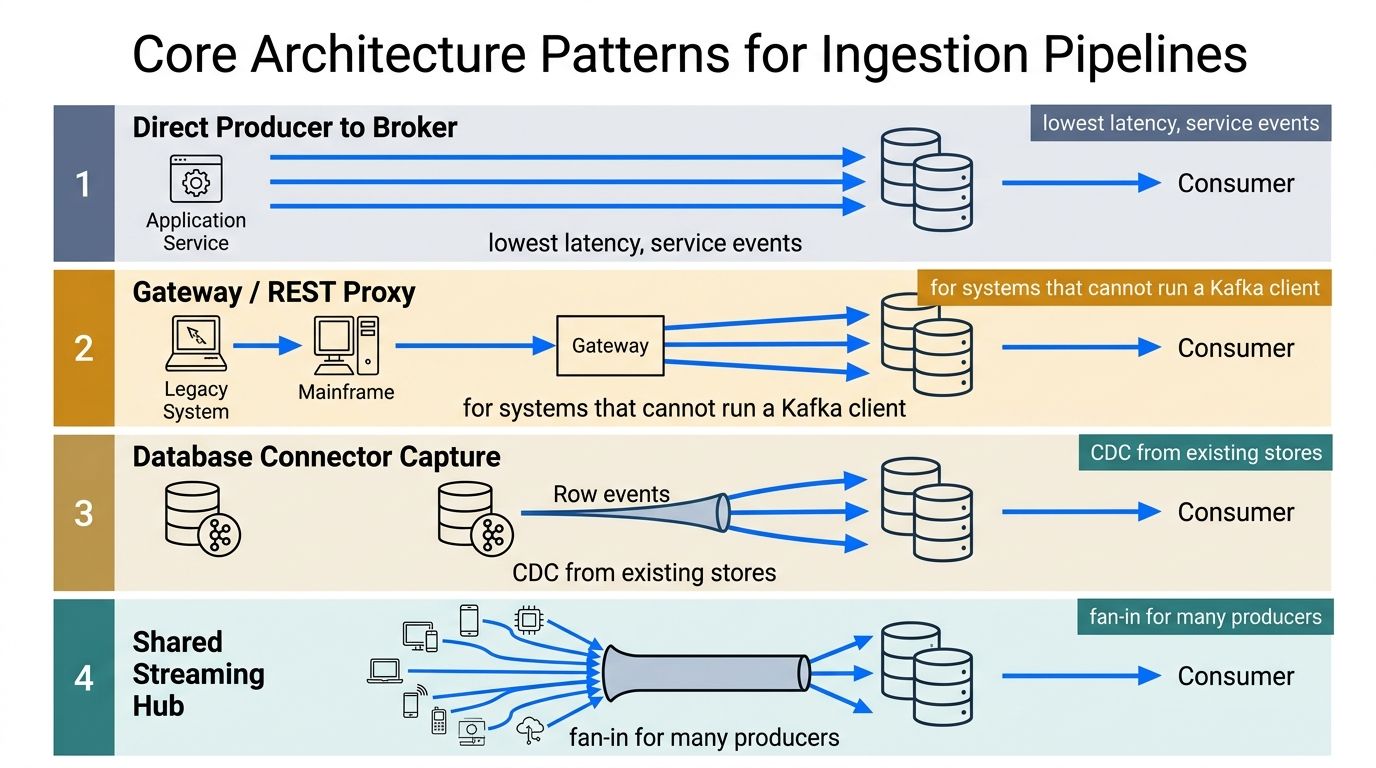
Wählen Sie die Topologie entsprechend den Fähigkeiten der Quelle und dem Downstream-Vertrag. Ein Dienst, der bereits Kafka spricht, sollte nicht durch ein HTTP-Gateway gezwungen werden, während ein Legacy-Mainframe kein Kafka-Client-Integrationsprojekt erhalten sollte, das er nicht unterstützen kann.
Direkter Producer-zu-Broker
Ein Java-, Go- oder Python-Dienst kann mithilfe eines nativen Clients direkt in Kafka veröffentlichen. Dies ist die richtige Wahl für Service-Ereignisse, Anwendungsaktivitäten, Zahlungsstatusänderungen und Telemetrie, bei denen der Producer Nachrichtenschlüssel, Batching, Retries und Schema-Serialisierung kontrolliert.
Der Vorteil liegt in der geringen Latenz und der präzisen Kontrolle. Der Preis ist die Kopplung. Jedes Producer-Team muss Delivery-Callbacks, Partition-Key-Verhalten, Authentifizierung, Schema-Kompatibilität und Backpressure verstehen. Ein direkter Producer kann zudem ein schlechtes Schlüsseldesign sofort offenlegen, was beim Testen nützlich, aber schmerzhaft ist, wenn das Topic bereits Produktionsdaten trägt.
Gateway oder REST-Proxy
Ein Gateway bietet Systemen, die keinen Kafka-Client ausführen können, eine einfachere HTTP-Schnittstelle. Legacy-Anwendungen, Mainframes, Partnerintegrationen und kleine Utilities können Datensätze übermitteln, ohne sich um die Details des Kafka-Protokolls kümmern zu müssen.
Das Gateway zentralisiert Authentifizierung, Validierung und Rate-Limiting, kann jedoch Fehler beim Partition Key verbergen. Wenn das Gateway Schlüssel zuweist oder standardmäßig eine ungeeignete Verteilungsstrategie verwendet, bemerkt das Quell-Team möglicherweise nicht, dass zusammengehörige Ereignisse ungleichmäßig verteilt werden. Es fügt zudem eine weitere Fehlergrenze hinzu, sodass Operatoren Metriken für akzeptierte Anforderungen, abgelehnte Anforderungen, in der Warteschlange befindliche Datensätze, Broker-Bestätigungen und die Downstream-Zustellung benötigen.
Kafka Connect für Quell- und Sink-Integration
Kafka Connect ist praktisch für Database-Capture, SaaS-Systeme, Dateien sowie die Bereitstellung im Warehouse oder Lakehouse. Source-Connectoren können Änderungen in Kafka veröffentlichen, während Sink-Connectoren Datensätze in externe Systeme verschieben können, ohne dass eine benutzerdefinierte Consumer-Anwendung erforderlich ist.
Das Offset-Modell von Connect vereinfacht den Neustart und die Wiederherstellung, da Connector-Tasks ihren Fortschritt speichern. Dieser Komfort sorgt nicht automatisch für ein Exactly-Once-Verhalten. Connector-Retries, sinkseitige Idempotenz, externe Commits und Task-Neustarts müssen weiterhin als ein Gesamtsystem bewertet werden. Connector-Bereitstellungen bringen zudem betrieblichen Aufwand mit sich, einschließlich Plugin-Kompatibilität, benutzerdefinierter Konfiguration, fehlgeschlagener Tasks und Wartung – Themen, die im the comparison of Kafka Connect, Flink, and Spark diskutiert werden.
Streaming-ETL mit Kafka Streams oder Flink
Verwenden Sie Kafka Streams oder Flink, wenn Datensätze angereichert, zusammengeführt, dedupliziert, in Fenstern gruppiert, zustandsbehaftet verarbeitet oder nach Event-Time behandelt werden müssen, bevor sie einen Sink erreichen. Diese Topologie hält die Transformationslogik in einer kontrollierten Streaming-Ebene, anstatt Geschäftsregeln über Producer und Connectoren zu verstreuen.
Der Kompromiss ist die betriebliche Tiefe. Zustandsbehaftete Jobs führen zu Checkpoints, Restore-Verhalten, Zustandswachstum, Bereitstellungskompatibilität und komplexeren Tests. Eine nützliche Entscheidungsheuristik ist einfach: Nutzen Sie direkte Producer für stabile Service-Verträge, Gateways für eingeschränkte Quellen, Connect für primär mechanische Verschiebungen und eine Verarbeitungs-Engine, wenn die Korrektheit vom Transformationszustand oder einer partitionsübergreifenden Logik abhängt.
Für einen umfassenderen Überblick darüber, wie Producer, Broker, Consumer und Ziele zusammenpassen, nutzen Sie diese data pipeline architecture reference.
Producer und Consumer bauen, die tatsächlich funktionieren
Ein produktiver Producer sollte doppelte Veröffentlichungen unwahrscheinlich machen, Übertragungsfehler offenlegen und nicht unendlich lange erneute Versuche unternehmen. Ein Consumer sollte Datensätze sorgfältig verarbeiten, Commits erst nach erfolgreicher Arbeit durchführen und fehlerhafte Datensätze isolieren, bevor sie eine ganze Partition blockieren.
Die Producer-Konfiguration sollte den Vertrag ausdrücken
Eine Java-Producer-Konfiguration könnte wie folgt aussehen:
acks=all lässt den Producer auf die stärkste konfigurierte Broker-Bestätigung warten. enable.idempotence=true verhindert, dass Producer-Retries doppelte Datensätze innerhalb des idempotenten Zustellungsmodells von Kafka erzeugen. Ein begrenztes linger.ms gibt Datensätzen Zeit, sinnvolle Batches zu bilden, ohne die Latenz in eine unkontrollierte Warteschlange zu verwandeln.
Ein benutzerdefinierter Partitioner sollte die geschäftlichen Anforderungen an die Reihenfolge widerspiegeln. Zahlungsereignisse erfordern in der Regel, dass alle Datensätze für ein Konto oder ein Transaktionsaggregat geordnet bleiben, während nicht zusammenhängende Konten auf die Partitionen verteilt werden sollten. Nennen Sie einen benutzerdefinierten Partitioner nicht „Sticky Ordering“, es sei denn, der Schlüssel definiert tatsächlich die Grenze der Reihenfolge.
Nutzen Sie Delivery-Callbacks und überprüfen Sie die Exception. Ein Timeout, eine Leader-Election oder ein temporärer Netzwerkfehler gehören in ein kontrolliertes Client-Retry-Verhalten. Setzen Sie delivery.timeout.ms so, dass der Client eine definierte Obergrenze hat, anstatt eine blinde Retry-Schleife um send() zu bauen.
Consumer-Konfiguration schützt den Fortschritt
Ein Python-Consumer, der confluent-kafka verwendet, kann das Zuweisungs- und Commit-Verhalten explizit machen:
Der Cooperative-Sticky-Assignor reduziert unnötige Bewegungen bei Gruppenänderungen. Manuelle Commits stellen sicher, dass der Offset erst vorgeschoben wird, nachdem der Sink den Datensatz akzeptiert hat, und nicht bereits, nachdem der Consumer ihn abgerufen hat. Ein Dead-Letter-Topic verhindert, dass ein einzelner fehlerhafter Datensatz eine Partition blockiert.
Die Poll-Schleife muss reaktionsfähig bleiben, selbst wenn das nachgelagerte System langsam ist. Wenn Lakehouse-Schreibvorgänge lange blockieren können, trennen Sie das Polling von der Verarbeitung, begrenzen Sie die Arbeitswarteschlange und passen Sie max.poll.interval.ms an den tatsächlichen Verarbeitungsvertrag an. Andernfalls kann Kafka einen langsamen, aber funktionierenden Consumer als tot interpretieren und ein erneutes Rebalance einleiten.
Auch der native Client spielt eine Rolle. librdkafka-Einstellungen wie Warteschlangenlimits, Fetch-Größen, Komprimierung, Socket-Verhalten und Statistikintervalle können den Durchsatz und die Tail-Latenz verändern. Überprüfen Sie diese Standardwerte, anstatt davon auszugehen, dass der Sprach-Wrapper die richtige Wahl getroffen hat. Die relevante Frage ist nicht, ob eine Einstellung beliebt ist, sondern welchen Fehler sie verhindert und welche Ressourcen sie verbraucht.
Eine nützliche data ingestion software overview kann dabei helfen, Transportkomponenten von den Validierungs- und Überwachungsfunktionen zu trennen, die sie umgeben sollten.
Schema-Handling und Strategien zur Fehlerbehebung
Die Delivery-Semantik ist eine Geschäftsentscheidung, die als Client-Konfiguration getarnt ist. Eine At-Most-Once-Verarbeitung kann für flüchtige Telemetriedaten akzeptabel sein. At-Least-Once ist oft die praktische Basis für Analyse-Feeds. Finanzielle Buchungsereignisse erfordern in der Regel eine idempotente Verarbeitung und eine sorgfältig entworfene Exactly-Once-Grenze.
Kafka unterscheidet zwischen At-Least-Once- und Exactly-Once-Verarbeitung. Die Unterstützung von Exactly-Once begann mit der Version 0.11.0.0 unter Verwendung von transaktionalen Producern und Consumern, um Duplikate und Verluste über Kafka-Topics hinweg zu verhindern, wie in der Confluent's delivery semantics documentation dokumentiert. Diese Fähigkeit macht einen beliebigen externen Sink jedoch nicht automatisch transaktional. Das Lakehouse, die Datenbank oder die API müssen Teil des Korrektheitsdesigns sein.
Schema-Evolution erfordert eine erzwungene Grenze
Avro, JSON Schema und Protobuf können alle funktionieren. Das Format ist weniger wichtig als die Frage, ob Producer ein gemeinsames Registry, eine Kompatibilitätsrichtlinie und einen Release-Prozess nutzen. Für gemeinsam genutzte Topics ist die Schema Registry mit abwärts- und abwärts-transitiver Kompatibilität der sicherste Standard, da Consumer eine vorhersagbare Möglichkeit benötigen, neue Datensätze zu lesen, während ältere Consumer weiterhin aktiv sind.
Schema-Drift ist gefährlicher als ein sichtbarer Absturz. Eine inkompatible Typänderung kann einen Ladevorgang stoppen, während eine nicht validierte Feldänderung im Stillen Werte verfälschen kann. Ein Registry bietet Kompatibilitätsprüfungen, aber Betreiber benötigen dennoch Warnmeldungen, wenn ein Producer eine abgelehnte Version versucht, wenn Consumer nach einem Deployment zurückfallen und wenn ein Dead-Letter-Topic zu wachsen beginnt.
Wiederholbare und finale Fehler trennen
Netzwerk-Timeouts, temporäre Leader-Elections und nicht verfügbare Broker sind in der Regel wiederholbar. Deserialisierungsfehler, ungültige Geschäftswerte und Poison Pills lassen sich nicht durch das Wiederholen derselben Operation beheben. Leiten Sie finale Fehler an ein Dead-Letter-Topic weiter – zusammen mit dem ursprünglichen Payload, Topic, Partition, Offset, Schema-Identifikator, der Fehlerklasse und dem Verarbeitungs-Zeitstempel.
Für einen transaktionalen Verarbeitungspfad gehören zu den wichtigen Einstellungen:
Die transactional.id muss pro Verarbeitungsidentität stabil sein und während des Deployments sorgfältig verwaltet werden. Consumer, die read_committed verwenden, vermeiden es, abgebrochene transaktionale Datensätze offenzulegen, aber Exactly-Once erfordert dennoch eine atomare Koordination zwischen Lesen, Verarbeiten und Schreiben. Idempotente Producer sind eine günstige Absicherung. Echtes Exactly-Once ist eine bewusste architektonische Entscheidung, kein Standard.
Delivery-Semantik im Vergleich zur Arbeitslast
Arbeitslast | Delivery-Semantik | Schema-Strategie | Fehler-Routing | Schlüsselkonfiguration |
|---|---|---|---|---|
Fire-and-Forget-Telemetrie | At-Most-Once, wo Verluste akzeptabel sind | Versioniertes JSON oder Protobuf mit Validierung | Ungültige Datensätze nur verwerfen oder stichprobenartig erfassen, wenn der Geschäftsinhaber Verluste akzeptiert | Begrenztes Delivery-Timeout |
Operative Analysen | At-Least-Once mit Sink-Deduplizierung | Registry-verwaltetes Avro, JSON Schema oder Protobuf | Dead-Letter-Topic für finale Fehler |
|
Zahlungstransaktionsereignisse | Exactly-Once über die definierte Verarbeitungsgrenze | Registry-verwaltetes Schema mit strenger Kompatibilität | Temporäre Fehler wiederholen, Poison-Datensätze isolieren | Transaktionen, |
Klinische Ereignisse im Gesundheitswesen | At-Least-Once oder Exactly-Once gemäß Quell- und Sink-Vertrag | Explizite Kompatibilitätsrichtlinie und Feldvalidierung | Dead-Letter-Topic mit Audit-Metadaten | Manuelle Commits nach validierter Persistenz |
Nutzen Sie eine klare Schema-Taxonomie, bevor Sie Topics erstellen. Schema types and their trade-offs bieten nützlichen Kontext, aber die betriebliche Regel bleibt dieselbe: Jedes gemeinsam genutzte Topic benötigt einen Eigentümer, eine Kompatibilitätsrichtlinie und einen Replay-Pfad.
Tuning von Partitionen und Batching für den Durchsatz
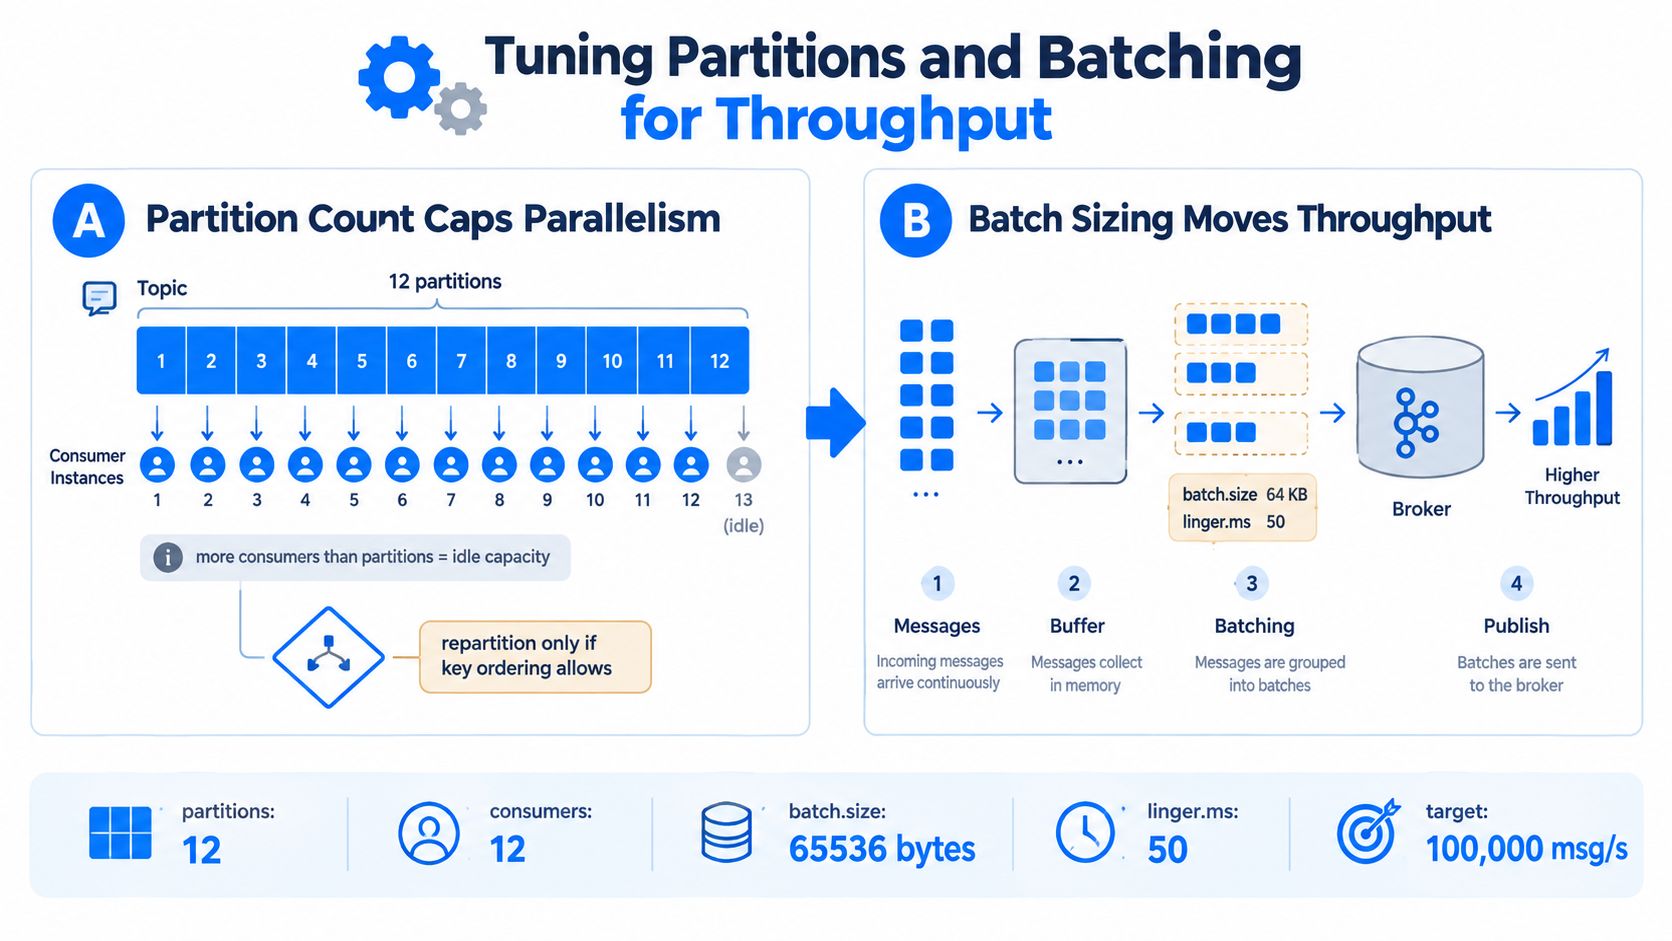
Zwei Stellschrauben beeinflussen den Durchsatz der Kafka-Ingestion in der Regel stärker als cleverer Anwendungscode: Partitionsanzahl und Batch-Größe. Partitionen ermöglichen Parallelität, erzeugen aber auch Dateien, Metadaten, Replikationsaufwand und Zuweisungs-Overhead. Sobald ein Topic in der Produktion ist, ist das Reduzieren seiner Partitionsanzahl keine sichere Routineaufgabe mehr. Planen Sie daher Raum für Wachstum ein, ohne unnötig große Cluster-Ressourcen zu verbrauchen.
Ein praktisches Modell zur Größenbestimmung beginnt mit dem erwarteten Spitzendurchsatz geteilt durch den nachhaltigen Durchsatz einer einzelnen Partition unter der beabsichtigten Schlüsselverteilung. Eine Tuning-Referenz nennt einen groben nachhaltigen Bereich von 10 bis 30 MB/s pro Partition, was jedoch als Ausgangshypothese und nicht als Garantie zu betrachten ist. Führen Sie Benchmarks mit echten Payload-Größen, Komprimierung, Replikation, Broker-Hardware und ungleichmäßig verteilten Schlüsseln durch.
Benchmarking vor der Änderung der Produktionstopologie
Die von Kafka und Anbietern veröffentlichten Benchmarks zeigen, warum die Konfiguration eine Rolle spielt. Ein empirischer Benchmark verzeichnete etwa 420.000 Nachrichten pro Sekunde auf Standard-Hardware mit einer Partition und dem Replikationsfaktor eins, während eine andere Studie etwa 800.000 Nachrichten pro Sekunde auf einem einzelnen, korrekt konfigurierten Broker meldete. Eine Azure-Engineering-Fallstudie nannte rund 2 GB/s mit 10 Brokern und 16 Festplatten pro Broker. Diese Zahlen stammen aus unterschiedlichen Umgebungen und sind nicht austauschbar. Nutzen Sie sie daher, um die Größenordnung zu bestimmen, und nicht, um ein konkretes Ergebnis zu versprechen. Siehe die Kafka history and performance reference für den historischen und Benchmark-Kontext.
Das Batching kann eine dramatische Wirkung haben. Ein Benchmark zeigte, dass der Wechsel von einer 16 KB Batch-Größe auf 100 KB den Producer-Durchsatz um etwa 300 % steigerte, während ein anderer 605 MB/s mit einer 1 MB batch.size, linger.ms=10 ms, 100 Partitionen und 3-facher Replikation maß, wie im Kafka throughput benchmark zusammengefasst.
Optimierung für die Arbeitslast, nicht für eine Checkliste
Starten Sie Producer-Tests mit steigender Producer-Anzahl, bis sich die p99-Latenz dem Service-Level-Ziel nähert. Erhöhen Sie dann die Partitionen, um sie an die gewünschte Parallelität anzupassen, und überprüfen Sie, ob sich die Schlüssel gleichmäßig verteilen. Zu große Partitionszahlen erzeugen Metadaten- und Koordinations-Overhead, während zu wenige Partitionen zu Hot Partitions und Lag-Spitzen bei Lastspitzen führen.
Testen Sie für Producer ein begrenztes linger.ms im Bereich von 5 bis 20 ms und eine batch.size zwischen 64 KB und 256 KB, bevor Sie größere Batches in Betracht ziehen. zstd oder lz4 können den Netzwerk- und Speicherdruck bei protokollartigen Payloads verringern, aber die Komprimierung verbraucht CPU. Setzen Sie buffer.memory über die erwartete Lastspitzenrate an, damit kurze Verzögerungen beim Sink oder Broker nicht sofort zu Producer-Fehlern führen.
Begrenzen Sie für Consumer max.poll.records, damit die Verarbeitung innerhalb des Poll-Intervalls bleibt. Optimieren Sie fetch.min.bytes, um Broker-Roundtrips zu amortisieren, wenn es die Latenz zulässt, und nutzen Sie statische Mitgliedschaften, wenn Deployments andernfalls vermeidbare Gruppenwechsel verursachen würden. Denken Sie daran, dass der Consumer-Durchsatz in der Regel stagniert, sobald die Anzahl der Consumer die Partitionsanzahl übersteigt. Mehr Prozesse erzeugen keine Arbeit, die das Topic nicht zuweisen kann.
Das Downstream-Problem, über das niemand spricht
Die Kafka-Ingestion ist nicht abgeschlossen, wenn der Broker einen Datensatz akzeptiert. Die schwerwiegenden Fehler treten häufig auf, wenn ein Sink einen unbegrenzten Event-Stream in Lakehouse-Tabellen, Warehouse-Zeilen oder Service-Aufrufe umwandelt. Eine Pipeline kann die Ziele von Producer und Broker erfüllen, während die nachgelagerten Daten verspätet, fragmentiert, fehlerhaft oder für Benutzer unsichtbar bleiben.
Schreibvorgänge mit hohem Durchsatz in Iceberg können viele kleine Dateien erzeugen. Diese Dateien erhöhen den Aufwand für Metadaten und Compaction, und Abfragen verlangsamen sich, wenn das Tabellen-Layout fragmentiert. Teams müssen entscheiden, wie viel Aktualität sie vor der Compaction akzeptieren und wie sie Schreibvorgänge gruppieren, ohne einen unbewältigbaren Backlog zu erzeugen. Betrachten Sie den Lakehouse-Sink als Teil des Ingestion-Designs, bei dem Dateigröße, Commit-Verhalten, Compaction-Kapazität und abfrage-sichtbare Aktualität gemeinsam überwacht werden.
Broker-Gesundheit kann Sink-Fehler verbergen
Der Kafka-Consumer-Lag ist die Differenz zwischen dem neuesten produzierten Offset einer Partition (dem Log-End-Offset) und dem zuletzt von einer Consumer-Gruppe committeten Offset. Es handelt sich um ein Signal pro Partition und nicht um ein vollständiges Maß für die End-to-End-Aktualität, wie in this consumer lag reference erklärt wird.
Ein Sink kann Offsets committen, während Schreibvorgänge verzögert, gepuffert, dupliziert oder für Abfragen noch nicht verfügbar sind. Überwachen Sie den gesamten Pfad:
Brokerseite: Log-End-Offset, committeter Offset, Lag pro Partition, Request-Latenz, unterreplizierte Partitionen, Festplattenauslastung und Partition-Skew.
Consumerseite: Verarbeitungsdauer, persistierte Datensätze, Retry-Anzahl, Rebalance-Ereignisse, Deserialisierungsfehler und Dead-Letter-Volumen.
Sinkseite: Commit-Latenz, Dateierstellungsrate, Akkumulation kleiner Dateien, Compaction-Backlog, abgewiesene Schreibvorgänge, Transaktionskonflikte und abfrage-sichtbare Aktualität.
Datenseite: Zeitnahes Eintreffen, Zeilenanzahl, Null-Muster, Eindeutigkeit der Schlüssel, Fehler bei Geschäftsregeln und Schemaänderungen.
Schema-Drift stellt einen weiteren stillen Fehlerpfad dar. Ein veraltetes Feld wird möglicherweise weiterhin über den Producer und Broker übertragen, während eine nachgelagerte Tabelle es ignoriert oder ihm die falsche Bedeutung zuweist. Erzwingen Sie Kompatibilität an der Topic-Grenze, erfassen Sie die Schemaversion bei jedem Ereignis und weisen Sie einen Verantwortlichen für Änderungen und Fehlerbenachrichtigungen zu.
Governance gehört auf die Exposure-Ebene
Neue Consumer sollten über definierte Identitäten, Rate-Limits, zulässige Topics, Schema-Zugriff, Aufbewahrungserwartungen und Audit-Trails verfügen, die an ein verantwortliches Team oder einen Geschäftszweck gebunden sind. Informelle Freigaben und benutzerdefinierte Proxys machen den Zugriff schwer überprüfbar und widerrufbar.
Dies ist im Finanzwesen, im Gesundheitswesen, in der Telekommunikation und im öffentlichen Sektor von Bedeutung. Betreiber müssen nachweisen können, dass Datensätze in der erwarteten Form, innerhalb des erforderlichen Zeitfensters und mit einem nachvollziehbaren Recovery-Pfad eingetroffen sind. Zur Consumer-governance gehören daher Zugriff, Nutzung, Replay-Autorisierung und die nachgelagerte Datenqualität.
Eine Pipeline ist nur so zuverlässig wie ihr langsamster, am wenigsten überwachter Schritt.
Betriebliche Gewohnheiten und eine Pre-Launch-Checkliste
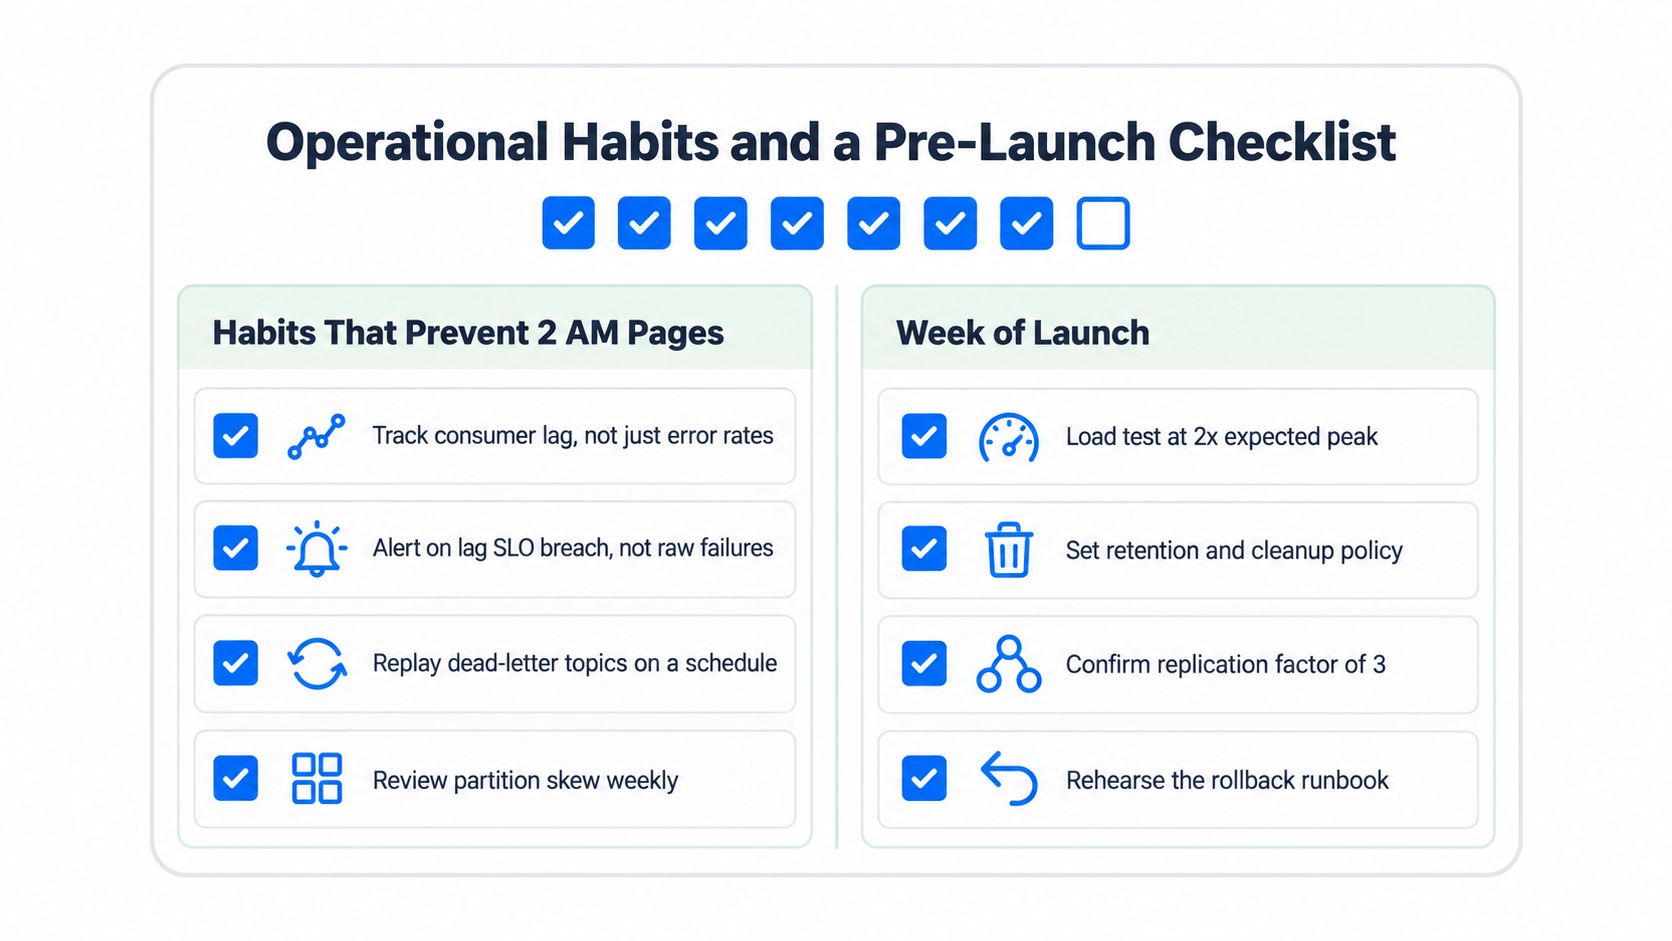
Zuverlässige Teams warten nicht bis zum Tag des Starts, um festzustellen, dass ihre Schlüsselverteilung ungleichmäßig ist oder ihr Sink nicht hinterherkommt. Sie führen Lasttests mit realistischen Datensätzen durch, überprüfen wöchentlich Dashboards und behandeln das Replay als normales Betriebsverfahren und nicht als Notfallmaßnahme.
Gewohnheiten, die nächtliche Benachrichtigungen verhindern
Überwachen Sie den Consumer-Lag im Vergleich zu einem SLO, nicht nur die reinen Fehlerraten. Ein Consumer kann fehlerfrei arbeiten, aber zu langsam für die geschäftliche Frist sein. Richten Sie Alarme für Lag-Überschreitungen, Partition-Skew, Speicherplatzmangel auf dem Broker, häufige Rebalances und das Anwachsen von Dead-Letter-Dateien ein.
Überprüfen Sie wöchentlich Grafana-Dashboards und JMX-Metriken, einschließlich Producer-Request-Latenz, Datensatz-Batch-Größe, Consumer-Fetch-Rate, Commit-Latenz, eingehenden und ausgehenden Bytes, unterreplizierten Partitionen und Gruppen-Rebalance-Aktivitäten. Die Überprüfung sollte Trends aufzeigen, bevor nachgelagerte Dashboards sie sichtbar machen.
Dead-Letter-Topics benötigen klare Verantwortlichkeiten und einen Zeitplan für das Replay. Eine DLQ, die unendlich wächst, ist keine Wiederherstellung. Es ist eine undokumentierte Quarantäne.
Die Woche vor dem Start
Führen Sie die folgenden Prüfungen in einer staging-Umgebung durch, die der Produktion entspricht:
Lastverteilung: Testen Sie mit realistischen Schlüsselverteilungen, einschließlich Hot-Key-Szenarien und stoßartigem Datenverkehr.
Schema-Kompatibilität: Registrieren Sie repräsentative Versionen und überprüfen Sie das abwärts- und abwärts-transitive Verhalten mit der Confluent Schema Registry.
Broker-Ausfall: Beenden Sie einen Broker während der Ingestion und bestätigen Sie die Wiederherstellung von Producern, Consumern und die Korrektheit des Sinks.
Offset-Wiederherstellung: Stellen Sie sicher, dass die Offset-Aufbewahrungszeit das Worst-Case-Wiederherstellungsfenster überschreitet. Kafka bewahrt Consumer-Offsets für einen konfigurierbaren Zeitraum auf, nachdem eine Gruppe inaktiv wird, gesteuert durch
offsets.retention.minutes; Red Hat dokumentiert zudemauto.offset.reset=earliestals eine Möglichkeit, Datenverlust zu vermeiden, wenn ein committeter Offset nicht mehr gültig ist, wie in der the Red Hat consumer configuration guidance beschrieben.Runbooks: Dokumentieren Sie die drei häufigsten Fehlerszenarien, den jeweiligen Verantwortlichen, das Rollback-Verfahren und den Replay-Befehl oder -Workflow.
Nutzen Sie die pipeline orchestration guidance, um zu klären, welches System die Wiederherstellung plant, welches System das Ergebnis validiert und welches Team den Vorfall schließt. Zuverlässigkeit bei der Ingestion wird durch kontinuierliche betriebliche Überprüfung erarbeitet, nicht durch eine finale Konfigurationsänderung.
digna bietet daten-observability direkt in der Umgebung für Kafka-gestützte Pipelines, einschließlich Aktualitätsüberwachung, Datensatzvalidierung, Anomalieerkennung und kontinuierlicher Verfolgung von Schemaänderungen über nachgelagerte Datenbestände hinweg. Besuchen Sie digna, um zu sehen, wie die modulare Plattform dabei helfen kann, Broker-Aktivitäten mit den Signalen für Datenqualität und -aktualität zu verknüpfen, die Ihre Ingestion-Runbooks benötigen.


