Datenqualitätsmanagement einfach erklärt
|
7
min. Lesezeit

Ein vertrauenswürdiges Dashboard fällt fünf Minuten vor einer Überprüfung durch die Geschäftsführung aus. Der Umsatz sieht ungewöhnlich niedrig aus, ein Kundensegment scheint verschwunden zu sein, und das Team beginnt gleichzeitig, SQL, Dashboards und Pipeline-Logs zu prüfen. Niemand kann sofort sagen, ob das Quellsystem unvollständige Datensätze gesendet hat, eine Transformation die Bedeutung eines Feldes verändert hat, eine Ladung verspätet eintraf oder das Dashboard die falsche Tabelle abgefragt hat.
Diese Unsicherheit ist das Problem der Datenbankqualität. Eine Datenbank kann jede Zeile fehlerfrei akzeptieren und dennoch eine irreführende Entscheidung unterstützen. Eine schlechte Datenqualität beeinträchtigt das Berichtswesen, die Analytik, die operativen Prozesse und die KI-Systeme, während die Kosten für die Bereinigung und Aufbereitung der Daten laut den von Integrate.io zusammengefassten Statistiken zur Branchendatenqualität bis zu 80 % der Zeit von Datenexperten in Anspruch nehmen können.
Das Qualitätsmanagement von Datenbanken bietet Teams die Möglichkeit, von der Notfalluntersuchung zur kontinuierlichen Kontrolle überzugehen. Der praktische Weg beginnt mit dem Unterschied zwischen valider Speicherung und vertrauenswürdiger Bedeutung und führt dann über Qualitätsdimensionen, Pipeline-Übergaben, Timeliness, Schemaänderungen, Geschäftsregeln, Eigentümerschaft und den unternehmensweiten Rollout.
Inhaltsverzeichnis
Einführung: Warum Datenbankqualität immer noch Entscheidungen beeinträchtigt
Was Datenbankqualitätsmanagement wirklich bedeutet
Strukturelle Korrektheit
Geschäftliche Korrektheit
Die wichtigsten Dimensionen, die vertrauenswürdige Daten definieren
Intrinsische Qualität
Kontextuelle Qualität
Repräsentative Qualität
Zugänglichkeitsqualität
Wie Qualität in Pipelines und Umgebungen scheitert
Die Entscheidung für ein Kontrollmuster
Überwachung von Timeliness, Schema und Geschäftsregeln in der Praxis
Beginnen Sie mit den Erwartungen an das Eintreffen
Schemas als Verträge behandeln
Bedeutung auf Datensatzebene validieren
Aufbau eines unternehmensweiten Programms für das Datenbankqualitätsmanagement
Datenbankqualitätsmanagement in die Tat umsetzen
Einführung: Warum Datenbankqualität immer noch Entscheidungen beeinträchtigt
Ein Analyst öffnet vor einer Überprüfung durch die Geschäftsführung ein Dashboard und sieht, dass der Umsatz weit unter den Erwartungen liegt. Die Untersuchung erstreckt sich über SQL, Pipeline-Logs, Transformationscode und Quellextrakte. Ein Datenbankadministrator kann zwar bestätigen, dass die Tabellen verfügbar sind, aber das Team kann immer noch nicht erklären, ob die Daten verspätet eintrafen, ihre Bedeutung während eines Release geändert haben oder aus einer veralteten Quelle stammen.
Eine Prüfung auf Feldebene kann verifizieren, dass jeder Wert ein gültiges Datum ist. Sie kann jedoch nicht bestätigen, dass diese Daten Kaufereignisse und nicht Erfassungszeiten darstellen. Eine Pipeline kann auch fehlerfrei abgeschlossen werden, während sie einen alten Extrakt lädt, einen geänderten Join anwendet oder zwei Quellstatus einem einzigen Warehouse-Wert zuordnet. Technischer Abschluss und geschäftliche Korrektheit sind unterschiedliche Ergebnisse.
Das Datenbankqualitätsmanagement kontrolliert daher den gesamten Weg von der Quelle bis zum Konsumenten. Es umfasst Prüfungen innerhalb von Datenbanken, Vergleiche zwischen Umgebungen und Beobachtungen über Pipeline-Läufe und Releases hinweg. In-Database-Observability schließt die Lücke, indem sie aufzeichnet, was sich geändert hat, wann es sich geändert hat und welche Regel oder Übergabe den Unterschied verursacht hat. Dadurch wird ein Qualitätsverlust sichtbar, bevor er einen Bericht oder eine operative Entscheidung erreicht.
Das geschäftliche Risiko ist groß. Eine schlechte Datenqualität kann Berichterstattung, Betrieb, Analysen und Entscheidungen beeinträchtigen, anstatt nur fehlerhafte Tabellen zu erzeugen. Ein Leitfaden für Geschäftsentscheidungen und Datenqualität erklärt, wie unzuverlässige Informationen Entscheidungen verzerren und den Nacharbeitsaufwand erhöhen können.
Praktische Regel: Wenn ein Team nicht feststellen kann, wo sich ein Wert geändert hat, wann er sich geändert hat und wer für die Korrektur verantwortlich ist, betreibt es eine periodische Überprüfung, kein Qualitätsmanagement.
Verwenden Sie drei Fragen, um die Arbeit zu strukturieren: Ist der Wert strukturell akzeptabel? Ist er für das Unternehmen von Bedeutung? Kann der Bewegung von der Quelle zum Konsumenten vertraut werden? Die Antworten verbinden Tabellenprüfungen mit Pipeline-Kontrollen, Release-Validierung, Eigentümerschaft und dem Nachweis, dass eine Entscheidung auf aktuellen, richtig interpretierten Daten beruht.
Was Datenbankqualitätsmanagement wirklich bedeutet
Ein Release kann erfolgreich abgeschlossen werden, während ein Bericht immer noch die falsche geschäftliche Bedeutung enthält. Beispielsweise kann ein Ingestion-Job einen gültigen Zeitstempel speichern, eine Transformation einen geänderten Join anwenden oder ein Mapping zwei Quellstatus in einen einzigen Warehouse-Wert zusammenführen. Das Datenbankqualitätsmanagement adressiert diese Lücke zwischen technischem Abschluss und Daten, die von Menschen sicher verwendet werden können.
Die Disziplin ist die fortlaufende Praxis, Daten für ihren beabsichtigten Verwendungszweck fit zu halten. Ein Finanzbericht, ein klinischer Arbeitsablauf, ein Kundenmodell und eine regulatorische Einreichung können sich auf dieselbe Datenbank stützen, doch jeder erwartet ein anderes Maß an Genauigkeit, Aktualität, Vollständigkeit und Interpretation. Die Qualitätskontrolle folgt daher den Daten über Pipelines und Releases hinweg und nicht nur durch Prüfungen einzelner Tabellen.
Strukturelle Korrektheit
Die syntaktische Korrektheit fragt, ob ein Wert der zulässigen Struktur der Datenbank entspricht. Eine customer_id muss existieren, ein Datum muss seinem Datentyp entsprechen, ein numerisches Feld muss eine Zahl enthalten, und eine Beziehung kann einen passenden übergeordneten Datensatz erfordern. Constraints, Nullability-Regeln, Typprüfungen und referenzielle Integritätskontrollen setzen diese Bedingungen durch.
Sie verhindern, dass eindeutig ungültige Werte in ein System gelangen oder darin weitergegeben werden. Sie stellen jedoch nicht fest, ob ein gültig gespeicherter Wert die Realität beschreibt.
Geschäftliche Korrektheit
Die semantische Korrektheit fragt, ob ein gespeicherter Wert das bedeutet, was das Unternehmen darunter versteht. Ein Auftrag kann einen gültigen Zeitstempel enthalten, der die Erfassungszeit und nicht die Kaufzeit aufzeichnet. Ein Kunde kann einen zulässigen Status haben, der im Widerspruch zu seinem tatsächlichen Lebenszyklusstatus steht. Eine Transaktion kann eine numerische Prüfung bestehen, obwohl sie dem falschen Konto zugeordnet ist.
Diese Unterscheidung ist zentral in der Fachliteratur zum Datenqualitätsmanagement, die Qualität als mehr als nur Formatierung behandelt und zwischen syntaktischer und semantischer Korrektheit unterscheidet.
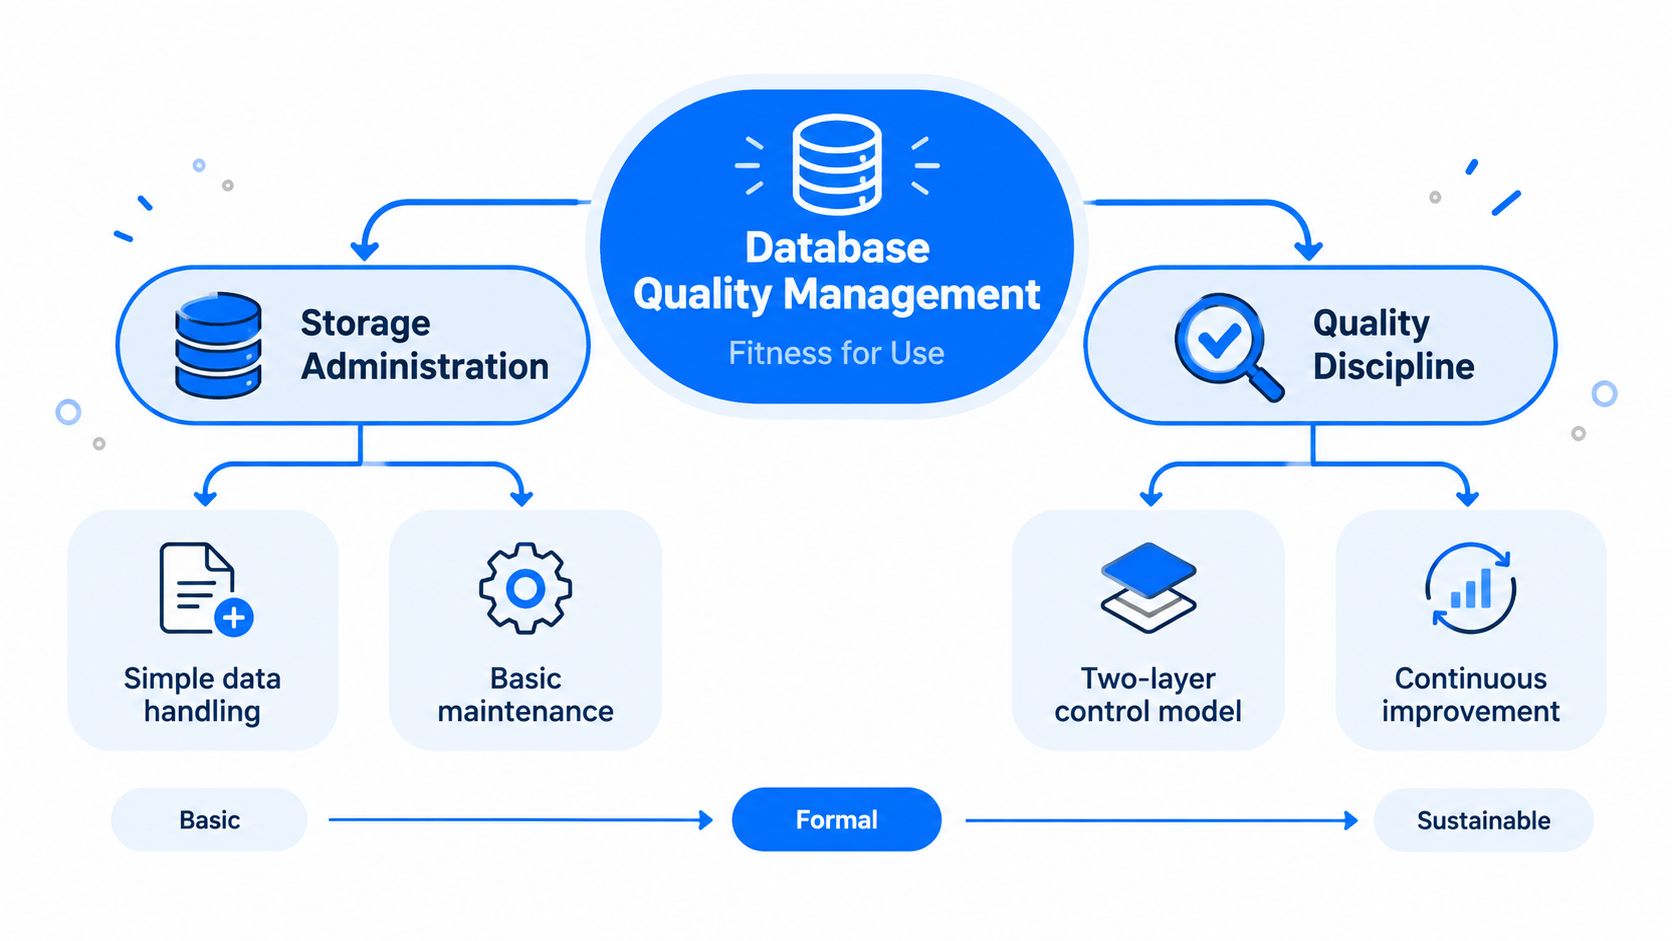
Eine Bibliothek verdeutlicht den Unterschied. Die Bestandsverwaltung kümmert sich um Regale, Katalognummern und Ausleihdaten. Die Qualitätsdisziplin prüft darüber hinaus, ob der Katalog jedes Buch korrekt beschreibt, die aktuelle Auflage identifiziert, doppelte Einträge vermeidet und autorisierten Lesern das Finden der benötigten Materialien ermöglicht.
Es folgt ein praktischer Regelkreis:
Eingehende Daten einschränken durch Typen, Schlüssel, Pflichtfelder und Beziehungsprüfungen.
Geschäftliche Bedeutung validieren durch Regeln für Bereiche, Status, Sequenzen, Referenzdaten und Beziehungen.
Ausnahmen aufzeichnen anstatt Fehler zu verwerfen.
Verantwortlichkeiten zuweisen, damit ein Team die Quelle, Transformation oder das Release zurückverfolgen kann, das ein Problem verursacht hat.
Wiederkehrendes Verhalten messen, um einen einzelnen fehlerhaften Datensatz von einer sich verschlechternden Pipeline zu unterscheiden.
Das Qualitätsmanagement umfasst somit Erfassung, Transformation, Speicherung, Bereitstellung und Konsum. In-Database-Observability verbindet diese Phasen, indem sie Änderungen, Zeitabläufe, Regelfehler und Übergaben in verschiedenen Umgebungen aufzeichnet. Teams können diese Erklärung der Datenqualität nutzen, um technische Kontrollen mit der geschäftlichen Eignung zu verbinden.
Die wichtigsten Dimensionen, die vertrauenswürdige Daten definieren
Eine Entscheidung kann selbst dann fehlschlagen, wenn eine Tabelle eine grundlegende Prüfung besteht. Datensätze können zwar vorhanden, aber veraltet sein, ein Feld kann korrekt sein, während ein anderes System widerspricht, oder eine gültige Struktur kann doppelte Entitäten enthalten. Vertrauenswürdige Daten erfordern daher mehrere Sichtweisen auf die Qualität, die über Pipelines, Releases und Umgebungen hinweg angewendet werden und nicht nur auf die endgültige Tabelle.
Die sechs Kerndimensionen bieten einen praktischen Ausgangspunkt:
Genauigkeit: Spiegelt die Daten das reale Objekt oder Ereignis korrekt wider?
Vollständigkeit: Sind die erforderlichen Datensätze und Felder vorhanden?
Konsistenz: Stimmen verwandte Systeme und Datensätze überein?
Timeliness: Sind die Daten verfügbar und aktuell, wenn die Benutzer sie benötigen?
Gültigkeit: Folgen sie den definierten Typen, Formaten, Bereichen und Regeln?
Eindeutigkeit: Gibt es keine unerwünschten doppelten Datensätze?
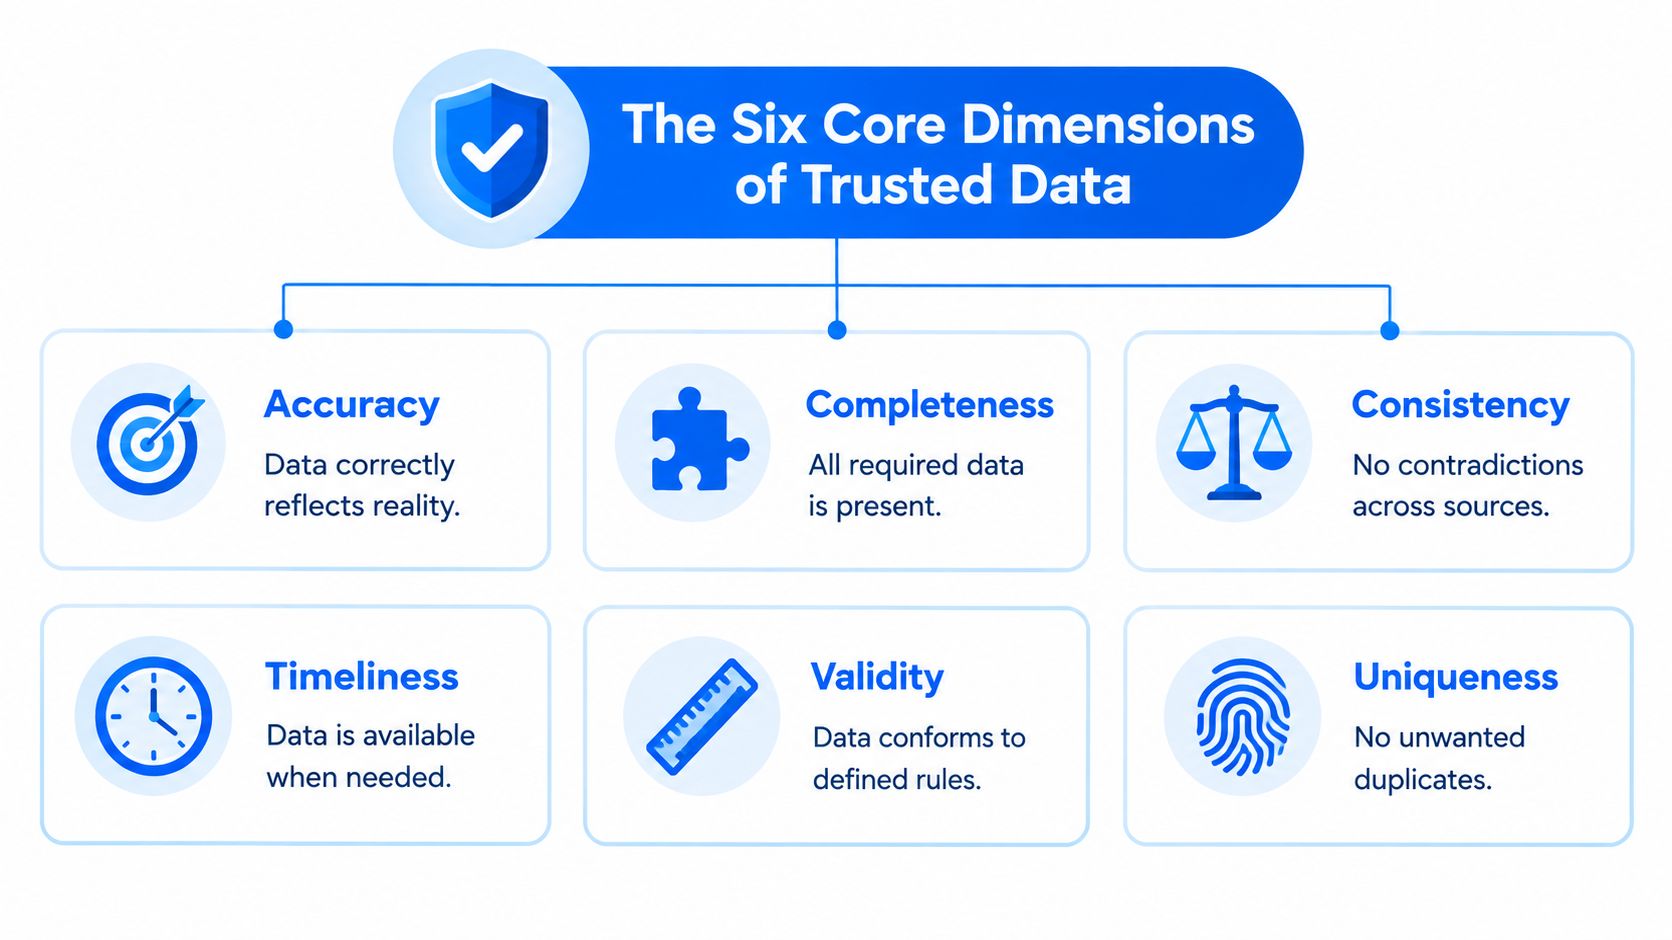
Diese Dimensionen lassen sich auch in vier operationelle Familien einteilen, die in der Literatur zum Total Data Quality Management diskutiert werden.
Intrinsische Qualität
Die intrinsische Qualität beschreibt Eigenschaften innerhalb der Daten selbst, insbesondere Genauigkeit und Glaubwürdigkeit. Ein Wert kann vorhanden und korrekt typisiert sein, aber dennoch unbrauchbar sein, wenn er nicht den zugrunde liegenden Kunden, das Konto, das Ereignis oder die Messung darstellt.
Contextual Qualität
Die kontextuelle Qualität fragt, ob die Daten für eine bestimmte Verwendung relevant, vollständig, aktuell und in angemessener Menge vorhanden sind. Daten, die für einen monatlichen Trend geeignet sind, können für eine operative Entscheidung in Echtzeit ungeeignet sein. Die Eignung hängt von der Entscheidung und ihrem Zeitpunkt ab, nicht nur von der Tabelle.
Repräsentative Qualität
Die repräsentative Qualität umfasst die Interpretierbarkeit und Konsistenz der Darstellung. Eindeutige Definitionen, stabile Namen, kompatible Formate und dokumentierte Transformationen helfen den Konsumenten, ein Feld zu verstehen und es sicher über verschiedene Datensätze hinweg zu vergleichen. Ein Release, das eine Bedeutung ändert, ohne einen Typ zu ändern, kann dennoch die Qualität verringern.
Zugänglichkeitsqualität
Die Zugänglichkeitsqualität betrifft die Frage, ob autorisierte Benutzer auf die Daten zugreifen und sie verwenden können, während die Zugriffssicherheit intakt bleibt. Genaue Daten, die ein freigegebener Workflow nicht abrufen kann, erfüllen ihren Zweck nicht.
Das operative Monitoring verwandelt diese Kategorien in Signale, die Teams in verschiedenen Umgebungen beobachten können. Freshness deckt Probleme mit der Timeliness auf. Schema-Tracking zeigt strukturelle Änderungen zwischen Releases auf. Volumen und Verteilung heben ungewöhnliche Verschiebungen bei der Anzahl der Datensätze oder der Wertemuster hervor. Lineage verbindet einen Fehler mit einer Upstream-Quelle, einer Transformation oder einem Deployment. dignas Übersicht über Datenqualitätsdimensionen verknüpft diese Erwartungen mit praktischen Monitoring-Signalen.
Getrennte Kontrollen beschleunigen die Diagnose. Ein Freshness-Alarm deutet auf ein Planungs- oder Bereitstellungsproblem hin. Eine Verteilungsanomalie deutet auf ein geändertes Quellverhalten oder eine geänderte Transformationslogik hin. Ein Schema-Alarm kann auf einen Release- oder Vertragsbruch hinweisen. Ein Zugriffsfehler lenkt die Aufmerksamkeit auf Berechtigungen oder die Plattformkonfiguration. Ein einzelner Score kann den Status zusammenfassen, während separate Signale zeigen, wo sich die Qualität verschlechtert hat und welches Team die Untersuchung durchführen sollte.
Wie Qualität in Pipelines und Umgebungen scheitert
Ein Bericht kann jede Prüfung in seiner endgültigen Tabelle bestehen und dennoch die falschen Werte enthalten. Der Quellextrakt kann sich vor der Erfassung ändern, eine Transformation kann die Bedeutung zwischen Umgebungen verändern oder ein Release kann eine Spalte hinzufügen, die einen Downstream-Konsumenten beschädigt, ohne die Einschränkungen der Zieltabelle zu verletzen. Die Qualität verschlechtert sich daher an den Übergabestellen, nicht erst bei der Speicherung.
Eine globale Umfrage aus dem Jahr 2026 ergab, dass 47 % der Befragten Datenqualitätsprobleme direkt mit der Transformation in Verbindung brachten, während 77 % der Unternehmen keine formelle Database-governance und -qualitätsprozesse hatten und 39 % sich auf manuelle Test- und Bereitstellungsmethoden verließen, so der Redgate-Bericht „State of the Database“ von 2026. Diese Ergebnisse weisen auf die Übergabestellen als zentrales Kontrollproblem hin. Teams benötigen Transparenz über Entwicklung, Test, Produktion, Warehouses, Lakes und Pipelines hinweg, anstatt sich auf Prüfungen innerhalb einer einzigen Zieltabelle zu verlassen.
Die Entscheidung für ein Kontrollmuster
Kontrollmuster | Am besten geeignet für | Kompromiss |
|---|---|---|
Manuelle Regeln | Bekannte, hochwertige Prüfungen im Besitz eines Spezialisten | Schwer skalierbar, bei Releases leicht zu übersehen und von menschlicher Nachverfolgung abhängig |
Deterministische Validierung | Stabile Verträge, Pflichtfelder, Bereiche, Beziehungen und Compliance-Bedingungen | Klar und reproduzierbar, erkennt aber nicht jede unerwartete Verhaltensänderung |
Automatisierte Observability | Freshness, Volumen, Verteilung, Schema-Drift und Muster, die schwer aufzuzählen sind | Eine breite Abdeckung erfordert ein Baseline-Management und einen Workflow zur Untersuchung von Alarmen |
Manuelle Prüfungen sind weiterhin für regulatorische Regeln oder finanzielle Abstimmungen geeignet, die eine explizite, überprüfbare Bedingung erfordern. Die deterministische Validierung eignet sich für Fälle, in denen das erwartete Ergebnis eindeutig ist. Die automatisierte Observability deckt Änderungen ab, die Teams vernünftigerweise nicht mit einer einzigen Regel für jedes mögliche Verhalten beschreiben können.
Sichern Sie jeden Übergang nacheinander ab. Prüfen Sie das Eintreffen der Quelle, validieren Sie den Transformations-Output, vergleichen Sie Schemata über Umgebungen hinweg und überwachen Sie den endgültigen Datensatz, der von Berichten oder Modellen verwendet wird. Die Ausführung in der Datenbank kann unnötige Bewegungen reduzieren, indem Metriken dort berechnet werden, wo sich die Daten bereits befinden. Lineage- und Release-Metadaten verknüpfen dann einen Vorfall mit der Änderung, die ihm vorausgegangen ist.
Eine Pipeline ist nur so vertrauenswürdig wie ihr am wenigsten beobachteter Übergang. Der Leitfaden zur Qualität von ETL-Datenpipelines stellt Prüfungen rund um Bewegung und Transformation in den Mittelpunkt, während In-Database-Observability die Lücke zwischen dem, was eine Pipeline produziert hat, und dem, was jede Umgebung enthält, schließt.
Überwachung von Timeliness, Schema und Geschäftsregeln in der Praxis
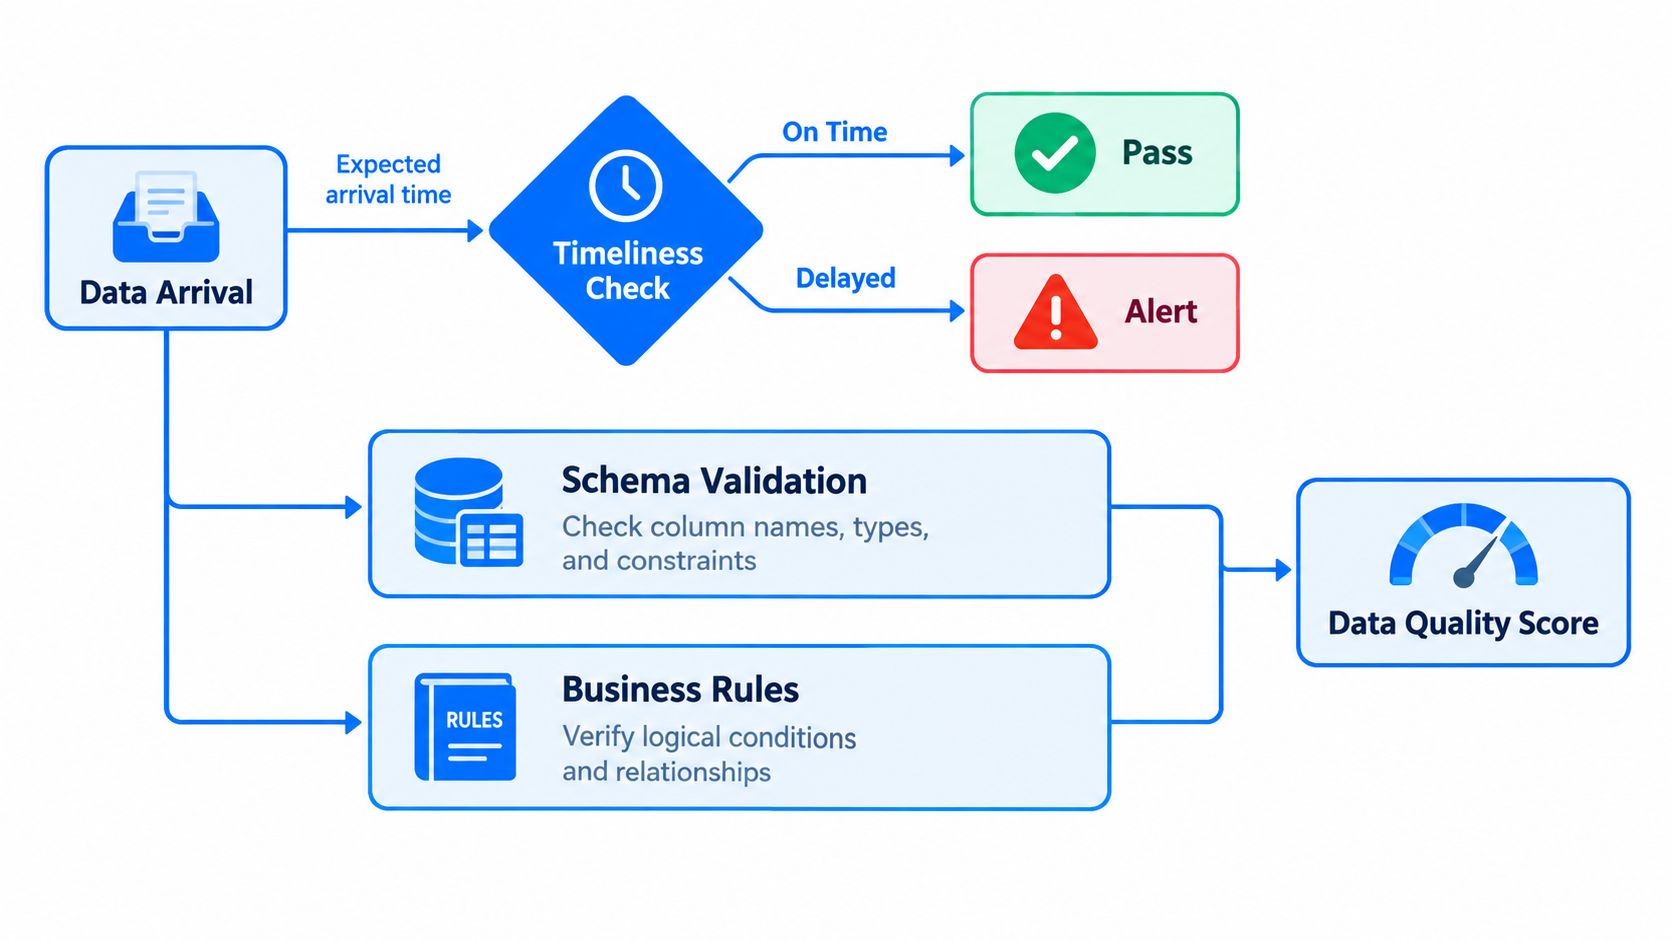
Ein Deployment kann Tabellenprüfungen bestehen und dennoch in der Praxis scheitern. Die Quelle kann verspätet eintreffen, ein Release kann einen Feldtyp ändern oder eine Transformation kann Datensätze erzeugen, die gegen die Domänenlogik verstoßen. Das operative Monitoring wird handhabbar, wenn jedes Signal eine klare Frage und Antwort hat. Die Timeliness fragt, ob die Daten zum erwarteten Zeitpunkt eingetroffen sind. Das Schema-Monitoring fragt, ob sich die Struktur geändert hat. Die Validierung von Geschäftsregeln fragt, ob die Datensätze noch ihren beabsichtigten Verwendungszweck unterstützen.
Beginnen Sie mit den Erwartungen an das Eintreffen
Das Monitoring der Timeliness vergleicht die tatsächliche Eintreffens- oder Aktualisierungszeit mit einem erwarteten Zeitplan oder SLA-Fenster. Die Timeliness auf Datensatzebene misst, ob ein einzelnes Ereignis innerhalb eines akzeptablen Zeitraums eingetroffen ist. Die Aktualität des Datensatzes misst, wie kürzlich eine Tabelle oder Partition aktualisiert wurde.
Ein Team könnte ein Bereitstellungsfenster für eine tägliche Quelle definieren und einen Alarm auslösen, wenn die letzte Aktualisierung der Tabelle den zulässigen Schwellenwert überschreitet. Dieser Schwellenwert hängt von der Domäne und dem Anwendungsfall ab. Ein Risikoprozess, ein kundenorientierter Workflow und ein explorativer Bericht haben unterschiedliche Toleranzen. Informationen zur schwellenwertbasierten Alarmierung finden Sie in diesem Leitfaden für Metriken und Monitoring der Daten-Timeliness. In-Database-Observability kann diese Prüfungen direkt bei den Daten berechnen, sodass verspätete Zugänge über Entwicklung, Staging und Produktion hinweg sichtbar werden und nicht nur an der Pipeline-Grenze.
Schemas als Verträge behandeln
Schemaprüfungen vergleichen die beobachtete Struktur mit dem erwarteten Vertrag. Überwachen Sie neue Spalten, entfernte Spalten, umbenannte Felder, geänderte Datentypen, Änderungen der Nullability und Änderungen von Constraints. Eine neue Spalte kann harmlos sein, während ein entfernter Identifikator oder eine Konvertierung von Zahl in Text Joins, Berechnungen oder Downstream-Modelle beschädigen kann.
Führen Sie Schemaprüfungen durch, bevor ein Release die Produktion erreicht, und setzen Sie das Monitoring nach dem Deployment fort. Der Vergleich desselben Vertrags über verschiedene Umgebungen hinweg hilft dabei, eine genehmigte Migration von einem Drift zu unterscheiden, der durch ein Quellsystem oder ein unvollständiges Release verursacht wurde.
Bedeutung auf Datensatzebene validieren
Geschäftsregeln drücken Bedingungen aus, die eine gültige Zeile erfüllen muss. Beispiele hierfür sind ein Enddatum, das nicht vor einem Startdatum liegt, eine Zahlung, die mit einem bestehenden Konto verknüpft ist, eine positive Menge für einen abgeschlossenen Verkauf oder ein vom Domänenmodell zugelassener Statusübergang.
Halten Sie fehlgeschlagene Datensätze für Untersuchungen bereit. Ein nützlicher Ausnahmedatensatz enthält den Datensatz, die Regel, den Wert, die Erfassungs- oder Aktualisierungszeit, die Umgebung, die Pipeline-Version und den Eigentümer. Dieser Kontext hilft Ingenieuren, schlechte Quelldaten von einer fehlerhaften Transformation zu unterscheiden und den Fehler mit dem Release oder der Umgebung zu verknüpfen, in der er aufgetreten ist.
Operativer Rat: Lösen Sie einen Alarm für eine Bedingung nur dann aus, wenn das empfangende Team weiß, welche Entscheidung es als Nächstes treffen soll. Andernfalls erzeugt das Monitoring nur Rauschen statt Kontrolle.
Eine kombinierte Qualitätsansicht kann den Status der Timeliness, den Schema-Status, die Ergebnisse der Geschäftsregeln und die betroffenen nachgelagerten Assets anzeigen. Der Score fasst dann die Erkenntnisse aus jeder Umgebung und jedem Übergang zusammen, anstatt eine unerklärliche Note zu präsentieren.
Aufbau eines unternehmensweiten Programms für das Datenbankqualitätsmanagement
Ein Unternehmensprogramm verbindet Mensch, Prozess und Plattform über Pipelines, Umgebungen und Releases hinweg. Jeder Teil beantwortet eine andere Frage: Wer ist Eigentümer der Daten, wie sollten die Teams reagieren und wo werden die Kontrollen ausgeführt? Dieses Modell behandelt Qualität als ein Kontrollproblem über Übergaben hinweg, nicht nur als eine Reihe von Tabellenprüfungen.
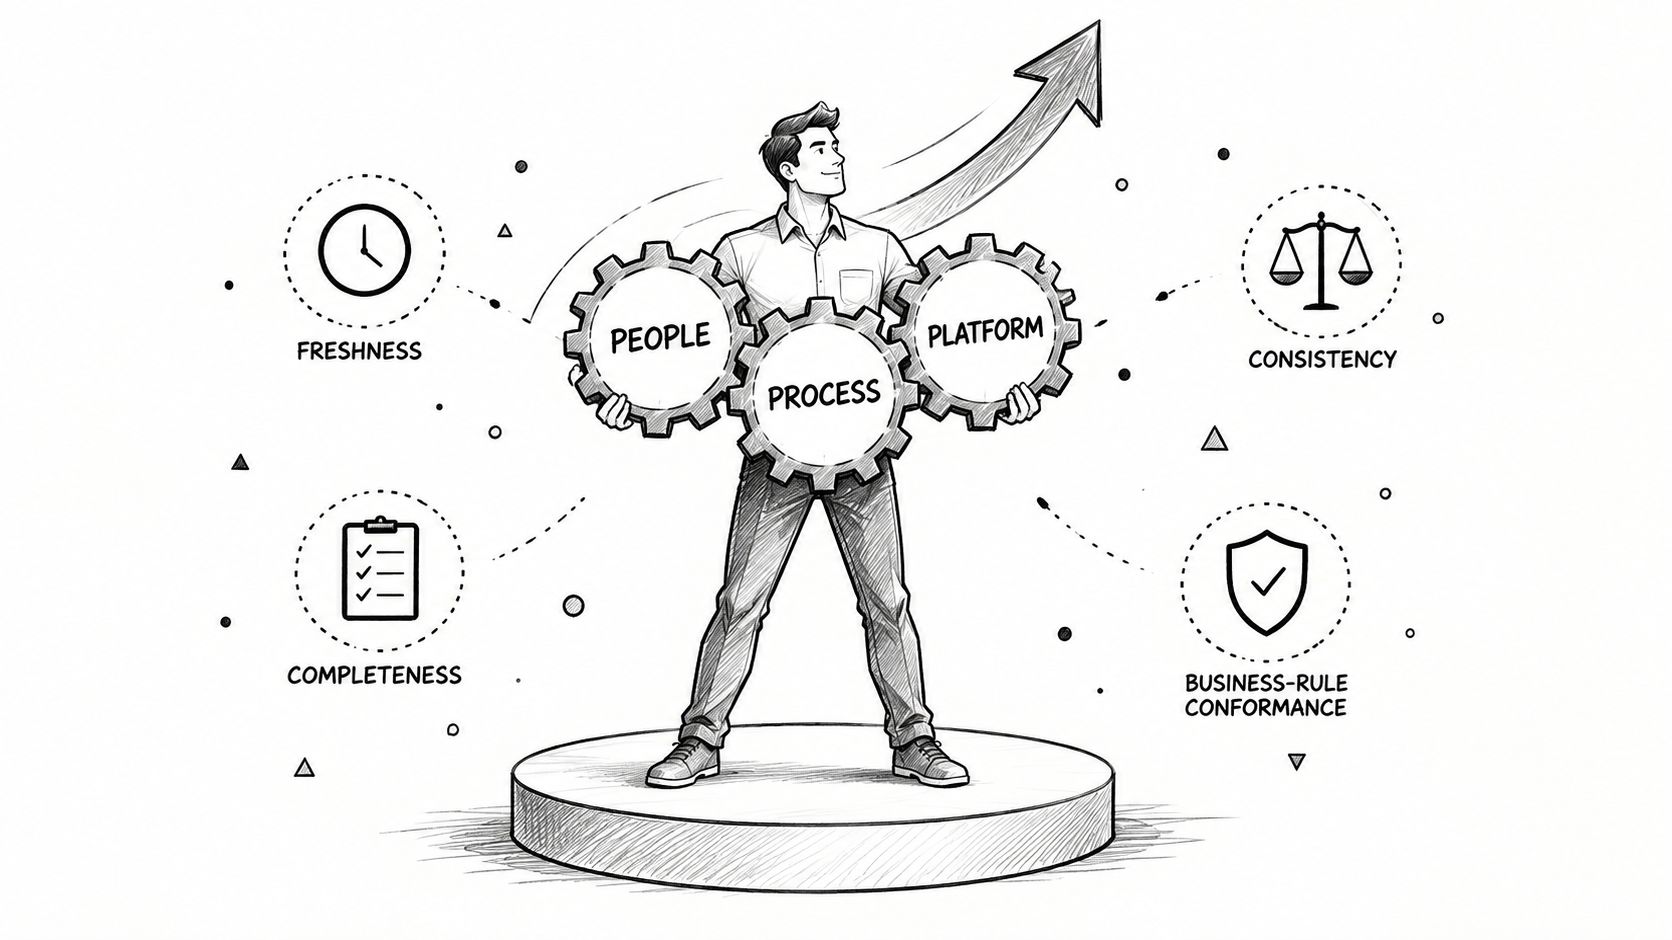
Beginnen Sie mit Maßnahmen, die an die geschäftliche Nutzung gekoppelt sind. Verfolgen Sie die Freshness für die Zuverlässigkeit der Bereitstellung, die Vollständigkeit für Pflichtfelder, die Konsistenz über autorisierte Quellen hinweg und die Einhaltung von Geschäftsregeln für kritische Datensätze. Führen Sie nach Möglichkeit dieselben Kontrollen in der Entwicklung, beim Testen und in der Produktion durch. Der Vergleich der Ergebnisse über verschiedene Umgebungen hinweg kann zeigen, ob ein Release das Verhalten geändert hat, bevor das Problem die Konsumenten erreicht. Fügen Sie Dimensionen nur hinzu, wenn sie eine Entscheidung, einen Eskalationspfad oder eine Governance-Verpflichtung unterstützen.
Die Eigentümerschaft sollte explizit sein. Data Engineering ist in der Regel für das Pipeline-Verhalten und die technische Behebung zuständig. Analytics Engineering und BI-Teams besitzen vertrauenswürdige Transformationen und die Konsumlogik. Domain Stewards definieren die Bedeutung und akzeptable Ausnahmen. Governance-Teams legen Standards, Nachweisanforderungen und Eskalationsrichtlinien fest. Ein gemeinsames Dashboard ermöglicht es diesen Gruppen, denselben Vorfall zu untersuchen, während ihre technischen Arbeitsabläufe getrennt bleiben.
Der Business Case sollte die Investition mit Ergebnissen verknüpfen, die für Führungskräfte erkennbar sind:
Reduzierung von Vorfällen: Erkennen Sie fehlende Ladungen, Schema-Drift und abnormale Verteilungen, bevor Konsumenten sie melden.
Governance-Bereitschaft: Bewahren Sie Nachweise über Prüfungen, Fehler, Eigentümerschaft und Behebungen auf.
Plattformeffizienz: Reduzieren Sie wiederholte manuelle Untersuchungen und konzentrieren Sie die Entwicklungszeit auf die Ursachen.
KI-Zuverlässigkeit: Versorgen Sie Modelle und Retrieval-Systeme mit Daten von beobachtbarer Freshness, Struktur und Bedeutung.
Eine Unternehmensstudie aus dem Jahr 2025 ergab, dass 84 % der Unternehmen mit ungenauen oder doppelten Daten zu kämpfen haben. Sie identifizierte außerdem Budgetdruck mit 27 %, Mangel an internen Ressourcen mit 24 % und komplexe Systemumgebungen mit 19 % als wesentliche Barrieren, so die Melissa-Studie zur Datenqualität in Unternehmen. Diese Einschränkungen sprechen für einen modularen Rollout anstelle einer großen, unternehmensweiten Ablösung.
Das Design kann je nach Branche angepasst werden. Im Finanzwesen können Abstimmung, Risikodaten und Audit Trails im Vordergrund stehen. Im Gesundheitswesen können klinische Vollständigkeit, Gültigkeit und Zugriffskontrollen im Vordergrund stehen. Telekommunikationsteams benötigen möglicherweise ein hochvolumiges Anomalie- und Bereitstellungsmonitoring. Programme im öffentlichen Sektor können Rückverfolgbarkeit, Konsistenz und Nachweisbarkeit priorisieren. Das Kontrollmuster bleibt modular, während sich die Regeln ändern.
In-Database-Observability schließt die Lücke zwischen einer erfolgreichen Pipeline-Prüfung und den Daten, die Konsumenten abfragen. Sie kann Testergebnisse, Release-Versionen, Umgebungsänderungen und Downstream-Auswirkungen miteinander verknüpfen und den Verantwortlichen für Vorfälle Beweise für die nächste Aktion liefern, anstatt nur einen weiteren isolierten Alarm zu senden.
Dieses Video bietet zusätzlichen Kontext für die Verknüpfung von Datenqualitätsoperationen mit der allgemeinen Plattformzuverlässigkeit:
Datenbankqualitätsmanagement in die Tat umsetzen
Ein praktischer Rollout beginnt mit dem Datensatz, der das größte geschäftliche Risiko oder den größten operativen Nacharbeitsaufwand verursacht. Dokumentieren Sie den beabsichtigten Verwendungszweck, den Eigentümer, die Erwartung an die Bereitstellung, die Schlüsselfelder, die Geschäftsregeln, die Downstream-Konsumenten und die akzeptablen Ausnahmen. Erstellen Sie eine Baseline, bevor Sie weitere Kontrollen hinzufügen, damit spätere Verbesserungen mit einem Ausgangswert verglichen werden können.
Verwenden Sie diese Entscheidungs-Checkliste:
Den Fehlerpfad zurückverfolgen: Verfolgen Sie Daten von der Quelle über die Transformation, die Umgebung, das Release, das Ziel und den Konsumenten.
Korrektheitsebenen trennen: Kombinieren Sie strukturelle Einschränkungen mit semantischer Validierung.
Signale nach Risiko auswählen: Überwachen Sie Freshness, Schema, Volumen, Verteilung, Lineage und Geschäftsregeln entsprechend den wahrscheinlichen Fehlermodi.
Vorfälle handhabbar machen: Erfassen Sie Eigentümerschaft, Schweregrad, Beweise und die nächste Reaktion.
Nach Risiko erweitern: Wenden Sie Kontrollen auf den nächsten kritischen Datensatz an, nachdem der erste Workflow nützliches operatives Feedback geliefert hat.
Die Qualität kann sich ändern, wenn sich das Quellverhalten, Code-Releases, Zeitpläne oder Geschäftsdefinitionen ändern. Unabhängige Untersuchungen berichteten in ihrem Update für 2026 von durchschnittlich einem Datenqualitätsproblem pro zehn Tabellen und Jahr, verglichen mit etwa einem Problem pro fünfzehn Tabellen bei früheren Messungen, wie aus den Datenqualitätsstatistiken von Monte Carlo hervorgeht. Eine kontinuierliche Beobachtung ist daher zuverlässiger als eine gelegentliche Bereinigung.
Wählen Sie eine modulare Plattform, die Prüfungen innerhalb der Kundenumgebung ausführt. Teams können mit einer einzelnen Funktion beginnen und diese auf Warehouses, Lakes und Pipelines ausweiten. In-Database-Prüfungen belassen die Daten an ihrem Ort, während Validierung, Timeliness, Anomalieerkennung und Schema-Tracking verschiedene Punkte im Qualitätslebenszyklus abdecken. Das Monitoring sollte auch Pipeline-Ergebnisse mit Release-Versionen, Umgebungsänderungen und den von Konsumenten abgefragten Daten verknüpfen. Diese Verbindung hilft den Verantwortlichen für Vorfälle, einen fehlgeschlagenen Test von einem Defekt zu unterscheiden, der erst später bei der Bereitstellung eingeführt wurde.
digna bietet In-Database-Datenqualitäts- und Observability-Funktionen zur Überwachung des Datenverhaltens, zur Validierung von Datensätzen, zur Verfolgung der Timeliness, zur Erkennung von Schemaänderungen und zur Unterstützung zuverlässiger Analysen und KI über Warehouses, Lakes und Pipelines hinweg. Besuchen Sie digna, um einen modularen Ansatz für Ihre Umgebungen, Ihr Eigentumsmodell und Ihre Qualitätsprioritäten zu evaluieren.


