Data Trust Analytics für moderne Datenteams erklärt
|
8
min. Lesezeit

Eine Umfrage zu Planungs-Insights aus dem Jahr 2024 ergab, dass 67 % der Unternehmen den für die Entscheidungsfindung verwendeten Daten nicht vollständig vertrauten, im Vergleich zu 55 % im Vorjahr – ein Rückgang des Vertrauens um 12 Prozentpunkte in einem einzigen jährlichen Zyklus. Die Analyse der Umfrage durch Precisely bringt das Problem auf den Punkt: Von Analytics-Teams wird erwartet, dass sie schneller agieren, während ihre Datenbasis weiterhin schwer zu überprüfen ist.
Diese Lücke ist das praktische Terrain der Data Trust Analytics. Sie verbindet Datenqualität, Observability, Anomalieerkennung, Lineage und Geschäftskontext, sodass Teams eine nützlichere Frage beantworten können als „Wurde die Pipeline ausgeführt?“. Sie können fragen: „Ist dieser Datensatz zuverlässig genug, um genau jetzt eine Entscheidung oder ein KI-Ergebnis zu stützen?“
Inhaltsverzeichnis
Warum Datenvertrauen der neue Engpass für Analytics und KI ist
Warum Code-Vertrauen nicht gleich Datenvertrauen ist
Was Data Trust Analytics tatsächlich bedeutet
Vertrauen ist ein zusammengesetztes Signal
Die fünf Säulen, die Vertrauenssignale erzeugen
Aktualität zeigt, ob die Daten auf dem neuesten Stand sind
Qualität prüft Werte und Geschäftsregeln
Volumen erfasst stille Vollständigkeitsfehler
Schema schützt die strukturelle Kompatibilität
Lineage identifiziert, wer und was betroffen ist
Wie Erkennungsebenen Statistik, ML und menschliche Überprüfung kombinieren
Wo maschinelles Lernen Mehrwert bietet
Warum Menschen Teil des Systems bleiben
Metriken, die Vertrauen in etwas Messbares verwandeln
Metriken gemeinsam lesen
Entscheidungskontext hinzufügen
Von Observability zur Entscheidungsreife für KI
Scorecards um Ergebnisse herum aufbauen
Vertrauen innerhalb von Unternehmensbeschränkungen operativ umsetzen
Die Control-Plane proportional halten
Zuständigkeiten zuweisen, bevor Warnmeldungen hinzugefügt werden
Ein tragfähiges Betriebsmodell für Datenvertrauen aufbauen
Vorfälle in institutionelles Wissen umwandeln
Vertrauen als funktionsübergreifende Praxis überprüfen
Warum Datenvertrauen der neue Engpass für Analytics und KI ist
Ein Finanzverantwortlicher öffnet vor einer Vorstandssitzung ein Umsatz-Dashboard. Das Diagramm zeigt einen starken Rückgang der regionalen Umsätze, woraufhin das Team einen Einstellungsplan verschiebt und seine Prognose korrigiert. Später stellt ein Ingenieur fest, dass eine vorgelagerte Änderung dazu führte, dass ein Teil der Kundendaten verspätet eintraf. Das Dashboard zeigte keine böswillige Fälschung an. Es zeigte Daten an, die unvollständig geworden waren, ohne dass der Fehler offensichtlich war.
Dieses Szenario ist häufig, da Dashboards, Modelle für maschinelles Lernen und KI-Copiloten die Bedingungen ihrer Quelldaten erben. Fehlende Zeilen können eine Metrik verringern. Eine veraltete Partition kann einen Trend aktuell aussehen lassen, obwohl er es nicht ist. Ein fehlerhafter Join kann Kunden aus einem Segment entfernen. Eine umbenannte Spalte kann eine Transformation verändern. Ohne brauchbare Lineage kann niemand schnell feststellen, welche Berichte, Features oder Entscheidungen betroffen sind.
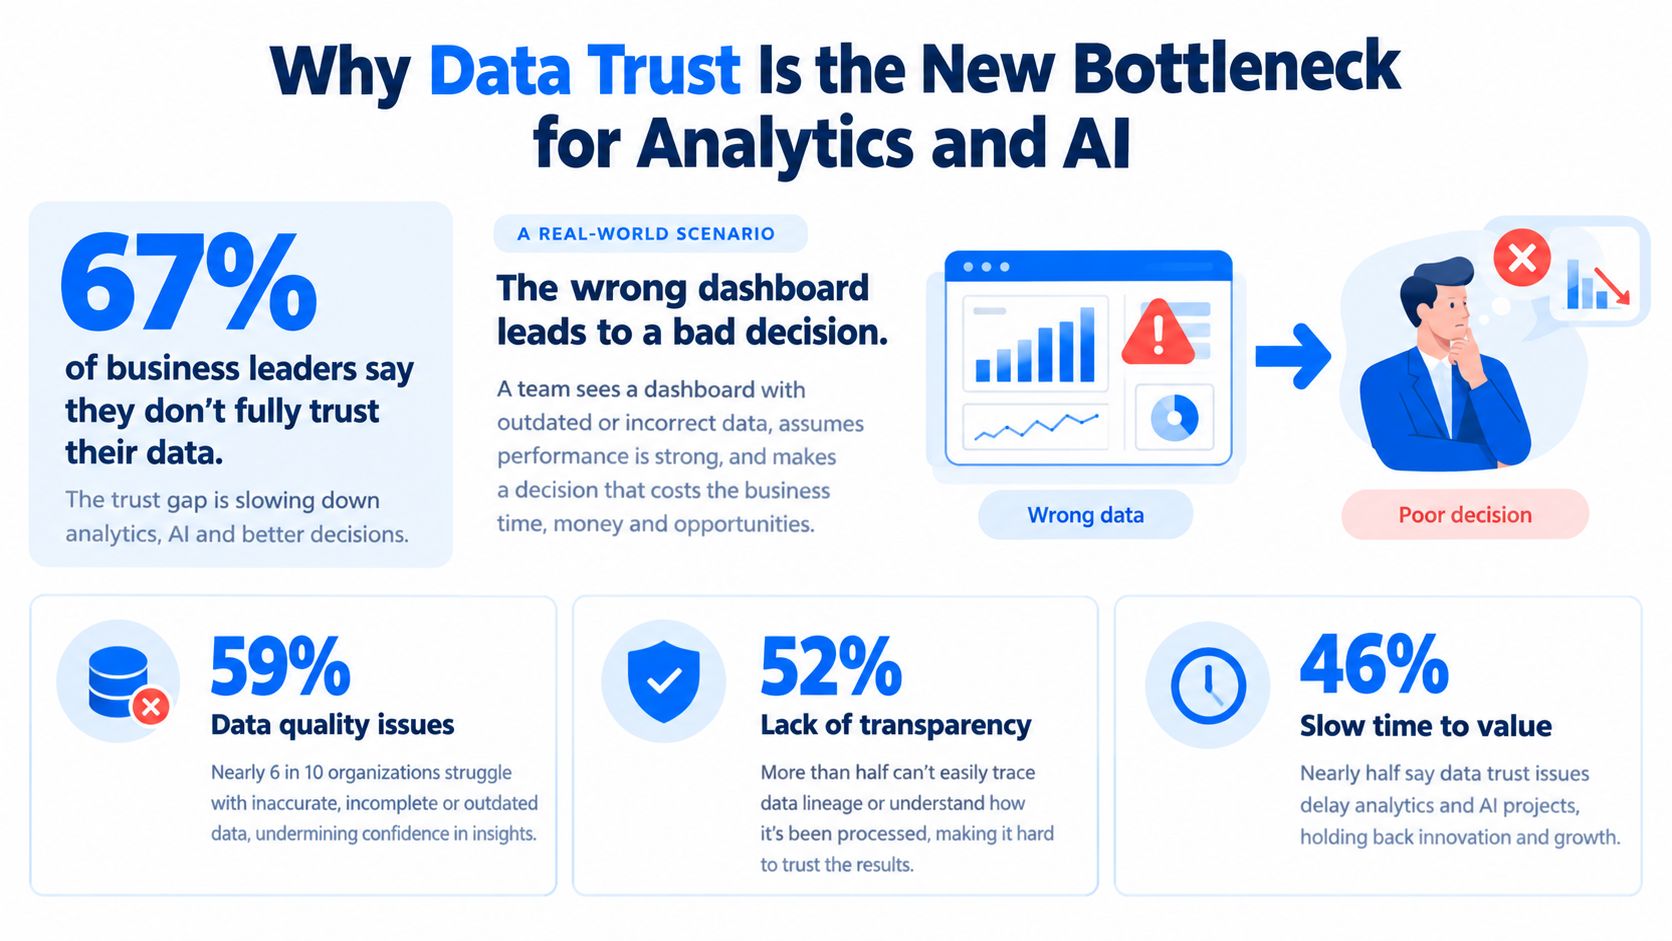
Die Kosten für das Unternehmen gehen über ein einzelnes falsches Diagramm hinaus. In einem entsprechenden Branchenbericht gaben 77 % der IT-Entscheidungsträger an, dass sie den Daten ihres Unternehmens für genaue, zeitnahe und geschäftskritische Entscheidungen nicht vollständig vertrauen, während 82 % sagten, dass Mitarbeiter abgeschlossene Analytics-Projekte aufgrund schlechter Datenqualität überarbeiten mussten. Derselbe Bericht von Precisely bringt geringes Vertrauen mit operativen Hürden in Verbindung, wobei eine mangelnde Datenqualität für 70 % der Befragten in Unternehmen mit geringem Vertrauen in Entscheidungsdaten das größte Hindernis darstellt.
Warum Code-Vertrauen nicht gleich Datenvertrauen ist
Ein Modell kann seine Bereitstellungstests erfolgreich bestehen und dennoch unzuverlässige Empfehlungen liefern, wenn seine Feature-Tabellen abgewichen sind (Drift). Eine SQL-Abfrage kann erfolgreich kompiliert werden, während sie weniger Zeilen zurückgibt, weil ein vorgelagerter Prozess das Laden einer Quelle gestoppt hat. Die Korrektheit der Software sagt Ihnen, dass der Code wie geplant ausgeführt wurde. Sie beweist nicht, dass die Eingaben vollständig, zeitnah, stabil oder für die Entscheidung geeignet waren.
Data Trust Analytics liefert diesen fehlenden Nachweis. Sie behandelt operative Signale als Teil der analytischen Gültigkeit und verknüpft Fehler mit den betroffenen Assets und verantwortlichen Eigentümern. Teams, die die Auswirkungen schlechter Datenqualität auf Geschäftsentscheidungen untersuchen, können diese Unterscheidung nutzen, um von der Korrektur sichtbarer Dashboard-Fehler zur Vermeidung unzuverlässiger Ergebnisse für Entscheidungsträger überzugehen.
Was Data Trust Analytics tatsächlich bedeutet
Beginnen wir mit der engen Definition. Die Datenqualität prüft, ob Werte und Datensätze bekannte Bedingungen erfüllen, z. B. ob ein Pflichtfeld ausgefüllt ist, ein Datum in einem zulässigen Bereich liegt oder eine Kundenkennung eindeutig ist. Diese Prüfungen sind notwendig, decken aber nur das ab, woran das Team gedacht hat.
Data Trust Analytics erweitert die Fragestellung. Sie kombiniert Qualitätsnachweise mit Freshness, Volume, Schemastabilität, Lineage, Eigentümerschaft und dokumentierter Bedeutung. Der Datenkonsument muss nicht nur wissen, ob ein Wert gültig erscheint, sondern auch, ob der Datensatz aktuell, verstanden, rückverfolgbar und für einen bestimmten Zweck sicher verwendbar ist.
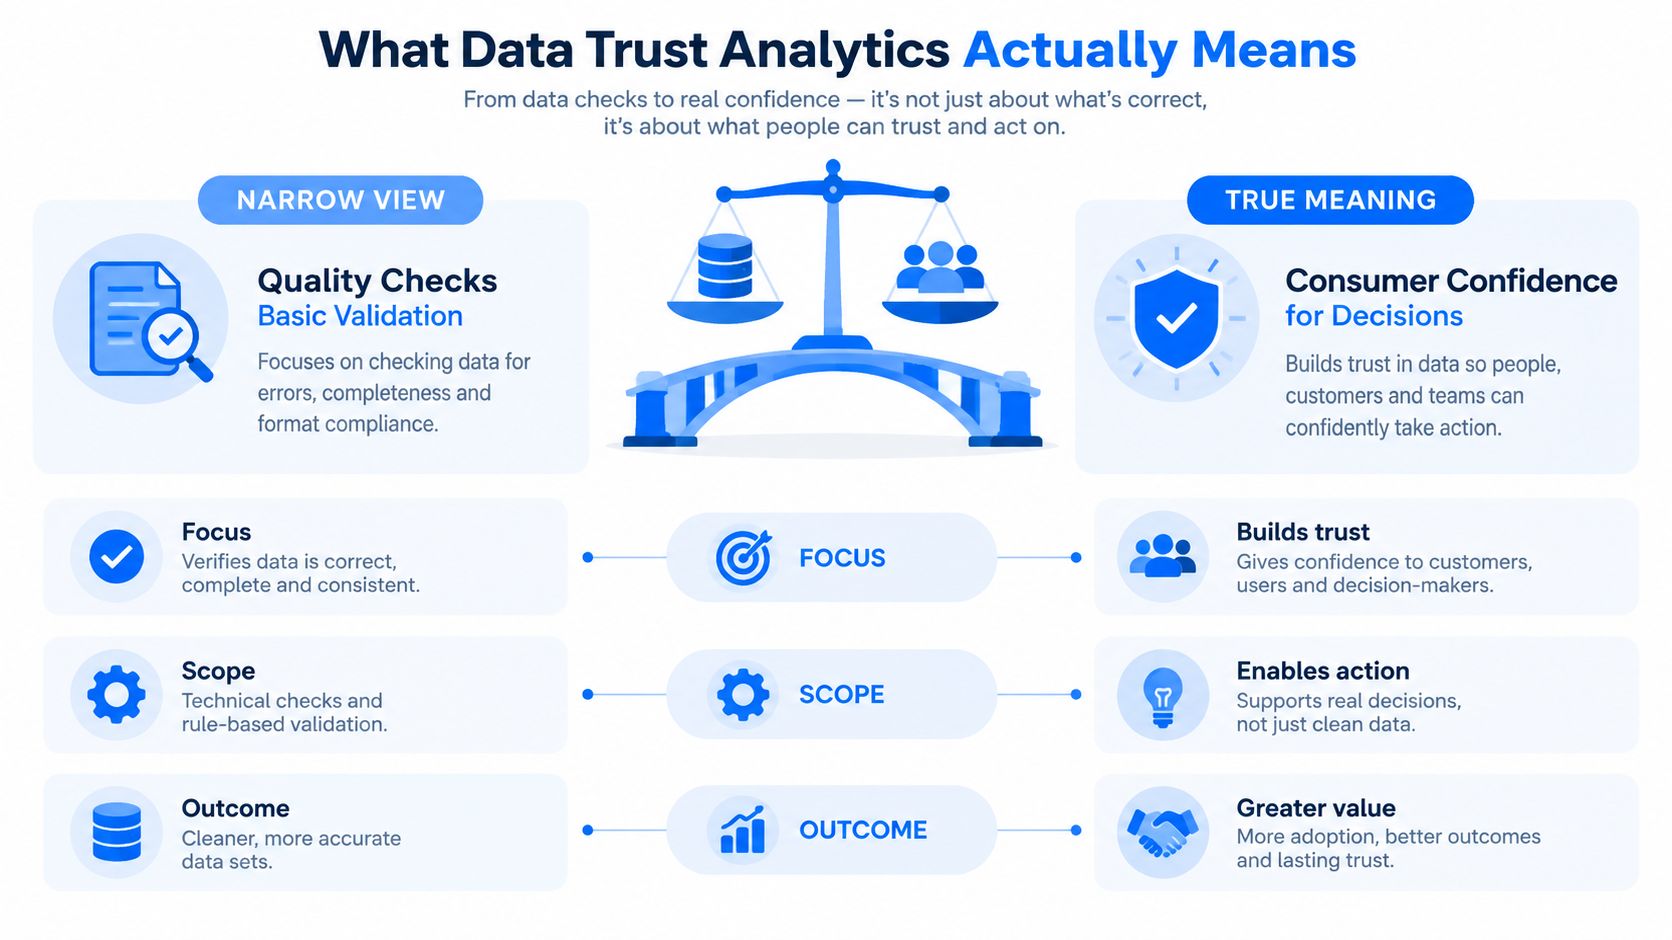
Eine nützliche Unterscheidung ist:
Datenqualität fragt: „Erfüllt dieser Wert die Regel?“
Data Trust Analytics fragt: „Würde ein Entscheidungsträger eine Empfehlung genau jetzt auf diesen Datensatz stützen?“
Diese zweite Frage hängt vom Kontext ab. Eine geringfügige Verzögerung mag für einen monatlichen Planungsbericht akzeptabel sein, für eine operative Warnmeldung jedoch nicht. Eine Spalte kann technisch gültig, aber semantisch mehrdeutig sein. Ein Modell-Feature kann Nullwertprüfungen bestehen, während es seine Verbindung zum Quellsystem verliert, das seine Bedeutung erklärt.
Vertrauen ist ein zusammengesetztes Signal
Betrachten Sie Vertrauen als eine Schlussfolgerung, die aus verschiedenen Arten von Nachweisen gezogen wird:
Operative Nachweise: Kamen die Daten zum erwarteten Zeitpunkt an und wurde die Pipeline erfolgreich abgeschlossen?
Statistische Nachweise: Ähneln Zahlen, Verteilungen, Mittelwerte und Muster fehlender Werte ihrem etablierten Verhalten?
Strukturelle Nachweise: Sind Spalten, Datentypen und Beziehungen kompatibel geblieben?
Kontextuelle Nachweise: Sind Zweck, Eigentümer, Lineage und geschäftliche Definition des Datensatzes dokumentiert?
Ein Data Observability-Framework macht diese Signale sichtbar, aber Sichtbarkeit allein ist nicht das Endergebnis. Der entscheidende Schritt ist die Übersetzung von Beobachtungen in eine Vertrauensbewertung für ein bestimmtes Dashboard, ein Modell, eine Metrik oder einen KI-Workflow.
Die Fünf Säulen, die Vertrauenssignale erzeugen
Ein stiller Pipeline-Fehler kündigt sich selten mit einer roten Fehlermeldung an. Nehmen wir an, ein vorgelagerter Change-Data-Capture-Prozess verliert zwei Tage lang Zeilen, aber der Job meldet weiterhin Erfolg. Umsatz-Dashboards weisen zu niedrige Zahlen aus, und ein Prognosemodell erhält eine unvollständige Kundenhistorie. Jede Observability-Säule deckt einen anderen Teil des Vorfalls auf.
Die standardmäßigen fünf Säulen sind Freshness, Qualität, Volume, Schema und Lineage. Sie arbeiten zusammen und sind keine austauschbaren Begriffe. Die Dimensionen der Datenqualität bieten eine nützliche Möglichkeit, die einzelnen Prüfungen mit der übergeordneten Frage zu verbinden, ob nachgelagerte Daten weiterhin für die Verwendung geeignet sind.
Freshness zeigt, ob die Daten auf dem neuesten Stand sind
Freshness prüft, ob ein Datensatz innerhalb des erwarteten Zeitplans eingetroffen ist. Eine Datenladung, die jeden Morgen erscheint, aber ihr normales Lieferfenster verpasst, sollte das Vertrauen verringern, selbst wenn die bereits vorhandenen Datensätze die Validierung bestehen. Die Timeliness-Überwachung kann eine verzögerte Ladung von einer fehlenden Ladung unterscheiden und auch eine unerwartet frühe Lieferung erkennen, die auf ein Planungs- oder Partitionierungsproblem hindeuten kann.
Quality tests values and business rules
Qualitätsprüfungen untersuchen Nullwertraten, Duplikate, ungültige Formate, referenzielle Beziehungen und geschäftliche Einschränkungen. Im Beispiel der verlorenen Zeilen weisen die verbleibenden Datensätze möglicherweise alle gültige Kunden-IDs auf, sodass eine Validierung auf Datensatzebene allein den Vorfall möglicherweise übersieht. Qualität wird aussagekräftiger, wenn sie zusammen mit Volume und historischem Verhalten interpretiert wird.
Volume catches silent completeness failures
Die Volume-Überwachung vergleicht Zeilenanzahlen oder andere Größenindikatoren mit erwarteten Mustern. Eine plötzliche Reduzierung kann einen teilweisen Extrakt offenbaren, selbst wenn die Pipeline keinen technischen Fehler ausgibt. Volume erklärt zwar nicht die Ursache, gibt dem Team aber ein frühes Signal, dass die Vollständigkeit des Datensatzes untersucht werden muss.
Schema protects structural compatibility
Die Schema-Verfolgung erkennt Hinzufügungen, Entfernungen, Umbenennungen und Typänderungen. Eine umbenannte Spalte kann eine nachgelagerte Transformation sofort unterbrechen, oder sie wird falsch zugeordnet und liefert plausible, aber irreführende Ergebnisse. Strukturelle Kompatibilität ist Teil des Vertrauens, da Konsumenten sowohl von den Werten als auch von der Form der Daten abhängen.
Lineage identifies who and what is affected
Lineage verbindet die Quelltabelle mit Transformationen, Dashboards, Features, Modellen und Geschäftsmetriken. Wenn der Zeilenabfall erkannt wird, hilft Lineage dem Team zu identifizieren, welche Umsatzberichte und Prognosen überprüft werden müssen. Die Eigentümerschaft verwandelt diese Übersicht dann in Action, indem sie den Vorfall an die Personen weiterleitet, die für die Quelle und die betroffenen Produkte verantwortlich sind.
Keine einzelne Säule allein kann die Entscheidungsreife bescheinigen. Vertrauen entsteht, wenn Signale korreliert, im Kontext interpretiert und an verantwortliche Eigentümer übermittelt werden.
Wie Erkennungsebenen Statistik, ML und menschliche Überprüfung kombinieren
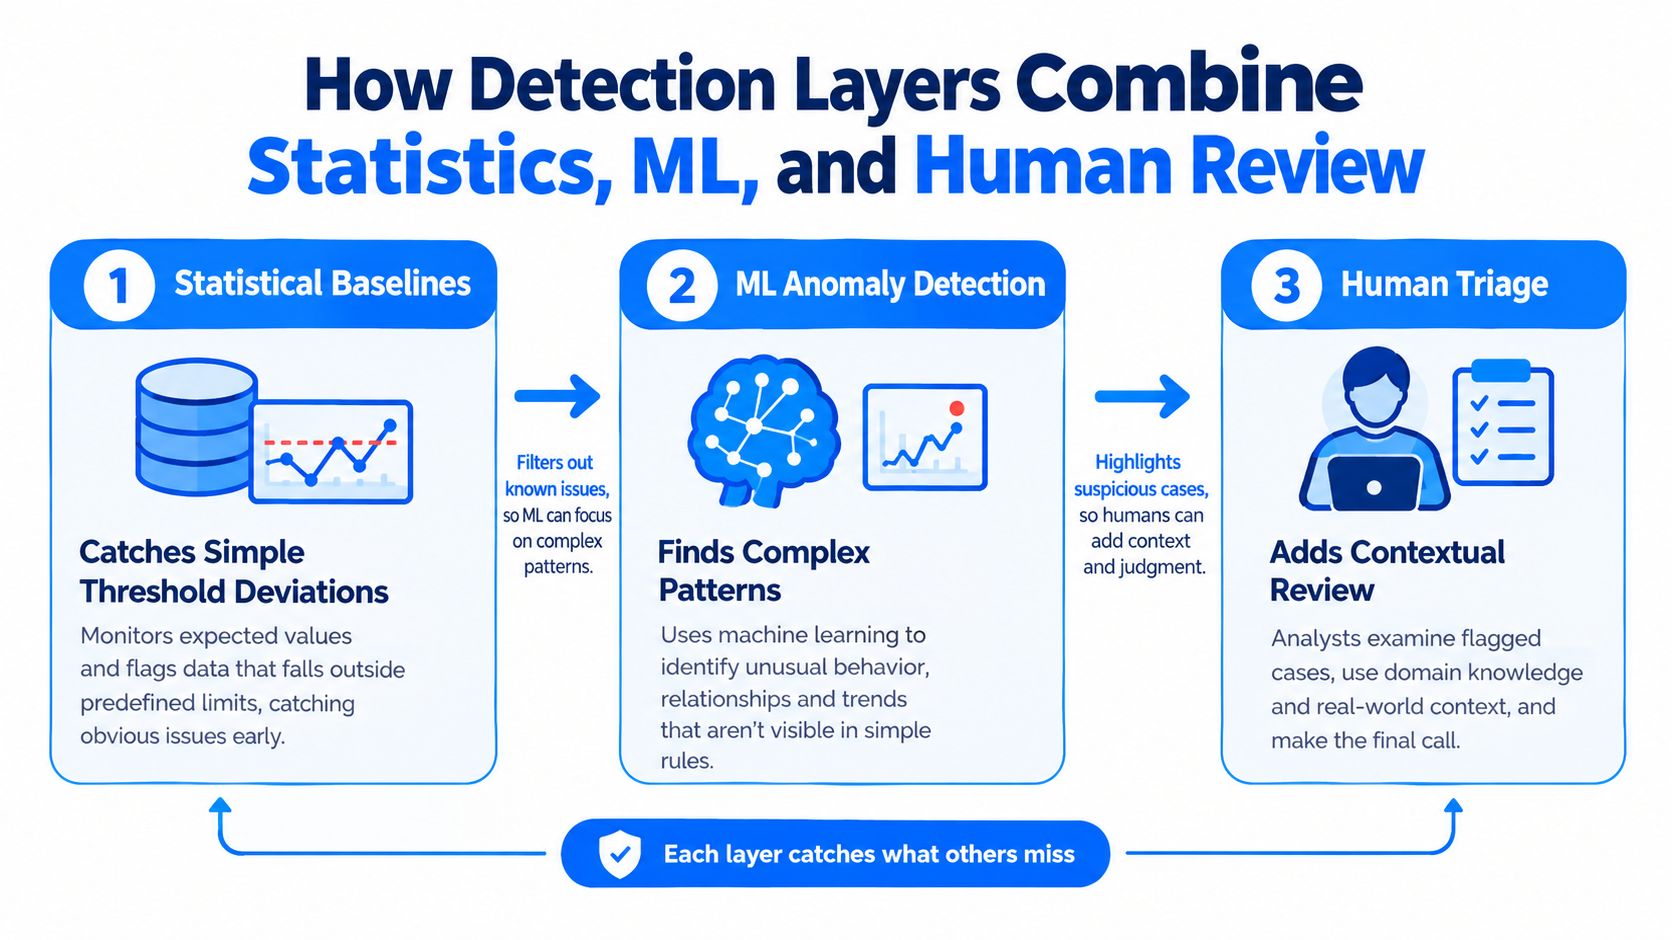
Die Erkennung funktioniert am besten als vielschichtiges System, da jede Ebene eine andere Frage beantwortet. Statistische Baselines erfassen eindeutige Fehler kostengünstig und erklärbar. Maschinelles Lernen identifiziert Verhaltensweisen, die feste Regeln möglicherweise übersehen. Die menschliche Überprüfung liefert den nötigen Geschäftskontext, um zu entscheiden, ob eine Warnmeldung einen Vorfall, eine geplante Änderung oder eine harmlose Abweichung darstellt.
Beginnen Sie mit Baselines für Freshness, Volume, Nullwertraten, Mittelwerte und andere Kernmaße. Ein Schwellenwert kann eine fehlende Lieferung kennzeichnen, während eine rollierende Statistik eine signifikante Abweichung vom jüngsten Verhalten aufzeigen kann. Diese Kontrollen sind bei der Überprüfung von Vorfällen leicht zu erklären, sodass sie auch dann nützlich bleiben, wenn ein Team fortgeschrittenere Erkennungsmethoden hinzufügt.
Wo maschinelles Lernen Mehrwert bietet
Statische Regeln werden unzuverlässiger, wenn Daten saisonalen Mustern, Wochentagen, Release-Zyklen oder Kundensegmenten folgen. Eine erlernte Verteilung oder ein saisonales Modell kann ein ungewöhnliches Muster erkennen, das innerhalb eines breiten festen Schwellenwerts bleibt – ein Ansatz, der auf statistischer Mustererkennung basiert. Eine Pipeline kann ihre Regel für die Mindestzeilenanzahl bestehen, während sie eine Verteilung erzeugt, die stark von ihrem etablierten Profil abweicht.
Für hochvolumige operative Daten beschreibt die Forschung der Universität Amsterdam einen konsensbasierten, unüberwachten Ansatz, der mehrere Modelle, Faustregeln, iterative Hyperparameter-Optimierung und einen Fachexperten im Prozess kombiniert. Die Methode der Studie unterstützt ein praktisches Designprinzip: Kein einzelner Detektor sollte für jede Art von Anomalie verantwortlich sein.
Warum Menschen Teil des Systems bleiben
Eine Pipeline kann feste Freshness- und Volume-Prüfungen bestehen und dennoch ein gelerntes Modell auslösen, weil eine Schlüsselmetrik auf ungewohnte Weise einbricht. Ein Analyst überprüft den Bereitstellungskalender und bestätigt, dass eine geplante Werbeaktion die Änderung verursacht hat. Die Kennzeichnung des Ereignisses als erwartet verhindert, dass ähnliche Warnmeldungen zu wiederkehrendem Rauschen werden, und verleiht dem Erkennungsprozess einen besseren Kontext.
Ein separates Datenqualitäts-Framework empfiehlt, jede eintreffende Charge zu profilieren, historische Profile aufzubewahren und die resultierende Zeitreihe in Anomalie-Modelle einzuspeisen. Der zitierte Profilierungsansatz behandelt Drift als messbare Sequenz und nicht als einmalige Überprüfung.
Praktische Regel: Nutzen Sie Regeln für bekannte Fehlermuster, Modelle für verändertes Verhalten und Menschen für den Geschäftskontext.
Metriken, die Vertrauen in etwas Messbares verwandeln
Vertrauen wird handhabbar, wenn Teams es durch Metriken ausdrücken, die sie melden, überwachen und verbessern können. Ein Dashboard, das lediglich sagt „Daten sehen gut aus“, ist schwer zu verteidigen. Eine Scorecard, die Freshness-Performance, ungelöste Anomalien, die Wiederherstellungszeit bei Schemaänderungen und die Lineage-Abdeckung anzeigt, gibt Ingenieuren und Stakeholdern eine gemeinsame operative Sprache.
Die folgenden Metriken sind Ausgangspunkte, keine universellen Zielvorgaben. Ein kritischer Zahlungsdatensatz sollte strengere Erwartungen haben als eine explorative Tabelle. Definieren Sie den Benchmark gemeinsam mit den Eigentümern und Konsumenten, die die Folgen eines Fehlers verstehen.
Metrik | Definition | Ziel-Benchmark | Quellsäule |
|---|---|---|---|
Freshness SLO | Anteil der erwarteten Aktualisierungen, die innerhalb des vereinbarten Rhythmus geliefert wurden | Festgelegt durch die Entscheidungsnutzung und Liefererwartung des Datensatzes | Freshness |
Anomalierate | Erkannte anomale Ereignisse im Verhältnis zur überwachten Tabellenpopulation und dem Beobachtungszeitraum | Niedrig genug, um die Aufmerksamkeit zu wahren, wobei bestätigte Vorfälle getrennt von akzeptierten Ereignissen verfolgt werden | Qualität, Volume, Freshness |
Schema-Änderung MTTR | Mittlere Zeit von einer nicht autorisierten oder inkompatiblen Schemaänderung bis zur Behebung | Kurz genug, um nachgelagerte Veröffentlichungen und Modellnutzung zu schützen | Schema |
Lineage-Abdeckung | Anteil der nachgelagerten Assets, die mit einer eigenen und überwachten vorgelagerten Quelle verbunden sind | Vollständige Abdeckung für kritische Berichte, Features und Modelle | Lineage |
Metriken gemeinsam lesen
Ein starkes Freshness-Ergebnis kompensiert keine schlechte Lineage. Eine niedrige Anomalierate kann stabile Daten bedeuten oder dass der Detektor zu konservativ eingestellt ist. Die MTTR bei Schemaänderungen kann gut aussehen, während Teams immer noch nicht in der Lage sind, alle betroffenen Dashboards zu identifizieren.
Veröffentlichen Sie aus diesem Grund den Metrik-Kontext zusammen mit dem Wert selbst. Erfassen Sie das überwachte Asset-Set, die Entscheidungsnutzung, Ausschlüsse, akzeptierte Anomalien und den Eigentumsstatus. Ein Leitfaden zur Messung der Zuverlässigkeit kann Teams dabei helfen, operative Beobachtungen in eine Diskussion über Zuverlässigkeit zu übersetzen, die auch geschäftliche Stakeholder verstehen.
Entscheidungskontext hinzufügen
Jede Scorecard sollte drei Fragen beantworten:
Was wurde gemessen? Nennen Sie die Tabelle, das Feature-Set, die Metrik oder den Modelleingang.
Was hat sich geändert? Zeigen Sie das aktuelle Signal im Vergleich zu seiner historischen Baseline und der vereinbarten Erwartung.
Welche Maßnahme folgt? Identifizieren Sie den Eigentümer, den Eskalationspfad sowie die Veröffentlichungs- oder Inferenzentscheidung.
Diese Struktur verhindert, dass Teams Datenvertrauen als dekoratives Dashboard-Label behandeln. Sie macht das Vertrauen überprüfbar.
Von Observability zur Entscheidungsreife für KI
Observability liefert Nachweise, sagt einem Modellbesitzer aber nicht automatisch, ob ein KI-System heute laufen sollte. Eine Plattform zeigt möglicherweise eine fehlerfreie Pipeline-Ausführung an, während die Feature-Daten weiterhin schwer zurückzuverfolgen, ungewöhnlich verteilt oder von ungelösten Anomalien betroffen sind.
Diese Lücke spiegelt sich in der Stimmung von Unternehmen wider. 58 % der Unternehmen gaben an, Data-Observability-Programme implementiert oder optimiert zu haben, doch 42 % vertrauen den Ergebnissen ihrer KI- oder Machine-Learning-Modelle immer noch nicht, so ein aktueller Bericht über das KI-Vertrauen in Unternehmen. Observability kann also mit Misstrauen koexistieren, wenn Teams die Infrastruktur überwachen, ohne zu beweisen, dass die nachgelagerten Eingaben entscheidungsreif sind.
Scorecards um Ergebnisse herum aufbauen
Eine Vertrauens-Scorecard sollte Nachweise an einen bestimmten Konsumenten binden. Beispielsweise könnte eine Feature-Tabelle eine akzeptable Freshness aufweisen, aber nur eine Lineage-Abdeckung von 60 % und drei ungelöste Anomalien. Diese Zahlen sind Beispielszenarien und keine allgemeinen Benchmarks, aber sie verdeutlichen, warum ein generischer grüner Pipeline-Status irreführend sein kann.
Der Modellfreigabeprozess kann explizite Bedingungen anwenden:
Freshness-Bedingung: Erforderliche Eingaben sind innerhalb der erwarteten Zeitfenster eingetroffen.
Qualitäts-Bedingung: Kritische Validierungsregeln wurden bestanden, Ausnahmen wurden dokumentiert.
Schema-Bedingung: Keine inkompatiblen strukturellen Änderungen sind ungelöst.
Lineage-Bedingung: Der Modellbesitzer kann kritische Features bis zu den überwachten Quellen zurückverfolgen.
Incident-Bedingung: Offene Anomalien haben einen zugewiesenen Eigentümer und eine dokumentierte Entscheidung.
Eine Scorecard sollte Unsicherheit nicht hinter einer einzigen Gesamtzahl verbergen. Sie sollte die Nachweise hinter der Entscheidung zeigen, die Genehmigung des Risikoverantwortlichen und die Bedingungen, unter denen das Ergebnis zurückgehalten oder überprüft werden muss.
Diese Nachweise können auch in der Modelldokumentation erscheinen. Führungskräfte, Aufsichtsbehörden, Analysten und Ingenieure benötigen mehr als nur eine Modellmetrik. Sie benötigen eine nachvollziehbare Erklärung, ob die das Ergebnis stützenden Daten zum Zeitpunkt der Nutzung aktuell, stabil, validiert und rückverfolgbar waren.
Vertrauen innerhalb von Unternehmensbeschränkungen operativ umsetzen
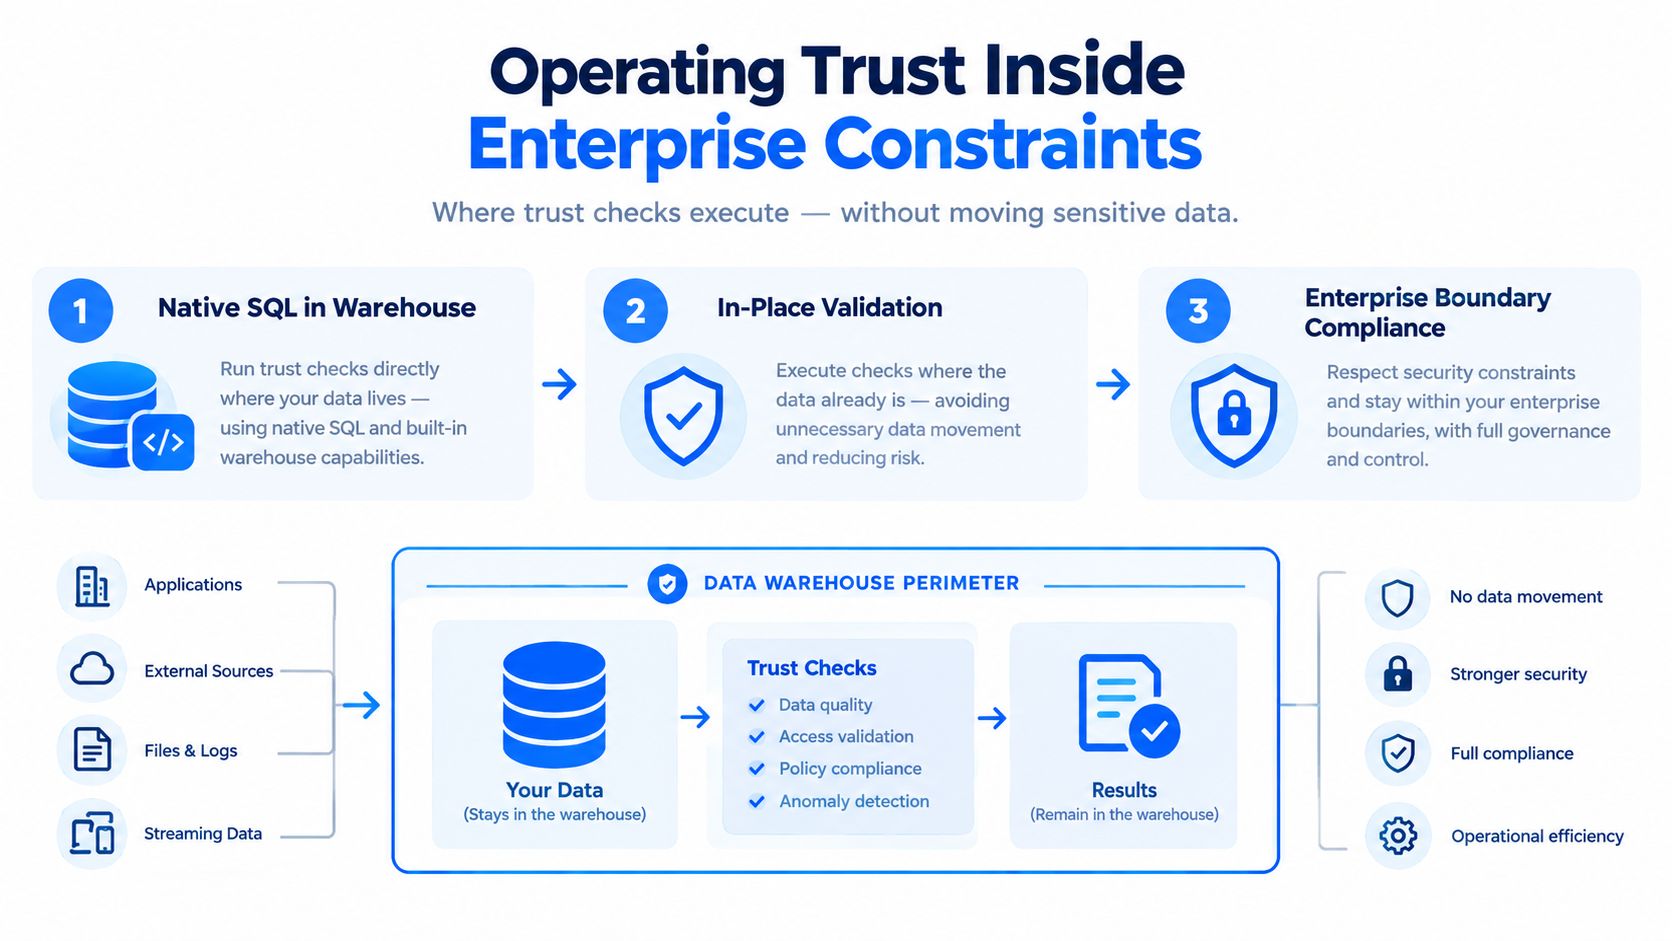
Vertrauensprüfungen müssen in die Umgebung passen, in der sensible Daten bereits liegen. Das Verschieben von Produktionsdaten in einen separaten Überwachungsdienst kann Bedenken hinsichtlich des Datenschutzes, der Datenresidenz, der Zugriffskontrolle, der Verschlüsselung und des Netzwerks aufwerfen. Es kann auch das Eigentumsmodell verkomplizieren, da die Nachweise von dem System getrennt werden, das die Daten hält.
Eine praktische Architektur trennt oft die Ausführung von der Koordination. Native SQL- oder datenbankeigene Prüfungen können Zeilenanzahlen, Einschränkungen, Freshness-Indikatoren und Validierungsergebnisse direkt dort berechnen, wo die Daten liegen. Ein zentralisierter Dienst kann dann Richtlinien, Warnmeldungen, die Weiterleitung von Vorfällen und Scorecards anhand der erforderlichen Metadaten verwalten, anstatt Kopien der eigentlichen Datensätze zu erstellen.
Die Control-Plane proportional halten
Das richtige Bereitstellungsmodell hängt von den Grenzen der Organisation ab. Eine Private Cloud oder eine On-Premises-Installation eignet sich am besten für Teams, die Produktionsdaten nicht aus ihrer Umgebung herausbewegen dürfen. digna gibt an, dass seine Plattform innerhalb der Private Cloud oder der On-Premises-Infrastruktur des Kunden läuft, wobei Datenqualitätsprüfungen und Anomalieerkennungslogik direkt in der Datenbank-Engine des Kunden ausgeführt werden. In der Dokumentation wird dieses In-Place-Modell beschrieben.
Das operative Design sollte auch Hürden bei der Einführung berücksichtigen. Eine aktuelle Umfrage ergab, dass 61 % der Teams sich immer noch auf manuelle Prüfungen oder SQL-basierte Validierung verließen, 27 % eine dedizierte Observability-Plattform nutzten und nur 14 % Service-Level-Agreements unternehmensweit durchsetzten, während 39 % sie zumindest verfolgten. Der Integrate.io-Bericht zeigt, warum Implementierungen bestehende Workflows respektieren müssen, anstatt davon auszugehen, dass jedes Team seine Validierungspraktiken sofort ersetzen kann.
Zuständigkeiten zuweisen, bevor Warnmeldungen hinzugefügt werden
Derselbe Bericht ergab, dass die Verantwortung für die Datenqualität bei 44 % der Befragten auf mehrere Teams verteilt war, und eine begrenzte Sichtbarkeit der Pipeline-Integrität für 31 % die größte Herausforderung darstellte. Geteilte Verantwortung kann funktionieren, aber nur, wenn jemand die Entscheidung besitzt, einen Vorfall zu untersuchen, ein Ergebnis zu veröffentlichen, zu unterdrücken oder wiederherzustellen.
Priorisieren Sie Kontrollen nach:
Entscheidungsauswirkung: Überwachen Sie zuerst Assets, die finanzielle, regulatorische, klinische, operative oder kundenbezogene Entscheidungen beeinflussen.
Datensensitivität: Minimieren Sie gespeicherte Metadaten und halten Sie den Zugriff im Einklang mit bestehenden Berechtigungen.
Fehlerkosten: Leiten Sie Warnmeldungen mit schwerwiegenden Folgen über etablierte Incident-Kanäle weiter.
Operative Eignung: Testen Sie Prüfungen bei verzögerter Datenaufnahme, beeinträchtigten Abhängigkeiten und Schemaänderungen.
Kaufen Sie kein plattformweites Versprechen ein, bevor Sie den Workflow in einem kritischen Bereich bewiesen haben. Eine modulare Einführung ermöglicht es Teams, die Signalqualität, die Verantwortung für Warnmeldungen und die operativen Kosten zu validieren, bevor sie die Abdeckung erweitern.
Ein tragfähiges Betriebsmodell für Datenvertrauen aufbauen
Ein dauerhaftes Vertrauensprogramm ist ein geschlossenes Betriebssystem, keine Sammlung von Überwachungswarnungen. Teams definieren Service-Level-Objectives für Freshness, Vollständigkeit, Gültigkeit, Schemakompatibilität und Lineage-Abdeckung und verknüpfen diese Ziele dann mit benannten Eigentümern, Eskalationspfaden und Schwellenwerten für geschäftliche Auswirkungen.
Die Reaktionsrichtlinie ist ebenso wichtig wie die Erkennung. Eine fehlgeschlagene Prüfung kann die nachgelagerte Veröffentlichung oder KI-Inferenz blockieren, aber nur, wenn dokumentierte Kontrollen die Unterbrechung rechtfertigen. In anderen Fällen kann das Unternehmen das letzte bekannte zuverlässige Ergebnis beibehalten, das Ergebnis als veraltet kennzeichnen und dem Eigentümer ein definiertes Zeitfenster zur Behebung des Problems einräumen.
Vorfälle in institutionelles Wissen umwandeln
Dokumentieren Sie für jeden wesentlichen Vorfall Folgendes:
Ursache: Was hat sich an der Quelle, der Transformation, dem Zeitplan, dem Schema oder dem Zugriffspfad geändert?
Auswirkung: Welche Tabellen, Metriken, Dashboards, Features, Modelle und Entscheidungen waren betroffen?
Reaktion: Wer hat den Vorfall untersucht, welche Maßnahmen wurden ergriffen und wie schnell wurde der Dienst wiederhergestellt?
Nachweise: Welche Validierungs- und Überwachungsergebnisse haben bestätigt, dass die Daten wieder sicher verwendet werden können?
Lassen Sie diese Erkenntnisse nach der Behebung wieder in die Validierungsregeln, die Baseline-Konfiguration, die Eigentumsübersichten, die Zugriffsrichtlinien und die Engineering-Backlogs einfließen. Ein wiederkehrender Freshness-Fehler erfordert möglicherweise eine Neugestaltung des Zeitplans. Ein wiederholtes Schemaproblem erfordert möglicherweise Kompatibilitätsverträge. Wiederholte Unklarheiten bei einer Metrik erfordern möglicherweise eine stärkere semantische Definition.
Vertrauen als funktionsübergreifende Praxis überprüfen
Data Engineering, Analytics, governance, Security und geschäftliche Stakeholder sollten die Scorecards gemeinsam überprüfen. Jede Gruppe sieht ein anderes Fehlermuster. Ingenieure verstehen das Pipeline-Verhalten, Analysten verstehen die Interpretation, Security versteht Risiken, governance versteht die Verantwortlichkeiten und Business-Eigentümer verstehen die Konsequenzen von Entscheidungen.
Diese Disziplin unterstützt umfassendere Bestrebungen, Geschäftswert mit Daten freizusetzen, da zuverlässige Daten zu einer operativen Fähigkeit und nicht zu einem ungeprüften Nebenprodukt werden. Das Ziel ist nicht, jede Anomalie zu eliminieren. Es geht darum, wiederholbare Nachweise dafür zu schaffen, dass das Unternehmen seine Daten kennt, weiß, wer sie besitzt, welche Entscheidungen von ihnen abhängen, und sich erholen kann, wenn sich die Bedingungen ändern.
Vertrauen wird verdient, wenn an gewöhnlichen Tagen wie an Tagen mit Vorfällen dieselben Nachweise dieselbe Entscheidung stützen.
digna bietet datenbanknahe Datenqualitäts- und Observability-Funktionen zur Überwachung von Anomalien, Timeliness, Validierung, Schemaänderungen und historischem Datenverhalten, ohne dass Produktionsdaten aus der Umgebung des Kunden verschoben werden müssen. Besuchen Sie digna, um zu sehen, wie dieser modulare Ansatz operative Signale mit der Entscheidungsbereitschaft für Analytics und KI verbinden kann.


