Data Observability-Metriken: Der Referenzkatalog
|
7
min. Lesezeit

Sie starren auf ein Dashboard, das normal aussieht, aber eine Upstream-Tabelle hat gestern Nachmittag eine Spalte umbenannt, und niemand hat es bemerkt, bis der Umsatzbericht auf dem Wert von Montag eingefroren blieb. Die Pipeline hat nicht angeschlagen, die Diagramme sind nicht abgestürzt, und das Modell hat weiterhin NULL-Werte ausgegeben. Das ist genau die Art von Fehler, die Data Observability-Metriken eigentlich abfangen sollten – aber nur, wenn Ihr Team das Signal benennen, es auf dieselbe Weise berechnen und sich darauf einigen kann, was passiert, wenn es eine Grenze überschreitet.
Teams haben bereits Fragmente der Antwort. Sie haben Freshness-Prüfungen in einem Tool, Zeilenanzahl-Warnungen in einem anderen, Schema-Protokolle in einem dritten und ein paar informelle Regeln, die in den Notizen der Rufbereitschaft stehen. Was ihnen meistens fehlt, ist ein direkt einsatzbereiter Referenzkatalog, eine gemeinsame Übersicht der Metriken selbst, wie jede einzelne berechnet wird und bei welchem Schwellenwert es sich lohnt, jemanden aufzuwecken. Ein klarer Katalog verwandelt unübersichtliches Monitoring in etwas, das man während eines Vorfalls tatsächlich nutzen kann, anstatt es nur in einer Demo zu bewundern. Für einen praktischen Einstieg ist dignas Data Observability-Übersicht ein nützliches Beispiel dafür, wie Teams in der Produktion über dieses Problem nachdenken.
Inhaltsverzeichnis
Warum Data Observability-Metriken einen gemeinsamen Katalog benötigen
Gemeinsames Vokabular verhindert das Abschweifen bei Vorfällen
Was Data Observability-Metriken sind
Metriken sind kontinuierlich, Prüfungen sind punktuell
Die fünf Kernkategorien auf einen Blick
Freshness, Volumen, Schema, Verteilung, Lineage
Freshness- und Timeliness-Metriken im Detail
Vier Metriken, die Freshness umsetzbar machen
Das Zeitfenster nach Asset-Klasse festlegen
Anomaliewerte sowie Abweichungs- oder Volatilitätsmaße
Drei Wege, um ungewöhnliches Verhalten zu erkennen
Anzahl der Schemaänderungen und strukturelle Abweichungssignale
Vier Metriken, die Struktur sichtbar machen
Business-KPI-Monitore als entscheidungsrelevante Ebene
Den KPI aus den zugrunde liegenden Assets aufbauen
Schnellreferenzmatrix für den Katalog
Querverweise zwischen Metrikkategorien
Freshness-zu-Volumen, Schema-zu-Verteilung, Lineage-zu-Abweichung
Auswahl des kleinsten Satzes an Metriken, der wirklich zählt
Warum Data Observability-Metriken einen gemeinsamen Katalog benötigen
Das Schlimmste an einer schleichenden Schemaabweichung ist nicht die Abweichung selbst. Es ist der halbe Tag, den Ihr Team damit verliert, darüber zu streiten, wie man es nennen soll. Ein Entwickler sagt, die Tabelle sei veraltet gewesen, ein anderer meint, der Extrakt sei fehlgeschlagen, und ein dritter weist darauf hin, dass die Ausgabe des Modells falsch war, weil eine Eingabespalte umbenannt wurde. Das Dashboard wurde immer noch gerrendert, sodass der Fehler harmlos aussah, bis ihn jemand für eine Entscheidung heranzog.
Ein Katalog ändert dieses Gespräch. Anstelle eines losen Haufens von Prüfungen erhalten Sie benannte Observability-Metriken, jede mit einer bekannten Formel, einem klaren Verantwortlichen und einem Alarmierungsszenario, das im Nachhinein überprüft werden kann. Das ist wichtig, denn derselbe Zustand kann auf drei verschiedene Arten beschrieben werden, wenn sich niemand einig ist, ob man über Freshness-Verzögerung, Schemakonformität oder nachgelagerten Volumenverlust spricht.
Gemeinsames Vokabular verhindert das Abschweifen bei Vorfällen
Wenn ein Data Lead, ein Analyst und ein Entwickler unter „verspäteten Daten“ dasselbe verstehen, verschwenden sie keine Zeit mehr mit Übersetzungen. Ein Metrikkatalog gibt ihnen eine Definition für jedes Signal, einen Berechnungsweg und eine Eskalationsregel. Das ist besonders nützlich, wenn sich eine Tabelle während der Geschäftszeiten anders verhält als über Nacht, da dasselbe Wort sehr unterschiedliche Fehlermodi beschreiben kann.
Ein Katalog reduziert auch die unkontrollierte Ausbreitung von Schwellenwerten. Ohne ihn erfindet jeder Entwickler in der Rufbereitschaft für jedes Asset einen neuen Grenzwert, was zu uneinheitlichen Benachrichtigungen, unterschiedlicher Priorisierung und schwindendem Vertrauen führt. Mit ihm kann das Team überprüfen, ob ein Signal in die Kategorie Warnung, Benachrichtigung oder „beobachten, aber niemanden wecken“ gehört.
Praktische Regel: Wenn zwei Personen darüber streiten können, ob das Problem an Freshness, Volumen oder dem Schema liegt, ist Ihr Katalog noch nicht spezifisch genug.
Der Wert wird bei einem echten Vorfall noch deutlicher. Ein Dashboard zeigt um 9:00 Uhr morgens vielleicht stagnierende Umsätze an, aber die Freshness-Metrik kann zeigen, dass die Aktualisierung der Bestellungen-Tabelle um 2:14 Uhr nachts gestoppt wurde. Das ist das erste unterbrochene Glied, und das ist es, was behoben werden muss, bevor jemand über nachgelagerte Berichte diskutiert. Für einen praktischen Einstieg zeigt dignas Data Observability-Übersicht, wie Teams in der Produktion über das Problem nachdenken.
Was Data Observability-Metriken sind
Data Observability-Metriken sind Zeitreihenmessungen, die von Daten-Assets und den Pipelines, die sie bewegen, erfasst werden. Dazu gehören Zeilenanzahlen, Null-Werte-Raten, Schema-Fingerabdrücke, Verteilungszusammenfassungen, Lineage-Lücken und abgeleitete Indikatoren wie Anomaliewerte oder Abweichungswerte. In der Praxis sind dies die Signale, deren Trend Sie im Laufe der Zeit verfolgen, um zu erkennen, wenn sich eine Tabelle nicht mehr wie gewohnt verhält.
Ein nützlicher Katalog macht diese Signale auf einen Blick lesbar. Eine Metrik namens null_rate_email_hourly sagt einem Analysten weitaus mehr als check_7, da der Name bereits das Thema, das Maß und die Häufigkeit enthält. Strukturierte Benennungskonventionen, wie das Muster der Daten-Tags für die KI-Inhaltserstellung, funktionieren auf dieselbe Weise: Labels sollten Menschen helfen zu erkennen, worauf sie schauen, bevor sie die Definition öffnen.
Metriken are continuous, checks are point-in-time
Eine grundlegende Datenqualitätsprüfung beantwortet in der Regel eine Ja-oder-Nein-Frage. Ist diese Spalte null? Ist diese ID eindeutig? Liegt der Wert im zulässigen Bereich? Diese Prüfungen sind nützlich, aber sie verifizieren eine bekannte Regel nur zu einem bestimmten Zeitpunkt.
Observability-Metriken funktionieren anders. Sie werden kontinuierlich gemessen, mit einer Baseline für dieses spezifische Asset verglichen und alarmieren bei Abweichungen und nicht nur bei Regelverstößen. Eine Null-Wert-Prüfung für ein E-Mail-Feld ist ein statischer Qualitätstest. Eine stündliche Null-Wert-Raten-Reihe mit einer gleitenden Baseline ist eine Observability-Metrik, da sie ein langsames, vorgeschaltetes Extraktionsproblem aufdecken kann, lange bevor jemand fehlerhafte Kampagnen bemerkt.
Dieser Unterschied ist wichtig für die Art und Weise, wie Teams den Katalog dokumentieren. Jeder Eintrag sollte drei Fragen konsistent und ohne Rätselraten beantworten.
Definition: Was die Metrik in einfacher Sprache bedeutet.
Berechnungsmethode: Die Formel oder Aggregation dahinter.
Alarmierungsverhalten: Ob sie warnt, benachrichtigt oder nur in Analysen einfließt.
Nützliche Unterscheidung: Wenn das Team die Prüfung nur ausführt, wenn jemand ein Problem vermutet, ist es ein Test. Wenn die Metrik im Trend liegt, eine Baseline hat und alarmierungsfähig ist, handelt es sich um Observability.
Am besten stellt man sich den Katalog als eine Schicht zwischen der rohen Telemetrie und dem menschlichen Handeln vor. Rohe Zählungen und Zeitstempel werden zu Metriken. Metriken werden zu Schwellenwerten. Schwellenwerte werden zu Runbook-Entscheidungen.
Die fünf Kernkategorien auf einen Blick
Der Bereich gliedert sich in der Regel in fünf Messkategorien, und jede Kategorie fängt eine andere Art von Fehler ab. Es handelt sich dabei nicht um konkurrierende Taxonomien, sondern um sich überschneidende Ansichten desselben Assets. Ein solider Katalog benennt alle fünf, damit sich Teams nicht zu sehr auf das eine Signal fixieren, das sie bereits zu erfassen wissen.
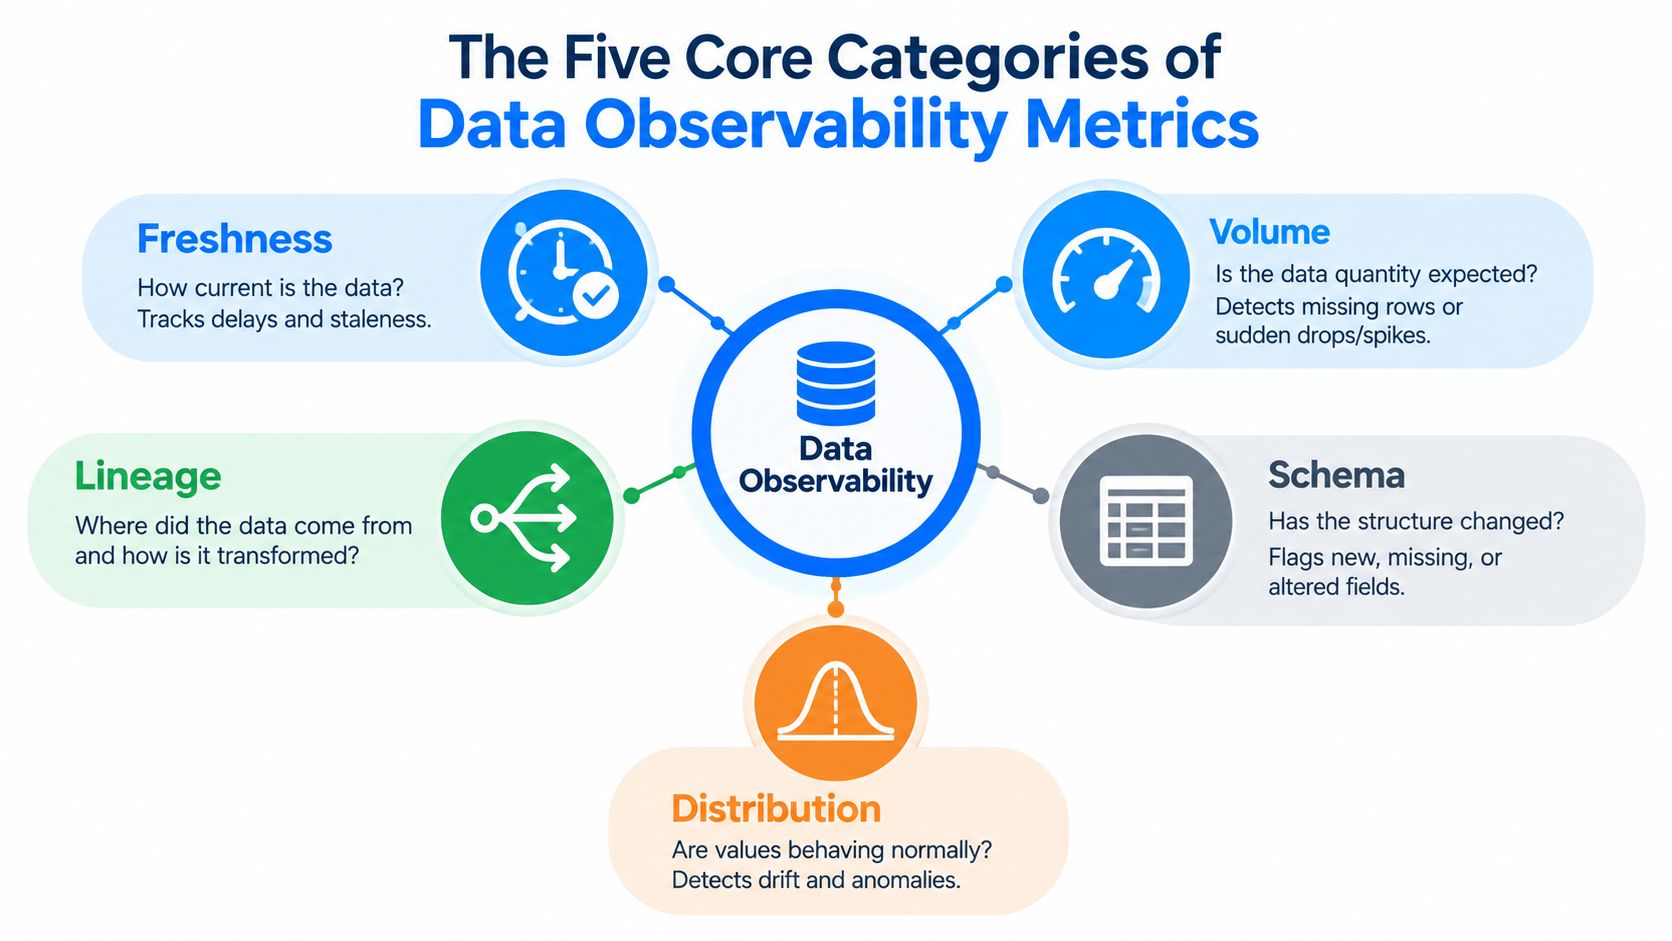
Freshness, volume, schema, distribution, lineage
Freshness fragt, ob die Daten für den geschäftlichen Anwendungsfall aktuell genug sind. Sie fängt verspätet eintreffende Partitionen und blockierte ELT-Jobs ab – also genau das, was ein Dashboard veralten lässt.
Volumen prüft, ob die Anzahl der Datensätze in etwa den Erwartungen entspricht. Es ist die erste Verteidigungslinie gegen leere Exporte, unvollständige Ladevorgänge und duplizierte Ingestions.
Schema überwacht strukturelle Änderungen wie neue Spalten, fehlende Felder, umbenannte Felder und Typänderungen. Es fängt die Fehler ab, die dazu führen, dass nachgelagerte Modelle NULL-Werte zurückgeben, selbst wenn die Tabelle noch geladen wird.
Verteilung betrachtet das Verhalten der Werte, nicht nur die Anzahl. Verschiebungen bei Null-Werten-Raten, Kardinalität, Bereichen oder der Form der Daten zeigen sich oft, bevor ein geschäftlicher Nutzer eine falsche Antwort bemerkt.
Lineage bildet die Abhängigkeitspfade ab. Sie zeigt Ihnen, welches Dashboard, welches Modell oder welche nachgelagerte Tabelle von dem geänderten Asset abhängt, und ist die Kategorie, die verhindert, dass eine einzige fehlerhafte Quelle zu einer stundenlangen, blinden Suche führt.
Das Nützliche an dieser Gruppierung in Kategorien ist, dass jede einzelne ein anderes Fehlermuster aufweist. Ein verspäteter Job sieht oft zuerst nach einem Freshness-Problem aus, dann nach einem Volumen-Problem. Eine API-Migration bei einem Drittanbieter zeigt sich oft gleichzeitig als Schemaabweichung und plötzlicher Anstieg von Null-Werten. Ein Ausfall der Quelle kann sich durch die Lineage ziehen und schließlich als Verteilungsabweichung nachgelagert erscheinen.
Nutzen Sie die Kategorie, die zu dem Symptom passt, das Sie zuerst messen können, und bestätigen Sie die anderen, bevor Sie das Problem eskalieren.
Freshness- und Timeliness-Metriken im Detail
Bei Freshness geht es um Verzögerung, nicht nur darum, ob ein Job gelaufen ist. Eine Pipeline kann erfolgreich sein und Daten dennoch zu spät liefern, um noch von Bedeutung zu sein. Bei Produkt-Events, Bestell-Feeds und operativen Dashboards ist die Verzögerung selbst der Vorfall.
Der sauberste Weg, Freshness auszudrücken, besteht darin, die Lücke zwischen erwarteter und tatsächlicher Verfügbarkeit zu messen. Das liefert Ihnen eine Metrik, für die Sie eine Baseline erstellen, Alarme einrichten und die Sie an den Verantwortlichen der Pipeline übergeben können. dignas Timeliness-Definition und Monitoring-Hinweise passen gut zu diesem Anwendungsfall, wenn Sie ein Plattformbeispiel suchen, das Lieferzeiten als primäres Signal behandelt.
Vier Metriken, die Freshness umsetzbar machen
max_event_lag_seconds ist das einfachste Maß für Verzögerung. Eine praktische Formel ist now() - max(event_time), die Ihnen sagt, wie weit das aktuellste Event hinter dem jetzigen Zeitpunkt hinterherhinkt.
row_arrival_rate verfolgt den Durchsatz im Zeitverlauf, meist als importierte Zeilen pro Minute. Ein plötzlicher Abfall kann bedeuten, dass die Quelle keine Daten mehr sendet, ein Filter zu streng eingestellt ist oder der vorgeschaltete Job feststeckt.
pipeline_completion_lag vergleicht eine geplante Fertigstellungszeit mit der tatsächlichen Fertigstellungszeit. Er erfasst, wann der Job technisch abgeschlossen ist, jedoch nicht, bevor die Service-Level-Vereinbarung (SLA) bereits verletzt wurde.
sla_breach_minutes misst, wie lange das Asset außerhalb seines Freshness-Budgets lag. Das ist die Zahl, die eine technische Verzögerung in eine Vorfalldauer verwandelt.
Metrik | Formel | Beispiel | Warnung | Benachrichtigung (Page) |
|---|---|---|---|---|
max_event_lag_seconds |
| Das neueste Event liegt hinter der aktuellen Zeit | Bei 50 Prozent der SLA | Bei 100 Prozent der SLA |
row_arrival_rate |
| Importrate fällt unter die erwartete Frequenz | Bei 50 Prozent des erwarteten Durchsatzes | Bei 100 Prozent des erwarteten Durchsatzes |
pipeline_completion_lag |
| Job endet nach Schließung des Fensters | Bei 50 Prozent des Freshness-Budgets | Bei 100 Prozent des Budgets |
sla_breach_minutes | Zeit über dem Freshness-Budget | Asset bleibt über das SLA-Fenster hinaus verspätet | Bei 50 Prozent der erlaubten Verspätung | Bei 100 Prozent und Eskalation bei 200 Prozent |
Das Zeitfenster nach Asset-Klasse festlegen
Nutzen Sie unterschiedliche Freshness-Budgets für verschiedene Datenprodukte. Produkt-Events benötigen meist Fenster im Sekundenbereich. Transaktionale Datensätze tolerieren oft etwa 5 Minuten. Nächtliche Aggregate liegen meist im Bereich von 15 bis 60 Minuten. Compliance-Exporte können in 24-Stunden-Fenstern gemessen werden, wenn es der Geschäftsprozess erlaubt.
Aus diesem Grund sind pauschale Grenzwerte eine schlechte Angewohnheit. Ein einziger Freshness-Schwellenwert kann nicht gleichzeitig für einen hochfrequenten Clickstream und eine tägliche Abrechnungstabelle funktionieren, ohne an einer Stelle Fehlalarme zu erzeugen. Eine gestaffelte Alarmierung ist stabiler: Warnung bei 50 Prozent der SLA, Benachrichtigung bei 100 Prozent und Eskalation bei 200 Prozent, falls das Asset immer noch verspätet ist.
Betriebliche Regel: Schreiben Sie die SLA direkt neben den Metriknamen. Wenn das Freshness-Budget im Runbook nicht offensichtlich ist, ist der Alarm nicht zielführend.
Anomaliewerte sowie Abweichungs- oder Volatilitätsmaße
Nicht jeder fehlerhafte Datensatz ist verspätet oder unvollständig. Manchmal kommen die Daten pünktlich an und verhalten sich trotzdem auf eine Weise, die keinen Sinn ergibt. Hier spielen Anomaliewerte und Abweichungsmaße ihre Stärken aus, da sie ein vages „das sieht merkwürdig aus“ in ein Signal verwandeln, das Sie mit der Historie vergleichen können.
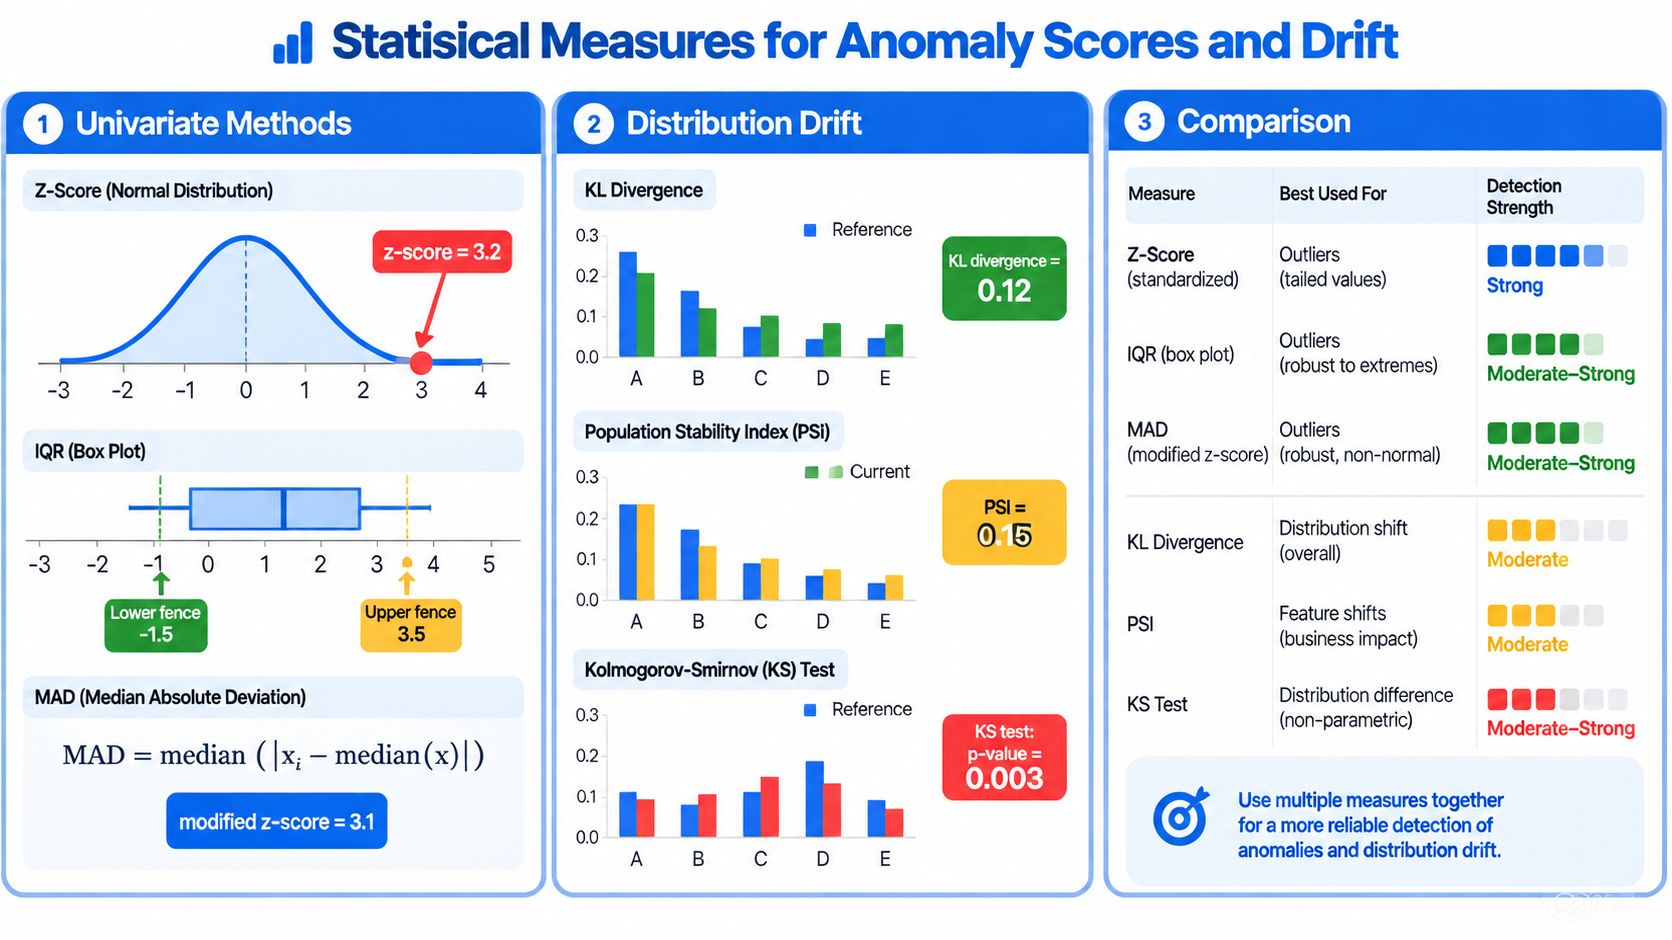
Drei Wege, um ungewöhnliches Verhalten zu erkennen
Univariate Methoden betrachten jeweils eine Metrik einzeln. Ein Z-Wert gibt an, wie weit der heutige Wert in Standardabweichungen vom Mittelwert abweicht. Ein modifizierter Z-Wert nutzt den Median und die mittlere absolute Abweichung (MAD), was hilft, wenn die Daten Ausreißer enthalten. IQR-Grenzen sind ebenfalls einfach, da sie Werte außerhalb der mittleren Verteilung kennzeichnen.
Verteilungsbasierte Methoden vergleichen die Form einer Stichprobe mit einer anderen. Die KL-Divergenz, PSI und der KS-Test sind gängige Optionen, wenn Sie wissen möchten, ob sich das Histogramm einer Spalte signifikant verschoben hat.
Zeitabhängige Baselines berücksichtigen Saisonalitäten. Eine tägliche Metrik kann besorgniserregend aussehen, wenn Sie den Montagmorgen mit dem Sonntagabend vergleichen. Daher sind gleitende Baselines nach Wochentag, Stunde oder Geschäftskalender meist sicherer als ein einzelner flacher Schwellenwert.
Nehmen wir als konkretes Beispiel die täglich_aktiven_nutzer. Wenn Sie einen gleitenden 14-Tage-Mittelwert und die Standardabweichung berechnen, kann das heutige Volumen mit dieser gleitenden Baseline verglichen werden. Ein einfacher Alarm kann ausgelöst werden, wenn der Wert über 3 Sigma steigt oder unter die Baseline des 10. Perzentils fällt. Diese zweiseitige Konfiguration ist wichtig, da sowohl Spitzen als auch Abfälle nachgelagerte Annahmen zerstören können.
Der größte Fehler besteht hier darin, einseitige Schwellenwerte für saisonale Daten zu verwenden. Die Besucherzahlen im Einzelhandel, ein Abrechnungslauf und die Logins einer B2B-App haben nicht dieselbe Form. Eine allgemeingültige Regel führt daher eher zu einer Überlastung durch Fehlalarme als zu Klarheit. Die Kosten für zu viele Fehlalarme sind real, da Teams in der Rufbereitschaft den Alarmen misstrauen, die sie eigentlich schützen sollten.
Die Anleitung zur Erkennung von Datenabweichungen ist eine nützliche Ergänzung, wenn Sie sehen möchten, wie Abweichungsmonitoring in Produktionsmuster übersetzt wird. Die Kernidee bleibt dieselbe: Messen Sie die Abweichung von der richtigen Baseline und nicht von einer abstrakten Vorstellung von Normalität.
Anzahl der Schemaänderungen und strukturelle Abweichungssignale
Schemaabweichungen werden handhabbar, sobald Sie aufhören, sie als vages Kompatibilitätsproblem zu behandeln, und anfangen, sie zu messen. Ein umbenanntes Feld, eine Typänderung oder eine entfernte Spalte lassen sich leichter zuweisen, wenn der Alarm das genaue strukturelle Ereignis benennt und vor dem Release auf den Verantwortlichen verweist.
Vier Metriken, die Struktur sichtbar machen
schema_change_count zählt Hinzufügungen, Löschungen und Typänderungen pro Pipeline-Durchlauf. Wenn eine Quelle beginnt, jede Woche Spalten hinzuzufügen, zeigt die Metrik dieses Muster, lange bevor das nachgelagerte Modell bricht.
backward_incompatible_change_rate ist der Anteil der Schemaänderungen, die bestehende Konsumenten beeinträchtigen können. Sie zeigt Ihnen, ob Änderungen auf sichere oder gefährliche Weise erfolgen.
drift_detection_latency_minutes misst die Zeit von einem vorgelagerten Commit oder Release bis zum Alarm. Wenn Sie nicht wissen, wie lange es dauert, eine Abweichung zu bemerken, wissen Sie auch nicht, wie ungeschützt Ihre Konsumenten sind.
orphaned_column_rate verfolgt Felder, die von keinem nachgelagerten Modell oder Dashboard mehr gelesen werden. Diese Spalten sind oft ein Zeichen für veraltete Abhängigkeiten, vergessene Logik oder eine Schnittstelle, die niemand mehr pflegt.
Abweichungsmetrik | Definition | Berechnung | Beispiel | Verantwortlicher |
|---|---|---|---|---|
schema_change_count | Anzahl struktureller Änderungen pro Durchlauf | Hinzufügungen + Löschungen + Typänderungen | Eine umbenannte Spalte erscheint im Ladevorgang | Data-Platform-Engineer |
backward_incompatible_change_rate | Anteil der Änderungen, die Konsumenten beeinträchtigen können | Inkompatible Änderungen / Änderungen insgesamt | Eine Typänderung schneidet Werte nachgelagert ab | Code-Inhaber |
drift_detection_latency_minutes | Zeit vom Commit bis zum Alarm | Alarmzeit minus Änderungszeit | Eine Migration wird erst bemerkt, nachdem ein Dashboard ausfällt | Pipeline-Verantwortlicher |
orphaned_column_rate | Vom nachgelagerten Konsumenten ungenutzte Felder | Ungelesene Spalten / Spalten insgesamt | Ein Feld verbleibt in der Tabelle, wird aber von nichts mehr gelesen | Analytics-Engineer |
Tabellenspezifische Baselines sind hier wichtig. Eine hochfrequente Event-Tabelle sollte nicht nach denselben Maßstäben wie eine sich langsam ändernde Referenztabelle beurteilt werden, da eine von beiden immer unruhig wirken wird, wenn man sie in dieselbe Regel zwingt. Leiten Sie kritische Änderungen vor dem Release an den Code-Inhaber weiter, nicht erst, wenn das Dashboard bereits ausgefallen ist.
Business-KPI-Monitore als entscheidungsrelevante Ebene
Einfache Observability-Metriken sagen Ihnen, was kaputt ist. Business-KPI-Monitore erklären der Führungsebene, was es bedeutet. Diese Ebene liegt über Freshness, Volumen, Schema, Verteilung und Lineage und verknüpft diese Signale mit Geschäftsergebnissen wie Umsatzgenauigkeit, Retourenverhalten, Churn und Auftragsabwicklung.

Den KPI aus den zugrunde liegenden Assets aufbauen
Ein entscheidungsrelevanter Monitor beginnt mit einer vertrauenswürdigen Geschäftskennzahl und verfolgt diese bis zu den beitragenden Daten-Assets zurück. Sobald Sie die Abhängigkeiten kennen, können Sie jedes Asset mit Observability-Metriken verknüpfen, sodass der übergeordnete KPI diese Signale erbt. Wenn sich der Umsatz im Checkout verändert, starren Sie nicht nur auf das Umsatzdiagramm. Sie prüfen gleichzeitig die Freshness der Bestell-Events, Volumenanomalien bei den Einzelposten und die Schemastabilität des Produktkatalogs.
Das ist der Unterschied zwischen einem reinen Vorzeige-Dashboard und einem echten Business-Monitor. Ein Vorzeige-Diagramm kann grün bleiben, selbst wenn einer der Inputs fehlt oder fehlerhaft ist. Ein entscheidungsrelevanter Monitor sucht nach der Fehlerquelle unterhalb des KPI und leitet das Problem an das Team weiter, das den Geschäftsprozess verantwortet.
Ein gutes Verantwortlichkeitsmodell ist unkompliziert. Finanzen oder Operations sollten den KPI definieren, das Data-Platform-Team sollte die rohen Observability-Signale verantworten, und das Analytics-Engineering sollte die Abhängigkeiten pflegen. Das verhindert, dass der Alarm zwischen Teams hin- und hergeschoben wird, von denen jedes nur einen Teil des Problems versteht.
digna ist eine Plattform, die Business-Monitoring mit Timeliness, Anomalieerkennung, Validierung und Schematracking direkt in der Umgebung des Kunden kombiniert. Der entscheidende Punkt ist nicht der Markenname, sondern das Prinzip: Der KPI wird erst dann umsetzbar, wenn die zugrunde liegenden Signale sichtbar und einem klaren Verantwortlichen zugewiesen sind.
Es sollte nur wenige KPI-Monitore geben, da mit jedem einzelnen eine menschliche Entscheidung verknüpft sein muss.
Schnellreferenzmatrix für den Katalog
Ein Referenzkatalog sollte auf einen einzigen Bildschirm passen, wenn jemand gerade ein Ticket zu einem Vorfall prüft. Das Ziel ist nicht, jede erdenkliche Metrik anzuzeigen, sondern einem Lead dabei zu helfen, eine Frage schnell zu beantworten: Worauf sollte ich bei diesem Asset alarmieren?
Die folgende Matrix fasst die gängigen Kategorien in einer praktischen Übersicht zusammen. Die Schwellenwerte sind Richtwerte, keine allgemeingültigen Wahrheiten, und sollten für jedes Asset individuell angepasst werden, nachdem Sie das tatsächliche Verhalten analysiert haben.
Metrikkategorie | Primäre Berechnung | Empfohlener Alarmschwellenwert | Typischer Verantwortlicher | Prioritätsstufe |
|---|---|---|---|---|
Freshness |
| Absolute SLA-Verletzung in Minuten | Data-Platform-Engineer | Hoch |
Volumenanomalie | Gleitender Mittelwert und Standardabweichung oder Z-Wert | Verteilungsbasierte Abweichung von der Baseline | Analytics-Engineer | Mittel bis Hoch |
Schema change count | Anzahl der Hinzufügungen, Löschungen, Typänderungen pro Durchlauf | Absolute Anzahl kritischer Änderungen | Code-Inhaber | Hoch |
Verteilungsabweichung | PSI, KS-Test oder Histogrammverschiebung | Relative Abweichung von der Baseline-Verteilung | Data-Quality-Lead | Mittel |
Lineage-Bruch | Fehlende vor- oder nachgelagerte Abhängigkeit | Absoluter Bruch im Abhängigkeitsdiagramm | Platform-Engineer | Hoch |
Null-Wert-Rate | Null-Werte geteilt durch Gesamtdatensätze | Relativer Anstieg gegenüber der Baseline | Analytics-Engineer | Mittel |
Eindeutigkeit | Eindeutige Werte geteilt durch Zeilenanzahl | Absoluter oder relativer Rückgang der Eindeutigkeit | Data Steward | Mittel |
Business-KPI-Monitor | Aus mehreren Signalen abgeleiteter KPI | Abweichung vom geschäftlichen Toleranzbereich | Business-Owner | Kritisch |
Wenn Sie eine Plattformtabelle suchen, die diese Art des Katalogdenkens widerspiegelt, zeigt dignas Metrik-Systemtabelle, wie Metrikfamilien für den operativen Einsatz strukturiert werden können. Die beste Matrix ist diejenige, die Ihr Team während eines Vorfalls tatsächlich pflegen kann, und nicht die mit den meisten Zeilen.
Querverweise zwischen Metrikkategorien
Eine verzögerte Pipeline beginnt oft mit einem Freshness-Problem und zeigt sich dann als Volumenanomalie, weil weniger Zeilen als in der Baseline angekommen sind. Behandeln Sie dieses Paar als einen einzigen Vorfallspfad und nicht als zwei voneinander unabhängige Alarme.

Freshness-zu-Volumen, Schema-zu-Verteilung, Lineage-zu-Abweichung
Eine Schemaänderung und ein plötzlicher Anstieg der Null-Werte treten oft gemeinsam nach einer API-Migration eines Drittanbieters auf. Eine einzige Änderung der Nutzdaten kann sowohl ein Problem mit fehlenden Feldern als auch ein Problem mit der Datenform verursachen. Daher sollte ein Schema-Alarm mit dem Verteilungsmonitor abgeglichen werden, bevor das Ticket geschlossen wird.
Lineage-Brüche können auch nachgelagerte Abweichungsalarme auslösen, wenn eine fehlende Quelle jede abhängige Tabelle beeinflusst. Asset-spezifische Baselines sorgen für einen fairen Vergleich, da eine tägliche Abrechnungstabelle und ein hochfrequenter Event-Stream beide einwandfrei funktionieren und sich dennoch völlig unterschiedlich verhalten können.
Verknüpfen Sie diese drei Paarungen als Folgeprüfungen in Ihrem Alarmierungstool, sodass das zweite Signal automatisch abgefragt wird, wenn das erste anschlägt.
Auswahl des kleinsten Satzes an Metriken, der wirklich zählt
Ein Satz von Metriken hilft nur dann, wenn er zu einer Entscheidung führt. Wenn ein Alarm nicht auf einen Verantwortlichen oder eine wahrscheinliche Lösung verweist, ist er nur störendes Rauschen.
Beginnen Sie mit einer Freshness-SLA für jede kritische Ebene, einem Anomaliewert für umsatzrelevante Volumina, der Anzahl der Schemaänderungen bei den Tabellen, die nachgelagerte Konsumenten beeinträchtigen können, und einem KPI-Monitor pro Hauptgeschäftsprozess. Für eine Zahlungsplattform könnte dieses Startset aus einer Freshness-SLA für die Transaktionstabelle, einem 3-Sigma-Anomaliewert für das tägliche Abrechnungsvolumen, der Anzahl der Schemaänderungen in der Kundentabelle und einem KPI-Monitor für die Erstattungsquote bestehen.
Wählen Sie Metriken basierend auf Verantwortlichkeit, Vorfallshistorie und potenzieller Schadenswirkung aus. Überprüfen Sie die Liste jedes Quartal neu, da sich Assets und Fehlermodi ändern – und der Katalog sollte sich mit ihnen verändern.
Häufig gestellte Fragen
Was sind Data-Observability-Kennzahlen?
Zeitreihenmessungen an Datenassets und den Pipelines, die sie bewegen. Ein Name wie null_rate_email_hourly sagt einer Analystin weit mehr als check_7, weil er Subjekt, Messgröße und Taktung schon trägt, bevor jemand die Definition öffnet.
Wie unterscheiden sich Kennzahlen von Qualitätsprüfungen?
Eine Prüfung beantwortet eine Ja-oder-Nein-Frage zu einem Zeitpunkt; eine Kennzahl wird getrendet, mit Baseline versehen und alarmierbar gemacht. Der nützliche Test ist einfach: Wird sie nur ausgeführt, wenn jemand ein Problem vermutet, ist es ein Test und keine Observability.
Welche fünf Kennzahlenkategorien gibt es?
Aktualität, Volumen, Schema, Verteilung und Lineage. Jede hat eine eigene Fehlersignatur: Aktualität dreht sich um Verzögerung statt um den Joblauf, Volumen prüft, ob die Satzanzahl ungefähr den Erwartungen entspricht, und Verteilung betrachtet Werteverhalten statt bloßer Zählungen.
Warum braucht ein Team einen gemeinsamen Kennzahlenkatalog?
Um Incident-Drift zu stoppen. Wenn Datenverantwortliche, Analystinnen und Engineers dasselbe unter „verspätete Daten“ verstehen, hören sie auf zu übersetzen und fangen an zu beheben. Wenn zwei Personen streiten können, ob es um Aktualität, Volumen oder Schema geht, ist der Katalog noch nicht präzise genug.
Was sollte jeder Katalogeintrag dokumentieren?
Drei Dinge: die Definition in klarer Sprache, die Berechnungsmethode dahinter und die Alarmhaltung, also ob die Kennzahl warnt, alarmiert oder nur in die Analyse fließt. Genau dieses letzte Feld bewahrt einen Katalog davor, zu undifferenziertem Rauschen zu werden.



