Zbiór kontroli jakości: praktyczny przewodnik projektowy
|
8
min. czyt.

Twój pulpit wygląda dobrze, dopóki finanse nie zamkną miesiąca i nie zapytają, dlaczego przychód jest zawyżony. Potok się nie wysypał. Hurtownia nie padła. Krok transformacji odrzucił wiersze z pustym customer_id, a wszystkie agregaty niżej w łańcuchu szły dalej, jakby nic się nie stało.
Takie awarie są powodem, dla którego zespoły potrzebują czegoś więcej niż rozproszonych testów i maili z alertami. Potrzebują zbioru danych kontroli jakości, który działa jak pamięć operacyjna potoku: co sprawdzono, jak wygląda „normalne”, co się zmieniło, kto odpowiada za problem i jak odróżnić prawdziwy incydent od szumu.
Wiele zespołów już wie, że powinno walidować dane. Trudniejsze pytanie brzmi, gdzie włożyć wysiłek. Niektóre zbiory potrzebują ciągłego śledzenia schematu i progów świeżości. Inne potrzebują kilku surowych reguł biznesowych i okazjonalnego przeglądu ręcznego. Traktowanie każdej tabeli tak samo zwykle rodzi rozrost reguł, zmęczenie alertami i martwe pola tam, gdzie liczą się najbardziej.
Spis treści
Wybór właściwego podejścia do monitorowania dla każdego zbioru
Powszechne nieporozumienia podkopujące programy jakości danych
Czym naprawdę jest zbiór danych kontroli jakości
Zbiór kontroli jakości zwykle pojawia się po bolesnym incydencie. Częsty wzorzec to pulpit finansowy raportujący przychód znacznie powyżej stanu faktycznego, bo rekordy powyżej w łańcuchu zostały źle odfiltrowane, zduplikowane albo częściowo załadowane. Nikt nie zauważa tego przy ingestii, bo potok wciąż „kończy się sukcesem”.
Zbiór danych kontroli jakości to ustrukturyzowany, odpytywalny zapis tego, jak wykrywasz i diagnozujesz taką awarię. To nie tylko tabela wyników testów. Trzyma kontrole wokół danych: reguły walidacji, oczekiwane linie bazowe, wybrane rekordy warte obejrzenia oraz metadane audytowe mówiące, co się stało i kiedy.
Gdzie mieści się w stosie
Zespoły często mylą go z sąsiednimi artefaktami.
To nie surowe logi walidacji. Logi mówią, że kontrola się wykonała. Zwykle nie zachowują dość kontekstu, by porównać zachowanie historyczne albo zbadać dryf.
To nie katalog danych. Katalog mówi, czym jest zbiór, kto go posiada i może skąd pochodzi. Zwykle nie przechowuje historii zaliczeń i niepowodzeń ani dowodów anomalii.
To nie zestaw testowy. Fixtures pomagają deweloperom sprawdzać transformacje w kontrolowanych warunkach. Zbiór kontroli jakości żyje obok eksploatacji produkcyjnej i zmienia się razem z nią.
Najczyściej myśleć o tym tak: potok wytwarza dane biznesowe, a zbiór kontroli jakości wytwarza dowody na wiarygodność tych danych.
Reguła praktyczna: jeśli twój zespół nie potrafi z jednego miejsca odpowiedzieć „co się zmieniło, kiedy się zaczęło i czy to naruszenie reguły, czy przesunięcie zachowania?”, prawdopodobnie nie masz jeszcze prawdziwego zbioru kontroli jakości.
Dlaczego musi pozostać żywy
To nie jednorazowy produkt nadzoru. To żywy zasób operacyjny. Prace normalizacyjne przesunęły jakość danych ku jawnym charakterystykom i mierzalnym kontrolom. ISO/IEC 25012 i ISO/IEC 25024 ustanowiły zarówno ogólny model jakości, jak i miary ilościowe, dlatego nowoczesne zespoły coraz częściej oddzielają „opisz dane” od „zmierz jakość”.
To rozróżnienie liczy się na produkcji. Dane zmieniają kształt. Systemy powyżej w łańcuchu zmieniają nazwy pól. Opóźnienie źródła przesuwa się po wdrożeniu u dostawcy. Użyteczny zbiór kontroli jakości musi wchłaniać te zmiany, zamiast skamienieć po pierwszej implementacji.
Jeśli potrzebujesz zwięzłego wprowadzenia w szerszą dyscyplinę, ten przegląd jakości danych dobrze uzupełnia opisany tu model operacyjny.
Podstawowe elementy zbioru kontroli jakości
Zbiór kontroli jakości staje się użyteczny, gdy oddziela wykrywanie od diagnozy. Wykrywanie mówi, że coś jest nie tak. Diagnoza mówi dlaczego, gdzie i kto powinien działać. Większość nieudanych wdrożeń robi tylko pierwszą część.
Pięć elementów, które się liczą
Każdy projekt operacyjny, któremu ufam, zawiera pięć warstw.
Element | Cel | Typowe przechowywanie |
|---|---|---|
Warstwa metadanych | Wskazuje właściciela, SLA, odsyłacz do pochodzenia, krytyczność i ścieżkę eskalacji | Tabela katalogowa, schemat kontrolny, repozytorium nadzoru |
Reguły walidacji | Egzekwują ograniczenia schematu, dopuszczalność wartości pustych, logikę biznesową i dozwolone formaty | Kod w kontroli wersji plus tabela reguł |
Linie bazowe statystyczne | Zapisują oczekiwane zachowanie: rozkłady, wzorce wartości pustych, wolumen i kardynalność | Tabele metryk w hurtowni lub w warstwie obserwowalności |
Próbki referencyjne | Zachowują wzorcowe rekordy, przypadki brzegowe i znane złe przykłady do przeglądu | Dedykowane tabele próbek lub wyselekcjonowane zestawy przeglądowe |
Ślady audytowe | Przechowują wyniki ze znacznikami czasu, różnice dryfu, incydenty i notatki o rozwiązaniu | Tabele historii QC, system incydentów, warstwa obserwowalności |
Co robi każda warstwa
Warstwa metadanych kotwiczy własność. Jeśli kontrola zawiedzie, a nikt nie wie, kto posiada zbiór ani jaki proces niżej w łańcuchu od niego zależy, alert ma ograniczoną wartość.
Warstwa reguł walidacji łapie awarie deterministyczne. Naruszenia klucza głównego, niedozwolone przejścia stanów, zepsute formaty dat i niemożliwe wartości należą tutaj. Tu też zaczyna liczyć się logika świadoma schematu, zwłaszcza przy strukturach zagnieżdżonych lub zmiennych. Zrozumienie różnych typów schematów i wzorców zmian pomaga unikać kruchych reguł, które pękają za każdym razem, gdy system źródłowy dodaje pole.
Warstwa linii bazowych statystycznych łapie zachowania, które wciąż przechodzą twarde reguły, ale nie są już normalne. Tabela może być poprawna, a mimo to podejrzana, jeśli rozkład kategorii nieoczekiwanie skacze, rośnie liczba duplikatów albo źródło przychodzi później niż zwykle.
Dlaczego brak jednego elementu osłabia pozostałe
Na próbkach referencyjnych i śladach audytowych wiele programów oszczędza. To zwykle się mści.
Bez próbek referencyjnych inżynierowie nie mogą szybko obejrzeć przypadków brzegowych ani porównać dzisiejszych złych rekordów ze znanymi wcześniej wzorcami awarii.
Bez śladów audytowych każdy incydent zaczyna się od zera. Zespoły tracą historię tego, kiedy zaczął się dryf, czy ten sam problem wracał i czy strojenie progów poprawiło, czy pogorszyło sprawę.
Kontrola, która mówi tylko „niepowodzenie”, jest ledwie lepsza niż brak kontroli. Eksploatujący potrzebują dowodów, nie samego statusu.
Najmocniejsze wdrożenia traktują zbiór kontroli jakości jak mały model operacyjny samego potoku: reguły, metryki, przykłady i historia w jednym odpytywalnym miejscu.
Kluczowe wymiary jakości, które trzeba monitorować
Pojedynczy walidator nie pokryje trybów awarii na produkcji. Jakość pęka wzdłuż różnych osi, a każda oś potrzebuje własnej logiki kontrolnej.
Niezależne wytyczne dotyczące QC zbiorów traktują dokładność, kompletność, spójność, unikalność i Timeliness jako osobne wymiary kontroli, bo zbiór może być kompletny i błędny, aktualny i niespójny albo strukturalnie nienaruszony i nieświeży. Te same wytyczne zalecają też łączenie kontroli deterministycznych z przeglądem statystycznym pod kątem anomalii, braków i stabilności schematu, bo wiele awarii ujawnia się najpierw jako przesunięcia częstości lub opóźnień, a nie jako oczywiste usterki na poziomie wierszy, jak przedstawia ten przewodnik po kontrolach jakości zbiorów danych.

Sześć wymiarów, sześć trybów awarii
Dokładność znaczy, że wartość odpowiada rzeczywistości lub wiarygodnemu źródłu. Uzgodnienia wobec sum księgowych, systemów prawdy albo zatwierdzonych danych referencyjnych należą tutaj.
Kompletność pyta, czy wymagane rekordy i pola są obecne. Skoki wartości pustych, częściowe ładowania i brakujące partycje zwykle ujawniają się tu najpierw.
Spójność sprawdza, czy ta sama encja biznesowa jest reprezentowana tak samo w różnych systemach. Niezgodne kody walut i sprzeczne etykiety statusu to częste przykłady.
Unikalność chroni przed podwójnym liczeniem i kolizjami tożsamości. Zduplikowane zdarzenia i powtórzone identyfikatory transakcji potrafią zepsuć raportowanie.
Poprawność egzekwuje oczekiwania co do formatu i dziedziny. Pole może być obecne i unikalne, a mimo to niepoprawne, jeśli łamie reguły wzorca, zakresu lub wartości wyliczeniowych.
Timeliness sprawdza, czy dane przyszły wtedy, kiedy biznes tego oczekuje. Technicznie poprawny zbiór wciąż może być bezużyteczny, jeśli dotrze za późno na raport lub decyzję.
Timeliness potrzebuje prawdziwego progu
Przy świeżości mgliste monitorowanie zawodzi najczęściej. Praktyczny model opiera się na progach: porównaj najnowszy znacznik czasu w zbiorze z czasem bieżącym i alarmuj, gdy różnica przekroczy zdefiniowane SLA. Jeden przykład z obserwowalności danych opisuje to jako kontrolę świeżości, w której tabela godzinowa łamie próg, gdy opóźnienie przekroczy dopuszczalną wartość.
To znacznie użyteczniejsze niż nazywanie czegoś „spóźnionym” bez przypiętego zegara.
Jeśli chcesz osobnego odniesienia do tego, jak te wymiary przekładają się na kontrole operacyjne, warto mieć pod ręką ten przewodnik po wymiarach jakości danych.
Prawdziwe przykłady zbiorów kontroli jakości w praktyce
Najłatwiej zrozumieć zbiór kontroli jakości, patrząc na to, co przechowuje, gdy zespoły używają go jako żywego zasobu, a nie statycznej listy.
Przykładowe wzorce z produkcji
Przykład | Wymiar jakości | Przechowywane artefakty | Sygnał operacyjny |
|---|---|---|---|
Przegląd oznaczonego zbioru treningowego | Dokładność | Pochodzenie etykiet, identyfikatory recenzentów, znaczniki niezgody, status konsensusu, próbkowe przeglądy eksperckie | Systematyczny dryf osób etykietujących albo klasy niejednoznaczne |
Strumień z rejestru schematów zdarzeń | Poprawność i integralność schematu | Zmiany kolumn, znaczniki czasu, autor, notatki o zgodności, poprzednia migawka schematu | Łamiąca zmiana nazwy pola, zmiana typu albo cichy dryf |
Pulpit SLA świeżości | Timeliness | Oczekiwane okna napływu, faktyczne czasy ingestii, historia naruszeń, status źródła | Chroniczne spóźnienia, pominięte ładowania, niestabilne dostawy ze źródła |
Dane etykietowane potrzebują własnego zapisu QC
Zbiory oznaczone to mocny przykład, bo zespoły często zakładają, że etykiety są „gotowe”, gdy kończy się kuracja. Nie są. Praca z NeurIPS podała średni 3,4% wskaźnik błędów etykiet w zbiorach ewaluacyjnych dziesięciu benchmarków, dość, by wpłynąć na wybór modelu i ranking, zgodnie z pracą NeurIPS o zbiorach danych i benchmarkach.
Dlatego dobre zbiory kontroli jakości dla danych etykietowanych śledzą pochodzenie recenzentów, liczbę niezgód, próbkowe ponowne kontrole eksperckie i kryteria akceptacji według poziomu ryzyka. Ta sama praca wspomina też o procesach, które ponownie przeglądają 10–20% danych, by poprawić zgodność tam, gdzie stawka jest wyższa.
Gdy etykiety napędzają zachowanie modelu, niezgoda nie jest szumem do ukrycia. To sygnał jakości do zapisania i zbadania.
Historia schematu powinna być odpytywalna
W strumieniach zdarzeń i współdzielonych tabelach hurtowni dryf schematu bywa incydentem przed incydentem. Producent zmienia nazwę pola. Transformacja niżej w łańcuchu wciąż działa, ale zaczyna zwracać wartości puste. Pulpit pęka później, daleko od przyczyny źródłowej.
Użyteczny zbiór kontroli jakości przechowuje migawki schematu w czasie, a do tego kto co zmienił i czy zmiana była wstecznie zgodna. To zamienia „coś się wczoraj zepsuło” w zapytanie: co zmieniło się powyżej w łańcuchu przed awarią?
Świeżość zasługuje na własny artefakt
Monitorowanie Timeliness też działa lepiej, gdy stoi za nim dedykowany zbiór. Zamiast binarnego alertu przechowuj oczekiwane okna napływu, faktyczne znaczniki napływu i historię naruszeń według źródła. Pozwala to oddzielić jednorazowe opóźnienia od chronicznej niestabilności źródła i dostosować eskalację do wpływu.
Jak zaprojektować zbiór kontroli jakości dla swoich potoków
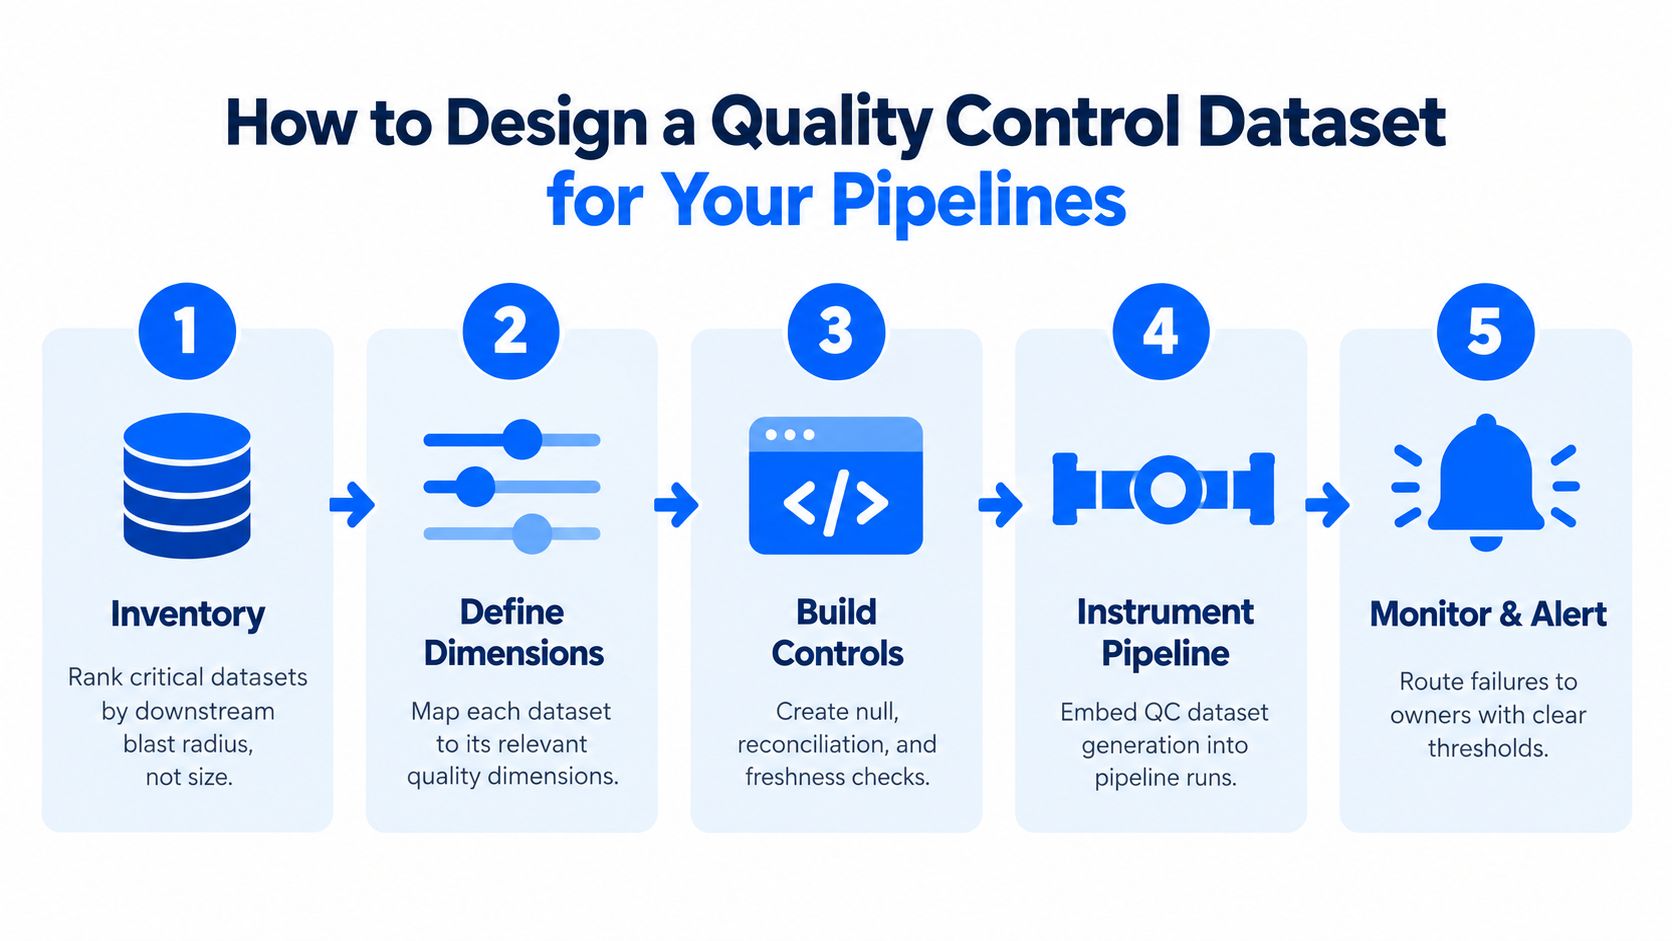
Zespoły zwykle projektują to od tyłu. Zaczynają od narzędzia, generują każdą kontrolę, jaka przyjdzie im do głowy, a potem toną w alertach. Lepsza kolejność zaczyna się od wpływu biznesowego.
Zacznij od promienia rażenia, nie od liczby zbiorów
Zinwentaryzuj krytyczne zbiory i uszereguj je według skutków niżej w łańcuchu, gdyby się zepsuły. Rozpoznawanie przychodów, sprawozdawczość regulacyjna, pulpity zarządu i cechy modeli używane w decyzjach produkcyjnych stoją wyżej niż tabele do analiz doraźnych.
Dla każdego poziomu określ, które wymiary liczą się najbardziej i co stanowi ostrzeżenie, a co naruszenie. Nie przypisuj każdemu zbiorowi tego samego standardu. Referencyjna tabela wymiarów może potrzebować ścisłej poprawności i okazjonalnego przeglądu ręcznego. Strumień zdarzeń klientów może potrzebować ciągłego monitorowania unikalności, schematu i Timeliness.
Dopasuj kontrolę do trybu awarii
Używaj różnych strategii walidacji dla różnych wymiarów.
Reguły deterministyczne sprawdzają się najlepiej przy zgodności ze schematem, dopuszczalności wartości pustych, dozwolonych zakresach i logice biznesowej.
Linie bazowe statystyczne lepiej pasują do wolumenu, zmian rozkładu, wahań kardynalności i nietypowych braków.
Przegląd anomalii pomaga, gdy zachowanie się zmienia, ale dokładnej reguły nie da się z góry w pełni określić.
Przechowuj reguły jako kod, gdy to możliwe. Reguła powinna być wersjonowana razem z logiką transformacji, którą chroni. Powiąż też każdą regułę z identyfikatorem zbioru, właścicielem i ścieżką eskalacji. Zawodząca kontrola bez właściciela staje się duchem na Slacku, którego wszyscy ignorują.
Zapisuj wyniki do samego zbioru QC
Zbiór kontroli jakości nie powinien tylko definiować kontroli. Powinien też przechowywać ich wyniki.
Zapisuj co najmniej:
Kontekst wykonania: identyfikator przebiegu potoku, nazwa zbioru, środowisko, znacznik czasu
Wynik kontroli: zaliczone, ostrzeżenie, niepowodzenie, pominięte
Dowód: wiersze naruszające, metryki zbiorcze, różnice dryfu albo różnicę schematu
Metadane operacyjne: właściciel, istotność, link do zgłoszenia, notatka o rozwiązaniu
Platforma może pomóc, jeśli pasuje do twojego środowiska. Na przykład podejście digna do walidacji danych i ciągłych kontroli jakości ustawia walidacje deterministyczne w jednej linii z bieżącym monitorowaniem, zamiast traktować je jak osobne programy.
Trzymaj nadzór przy eksploatacji
Zbiór kontroli jakości przetrwa rotację ludzi tylko wtedy, gdy ktoś go utrzymuje. Dodaj rytm przeglądów, kryteria wycofywania przestarzałych reguł i pętlę zwrotną po incydentach. Jeśli kontrola odpala bez przerwy bez wykonalnych wniosków, popraw ją albo usuń. Jeśli incydent się prześlizgnął, zapisz tę lekcję jako nową kontrolę albo linię bazową.
Nawyk eksploatującego: każdy istotny incydent danych powinien kończyć się jednym pytaniem: co zbiór kontroli jakości powinien zapamiętać, by następnym razem łatwiej to wychwycić?
Wybór właściwego podejścia do monitorowania dla każdego zbioru
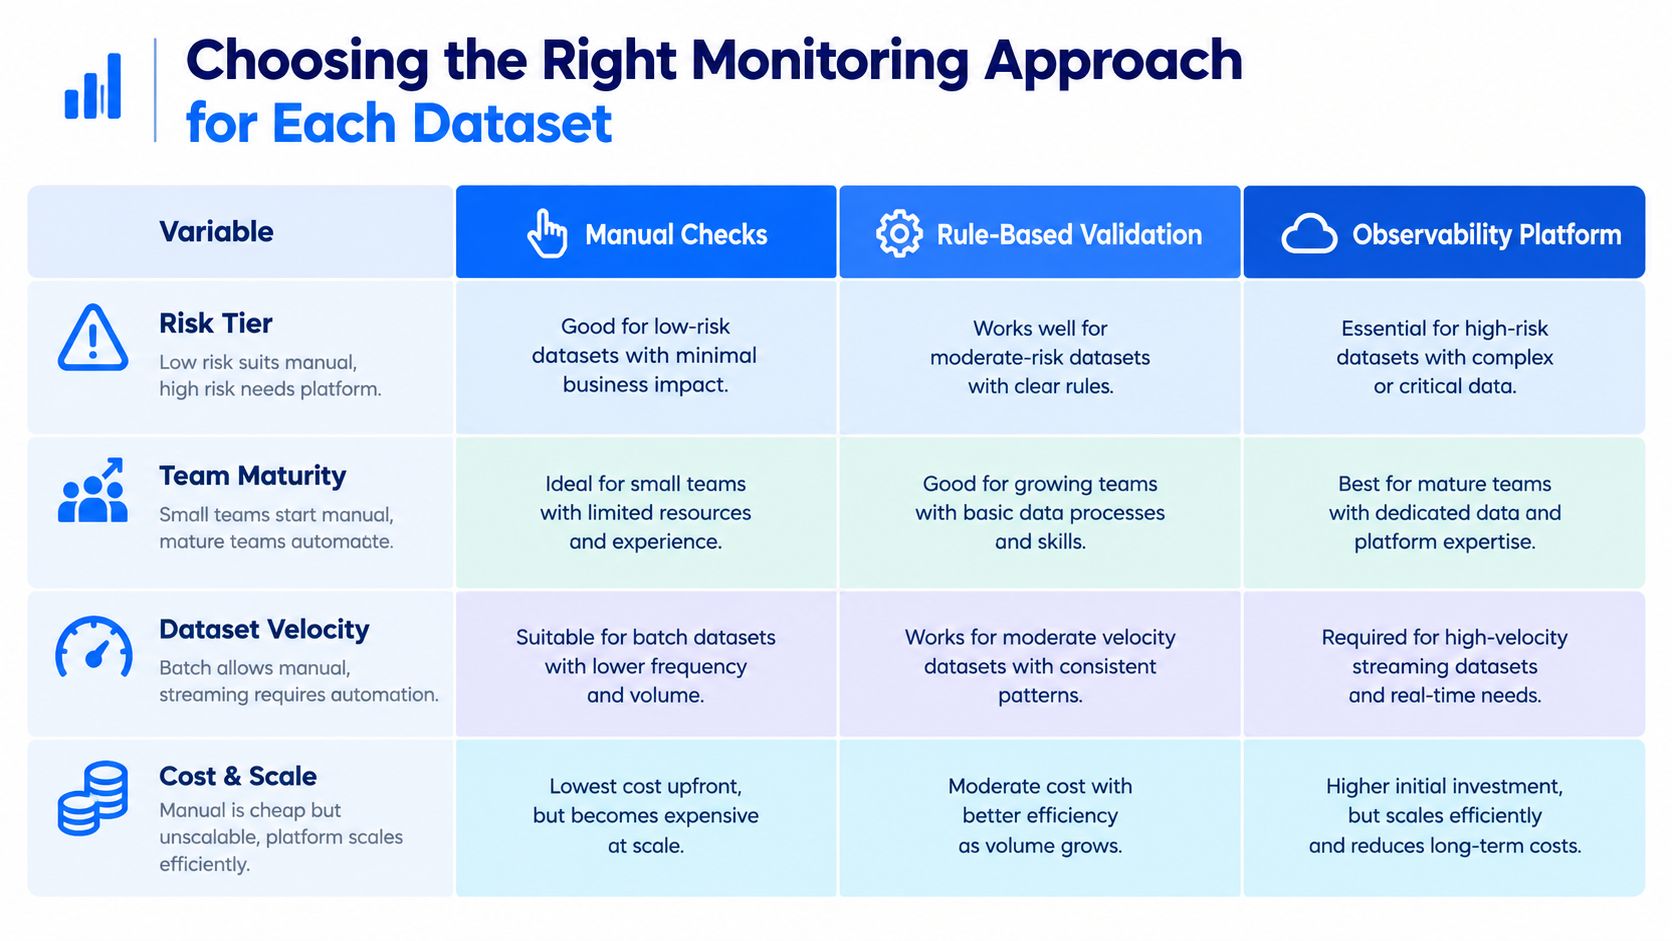
Strategia monitorowania nie jest drabiną dojrzałości. To decyzja triażowa. Właściwa odpowiedź zależy od ryzyka, tempa i kosztu awarii.
Niedawny raport branżowy wykazał, że 61% organizacji wciąż polega na kontrolach ręcznych lub walidacji w SQL, 27% używa dedykowanej platformy obserwowalności, a 31% wskazuje ograniczoną widoczność kondycji potoków jako największe wyzwanie, zgodnie z raportem trendów 2025 o jakości i obserwowalności danych od Integrate.io. Pokrywa się to z doświadczeniem wielu zespołów. Problemem zwykle nie jest to, czy QC ma znaczenie. Chodzi o to, gdzie automatyzacja się opłaca.
Kiedy które podejście pasuje
Kontrole ręczne wciąż mają sens przy danych referencyjnych o małym wolumenie, mapowaniach prawnych i procesach, gdzie ludzki osąd waży więcej niż szybkość. Załamują się, gdy dane zmieniają się często albo incydenty wymagają szybkiej reakcji.
Walidacja regułowa pokrywa dużą część ważnych potoków. Działa dobrze, gdy biznes potrafi zdefiniować jasne ograniczenia, a zespół inżynierski trzyma reguły blisko kodu transformacji.
Platformy obserwowalności zasługują na swoje miejsce w systemach szybkich, wieloźródłowych i o dużym promieniu rażenia. Tam potrzeba linii bazowych, monitorowania świeżości, śledzenia schematu, kontekstu pochodzenia i scentralizowanych alertów.
Sygnały eskalacji, na które warto patrzeć
Przesuń zbiór wyżej w stosie monitorowania, gdy zobaczysz wzorce takie jak te:
Rosnące fałszywe alarmy: progi są zbyt sztywne wobec bieżącego zachowania
Częste ręczne gaszenie pożarów: inżynierowie spędzają zbyt dużo czasu na badaniu powracających problemów
Skargi na nieświeże dane: interesariusze tracą zaufanie, bo zespół za późno wykrywa spóźnienia
Własność rozłożona na wiele zespołów: awarie przekraczają granicę producenta i odbiorcy i wymagają wspólnego kontekstu
Zespołom oceniającym opcje obserwowalności przyda się ten przegląd obserwowalności danych, bo ujmuje problem wokół widoczności operacyjnej, a nie ogólnego monitoringu.
Powszechne nieporozumienia podkopujące programy jakości danych
Większość słabych programów nie upada dlatego, że zespołom nie zależy. Upada, bo założenia operacyjne są błędne.
Założenia, które sprawiają kłopot
Nieporozumienie | Rzeczywistość operacyjna | Działanie naprawcze |
|---|---|---|
Więcej reguł zawsze poprawia jakość | Rozrost reguł tworzy szum i zasłania ważne awarie | Priorytetyzować kontrole według ryzyka i wykonalności |
Jednorazowa kuracja wystarczy | Zachowanie danych zmienia się wraz ze źródłami, schematami i użyciem | Przeglądać progi i linie bazowe według harmonogramu |
Obserwowalność zastępuje nadzór | Narzędzia ujawniają incydenty, ale nie przypisują odpowiedzialności | Określić właścicieli, istotność i ścieżki naprawy |
Zbiory QC są tylko dla ML | Analityka, finanse i potoki regulacyjne cierpią na te same wzorce awarii | Stosować model we wszystkich operacyjnych dziedzinach danych |
Jakość należy tylko do zespołu danych | Producenci i właściciele biznesowi definiują wiele krytycznych oczekiwań | Dzielić własność według zbioru i typu kontroli |
Dlaczego te przekonania się utrzymują
„Dodaj więcej reguł” brzmi bezpiecznie, bo wydaje się konkretne. W praktyce zbyt wiele kontroli o niskiej wartości grzebie tę garstkę, która chroni biznes. Zespoły przestają ufać alertom, a prawdziwe incydenty zlewają się z szumem tła.
„Jednorazowe sprzątanie” to kolejna pułapka. Sama ewolucja schematu sprawia, że statyczne kontrole niszczeją. W środowiskach operacyjnych śledzenie schematu musi być ciągłe. Dokumentacja digna opisuje na przykład ciągłe monitorowanie schematów tabel, kolumn i typów danych z porównaniami wobec wcześniejszych migawek oraz alertami przez pulpit, API, e-mail, Slacka lub webhooki. To właściwy model myślowy, nawet jeśli używasz innego narzędzia.
Co działa zamiast tego
Trwały wzorzec jest węższy i surowszy.
Wybierz mniej kontroli z jasnymi właścicielami.
Odświeżaj linie bazowe, gdy zmienia się zachowanie źródła.
Traktuj incydenty jako wsad do projektowania kontroli.
Trzymaj dowody w zbiorze QC, a nie zakopane w wątkach na czacie.
Program jakości staje się wiarygodny, gdy eksploatujący potrafią wskazać, które awarie mają znaczenie, kto reaguje i jak system uczy się z incydentu.
Złożenie wszystkiego w całość i kolejne kroki
Działający model operacyjny ma cztery warstwy. Zacznij od wymiarów jakości ważnych dla każdego zbioru. Podeprzyj te wymiary elementami strukturalnymi: regułami, liniami bazowymi, próbkami i historią audytową. Wybierz podejście do monitorowania odpowiadające ryzyku i tempu zmian zbioru. Potem domknij pętlę, zamieniając incydenty w aktualizacje progów, nowe reguły albo wycofane kontrole.
Brzmi ciężej, niż jest. W jednym sprincie zespół może zinwentaryzować krytyczne zbiory, uszeregować je według wpływu, określić dla każdego mały zestaw kontroli i skierować awarie do istniejących kanałów incydentów. Zacznij najpierw od kontroli deterministycznych. Dodaj linie bazowe statystyczne, gdy zespół będzie miał dość historii, by wiedzieć, jak wygląda normalne.

Pierwszy ruch nie musi być ambitny. Wybierz w tym tygodniu trzy zbiory. Dla każdego zapisz właściciela, oczekiwanie kompletności i próg świeżości. Obecny kierunek amerykańskiej federalnej społeczności danych jest tu użytecznym sygnałem: raport American Statistical Association z 2025 roku dowodzi, że agencje powinny udostępniać łatwo dostępne metryki jakości, zachowywać dane historyczne i metadane oraz ujednolicać cytowania i identyfikatory, jak opisuje raport The Nation's Data at Risk 2025. To ta sama dyscyplina operacyjna, której potrzebują mocne zespoły danych w sektorze prywatnym.
Zespoły, które poprawiają się najszybciej, nie próbują monitorować wszystkiego naraz. Czynią mierzalnym jeden krytyczny zbiór, a potem powtarzają wzorzec.
digna daje zespołom sposób na prowadzenie jakości i obserwowalności danych we własnym środowisku, z wykonaniem w bazie, tak że monitorujący SQL działa w hurtowni, a w warstwie obserwowalności przechowywane są jedynie wyniki i metadane, jak opisują praktyki potoków danych digna. Jeśli budujesz zbiór kontroli jakości i potrzebujesz śledzenia schematu, monitorowania Timeliness, walidacji i wykrywania anomalii bez przenoszenia wrażliwych danych produkcyjnych, odwiedź digna.
Zbiór QC zapisuje, co znalazły twoje kontrole; obserwowalność platformy danych pilnuje, by te kontrole nadal działały i by zauważono, gdy przestaną.
Najczęściej zadawane pytania
Czym jest zbiór danych kontroli jakości?
Żywym zbiorem, który zapisuje wyniki twoich kontroli jakości, stojącym obok potoków, które obserwuje, a nie wewnątrz nich. Musi pozostać żywy, bo nieświeży zapis QC opisuje system, który już nie istnieje, a to gorzej niż brak jakiegokolwiek.
Jakie są jego podstawowe elementy?
Pięć: same kontrole, wyniki, które generują, historia schematu, zapis świeżości i metadane nadzoru wiążące każdą kontrolę z właścicielem. Usuń jeden, a reszta słabnie — wyniki bez historii schematu nie wyjaśnią na przykład, dlaczego kontrola zaczęła zawodzić.
Które wymiary jakości powinien monitorować?
Sześć wymiarów odpowiada sześciu różnym trybom awarii, a Timeliness jest tym, który potrzebuje prawdziwego progu zamiast mglistego poczucia „niedawno”. Dopływ danych technicznie obecny, ale cztery godziny po swoim oknie decyzyjnym, już zawiódł, nawet jeśli każda wartość w nim jest poprawna.
Jak zdecydować, które zbiory objąć?
Zacznij od promienia rażenia, nie od liczby zbiorów. Tabela zasilająca sprawozdawczość regulacyjną albo liczbę widzianą przez klienta zasługuje na kontrole wcześniej niż tabela, której nikt nie odpytuje, choćby była największa. Potem dopasuj kontrolę do trybu awarii, zamiast stosować wszędzie te same generyczne sprawdzenia.
Jakie nieporozumienia podkopują te programy?
Przekonanie, że pomyślnie zakończony potok oznacza poprawne dane, oraz że więcej kontroli równa się większemu pokryciu. Przykład otwierający to pokazuje: transformacja po cichu odrzuciła wiersze z pustym customer_id, a wszystkie agregaty niżej w łańcuchu szły dalej, jakby nic się nie stało.



