Pozyskiwanie danych w Apache Kafka: Praktyczny przewodnik wdrożeniowy
|
6
min. czyt.

O godzinie 3:00 w nocy alert zazwyczaj nie mówi: „Twoja architektura pozyskiwania danych jest błędna”. Informuje o rosnącym opóźnieniu konsumenta, ponawianiu zadania ujścia (sink task) lub o tym, że tabela podrzędna przestała się odświeżać. Zanim ktoś prześledzi problem od producenta, przez system Kafka, aż do jeziora danych (lakehouse), pierwotna awaria może już zostać pogrzebana pod rebalansami, ponownymi próbami, niezgodnościami schematów i zduplikowanymi rekordami.
Dlatego pozyskiwanie danych Apache Kafka musi być zaprojektowane jako pełny cykl życia. Kafka może zapewnić trwały szkielet zdarzeń o wysokiej przepustowości, ale niezawodność produkcyjna zależy od tego, co dzieje się przed dotarciem rekordów do brokera oraz po ich odczytaniu przez konsumentów. Projektowanie tematów (topics), partycjonowanie, semantyka dostarczania, wymuszanie schematów, zachowanie ujścia oraz Observability – wszystko to decyduje o tym, czy rurociąg zachowa poprawność pod obciążeniem.
Spis treści
Prawdziwe wyzwanie stojące za pozyskiwaniem danych z systemu Kafka
Każda wczesna decyzja generuje pracę na dalszych etapach
Niezawodność obejmuje również ogon dystrybucji
Kluczowe wzorce architektury dla rurociągów pozyskiwania danych
Bezpośredni producent do brokera
Brama lub proxy REST
Kafka Connect do integracji ze źródłami i ujściami
Strumieniowe ETL z Kafka Streams lub Flink
Budowanie producentów i konsumentów, którzy naprawdę działają
Konfiguracja producenta powinna wyrażać kontrakt
Konfiguracja konsumenta chroni postęp przetwarzania
Obsługa schematów i strategie odzyskiwania po awarii
Ewolucja schematu wymaga wymuszonej granicy
Rozdzielenie błędów odwracalnych od ostatecznych
Semantyka dostarczania a obciążenie pracą
Dostrajanie partycji i grupowania w celu zwiększenia przepustowości
Przeprowadź testy porównawcze przed zmianą topologii produkcyjnej
Dostrajaj pod kątem obciążenia, a nie listy kontrolnej
Problem na dalszych etapach, o którym nikt nie mówi
Stan zdrowia brokera może maskować awarię ujścia
Zarządzanie (governance) powinno odbywać się na warstwie udostępniania
Nawyki operacyjne i lista kontrolna przed wdrożeniem
Nawyki, które zapobiegają nocnym wezwaniom
Tydzień przed wdrożeniem
Prawdziwe wyzwanie stojące za pozyskiwaniem danych z systemu Kafka
Pierwsza poważna awaria produkcyjna, jaką widziałem w rurociągu płatniczym, wcale nie zaczęła się od przestoju brokera. Wdrożenie ewolucji schematu wywołało rebalans konsumentów w najmniej odpowiednim momencie. Jeden z konsumentów przestał robić użyteczne postępy, zaległości rosły, a ujście do podrzędnego jeziora danych zaczęło zapisywać zduplikowane wiersze, ponieważ logika odzyskiwania ponawiała pracę, która trafiła już do magazynu danych.
Broker był sprawny. Wskaźniki błędów producenta wyglądały normalnie. Incydent i tak skończył się wezwaniem o 3:00 rano, ponieważ zespół potraktował pozyskiwanie danych jako zwykłe połączenie między aplikacją a systemem Kafka, zamiast jako łańcuch stanowych kontraktów. Praktyczna definicja pozyskiwania danych jest szersza niż sam transport, co jasno wyjaśnia data ingestion meaning guide. Rekordy muszą docierać, pozostawać zrozumiałe, być przetwarzane w akceptowalnym oknie czasowym i trafiać do miejsca docelowego bez utraty jakości.
Każda wczesna decyzja generuje pracę na dalszych etapach
Klucz partycjonowania tematu decyduje o kolejności i dystrybucji obciążenia. Liczba partycji ogranicza współbieżność konsumentów i wpływa na rebalansowanie. Potwierdzenia producenta i idempotencja wpływają na zachowanie duplikatów. Rozmiar grupy konsumentów wpływa na czas odzyskiwania sprawności, podczas gdy model zatwierdzania (commit) i ponawiania ujścia decyduje o tym, czy dostarczanie typu „co najmniej raz” (at-least-once) objawi się w postaci zduplikowanych wierszy.
Wybory te tworzą również zależności poza systemem Kafka:
Układ tematów: Współdzielone tematy wymagają jasnego określenia własności, nazewnictwa, retencji oraz reguł schematów.
Klucz partycjonowania: Źle dobrany klucz tworzy przeciążone partycje (hot partitions) lub niszczy gwarancję kolejności, od której zależy proces biznesowy.
Semantyka dostarczania: Zdarzenie księgowe i jednorazowa telemetria nie powinny mieć takiego samego kontraktu przetwarzania.
Skalowanie konsumentów: Dodawanie konsumentów powyżej liczby dostępnych partycji nie zwiększa użytecznej współbieżności.
Zapisy do jeziora danych (lakehouse): Ciągłe strumienie mogą tworzyć wiele małych plików, co zwiększa nakład pracy związany z kompaktowaniem i obniża wydajność zapytań – jest to kompromis omówiony w guidance on delivering Kafka data to Iceberg streaming tables.
Zasada praktyczna: Rurociąg Kafka nie jest sprawny tylko dlatego, że producenci otrzymują potwierdzenia. Jest sprawny wtedy, gdy dane na dalszych etapach pozostają kompletne, terminowe (Timeliness), poprawnie ustrukturyzowane i możliwe do odzyskania.
Niezawodność obejmuje również ogon dystrybucji
W finansach i opiece zdrowotnej rekord, który dociera z opóźnieniem lub ze zmienionym polem, może być tak samo szkodliwy jak rekord utracony. Zdarzenie płatnicze może zostać dostarczone, ale zduplikowane. Zdarzenie kliniczne może zostać dostarczone, ale nie przejść walidacji po zmianie schematu. Operacyjny kanał danych może wykazywać niskie opóźnienie brokera, podczas gdy w jego ujściu gromadzą się niezatwierdzone pliki.
Poniższe sekcje skupiają się na tych właśnie trybach awarii. Celem nie jest jedynie przesłanie bajtów do systemu Kafka. Chodzi o to, aby zapobiec kolejnemu nocnemu wezwaniu poprzez zaprojektowanie całej ścieżki – od zachowania źródła i przypisywania partycji, po ład schematów (schema governance), zatwierdzenia ujścia i dowody, których operatorzy potrzebują podczas odzyskiwania sprawności.
Kluczowe wzorce architektury dla rurociągów pozyskiwania danych
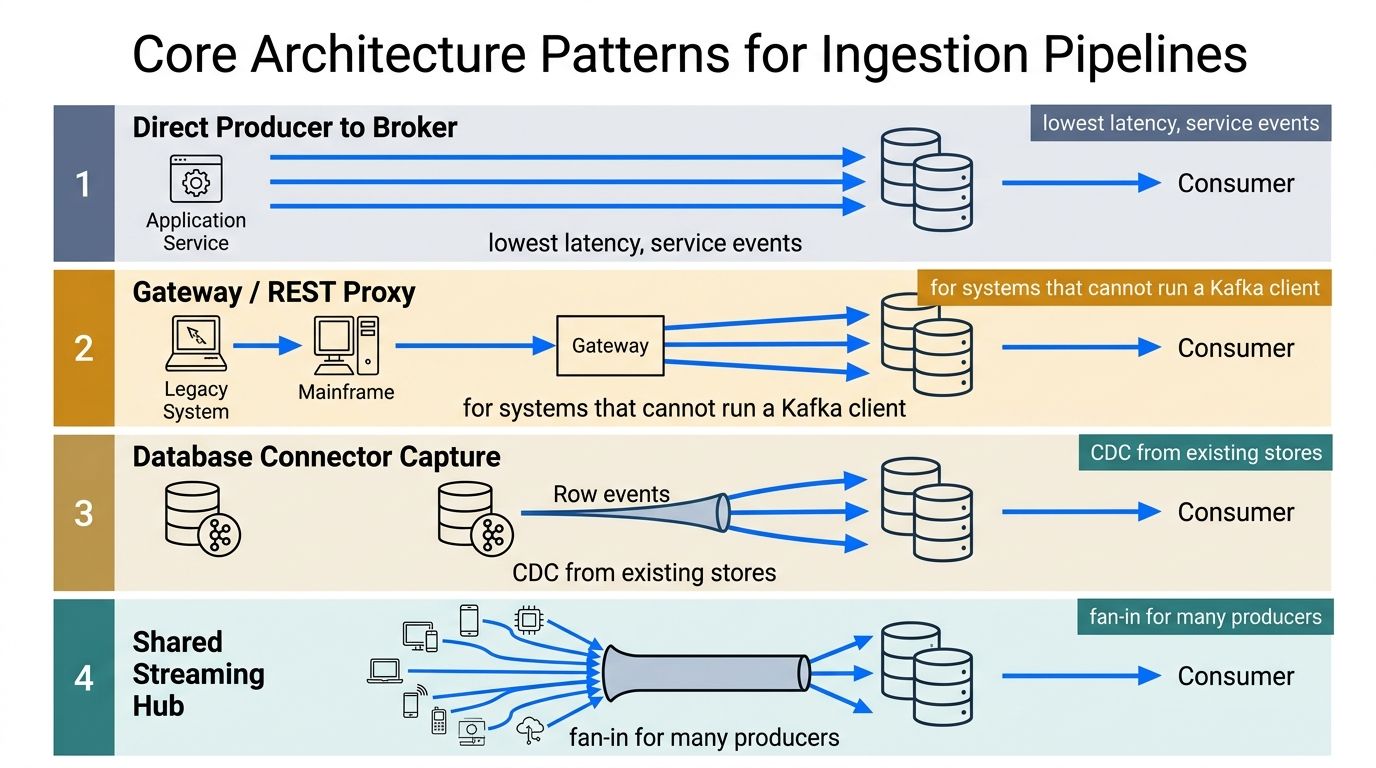
Wybierz topologię zgodnie z możliwościami źródła i kontraktem na dalszych etapach. Usługa, która natywnie obsługuje protokół Kafka, nie powinna być zmuszana do korzystania z bramy HTTP, podczas gdy starszy system mainframe nie powinien otrzymać projektu integracji z klientem Kafka, którego nie jest w stanie obsłużyć.
Bezpośredni producent do brokera
Usługa napisana w języku Java, Go lub Python może publikować bezpośrednio w systemie Kafka przy użyciu natywnego klienta. Jest to odpowiednie rozwiązanie dla zdarzeń usługowych, aktywności aplikacji, zmian stanu płatności i telemetrii, gdzie producent kontroluje klucze komunikatów, grupowanie (batching), ponowne próby i serializację schematów.
Zaletą są niskie opóźnienia i precyzyjna kontrola. Kosztem jest powiązanie komponentów (coupling). Każdy zespół tworzący producenta musi rozumieć wywołania zwrotne dostarczania (delivery callbacks), zachowanie klucza partycji, uwierzytelnianie, kompatybilność schematów i mechanizmy backpressure. Bezpośredni producent może również natychmiast ujawnić złe projektowanie klucza, co jest przydatne podczas testów, ale bolesne, jeśli temat obsługuje już ruch produkcyjny.
Brama lub proxy REST
Brama (gateway) zapewnia prostszy interfejs HTTP dla systemów, które nie mogą uruchomić klienta Kafka. Starsze aplikacje, systemy typu mainframe, integracje z partnerami i małe narzędzia pomocnicze mogą przesyłać rekordy bez konieczności zarządzania szczegółami protokołu Kafka.
Brama centralizuje uwierzytelnianie, walidację i ograniczanie przepustowości (rate limiting), ale może maskować błędy związane z kluczem partycjonowania. Jeśli brama sama przypisuje klucze lub domyślnie stosuje nieodpowiednią strategię dystrybucji, zespół źródłowy może nie zauważyć, że powiązane zdarzenia trafiają do partycji w sposób nierównomierny. Dodaje to również kolejną granicę awarii, więc operatorzy potrzebują metryk dla żądań zaakceptowanych, odrzuconych, zakolejkowanych rekordów, potwierdzeń brokera oraz dostarczania na dalsze etapy.
Kafka Connect do integracji ze źródłami i ujściami
Kafka Connect jest praktycznym rozwiązaniem do przechwytywania zmian w bazach danych (CDC), systemów SaaS, plików oraz dostarczania danych do hurtowni lub jezior danych. Konektory źródłowe mogą publikować zmiany w systemie Kafka, podczas gdy konektory ujścia mogą przenosić rekordy do systemów zewnętrznych bez potrzeby tworzenia dedykowanej aplikacji konsumenckiej.
Model offsetów w Connect upraszcza restart i odzyskiwanie sprawności, ponieważ zadania konektora zapisują swój postęp. Ta wygoda nie zapewnia automatycznie zachowania typu
✦ Generated with Artifical Intelligence



Poznaj zespół tworzący platformę
Zespół z Wiednia, składający się z ekspertów od AI, danych i oprogramowania, wspierany rygorem akademickim i doświadczeniem korporacyjnym.