Czym jest zarządzanie jakością danych w ochronie zdrowia
|
8
min. czyt.

Lekarz otwiera dashboard przed poranną odprawą i widzi uspokajający trend. Najnowszy wynik laboratoryjny wygląda prawidłowo, ale strumień danych dotarł już po zamknięciu okna raportowego. W innym miejscu kod rozpoznania jest sprzeczny z historią pacjenta, ponieważ system źródłowy zmapował wartość inaczej podczas wymiany danych. Rekord istnieje, a mimo to nie nadaje się do podjęcia decyzji, której dotyczy.
Tak w praktyce wygląda zarządzanie jakością danych w ochronie zdrowia. To ciągła dyscyplina sprawdzania, czy dane kliniczne, operacyjne, dotyczące zdrowia publicznego, badawcze i regulacyjne są kompletne, dokładne, spójne, znaczące i dostępne wtedy, gdy są potrzebne. Obejmuje ona kontrole w miejscu zbierania danych, walidację wymiany, wykrywanie anomalii, naprawę błędów, lineage oraz governance.
Spis treści
Wysoka stawka integralności danych klinicznych
Gdzie błędy stają się widoczne
Kluczowe wymiary jakości danych w ochronie zdrowia
Cztery pytania do tego samego zbioru danych
Od wymiarów do kontroli
Typowe pułapki walidacji danych medycznych
Trzy rodzaje błędów, które trzeba rozróżniać
Dlaczego zagregowane wskaźniki ukrywają ryzyko
Od statycznych audytów do ciągłej obserwowalności
Kontrole audytowe a obserwowalność
Co powinien wykrywać ciągły monitoring
Interoperacyjność i zgodność z regulacjami
Zgodność strukturalna to nie zgodność semantyczna
Czyste dane wciąż mogą prowadzić do niebezpiecznej AI
Wdrażanie skalowalnego frameworku jakości danych
Warstwowa budowa systemu kontroli
Mniej przenoszenia danych i mniej szumu alertów
Strategie danych medycznych odporne na przyszłość
Wysoka stawka integralności danych klinicznych
Spóźniony wynik może być równie szkodliwy jak błędny. Jeśli hurtownia danych klinicznych otrzyma wartość laboratoryjną po tym, jak zespół opieki ocenił już stan pacjenta, dane mogą być technicznie poprawne, ale operacyjnie niebezpieczne. To samo dotyczy brakującej informacji o alergii, zdublowanej tożsamości pacjenta, nieaktualnej listy leków czy rozpoznania, którego znaczenie zmieniło się między systemami.
Zespoły medyczne podejmują decyzje za pośrednictwem połączonych systemów. Elektroniczna dokumentacja medyczna, systemy laboratoryjne, systemy obrazowania, rejestry, środowiska rozliczeń i hurtownie raportowe dostarczają po fragmencie historii pacjenta. Gdy zawiedzie jeden element, personel może powtarzać badania, ręcznie uzgadniać rekordy, opóźniać raportowanie lub działać na podstawie niepełnego obrazu.
Skala wymiany danych sprawia, że dostępność jest wymogiem jakości, a nie udogodnieniem. W 2021 roku 88% szpitali w USA elektronicznie wysyłało lub pozyskiwało informacje o zdrowiu pacjentów poprzez zapytania lub elektroniczne otrzymywanie podsumowań opieki, według raportu o interoperacyjności Office of the National Coordinator for Health IT. Dane, których nie da się odnaleźć, zinterpretować ani wykorzystać w miejscu udzielania opieki, nie spełniają swojego celu, nawet jeśli nadal są gdzieś przechowywane.
Gdzie błędy stają się widoczne
Niska jakość danych tworzy kilka rodzajów ryzyka operacyjnego:
Ryzyko kliniczne: brakujące lub sprzeczne informacje mogą zniekształcić diagnozę, uzgadnianie leków i decyzje terapeutyczne.
Ryzyko raportowe: niekompletne zdarzenia lub niestabilne mianowniki mogą sprawić, że wskaźniki jakości wyglądają lepiej lub gorzej niż w rzeczywistości.
Ryzyko badawcze: niespójne kodowanie i pochodzenie danych osłabiają powtarzalność i utrudniają obronę definicji kohort.
Ryzyko zgodności: zespoły mogą nie być w stanie wykazać, które rekordy zostały sprawdzone, która reguła zawiodła i jak przebiegła naprawa.
Ryzyko utraty zaufania: lekarze i analitycy przestają polegać na dashboardach, gdy wielokrotnie natrafiają na rozbieżności.
Okresowy projekt porządkowania danych nie rozwiązuje tych problemów. Zanim audyt wykryje opóźniony interfejs, uszkodzone mapowanie lub brakujące ładowanie danych z placówki, dalsze raporty i modele mogą już te dane wykorzystać. Praktyczne pytanie nie brzmi, czy organizacja ma błędy. Ma je każde złożone środowisko ochrony zdrowia. Pytanie brzmi, czy potrafi wcześnie wykryć istotne awarie, ustalić ich przyczynę i zachować dowody reakcji.
Aby zobaczyć, jak takie błędy wpływają na opiekę, przeczytaj o pięciu poważnych incydentach spowodowanych niską jakością danych w ochronie zdrowia. Główny wniosek jest prosty: integralność danych jest częścią bezpieczeństwa klinicznego i kontroli operacyjnej, a nie odizolowanym problemem z backlogu zespołu data engineering.
Kluczowe wymiary jakości danych w ochronie zdrowia
Framework Data Quality Review Światowej Organizacji Zdrowia (WHO) stanowi dla zespołów medycznych użyteczny punkt wyjścia. Definiuje jakość poprzez kompletność, spójność wewnętrzną, porównanie zewnętrzne oraz zewnętrzną spójność danych populacyjnych, zgodnie z opisem w wytycznych WHO dotyczących frameworku i metryk.
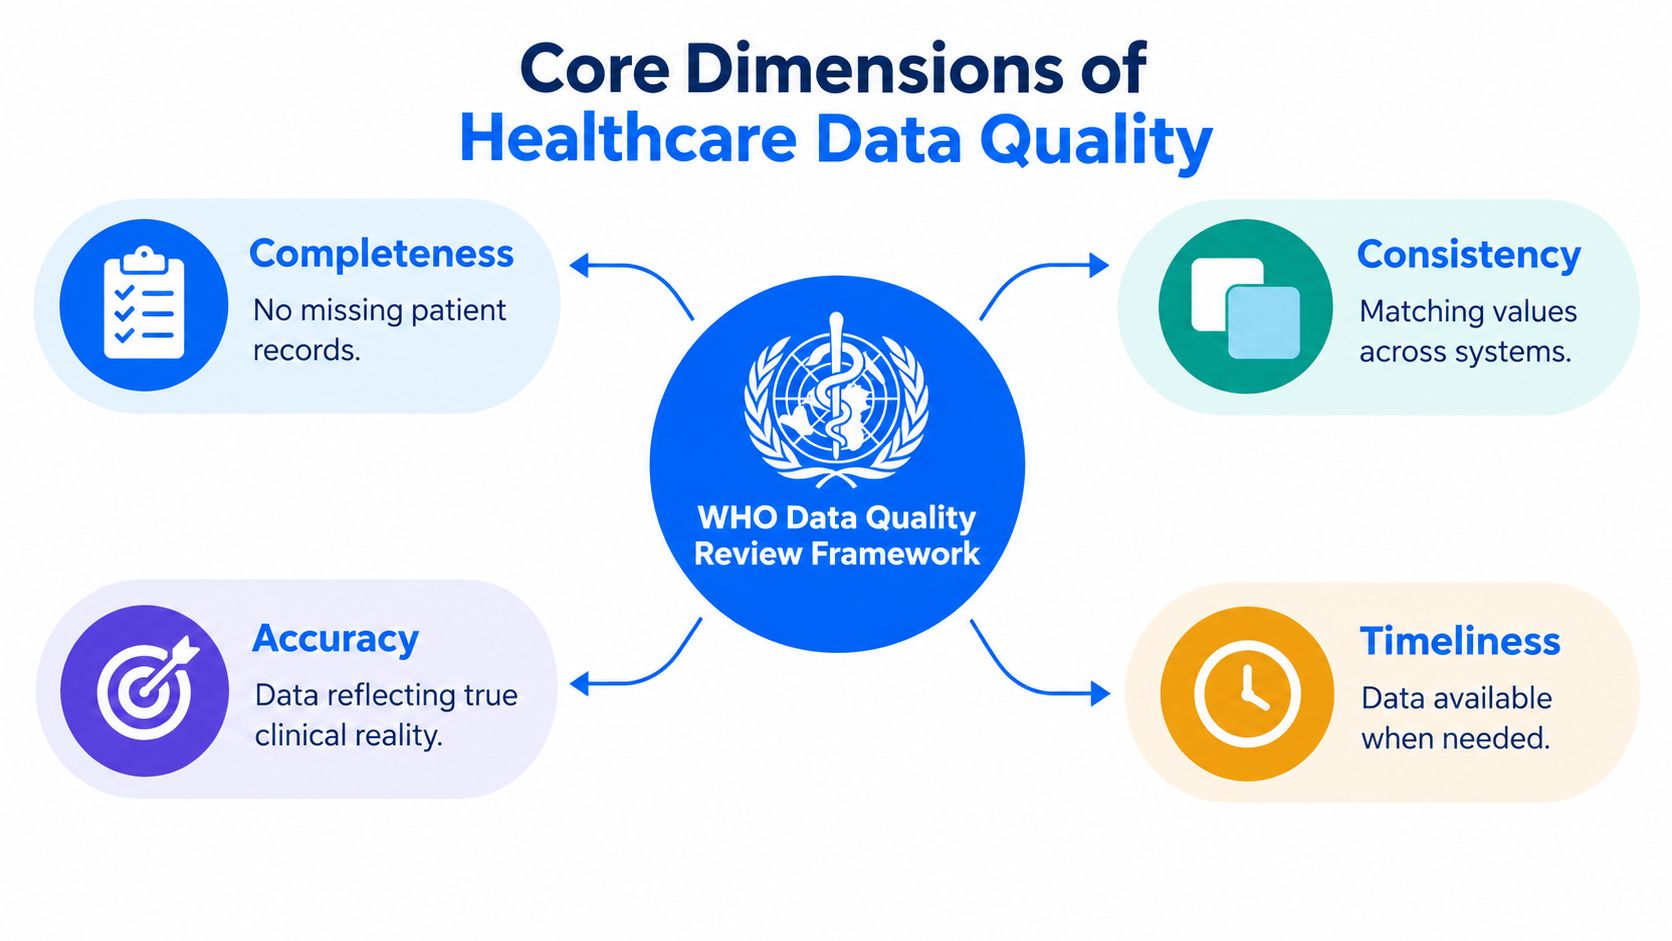
Wymiary te tworzą słownik do oceny, czy dane nadają się do określonego zastosowania. Nie powinny jednak stać się listą kontrolną oderwaną od kontekstu procesów.
Cztery pytania do tego samego zbioru danych
Kompletność dotyczy tego, czy wymagane rekordy, pola, zdarzenia i jednostki sprawozdawcze są obecne. Placówka może przesyłać wizyty, ale pomijać zdarzenia wypisu, albo uzupełniać dane demograficzne, pozostawiając puste pola istotne klinicznie. Kompletność obejmuje też sposób dostarczania danych. Kompletny plik, który dotrze po terminie raportowym, może być do tego celu bezużyteczny.
Spójność wewnętrzna dotyczy tego, czy powiązane wartości są ze sobą zgodne. Daty powinny następować w prawidłowej kolejności, powiązane rekordy powinny odwoływać się do istniejących encji, a wartości powinny spełniać reguły kliniczne lub biznesowe. Wiek pacjenta, data wizyty, rozpoznanie i historia procedur mogą osobno wyglądać poprawnie, a razem tworzyć niemożliwą kombinację.
Porównanie zewnętrzne zestawia sumy z niezależnym źródłem. Aktywność placówki można porównać z rejestrem, aplikacją źródłową, systemem laboratoryjnym lub rejestrem sprawozdawczym. Pomaga to wykryć systematyczne zaniżanie danych, które kontrole na poziomie rekordu mogą przeoczyć.
Zewnętrzna spójność danych populacyjnych sprawdza, czy mianowniki i szacunki populacji nadają raportowanym wskaźnikom sens. Wskaźnik szczepień, wskaźnik przyjęć czy wskaźnik chorobowości może być poprawnie obliczony, a mimo to wprowadzać decydentów w błąd, jeśli bazowy szacunek populacji jest nieaktualny lub niedopasowany.
Framework wspiera także praktyczne oczekiwania dotyczące dokładności, wiarygodności i aktualności. Dokładność określa, jak wiernie wartość odzwierciedla faktycznie udzielone świadczenia lub rzeczywistość kliniczną. Wiarygodność określa, czy powtarzane pomiary pozostają stabilne i godne zaufania. Aktualność określa, czy informacja jest dostępna w oknie czasowym wymaganym przez dane zastosowanie.
Od wymiarów do kontroli
Program jakości powinien definiować progi dla poszczególnych zbiorów danych i procesów, zamiast publikować jeden wynik dla całej organizacji. Przydatne kontrole to:
Kontrole pól wymaganych i pokrycia zdarzeń.
Walidacja zakresów, słowników kodów i reguł warunkowych.
Uzgadnianie sum i identyfikatorów między systemami.
Monitorowanie opóźnionych, brakujących lub nietypowo małych ładowań.
Dokumentowanie wyjątków, odpowiedzialności, działań naprawczych i dowodów.
Wymiary jakości danych mają znaczenie, ponieważ zbiór danych może być kompletny, ale niedokładny, spójny, ale nieaktualny, albo strukturalnie poprawny, ale semantycznie mylący. Zarządzanie jakością zaczyna się wtedy, gdy zespoły łączą każdy wymiar z decyzją, którą dane mają wspierać.
Typowe pułapki walidacji danych medycznych
Najczęstszym błędem walidacji jest traktowanie wypełnionych pól jako dowodu jakości. Wartość może być obecna, mieć poprawny typ, a mimo to być błędna dla danego pacjenta, danego epizodu opieki lub mieć inne znaczenie po wymianie danych. Zespoły medyczne potrzebują osobnych kontroli dla kompletności, dokładności, poprawności, spójności, unikalności i aktualności.
To rozróżnienie ma charakter operacyjny. Metodologia jakości dla zakażeń związanych z opieką zdrowotną rządu Wielkiej Brytanii definiuje dokładność jako zbliżenie do rzeczywistości, kompletność jako obecność oczekiwanych rekordów i niezbędnych wartości, a aktualność jako bieżącość i dostępność dla okresu, którego dane dotyczą. Podkreśla też kluczową kwestię: kompletność nie oznacza dokładności.
Trzy rodzaje błędów, które trzeba rozróżniać
Brakujące dane: oczekiwana wizyta, obserwacja, mianownik lub wymagane pole nigdy nie dociera. Reakcją jest zbadanie zbierania danych, dostarczania przez interfejs i procesu ładowania.
Błędne dane: rekord dociera, ale jego wartość jest sprzeczna z wiarygodnym źródłem, zakresem lub regułą kliniczną. Reakcja wymaga porównania, walidacji i korekty.
Dane spóźnione lub nieaktualne: wartość jest poprawna, ale niedostępna wtedy, gdy proces jej potrzebuje. Reakcja wymaga bazowych wzorców dostaw i monitorowania aktualności.
Czwarta kategoria zasługuje na równie dużą uwagę: błąd semantyczny. Dwa systemy mogą wymieniać składniowo poprawny kod, przypisując mu różne znaczenia. Transformacja może zachować format, ale utracić kontekst, jednostki, pochodzenie lub powiązanie z innym zasobem.
Dlaczego zagregowane wskaźniki ukrywają ryzyko
Wieloośrodkowe badanie z 2025 roku obejmujące 19 szpitali wykazało, że 17,7% zidentyfikowanych problemów z jakością danych miało duży wpływ, obejmując co najmniej połowę odpowiednich rekordów, a niepełne badanie przyczyn błędów prowadziło do przeoczenia krytycznych wad systemowych, jak opisano w badaniu opublikowanym w Journal of the American Medical Informatics Association. Badanie zidentyfikowało błędy przy ręcznym przenoszeniu danych z dokumentacji, różnice między systemami źródłowymi oraz błędy ekstrakcji, co pokazuje, dlaczego zespoły muszą badać przyczyny, zamiast zatrzymywać się na procencie dokładności.
Przydatna sekwencja walidacji wygląda tak:
Walidacja struktury: sprawdzenie typów danych, wymaganych elementów, dozwolonych wartości i integralności referencyjnej.
Walidacja znaczenia: stosowanie reguł klinicznych, operacyjnych i międzypolowych.
Walidacja dostarczania: porównanie czasu dotarcia, wolumenu, odsetka wartości null i rozkładów z oczekiwanym zachowaniem.
Walidacja wpływu: identyfikacja dotkniętych raportów, miar, modeli, placówek i grup pacjentów.
Rejestrowanie naprawy: zachowanie reguły, źródła, znacznika czasu, liczby dotkniętych rekordów, właściciela i statusu.
Takie podejście traktuje walidację jako system kontroli, a nie jednorazowe czyszczenie danych. Walidacja danych medycznych na dużą skalę powinna pomagać zespołom zlokalizować warstwę, w której występuje błąd, i nadać priorytet defektom, które mogą zmienić wynik kliniczny lub regulacyjny.
Od statycznych audytów do ciągłej obserwowalności
Okresowe audyty wciąż mają swoją rolę. Zapewniają niezależną weryfikację, testują governance i sprawdzają, czy kontrole działają zgodnie z założeniami. Nie wystarczają jednak jako główny mechanizm wykrywania problemów w szybko zmieniających się danych klinicznych.
Przegląd elektronicznych dokumentów klinicznych wykazał, że 86,3% badanych dokumentów zawierało błędy, średnio 4,9 błędu na dokument, zgodnie z recenzowanym przeglądem elektronicznych dokumentów klinicznych. Ten sam przegląd oddzielił alerty dotyczące kompletności od alertów składniowych, co pokazuje, dlaczego plik, który dotarł bez problemów, wciąż może zawierać defekty utrudniające dalsze wykorzystanie.
Kontrole audytowe a obserwowalność
Model działania | Mocne strony | Słabe strony |
|---|---|---|
Okresowy audyt ręczny | Zapewnia głębię przeglądu i dowody dla governance | Wykrywa błędy po tym, jak dane już się rozprzestrzeniły |
Stała biblioteka reguł | Egzekwuje jawne wymagania biznesowe i kliniczne | Wymaga utrzymania i może generować szum alertów |
Ciągła obserwowalność | Wykrywa zmiany zachowania, brakujące ładowania i dryf dostaw | Wymaga projektu wzorców bazowych, właścicieli i rozsądnej eskalacji |
Analiza przez człowieka | Interpretuje kontekst i potwierdza przyczynę źródłową | Nie skaluje się jako pierwszy filtr dla każdego rekordu |
Rozbudowany, ręcznie tworzony zestaw reguł może wyglądać rygorystycznie, a jednocześnie stawać się trudny w utrzymaniu. Zespoły mogą ignorować alerty, gdy progi są kruche, duplikaty częste, a każda drobna zmiana rozkładu otrzymuje ten sam priorytet. Z kolei system bez reguł deterministycznych może wykrywać nietypowe zachowanie, nie rozumiejąc, czy zmiana narusza wymaganie kliniczne.
Praktyczny model łączy oba podejścia. Walidacja deterministyczna obsługuje znane ograniczenia, takie jak pola wymagane, poprawne kody, relacje referencyjne i warunkowa logika kliniczna. Monitorowanie behawioralne uczy się oczekiwanych wzorców wolumenów rekordów, odsetka wartości null, czasów dostaw, rozkładów wartości i aktywności, a następnie sygnalizuje odchylenia wymagające analizy.
Co powinien wykrywać ciągły monitoring
Użyteczna warstwa obserwowalności potrafi wykryć:
Brakujące ładowanie z placówki lub nieoczekiwany spadek liczby rekordów.
Zmianę schematu, która dodaje, usuwa lub modyfikuje kolumnę.
Nagłe przesunięcie w rozkładach kodów lub odsetku wartości null.
Strumień danych docierający później niż wynika z wyuczonego wzorca dostaw.
Metrykę biznesową wychodzącą poza swój normalny zakres.
Powtarzający się błąd walidacji skoncentrowany w jednym źródle lub interfejsie.
Wartością nie jest sam alert. Wartością jest kontekst: który zbiór danych się zmienił, kiedy, które źródło go wytworzyło, ile rekordów zostało dotkniętych i które produkty zależą od niego. Obserwowalność jakości danych wyraża to przejście od reaktywnego porządkowania do ciągłego monitorowania niezawodności.
Interoperacyjność i zgodność z regulacjami
Interoperacyjność często sprowadza się do tego, czy systemy potrafią wymieniać komunikaty. To zbyt słaba definicja dla pracy klinicznej. System odbierający musi umieć sparsować, zinterpretować, powiązać i wykorzystać informacje w wymaganym oknie czasowym.
United States Core Data for Interoperability, czyli USCDI, definiuje podstawowe klasy i elementy danych, które muszą obsługiwać certyfikowane systemy IT w ochronie zdrowia. Do odpowiednich specyfikacji należą HL7 FHIR US Core oraz Consolidated Clinical Document Architecture. Wymagania HL7 Patient Information Quality Improvement opisują również mechanizmy oceny danych ustrukturyzowanych, w tym pola wymagane, powiązania terminologiczne, strukturę dokumentów i relacje między wymienianymi zasobami.
Zgodność strukturalna to nie zgodność semantyczna
Walidacja FHIR może sprawdzać typy danych, liczności, wyrażenia, terminologię i referencje. Te kontrole są niezbędne, ale nie gwarantują, że dwie organizacje używają danego pojęcia w tym samym kontekście operacyjnym. Rozbieżności semantyczne między standardami, takimi jak HL7 FHIR i SNOMED CT, mogą sprawić, że technicznie interoperacyjne dane będą miały niespójne znaczenie.
Standardy też ewoluują. USCDI i powiązane specyfikacje wymiany są aktualizowane co roku, dlatego organizacje potrzebują śledzenia zmian, a nie jednorazowego projektu zgodności. Zmieniony element, powiązanie terminologiczne, profil lub struktura dokumentu może wpłynąć na ładowanie danych, raportowanie, analitykę i modele.
Zasada praktyczna: traktuj każdą granicę wymiany danych jako granicę jakości. Sprawdzaj, co dotarło, co to oznacza, kiedy dotarło i jak ma się do wiarygodnych danych źródłowych.
Czyste dane wciąż mogą prowadzić do niebezpiecznej AI
Zbiór danych może przejść kontrole schematu i kompletności, a mimo to pozostać niereprezentatywny. Braki danych mogą koncentrować się w jednej populacji, praktyki kodowania mogą różnić się między placówkami, a rzadkie schorzenia mogą być niedostatecznie rejestrowane. Takie wzorce wpływają nie tylko na analitykę opisową, ale też na budowę i monitorowanie modeli.
Przegląd National Academies z 2025 roku podkreślił, że dostępność danych, ich jakość i stronniczość są ściśle powiązane w AI dla ochrony zdrowia, ostrzegając, że systemy zautomatyzowane mogą wzmacniać słabości semantyczne i jakościowe zamiast je korygować, jak podsumowano w przeglądzie National Academies. To zmienia pytanie o jakość z „Czy tabela jest czysta?” na „Kto jest reprezentowany, czyich danych brakuje i jak zmienia się skuteczność w różnych placówkach i grupach?”
Program, który da się obronić, łączy kontrole techniczne z governance:
Zachowuj lineage od zbierania danych po transformację.
Rejestruj pochodzenie danych i mapowania semantyczne.
Monitoruj kompletność w podgrupach i przesunięcia rozkładów.
Śledź zmiany kodowania i zachowania specyficzne dla źródeł.
Analizuj wyniki w dalszych procesach, a nie tylko odsetek pozytywnych walidacji.
Eskaluj niewyjaśnione pogorszenie jakości do właścicieli klinicznych i odpowiedzialnych za governance.
Zgodność danych medycznych z regulacjami wymaga zatem czegoś więcej niż kontroli formatu. Wymaga dowodów, że dane pozostają zrozumiałe, identyfikowalne, aktualne i odpowiednie dla danej decyzji lub regulowanego zastosowania.
Wdrażanie skalowalnego frameworku jakości danych
Skalowalny framework zaczyna się od zastosowania, a nie od narzędzi. Należy zidentyfikować decyzje kliniczne, operacyjne i regulacyjne zależne od każdego zbioru danych, a następnie określić, jak wygląda błąd w danym zastosowaniu. Strumień danych laboratoryjnych może wymagać ścisłego monitorowania dostaw, podczas gdy historyczny zbiór badawczy może tolerować opóźnienia, ale wymagać lepszej dokumentacji pochodzenia i kompletności.
Warstwowa budowa systemu kontroli
Zacznij od inwentaryzacji danych, która łączy źródła, tabele, pipeline'y, właścicieli, produkty zależne i zamierzone zastosowania. Nadaj priorytet zbiorom danych o dużym wpływie, zamiast próbować monitorować wszystko naraz.
Następnie ustanów cztery uzupełniające się warstwy kontroli:
Walidacja rekordów: kontrole pól wymaganych, walidacja słowników kodów, kontrole zakresów, integralność referencyjna i warunkowe reguły biznesowe.
Monitorowanie zbiorów danych: śledzenie wolumenów, odsetka wartości null, duplikatów, rozkładów i nieoczekiwanej zmienności według źródła i placówki.
Monitorowanie dostaw: uczenie się oczekiwanych wzorców dotarcia danych i sygnalizowanie brakujących ładowań, opóźnień oraz nietypowych godzin dostaw.
Monitorowanie strukturalne: wykrywanie dodanych lub usuniętych kolumn, zmienionych typów danych i innego dryfu schematu, zanim odbiorcy danych niespodziewanie przestaną działać.
Przechowuj dowody blisko kontroli. Każdy incydent powinien zachowywać zbiór danych, regułę lub sygnał, znacznik czasu, źródło, liczbę dotkniętych rekordów, istotność, właściciela, status naprawy i notatki z rozwiązania. Taki zapis wspiera governance i pomaga inżynierom odróżnić lokalny problem z dokumentacją od awarii interfejsu po stronie źródła.
Mniej przenoszenia danych i mniej szumu alertów
Środowiska ochrony zdrowia nakładają ścisłe ograniczenia na przenoszenie danych wrażliwych. Wykonywanie w bazie danych pozwala zespołom obliczać metryki i prowadzić analizy w hurtowni lub platformie klienta, ograniczając zbędne kopiowanie i zachowując istniejące mechanizmy kontroli dostępu. Wdrożenie w chmurze prywatnej lub on-premises sprawdza się w środowiskach, w których dane produkcyjne muszą pozostać w chmurze organizacji, jej wirtualnej sieci prywatnej lub centrum danych.
Projekt alertów jest równie ważny jak samo wykrywanie. Należy przekazywać tylko odchylenia wymagające działania, grupować powiązane błędy, pokazywać prawdopodobny wpływ i pozwalać zespołom wyciszać znane prace serwisowe bez ukrywania nowych zachowań. Modułowa platforma, taka jak digna, może łączyć wykrywanie anomalii, walidację na poziomie rekordów, monitorowanie aktualności, śledzenie schematu i wspólny przegląd incydentów, zachowując obliczenia w środowisku klienta.
Celem wdrożenia nie jest idealny wynik. Celem jest powtarzalna pętla operacyjna: wykrywanie, triaż, analiza, naprawa, weryfikacja i wyciąganie wniosków.
Strategie danych medycznych odporne na przyszłość
Dane medyczne będą napływać z coraz większej liczby miejsc, urządzeń, aplikacji i ścieżek wymiany. Telemedycyna, urządzenia ubieralne, badania genomiczne i informacje generowane przez pacjentów dostarczają cennych sygnałów, ale wprowadzają też odmienne sposoby zbierania danych, jednostki, wzorce braków i wymagania dotyczące pochodzenia. Odporna strategia zakłada, że jakość będzie się zmieniać wraz ze zmianą środowiska.
Najtrwalsze podejście wbudowuje kontrole w cały cykl życia danych:
Przy zbieraniu: jawnie określ wymagany kontekst i tam, gdzie to praktyczne, zapobiegaj niejednoznacznym wpisom.
Przy ładowaniu: waliduj strukturę, terminologię, relacje i tożsamość źródła.
Podczas transformacji: zachowuj lineage, jednostki, pochodzenie i decyzje semantyczne.
Na produkcji: monitoruj dostawy, rozkłady, zachowanie schematu i wpływ biznesowy.
Po incydentach: dokumentuj przyczynę źródłową i przekształcaj powtarzające się błędy w kontrole zapobiegawcze.
Programistyczne zestawy SDK pozwalają umieszczać kontrole jakości bezpośrednio w pipeline'ach danych i aplikacjach. Zmniejsza to dystans między inżynierem zmieniającym transformację a zespołem governance, który później odkrywa jej konsekwencje. Kontrole nadal powinny być obserwowalne, wersjonowane, testowalne i przypisane do właścicieli.
Jakość danych staje się trwała, gdy zespoły traktują ją jako operacyjną właściwość każdego pipeline'u, a nie końcową inspekcję przed publikacją.
Najlepsze programy w ochronie zdrowia opierają się też wąskiej definicji „czystych” danych. Monitorują kompletność według podgrup i placówek, odróżniają wartości poprawne od wartości znaczących, testują aktualność względem terminów klinicznych i sprawdzają, czy modele lub raporty zachowują się inaczej po zmianach w źródłach. Ciągłe doskonalenie oznacza dopracowywanie progów, wycofywanie hałaśliwych kontroli, rozszerzanie lineage i angażowanie interesariuszy klinicznych, gdy anomalie techniczne mogą wpłynąć na opiekę.
Czym więc jest zarządzanie jakością danych w ochronie zdrowia? To stała praktyka utrzymywania informacji w stanie przydatnym do zamierzonych zastosowań klinicznych, operacyjnych, badawczych, zdrowia publicznego i regulacyjnych. Organizacje, które wbudują tę dyscyplinę w zbieranie danych, ich wymianę, pipeline'y i systemy decyzyjne, mogą uczynić dane kontrolowanym zasobem, a nie powracającym źródłem niepewności.
digna zapewnia jakość danych i obserwowalność w bazie danych dla zbiorów danych medycznych, w tym wykrywanie anomalii, walidację na poziomie rekordów, monitorowanie aktualności i śledzenie schematu we własnym środowisku. Odwiedź digna, aby ocenić modułowe podejście do zwiększania wiarygodności danych klinicznych, operacyjnych i regulacyjnych.
Zdublowane tożsamości pacjentów i wizyty wskazujące na nieistniejące już rekordy to w równym stopniu błędy relacji, co błędy wartości. Jak testować te powiązania między systemami EHR, laboratoryjnymi i raportowymi, opisujemy w artykule o integralności referencyjnej danych medycznych.
Najczęściej zadawane pytania
Czym jest zarządzanie jakością danych w ochronie zdrowia?
To ciągła dyscyplina sprawdzania, czy dane kliniczne, operacyjne, badawcze, dotyczące zdrowia publicznego i regulacyjne są kompletne, dokładne, spójne, znaczące i dostępne wtedy, gdy są potrzebne. Obejmuje kontrole w miejscu zbierania danych, walidację wymiany, wykrywanie anomalii i naprawę błędów aż po lineage i governance, zamiast być jednorazowym projektem porządkowania danych.
Jakich wymiarów używa WHO do oceny jakości danych medycznych?
Framework WHO Data Quality Review wykorzystuje kompletność, spójność wewnętrzną, porównanie zewnętrzne z niezależnym źródłem oraz zewnętrzną spójność danych populacyjnych, takich jak mianowniki. Wspiera też oczekiwania dotyczące dokładności, wiarygodności i aktualności. Zespoły powinny przekładać każdy wymiar na progi dla konkretnego zbioru danych i procesu zamiast jednego wyniku dla całej organizacji.
Dlaczego kompletny rekord nie dowodzi dobrej jakości danych medycznych?
Kompletność nie oznacza dokładności. Wartość może być obecna i mieć poprawny typ, a mimo to być błędna dla pacjenta, epizodu opieki lub zmienić znaczenie po wymianie danych. Dane brakujące, błędne, spóźnione i semantycznie niespójne to odrębne rodzaje błędów, a każdy wymaga własnej kontroli, od kontroli interfejsów po bazowe wzorce dostaw i mapowanie terminologii.
Dlaczego okresowe audyty nie wystarczają w przypadku danych klinicznych?
Audyty wykrywają błędy dopiero wtedy, gdy dane trafiły już do raportów i modeli. Jeden z przeglądów wykazał błędy w 86,3% badanych elektronicznych dokumentów klinicznych. Ciągła obserwowalność uzupełnia audyty, sygnalizując brakujące ładowania z placówek, spóźnione strumienie danych, zmiany schematu oraz przesunięcia w odsetku wartości null lub rozkładach kodów, póki jest jeszcze czas na reakcję.
Jak zbudować skalowalny framework jakości danych w ochronie zdrowia?
Należy zacząć od decyzji, które wspiera każdy zbiór danych, a następnie nakładać warstwy kontroli: walidację rekordów, monitorowanie wolumenów i rozkładów w zbiorach danych, monitorowanie dostaw względem wyuczonych wzorców oraz monitorowanie strukturalne pod kątem dryfu schematu. Uruchamianie kontroli w bazie danych ogranicza przenoszenie danych wrażliwych, a każdy incydent powinien zachowywać właściciela, dotknięte rekordy i status naprawy.


