Tabela systemowa metryk: Schemat, zapytania i najlepsze praktyki
|
9
min. czyt.

Właściciel pulpitu nawigacyjnego otwiera poranny raport i stwierdza, że liczby nie zmieniły się od dwóch dni. Sam potok danych wyświetla się na zielono, hurtownia danych jest dostępna i żadne zadanie nie zakończyło się błędem. Później ktoś odkrywa, że kolumna źródłowa zmieniła typ, transformacja pominęła część swoich danych wejściowych lub najnowsza partycja nigdy nie dotarła. Incydent nie został spowodowany brakiem pulpitu nawigacyjnego. Został spowodowany brakiem dowodów operacyjnych.
Systemowa tabela metryk (metrics system table) dostarcza tych dowodów w formie umożliwiającej zadawanie zapytań. Zamiast rozpraszać testy w notatnikach, skryptach powłoki, metadanych hurtowni danych i zewnętrznych narzędziach monitorujących, zespoły mogą rejestrować sygnały na poziomie tabeli i kolumny w jednej księdze operacyjnej. Taka księga może obsługiwać kontrole świeżości, analizę wolumenu, wykrywanie zmian schematu, badanie historii, przepływy pracy związane z własnością oraz ścieżki audytu bez zamieniania każdego dochodzenia w niestandardowy projekt inżynieryjny.
Spis treści
Dlaczego zespoły zajmujące się danymi potrzebują systemowej tabeli metryk
Praktyczna luka między zbieraniem a działaniem
Czym jest systemowa tabela metryk
Dlaczego separacja ma znaczenie
Metadane dostawcy a kontrolowana księga wewnętrzna
Podstawowy schemat i wzorce projektowe kolumn
Projekt referencyjny
Klucze i ścieżki dostępu
Praktyczne zapytania SQL dla typowych zadań z zakresu Observability
Naruszenia świeżości (Timeliness)
Anomalie wolumenu
Dryf schematu
Strategie retencji i agregacji
Retencja tylko danych surowych
Podsumowania w przedziałach czasowych
Wielopoziomowa retencja
Łączenie metryk z sygnałami świeżości i dryfu schematu
Korelacja sygnałów
Macierz decyzyjna dla reakcji o niskim poziomie szumów
Kiedy większa liczba metryk zmniejsza skuteczność Observability
Priorytetyzacja według konsekwencji
Wycofywanie kontroli, które nie wpływają na decyzje
Instrumentacja tabel metryk na platformach korporacyjnych
Wzorzec wdrożenia, który się sprawdza
Ochrona wydajności
Governance i audytowalność w branżach regulowanych
Oddzielenie procesów zapisu od odczytu
Szybka ściągawka do projektowania systemowej tabeli metryk
Wzorce zapytań produkcyjnych
Progi wymagają kontekstu
Dlaczego zespoły zajmujące się danymi potrzebują systemowej tabeli metryk
Zespół zajmujący się danymi zazwyczaj dowiaduje się o problemach z niezawodnością od swoich odbiorców. Analityk zgłasza, że pulpit nawigacyjny przychodów jest nieaktualny. Użytkownik z działu finansów zauważa nieoczekiwaną zmianę w raporcie. Inżynier uczenia maszynowego odkrywa, że tabela cech zawiera nieznany typ danych lub nietypowe nagromadzenie brakujących wartości. Do tego czasu system przestał już spełniać swój cel operacyjny, nawet jeśli każde zadanie orkiestracji zakończyło się pomyślnie.
Brakującą warstwą jest często mały zestaw trwałych elementów pierwotnych Observability. Systemowa tabela metryk może rejestrować liczbę wierszy, wskaźniki brakujących wartości, zachowanie unikalnych wartości, znaczniki czasu, opóźnienia i sygnatury schematu na poziomie tabeli lub kolumny. Te wartości zamieniają niewidoczną zmianę w rekord, który SQL może sprawdzić, porównać, zachować i skierować do odpowiedniego właściciela.
Różnica ma znaczenie, ponieważ status potoku odpowiada tylko na jedno pytanie: czy zadanie zostało uruchomione? Nie odpowiada na pytanie, czy dane dotarły zgodnie z harmonogramem, czy wolumen wyjściowy jest wiarygodny, czy krytyczna kolumna uległa zmianie, ani czy dalszy proces biznesowy może zaufać wynikowi. Fundament, jakim jest Data Observability, dodaje te sygnały do obrazu operacyjnego.
Praktyczna luka między zbieraniem a działaniem
Skrypty ad-hoc często sprawdzają się przy pierwszej kontroli. Stają się jednak trudne do kontrolowania pod kątem governance, gdy każdy zespół wdraża własne konwencje nazewnictwa, progi, harmonogramy i miejsca docelowe alertów. Zewnętrzne narzędzia mogą zwiększyć pokrycie, ale mogą pozostawić definicje metryk, kontekst historyczny i metadane własności rozproszone w wielu systemach.
Scentralizowana tabela daje inżynierom stabilny interfejs:
Wykrywanie: przechowywanie zaobserwowanej wartości i czasu jej obliczenia.
Porównanie: ocena jej w stosunku do punktu odniesienia, oczekiwań na poziomie usług lub poprzedniego okresu.
Eskalacja: dołączanie poziomu ważności, właściciela, podręcznika procedur (runbook) i statusu.
Dowód: zachowanie informacji o tym, co zostało sprawdzone, kiedy zostało uruchomione i jaki wynik przyniosło.
Zasada praktyczna: Metryka nie ma charakteru operacyjnego, dopóki ktoś nie może zadać o nią zapytania, zidentyfikować jej właściciela, zdecydować, jakie działanie powinna wywołać, i przejrzeć jej historii.
Tabele metryk bazy Oracle ilustrują przejście architektoniczne od ręcznej kontroli w danym momencie do standaryzowanego śledzenia bieżącego i historycznego. W wersji Oracle 10g wprowadzono tabele metryk, które obliczały przyrosty i współczynniki, upraszczając pytania takie jak bieżący współczynnik wejścia/wyjścia bazy danych. Powiązane widoki historyczne wspierają analizę trendów, w tym DBA_HIST_SYSMETRIC_SUMMARY do analizy wielodniowej oraz DBA_HIST_METRIC_NAME do identyfikacji metryk we wspólnym repozytorium AWR. Historia tabel metryk Oracle i śledzenie operacyjne pokazuje, dlaczego ten wzorzec pozostaje użyteczny: zespoły potrzebują zarówno stanu bieżącego, jak i dowodów niezbędnych do zrozumienia, jak ten stan powstał.
Bez systemowej tabeli metryk zespoły reagują na skargi. Dzięki niej mogą wykryć pogorszenie jakości, zanim interesariusz otworzy zgłoszenie, skorelować kilka sygnałów i utworzyć gotowe do celów governance dowody z tego samego rekordu operacyjnego.
Czym jest systemowa tabela metryk
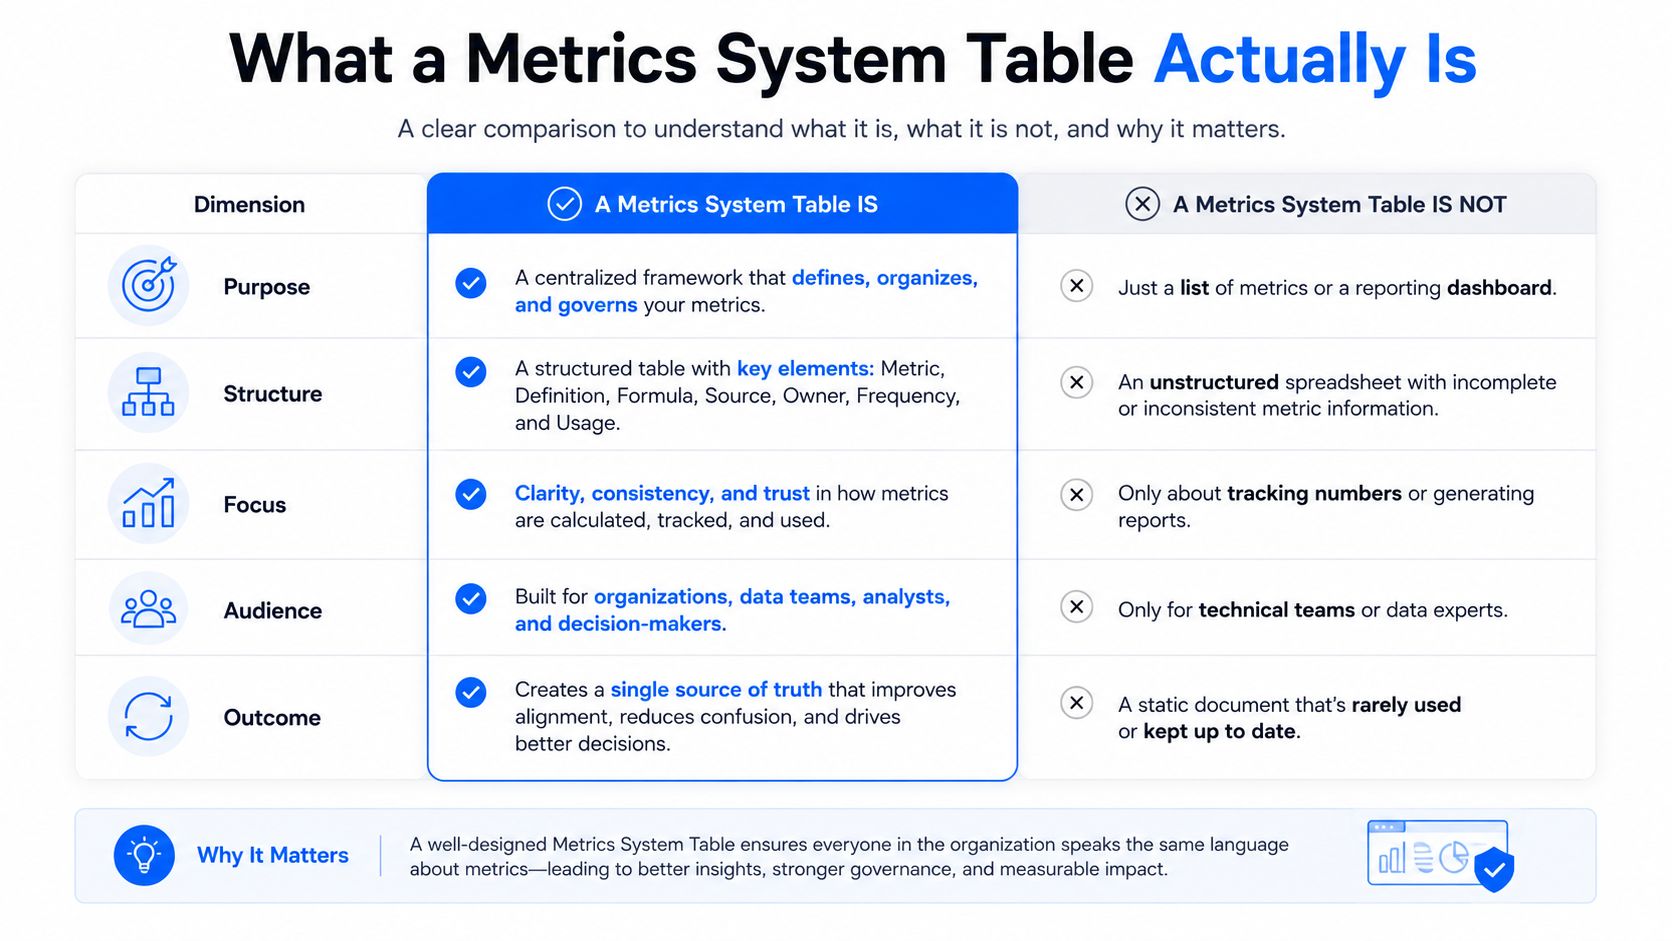
Systemowa tabela metryk to operacyjna księga o niskim opóźnieniu zawierająca obliczone obserwacje dotyczące zasobów danych. Rejestruje ona pomiary pochodzące z tabel użytkowników, potoków danych lub metadanych platformy, nie zastępując podstawowych danych ani nie tworząc drugiej kopii w hurtowni.
Tabela przeznaczona dla użytkowników zawiera encje biznesowe, takie jak zamówienia, użytkownicy, zdarzenia lub roszczenia. Tabela metryk rejestruje obserwacje dotyczące tych encji, w tym liczbę wierszy w danym momencie, znacznik czasu ostatniego zdarzenia, współczynnik brakujących wartości, szacowaną kardynalność, sygnaturę schematu lub wynik walidacji. Zmierzona wartość należy do rekordu metryki. Wiersze źródłowe pozostają w tabeli aplikacyjnej lub analitycznej.
Dlaczego separacja ma znaczenie
Oba rodzaje obciążeń mają inną charakterystykę. Tabele użytkowników mogą obsługiwać transakcje, złączenia, agregacje lub pobieranie danych. Systemowa tabela metryk jest zasadniczo zaprojektowana do zapytań o przedziały czasowe, filtrowanych wyszukiwań, zapisów zorientowanych na dopisywanie i porównań historycznych. Traktowanie jej jak transakcyjnej tabeli faktów zwiększa szczegółowość, pamięć masową i narzut zapytań, nie poprawiając przy tym decyzji operacyjnych.
Praktyczny rekord może zawierać:
Wymiary: baza danych, schemat, tabela, kolumna, typ metryki, środowisko i domena biznesowa.
Miary: zaobserwowana wartość, liczba wierszy, których dotyczy problem, zużycie zasobów lub wynik anomalii.
Metadane wykonania: czas obliczenia, identyfikator zapytania źródłowego lub zadania, wersja testu i status wyniku.
Kontekst governance: właściciel, ważność, odniesienie do pochodzenia danych (lineage) i stan naprawy.
Tabela powinna również wspierać ustalanie priorytetów. Sam strumień pomiarów o dużym wolumenie nie jest jeszcze przepływem pracy powiadomień o alertach. Zespoły potrzebują progów, własności i pól statusu, które pozwalają odfiltrować rutynowe wahania od warunków wymagających działania. Utrzymywanie tych decyzji blisko zarejestrowanej obserwacji wspiera operacje o niskim poziomie szumów, gotowe do procesów governance, i umożliwia wykonywanie kontroli na danych w bazie, zamiast eksportować każdy szczegół na zewnątrz.
Taka konstrukcja wpisuje się w rolę relacyjnych tabel systemowych jako warstwy metadanych. Ujawniają one sygnały profilowania i monitorowania, a nie zwykłe wiersze aplikacji. Kompaktowy zagregowany rekord ze znacznikiem czasu może służyć jako księga operacyjna, kontrolując jednocześnie narzut pamięci masowej i zapytań, zgodnie z wytycznymi dotyczącymi projektowania tabel systemowych.
Metadane dostawcy a kontrolowana księga wewnętrzna
Snowflake, BigQuery i Databricks dostarczają generowane przez system metadane, historię zapytań, historię tabel i widoki schematów informacyjnych. Źródła te pomagają w inspekcji specyficznej dla danej platformy, ale mogą nie zapewniać zasad retencji, modelu nazewnictwa, kontroli biznesowych, pól własności ani schematu międzyplatformowego, których wymaga przedsiębiorstwo.
Niestandardowa tabela pozwala zespołowi zdefiniować:
które metryki są autorytatywne,
jak często każda metryka jest obliczana,
jak długo surowe i podsumowane rekordy pozostają dostępne,
które progi generują incydenty,
oraz które metadane audytorzy i stewardzi danych mogą kontrolować.
Ta kontrola ma znaczenie, gdy wynik świeżości, zdarzenie schematu lub walidacja biznesowa muszą pozostać zrozumiałe po zmianie pierwotnego potoku danych. Warstwa semantyczna może standaryzować znaczenie biznesowe nad tymi sygnałami, nie ukrywając rekordu operacyjnego. Zespoły oceniające tę granicę mogą porównać podejście oparte na księdze z warstwą semantyczną dbt.
Podstawowy schemat i wzorce projektowe kolumn
Użyteczny schemat oddziela to, co było mierzone, od zaobserwowanej wartości oraz sposobu wygenerowania obserwacji. Połączenie tych ról w jedną przeciążoną kolumnę utrudnia filtrowanie, retencję i alertowanie.
Zacznij od wąskiego modelu zdarzeń. Statyczne wymiary identyfikują zasób i metrykę. Pola dynamiczne przechowują wynik w określonym czasie obserwacji. Metadane wykonania wyjaśniają proces obliczeniowy i dają operatorom wystarczający kontekst do odtworzenia lub selekcji wyniku.
Projekt referencyjny
Nazwa kolumny | Typ danych | Cel | Przykładowa wartość |
|---|---|---|---|
|
| W pełni kwalifikowana mierzona tabela |
|
|
| Mierzona kolumna, dopuszczająca wartość null dla metryk tabeli |
|
|
| Tożsamość metryki |
|
|
| Czas obliczenia metryki |
|
|
| Wynik numeryczny |
|
|
| Dolna dopuszczalna granica |
|
|
| Górna dopuszczalna granica |
|
|
| Wynik oceny |
|
|
| Definicja testu i kontekst diagnostyczny |
|
Dokładne typy różnią się w zależności od platformy, ale zasada projektowania pozostaje ta sama. Używaj typu DECIMAL dla współczynników, gdy precyzja ma znaczenie, TIMESTAMP WITH TIME ZONE dla czasów obserwacji oraz strukturyzowanego pola rozszerzenia takiego jak JSONB dla zmieniających się szczegółów, takich jak powody błędów, definicje filtrów lub identyfikatory zadań źródłowych. Nie umieszczaj kluczowych wymiarów filtrowania wewnątrz formatu JSON, jeśli operatorzy wysyłają do nich regularne zapytania. Przenieś te pola do indeksowanych kolumn.
Implementacja w stylu PostgreSQL może wyglądać następująco:
Klucze i ścieżki dostępu
Klucz złożony zapobiega duplikowaniu obserwacji dla tego samego zasobu, metryki i czasu obliczeń. W systemach, w których powtórne uruchomienia mogą generować wiele uprawnionych wyników, dodaj identyfikator uruchomienia i spraw, aby reguła unikalności odzwierciedlała ten model wykonania zamiast nadpisywać dowody.
Utwórz ścieżki dostępu wokół rzeczywistych pytań operatorów:
Zapytanie o niedawne naruszenia świeżości może wówczas filtrować według typu metryki i zakresu czasu zamiast skanować niepowiązane kontrole. Wytyczne MySQL dotyczące schematu informacyjnego zwracają uwagę na tę samą kwestię operacyjną z innej perspektywy: dynamiczne metadane, takie jak liczba wierszy, długość danych, długość indeksu, czas aktualizacji i kardynalność, mogą generować narzut, dlatego zespoły powinny pytać tylko o potrzebne obiekty i unikać szerokiego skanowania. Wskazówki dotyczące optymalizacji schematu informacyjnego wspierają filtrowany dostęp według schematu, tabeli, typu metryki i przedziału czasowego.
Schemat powinien być również udokumentowany wraz z kontrolami, które go zasilają. Katalog schematów hurtowni danych może pomóc zespołom wnioskować o zależnościach, ale księga metryk powinna pozostać zoptymalizowana pod kątem dostępu operacyjnego, a nie kompletności opisowej. Zobacz schematy w hurtowni danych, aby dowiedzieć się więcej o granicy między metadanymi strukturalnymi a dowodami monitorowania.
Praktyczne zapytania SQL dla typowych zadań z zakresu Observability
SQL staje się użyteczny, gdy każde zapytanie odpowiada na pytanie operacyjne i zwraca wystarczający kontekst do podjęcia decyzji. Poniższe wzorce zakładają użycie tabeli referencyjnej z poprzedniej sekcji i wykorzystują składnię w stylu PostgreSQL. Snowflake, BigQuery i Redshift wymagają niewielkich zmian w składni funkcji znacznika czasu, percentyla i daty.
Naruszenia świeżości (Timeliness)
Przechowuj ostatnio zaobserwowany znacznik czasu źródła jako metric_value dla metryki świeżości lub zapisuj go w strukturyzowanych metadanych, jeśli platforma wymaga osobnej numerycznej wartości wieku. Poniższe zapytanie porównuje najnowszą obserwację z umową SLA zapisaną w tabeli konfiguracyjnej.
Partycjonuj tabelę według computed_at tam, gdzie platforma to obsługuje. Ograniczony predykat czasu umożliwia przycinanie partycji i zapobiega skanowaniu całej historii.
Anomalie wolumenu
Kroczący punkt odniesienia powinien odzwierciedlać normalne wahania, a nie tylko jedno poprzednie uruchomienie. Ten przykład wykorzystuje średnią kroczącą i odchylenie standardowe na podstawie historycznych metryk liczby wierszy.
Użyj klucza partycjonowania lub klucza klastrowania dla nazwy tabeli i czasu obserwacji. Dokładny przedział powinien odzwierciedlać ryzyko biznesowe i sezonowość, a nie uniwersalną stałą.
Dryf schematu
Dryf schematu jest najłatwiejszy do wykrycia, gdy migawka bazowa (baseline snapshot) jest przechowywana jako osobna rodzina metryk. Poniższe zapytanie porównuje szczegóły bieżącej sygnatury schematu z ostatnią zatwierdzoną migawką.
Zespoły, które chcą mierzyć dryf schematu operacyjnie, mogą śledzić częstotliwość dryfu oraz opóźnienie wykrywania dryfu, zdefiniowane jako liczba zmian schematu w danym okresie oraz czas między zmianą a jej wykryciem. Wytyczne dotyczące monitorowania dryfu schematu opisują te miary, nie wymagając, aby każda zmiana strukturalna stawała się incydentem.
Zadanie Observability | Podstawowy wzorzec SQL | Kluczowe funkcje | Typowy próg |
|---|---|---|---|
Świeżość (Timeliness) | Najnowsza obserwacja w stosunku do skonfigurowanego wieku |
| SLA specyficzne dla tabeli |
Anomalia wolumenu | Kroczący punkt odniesienia i przedział odchylenia |
| Zależny od punktu odniesienia |
Dryf schematu | Bieżąca migawka porównana z punktem odniesienia |
| Dodano, usunięto lub zmieniono typ |
Monitorowanie wskaźnika wartości null | Bieżący współczynnik w stosunku do punktu odniesienia |
| Tolerancja specyficzna dla kolumny |
Śledzenie opóźnień | Odstęp między uruchomieniami i porównanie czasu działania |
| Oczekiwanie specyficzne dla potoku |
Zapewnij kontrolę wersji dla tych zapytań i przeglądaj je tak samo jak kod produkcyjny. Praktyki optymalizacji zapytań SQL są szczególnie istotne, gdy tabela metryk zawiera dane z wielu miesięcy obserwacji.
Strategie retencji i agregacji
Surowe obserwacje są cenne podczas reagowania na incydenty, ale drogie, gdy są przechowywane bez planu. Tabela metryk rejestrująca każde uruchomienie, zasób i kontrolę może szybko rosnąć, dlatego retencja powinna odpowiadać na pytania, które muszą rozwiązać operatorzy.
Trzy wzorce pokrywają większość wdrożeń.
Retencja tylko danych surowych
Ten model przechowuje szczegółowe rekordy i usuwa je zgodnie z zasadą czasu życia (TTL). Zachowuje najlepsze szczegóły śledcze, w tym dokładny kontekst wykonania i sekwencję zmian, które poprzedziły incydent. Wadą jest to, że zapytania o historyczne trendy skanują więcej wierszy, a tabela wymaga rygorystycznego utrzymania partycji.
Retencja tylko danych surowych sprawdza się, gdy badanie incydentów jest dominującym przypadkiem użycia lub gdy platforma zapewnia już niedrogie przycinanie partycji. Nie sprawdza się dobrze, gdy zespoły ds. governance potrzebują długich trendów historycznych, a operatorzy rutynowo wysyłają zapytania do całej tabeli.
Podsumowania w przedziałach czasowych
Agregacje godzinowe lub dzienne przechowują wartości skumulowane, takie jak minimum, maksimum, średnia, liczba, najnowsza wartość i liczba anomalii. Przyspieszają one analizę trendów i zmniejszają ilość danych historycznych, które muszą pozostać w hurtowni bazy danych. Kompromisem jest nieodwracalność. Podsumowanie dzienne może wykazać, że tabela zachowywała się nienormalnie, ale może nie ujawnić, które uruchomienie, kolumna lub kontrola wywołały pierwsze odchylenie.
Używaj widoków zmaterializowanych lub przyrostowych modeli dbt do tych podsumowań. Partycjonuj według daty przedziału i zachowuj wymiary wymagane dla najpopularniejszych filtrów, takich jak tabela, typ metryki, domena i środowisko.
Wielopoziomowa retencja
Model hybrydowy przechowuje surowe rekordy przez krótki czas operacyjny, a zagregowane podsumowania przez dłuższy czas analityczny. Równoważy szczegółowość incydentów z widocznością trendów, podczas gdy zimne przechowywanie (cold storage) może zawierać dowody zgodności z przepisami, gdy interaktywne opóźnienie zapytań nie jest wymagane.
Decyzja o retencji: Zachowaj surowe szczegóły tam, gdzie wpływają one na wynik dochodzenia. Agreguj rekordy, gdy pozostałe pytania mają charakter kierunkowy, porównawczy lub dotyczą obszaru governance.
Dostosuj retencję do wzorców dostępu. Jeśli operatorzy filtrują według tabeli i niedawnego czasu, partycjonuj według daty obserwacji i klastruj lub indeksuj według nazwy tabeli. Jeśli audytorzy filtrują według kontroli, właściciela lub okresu sprawozdawczego, zachowaj te pola w podsumowaniu zamiast zmuszać ich do rekonstrukcji kontekstu z surowych zdarzeń.
Funkcje historyczne hurtowni danych mogą uzupełniać ten projekt, ale nie eliminują konieczności wyboru, które rekordy metryk powinny pozostać dostępne do zapytań. Wzorce danych historycznych Snowflake dostarczają przydatnego kontekstu do oddzielenia historii operacyjnej od analizy długoterminowej.
Łączenie metryk z sygnałami świeżości i dryfu schematu
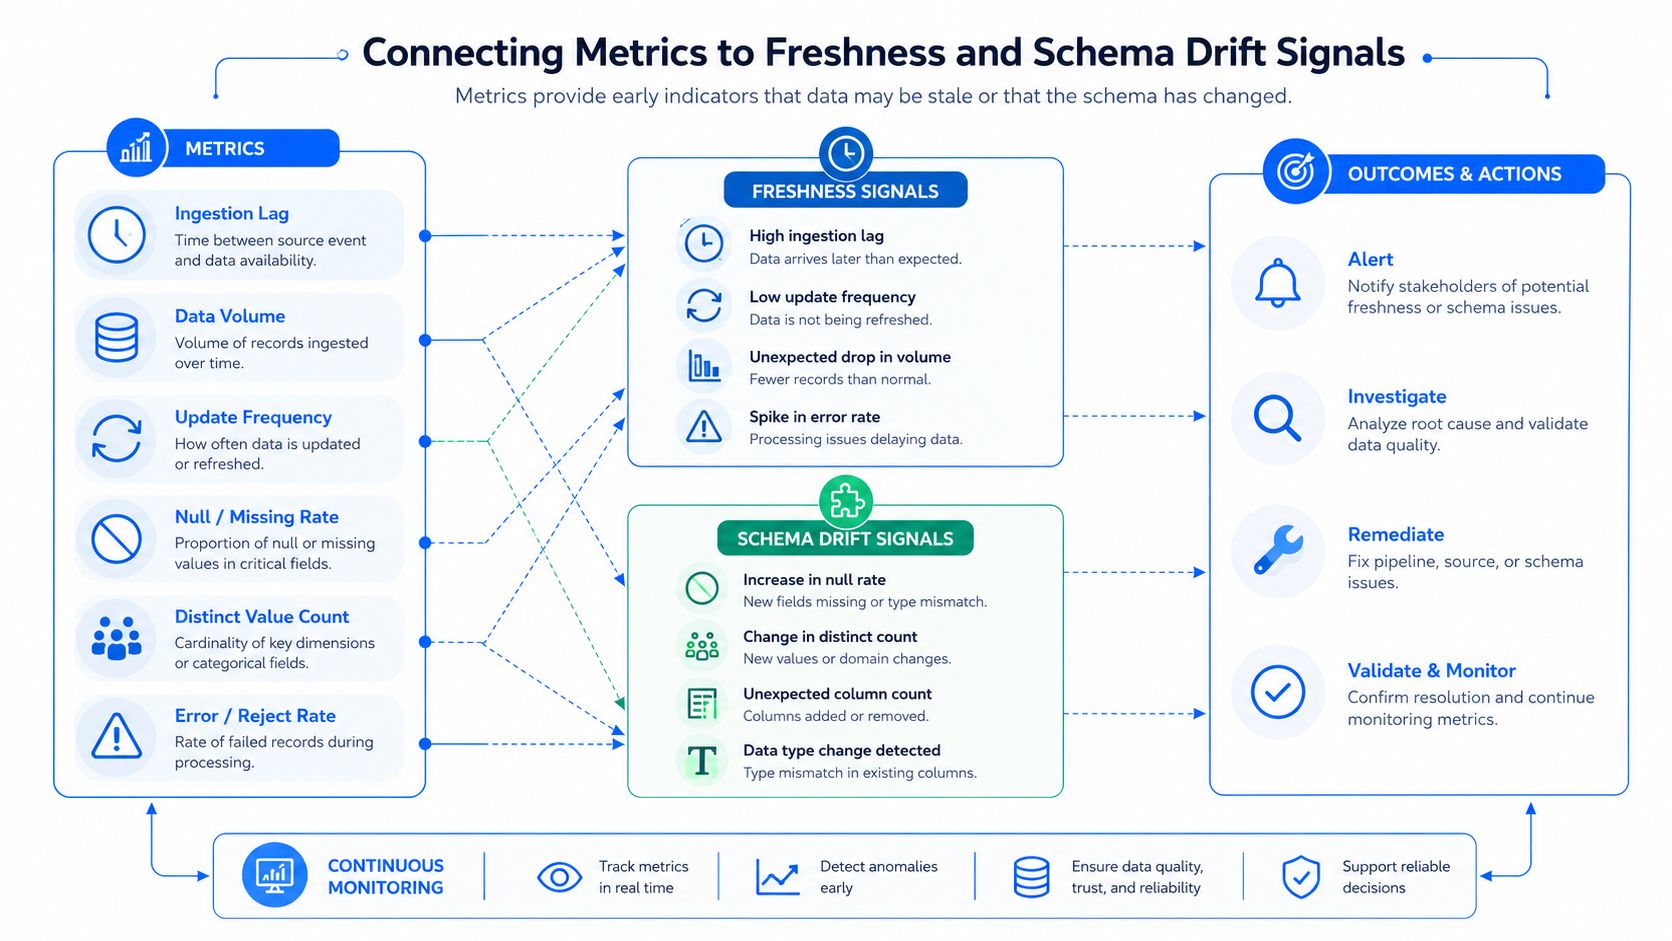
Pojedyncza metryka rzadko wyjaśnia, czy tabela jest bezpieczna do użycia. Opóźnione przyjście danych może być niegroźne, jeśli zmienił się harmonogram źródłowy. Zmiana liczby wierszy może być oczekiwana podczas wydarzenia sezonowego. Zmiana schematu może być wstecznie kompatybilna. Użyteczny sygnał pojawia się, gdy kilka obserwacji wskazuje na ten sam tryb awarii.
Rekordy świeżości, wolumenu i schematu można łączyć za pomocą identyfikatora tabeli i wspólnego przedziału czasowego. Na tej podstawie zespoły mogą zbudować złożony wskaźnik niezawodności, ale wynik ten powinien raczej określać priorytet dochodzenia, niż udawać, że reprezentuje obiektywną prawdę.
Korelacja sygnałów
Proste zapytanie korelacyjne może zidentyfikować tabele z wieloma jednoczesnymi stanami:
Zasada eskalacji powinna odzwierciedlać konsekwencje. Błąd świeżości w połączeniu z błędem wolumenu może uzasadniać automatyczną próbę ponowienia lub badanie źródła. Zmiana schematu połączona z wrażliwym na typ modelem przetwarzającym dane downstream powinna wstrzymać wdrażanie zmian i wymagać weryfikacji przez stewarda. Izolowane wahanie wskaźnika wartości null może wymagać jedynie obserwacji, a nie powiadamiania inżyniera.
Macierz decyzyjna dla reakcji o niskim poziomie szumów
Kombinacja sygnałów | Prawdopodobna interpretacja | Reakcja |
|---|---|---|
Tylko świeżość | Opóźniona lub brakująca dostawa | Sprawdź harmonogram upstream, a następnie ponów próbę, gdy będzie to bezpieczne |
Tylko wolumen | Wahania obciążenia lub częściowy eksport | Porównaj sumy źródłowe i ostatnie obciążenie pracą |
Tylko schemat | Zmiana strukturalna | Sprawdź kompatybilność i zależności downstream |
Świeżość i wolumen | Niekompletne lub opóźnione ładowanie | Eskaluj do właściciela potoku |
Schemat i wolumen | Zmiana kontraktu danych lub transformacji | Wstrzymaj publikację downstream i przeprowadź weryfikację |
Wszystkie trzy | Szeroka awaria zasobu | Otwórz incydent o wysokim priorytecie z kontekstem pochodzenia danych (lineage) |
Monitorowanie dryfu schematu odpowiada na pytanie, czy kolumna została dodana, usunięta lub zmieniono jej typ bez ostrzeżenia. Świeżość (Timeliness) weryfikuje, czy dane docierają zgodnie z harmonogramem. Definicje te różnią się pod względem operacyjnym, a wskazówki dotyczące sygnałów Data Observability są przydatne przy projektowaniu taksonomii metryk.
Zespoły mogą wykonywać te kontrole bezpośrednio w bazie danych, unikając niepotrzebnego przesyłania danych i zmniejszając dystans między obserwacją a decyzją. Wykonywanie Observability w bazie danych opisuje ten model jako uruchamianie testów bezpośrednio w środowisku bazy danych, co pasuje do systemowej tabeli metryk przechowującej kompaktowe wyniki, a nie wyodrębnione dane źródłowe.
Kiedy większa liczba metryk zmniejsza skuteczność Observability
Zapewnienie pokrycia wydaje się bezpiecznym rozwiązaniem, dopóki tabela metryk nie stanie się katalogiem wszystkiego, co da się zmierzyć. W tym momencie koszty zapytań rosną, strumienie alertów stają się trudne do sklasyfikowania, a istotne awarie konkurują z niegroźnymi wahaniami.
Zespół może śledzić ogromny zestaw statystyk na poziomie kolumn, jednocześnie przeoczając błąd logiki biznesowej. Może również generować tak wiele powiadomień, że inżynierowie zatwierdzają je bez badania przyczyny. Problemem nie jest sam pomiar. Problemem jest traktowanie każdego pomiaru jako wymagającego równego działania.
Priorytetyzacja według konsekwencji
Zacznij od sygnałów, które wpływają na zdolność odbiorcy do korzystania z danych:
Świeżość o najwyższym priorytecie: Monitoruj, czy tabele zarządcze, regulacyjne, skierowane do klientów lub operacyjne docierają na czas.
Wolumen na poziomie tabeli: Wykrywaj puste przebiegi, częściowe ekstrakty i nieoczekiwane zmiany źródłowe przed dodaniem szczegółowych kontroli.
Kompatybilność schematu: Stosuj monitorowanie strukturalne na ścieżkach krytycznych, na których zmiana typu danych lub kolumny może uszkodzić modele.
Ukierunkowane kontrole kolumn: Dodawaj kontrole wskaźnika wartości null, kardynalności lub rozkładu, gdy konkretna kolumna wpływa na obliczenia finansowe, cechy modelu lub kontrolę zgodności (Compliance).
Taka sekwencja sprawia, że systemowa tabela metryk pozostaje operacyjną księgą, a nie pełnym katalogiem danych. Szersze monitorowanie na poziomie tabeli może obejmować świeżość, dryf schematu i anomalie wolumenu bez konieczności wprowadzania setek reguł dla każdego zbioru danych, podczas gdy głębsza walidacja pozostaje dostępna dla zasobów o wysokim stopniu ryzyka. Ujednolicone wytyczne dotyczące jakości danych i Observability wspierają to warstwowe podejście.
Wycofywanie kontroli, które nie wpływają na decyzje
Każda kontrola powinna mieć właściciela, zdefiniowaną reakcję i powód, dla którego pozostaje aktywna. Jeśli metryka nie wywołała żadnej reakcji wymagającej działania w okresie przeglądu, zadaj sobie pytanie, czy próg jest błędny, czy zasób ma niski priorytet, czy też kontrola nie powinna już być częścią ciągłego monitorowania.
Test operacyjny: Jeśli alert nie pozwala zidentyfikować odpowiedzialnego zespołu i kolejnego kroku, prawdopodobnie nie powinien nikogo powiadamiać.
Używaj pulpitów nawigacyjnych do celów eksploracyjnych, a alertów do podejmowania decyzji. Naruszenie świeżości na poziomie tabeli może powiadomić właściciela. Niewielka zmiana rozkładu może pozostać widoczna w analizie trendów, dopóki nie połączy się z innym sygnałem. Dyskusja w Snowflake na temat naprawiania jakości danych wzmacnia ogólny kompromis: pokrycie monitorowaniem jest przydatne tylko wtedy, gdy zespoły mogą podjąć działania na podstawie wyniku, a nie wtedy, gdy generuje ono więcej nieprzejrzanych raportów. Zobacz przepływy pracy związane z naprawianiem jakości danych.
Właściwym celem nie jest maksymalna objętość metryk. Jest nim najmniejszy zestaw sygnałów, który wcześnie wykrywa istotne pogorszenie jakości, wspiera diagnozę i tworzy wiarygodny zapis zdarzeń.
Instrumentacja tabel metryk na platformach korporacyjnych
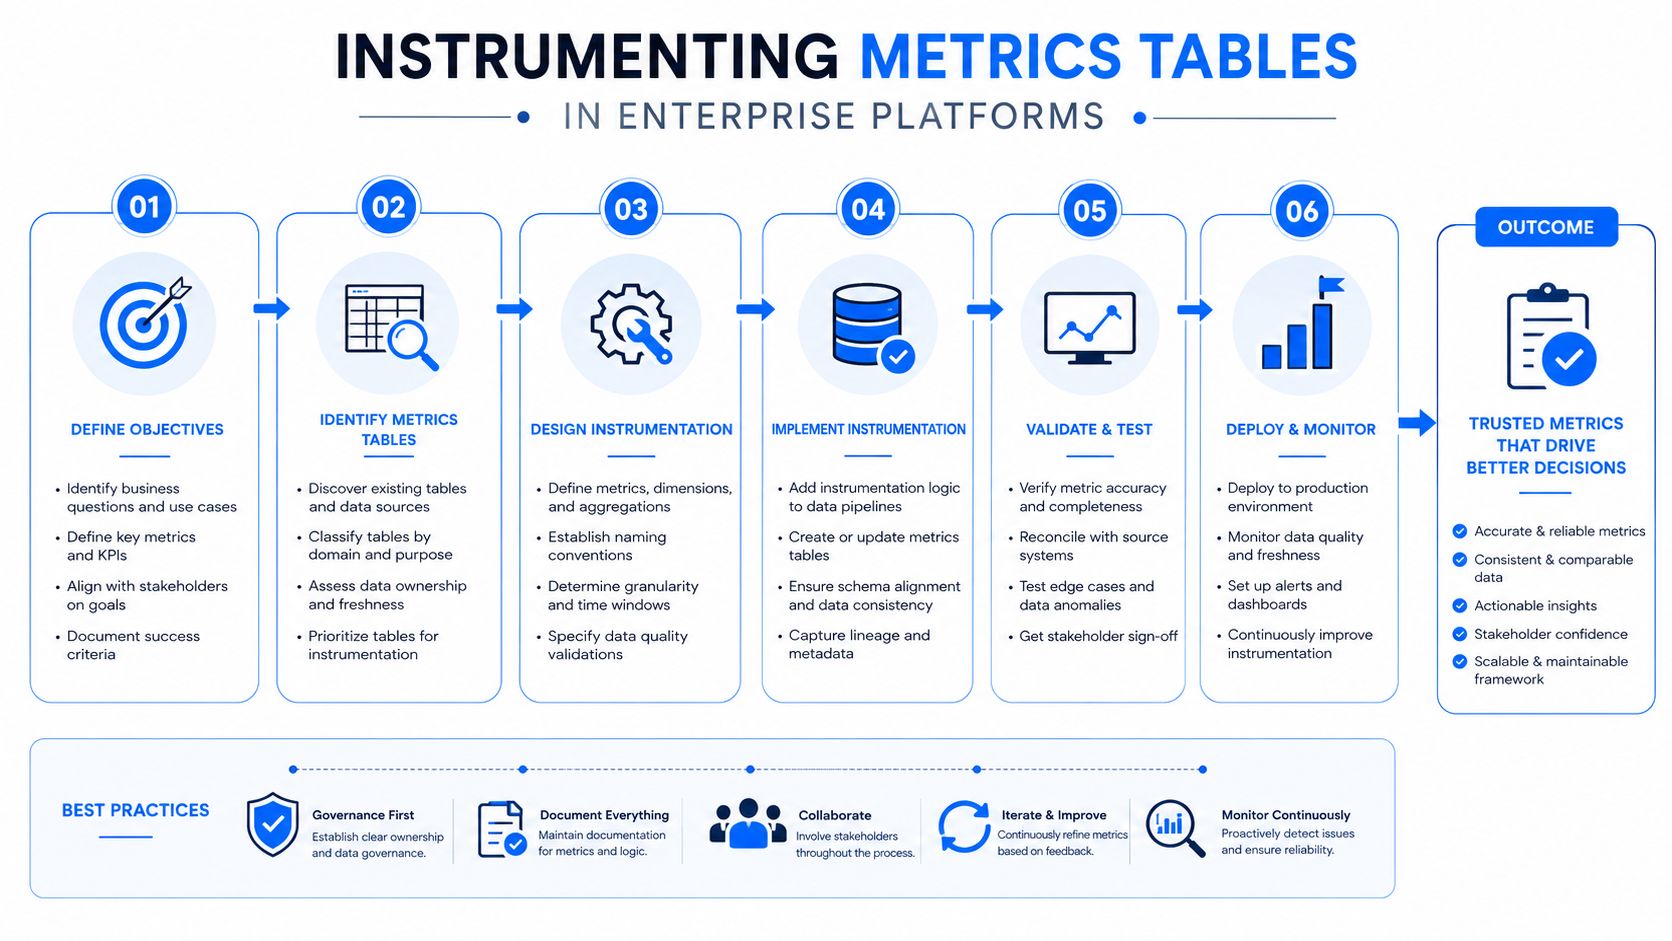
Instrumentacja produkcyjna powinna działać blisko danych i znajdować się w systemie kontroli wersji. Zaplanowane zadania SQL, post-hooki dbt, procedury natywne hurtowni i orkiestracja platformy mogą zasilać systemową tabelę metryk bez eksportowania surowych rekordów do osobnej usługi.
Wybór implementacji zależy od testu. Zapytanie o świeżość może zostać uruchomione po załadowaniu danych. Migawka schematu może zostać wykonana przed wydaniem modeli downstream. Cięższe obliczenia rozkładu mogą być wykonywane zgodnie z harmonogramem odpowiadającym ich ryzyku i kosztom. Ważne jest, aby harmonogram, zapytanie, próg, właściciel i zasady retencji były deklarowane wspólnie.
Wzorzec wdrożenia, który się sprawdza
Utwórz księgę. Dodaj tabelę metryk, tabelę konfiguracyjną, pola własności i mechanizm retencji przed włączeniem alertów.
Zarejestruj krytyczne zasoby. Zapisz identyfikatory tabel, domenę biznesową, poziom ważności, oczekiwany harmonogram i odpowiedzialny zespół.
Zasilaj bazę danych. Używaj zaplanowanych zapytań SQL, hooków dbt lub natywnych zadań, aby obliczać kompaktowe agregaty na miejscu.
Wyznacz punkt odniesienia przed wysłaniem alertu. Przechowuj obserwacje wystarczająco długo, aby zrozumieć normalne zachowanie, a następnie ustaw progi odzwierciedlające specyfikę zasobu.
Kieruj wyniki wymagające działania. Przesyłaj zatwierdzone incydenty do Slacka, PagerDuty, pulpitów nawigacyjnych governance lub istniejącego narzędzia Observability.
Dołączaj procedury (runbooki). Przechowuj odnośniki do procedur naprawczych wraz z konfiguracją metryk, aby alert otwierał się z pełnym kontekstem.
Platforma taka jak Monte Carlo może konsumować sygnały z hurtowni bazy danych, podczas gdy niestandardowa usługa może wysyłać zapytania bezpośrednio do księgi. digna zapewnia obliczanie metryk wewnątrz bazy danych dla liczby rekordów, wskaźników brakujących wartości, statystyk rozkładu, agregacji KPI i odchyleń od harmonogramu, oferując moduły do wykrywania anomalii, walidacji i śledzenia schematów.
Ochrona wydajności
Indeksuj lub klastruj pola, według których operatorzy filtrują najczęściej. Partycjonuj według daty obserwacji tam, gdzie jest to obsługiwane. Unikaj ponownego obliczania kosztownych metryk dla każdej tabeli przy każdym uruchomieniu i nie pozwól, aby zapytanie alertu skanowało wszystkie rekordy historyczne, gdy najnowsza partycja zawiera niezbędne dowody.
Utrzymuj definicje kontroli w repozytorium i przeglądaj zmiany w tym samym procesie co kod transformacji. Logika zapisana w notatnikach i rozproszone skrypty są trudne do audytowania, odtwarzania lub wycofywania. Wersjonowana konfiguracja sprawia, że zmiany własności, edycje progów i ewolucja schematu są w pełni widoczne.
Governance i audytowalność w branżach regulowanych
In finance, healthcare, telecommunications, and the public sector, observability evidence must survive beyond the incident that created it. A metrics system table can record that a check ran, what it measured, which version executed, whether it passed, and who owned the result.
Taki rekord wspiera coś więcej niż tylko reagowanie na incydenty. Może pomóc audytorowi zweryfikować, czy krytyczna tabela finansowa została zweryfikowana przed procesem raportowania lub czy wrażliwa kolumna pozostała w oczekiwanym zakresie jakości. Wartość wynika z zachowania dowodów wykonania i możliwości ich wyjaśnienia.
Oddzielenie procesów zapisu od odczytu
Zautomatyzowane potoki powinny odpowiadać za zapisy. Audytorzy, stewardzi danych, właściciele kontroli i inżynierowie platformy powinni otrzymać ograniczony dostęp do odczytu. Unikaj przyznawania użytkownikom operacyjnym uprawnień do edycji wyników historycznych, ponieważ modyfikowalne dowody osłabiają ścieżkę audytu.
Przydatne pola audytowe obejmują:
check_executed_at, czas wykonania oceny.observed_at, czas reprezentowany przez metrykę.check_version, identyfikujący użytą logikę.owner_team, identyfikujący odpowiedzialność.lineage_reference, łączący wynik z zasobami upstream i downstream.result_statusorazfailure_reason, sprawiające, że wynik jest zrozumiały.remediation_status, wskazujący, czy problem został zweryfikowany lub rozwiązany.
Nazwa kolumny | Typ danych | Cel | Wymóg retencji |
|---|---|---|---|
|
| Identyfikuje kontrolowany test | Zachowaj wraz z rekordem kontroli |
|
| Dowodzi czasu wykonania | Zachowaj przez okres audytu |
|
| Identyfikuje stan mierzonych danych | Zachowaj wraz z wynikiem |
|
| Określa odpowiedzialność | Zachowaj, dopóki kontrola jest aktywna |
|
| Łączy zasób z zależnościami | Zachowaj do celów dochodzenia i weryfikacji |
|
| Przechowuje zaobserwowany wynik | Zachowaj wraz z dowodem kontroli |
|
| Rejestruje stan powodzenia lub błędu | Zachowaj jako niezmienny dowód |
|
| Wskazuje na powiązane artefakty | Zachowaj zgodnie z zasadami polityki |
Regulowany okres retencji może znacznie wykraczać poza okno szybkich zapytań (hot-query window). Przechowuj niedawne dowody w hurtowni bazy danych na potrzeby dostępu operacyjnego, kompresuj starsze partycje i archiwizuj niezmienne rekordy w kontrolowanym magazynie obiektowym, gdy interaktywny dostęp nie jest już konieczny. Stosuj szyfrowanie, logowanie dostępu i zasady usuwania zgodne z klasyfikacją danych.
Systemowa tabela metryk staje się infrastrukturą governance, gdy jej rekordy są niezmienne, przypisywalne, powtarzalne i powiązane z pochodzeniem danych (lineage). Nie powinna jedynie informować, że kontrola zakończyła się niepowodzeniem. Powinna wyjaśniać, która kontrola została uruchomiona, na jakim zasobie, przy jakiej definicji i co wydarzyło się później.
Szybka ściągawka do projektowania systemowej tabeli metryk
Projekt produkcyjny powinien być łatwy do skontrolowania podczas incydentu. Poniższa tabela podsumowuje pola, które zazwyczaj mają największe znaczenie.
Kluczowa kolumna | Sugerowany typ | Rola operacyjna | Częstotliwość aktualizacji |
|---|---|---|---|
|
| Identyfikuje mierzony zasób | Każda obserwacja |
|
| Identyfikuje sygnał | Każda obserwacja |
|
| Przechowuje obliczony wynik | Zgodnie z harmonogramem kontroli |
|
| Identyfikuje stan danych | Na obserwację źródłową |
|
| Porównuje migawki strukturalne | Podczas kontroli schematu |
|
| Śledzi wolumen tabeli | Zgodnie z harmonogramem ładowania lub kontroli |
Wzorce zapytań produkcyjnych
Kontrole świeżości: Filtruj ostatnie rekordy o statusie
metric_type = 'freshness'i porównaj najnowszą obserwację ze skonfigurowanym limitem wieku zasobu.Anomalie wolumenu: Używaj ograniczonego okna historycznego, funkcji okna i punktu odniesienia specyficznego dla tabeli, zamiast porównywać każdy wynik z bezpośrednio poprzednim uruchomieniem.
Alerty o dryfie schematu: Porównaj bieżącą migawkę schematu z zatwierdzonym punktem odniesienia i klasyfikuj osobno dodania, usunięcia oraz zmiany typów.
Monitory wskaźnika wartości null: Filtruj według kolumny i typu metryki, a następnie oceń bieżący współczynnik w stosunku do oczekiwanego zakresu kolumny.
Śledzenie opóźnień: Używaj
LAGdla uporządkowanych obserwacji, aby obliczyć odstępy między uruchomieniami i wyizolować opóźnienia w dostawie.
Gotowe do produkcji filtry powinny zawężać dane według table_name, metric_type i okna obserwacji przed zastosowaniem obliczeń. Taka kombinacja wspiera przycinanie partycji, użycie indeksów i niższy koszt dochodzenia.
Progi wymagają kontekstu
Nie istnieje uniwersalna umowa SLA dotycząca świeżości, przedział wolumenu ani granica wskaźnika wartości null, które pasowałyby do każdej tabeli korporacyjnej. Tabela o najwyższym priorytecie może wymagać bardziej rygorystycznych oczekiwań dotyczących dostawy niż zbiór danych o charakterze eksploracyjnym. Źródło aktualizowane codziennie może tolerować inny wzorzec wolumenu niż strumień zdarzeń o wysokiej częstotliwości. Zmiana schematu może być nieszkodliwa dla jednego odbiorcy i blokująca wdrożenie dla innego.
Użyj zachowań historycznych do ustalenia punktu odniesienia, a następnie połącz progi z konsekwencjami i własnością. Wymagaj wielu powiązanych sygnałów przed eskalacją szumliwych warunków i dbaj o to, by rekord alertu był wystarczająco bogaty, by ułatwić przekazanie zadania. Regularnie weryfikuj kontrole, usuwaj pomiary, które nie prowadzą do konkretnych działań, i zachowaj dowody niezbędne do celów governance.
digna pomaga zespołom obliczać i analizować metryki na poziomie tabeli wewnątrz bazy danych, monitorować terminowość i anomalie, walidować rekordy oraz śledzić zmiany schematu bez wyprowadzania danych produkcyjnych poza środowisko klienta. Odwiedź digna, aby zobaczyć, jak jej modułowe możliwości Observability mogą przekształcić systemową tabelę metryk w kontrolowany przepływ pracy dla inżynierów danych, stewardów i właścicieli platform.
Najczęściej zadawane pytania
Czym jest metrics system table?
To operacyjna księga o niskim opóźnieniu zawierająca wyliczone obserwacje o zasobach danych. Jest celowo oddzielona od tabel biznesowych z encjami takimi jak zamówienia, użytkownicy, zdarzenia czy szkody, bo oba obciążenia mają inny kształt i inne wzorce zapytań.
Dlaczego skrypty doraźne nie wystarczą?
Sprawdzają się przy pierwszej kontroli i potem przestają się skalować. Scentralizowana tabela daje inżynierom stabilny interfejs do wykrywania, porównania z linią bazową lub poprzednim okresem, eskalacji z wagą i właścicielem oraz dowodu, co sprawdzono, kiedy się wykonało i jaki dało wynik.
Co powinien zawierać każdy rekord?
Cztery grupy: wymiary takie jak baza, schemat, tabela, kolumna, typ wskaźnika, środowisko i dziedzina biznesowa; miary takie jak wartość obserwowana, liczba dotkniętych wierszy czy wynik anomalii; metadane wykonania, jak czas obliczenia, zadanie źródłowe i wersja kontroli; oraz kontekst governance, czyli właściciel, waga, odniesienie do lineage i stan naprawy.
Kiedy wskaźnik jest naprawdę operacyjny?
Gdy ktoś potrafi go odpytać, wskazać właściciela, zdecydować, jakie działanie ma wywołać, i przejrzeć jego historię. Mniej niż to oznacza zbieraną liczbę, a nie działającą kontrolę, a status potoku odpowiada wyłącznie na pytanie, czy zadanie się wykonało.
Czy ten projekt ma precedens?
Tak, w relacyjnych tabelach systemowych używanych jako warstwa metadanych. Oracle 10g wprowadził tabele metryk liczące delty i tempa, upraszczając pytania w rodzaju bieżącego tempa operacji wejścia-wyjścia bazy, czyli tę samą zmianę architektoniczną od ręcznej inspekcji punktowej do ustandaryzowanego śledzenia bieżącego i historycznego.


