S3 jako system plików
|
7
min. czyt.

Montowanie S3 jako systemu plików jest zazwyczaj błędnym domyślnym wyborem. Zespoły decydują się na to rozwiązanie, ponieważ ścieżka wygląda znajomo, starsze narzędzia nadal działają, a obietnica „po prostu zamontuj bucket” brzmi taniej niż przepisywanie potoków danych. Ten skrót ukrywa niedopasowanie semantyczne, które w analityce przedsiębiorstwa objawia się jako skoki opóźnień, nietypowe zachowanie spójności, chaotyczne governance i nieoczekiwane koszty operacyjne.
Bezpieczniejsza reguła jest prosta. Używaj S3 do tego, do czego służy – jako obiektowej pamięci masowej, chyba że masz wąski zakres zadań, który wymaga semantyki plików. Jeśli potraktujesz punkt montowania jako warstwę wygody, a nie decyzję architektoniczną, skończysz na debugowaniu abstrakcji zamiast dostarczania danych.
Spis treści
Dlaczego montowanie S3 jako systemu plików to zazwyczaj błędny domyślny wybór
Porównanie pamięci obiektowej i systemów plików POSIX
Mapowanie operacji na plikach na zachowanie S3
Zachowanie spójności, którego nie można zignorować
Operacje, które wciąż sprawiają ludziom problemy
Opcje montowania od s3fs i FUSE do S3 Files
Porównuj stos technologiczny, nie marketing
Obciążenia analityczne w warstwie systemu plików S3
Dostosuj konfigurację do faktycznego obciążenia
Ład korporacyjny (governance) i Observability dla dostępu do plików S3
Audytuj warstwę obiektową, a nie tylko punkt montowania
Kiedy S3 jako system plików rzeczywiście ma sens
Używaj go, gdy kompromis jest świadomy
Why Mounting S3 as a File System Is Usually the Wrong Default
Częstym błędem jest zakładanie, że skoro bucket może wyglądać jak katalog, to powinien się tak samo zachowywać. To założenie gubi zespoły, ponieważ punkt montowania ukrywa fakt, że pod spodem S3 nadal jest pamięcią obiektową, charakteryzującą się inną wydajnością, spójnością i zachowaniem metadanych niż dysk lokalny czy udział NFS. Pamięć obiektowa z chęcią zapisze Twoje bajty, ale nie przejmie gwarancji, na które może liczyć Twoja aplikacja.
W środowisku produkcyjnym to właśnie ta różnica staje się źródłem problemów. Inżynierowie używają punktów montowania, aby utrzymać przy życiu stare skrypty, po czym odkrywają, że zadania z dużą liczbą zmian nazw, współdzielone zapisy i przeszukiwanie metadanych zachowują się jak warstwa tłumaczeniowa, a nie natywny system plików. Rezultatem jest często większa liczba ruchomych elementów, ukrytych ponownych prób i miejsc, w których koszty wymykają się spod kontroli z powodu lawinowego wzrostu liczby żądań i rotacji w pamięci podręcznej.
Zasada praktyczna: jeśli obciążenie wymaga jedynie „folderu”, nie oznacza to, że wymaga systemu plików.
Sposób, w jaki samo AWS rozwijało S3, doskonale to udowadnia. Od momentu uruchomienia 14 marca 2006 roku z pojemnością około 1 petabajta na około 400 węzłach pamięci masowej w 15 szafach serwerowych i łączną przepustowością 15 Gb/s, S3 urosło do platformy przechowującej ponad 500 bilionów obiektów i obsługującej ponad 200 milionów żądań na sekundę na całym świecie do marca 2026 r., w obrębie 123 stref dostępności w 39 regionach AWS (AWS S3 history and scale). Taka skala sprawia, że S3 doskonale sprawdza się przy obciążeniach obiektowych, ale nie zamienia go w magiczny sposób w dysk POSIX. Jeśli Twoja architektura zależy od zachowania lokalnych plików, musisz udowodnić, dlaczego punkt montowania jest tam niezbędny.
W przypadku zespołów projektujących platformę od zera, pierwsze pytanie nie brzmi „czy możemy to zamontować?”. Brzmi ono: „jaki tryb awarii na siebie sprowadzamy?”. Jeśli chcesz przeprowadzić rzetelny przegląd projektu systemu wokół tego pytania, właściwym punktem wyjścia jest this data system architecture guide.
Porównanie pamięci obiektowej i systemów plików POSIX
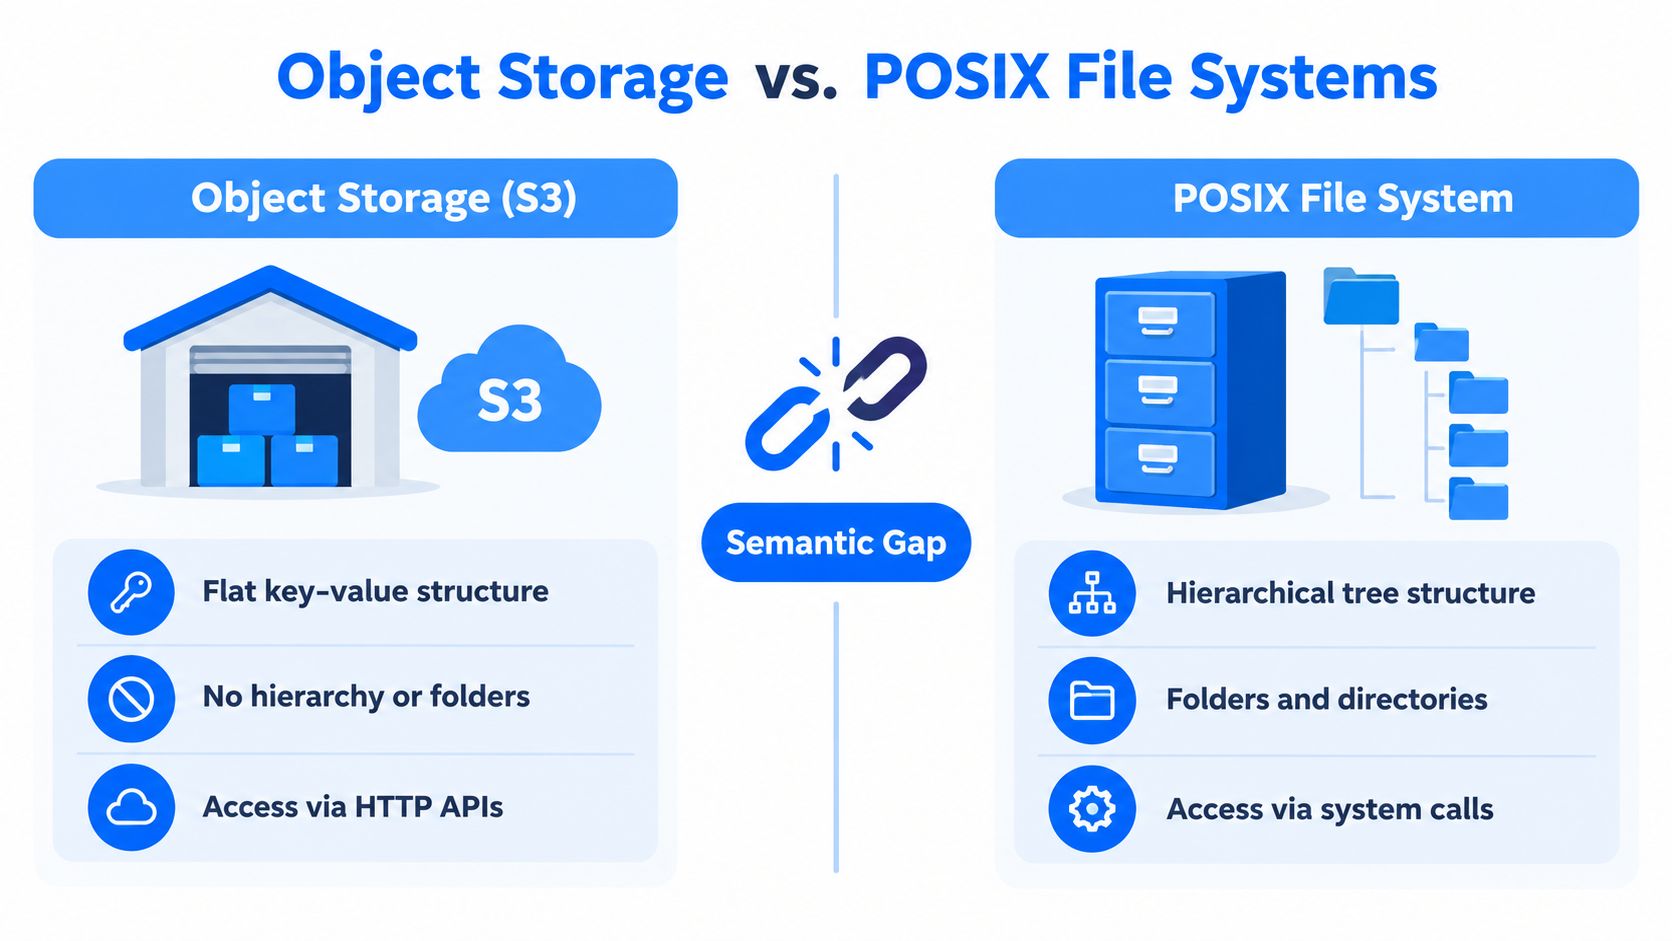
Pomyśl o tym w kategoriach magazynu. Bucket to magazyn, obiekt to zapieczętowana skrzynia, a klucz to etykieta na skrzyni. Możesz przenosić skrzynie, zastępować je i listować etykiety, ale nie możesz otworzyć skrzyni i edytować jednej strony w jej wnętrzu, tak jak edytujesz dokument na laptopie. To jest właśnie ta luka semantyczna, którą każda warstwa montowania musi ukryć.
Mapowanie operacji na plikach na zachowanie S3
Zacznijmy od open. W POSIX otwarcie pliku to zwykłe wywołanie systemowe w hierarchicznym systemie plików. W S3 „otwarcie” to w rzeczywistości decyzja klienta o pobraniu obiektu lub przygotowaniu ścieżki zapisu za pomocą warstwy tłumaczeniowej. System może sprawić, że będzie to wyglądać znajomo, ale mechanizm pod spodem nadal opiera się na obiektach.
Teraz zamapujmy zapis częściowy i nadpisanie. W systemie plików często można modyfikować bajty w miejscu. W S3 obiekt jest zastępowany w całości. Dlatego przepływy pracy zorientowane na pliki, które zakładają edycję przyrostową, mogą stać się kosztowne lub kłopotliwe po przetłumaczeniu na operacje obiektowe (object-store behavior and overwrite differences). Model pamięci masowej nie zachowuje się jak zmienny blok pamięci współdzielonej.
Na koniec rozważmy zmianę nazwy (rename) i atomową zmianę nazwy. W POSIX semantyka zmiany nazwy jest częścią kontraktu systemu plików. W S3 zmiana nazwy jest emulowana, zazwyczaj jako kopiowanie i usunięcie lub zmiana metadanych w warstwie montowania. To właśnie tutaj pojawiają się niespodzianki, ponieważ przeniesienie katalogu może przerodzić się w serię operacji obiektowych zamiast pojedynczej operacji atomowej.
Punkt montowania może tłumaczyć nazwy. Nie potrafi jednak stworzyć semantyki.
Krótkie wyjaśnienie dla interesariuszy jest bezlitosne. S3 to płaska przestrzeń nazw obiektów z nałożoną warstwą prezentacji przypominającą pliki. POSIX to hierarchiczny system plików z natywną semantyką katalogów i modyfikacji. Im bardziej Twoje obciążenie opiera się na edycjach atomowych, blokowaniu i zmianach nazw, tym bardziej warstwa tłumaczeniowa musi udawać coś, czego backend pamięci masowej nigdy nie obiecywał.
Zachowanie spójności, którego nie można zignorować
Spójność S3 to moment, w którym wiele założeń dotyczących systemu plików zaczyna pękać. Amazon S3 zapewnia obecnie silną spójność typu read-after-write dla operacji GET, PUT i LIST we wszystkich regionach AWS, a AWS gwarantuje, że to, co zapiszesz, będzie tym, co odczytasz (S3 consistency model). Eliminuje to istotną klasę niespodzianek, ale nie zamienia S3 w system plików POSIX.
Operacje, które wciąż sprawiają ludziom problemy
Użytkownik wciąż może napotkać problemy, gdy aplikacja zakłada koordynację na poziomie systemu plików, która nie istnieje. Przepływy pracy związane z nadpisywaniem, wzorce zmiany nazw w stylu katalogów oraz ścieżki dostępu wymagające dużej ilości metadanych nadal zależą od warstwy montowania, która musi dodać synchronizację lub buforowanie, których samo S3 nie zapewnia. Gdy zespoły to ignorują, ostatecznie stykają się z nieaktualnymi odczytami, wyścigami (race conditions) lub niespójnością typu split-brain w przepływach pracy z wieloma klientami, szczególnie gdy wielu zapisujących korzysta z tej samej przestrzeni nazw.
Ryzyko nie jest teoretyczne. Jedno zadanie może zapisywać dane, drugie może listować ten sam prefiks i oba mogą uważać, że są właścicielami tej samej logicznej ścieżki. Jeśli potok danych oczekuje atomowego zastąpienia katalogu lub blokowania plików, abstrakcja musi zapewnić koordynację nałożoną na semantykę obiektową, a ta koordynacja staje się kolejnym punktem potencjalnej awarii.
Operacja | Zachowanie POSIX | Zachowanie S3 | Ryzyko dla użytkowników systemu plików |
|---|---|---|---|
Utworzenie i odczyt | Natywne utworzenie pliku, a następnie natychmiastowy odczyt | Silnie spójne dla nowych obiektów | Niższe ryzyko, ale zachowanie punktu montowania wciąż ma znaczenie |
Nadpisanie | Semantyka aktualizacji pliku w miejscu | Semantyka zastępowania obiektów | Czytelnicy mogą nie otrzymać zachowania aktualizacji typowego dla plików |
Zmiana nazwy katalogu | Pozornie atomowe przeniesienie przestrzeni nazw | Emulowane przez operacje na obiektach lub warstwę metadanych | Osierocone klucze, częściowe przeniesienia, ukryte ponowne próby |
Listowanie katalogu | Natywne metadane katalogu | Listowanie kluczy obiektów w oparciu o prefiks | Listowanie dużych zbiorów może stać się wolne i generować szum operacyjny |
AWS S3 Files dostarcza kolejnego sygnału, że ta abstrakcja ma swoje granice. Dokumentacja ujawnia wyraźne limity, takie jak 25 000 połączeń na system plików i 10 000 punktów dostępowych na system plików, co przypomina, że punkt montowania to nie to samo co dysk lokalny (S3 Files limits and behavior). Projektuj z uwzględnieniem tych limitów, zamiast łudzić się, że one nie istnieją.
Dla zespołów odpowiedzialnych za potoki danych najbezpieczniejszym nawykiem jest kierowanie każdego przepływu pracy wrażliwego na spójność przez jednoznacznego właściciela i jawny krok walidacji. Jeśli potrzebujesz praktycznej listy kontrolnej do wykrywania takich rozbieżności, użyj data consistency checks jako modelu myślenia o tym problemie.
Opcje montowania od s3fs i FUSE do S3 Files
Nie każdy punkt montowania S3 jest zbudowany tak samo. Niektóre opcje istnieją po to, aby utrzymać przy życiu starsze narzędzia, inne mają na celu zmniejszenie tarć operacyjnych, a jeszcze inne lepiej opisać jako warstwy dostępu niż prawdziwe systemy plików. Właściwy wybór zależy od tego, czy potrzebujesz dostępu do odczytu, zapisu przelotowego, współdzielonych modyfikacji, czy też czystszego sposobu na zasilanie silników analitycznych, które już natywnie obsługują pamięć obiektową.
Porównuj stos technologiczny, nie marketing
s3fs i podobne rozwiązania oparte na FUSE są zazwyczaj pierwszym przystankiem dla zespołów, które potrzebują szybkiego pomostu kompatybilności. Są wygodne, ale wprowadzają dodatkową warstwę procesów, dodatkowe opóźnienia i większe ryzyko powstawania wąskich gardeł, gdy pojedynczy węzeł staje się punktem przeciążenia. Mogą być odpowiednie do lekkich zastosowań interaktywnych lub jako tymczasowe rusztowanie migracyjne, ale są kiepskim domyślnym wyborem dla obciążonych potoków korporacyjnych.
Goofys i Mountpoint for S3 należą do tej samej szerokiej rodziny warstw kompatybilności. Mogą usprawnić określone wzorce dostępu, ale nadal nie eliminują niedopasowania semantycznego między pamięcią obiektową a semantyką plików. Używaj ich, gdy głównym celem jest „niech to narzędzie teraz zadziała”, a nie „budujmy wokół tego platformę na stałe”.
Nowsza usługa AWS – S3 Files – ma inne przeznaczenie. AWS pozycjonuje ją jako współdzielony system plików dla EC2, Lambda, EKS i ECS, z dostępem NFS 4.1 i 4.2 oraz dwukierunkową synchronizacją między zamontowanym systemem plików a bucketem (S3 Files behavior and regions). To sprawia, że rozwiązanie jest bardziej natywne niż zwykła nakładka FUSE, ale nadal nie jest to dysk POSIX. Ten kompromis projektowy jest lepszy dla współdzielonego dostępu niż dla losowych zapisów w stylu bazodanowym.
Natywne API pamięci obiektowej to najczystsza odpowiedź, gdy Twój silnik już je obsługuje. Spark, Trino i DuckDB uzyskują lepszą równoległość i czystsze skalowanie, gdy komunikują się bezpośrednio z S3, zamiast przechodzić przez punkt montowania próbujący naśladować katalogi. Jeśli narzędzie potrafi już wykonywać równoległe listowanie, wektoryzowane odczyty czy pushdown predykatów, nie zmuszaj go do działania przez plikową nakładkę.
Opcja | Stos technologiczny | Obsługa zapisu | Limit przepustowości | Najlepsze zastosowanie |
|---|---|---|---|---|
s3fs | Klient oparty na FUSE | Ograniczona, zorientowana na kompatybilność | Często ograniczana przez węzeł klienta | Starsze narzędzia i krótkotrwałe prace migracyjne |
Inne punkty montowania FUSE | Warstwa kompatybilności | Zależy od implementacji | Zależy od narzutu tłumaczenia | Dostęp z przewagą odczytu przy niskiej współbieżności |
S3 Files | Zarządzany przez AWS interfejs systemu plików nad S3 | Dwukierunkowa synchronizacja | Lepszy dla współdzielonego dostępu, wciąż nienatywny dla POSIX | Współdzielone zasoby obliczeniowe i współpraca oparta na plikach |
Natywne API obiektowe | Bezpośrednia integracja z SDK S3 lub silnikiem | Pełna semantyka obiektowa | Skaluje się wraz z równoległością pamięci obiektowej | Spark, Trino, DuckDB i nowoczesna analityka |
Rekomendacja jest jasna. Używaj punktów montowania tylko do odczytu, gdy musisz zachować stare narzędzia. Punktów montowania z zapisem przelotowym używaj wyłącznie z jawnymi regułami ponawiania, zasadami własności i ścieżkami wycofywania zmian. Preferuj natywne API obiektowe wszędzie tam, gdzie narzędzie je obsługuje, ponieważ jest to ścieżka, która skaluje się bezproblemowo w analityce. Jeśli chcesz spojrzeć szerzej na projektowanie potoków, ETL data pipeline guide to schemat, którego zespół platformy powinien użyć przed zatwierdzeniem punktu montowania.
Obciążenia analityczne w warstwie systemu plików S3
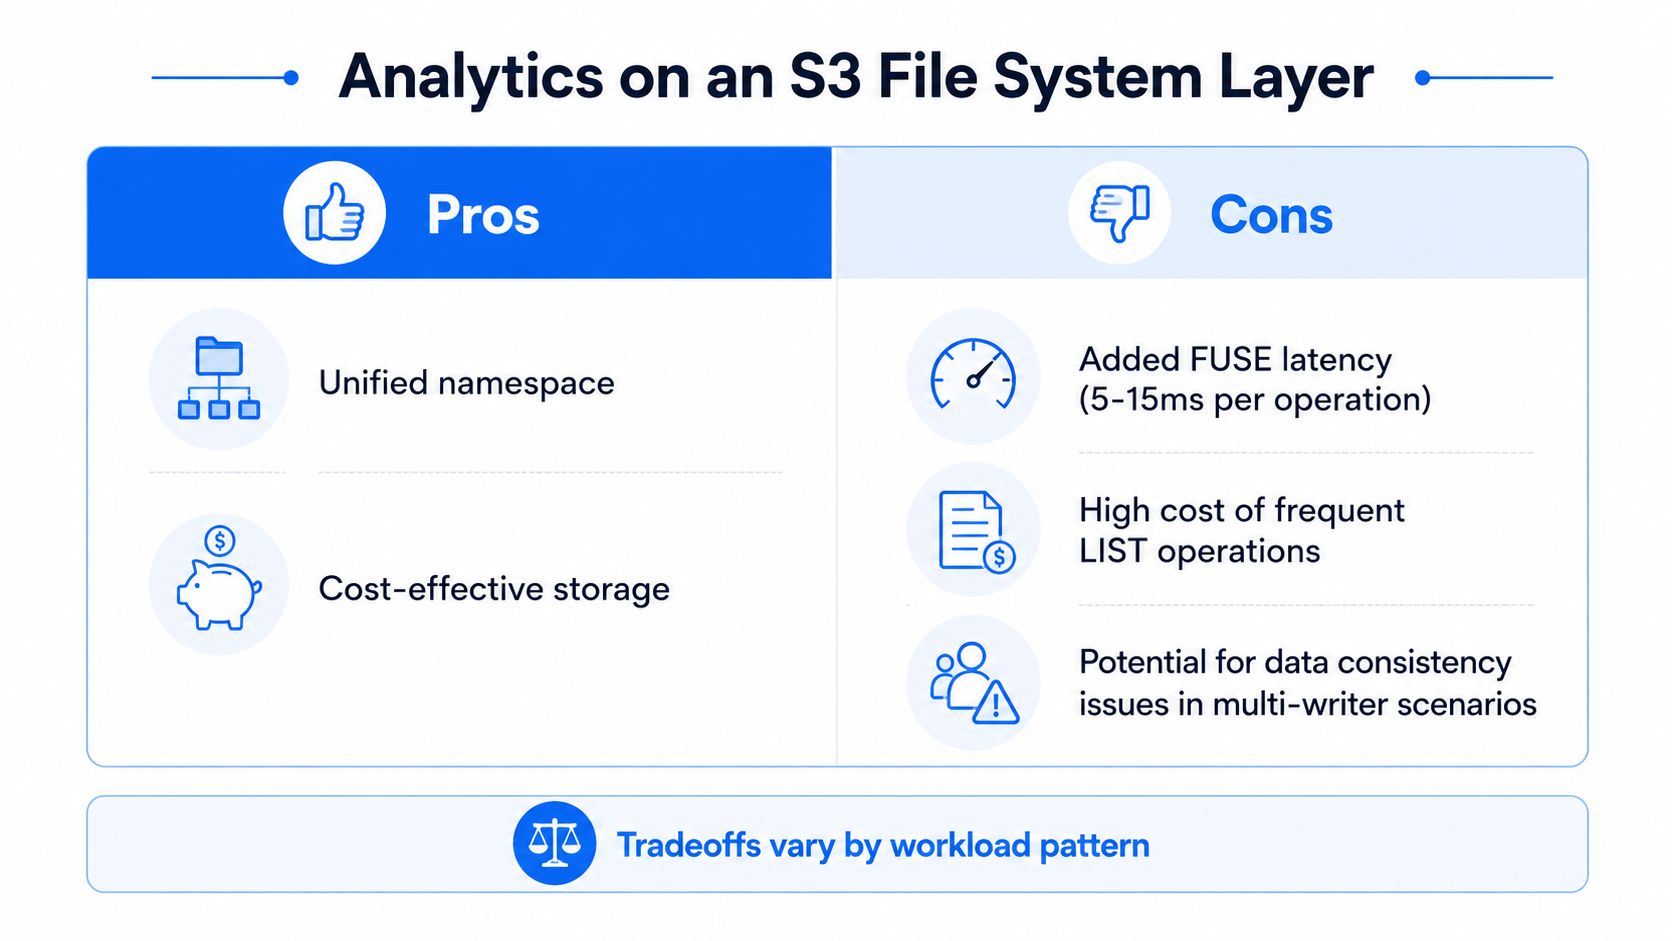
Obciążenia analityczne szybko ujawniają słabe punkty, ponieważ operują zarówno na bajtach, jak i na metadanych. Zadania Spark i Hive mogą tolerować etapowe odczyty, jeśli wzorzec dostępu jest głównie sekwencyjny, ale gdy obciążenie zaczyna skanować katalogi, zmieniać nazwy partycji lub generować masę małych plików, warstwa montowania staje się kosztowna – zarówno pod względem czasu, jak i ruchu w warstwie sterowania. Trino i DuckDB zazwyczaj radzą sobie lepiej, gdy mogą komunikować się z S3 bezpośrednio, ponieważ unikają abstrakcji plikowej, która nigdy nie była budowana z myślą o dynamicznych metadanych.
Dostosuj konfigurację do faktycznego obciążenia
Jeśli zadanie ma charakter wsadowy, etapowe przesyłanie danych przez S3 wciąż może mieć sens, gdy wzorzec odczytu jest przewidywalny, a dane wyjściowe są zapisywane jednorazowo. W takim przypadku skup się na ograniczeniu niepotrzebnego przeszukiwania katalogów i pozwól silnikowi odczytywać większe fragmenty zamiast udawać, że każdy wiersz zasługuje na niezależne odpytanie pliku. Narzędzia obsługujące odczyt z wyprzedzeniem (read-ahead), równoległe zakresy GET lub pushdown predykatów zazwyczaj osiągają lepsze wyniki niż ogólny punkt montowania, ponieważ pozostają bliżej semantyki obiektowej.
Innym problematycznym obszarem są małe pliki. Warstwa systemu plików sprawia, że namnażanie małych plików wygląda nieszkodliwie, dopóki operacje listowania i metadanych nie zaczną dominować w zadaniu. Problemem stają się również zapisy tabel z dużą liczbą zmian nazw, ponieważ punkt montowania musi emulować zachowanie, którego pamięć obiektowa natywnie nie zapewnia. W takich sytuacjach formaty tabel takie jak Iceberg i Hudi udowadniają swoją wartość, ponieważ kodują własne warstwy spójności i metadanych zamiast polegać na sztuczkach z katalogami.
Zasada praktyczna: jeśli Twój układ danych polega na zmianie nazwy jako mechanizmie zatwierdzania (commit), rozwiązujesz problem formatu tabeli za pomocą instalacji hydraulicznej pamięci masowej.
Kwestia kosztów również ma znaczenie. Częste operacje LIST na dużych bucketach są antywzorcem dla analityki opartej na punktach montowania, ponieważ każde ułatwienie zorientowane na pliki może przełożyć się na dodatkowe żądania i opóźnienia. Dlatego bezpośrednia ścieżka do S3 jest zazwyczaj lepszym wyborem dla dużych zbiorów danych przedsiębiorstwa, zwłaszcza gdy zespół platformy monitoruje już wzorce zapytań, liczbę plików i rotację obiektów.
Dla zespołów, które potrzebują opomiarowania tych kompromisów, widok operacyjny jest tak samo ważny jak silnik zapytań. Właściwy wzorzec monitorowania powinien znaleźć się w data lake monitoring, a nie w jednorazowym skrypcie montowania.
Ład korporacyjny (governance) i Observability dla dostępu do plików S3
Gdy S3 zostanie udostępnione jako system plików, governance musi podążać za danymi, a nie za iluzją folderów. Granice IAM nadal mają znaczenie na poziomie bucketu lub prefiksu, szyfrowanie KMS wciąż ma znaczenie dla danych w spoczynku, a polityki punktów końcowych VPC nadal są kluczowe, jeśli chcesz zapobiec przypadkowemu wyciekowi danych do sieci publicznej. Ścieżka pliku może wyglądać znajomo dla użytkowników, ale warstwa sterowania pod spodem to wciąż pamięć obiektowa, więc Twój model uprawnień musi odpowiadać semantyce obiektów.
Audytuj warstwę obiektową, a nie tylko punkt montowania
Dzienniki audytu systemu plików tutaj nie wystarczą. Punkt montowania może ukrywać operacje na poziomie obiektów przed osobami, które patrzą tylko na ślady w stylu POSIX. Oznacza to, że zespół ds. bezpieczeństwa potrzebuje logów dostępu S3, zdarzeń danych CloudTrail i telemetrii pamięci masowej w tym samym potoku monitorowania. Bez tego można przeoczyć niespójności, nieaktywne punkty montowania, wycieki poświadczeń na hostach typu bastion oraz wzorce GET, które wyglądają normalnie dla klienta plikowego, ale podejrzanie dla osoby reagującej na incydenty.
Klasyfikacja danych również staje się trudniejsza. Ścieżka pliku w zamontowanej przestrzeni nazw nie mapuje się jeden do jednego na listę ACL czy politykę obiektową, dlatego zespoły potrzebują jasnych reguł określających, kto i co może widzieć oraz gdzie te reguły są egzekwowane. Jeśli ten sam bucket jest używany przez wiele narzędzi, potrzebne są również konwencje własności, które zapobiegają niejednoznacznym ścieżkom zapisu i przypadkowym kolizjom w przestrzeni nazw.
AWS S3 Files dodaje jedną szczególnie przydatną regułę operacyjną. Jeśli ten sam element zostanie zmieniony zarówno w systemie plików, jak i bezpośrednio w buckecie, AWS traktuje bucket jako źródło prawdy i przenosi konfliktowy plik do katalogu lost-and-found. AWS zaleca wybranie albo systemu plików, albo S3 jako głównego źródła zapisu (S3 Files best practices). To w równym stopniu polityka governance, co szczegół techniczny, ponieważ zmusza zespoły do wskazania źródła prawdy, zanim powstanie chaos.
W przypadku korporacyjnych platform danych zadaniem jest ciągłe monitorowanie samej warstwy. Jeśli punkt montowania się rozjedzie, wyciekną dane uwierzytelniające lub obciążenie zacznie generować lawinę żądań GET w sposób odbiegający od oczekiwanego wzorca, zespół platformy powinien to zauważyć zanim odczuje to biznes. To dokładnie taki rodzaj widoczności, jaki ma zapewniać platforma klasy Data Observability.
Kiedy S3 jako system plików rzeczywiście ma sens
Używaj S3 jako systemu plików tylko wtedy, gdy obciążenie uzasadnia tę abstrakcję. Przejściowe przygotowywanie danych dla pojedynczego zadania wsadowego jest w porządku. Starsze narzędzia powiązane z POSIX, których nie można przepisać w harmonogramie projektu, są w porządku. Analityka oparta głównie na odczycie formatów Parquet lub tabelarycznych, które same zarządzają swoimi metadanymi, również jest w porządku, zwłaszcza gdy celem jest uniknięcie powielania kopii i niepotrzebnego przenoszenia danych.
Używaj go, gdy kompromis jest świadomy
To, co nie powinno trafiać na punkt montowania oparty na S3, to baza danych z losowym zapisem, współdzielony obszar roboczy o dużej zmienności lub architektura mikrousług, która używa punktu montowania tak, jakby był to współdzielony dysk o niskich opóźnieniach. Systemy te wymagają silniejszej semantyki plików, niż pamięć obiektowa może zapewnić poprzez warstwę tłumaczeniową, i zazwyczaj zawodzą dokładnie tam, gdzie współbieżność i modyfikacje mają największe znaczenie.
Przejrzysty model decyzyjny polega na ocenie potencjalnego obciążenia pod kątem sześciu pytań.
Częstotliwość zapisu. Jeśli zapisy są częste i małe, zrezygnuj.
Wzorce listowania. Jeśli aplikacja stale przeszukuje katalogi, zrezygnuj.
Tolerancja opóźnień. Jeśli kilka dodatkowych cykli zapytanie-odpowiedź psuje przepływ pracy, zrezygnuj.
Limit kosztów. Jeśli wzrost liczby żądań ma większe znaczenie niż koszt pamięci, zrezygnuj.
Poziom bezpieczeństwa. Jeśli egzekwowanie polityki zależy wyłącznie od semantyki ścieżki, zrezygnuj.
Ścieżka wycofania (rollback). Jeśli nie możesz powrócić do bezpośredniego korzystania z API S3 lub innego magazynu danych, nawet nie zaczynaj.
Uczciwa rekomendacja jest prosta. Używaj punktu montowania, gdy celem jest kompatybilność, a obciążenie jest wąskie. Unikaj go, gdy wymaganiem są współdzielone modyfikacje, złożona współbieżność lub zachowanie typowe dla baz danych. S3 to doskonały fundament platformy danych, ale nakładka systemu plików nie zamieni go w NAS ogólnego przeznaczenia.

Jeśli Twój zespół podejmuje decyzję o udostępnieniu S3 jako punktu montowania, digna może pomóc Ci utrzymać przejrzystość warstwy danych dzięki Observability monitorującemu terminowość (Timeliness), zmiany schematów, anomalie oraz zachowanie platformy w Twoim własnym środowisku. Odwiedź digna, aby przekonać się, jak platforma Data Observability pomaga monitorować długofalowe skutki takich wyborów architektonicznych, zanim punkt montowania doprowadzi do awarii na produkcji.
Najczęściej zadawane pytania
Czy warto montować S3 jako system plików?
Zwykle nie. Montowanie to zły domyślny wybór, bo ukrywa fakt, że pod spodem wciąż jest magazyn obiektowy o innym zachowaniu wydajności, spójności i metadanych niż dysk lokalny czy udział NFS. Używaj S3 jako magazynu obiektowego, chyba że wąskie obciążenie naprawdę wymaga semantyki plikowej.
Dlaczego bucket wyglądający jak katalog nie zachowuje się jak katalog?
Bo wygląd katalogu jest emulacją. Częstym błędem jest założenie, że skoro bucket może wyglądać jak folder, powinien się jak folder zachowywać, a na produkcji właśnie tam zaczyna się ból.
Jak operacje POSIX odwzorowują się na S3?
Niedoskonale. Otwarcie to w rzeczywistości decyzja klienta o pobraniu obiektu lub przygotowaniu ścieżki zapisu przez warstwę tłumaczącą, zapis częściowy i nadpisanie zastępują cały obiekt, a zmiana nazwy jest wzorcem emulacji, zwykle kopiowaniem z usunięciem albo przepisaniem metadanych w warstwie montowania.
Jakie pytanie powinno zastąpić „czy da się to zamontować?”
„Jaki tryb awarii kupujemy?” Jeśli obciążenie potrzebuje tylko folderu, nie znaczy to, że potrzebuje systemu plików, a odpowiedź najpierw na pytanie o tryb awarii zwykle usuwa montowanie z projektu.
Jak bardzo S3 urosło od startu?
Z około 1 petabajta na mniej więcej 400 węzłach składowania w 15 szafach i 15 Gb/s łącznego pasma w dniu startu 14 marca 2006 r. do ponad 500 bilionów obiektów i ponad 200 milionów żądań na sekundę globalnie w marcu 2026 r., w 123 strefach dostępności w 39 regionach AWS.



