9 rodzajów wykrywania anomalii w praktyce
|
10
min. czyt.

Większość porad o wykrywaniu anomalii zaczyna się od algorytmów. To odwrotna kolejność. Wykrywanie anomalii zaczyna się od właściwej definicji normalności.
Żadna pojedyncza metoda nie pasuje do każdego zbioru danych, bo anomalie przybierają różne formy. Anomalia punktowa to jedna dziwna wartość, na przykład nagły skok nieudanych płatności. Anomalia kontekstowa wygląda źle dopiero w kontekście, jak normalnie wyglądający wolumen transakcji pojawiający się o niewłaściwej godzinie. Anomalia zbiorowa to wzorzec rozłożony na wiele rekordów albo kroków czasowych, na przykład spóźniona partia, po której następuje fala nadrabiania. W praktyce zespoły muszą też oddzielać problemy jednowymiarowe od wielowymiarowych, bo jedna kolumna zachowująca się dziwnie to coś zupełnie innego niż kilka pól dryfujących razem.
To rozróżnienie ma głębokie korzenie. Nowszy przegląd historyczny cofa wczesne myślenie o anomaliach w szeregach czasowych do Bernoulliego w 1777 roku, potem do rozróżnienia typów anomalii przez Foxa w 1972 i rozszerzenia Tsaya w 1988, podczas gdy współczesna praktyka wciąż opiera się na anomaliach punktowych, kontekstowych i zbiorowych jako kategoriach podstawowych (historyczny przegląd wykrywania anomalii w szeregach czasowych). To wciąż właściwy punkt wyjścia przy wyborze spośród głównych rodzajów wykrywania anomalii.
Praktyczna reguła sprawdza się lepiej niż uniwersalny przepis. Używaj walidacji deterministycznej dla znanych warunków. Używaj metod statystycznych albo szeregów czasowych, gdy zachowanie jest mierzalne i powtarzalne. Używaj uczenia maszynowego, gdy wzorce są złożone, wielowymiarowe albo zmieniają się zbyt szybko dla statycznej logiki. Platformy takie jak digna łączą metody statystyczne, uczenie maszynowe, walidację, Timeliness i monitorowanie schematu wewnątrz infrastruktury klienta, gdy ten model eksploatacji ma znaczenie.
Spis treści
1. Uczenie statystycznych linii bazowych
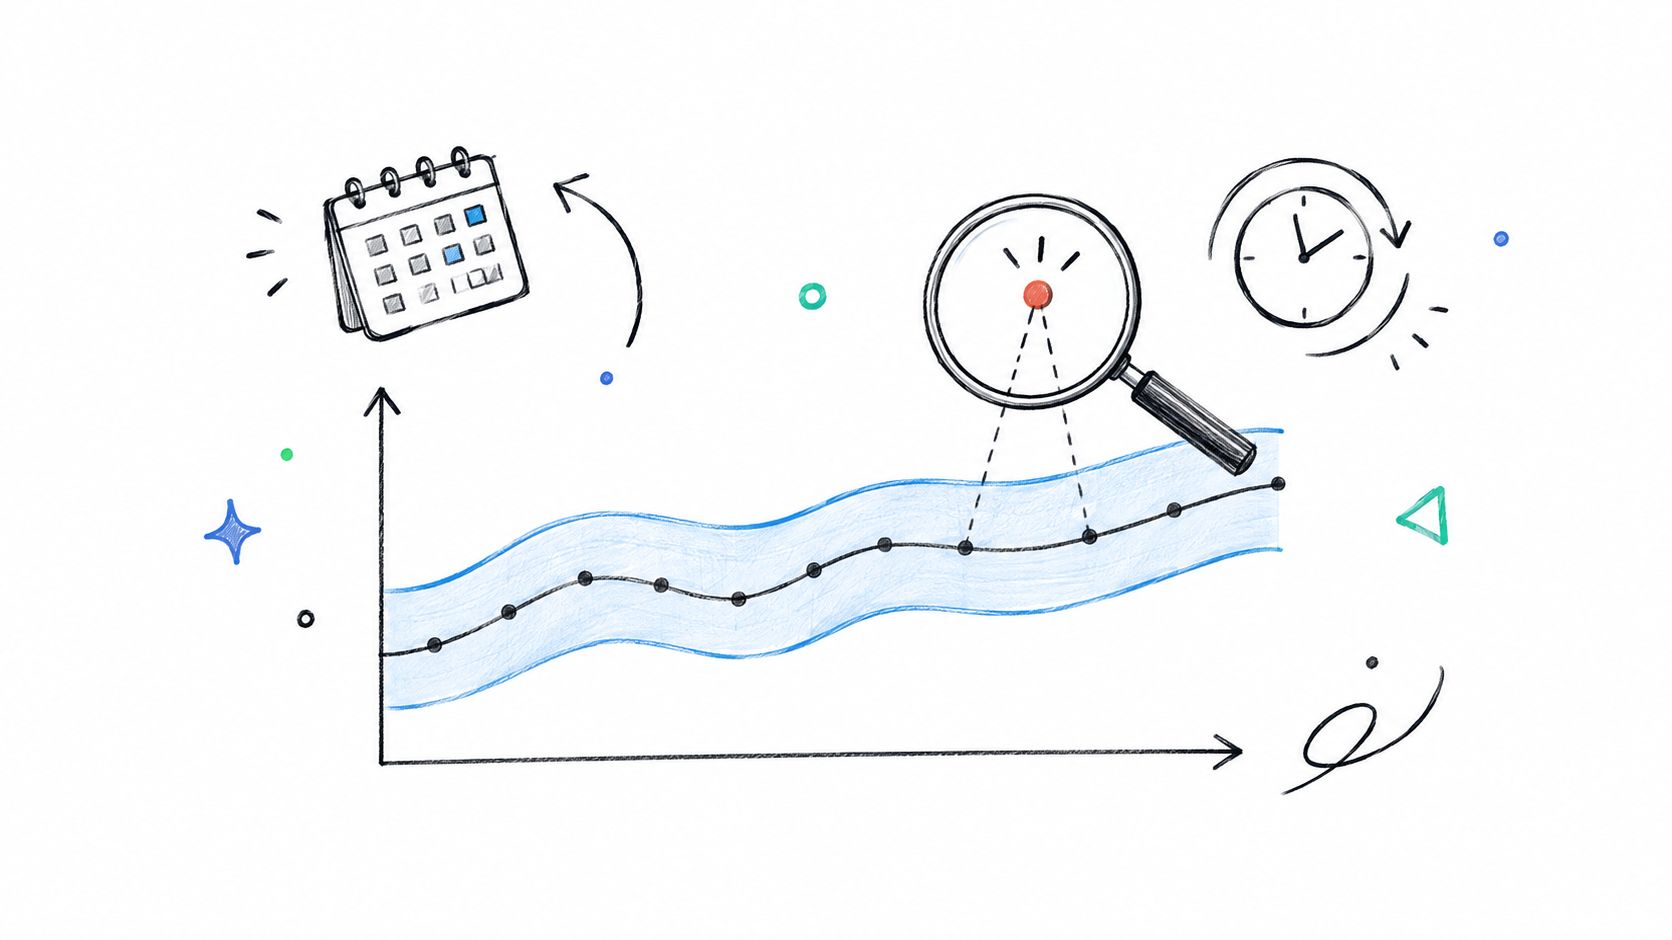
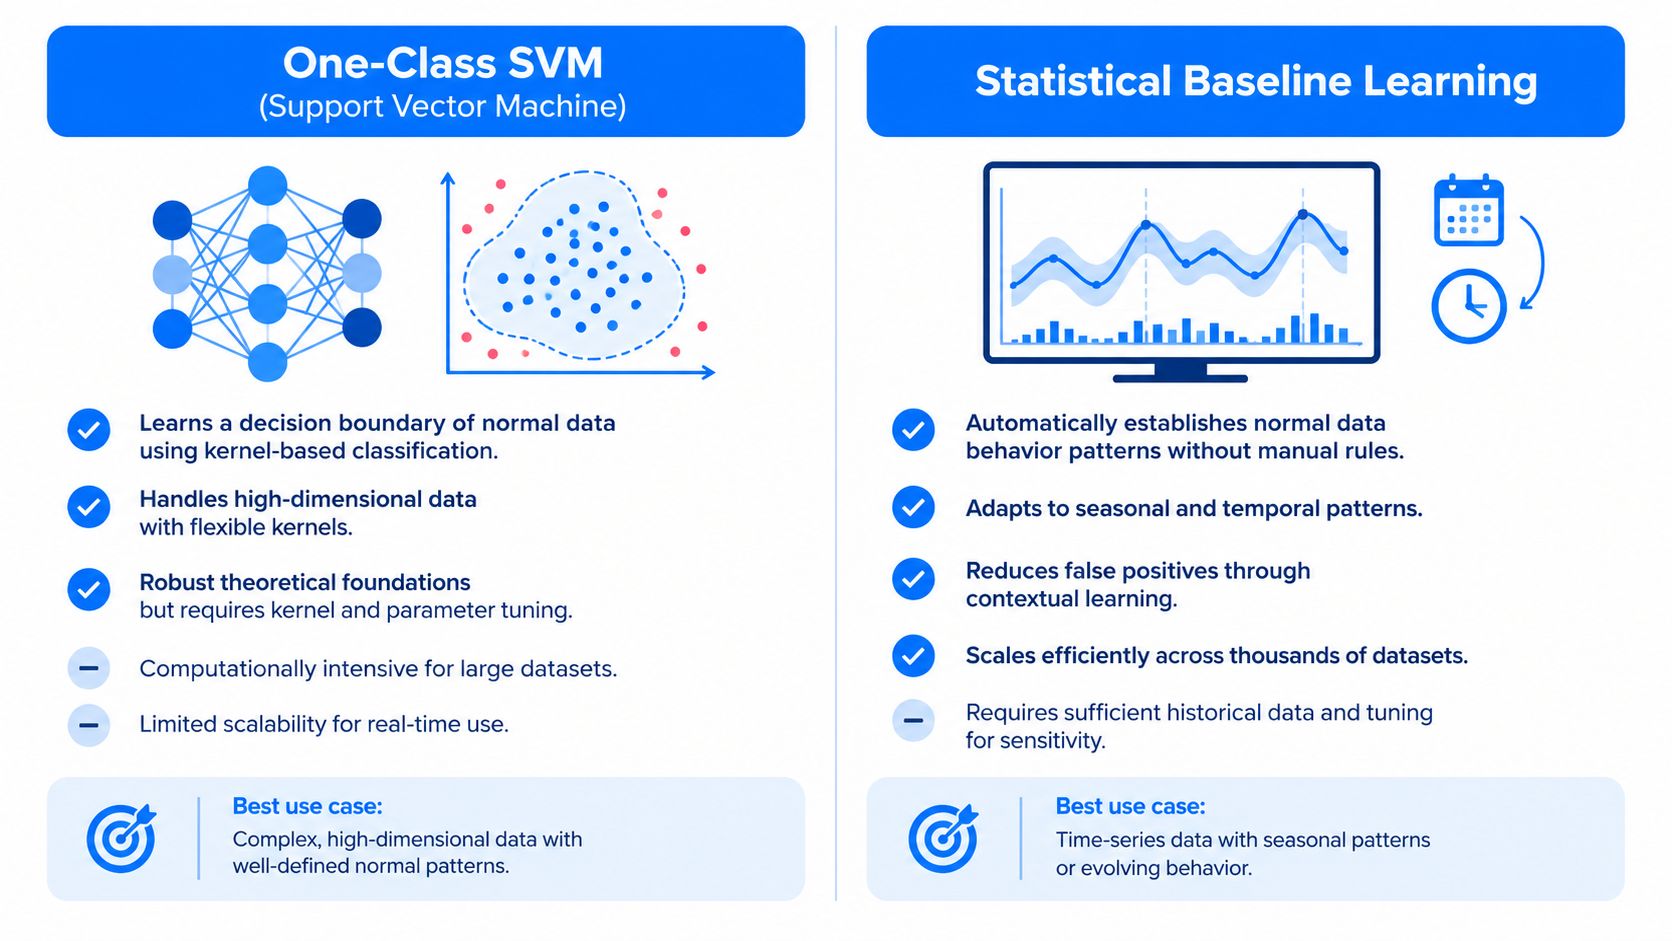
Niektóre zespoły nazywają to „wykrywaniem anomalii z AI”, ale użyteczna idea jest prostsza. System uczy się z historii, jak wygląda normalne zachowanie, a potem zgłasza odchylenia od tej linii bazowej.
Ta metoda działa najlepiej, gdy metryka ma rozpoznawalne zachowanie w czasie. Liczba transakcji może rosnąć w dni robocze i spadać w weekendy. Dane o szkodach mogą napływać przewidywalnymi falami. Zdarzenia wsparcia mogą skakać każdego ranka, a potem się stabilizować. Model linii bazowej wchłania te wzorce lepiej niż sztywny próg.
Oto intuicja wizualna.
Jakich dowodów używa
Uczenie linii bazowych opiera się na obserwowanym zachowaniu statystycznym w czasie. Zamiast pytać „czy ta wartość przekroczyła stały limit”, pyta „czy ta wartość jest nietypowa dla tego zbioru, o tej porze, przy tym niedawnym wzorcu”.
To czyni je praktycznym dopasowaniem do obserwowalności danych. Zespół finansowy może obserwować dzienny wolumen transakcji. Zespół operacji w ochronie zdrowia może monitorować strumienie przyjęć. Platforma danych telekomunikacyjnych może śledzić spóźnione rekordy użycia. W każdym przypadku model uczy się oczekiwanych zakresów, trendów i powtarzalnej zmienności.
Przydatnym pojęciem tła jest rozkład danych w analizie anomalii. Zespoły, które rozumieją rozrzut, skośność i oczekiwaną zmienność, zwykle skuteczniej stroją linie bazowe.
Reguła praktyczna: łącz uczenie linii bazowych z kontrolami deterministycznymi na zbiorach o wysokim ryzyku. Wyuczone zachowanie łapie dryf. Reguły łapią znane naruszenia.
Gdzie pomaga, a gdzie sobie nie radzi
Pomaga, gdy „normalne” zmienia się w czasie, ale wciąż trzyma się wzorca. Nie radzi sobie, gdy masz za mało historii, gdy proces zmienił się w zeszłym tygodniu albo gdy metryka jest w większości szumem.
Przykłady:
Finanse: nieoczekiwany dryf wolumenu transakcji, choć żaden próg nie został przekroczony
Ochrona zdrowia: nietypowe przesunięcia aktywności pacjentów między placówkami
Telekomunikacja: nienormalne tempo napływu danych w potokach ingestii
Częste kompromisy:
Mocne w interpretowalności: zespoły zwykle widzą oczekiwane pasmo i potrafią wyjaśnić, dlaczego odpalił alert
Wrażliwe na złe okna treningowe: okresy incydentów mogą zanieczyścić linię bazową
Lepsze z kontrolami wspierającymi: kontrole walidacji i Timeliness zwiększają zaufanie
2. Isolation Forest
Isolation Forest to metoda uczenia maszynowego, która wygląda dziwnie tylko do chwili, gdy wyobrazisz sobie, co robi. Wciąż dzieli dane losowo na mniejsze partycje. Punkty, które szybko zostają odizolowane, są bardziej prawdopodobnymi anomaliami.
To podejście czyni ją użyteczną dla danych wielowymiarowych. Jeśli oceniasz wiele cech naraz, metody oparte na odległości robią się niewygodne. Isolation Forest omija część tej złożoności, skupiając się na tym, jak łatwo oddzielić punkt od reszty.
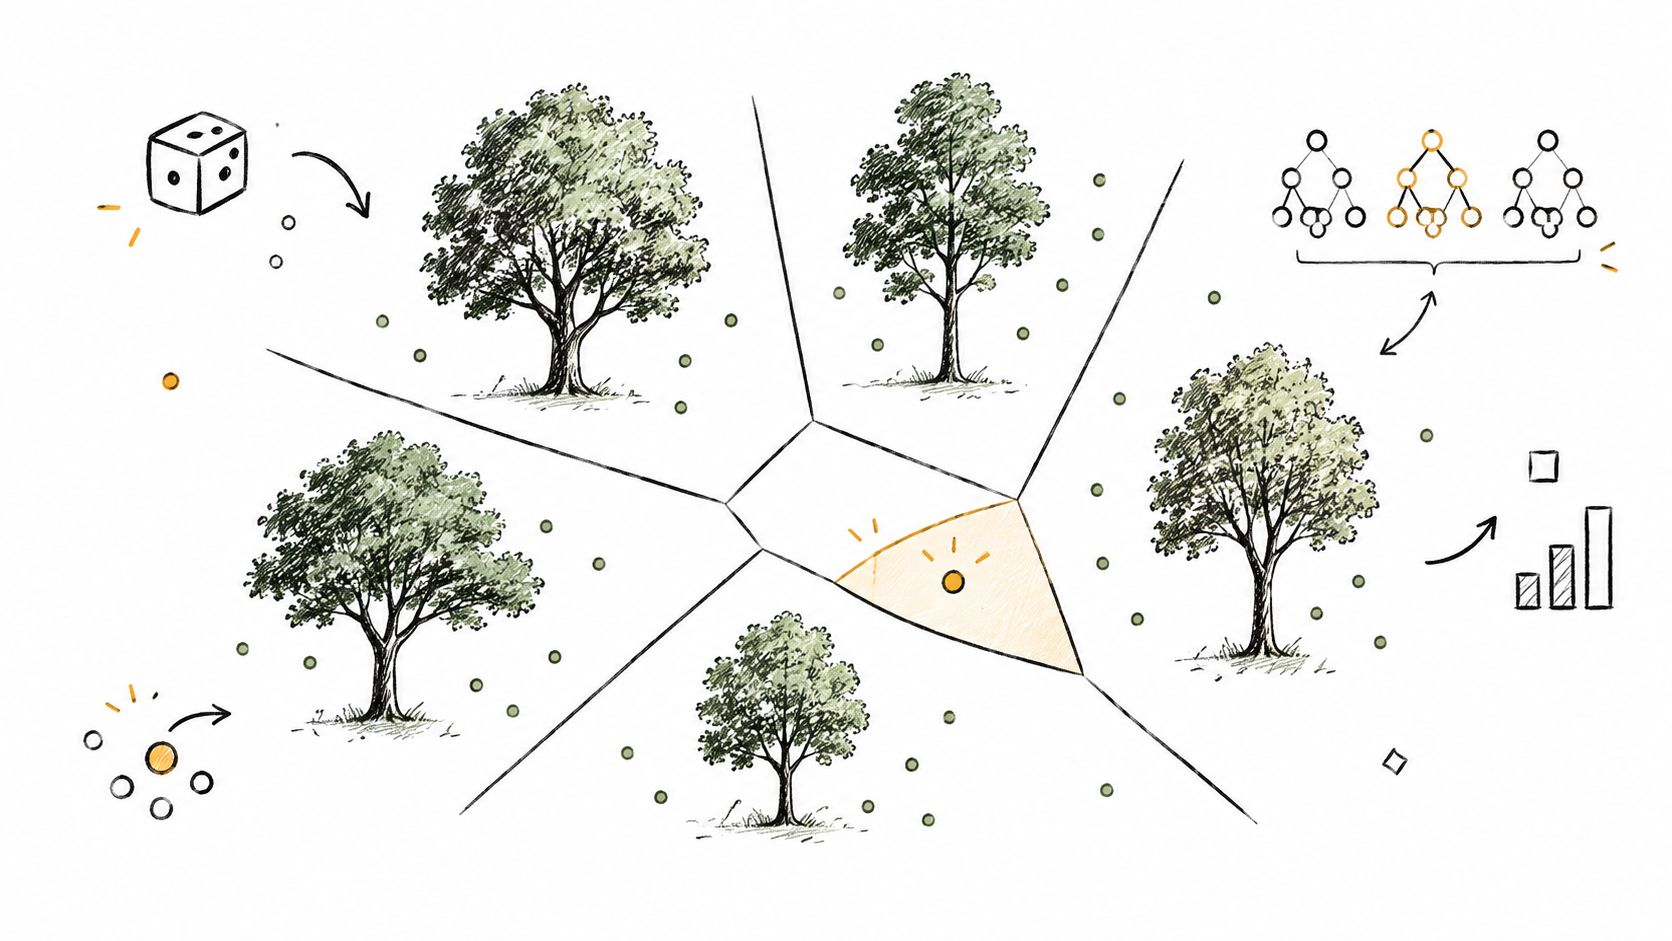
Jak działa w praktyce
Trenujesz model na danych bez etykiet. Tworzy wiele losowych drzew. Normalna obserwacja zwykle wymaga więcej podziałów do izolacji, bo leży w gęstym obszarze. Nietypowa obserwacja zostaje oddzielona w mniejszej liczbie kroków.
To czyni ją rozsądną opcją, gdy nie masz etykiet i nie chcesz ręcznie pisać reguł dla każdej podejrzanej kombinacji. Bank może punktować transakcje po kwocie, kategorii sprzedawcy, czasie, geografii i kanale. Szpital może analizować kombinacje miar operacyjnych. Zespół telekomunikacyjny może monitorować zachowanie sieci w kilku wymiarach.
Jeśli chcesz wypróbować metodę praktycznie, przepływ wykrywania anomalii w Pythonie jest częstym punktem startowym.
Kompromisy, na które warto uważać
Isolation Forest potrafi dobrze działać na danych wielowymiarowych, ale to nie magia. Wybór cech wciąż ma znaczenie. Skalowanie też. Jeśli jedna zmienna dominuje zakres, model może odizolować niewłaściwe rekordy z niewłaściwego powodu.
Dobre zastosowania to między innymi:
Filtrowanie oszustw: nietypowe kombinacje wielu atrybutów transakcji
Monitorowanie operacyjne: zachowanie wyglądające normalnie w każdej pojedynczej metryce, a dziwnie w kombinacji
Eksploracja: duże zbiory bez etykiet, w których potrzebujesz kandydatów do przeglądu
Zacznij od parametrów domyślnych, a potem sprawdź realne alerty z właścicielami dziedziny. Punkt nietypowy matematycznie nie zawsze jest anomalią istotną biznesowo.
3. Metody wskaźnika Z i odchylenia standardowego
Jeśli potrzebujesz prostej odpowiedzi na pytanie „czy ta wartość leży nietypowo daleko od średniej”, wskaźnik Z to zwykle pierwsza metoda do wypróbowania.
Mierzy, jak daleko punkt leży od średniej w jednostkach odchylenia standardowego. Brzmi technicznie, ale logika decyzyjna jest prosta. Jeśli wartość jest dostatecznie daleko od typowej, zgłoś ją.

Najlepsze zastosowanie wskaźnika Z
Wskaźniki Z są przydatne, gdy metryka jest dość stabilna, a jej rozkład zachowuje się rozsądnie. Częste techniki bazowe w praktycznym statystycznym wykrywaniu anomalii to wskaźnik Z, rozstęp ćwiartkowy i metody średniej ruchomej, a zespoły mogą je łączyć przez głosowanie albo ważoną punktację, by ograniczyć fałszywe alarmy i poprawić wykrywanie (praktyczne notatki o metodach wykrywania anomalii w szeregach czasowych).
Dlatego wskaźniki Z wciąż pojawiają się w monitorowaniu korporacyjnym. Łatwo je wyjaśnić. Zespół finansowy może zgłaszać nietypowe kwoty transakcji. Zespół opieki może obserwować odstające parametry życiowe. Zespół danych może monitorować liczbę wierszy w powtarzalnych ładowaniach.
Jeśli musisz staranniej przemyśleć, czy średnia i rozrzut są właściwym podsumowaniem, ten przewodnik po tym, jak opisać rozkład danych, daje użyteczny kontekst.
Ograniczenia i praktyczne korekty
Słabością jest kontekst. Wskaźnik Z na surowych danych może przeoczyć sezonowość, dryf albo rozkłady skośne. Dzienna metryka sprzedaży z silnym wzorcem dni roboczych może wyglądać anomalnie w każdy weekend, jeśli zignorujesz kontekst czasowy.
Używaj wskaźników Z ostrożnie, gdy:
Metryka jest stabilna: liczby wierszy, rozmiary plików, czasy trwania albo kwoty o niewielkim dryfie
Potrzebujesz przejrzystości: audyt albo przegląd przez interesariuszy jest łatwiejszy przy prostej matematyce
Chcesz punktu odniesienia: to mocne pierwsze przejście przed cięższymi modelami
Krótkie korekty praktyczne:
Używaj okien kroczących: lepsze przy zmiennym zachowaniu szeregów czasowych
W razie potrzeby wybieraj warianty: alternatywy oparte na medianie lepiej radzą sobie z wartościami odstającymi
Dodaj reguły biznesowe: wartość nietypowa statystycznie może być operacyjnie w porządku
4. Local Outlier Factor
Niektóre anomalie nie są ekstremalne globalnie. Są dziwne tylko względem sąsiednich danych. Właśnie tam przydaje się Local Outlier Factor, czyli LOF.
LOF porównuje lokalną gęstość punktu z gęstością jego sąsiadów. Jeśli punkt siedzi w rzadszym obszarze niż rekordy wokół niego, metoda traktuje go jako podejrzany. To czyni ją dobrą dla danych skupionych, w których „normalne” ma kilka odmian.
Dlaczego gęstość ma znaczenie
Pomyśl o użyciu klientów w telekomunikacji. Użytkownicy intensywni, okazjonalni i konta firmowe mogą tworzyć osobne grupy. Rekord może wyglądać normalnie w porównaniu z całą populacją, a mimo to odstawać wewnątrz własnego skupienia. LOF zbudowano właśnie do takiego porównania kontekstowego.
Ta sama logika pomaga w monitorowaniu platformy. Zestaw zadań może mieścić się w jednym paśmie opóźnień, a inna rodzina potoków działać w innym. LOF potrafi wychwycić zadanie nietypowe dla swojej grupy rówieśniczej, nawet jeśli w liczbach bezwzględnych nie wygląda na duże.
Dopasowanie praktyczne i kompromisy
LOF jest najmocniejszy, gdy sąsiedztwa mają sens. Słabnie, gdy wymiary się mnożą, a wszystko staje się rzadkie. W danych wielowymiarowych relacje najbliższych sąsiadów mogą stać się mniej informacyjne.
Użyteczne scenariusze:
Telekomunikacja: nietypowe zachowanie klienta wewnątrz podobnych kohort użycia
Platformy danych: anomalne zadania względem zadań porównywalnych
Operacje w ochronie zdrowia: rekordy niepasujące do pobliskich wzorców operacyjnych
Warto zapamiętać:
Dobieraj rozmiar sąsiedztwa starannie: za mały i alerty robią się nerwowe, za duży i kontekst lokalny znika
Najpierw skaluj cechy: porównania gęstości pękają, gdy jedna cecha dominuje
Używaj pętli przeglądu: LOF często znajduje subtelne przypadki wymagające interpretacji biznesowej
LOF działa zwykle lepiej jako element zestawu niż jako samotny detektor. Połącz go z prostym filtrem statystycznym albo regułą deterministyczną, by obciąć szum przeglądu.
5. Sieci neuronowe typu autoenkoder
Autoenkodery należą do rodziny rekonstrukcyjnej. Zamiast wyznaczać jawne granice albo mierzyć gęstość, uczą się kompresować i odbudowywać normalne dane. Gdy rekonstrukcja idzie źle, wejście może być anomalne.
Ta idea jest potężna, gdy wzorzec jest złożony i nieliniowy. To także moment, w którym wykrywanie anomalii staje się trudniejsze do wytłumaczenia nietechnicznym interesariuszom.
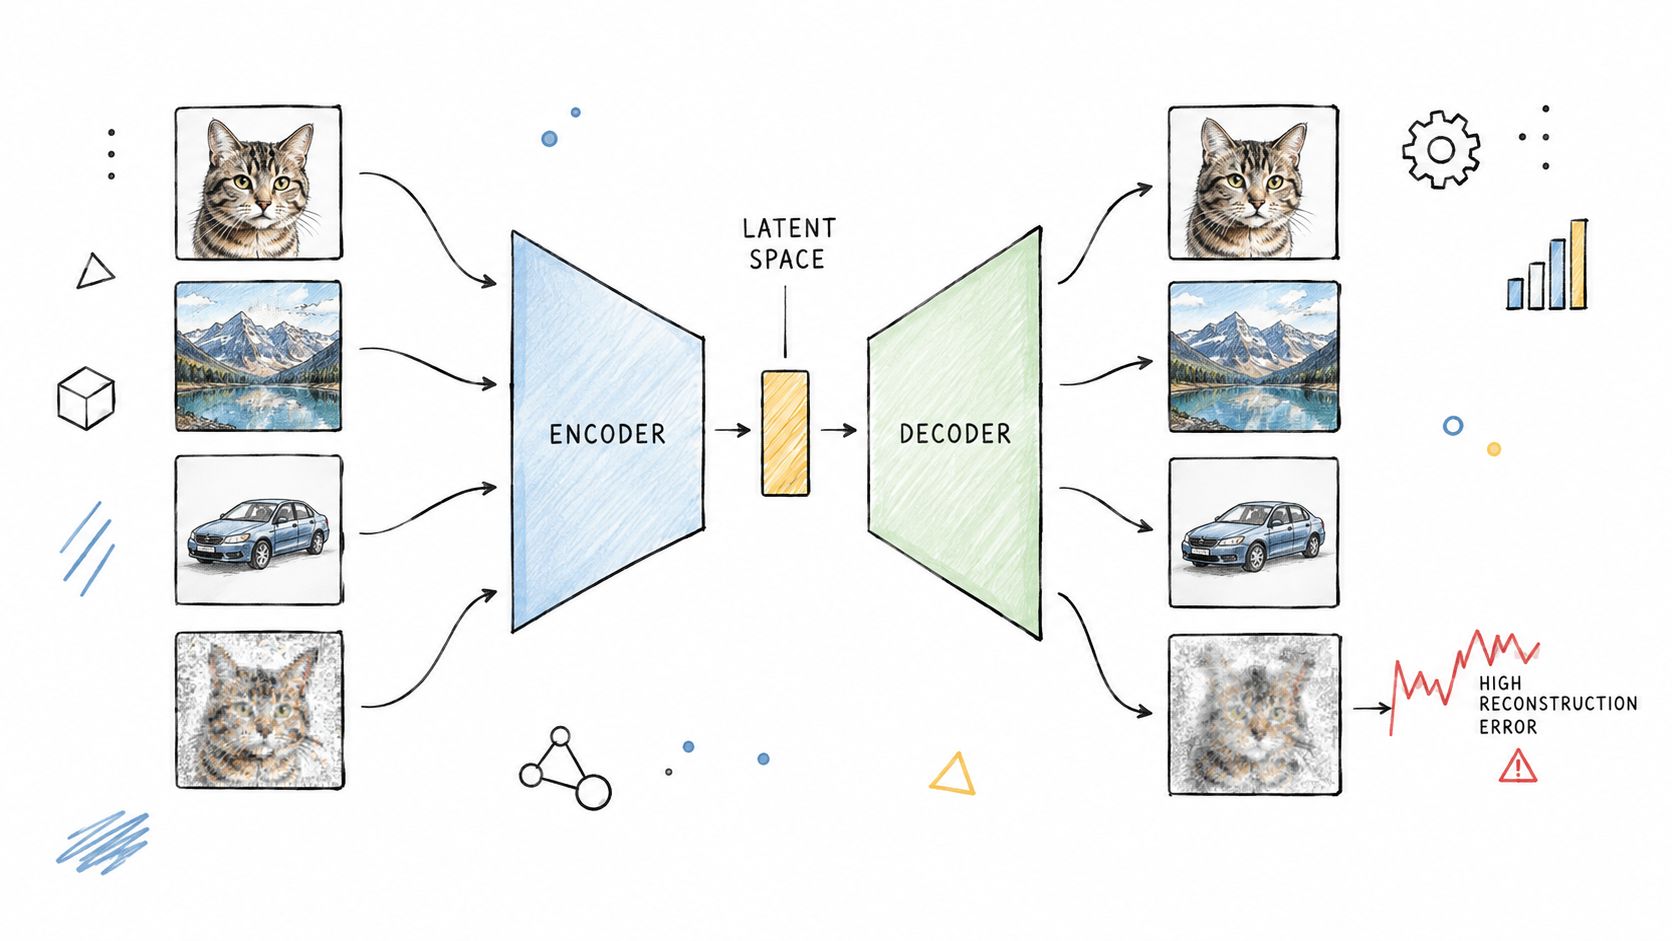
Gdzie pomaga rekonstrukcja
Autoenkodery przydają się, gdy normalne zachowanie zależy od wielu współdziałających zmiennych, a proste granice tego nie uchwycą. Zespół finansowy może punktować złożone zachowania cenowe. Zespół w ochronie zdrowia może monitorować kombinacje z wielu urządzeń albo czujników. Zespół telekomunikacyjny może oceniać sygnatury ruchu, które nie rozdzielają się czysto metodami liniowymi.
W szerokich przeglądach metody wykrywania anomalii grupuje się zwykle w podejścia statystyczne, klasyczne podejścia uczenia maszynowego i metody oparte na sieciach neuronowych (przegląd metod statystycznych, uczenia maszynowego i głębokiego). Autoenkodery siedzą mocno w tej trzeciej grupie.
Przy zachowaniach zależnych od czasu pojawiają się często w szerszych przepływach wykrywania anomalii w szeregach czasowych, zwłaszcza gdy relacje między sygnałami liczą się bardziej niż pojedyncza metryka.
Kompromisy są realne
Autoenkodery potrafią uchwycić wzorce, które prostsze metody pomijają. Potrzebują też czystszych danych treningowych, więcej strojenia i mocniejszej dyscypliny operacyjnej. Jeśli model nauczy się zepsutego „normalnego”, błąd rekonstrukcji traci znaczenie.
Używaj ich, gdy:
Wzorce są złożone: liczą się interakcje nieliniowe
Etykietowane anomalie są rzadkie: rekonstrukcja nie wymaga wielu przykładów awarii
Możesz utrzymać model: trening, dotrenowanie i przegląd progów potrzebują właściciela
Metody neuronowe często znajdują cenne anomalie, ale rzadko zastępują prostsze kontrole. Zespoły wciąż potrzebują wytłumaczalnych sprawdzeń na przeglądy incydentów i rozmowy audytowe.
6. Jednoklasowa SVM (Support Vector Machine)
Jednoklasowa SVM próbuje nauczyć się granicy wokół normalnych danych. Wszystko poza tą wyuczoną granicą traktuje jako nietypowe.
To czyni ją koncepcyjnie inną niż Isolation Forest. Isolation Forest pyta, jak łatwo oddzielić punkt. Jednoklasowa SVM pyta, czy punkt mieści się w akceptowanym obszarze normalnego zachowania.
Kiedy uczenie granicy ma sens
Ta metoda przydaje się, gdy normalne rekordy tworzą spójny kształt, nawet jeśli nie jest on liniowy. Funkcje jądrowe pozwalają modelowi rysować bardziej elastyczne granice, co może pomóc przy wzorcach wielowymiarowych.
Przykłady to:
Usługi finansowe: transakcje wypadające poza normalne zachowanie klienta
Ochrona zdrowia: nietypowe profile kliniczne w kilku pomiarach
Analityka klienta: wzorce aktywności konta wykraczające poza znane normy
Głównym wyzwaniem jest wrażliwość. Jednoklasowa SVM potrafi mocno reagować na skalowanie cech, dobór parametrów i zaszumione dane treningowe. Przy dużych zbiorach bywa też kosztowna obliczeniowo wobec lżejszych metod.
Czego zespoły powinny się spodziewać
Jednoklasowa SVM bywa dobrym wyborem dla średniej wielkości, ustrukturyzowanych zbiorów, gdzie uczenie „tylko z klasy normalnej” pasuje do problemu biznesowego. Mniej przekonuje, gdy potrzebujesz łatwej wytłumaczalności albo niskonakładowego zachowania na produkcji.
Pomocne nawyki eksploatacyjne:
Normalizuj wejścia: to rzadko bywa opcjonalne
Trzymaj cechy sensowne: słabe cechy zniekształcają granicę
Dotrenowuj po zmianach procesu: nowe produkty, kanały czy przepływy mogą przesunąć obszar normalny
Jeśli potrzebujesz modelu łatwiejszego do omówienia z audytorami albo kierownikami operacji, deterministyczna walidacja albo statystyczne linie bazowe zwykle wygrywają.
7. Dekompozycja sezonowa i ARIMA
Czas zmienia w wykrywaniu anomalii wszystko. Wartość może wyglądać źle tylko dlatego, że pojawiła się o niewłaściwej godzinie, w niewłaściwym dniu albo po niewłaściwej sekwencji. Dekompozycja sezonowa i ARIMA są zbudowane pod ten problem.
Te metody używają oczekiwania czasowego jako dowodu. Pytają, co powinno wydarzyć się dalej, przy danej historii szeregu.
Środowisko benchmarkowe pokazuje, czemu staranny dobór metody ma znaczenie. ADBench ocenił 30 algorytmów wykrywania anomalii na 57 zbiorach danych, a UCR Time Series Anomaly Archive udostępnia 250 wyselekcjonowanych szeregów czasowych dla badań, co potwierdza, że wybór algorytmu mocno zależy od cech zbioru (przegląd benchmarku ADBench i archiwum UCR).
Czego szukają
Dekompozycja sezonowa rozdziela szereg na trend, sezonowość i zachowanie resztowe. ARIMA modeluje zależność czasową wprost. Oba są przydatne, gdy anomalia nie jest po prostu „wysoka” albo „niska”, lecz „nieoczekiwana dla tej chwili”.
To ma znaczenie w realnej eksploatacji. Nocne ładowanie wsadowe, które nie przychodzi zgodnie z planem, to problem Timeliness. Skok aktywności klientów w święto może być normalny, jeśli sezonowość i kontekst zdarzeń są poprawnie zamodelowane. Spadek przychodów w spokojny weekend może nie zasługiwać na eskalację.
Ta rodzina metod jest szczególnie istotna dla anomalii zbiorowych i podsekwencyjnych. Nowszy przegląd zauważa, że wiele incydentów produkcyjnych to nie odosobnione punkty, lecz anomalie zbiorowe albo podsekwencyjne, i podkreśla praktyczną lukę w doborze metody dla przypadków takich jak spóźnione ładowania, dryf schematu i wielosygnałowe zachowanie potoków (przegląd o wykrywaniu przesunięć systemowych i danych obserwowalności). Jeśli pracujesz przy monitorowaniu dostaw danych, ta luka zabrzmi znajomo.
Użyteczną referencją wdrożeniową jest ten przewodnik po wykrywaniu anomalii w szeregach czasowych.
Dobre dopasowanie do obserwowalności danych
Te metody bywają właściwą odpowiedzią dla:
Brakujących albo spóźnionych ładowań: oczekiwane okna napływu liczą się bardziej niż surowe wartości
Sezonowych metryk biznesowych: wzorce dzienne, tygodniowe albo miesięczne wyznaczają normalne zachowanie
Dryfu w procesach powtarzalnych: stopniowe odchodzenie od historycznych terminów albo wolumenów
Opóźniony potok to często anomalia zbiorowa, nie punktowa. Metody świadome czasu wychwytują ją wcześniej niż progi statyczne.
8. Odległość Mahalanobisa
Odległość Mahalanobisa to jedno z najbardziej użytecznych wielowymiarowych narzędzi statystycznych, które wiele zespołów pomija. Mierzy, jak daleko punkt leży od środka danych, uwzględniając skalę i korelację.
Ta ostatnia część ma znaczenie. Jeśli dwie zmienne zwykle poruszają się razem, rekord może wyglądać całkiem normalnie w każdej pojedynczej kolumnie, a mimo to być dziwny jako kombinacja.
Dlaczego korelacja zmienia odpowiedź
Załóżmy, że wzrost przychodów, marża i wskaźnik zadłużenia zwykle układają się w segmencie w znaną zależność. Rekord firmy o przeciętnych wartościach w każdej metryce i tak może naruszać typowy wzorzec wielowymiarowy. Odległość Mahalanobisa potrafi ujawnić tę niezgodność skuteczniej niż zwykła odległość euklidesowa.
To czyni ją użyteczną w finansach, operacjach klinicznych i monitorowaniu jakości danych. Rekord medyczny może pokazywać wartości pojedynczo wiarygodne, które w połączeniu tworzą profil niewiarygodny. Platforma danych może obserwować metryki jakości akceptowalne osobno, a podejrzane razem.
Kiedy jej używać
Odległość Mahalanobisa to mocny środek pomiędzy prostą statystyką a pełnym uczeniem maszynowym. Pozostaje interpretowalna, a lepiej radzi sobie ze strukturą wielowymiarową niż progi na pojedynczych kolumnach.
Działa najlepiej, gdy:
Zmienne są skorelowane: kowariancja niesie użyteczną informację
Potrzebujesz wytłumaczalnych kontroli wielowymiarowych: analitycy mogą sprawdzić, które zależności się przesunęły
Dane są ustrukturyzowane: stabilne metryki pasują często lepiej niż surowe strumienie zdarzeń
Oszacowania kowariancji mogą stać się niestabilne w warunkach zaszumionych albo wielowymiarowych. Segmentowane oszacowanie kowariancji i segmentacja często poprawiają wiarygodność.
9. Walidacja regułowa i deterministyczna
Najbardziej zaniedbana rada w wykrywaniu anomalii brzmi tak. Jeśli biznes już wie, że dany warunek jest nie do przyjęcia, nie trenuj modelu, by odkrywał go na nowo.
Walidacja regułowa korzysta z jawnej logiki. Pola wymagane muszą być wypełnione. Wartości referencyjne muszą pasować do zatwierdzonych list. Daty muszą przestrzegać ograniczeń kolejności. Warunki regulacyjne muszą być spełnione dokładnie. To nie jest monitorowanie „starej szkoły”. To najczystsza forma dowodu, jaką możesz mieć.
Najmocniejszy rodzaj sygnału
Reguły korzystają z jawnej wiedzy biznesowej zamiast wnioskowanych wzorców. Jeśli plik medyczny musi zawierać obowiązkowe identyfikatory, nie ma sensu pytać modelu statystycznego, czy brakujące identyfikatory wyglądają nietypowo. One są nieważne. Jeśli proces finansowy wymaga, by kwoty mieściły się w określonym zakresie polityki, kontrola deterministyczna jest sprawdzeniem podstawowym.
Dlatego metody regułowe pozostają niezbędne w środowiskach regulowanych i krytycznych procesach sprawozdawczych. Dają zespołom pełną audytowalność i stabilne zachowanie operacyjne.
Przykłady:
digna Data Validation: kontrole na poziomie rekordów wobec reguł biznesowych
Usługi finansowe: kontrole powiązane z ograniczeniami polityki albo regulacji
Ochrona zdrowia: kompletność pól obowiązkowych i spójność logiczna
Sektor publiczny: audytowalne egzekwowanie wymaganych warunków danych
Gdzie kończą się reguły
Reguły są precyzyjne, ale łapią tylko to, co ktoś pomyślał zdefiniować. Nie wykryją nietypowej struktury klientów, subtelnego dryfu metryki ani przesuwającej się linii bazowej czasów napływu.
Nowsze przeglądy podkreślają, że praktyczna ocena wykrywania anomalii wciąż potrzebuje lepszych wskazówek przy ograniczeniach prywatności, wdrożenia, wytłumaczalności i eksploatacji, a badania nad obserwowalnością nadal uwypuklają wyzwanie ograniczania szumu w logach, śladach i metrykach za pomocą godnej zaufania automatyzacji (przegląd operacyjnego, wytłumaczalnego i świadomego wdrożenia wykrywania anomalii). Deterministyczna walidacja pomaga zaufaniu, bo zespoły widzą dokładny warunek, który zawiódł.
Używaj reguł do:
Znanych wymagań biznesowych
Kontroli zgodności i audytu
Pól i rekordów wysokiego ryzyka
Jasnych ścieżek eskalacji
Porównanie 9 metod wykrywania anomalii
Metoda | 🔄 Złożoność wdrożenia | ⚡ Zapotrzebowanie na zasoby | 📊 Oczekiwane rezultaty | 💡 Idealne zastosowania | ⭐ Kluczowe zalety |
|---|---|---|---|---|---|
Uczenie statystycznych linii bazowych | Umiarkowana, automatyczna konfiguracja, strojenie czułości | Niskie–średnie, potrzebne dane historyczne, skromne obliczenia | Wykrywanie anomalii świadome kontekstu, z mniejszą liczbą fałszywych alarmów | Ciągłe monitorowanie KPI i jakości danych, metryki sezonowe | Sama dostosowuje się do trendów i sezonowości; skalowalna; szybko daje wartość |
Isolation Forest | Umiarkowana, trenowanie drzew i strojenie parametrów | Niskie–średnie, wydajny przy dużych i wielowymiarowych danych | Mocne wykrywanie wielowymiarowe w wysokich wymiarach | Wykrywanie oszustw, wielowymiarowe zbiory operacyjne | Wydajny, odporny na nieistotne cechy, bez miary odległości |
Wskaźnik Z i odchylenie standardowe | Niska, proste obliczenia statystyczne | Minimalne, pomijalne obliczenia | Szybkie, czytelne oznaczenia wartości odstających dla jednej metryki | Liczby wierszy, progi pojedynczej metryki, pierwsza linia monitorowania | Wyjątkowo szybki, przejrzysty, łatwy do audytu i wdrożenia |
Local Outlier Factor (LOF) | Umiarkowana–wysoka, dobór sąsiadów i miary odległości | Średnie–wysokie, kosztowny przy dużych próbach albo wysokich wymiarach | Wykrywa lokalne odchylenia gęstości i odstające typowe dla skupienia | Zbiory o zmiennej gęstości albo anomaliach zależnych od skupienia | Uchwyca kontekst lokalny; bez założenia o rozkładzie globalnym |
Sieci neuronowe typu autoenkoder | Wysoka, projekt architektury i strojenie hiperparametrów | Wysokie, GPU, przydatny duży czysty albo etykietowany zbiór treningowy | Wykrywa złożone anomalie nieliniowe przez błąd rekonstrukcji | Złożone wzorce wielowymiarowe, dane z wielu czujników albo czasowe | Modeluje zależności nieliniowe; skaluje się na złożone zestawy cech |
Jednoklasowa SVM | Wysoka, dobór jądra i strojenie parametrów | Średnie–wysokie, pamięć i obliczenia rosną z wielkością danych | Wykrywanie oparte na granicy; wrażliwe na skalowanie i jądra | Zbiory ze spójnym obszarem normalnym, gdzie anomalie leżą na zewnątrz | Elastyczne granice decyzyjne o mocnych podstawach teoretycznych |
Dekompozycja sezonowa i ARIMA | Umiarkowana, dobór parametrów sezonowych i ARIMA | Niskie–średnie, potrzebne długie szeregi historyczne | Czytelne składowe trendu i sezonowości oraz prognozowane anomalie | Szeregi czasowe o silnej sezonowości, Timeliness potoków | Zaprojektowane pod dane czasowe; czytelna dekompozycja i prognozy |
Odległość Mahalanobisa | Niska–umiarkowana, oszacowanie i odwracanie kowariancji | Niskie–średnie, potrzebna wystarczająca liczba próbek na wymiar | Wielowymiarowe oceny odstawania uwzględniające korelacje | Skorelowane wielowymiarowe kontrole i monitorowanie jakości | Uwzględnia kowariancję i skalę; skuteczna przy zmiennych skorelowanych |
Walidacja regułowa i deterministyczna | Wysoka, ręczne pisanie i utrzymanie reguł | Średnie, wysiłek ludzki; niskie obliczenia | Deterministyczne wyniki zaliczone lub niezaliczone z pełną audytowalnością | Kontrole regulacyjne i krytyczne reguły biznesowe | W pełni przejrzysta, audytowalna, dokładne egzekwowanie logiki biznesowej |
Wybierz metodę pasującą do sygnału
Najbardziej praktyczny sposób zrozumienia rodzajów wykrywania anomalii to przestać traktować je jak rywalizujące obozy. To różne sposoby zbierania dowodów.
Używaj wskaźników Z, gdy metryka jest prosta, stabilna i łatwa do podsumowania średnią i rozrzutem. Używaj uczenia linii bazowych, gdy zachowanie zbioru zmienia się w czasie, ale wciąż tworzy oczekiwany wzorzec. Używaj dekompozycji sezonowej albo ARIMA, gdy liczą się moment, trend i powtarzalność, zwłaszcza przy brakujących ładowaniach, opóźnieniach dostaw i aktywności biznesowej o rytmie dziennym albo tygodniowym. Używaj LOF i odległości Mahalanobisa, gdy kontekst pochodzi z sąsiednich punktów albo skorelowanych zmiennych. Używaj Isolation Forest, jednoklasowej SVM albo autoenkoderów, gdy dane są bez etykiet, wielowymiarowe i zbyt złożone dla statycznej logiki.
Szersze pole metodyczne odzwierciedla tę różnorodność. Wykrywanie anomalii w szeregach czasowych klasyfikuje się zwykle na uczenie nienadzorowane, nadzorowane i półnadzorowane, a ta sama literatura grupuje metody w rodziny prognostyczne, rekonstrukcyjne, odległościowe, kodujące, sąsiedztwa i probabilistyczne (przegląd VLDB rodzin wykrywania anomalii w szeregach czasowych). To pomocne przypomnienie, że wybór algorytmu powinien zaczynać się od sygnału, a nie od ulubionego modelu.
Kierunek rynku też wskazuje raczej na kombinacje operacyjne niż na pojedyncze narzędzia. Jedna prognoza branżowa przewiduje wzrost rynku wykrywania anomalii z 4,28 miliarda dolarów w 2024 roku do 9,25 miliarda do 2032, a przywództwo we wdrożeniach w 2025 przypisuje oprogramowaniu z udziałem 81,6% oraz wdrożeniom chmurowym z udziałem 72,8% (prognoza rynku wykrywania anomalii). To nie znaczy, że każdy zespół powinien pędzić do stosu wyłącznie chmurowego. Pokazuje jednak, że skalowalne, produkcyjne wykrywanie anomalii weszło do głównego nurtu eksploatacji w przedsiębiorstwach.
Dla obserwowalności danych najmocniejszy układ zwykle łączy metody. Reguła deterministyczna może odrzucić niemożliwe rekordy. Model linii bazowej może wykryć stopniowy dryf liczby wierszy albo wartości. Detektor Timeliness może wyłapać spóźnione ładowania. Monitor schematu może złapać zmiany strukturalne, zanim odbiorcy niżej w łańcuchu zawiodą. Ten warstwowy projekt pasuje do tego, jak powstają incydenty. Niewiele awarii produkcyjnych zapowiada się jednym idealnym sygnałem.
digna jest trafnym przykładem takiego łączonego podejścia. Platforma działa wewnątrz środowiska klienta i zbiera razem wykrywanie anomalii wspierane AI, walidację na poziomie rekordów, monitorowanie Timeliness, śledzenie schematu, monitorowanie metryk biznesowych i platformowych oraz wykonanie w bazie. Ta kombinacja ma znaczenie dla zespołów, które potrzebują zarówno adaptacyjnego wykrywania, jak i kontrolowanego, audytowalnego egzekwowania.
Użyj tej listy kontrolnej, zanim wybierzesz metodę:
Zdefiniuj anomalię jasno: czy to problem punktowy, kontekstowy, zbiorowy, jednowymiarowy czy wielowymiarowy?
Potwierdź historię danych: czy masz dość czystej historii, by nauczyć się normalnego zachowania?
Zmierz fałszywe alarmy: kto będzie przeglądał alerty i jaki poziom szumu jest do przyjęcia?
Przypisz odpowiedzialność za reakcję: który zespół bada dryf, nieudane reguły albo opóźnienia dostaw?
Przeglądaj po zmianach procesu: dotrenuj, przestrój albo przepisz kontrole, gdy zmieniają się produkty, potoki lub harmonogramy
Właściwa metoda to ta, która pasuje do sygnału, do danych i do realiów operacyjnych wokół obu.
digna daje zespołom danych modułowy sposób stosowania tych podejść do wykrywania anomalii na produkcji, od uczenia linii bazowych wspieranego AI po walidację deterministyczną, monitorowanie Timeliness i śledzenie schematu. Ponieważ działa wewnątrz środowiska klienta i wykonuje kontrole w bazie, pasuje zespołom, które potrzebują obserwowalności przy silnej kontroli nad przepływem danych i procesami przeglądu. Jeśli to odpowiada twojej konfiguracji, odwiedź digna.
Wybór metody to łatwiejsza połowa; utrzymanie jej w kalibracji, gdy dane się zmieniają, to prawdziwa praca, i właśnie tam ciągłe monitorowanie jakości danych zarabia na swoje miejsce.
Najczęściej zadawane pytania
Od czego naprawdę powinno się zaczynać wykrywanie anomalii?
Od właściwej definicji normalności, a nie od algorytmów. Większość porad startuje od metody, co jest odwrotną kolejnością: to samo odchylenie może być incydentem w jednym zbiorze i oczekiwaną sezonowością w innym, a żaden model nie rozstrzygnie tego za ciebie.
Czym różnią się statystyczne linie bazowe od isolation forest?
Uczenie statystycznych linii bazowych modeluje oczekiwane zachowanie z historii i zgłasza odejścia od niego. Isolation forest zamiast tego izoluje punkty łatwe do oddzielenia od reszty, co dobrze skaluje się na danych wielowymiarowych, ale daje mniej intuicji, dlaczego punkt został zgłoszony.
Kiedy używać wskaźników Z zamiast metod gęstościowych?
Wskaźniki Z pasują do w przybliżeniu normalnych rozkładów jednej zmiennej, gdzie odchylenie od średniej ma znaczenie. Local Outlier Factor zarabia na swoje miejsce, gdy liczy się gęstość — gdy punkt jest normalny globalnie, ale nietypowy wobec najbliższych sąsiadów, czego wskaźniki Z nie widzą.
Które metody pasują do danych szeregów czasowych?
Dekompozycja sezonowa i ARIMA, bo oddzielają trend i sezonowość od reszty i szukają odchyleń w tym, co zostaje. To dobrze pasuje do obserwowalności danych, gdzie poniedziałkowy skok jest rutyną, a ten sam skok w środę już nie.
Czy kontrole regułowe wciąż liczą się obok ML?
Tak — walidacja deterministyczna jest najmocniejszym rodzajem sygnału, bo jest wytłumaczalna i audytowalna w sposób, w jaki wynik modelu nie jest. Reguły kończą się tam, gdzie zaczynają się nieznane niewiadome, a to dokładnie miejsce, w którym pałeczkę przejmują metody behawioralne.