Otwarty format tabeli: kompletny przewodnik na 2026
|
8
min. czyt.

Apache Iceberg jest używany przez 58% organizacji do analityki krytycznej dla biznesu, a 95% wykorzystuje go lub planuje wykorzystać do obciążeń AI i uczenia maszynowego. Otwarty format tabeli to warstwa specyfikacji nad plikami kolumnowymi, która daje silnikom jeden, wersjonowany obraz plików, schematu i partycji tabeli, dzięki czemu różne narzędzia mogą czytać i zapisywać te same dane z gwarancjami transakcyjnymi.
Być może już tkwisz w środku tego problemu. Zbiór danych sprzedażowych leży w chmurowej pamięci obiektowej jako pliki Parquet. Spark potrzebuje go do trenowania modeli uczenia maszynowego, Trino do pulpitów, a potok wciąż zapisuje nowe partycje, gdy analitycy odpytują wczorajsze dane. Pliki są tanie i czytelne, ale sama tabela nie ma wiarygodnego wspólnego kontraktu, dopóki go nie dodasz.
Tym kontraktem jest otwarty format tabeli. Nie zastępuje Parquet ani twoich silników zapytań. Dodaje metadane, obsługę transakcji, reguły schematu i historię tabeli potrzebne do tego, by analityczna pamięć oparta na plikach zachowywała się jak zarządzana tabela.
Spis treści
Co otwarty format tabeli naprawdę rozwiązuje
Brakujący kontrakt
Czego nie rozwiązuje
Kluczowe pojęcia stojące za specyfikacją
Transakcyjne metadane jako indeks główny
Partycjonowanie jako reguła grupowania katalogu
Ewolucja schematu jako historia katalogu
Snapshoty jako wydania z określonego momentu
Jak Iceberg, Delta Lake i Hudi podchodzą do tego samego problemu
Korzyści, kompromisy i wybór zależny od obciążenia
Gdzie widać korzyści
Gdzie pozostają kompromisy
Dobre praktyki eksploatacji otwartych formatów tabel w skali przedsiębiorstwa
Traktuj katalog jak infrastrukturę produkcyjną
Spraw, by partycjonowanie odpowiadało na realne pytania
Wyznacz granice snapshotom
Generuj sygnały operacyjne w momencie zapisu
Wzorce obserwowalności i integracji dla produkcyjnych lakehouse
Cztery sygnały warte połączenia
Szczegóły integracji i wdrożenia
Wdrożenie i eksploatacja w środowiskach regulowanych
Kontrole do ustalenia przed produkcją
Praktyczna lista kontrolna przed standaryzacją formatu
Co otwarty format tabeli naprawdę rozwiązuje
Inżynierka danych może umieścić spartycjonowane dane sprzedażowe w pamięci obiektowej i wskazać Sparkowi katalog. Trino często potrafi odczytać te same pliki Parquet. Pierwsze zapytanie może zadziałać, ale model operacyjny robi się kruchy, gdy tylko pojawi się wielu zapisujących, zmieniające się schematy i równolegli czytelnicy.
Surowe pliki nie mówią każdemu silnikowi, które pliki należą do logicznej tabeli. Nazwa katalogu może sugerować tożsamość tabeli, ale nie zapisuje wiarygodnie, czy plik jest aktualny, zastąpiony, niekompletny czy utworzony przez niepowiązany proces. Foldery partycji też nie dają uniwersalnej historii tego, jak zmieniał się układ tabeli.
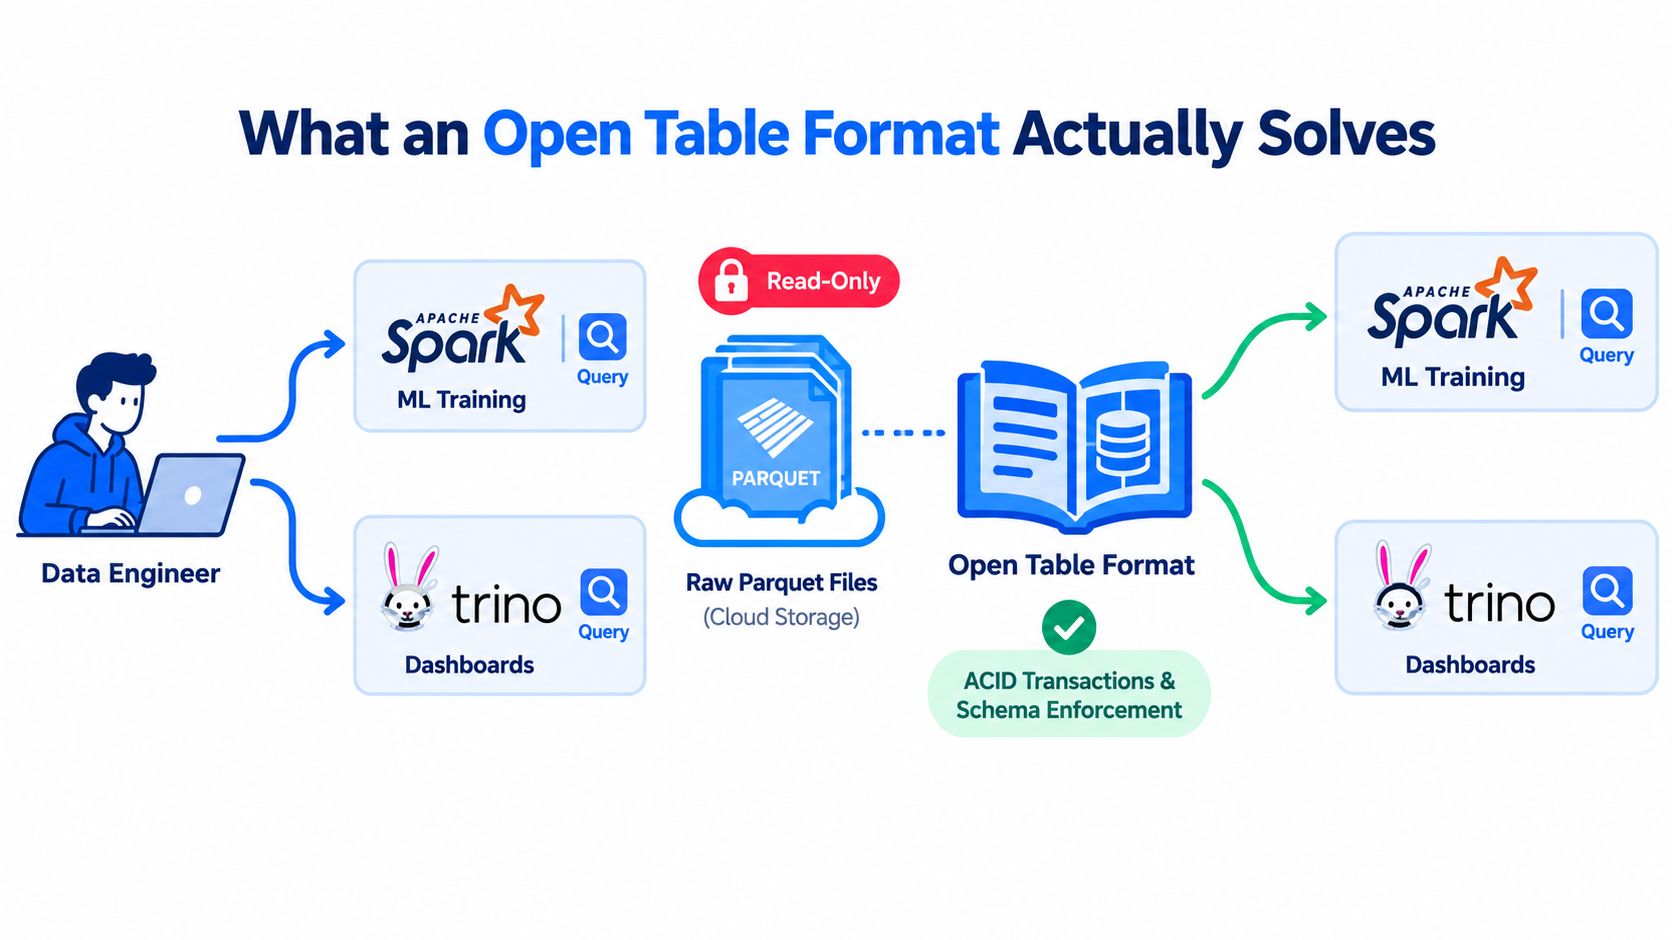
Brakujący kontrakt
Otwarty format tabeli leży obok plików danych i zapisuje informacje, co do których silniki muszą być zgodne:
Tożsamość tabeli: logiczna tabela ma stabilną definicję, niezależną od pojedynczego silnika czy skanowania katalogu.
Inwentarz plików: metadane wskazują pliki danych należące do tabeli oraz te, których nie należy już czytać.
Układ partycji: tabela zapisuje, jak zorganizowane są wiersze, dzięki czemu silniki mogą pomijać nieistotne dane.
Historia schematu: dodania, usunięcia, zmiany nazw i zgodne zmiany kolumn stają się częścią zarządzanej definicji tabeli.
Atomowe snapshoty: czytelnicy mogą wybrać spójną wersję, gdy zapisujący commituje nową.
Wynikiem jest wspólna specyfikacja. Spark może użyć tabeli do przygotowania danych pod uczenie maszynowe, Trino może obsłużyć interaktywny SQL, a oba rozstrzygną ten sam stan logiczny, zamiast niezależnie zgadywać go ze struktury folderów.
Czego nie rozwiązuje
Otwarty format tabeli nie tworzy automatycznie dobrych modeli danych, sensownych partycji, szybkich zapytań ani wiarygodnych wartości biznesowych. Może chronić spójność na poziomie tabeli, ale zespoły wciąż muszą zdecydować, jak dane są zapisywane, walidowane, kompaktowane, nadzorowane i monitorowane.
To rozróżnienie zapobiega częstemu błędowi architektonicznemu. Format jest fundamentem pod modelem operacyjnym, a nie samym modelem operacyjnym.
Kluczowe pojęcia stojące za specyfikacją
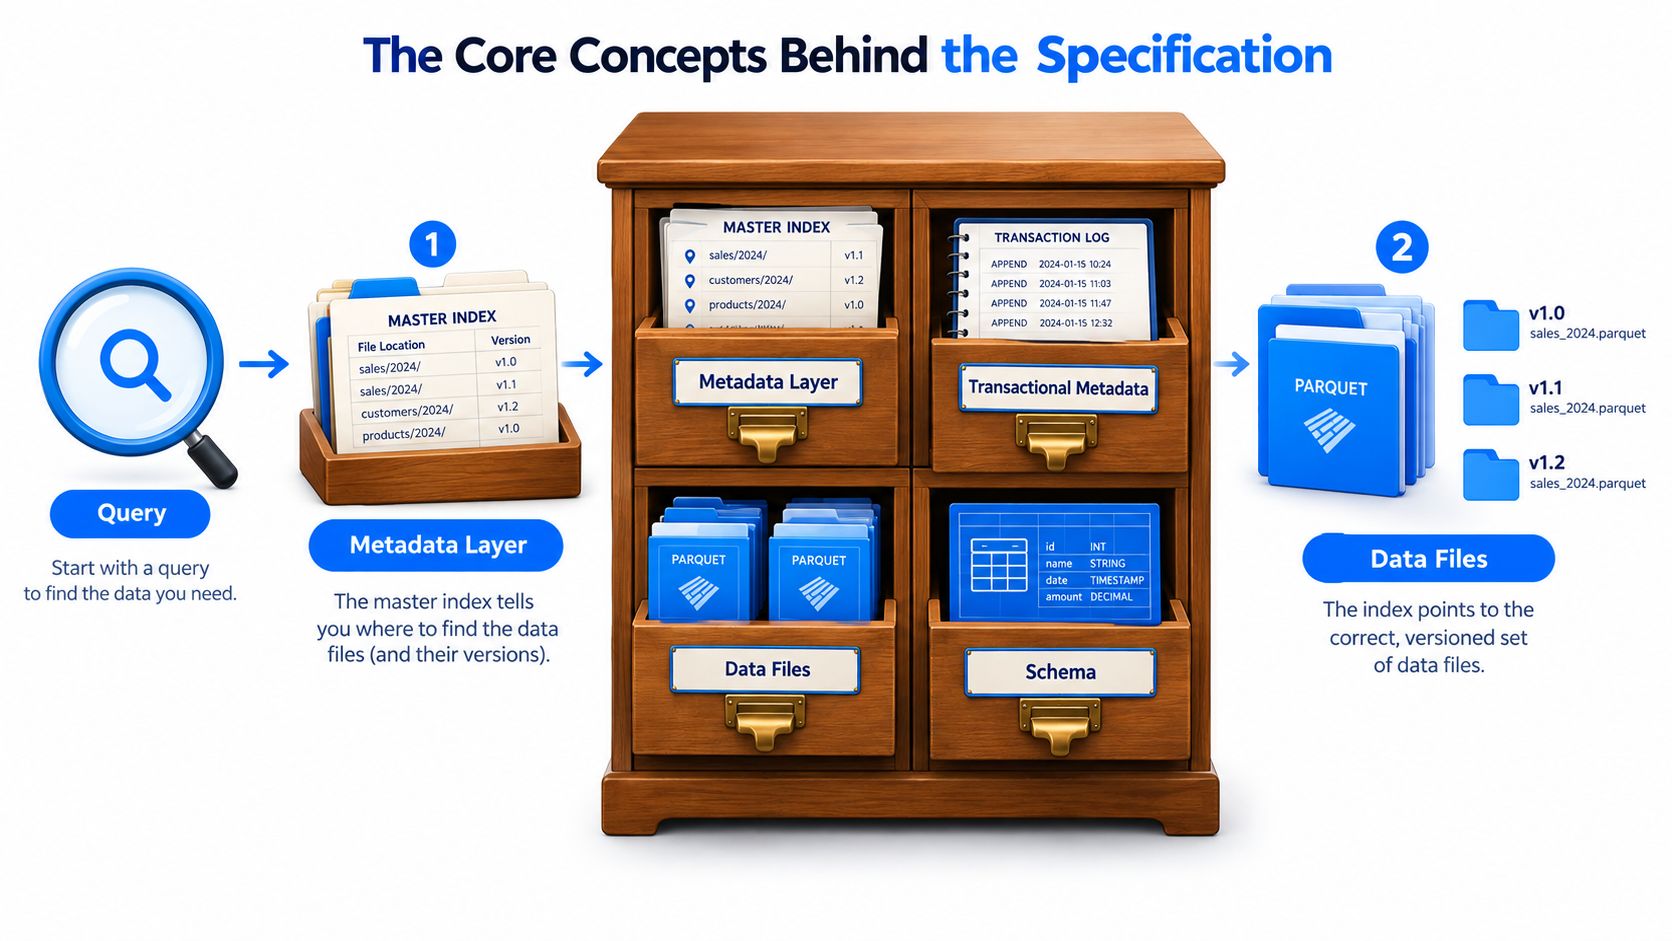
Katalog biblioteczny ułatwia zrozumienie warstwy metadanych. Książki to twoje pliki danych Parquet. Katalog to specyfikacja tabeli. Czytelnik najpierw zagląda do kart, a potem idzie do regałów z poszukiwanymi książkami.
Transakcyjne metadane jako indeks główny
Warstwa metadanych zapisuje, które pliki należą do tabeli i jak te pliki odnoszą się do snapshotu tabeli. Zamiast kazać Sparkowi czy Trino przeglądać każdą ścieżkę w pamięci obiektowej, silnik podąża za zarządzanym indeksem tabeli.
Wyobraź sobie kartę katalogową z napisem: „Te regały zawierają aktualne wydanie kolekcji sprzedażowej”. Jeśli zapisujący zastąpi starsze pliki świeżo skompaktowanymi, katalog zmienia aktywny inwentarz jednym commitem. Czytelnicy nie muszą domyślać się, czy widzieli kompletną aktualizację.
To właśnie praktyczny sens zarządzania metadanymi. Metadane to nie ozdobna dokumentacja. Kierują planowaniem, wspierają spójne odczyty i dają eksploatującym zapis tego, jak zmieniała się tabela.
Partycjonowanie jako reguła grupowania katalogu
Reguła partycjonowania grupuje powiązane dane, by silnik mógł uniknąć skanowania niezwiązanych plików. Jeśli dane sprzedażowe są zorganizowane wokół czasowego lub regionalnego wzorca dostępu, zapytanie z pasującym filtrem może zawęzić zakres skanowania.
Reguła musi odpowiadać rzeczywistym obciążeniom. Projekt partycji odzwierciedlający sposób filtrowania w pulpitach może ograniczyć zbędne odczyty, natomiast projekt oparty na nieodpowiednim lub zbyt drobnym atrybucie może wytworzyć narzut operacyjny i mnóstwo małych plików.
Ewolucja schematu jako historia katalogu
Schemat to katalogowy opis tego, co zawiera każda książka. Gdy potok dodaje kolumnę, zmienia jej nazwę lub typ, format tabeli może zapisać tę zmianę, zamiast zostawiać każdemu silnikowi odkrywanie jej na własną rękę.
Ta historia ma znaczenie, gdy stare i nowe pliki współistnieją. Czytelnik potrzebuje reguł interpretacji obu wersji, a potok potrzebuje jasnego trybu awarii, gdy zmiana jest niezgodna. Ewolucja schematu zmniejsza ciche rozbieżności, ale nie rozstrzyga, czy nowa kolumna jest poprawna znaczeniowo.
Snapshoty jako wydania z określonego momentu
Snapshot to spójna wersja tabeli. Łączy metadane tabeli ze zbiorem plików danych, których czytelnicy powinni użyć w danym momencie. Dokumentacja Apache Iceberg opisuje podróż w czasie jako sposób uruchamiania powtarzalnych zapytań wobec konkretnego snapshotu, natomiast specyfikacja przechowuje snapshoty w pliku JSON metadanych tabeli, a nie jako osobne obiekty serializowane. Zobacz dokumentację Apache Iceberg i specyfikację Iceberga, by poznać model źródłowy.
Razem te cztery pojęcia pozwalają Sparkowi i Trino pracować na tej samej skatalogowanej kolekcji. Jeden silnik może zapisywać nowe wydanie, gdy drugi czyta stabilne wcześniejsze, zależnie od zachowania transakcyjnego formatu i implementacji katalogu.
Jak Iceberg, Delta Lake i Hudi podchodzą do tego samego problemu
Apache Iceberg, Delta Lake i Apache Hudi dodają zarządzanie tabelami do analitycznej pamięci opartej na plikach, ale ich historia projektowa wpływa na sposób użycia. Iceberg powstał w Netflixie w 2017 roku, został przekazany Apache Software Foundation w 2018, a w maju 2020 stał się projektem najwyższego poziomu. Jego projekt kładzie nacisk na neutralne wobec silnika metadane tabeli i szeroką interoperacyjność z systemami takimi jak Spark, Trino, Flink, Hive i Impala, co opisuje projekt Apache Iceberg.
Delta Lake używa plików danych Parquet wraz z dziennikiem transakcji w katalogu _delta_log. Dziennik zawiera uporządkowane wpisy JSON i okresowe punkty kontrolne w Parquet, a snapshot tabeli uzyskuje się, czytając dziennik do wybranej wersji, jak podaje praca badawcza o Delta Lake. Ten model czyni dziennik transakcji centralnym autorytetem dla stanu tabeli.
Hudi kojarzy się szczególnie z ingestią przyrostową, upsertami, usunięciami i potokami danych działającymi niemal w czasie rzeczywistym. Jego podejścia copy-on-write i merge-on-read to różne kompromisy między prostotą odczytu a zachowaniem zapisu czy ingestii. Hudi kładzie też większy nacisk na wzorce indeksowania na poziomie rekordów, by kierować aktualizacjami.
Wymiar | Apache Iceberg | Delta Lake | Apache Hudi |
|---|---|---|---|
Oś projektowa | Neutralne wobec silnika tabele analityczne i przenośne metadane | Transakcyjne tabele Parquet oparte na uporządkowanym dzienniku | Zapisy przyrostowe, upserty, usunięcia i ingestia strumieniowa |
Stan tabeli | Metadane wskazują snapshoty, manifesty i pliki danych |
| Oś czasu i struktury metadanych śledzą commity tabeli oraz grupy plików |
Partycjonowanie | Wspiera ewolucję układu partycji wraz ze zmianą wzorców zapytań | Używa danych spartycjonowanych z opcjami optymalizacji zależnymi od silnika | Używa partycjonowania obok indeksowania i wyboru trybu zapisu |
Ewolucja schematu | Zarządzana przez metadane tabeli i identyfikatory schematu | Zarządzana przez reguły tabeli i dziennika transakcji | Zarządzana przez metadane tabeli i konfigurację zapisującego |
Izolacja snapshotów | Czytelnicy rozstrzygają spójny snapshot metadanych | Czytelnicy rozstrzygają wersję tabeli z dziennika transakcji | Czytelnicy używają osi czasu Hudi i wybranego stanu commitu |
Typowa mocna strona | Analityczny dostęp z wielu różnych silników | Transakcyjne przepływy lakehouse skupione na Databricks | Częste zmiany przyrostowe i ingestia na poziomie rekordów |
Nacisk operacyjny | Katalog, manifesty, planowanie i utrzymanie metadanych | Retencja dziennika, punkty kontrolne, kompaktowanie i integracja platformy | Kompaktowanie, indeksowanie, klastrowanie i zarządzanie trybami zapisu |
To porównanie nie jest listą funkcji. To wskazówka o stylu eksploatacji. Iceberg często pasuje do platformy, gdzie kilka silników musi współdzielić tabele. Delta bywa naturalnym wyborem, gdy dominują przepływy zorientowane na Databricks i Spark. Hudi zasługuje na uważną ocenę, gdy ciągłe upserty i przetwarzanie przyrostowe są ważniejsze niż szeroka interoperacyjność odczytu.
Cokolwiek wybierzesz, jakość danych pozostaje osobną odpowiedzialnością. Platforma może zarządzać commitami i regułami schematu, a mimo to przyjmować błędne wartości, dlatego praktyki jakości danych w Databricks należą do przeglądu architektury, a nie do etapu po wdrożeniu.
Korzyści, kompromisy i wybór zależny od obciążenia
Wybór formatu powinien zaczynać się od obciążenia, a nie od uniwersalnej preferencji. W jednym porównaniu w stylu TPC-DS Iceberg i Delta wypadły blisko siebie w kilku zapytaniach intensywnie czytających, podczas gdy Hudi był wolniejszy przy tych samych obciążeniach. Interaktywne zapytanie 19 wykonało się w 1,45 sekundy na Icebergu, 1,38 sekundy na Delcie i 2,92 sekundy na Hudi, a raportowe zapytanie 27 zajęło 8,70 sekundy na Icebergu, 8,45 sekundy na Delcie i 12,10 sekundy na Hudi. W głębokiej analityce zapytanie 64 zajęło 184,20 sekundy na Icebergu, 181,90 sekundy na Delcie i 210,50 sekundy na Hudi, jak podaje ten benchmark otwartych formatów tabel.
Te wyniki nie wyłaniają trwałego zwycięzcy. Pokazują, dlaczego reprezentatywne pulpity, złączenia, filtry, zapisy i operacje utrzymaniowe liczą się bardziej niż pojedynczy nagłówkowy benchmark.
Wzorzec obciążenia | Zalecany format | Czynnik rozstrzygający |
|---|---|---|
Częste upserty strumieniowe i zmiany przyrostowe | Apache Hudi | Zachowanie ingestii na poziomie rekordów, obsługa aktualizacji oraz wybór między merge-on-read a copy-on-write |
Odczyty analityczne z wielu różnych silników | Apache Iceberg | Przenośność między silnikami i integracja z katalogiem |
Przepływy lakehouse skupione na Databricks | Delta Lake | Integracja dziennika transakcji i bliskie dopasowanie do platformy |
Interaktywne BI i pulpity SQL | Iceberg lub Delta po testach | Wydajność ścieżki odczytu, narzut planowania i faktyczne zachowanie pulpitów |
Zbiory danych AI i ML współdzielone między narzędziami | Zależnie od obciążenia | Zgodność silników, nadzór, powtarzalność i wzorce dostępu przy trenowaniu |
Gdzie widać korzyści
Interoperacyjność pozwala zespołom korzystać z jednego nadzorowanego zbioru danych z wielu silników, zamiast utrzymywać kopie dla każdego odbiorcy. Commity transakcyjne chronią czytelników przed częściowymi zapisami i pomagają potokom publikować kompletne stany tabeli. Metadane katalogu wspierają uprawnienia, odnajdywalność, pochodzenie danych i procesy audytowe, gdy katalog jest traktowany jak prawdziwa usługa platformowa.
Otwarte tabele mogą też wspierać gotowość na AI. Potoki treningowe zyskują, gdy stany historyczne są powtarzalne i gdy te same nadzorowane dane są dostępne dla przygotowania, ewaluacji i obciążeń analitycznych.
Gdzie pozostają kompromisy
Zależność od katalogu tworzy realny tryb awarii. Jeśli katalog lub usługa metadanych jest niedostępna, odczyty i zapisy mogą się zatrzymać, nawet gdy pliki źródłowe pozostają w pamięci obiektowej. Transakcje międzytabelowe i zachowanie kluczy obcych nie dorównują tradycyjnej relacyjnej bazie danych, a najnowsze opracowania podkreślają, że gwarancje ACID zwykle ograniczają się do pojedynczych tabel.
Eksploatacja trwa też po pierwszym udanym zapisie. Kompaktowanie, wygasanie snapshotów, sprzątanie osieroconych plików, utrzymanie partycji i przegląd schematu wymagają właściciela. Format zmniejsza niejednoznaczność, ale nie usuwa pracy platformowej ani nie wymusza poprawności biznesowej.
Dobre praktyki eksploatacji otwartych formatów tabel w skali przedsiębiorstwa
Specyfikacja daje wiarygodne słownictwo dla stanu tabeli. Nie daje dyscypliny operacyjnej potrzebnej, by ten stan pozostał zdrowy. Cztery praktyki zasługują na wyraźnego właściciela, zanim pojawią się obciążenia produkcyjne.
Traktuj katalog jak infrastrukturę produkcyjną
Metastore, katalog REST czy ujednolicony katalog nadzoru to warstwa sterowania. Nadaj mu cele dostępności, przeglądy dostępu, ślady audytowe, procedury kopii zapasowych i runbook incydentów. Tabela może leżeć w pamięci obiektowej, ale silniki wciąż zależą od katalogu przy rozstrzyganiu jej tożsamości, metadanych, uprawnień i bieżącego stanu.
Reguła praktyczna: jeśli awaria katalogu zatrzymałaby pracę analityczną, monitoruj go i przywracaj jak warstwę sterowania bazy danych, a nie jak plik konfiguracyjny.
Spraw, by partycjonowanie odpowiadało na realne pytania
Wybieraj partycje na podstawie zaobserwowanych filtrów zapytań i zachowania zapisu. Iceberg wspiera ewolucję układu partycji, więc zespoły mogą go zmieniać, gdy rośnie wolumen danych lub zmieniają się wzorce zapytań, ale funkcja ewolucji nie usuwa kosztu złych decyzji początkowych.
Po każdej większej zmianie potoku sprawdzaj, czy powstają małe pliki. Klucze partycji o wysokiej kardynalności mogą rozproszyć dane po wielu plikach, a zbyt szerokie partycje mogą zmusić silniki do skanowania większej ilości danych niż potrzeba. Sortowanie i kompaktowanie mogą poprawić lokalność, ale dokładają pracy utrzymaniowej.
Wyznacz granice snapshotom
Historyczne snapshoty pomagają w powtarzalności, wycofaniu i diagnostyce. Nieograniczona retencja tworzy więcej metadanych do zaplanowania i więcej obiektów do zarządzania, więc zdefiniuj politykę opartą na potrzebach odtwarzania, wymogach audytowych i regułach cyklu życia pamięci masowej.
Połącz wygasanie snapshotów ze sprzątaniem osieroconych plików. Usuwanie odwołań w metadanych bez bezpiecznego wskazania danych nieodwołanych może stworzyć inną awarię, więc sprzątanie powinno być przemyślane, obserwowalne i przetestowane.
Generuj sygnały operacyjne w momencie zapisu
Zapisujący wiedzą, kiedy zaczyna się commit, ile plików tworzą, jak długo commit trwa i czy uruchomiono kompaktowanie. Rejestruj te fakty jako ustrukturyzowane zdarzenia, zamiast próbować odtworzyć je później z rozproszonych dzienników.

Śledź liczbę plików, ich rozmiary, opóźnienie commitów, wiek snapshotów, nieudane commity i kondycję kompaktowania. Te sygnały łączą operacje formatu z objawami, które zauważają użytkownicy: wolnymi pulpitami, nieświeżymi zbiorami danych i niekompletnymi ładowaniami.
Dojrzałość operacyjna decyduje, czy lakehouse działa niezawodnie. Otwarta specyfikacja jest potrzebna dla wspólnej semantyki, ale to twoje polityki katalogu, zadania utrzymaniowe, kierowanie alertów i model odpowiedzialności decydują, czy ta semantyka wytrzyma presję produkcji.
Wzorce obserwowalności i integracji dla produkcyjnych lakehouse
Tabela może być poprawna transakcyjnie i mimo to błędna operacyjnie. Może mieć nową kolumnę psującą model niżej w łańcuchu, udany commit, który dotarł za późno na termin raportowy, albo poprawny zbiór plików o wolumenie rekordów mocno odbiegającym od ustalonej linii bazowej.
Obserwowalność powinna odwzorowywać się wprost na operacje tabeli. Śledzenie schematu bada metadane katalogu lub informacje z manifestów pod kątem kolumn dodanych, usuniętych i o zmienionym typie. Kontrole wewnątrz bazy oceniają rekordy tam, gdzie już są, co pozwala uniknąć eksportu próbek i umożliwia zespołom testowanie liczby wierszy, zachowania wartości pustych, reguł biznesowych i wybranych relacji.
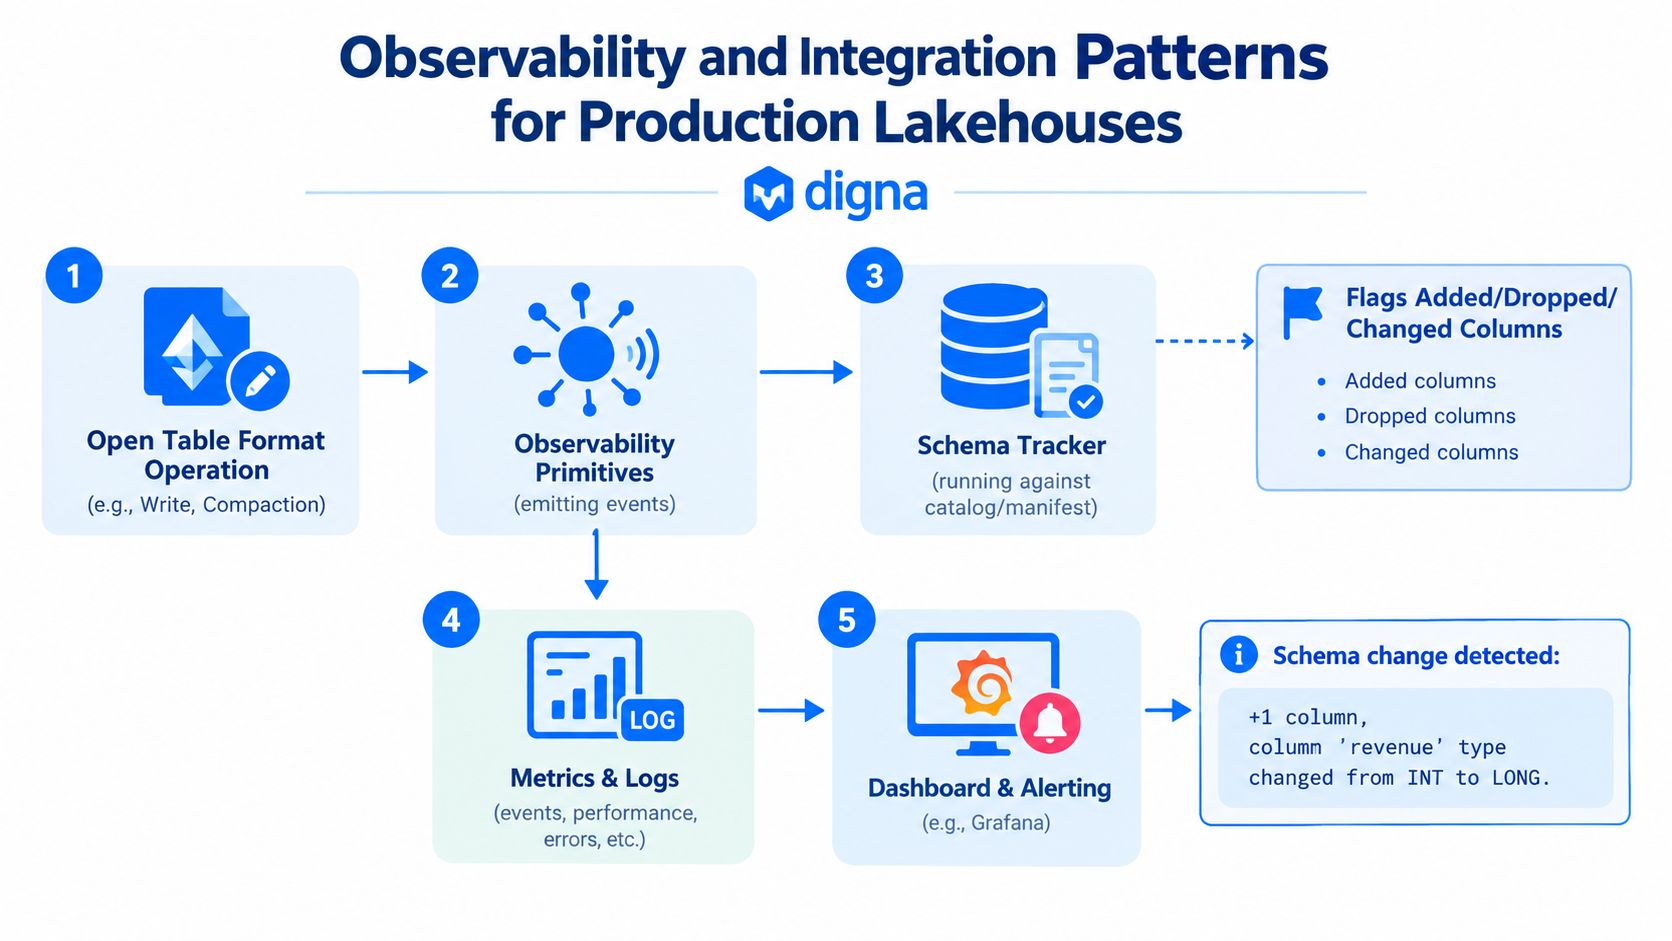
Cztery sygnały warte połączenia
Wykrywanie zmian schematu: oznacz kolumnę dodaną, usuniętą lub o zmienionym typie, zanim odbiorca niżej w łańcuchu zawiedzie albo wymusi konwersję wartości.
Walidacja danych: uruchamiaj asercje wobec tabeli dla pól wymaganych, dozwolonych wartości, reguł biznesowych na poziomie rekordów i warunków integralności.
Linie bazowe anomalii: porównuj liczbę rekordów w partycjach, rozmiary plików, zachowanie commitów i inne metryki z historycznym zachowaniem zbioru danych.
Monitorowanie Timeliness: porównuj tworzenie snapshotów i napływ danych z oczekiwanym harmonogramem dostaw, by technicznie udany potok nie ukrył incydentu świeżości.
Użyteczną jednostką monitorowania nie jest wyłącznie zadanie. To stan tabeli, który czytają odbiorcy. Udane zadanie może mimo wszystko opublikować niekompletny okres biznesowy, wprowadzić niezgodny schemat albo stworzyć patologiczny układ plików.
Szczegóły integracji i wdrożenia
Platforma obserwowalności może łączyć się z API Iceberg REST lub Unity Catalog po dostęp do schematu i metadanych, przyjmować ustrukturyzowane zdarzenia zapisu do analizy anomalii i wysyłać alerty do tych samych kanałów incydentów, których używa monitorowanie hurtowni. Znaczenie ma też umiejscowienie agentów. Zespoły muszą zdecydować, czy komponenty monitorujące działają obok środowiska obliczeniowego, w sieci prywatnej czy w innej kontrolowanej granicy usługi.
Uprawnienia muszą być zgodne z RBAC katalogu. Monitorowanie powinno widzieć wystarczająco dużo metadanych i zawartości tabel, by wyliczyć wymagane sygnały, nie omijając warstwy nadzoru. Platforma taka jak rozwiązanie obserwowalności danych digna może być jedną z opcji, z możliwościami śledzenia schematu, walidacji wewnątrz bazy, wykrywania anomalii i monitorowania terminowości w środowisku klienta.
Szersza zasada jest prosta: każdy commit powinien wytwarzać dowody na to, co się zmieniło, kiedy dotarło i czy jego zachowanie mieści się w przyjętej linii bazowej.
Wdrożenie i eksploatacja w środowiskach regulowanych
Wybór między Icebergiem, Delta Lake a Hudi rzadko bywa najtrudniejszą decyzją w środowisku regulowanym. Trudne pytania dotyczą tego, gdzie działa katalog, jak silniki się uwierzytelniają, jak uprawnienia odwzorowują się na wrażliwe kolumny i jak operacje na metadanych pojawiają się w śladzie audytowym.
Wdrożenie typu bring-your-own-cloud utrzymuje pamięć masową, usługi katalogowe, moc obliczeniową i monitorowanie w granicy chmurowej organizacji. Zespół kontroluje ścieżki sieciowe i retencję, ale odpowiada też za dostępność, aktualizacje, zarządzanie kluczami i testy odtwarzania. Projekt wieloregionowy dokłada decyzje o replikacji i rezydencji. Eksploatujący muszą określić, które metadane i snapshoty są replikowane, jak pochodzenie danych przechodzi między regionami i która procedura wycofania obowiązuje, gdy regiony się rozjadą.
Odizolowane wdrożenie lokalne znów zmienia ograniczenia. Zewnętrzne usługi zarządzane mogą być niedostępne, więc aktualizacje katalogu, testy zgodności formatu, obserwowalność i dowody incydentów muszą działać wewnątrz odizolowanego środowiska.

Kontrole do ustalenia przed produkcją
Lokalizacja katalogu: wybierz usługę zarządzaną, katalog we własnym hostingu lub ujednoliconą platformę nadzoru, kierując się wymogami odtwarzania, rezydencji i audytu.
Tożsamość i dostęp: odwzoruj uprawnienia katalogu na istniejące polityki RBAC lub ABAC, łącznie z tożsamościami usług używanymi przez ingestię i monitorowanie.
Obsługa danych wrażliwych: oznaczaj i nadzoruj dane osobowe w warstwie katalogu i platformy, zamiast zakładać, że format pliku egzekwuje politykę.
Zapewnienie w czasie działania: weryfikuj na bieżąco świeżość, zgodność schematu, zachowanie danych i zdarzenia dostępu, zamiast polegać na jednorazowej walidacji.
Zespoły powinny dokumentować te wybory obok wymogów rezydencji danych. Format może uczynić historię tabeli i stan plików bardziej jawnymi, ale to dojrzałość operacyjna decyduje, czy lakehouse dostarczy trwałych dowodów audytowych.
Praktyczna lista kontrolna przed standaryzacją formatu
Użyj tych zdań podczas najbliższego przeglądu architektury:
Dopasowanie katalogu: sprawdź, czy katalog obsługuje twoje silniki, model tożsamości, wymogi audytowe i projekt odtwarzania.
Zgodność silników: przetestuj rzeczywiste kombinacje Sparka, Trino, Flinka, hurtowni i BI, które będą czytać lub zapisywać tabele.
Strategia partycjonowania: dopasuj partycjonowanie i sortowanie do zaobserwowanych wzorców dostępu i zachowania zapisu.
Polityka snapshotów: zdefiniuj retencję, wycofanie, kompaktowanie i sprzątanie osieroconych plików przed użyciem produkcyjnym.
Kontrola dostępu: potwierdź, że wrażliwe kolumny, tożsamości usług i uprawnienia monitorowania są zgodne z istniejącymi politykami nadzoru.
Alerty schematu: monitoruj kolumny dodane, usunięte, przemianowane i o zmienionym typie, zanim odbiorcy niżej w łańcuchu przestaną działać.
SLA świeżości: porównuj napływ snapshotów z oczekiwanymi czasami dostaw dla odbiorców wsadowych i strumieniowych.
Linie bazowe anomalii: śledź w czasie liczbę plików, wolumeny rekordów, opóźnienie commitów i zachowanie partycji.
Procedura wycofania: przetestuj, jak eksploatujący rozpoznają wadliwy snapshot i przywracają bezpieczny stan tabeli.
Wracaj do listy po każdej większej aktualizacji silnika, zmianie regulacyjnej lub refaktoryzacji potoku. Otwarty format tabeli zmniejsza niejednoznaczność, ale nie znosi odpowiedzialności operacyjnej.
digna pomaga zespołom danych monitorować zmiany schematu, walidować rekordy wewnątrz bazy, wykrywać nietypowe zachowanie tabel i śledzić terminowość we własnej chmurze lub centrum danych. Odwiedź digna, by połączyć te kontrole z operacjami otwartego formatu tabeli, na których twój lakehouse już się opiera.
Standaryzacja formatu rozstrzyga, gdzie mieszkają metadane tabeli; nie rozstrzyga, czy zawarte w niej wartości są poprawne, a właśnie tam zaczyna się zarządzanie jakością danych.
Najczęściej zadawane pytania
Co otwarty format tabeli naprawdę rozwiązuje?
Brakujący kontrakt między plikami a silnikami. Surowe pliki nie mówią każdemu silnikowi, które z nich należą do logicznej tabeli, więc otwarty format tabeli leży obok danych i zapisuje to, co silniki muszą uzgodnić.
Co zapisuje ten kontrakt?
Pięć rzeczy: tożsamość tabeli niezależną od pojedynczego silnika, inwentarz plików wskazujący, które należą do tabeli, a których nie należy już czytać, układ partycji, by silniki mogły pomijać dane, historię schematu obejmującą dodania, usunięcia i zmiany nazw oraz atomowe snapshoty, by czytelnicy dostawali spójną wersję, gdy zapisujący commituje.
Jak szerokie jest wdrożenie Iceberga?
Apache Iceberg jest używany przez 58% organizacji do analityki krytycznej dla biznesu, a 95% wykorzystuje go lub planuje wykorzystać do obciążeń AI i uczenia maszynowego. Te dwie liczby tłumaczą, dlaczego wybór formatu stał się decyzją platformową, a nie szczegółem przechowywania.
Czy Iceberg, Delta Lake i Hudi rozwiązują różne problemy?
Podchodzą do tego samego problemu inaczej, zamiast rozwiązywać różne problemy. Wszystkie trzy dostarczają kontrakt tabeli; różnią się wzorcami zapisu, obsługą usunięć i powiązaniem z ekosystemem, dlatego wybór powinien iść za obciążeniem, a nie za marką.
Co warto potwierdzić przed standaryzacją jednego z nich?
Że przetrwa twoje regulowane wdrożenie, a nie tylko benchmark. Praca w skali przedsiębiorstwa niesie higienę metadanych, koordynację silników i ograniczenia wdrożeniowe, których proof of concept na jednym silniku nie ujawni.



