Obserwowalność jakości danych: praktyczny przewodnik dla zespołów danych
|
8
min. czyt.

Znasz to uczucie. O 6:45 dashboard wygląda bez zarzutu, ale o 8:00 liczby się nie zgadzają, VP pyta, dlaczego przychody zmieniły się w nocy, a zespół danych przekopuje logi pipeline'u, podczas gdy wszyscy inni czekają na odpowiedź. To właśnie data downtime i jeden z najszybszych sposobów, by zaufana warstwa raportowa stała się obciążeniem.
Obserwowalność jakości danych zmienia to podejście. Zamiast czekać na zepsute dashboardy, śledzi zachowanie danych w trakcie ich przepływu, dzięki czemu zespoły wychwytują opóźnienia w aktualności, schema drift, zmiany wolumenu i błędy walidacji, zanim przenikną one do decyzji. Nie chodzi o więcej alertów. Chodzi o wcześniejszy sygnał, sprawniejszy triage i mniej czasu poświęcanego na tłumaczenie, dlaczego liczbom nie można ufać.
Spis treści
Ukryty koszt wadliwych danych
Incydent w poniedziałkowy poranek rzadko zaczyna się dramatycznie. Zaczyna się od jednej nieaktualnej tabeli, jednego brakującego ładowania albo jednej cichej zmiany schematu, której nikt w porę nie zauważył. Zanim problem wyjdzie na jaw, szkody wychodzą już poza hurtownię danych i dotykają biznesu.
Skalę tego problemu łatwo nie docenić. Badanie Wakefield Research z 2023 roku, zlecone przez Monte Carlo, wykazało, że miesięczna liczba incydentów danych wzrosła z 59 w 2022 roku do 67 w 2023 roku, co oznacza 1,89-krotny wzrost data downtime, a 68% respondentów potrzebowało co najmniej czterech godzin na wykrycie incydentu. To samo badanie wskazało średni czas rozwiązania na poziomie 15 godzin na incydent, a ponad połowa respondentów stwierdziła, że co najmniej 25% przychodów jest narażonych na problemy z jakością danych, przy czym średni udział przychodów dotkniętych tymi problemami wzrósł do 31% z 26% rok wcześniej. Wszystkie te dane przytoczono w przeglądzie kategorii w raporcie o rynku data observability.
Jak to wygląda w praktyce
Analityk finansowy odświeża prezentację dla zarządu i zauważa liczbę, która nie zgadza się z wczorajszym eksportem. Data engineer sprawdza logi orkiestracji i widzi, że pipeline zakończył się pomyślnie, co jest gorszą, a nie lepszą wiadomością, bo problem kryje się teraz w treści danych, a nie w statusie joba. Zespół zaczyna porównywać liczby wierszy, szukać zmian schematu i pisać do właścicieli, którzy mogą nawet nie wiedzieć, że to oni spowodowali awarię.
Praktyczna zasada: jeśli pierwszym sygnałem problemu jest pytanie od użytkownika biznesowego, warstwa monitoringu jest już zbyt daleko w dół strumienia.
Właśnie dlatego obserwowalność ma znaczenie. Nie zastępuje analizy przyczyn źródłowych i nie sprawia magicznie, że dane stają się poprawne. Daje wcześniejsze ostrzeżenie, dzięki czemu zespół przestaje traktować każdy incydent jak niespodziankę i zaczyna traktować go jak kontrolowalne ryzyko operacyjne.

Najlepsze zespoły, z którymi pracowałem, przestały pytać: „Dlaczego ten dashboard się zepsuł?” i zaczęły pytać: „Co się zmieniło, zanim dashboard się zepsuł?”. Ta zmiana to sedno sprawy. Obserwowalność jakości danych pozwala odpowiedzieć na to pytanie, zanim biznes zapłaci za to cenę.
Czym jest obserwowalność jakości danych
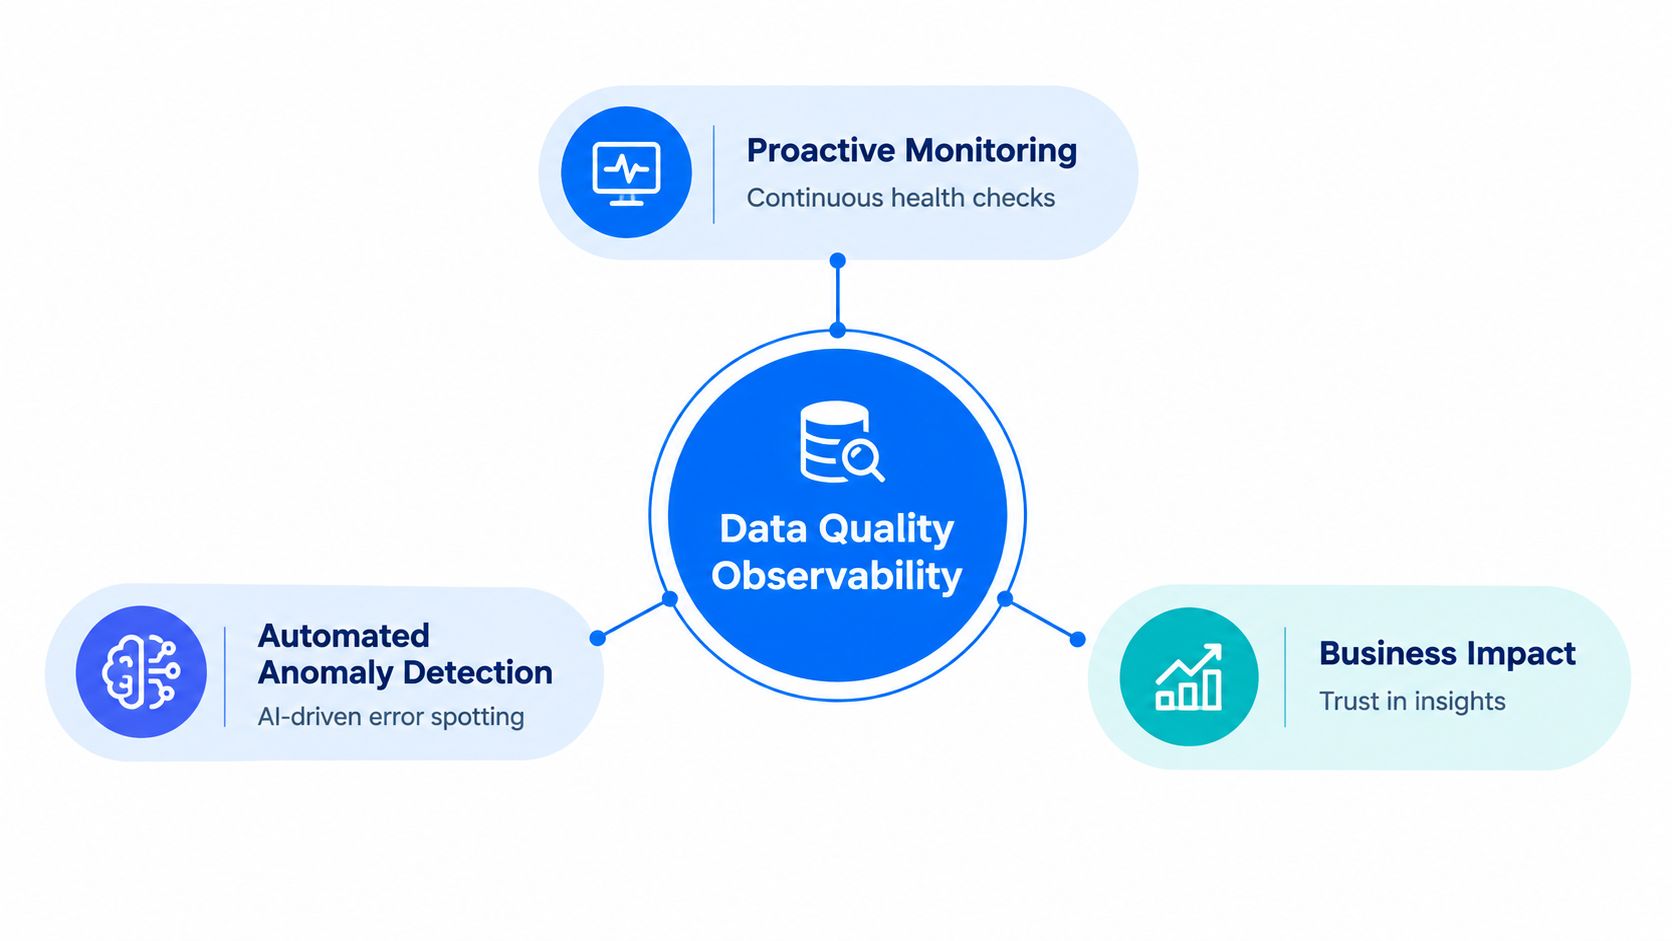
Dashboard może wyglądać dobrze, podczas gdy pipeline za nim stopniowo dryfuje. Tabela źródłowa może nadal ładować się na czas, ale jej schemat zmienia się pod spodem, transformacja zaczyna przekształcać wartości, a raporty w dalszej części procesu pozostają błędne, dopóki ktoś nie zauważy rozbieżności. Obserwowalność jakości danych koncentruje się na tych sygnałach systemowych, a nie tylko na końcowym wyniku na poziomie wierszy.
Od reguł do sygnałów
Kontrole oparte na regułach nadal mają znaczenie. Są precyzyjne, audytowalne i przydatne tam, gdzie logikę biznesową trzeba egzekwować na poziomie rekordu. Wiele jednak pomijają, bo wychwytują tylko to, czego awarii już się spodziewasz. Obserwowalność analizuje sygnały zewnętrzne, takie jak aktualność, wolumen, schemat, rozkład i lineage, a następnie na podstawie tych wzorców pokazuje, czy pipeline zachowuje się normalnie, zgodnie z definicją w praktycznych materiałach o obserwowalności.
Ta zmiana ma największe znaczenie, gdy pojawia się schema drift. Jeśli źródło doda, usunie, zmieni nazwę lub typ kolumny, krucha transformacja może zawieść bez ostrzeżenia albo przesłać błędne wartości do dalszej analityki, zanim ktokolwiek to zauważy, schema drift to kluczowy sygnał obserwowalności. Obserwowalność wychwytuje samą zmianę strukturalną, zamiast czekać, aż błędny wynik wyjdzie na powierzchnię.
Druga strona medalu to zmęczenie alertami. Statyczne reguły mogą generować długi strumień mało wartościowych alertów, zwłaszcza gdy zmiany w danych są dla biznesu czymś normalnym. Monitoring behawioralny ogranicza ten szum, sprawdzając, czy wzorzec zmienił się w istotny sposób, co lepiej pasuje do nowoczesnych pipeline'ów i do sposobu, w jaki zespoły badają incydenty.
Obserwowalność jest najskuteczniejsza, gdy śledzi zachowanie danych, a nie tylko to, czy wiersz spełnia regułę.
Co monitorować w pierwszej kolejności
Zacznij od sygnałów, które mówią, czy pipeline działa i jest spójny.
Aktualność: spóźnione dane to często pierwszy objaw zatrzymanego lub działającego gorzej pipeline'u.
Wolumen: nagłe skoki lub spadki mogą wskazywać na problemy z ingestion, duplikaty lub częściowe ładowania.
Schemat: nieoczekiwane zmiany pól to często najkrótsza droga do zepsutych transformacji.
Rozkład: przesunięcia we wzorcach wartości mogą ujawnić cichą korupcję danych, które na poziomie tabeli nadal wyglądają poprawnie.
Lineage: wiedza o tym, skąd pochodzą dane i dokąd płyną, pozwala śledzić wpływ zamiast zgadywać.
Praktyczny cel jest prosty. Jeśli kontrole jakości danych mówią, czy rekord jest akceptowalny, obserwowalność mówi, czy cały przepływ zachowuje się w sposób godny zaufania. Szersze omówienie tego, jak sygnały behawioralne zastępują statyczne reguły, znajdziesz w przeglądzie data observability.
Kluczowe sygnały w monitorowaniu kondycji danych
Monitoring działa najlepiej, gdy każdy sygnał odpowiada konkretnemu trybowi awarii i konsekwencji biznesowej. Tradycyjne kontrole oparte na regułach nadal są przydatne, ale często traktują każde odchylenie jako równie pilne. Obserwowalność oparta na AI dodaje bazowe wzorce zachowań, pomagając zespołom odróżnić oczekiwaną zmienność od wzorca, który zagraża dostępności danych, raportowaniu lub decyzjom operacyjnym. Celem jest mniej mało wartościowych alertów i szybsza reakcja na data downtime.
Aktualność, wolumen, schemat i walidacja działają razem
Timeliness to często najwcześniejszy sygnał, że pipeline się zatrzymał lub działa gorzej. Nowoczesne implementacje uczą się rytmu dostaw zbioru danych, wyliczają, kiedy powinno nadejść kolejne ładowanie, i alarmują, gdy jest ono spóźnione lub go brakuje, jak opisano w materiałach o monitoringu operacyjnym. Logika Timeliness potrafi też wykryć dostawy, które przychodzą wcześniej niż zwykle, co ma znaczenie, gdy źródło odbiega od swojego normalnego rytmu, ten wzorzec oparty na rytmie dostaw opisują również dokumentacje platform.
Wykrywanie anomalii dodaje kontekst do prostego progu. Skok w tabeli aktywności klientów może wynikać z uzasadnionej kampanii albo wskazywać na zduplikowany feed, który ponownie odtwarza rekordy. Model behawioralny nie ustali sam biznesowego wyjaśnienia, ale może zasygnalizować istotną zmianę, zanim analitycy zaczną polegać na tych danych.
Śledzenie schematu ogranicza awarie strukturalne w dalszej części procesu. Feed finansowy może dodać pole dopuszczające wartości null, a ekstrakt danych medycznych może zmienić definicję typu, nie ujawniając żadnego oczywistego problemu w źródle. Awaria może wyjść na jaw dopiero w transformacji, modelu lub dashboardzie, gdzie diagnoza zajmuje więcej czasu.
Walidacja łączy obserwowalność z regułami biznesowymi. Kontrole na poziomie wierszy porównują wartości z oczekiwanymi formatami, długościami i metrykami jakości. Wspierają prace związane z compliance, dowody na potrzeby audytu oraz ukierunkowany przegląd rekordów wysokiego ryzyka, a walidację na poziomie wierszy opisuje literatura dotycząca weryfikacji.
Przewodnik po metrykach data observability pomoże przypisać każdą metrykę do trybu awarii, który ma ujawniać.
Sygnał | Co wychwytuje | Czego nie wychwytuje |
|---|---|---|
Aktualność | Spóźnione lub brakujące ładowania | Błędne znaczenie biznesowe |
Wolumen | Brakujące dane, duplikaty, ponownie odtwarzane feedy | Drobne błędy na poziomie wierszy |
Schemat | Dodane, usunięte, przemianowane lub zmienione typem pola | Błędy semantyczne w poprawnych kolumnach |
Walidacja | Naruszenia reguł na poziomie rekordu | Nieoczekiwane zachowania poza zestawem reguł |
Zakres ważniejszy niż pokrycie
Głównym kosztem nie jest wybór sygnałów. Jest nim stosowanie ich bez rozróżnienia w dużych środowiskach, wielu stackach i ogromnej liczbie tabel. Szersze pokrycie zwiększa obciążenie obliczeniowe, ilość metadanych i narzut związany z alertami, na co praktycznie zwraca uwagę Databricks. Nadmiar alertów powoduje też zmęczenie operacyjne. Gdy inżynierowie przestają ufać powiadomieniom, prawdziwa awaria danych może czekać w kolejce za rutynowymi wahaniami.
Priorytetowo traktuj pipeline'y, których awaria wpłynęłaby na przychody, raportowanie, compliance lub obsługę klientów. Wykrywanie oparte na AI może ograniczyć powtarzalne alerty progowe, a jawna walidacja nadal sprawdza się przy znanych regułach. Stosowane razem, te podejścia dają spokojniejszy strumień alertów z jaśniejszą odpowiedzialnością i szybszą reakcją na incydenty.
Wzorce architektury obserwowalności
Większość porażek w obserwowalności wynika z wyborów architektonicznych, a nie z samego sygnału monitoringu. Zespoły albo przenoszą zbyt dużo danych do osobnego narzędzia, albo doklejają kontrole po fakcie i liczą, że kompromisy dotyczące opóźnień i bezpieczeństwa nie będą miały znaczenia. W praktyce architektura musi uwzględniać miejsce, w którym dane już się znajdują.
Kontrole jak najbliżej danych
Najmocniejszym wzorcem jest wykonywanie w bazie danych. Logika monitoringu działa wewnątrz hurtowni lub data lake'a, więc dane pozostają na miejscu, a zespół unika zbędnego przenoszenia ich między systemami. Ma to znaczenie zarówno dla bezpieczeństwa, jak i wydajności, zwłaszcza gdy platforma już obsługuje wrażliwe zbiory danych lub duże obciążenia.
Tu również modułowość pokazuje swoją wartość. Monolityczny stack obserwowalności bywa trudny do wdrożenia, bo zmusza zespoły do szerokiego rolloutu, zanim udowodnią jego wartość. Podejście modułowe pozwala zacząć od jednego problemu, takiego jak schema drift czy terminowość danych, a następnie rozszerzyć działania o walidację lub monitoring biznesowy, gdy pierwszy sygnał już działa.
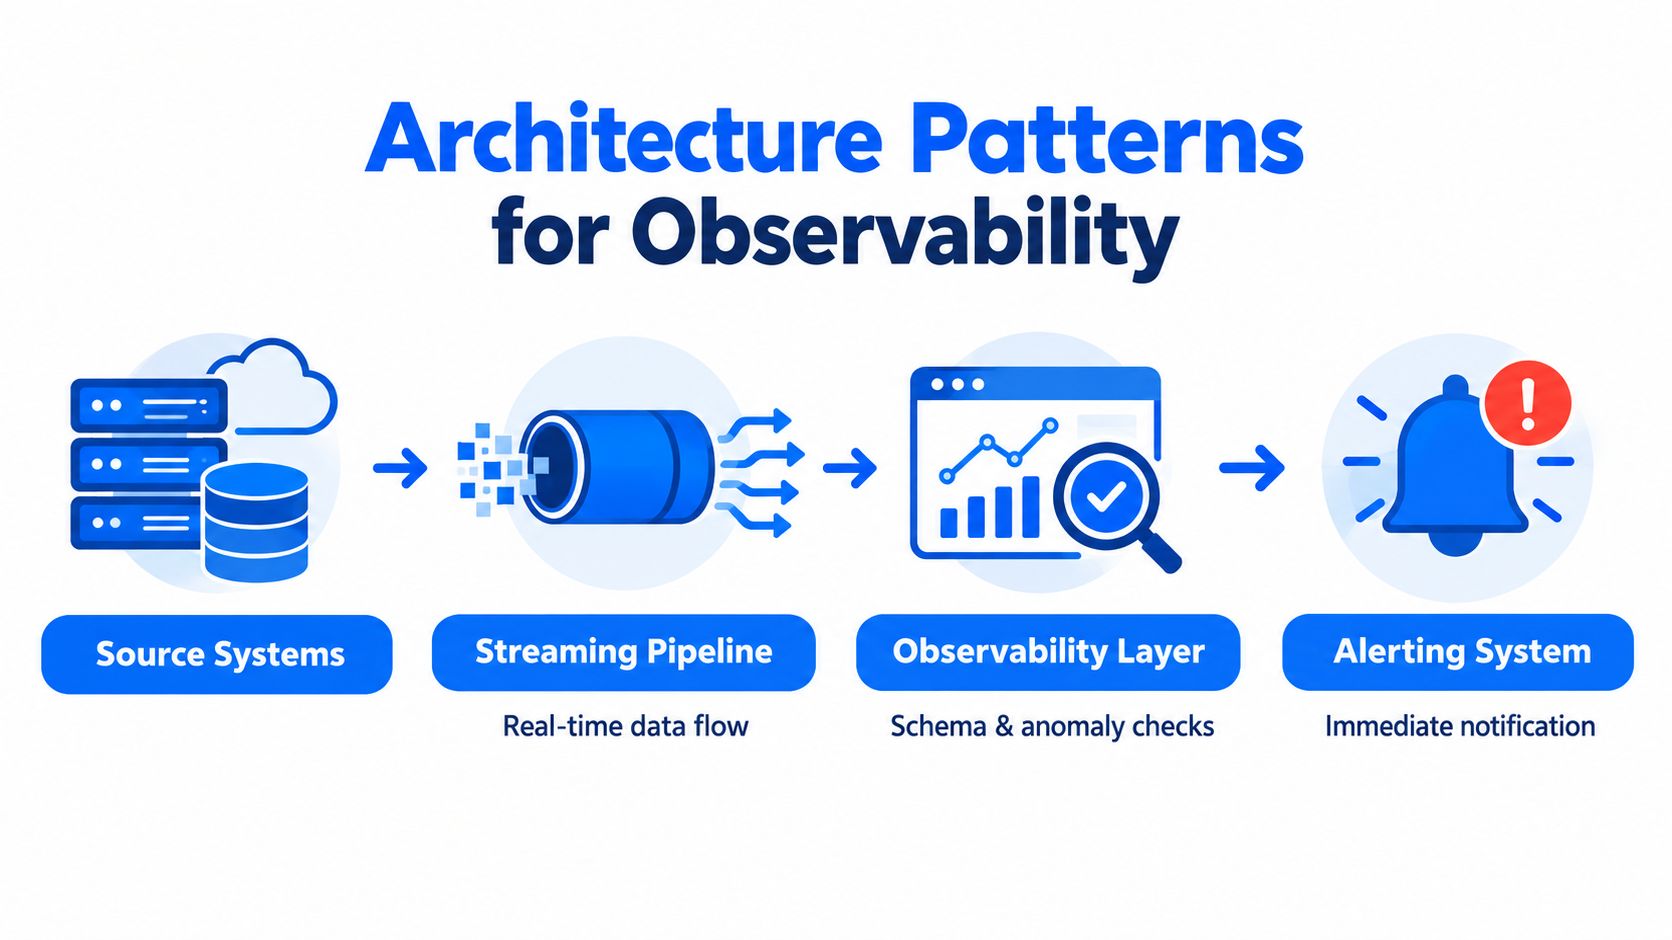
Przejrzysta architektura zwykle wygląda tak:
Systemy źródłowe generują dane operacyjne lub analityczne.
Pipeline'y strumieniowe lub wsadowe przenoszą dane do środowiska objętego governance.
Warstwa obserwowalności ocenia sygnały aktualności, schematu i anomalii tam, gdzie dane już się znajdują.
System alertów kieruje do właściwego właściciela tylko istotne incydenty.
Dlaczego platformy modułowe łatwiej wdrożyć operacyjnie
Platforma modułowa ogranicza zasięg skutków, gdy wprowadzasz obserwowalność do dojrzałego stacku. Możesz najpierw skierować ją na najważniejsze tabele, a potem rozszerzać zakres w miarę, jak zespół nabiera zaufania do jakości sygnału. Ułatwia to też wdrożenie zespołom data engineeringu, bo logika monitoringu rozwija się razem z pipeline'ami, zamiast wymuszać osobny model operacyjny.
Przewodnik digna po architekturze obserwowalności dobrze wpisuje się w ten modułowy wzorzec, zwłaszcza w przypadku zespołów, które chcą utrzymać monitoring blisko hurtowni lub data lake'a, zamiast budować oderwaną warstwę, której utrzymanie jest kosztowne.
Nie chodzi o architekturę dla samej architektury. Chodzi o mniejsze tarcia, mniej przenoszenia danych i pewność, że warstwa monitoringu nie stanie się kolejnym źródłem szumu operacyjnego.
Rola obserwowalności w analityce i AI
Zarówno analityka, jak i AI szybko zawodzą, gdy dane wejściowe dryfują. Dashboard może pokazywać błędne wyniki, bo feed się spóźnił. Model może stać się niewiarygodny, bo zmieniły się wartości cech. W obu przypadkach problem często pozostaje niewidoczny, dopóki biznes nie odczuje jego skutków.
Dlaczego AI podnosi poprzeczkę
Źródło z 2025 roku dotyczące rynku i luki we wdrożeniach wskazało, że 48% respondentów uważa niską jakość danych za główną barierę gotowości na AI, a inne badanie wykazało, że 74% organizacji uznaje monitorowanie krytycznych procesów biznesowych za ważne, a 54% twierdzi, że to jakość wykrywania alertów najbardziej wpływa na ROI z obserwowalności, jak podsumowano w analizie graczy rynkowych. To nie są abstrakcyjne liczby. Pokazują, że zespoły nie traktują już obserwowalności jako niszowego tematu inżynieryjnego, lecz jako warunek konieczny dla AI i raportowania na poziomie zarządu.
Ma to znaczenie, bo pipeline'y AI nie zależą wyłącznie od czystych rekordów. Zależą od stabilnych danych wejściowych, przewidywalnego zachowania cech i wiarygodnych sygnałów w dalszej części procesu. Jeśli dane zasilające model zmienią kształt, model może nadal zwracać wynik, ale ten wynik może tracić wartość bez żadnego wyraźnego sygnału awarii.
Wskaźniki biznesowe wymagają tej samej dyscypliny
Obserwowalność wyszła też poza klasyczny monitoring pipeline'ów w stronę monitorowania procesów biznesowych. To ważna zmiana, bo kadrę zarządzającą nie interesuje, czy diff schematu był ciekawy. Interesuje ją, czy churn klientów, wolumen zamówień, obsługa roszczeń lub inne biznesowe KPI wyszły poza oczekiwany zakres. Monitorowanie tych wskaźników na danych źródłowych daje zespołom wcześniejszy wgląd w dryf operacyjny, bez czekania, aż ujawni go warstwa raportowa.
Przewodnik digna dotyczący gotowości na AI wpisuje się w to szersze spojrzenie, bo obserwowalność nie dotyczy już wyłącznie kondycji technicznej. Chodzi o wykazanie, że fundament danych udźwignie analitykę, automatyzację i AI bez tworzenia martwych punktów.
Gdy zespołom to się uda, przestają pytać, czy dashboard działa. Zaczynają pytać, czy sygnały stojące za dashboardem nadal zasługują na zaufanie.
Platformy modułowe i przykłady z praktyki
Zaletą modułowej obserwowalności jest to, że pozwala zespołom rozwiązać konkretny problem z niezawodnością bez kupowania zupełnie nowego modelu operacyjnego. Ma to znaczenie w środowiskach korporacyjnych, gdzie zespoły z finansów, ochrony zdrowia, telekomunikacji i sektora publicznego mierzą się z różnymi wzorcami awarii i mają różną tolerancję na szum.
Gdzie sprawdza się modułowa obserwowalność
Zespół z sektora usług finansowych zwykle dba o terminowość, integralność transakcji i raportowanie w dalszej części procesu. Jeśli feed regulacyjny spóźni się, problem nie jest wyłącznie operacyjny. Podważa zaufanie do raportowania i może kaskadowo prowadzić do niedotrzymanych terminów. Platforma modułowa może najpierw skupić się na terminowości i wykrywaniu anomalii dla krytycznych feedów, a następnie dodać śledzenie schematu i walidację tam, gdzie reguły biznesowe są najważniejsze.
Zespół z sektora ochrony zdrowia ma inne ograniczenia. Kliniczne i operacyjne zbiory danych często wymagają walidacji, stabilności strukturalnej i identyfikowalności między systemami źródłowymi. Zmiany schematu w pipeline'ie elektronicznej dokumentacji medycznej mogą być równie dotkliwe jak opóźniona dostawa, bo mogą zepsuć analitykę lub procesy raportowe w dalszej części procesu, nawet gdy system źródłowy wydaje się działać poprawnie.
Dlaczego jedna platforma może pozostać skoncentrowana
digna to jedna z opcji w tej kategorii, a jej modułowa konstrukcja łączy wykrywanie anomalii oparte na AI, monitorowanie terminowości, śledzenie schematu i walidację na poziomie rekordów we własnym środowisku klienta. Ten model sprawdza się, gdy zespoły chcą pozostawić dane na miejscu i dodać obserwowalność bez przenoszenia danych produkcyjnych do osobnej usługi zewnętrznej.
Strona z przypadkami użycia digna przyda się zespołom, które porównują, jak te moduły odpowiadają na różne potrzeby operacyjne. Najważniejsza nie jest jednak marka. Najważniejsza jest zasada projektowa: zacznij od sygnałów dopasowanych do pipeline'ów o najwyższym ryzyku, a potem rozszerzaj zakres tylko tam, gdzie monitoring zwiększa zaufanie bardziej, niż dokłada narzutu.
Jeśli platforma nie potrafi wyjaśnić, dlaczego alert ma znaczenie dla biznesu, nie jest jeszcze gotowa.
Ta zasada obowiązuje we wszystkich branżach. Najlepsze wdrożenie obserwowalności to zwykle takie, które zaczyna się wąsko, udowadnia swoją wartość, a potem rośnie tylko tam, gdzie zespół jest w stanie utrzymać czysty sygnał.
Obalanie popularnych mitów
Największy mit głosi, że obserwowalność to po prostu ładniejszy sposób na znajdowanie złych rekordów. Tak nie jest. Jakość rekordów nadal ma znaczenie, ale trudniejszym problemem jest decyzja, co zasługuje na uwagę, bo każda nowa monitorowana tabela dokłada kosztów, metadanych i narzutu związanego z alertami.
Więcej monitoringu nie zawsze oznacza więcej zaufania
Hałaśliwy strumień alertów może podkopać zaufanie szybciej niż brak monitoringu. Gdy każde drobne odchylenie wywołuje powiadomienie dyżurne, inżynierowie zaczynają ignorować ostrzeżenia, a system traci wiarygodność. Dlatego kontrola zakresu jest tak ważna, zwłaszcza w dużych środowiskach, gdzie monitorowanie wszystkiego w tym samym stopniu jest zarówno kosztowne, jak i rozpraszające.
Kolejnym częstym błędem jest założenie, że obserwowalność jest tylko dla dużych przedsiębiorstw. Mniejsze zespoły też na niej zyskują, ale tylko wtedy, gdy skupiają się na najważniejszych pipeline'ach. Jeśli trzyosobowy zespół danych monitoruje każdą mało wartościową tabelę w hurtowni, utonie w pracy, której wcale nie potrzebuje.
Stosuj obserwowalność tam, gdzie biznes odczuwa ból
Praktyczna zasada jest prosta. W pierwszej kolejności obserwuj zasoby, w których opóźnienie, dryf lub awaria wpłynęłyby na raportowanie, doświadczenie klienta, compliance lub jakość modeli. Gdy będą stabilne, rozszerz działania na sąsiednie zbiory danych z tą samą dyscypliną.
Dobra obserwowalność zmniejsza niepewność. Zła obserwowalność tworzy jedynie bardziej dopracowaną wersję zmęczenia alertami.
To kluczowy kompromis. Więcej wykrywania ma sens tylko wtedy, gdy zespół może na tej podstawie działać, i to wystarczająco szybko, by miało to znaczenie. W przeciwnym razie warstwa monitoringu staje się kolejnym źródłem tarć.
Budowa strategii Data Observability
Skuteczna strategia zaczyna się od pipeline'ów, których awaria zabolałaby najbardziej. Brzmi to oczywiście, ale wiele zespołów wciąż zaczyna od instrumentacji najprostszego zbioru danych zamiast najważniejszego. Efekt to dopracowany dashboard dla tabeli niskiego ryzyka i brak realnej ochrony tam, gdzie biznes jest faktycznie narażony.
Zacznij od ścieżek krytycznych, nie od szerokiego pokrycia
Zidentyfikuj tabele, feedy i raporty, które napędzają finanse, operacje, doświadczenie klienta lub obciążenia AI. Następnie określ, które sygnały są najważniejsze dla każdego z nich. W jednym pipeline'ie kluczowym problemem może być spóźnione ładowanie, a w innym większe znaczenie mają zmiany schematu lub przesunięcia rozkładu.
Następnie wykorzystaj obserwowalność, by ograniczyć ręczne tworzenie reguł. Nie oznacza to rezygnacji z walidacji. Oznacza zarezerwowanie szczegółowych kontroli na poziomie rekordów dla zasobów, w których poprawność biznesowa ma największe znaczenie, i pozostawienie reszty środowiska monitoringowi behawioralnemu. Taka równowaga sprawia, że system pozostaje praktyczny.
Buduj z myślą o działaniu, nie tylko o wykrywaniu
Alerty powinny prowadzić do przypisania odpowiedzialności, triage'u i rozwiązania problemu. Jeśli platforma nie potrafi skierować incydentu do zespołu, który jest właścicielem danych, sygnał nie zamieni się w poprawkę. Jeśli alert nie pokazuje prawdopodobnego wpływu na dalsze etapy, inżynierowie spędzą zbyt dużo czasu na ręcznym odtwarzaniu zasięgu skutków.
Lepsze wyniki osiągniesz, jeśli wcześnie podejmiesz te trzy decyzje:
Zacznij od pipeline'ów o dużym wpływie: monitoruj dane, których awaria zmieniłaby decyzje biznesowe.
Oddziel sygnał od szumu: dostrój alerty tak, by zespół widział istotne odchylenia, a nie każde drobne wahanie.
Utrzymaj prosty model operacyjny: korzystaj z funkcji modułowych, aby obserwowalność rosła razem ze stackiem, zamiast go przytłaczać.
Długoterminowym celem jest zaufanie, a nie narzędzia. Gdy monitoring staje się częścią tego, jak zespół dostarcza wiarygodne dane, zespoły analityczne działają szybciej, użytkownicy biznesowi zadają mniej defensywnych pytań, a data engineering przestaje spędzać cały tydzień na usuwaniu skutków incydentów, którym można było zapobiec.
Jeśli dopracowujesz swoją strategię obserwowalności jakości danych, digna zapewnia zespołom modułowe wykrywanie anomalii, kontrole terminowości, śledzenie schematu i walidację we własnym środowisku. Odwiedź digna i zobacz, jak to podejście może wspierać wiarygodną analitykę i AI bez zbędnego przenoszenia danych i szumu operacyjnego.
Jeśli chcesz zobaczyć, jak to modułowe podejście z wykonywaniem w bazie danych wygląda w skali całej platformy, od aktualności i zmian schematu po anomalie i walidację, nasza strona obserwowalność platformy danych pokazuje, jak digna monitoruje te sygnały bez wynoszenia danych poza Twoje środowisko.
Najczęściej zadawane pytania
Czym jest obserwowalność jakości danych?
Obserwowalność jakości danych śledzi zachowanie danych podczas ich przepływu przez pipeline'y, korzystając z sygnałów takich jak aktualność, wolumen, schemat, rozkład i lineage. Zamiast czekać na zepsuty dashboard, wcześnie sygnalizuje spóźnione ładowania, schema drift lub zmiany wolumenu, dzięki czemu zespoły pytają, co się zmieniło, zanim dashboard się zepsuł, a nie dlaczego się zepsuł.
Czym data observability różni się od kontroli jakości danych opartych na regułach?
Kontrole oparte na regułach wychwytują tylko problemy, których już się spodziewasz, natomiast obserwowalność uczy się normalnego zachowania i sygnalizuje istotne zmiany. Reguły pozostają cenne przy precyzyjnej, audytowalnej logice na poziomie rekordów, ale pomijają nieoczekiwane awarie i mogą zalewać zespoły mało wartościowymi alertami. Artykuł zaleca utrzymanie walidacji dla znanych reguł i pozostawienie reszty monitoringowi behawioralnemu.
Które sygnały data observability warto monitorować w pierwszej kolejności?
Zacznij od aktualności, wolumenu, schematu, rozkładu i lineage, bo pokazują, czy pipeline działa i jest spójny. Każdy z nich odpowiada konkretnemu trybowi awarii: aktualność wychwytuje spóźnione lub brakujące ładowania, wolumen duplikaty i ponownie odtwarzane feedy, a schemat dodane, usunięte, przemianowane lub zmienione typem pola, choć żaden z nich samodzielnie nie wychwytuje błędów semantycznych.
Ile czasu zajmuje wykrycie incydentu danych?
Często więcej, niż zespoły się spodziewają: w badaniu Wakefield Research z 2023 roku 68% respondentów potrzebowało co najmniej czterech godzin na wykrycie incydentów danych. Rozwiązanie zajmowało średnio 15 godzin na incydent, a miesięczna liczba incydentów wzrosła rok do roku z 59 do 67, dlatego wcześniejszy sygnał jest ważniejszy niż szybsze gaszenie pożarów.
Czy kontrole obserwowalności powinny działać wewnątrz hurtowni danych?
Tak, wykonywanie w bazie danych to najmocniejszy wzorzec architektury, bo logika monitoringu działa tam, gdzie dane już się znajdują, zamiast kopiować je do osobnego narzędzia. Poprawia to bezpieczeństwo i wydajność przy wrażliwych lub dużych obciążeniach, a podejście modułowe pozwala zespołom zacząć od jednego problemu, na przykład schema drift, zanim rozszerzą zakres.



