Monitorowanie hurtowni danych: kompletny przewodnik na 2026 rok
|
7
min. czyt.

Poniedziałkowy poranek bywa bolesny, gdy dashboard zarządu otwiera się z nieaktualnymi liczbami, tabela przychodów jest opóźniona, a na Slacku ktoś pyta, dlaczego suma KPI nie zgadza się z danymi działu finansów. Taka jest operacyjna rzeczywistość stojąca za monitorowaniem hurtowni danych, czyli pracą, która sprawia, że zespoły nie dowiadują się o problemach dopiero wtedy, gdy użytkownicy biznesowi podjęli już decyzje na podstawie błędnych danych.
Rozdźwięk między oczekiwaniami a rzeczywistością wciąż jest duży. Wspólne podsumowanie badań z 2023 roku wykazało, że tylko 7% zespołów danych rozwiązuje problemy, zanim odczują je użytkownicy, 39% poświęca od 20% do 40% swojego czasu na naprawę pipeline'ów, 51% potrzebuje kilku godzin na rozwiązanie pojedynczego incydentu, a 36% potrzebuje kilku dni lub więcej badanie źródłowe dotyczące operacji data observability. Te liczby wyjaśniają, dlaczego monitorowanie nie jest już miłym dodatkiem do hurtowni, lecz częścią utrzymania ciągłości biznesu.
Zmiana jest widoczna także w całym rynku. Badanie branżowe z 2026 roku wykazało, że tylko 22% organizacji uważa data observability za krytyczne, kolejne 32% określa je jako bardzo ważne, a nieco ponad jedna trzecia deklaruje faktyczne wdrożenie badanie branżowe dotyczące dojrzałości observability. Ta luka mówi wszystko, ponieważ większość przedsiębiorstw wciąż potrzebuje lepszego wglądu w aktualność, jakość i wzorce awarii, zanim będzie mogła zaufać analityce i AI.
Spis treści
Dlaczego monitorowanie hurtowni danych jest ważne właśnie teraz
Hurtownia może z zewnątrz wyglądać na zdrową, a mimo to zawodzić w sposób, który wpływa na biznes. Dział finansów widzi czysty dashboard, dział sprzedaży widzi normalną linię trendu, a potem ktoś zauważa, że wczorajsze odświeżenie nigdy nie dotarło albo zmiana schematu zepsuła model downstream. Zanim takie problemy wyjdą na jaw, zespoły spędzają już poranek na uzgadnianiu systemów zamiast na korzystaniu z danych.
Koszt czekania, aż zauważą to użytkownicy
Najgorsze incydenty w hurtowni zwykle nie są głośne. Tabela może odświeżyć się z opóźnieniem, kolumna może zmienić typ, a pipeline może zakończyć się częściowym sukcesem i wciąż zostawić użytkowników biznesowych z nieaktualnymi wynikami. Monitorowanie ma znaczenie, ponieważ wychwytuje takie sytuacje, zanim przerodzą się w problemy z zaufaniem w całej organizacji.
Starsze modele operacyjne opierały się na ręcznych kontrolach i wiedzy plemiennej. To podejście przestaje działać, gdy od tej samej hurtowni zależą dziesiątki domen, interesariuszy i pipeline'ów.
Praktyczna zasada: jeśli ktoś musi otworzyć dashboard, żeby sprawdzić, czy hurtownia jest zdrowa, hurtownia jest już zbyt trudna w zarządzaniu.
Dlaczego observability stało się dyscypliną operacyjną
Podsumowanie badań z 2023 roku jasno pokazuje ten kompromis. Zespoły wciąż reagują po fakcie, zamiast zapobiegać problemom. Gdy inżynierowie poświęcają dużą część czasu na naprawę pipeline'ów, a i tak potrzebują godzin lub dni na rozwiązanie incydentów, problemem nie jest już jednorazowy błąd. Problemem jest sam model działania.
Dlatego dojrzałe programy monitorowania koncentrują się na wczesnym wykrywaniu, jasnej odpowiedzialności i szybkim kierowaniu zgłoszeń. Nie pytają tylko, czy zadanie się wykonało. Pytają, czy właściwe dane dotarły na czas, czy zmieniła się struktura, czy spadła jakość i czy biznesowe KPI nadal mają sens.
Dla zespołów, które chcą zacieśnić tę pętlę, praktycznym punktem wyjścia są dobre praktyki digna dotyczące hurtowni danych. Pomagają odróżnić „mamy alerty” od „wiemy, co robić, gdy hurtownia dryfuje”.
Skuteczny program monitorowania musi też uwzględniać realne kompromisy operacyjne. Zbyt wiele alertów sprawia, że zespoły je ignorują. Zbyt mało kontroli oznacza, że pierwszym sygnałem problemu jest sfrustrowany analityk albo zła decyzja, która już jest w toku. Właściwa równowaga łączy tradycyjną walidację z wykrywaniem anomalii, w tym podejściami działającymi w bazie danych, które utrzymują kontrole blisko danych i skracają czas między awarią a jej wykryciem.
Nagrodą jest zaufanie. Gdy hurtownia jest monitorowana celowo, inżynierowie danych spędzają mniej czasu na gaszeniu pożarów, analitycy rzadziej ręcznie weryfikują ekstrakty, a kadra zarządzająca przestaje pytać, która wersja liczby jest poprawna. To właśnie sprawia, że hurtownia nadaje się do użytku w skali przedsiębiorstwa.
Kluczowe elementy monitorowania hurtowni danych
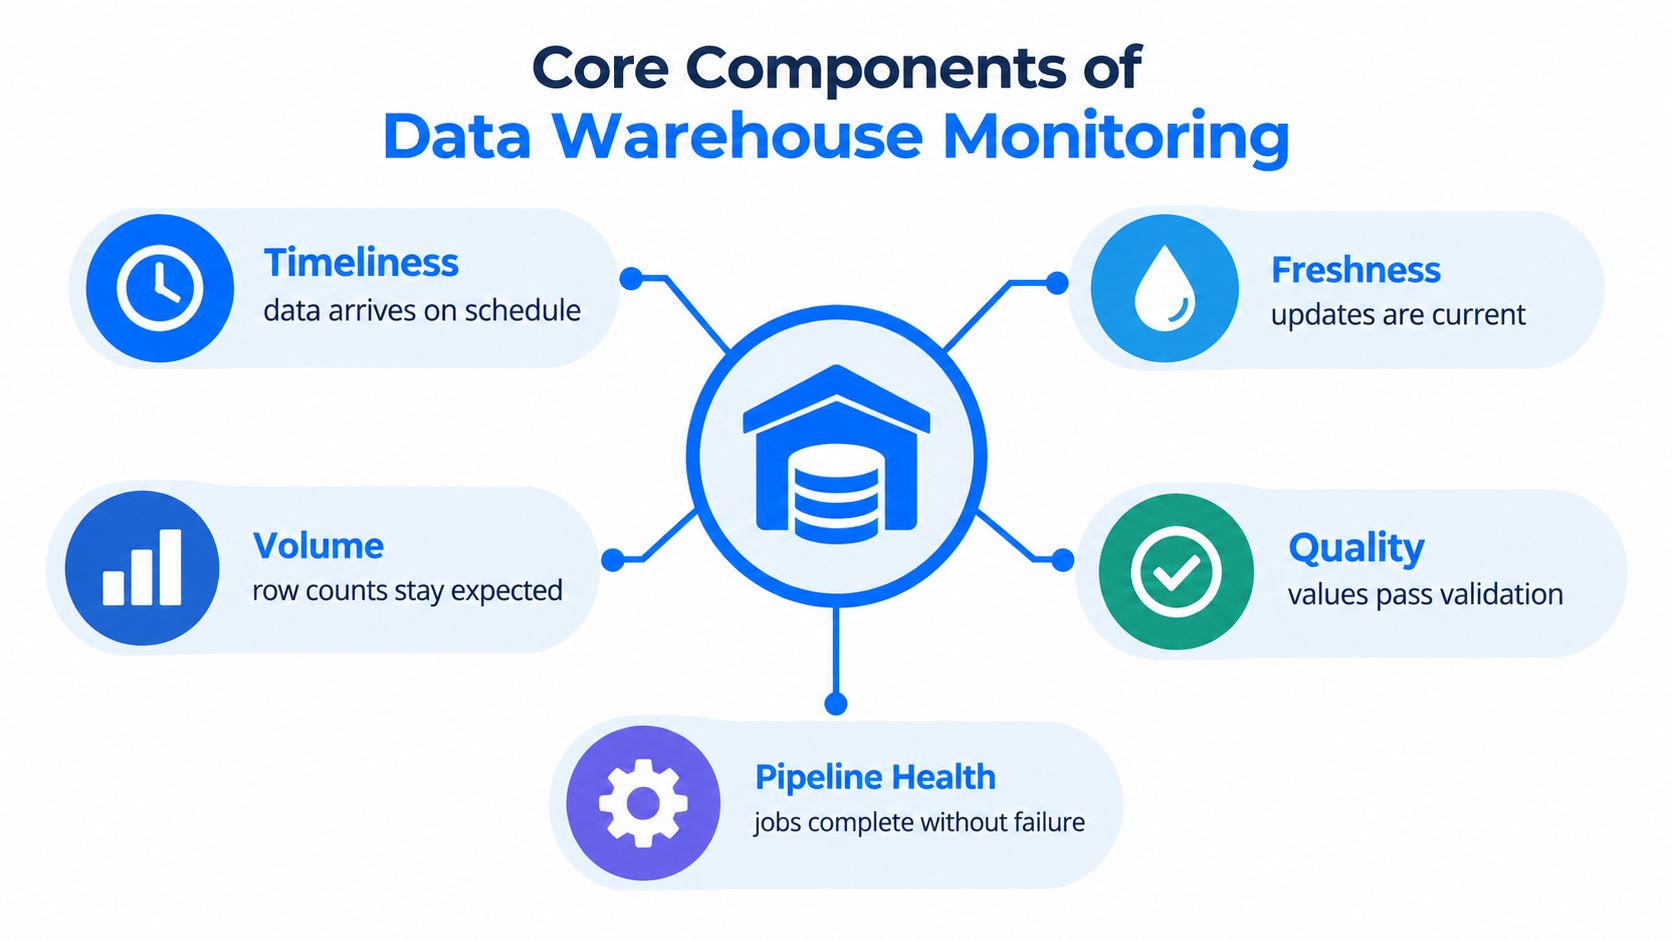
Monitorowanie działa tylko wtedy, gdy obejmuje właściwe warstwy ryzyka. Hurtownia może załadować się na czas i nadal zawierać błędne rekordy. Może też wyglądać na aktualną, podczas gdy zmiana pola po cichu psuje modele downstream. Solidne monitorowanie łączy te rodzaje awarii, zamiast traktować je jako osobne narzędzia.
Terminowość i aktualność są powiązane, ale to nie to samo
Monitorowanie terminowości sprawdza, czy aktualizacje docierają wtedy, kiedy powinny. Praktyczny test jest prosty: porównaj faktyczny czas aktualizacji z harmonogramem lub SLA, a następnie wyślij alert, gdy różnica stanie się zbyt duża. Typowym przykładem jest tabela godzinowa, która wyzwala alert, gdy przerwa między aktualizacjami przekracza około 2 godzin wytyczne dotyczące monitorowania terminowości.
Aktualność (freshness) to wiek najnowszego rekordu. Terminowość pyta, czy ładowanie odbyło się na czas. Aktualność pyta, jak bieżące są dane w tej chwili. Zespoły często mylą te pojęcia, co rodzi fałszywe poczucie bezpieczeństwa. Zadanie może wykonać się zgodnie z harmonogramem i mimo to załadować stare rekordy. Opóźnione zadanie może z kolei dostarczyć bieżące dane, gdy już się zakończy.
Monitorowanie schematu i jakości wychwytuje cichsze awarie
Schema drift to jeden z najłatwiejszych sposobów na zepsucie odbiorców downstream bez widocznego incydentu. Zmiany strukturalne, takie jak dodanie i usunięcie kolumn, zmiany typów, zmiany nazw pól i zmiany ograniczeń, mogą bez ostrzeżenia zepsuć dashboardy, data marty i modele, jeśli nie zostaną wychwycone i zakomunikowane. Zespołom, które potrzebują praktycznego punktu odniesienia, dobre praktyki digna dotyczące hurtowni danych dają dobry start do przemyślenia kontroli zmian w strukturze hurtowni. Celem jest nie tylko wykrycie zmiany, ale też upewnienie się, że właściciele downstream wiedzą, co się zmieniło, zanim wdrożą błędne założenia.
Monitorowanie jakości działa na poziomie rekordów. Powinno walidować dane względem reguł biznesowych i obejmować kontrole kompletności, dokładności, spójności i terminowości wytyczne dotyczące incydentów jakości danych. Neutralne wytyczne zalecają też mierzalne progi, takie jak wartości null poniżej 0,1% i zero zduplikowanych identyfikatorów klientów w miesiącu, aby jakość nie pozostawała kwestią subiektywną.
Gdy monitorowanie jest mgliste, zespoły spierają się o wagę problemu. Gdy jest mierzalne, mogą działać.
Wydajność i kondycja pipeline'ów utrzymują system w używalności
Monitorowanie wydajności to element, który wiele zespołów odkłada, dopóki użytkownicy nie zaczną narzekać. Śledzi zużycie zasobów, opóźnienia zapytań i przepustowość, aby hurtownia nie stała się tak wolna, że w praktyce przestaje działać. Ma to znaczenie, ponieważ hurtownia, która technicznie działa, ale odpowiada zbyt wolno, i tak zawodzi biznes.
Kondycja pipeline'ów łączy wszystkie pozostałe sygnały. Jeśli zadania kończą się błędem, ponawiają się w nieskończoność albo zaczynają trwać dłużej w sposób, którego nikt nie zauważa, każda inna warstwa staje się bardziej zaszumiona. Zespoły, które monitorują kondycję pipeline'ów razem z jakością i aktualnością danych, otrzymują wcześniejsze ostrzeżenia i rzadziej przerzucają się winą między zespołami platformy i analityki.
Zespołom, które potrzebują praktycznego modelu operacyjnego zamiast teorii, podejście digna do integracji z hurtownią danych pokazuje, jak monitorowanie może działać blisko hurtowni, zamiast być doczepione jako osobny system.
Tradycyjne reguły a observability oparte na AI
Statyczne reguły nadal mają znaczenie, ale same nie wystarczą. Sztywno zakodowane progi dobrze wychwytują znane rodzaje awarii, zwłaszcza gdy reguła biznesowa jest jasna, a tolerancja stała. Radzą sobie gorzej, gdy dane zmieniają kształt, wzorce dryfują albo anomalie pojawiają się w sposób, którego nikt nie przewidział.
W czym statyczne reguły są dobre, a gdzie zawodzą
Monitorowanie oparte na regułach jest proste. Jeśli zadanie się spóźnia, jeśli wartości null przekraczają próg, jeśli znika krytyczna kolumna, alert zostaje wysłany. Dzięki temu łatwo je wyjaśnić, łatwo audytować i dobrze sprawdza się w kontrolach wynikających z wymogów compliance.
Wadą jest utrzymanie. Każdy nowy zbiór danych, przypadek brzegowy czy reguła biznesowa to kolejny próg do dostrojenia. W dużych środowiskach sama liczba alertów staje się problemem, ponieważ ludzie przestają ufać powiadomieniom, gdy zbyt wiele z nich jest rutynowych lub mało wartościowych.
Jak observability oparte na AI zmienia nakład pracy
Observability oparte na AI idzie inną drogą. Zamiast wymagać od inżynierów zdefiniowania każdego progu z góry, uczy się bazowego zachowania każdego zbioru danych i sygnalizuje odchylenia od oczekiwanego wzorca. Dzięki temu sprawdza się przy dryfie, subtelnych anomaliach i sytuacjach, które nie pasują do prostej reguły.
Kompromisem jest dojrzałość. Metody oparte na AI potrzebują wystarczającej historii, żeby się uczyć, i nadal wymagają dostrajania, gdy zmieniają się wzorce użycia. Najlepiej sprawdzają się w połączeniu z ukierunkowanymi regułami dla znanej logiki biznesowej, podczas gdy warstwa AI odpowiada za szerokie wykrywanie anomalii i priorytetyzację.
Warto spojrzeć na to w ten sposób.
Obszar | Statyczne reguły | Observability oparte na AI |
|---|---|---|
Wykrywanie | Znane rodzaje awarii | Nieoczekiwany dryf i anomalie |
Szum | Mogą być precyzyjne, ale w skali generują szum | Może ograniczyć mnożenie ręcznych progów, ale nadal wymaga dostrajania |
Utrzymanie | Stałe utrzymywanie reguł | Zarządzanie punktami bazowymi i dostrajanie modeli |
Szerszy kontekst operacyjny dają trendy w monitorowaniu wydajności IT, które stanowią użyteczną analogię tego, jak zespoły monitorujące ograniczają szum, nie tracąc z oczu istotnych sygnałów.
Najlepsze konfiguracje produkcyjne zwykle łączą oba podejścia. Stosuj deterministyczne reguły tam, gdzie kontrole nigdy nie mogą być niejednoznaczne, a następnie dodaj wykrywanie oparte na AI tam, gdzie hurtownia zachowuje się bardziej jak żywy system niż jak stała lista kontrolna. Zespołom oceniającym różne metody praktycznym punktem odniesienia będzie porównanie digna kontroli jakości opartych na AI z metodami tradycyjnymi.
Kluczowe metryki, które powinien monitorować każdy zespół
Program monitorowania staje się realny, gdy śledzi metryki, na podstawie których można działać. Nie chodzi o mierzenie wszystkiego. Chodzi o mierzenie tego, co mówi, czy hurtownia poprawnie zasila biznes.
Zacznij od terminowości, jakości i wydajności
Metryki terminowości porównują faktyczny czas aktualizacji z oczekiwanym harmonogramem lub SLA. Jeśli zadanie wsadowe ma uruchamiać się codziennie, potrzebujesz jasnego progu określającego, jakie opóźnienie uzasadnia alert. Dokładny próg zależy od biznesu, ale najważniejsze jest, aby zespół uzgodnił go z wyprzedzeniem, a nie po incydencie.
Metryki jakości zamieniają reguły biznesowe w kontrole. Używaj ich do walidacji kompletności, dokładności, spójności i terminowości na poziomie wierszy wytyczne dotyczące monitorowania jakości. Gdy progi są mierzalne, zespoły mogą zdecydować, czy pogorszenie jest akceptowalne, przejściowe, czy też jest prawdziwym incydentem wymagającym triażu.
Metryki wydajności powinny obejmować czas odpowiedzi zapytań, przepustowość pipeline'ów i wykorzystanie zasobów. Wolne zapytania i przeciążone pipeline'y są często pierwszym sygnałem, że hurtownia jest pod presją, zwłaszcza w okresach intensywnego raportowania lub po uruchomieniu nowego modelu.
Nie poprzestawaj na kondycji technicznej
Metryki biznesowe mają znaczenie, ponieważ ujawniają problemy, których nie wychwytują kontrole techniczne. Przychody, liczba transakcji, aktywność klientów i inne operacyjne KPI mogą ujawnić problem z hurtownią szybciej niż strona ze statusem zadań. Jeśli kluczowa metryka biznesowa nagle się zmienia, choć otoczenie biznesowe pozostaje bez zmian, hurtownia zasługuje na dokładne sprawdzenie.
Dlatego też aktualność i terminowość należy traktować osobno. Tabela może być aktualizowana zgodnie z harmonogramem i nadal zawierać nieaktualne wartości źródłowe albo może zawierać świeże wartości, ale z opóźnieniem, którego użytkownicy nie mogą zaakceptować. Oba stany są użytecznymi sygnałami, ale wskazują na różne przyczyny źródłowe.
Dobre monitorowanie nie pyta tylko, czy dane istnieją. Pyta, czy biznes może im zaufać.
Zespołom, które chcą zdefiniować te sygnały w bardziej uporządkowany sposób, praktycznym punktem odniesienia będą wytyczne digna dotyczące metryk terminowości danych. Pomagają powiązać oczekiwania wynikające z harmonogramu z operacyjną rzeczywistością dostarczania danych do hurtowni.
Przejrzysty zestaw metryk sprawia też, że przeglądy incydentów pozostają rzetelne. Jeśli zespół widzi jednocześnie czas, jakość i wpływ na biznes, znacznie łatwiej odróżnić problem z ładowaniem od problemu z modelowaniem lub rzeczywistej zmiany w biznesie.
Wzorce wdrożeniowe monitorowania w przedsiębiorstwie
Monitorowanie w przedsiębiorstwie zawodzi, gdy tworzy więcej systemów do zarządzania, niż zapobiega problemom. Najskuteczniejszy wzorzec wdrożenia utrzymuje kontrole blisko danych, zatrzymuje wrażliwe informacje w środowisku klienta i sprawia, że alerty są zrozumiałe dla zespołów, które muszą na nie reagować.
Wykonywanie w bazie danych to najbezpieczniejszy domyślny wybór operacyjny
Uruchamianie kontroli w bazach danych samego klienta ogranicza przepływ danych i lepiej spełnia wymogi bezpieczeństwa i ładu danych niż eksportowanie wszystkiego do systemów zewnętrznych. Ma to znaczenie w środowiskach regulowanych, ale także w zwykłych przedsiębiorstwach, które nie chcą przenosić wrażliwych danych z hurtowni na potrzeby monitorowania.
Architektura ma tu większe znaczenie niż marka. Model działający w bazie danych pozwala warstwie monitorowania analizować dane tam, gdzie się znajdują, a jednocześnie generować alerty, trendy i aktualizacje statusu widoczne dla właściwych osób. W praktyce oznacza to zwykle mniej tarć z zespołami bezpieczeństwa i mniej niespodzianek podczas przeglądów.
Scentralizowane alerty potrzebują kontekstu, nie tylko szybkości
Ujednolicone alertowanie działa tylko wtedy, gdy powiadomienia są powiązane z właściwym właścicielem i właściwą ścieżką reakcji. Zaszumiony strumień incydentów nie pomaga, jeśli ta sama wiadomość trafia na pięć kanałów, a nikt nie wie, kto odpowiada za naprawę. System monitorowania musi kierować zgłoszenia według zbioru danych, domeny lub typu awarii, aby właściwa osoba zobaczyła właściwy sygnał.
Pragmatyczny wzorzec dla przedsiębiorstw wygląda następująco.
Kontrole w bazie danych: wykonuj obliczenia obok hurtowni, aby ograniczyć przepływ danych i uprościć ład danych.
Dostęp oparty na rolach: ogranicz krąg osób, które widzą wrażliwe szczegóły incydentów.
Dopasowanie operacyjne: integruj się z narzędziami do orkiestracji i komunikacji, z których zespół już korzysta.
Wspólna widoczność: udostępniaj ten sam sygnał inżynierom, analitykom i użytkownikom biznesowym, bez zmuszania ich do korzystania z różnych wersji prawdy.
Dla zespołów oceniających narzędzia wspierające ten model istotny jest przegląd monitorowania i raportowania w digna, ponieważ pokazuje, jak alertowanie i raportowanie mogą działać na kontrolach natywnych dla hurtowni, nie tworząc problemu osobnej kopii danych.
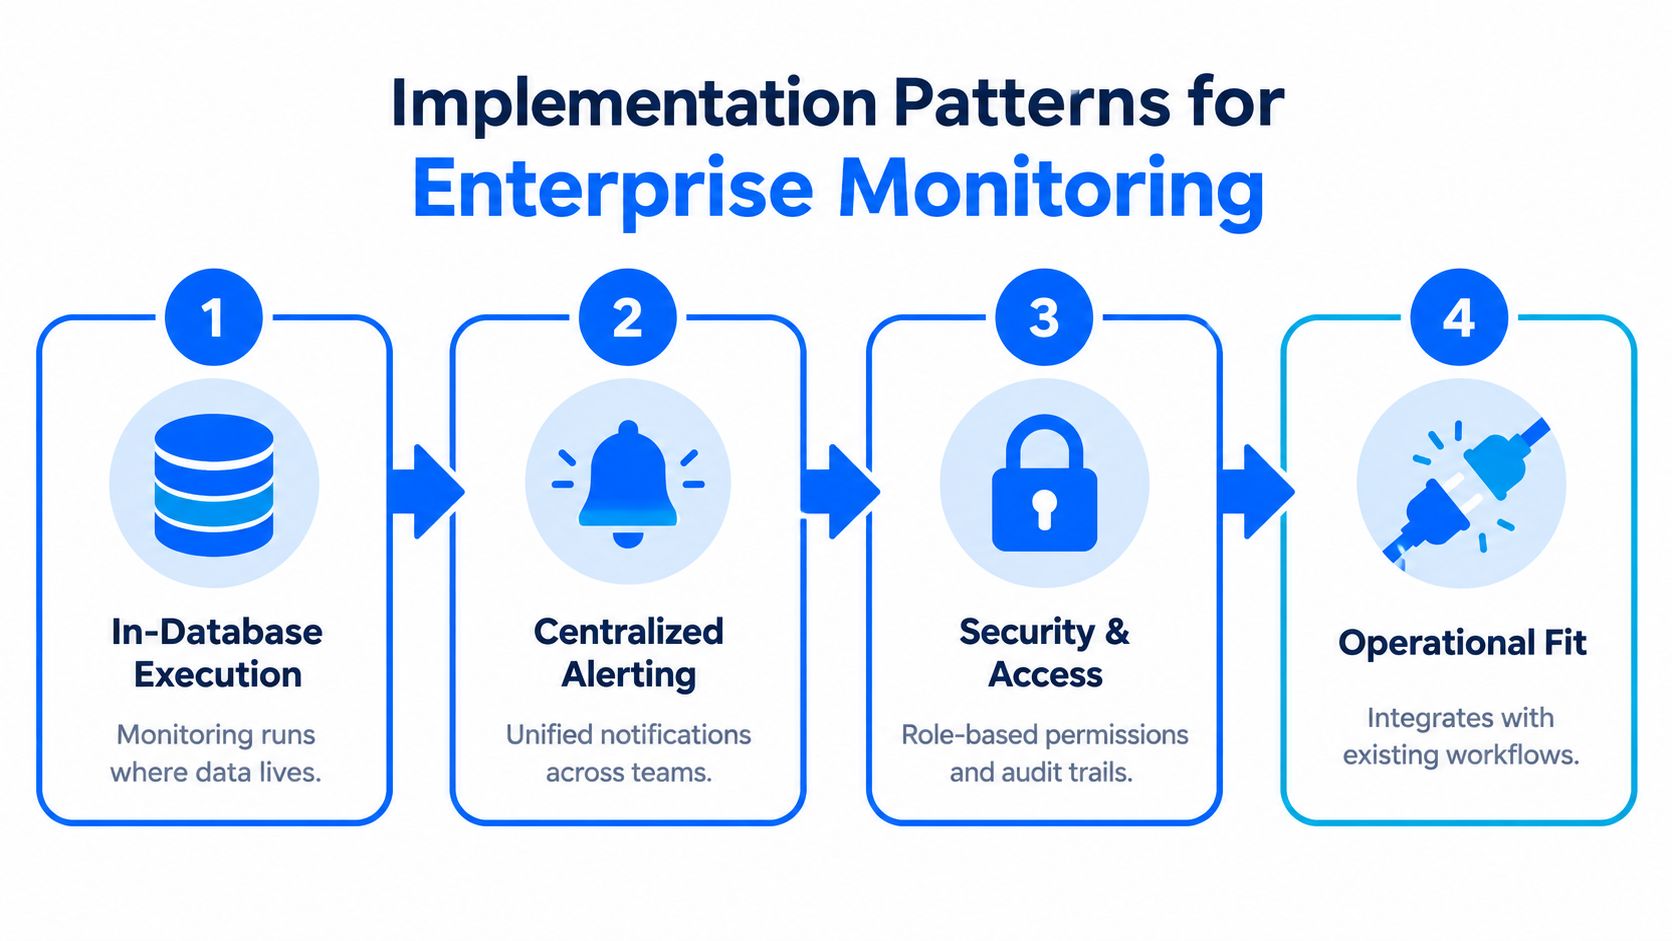
Celem jest dopasowanie operacyjne. Jeśli warstwa monitorowania przerywa każdy proces pracy, nie przetrwa zderzenia z produkcją. Jeśli pasuje do sposobu, w jaki zespół hurtowni już pracuje, staje się częścią płaszczyzny kontroli, a nie kolejnym dashboardem, którego nikt nie sprawdza.
Budowanie kultury monitorowania na lata
Narzędzia do monitorowania same z siebie nie zapewniają niezawodności. Zapewniają ją zespoły. Organizacje, którym się to udaje, traktują observability jako część operacji na danych, a nie jednorazowe zadanie konfiguracyjne przekazane inżynierom po incydencie.
Odpowiedzialność i reakcja muszą być jasno określone
Każda domena danych potrzebuje jasno wskazanego właściciela, a każdy typ alertu znanej ścieżki reakcji. Gdy pojawi się zmiana schematu, analytics engineer powinien wiedzieć, czy zaktualizować model, powiadomić właściciela dashboardu, czy eskalować sprawę do zespołu platformy. Gdy reguła jakości nie przejdzie, ktoś musi zdecydować, czy problem leży w danych źródłowych, w błędnej transformacji, czy w regule biznesowej wymagającej zmiany.
Równie ważne są pętle informacji zwrotnej. Każdy incydent powinien zostawić po sobie coś użytecznego: lepszy próg, czystszą regułę lub dokładniejszy punkt bazowy. Bez tej pętli zespoły po prostu powtarzają to samo gaszenie pożarów z nieco innymi objawami.
Przeglądaj szum, szkol użytkowników i utrzymuj program przy życiu
Regularne przeglądy to sposób, w jaki dobre programy monitorowania pozostają w dobrej kondycji. Zespoły powinny wracać do tego, które alerty zostały wysłane, które były przydatne, a które należy wycofać lub zaostrzyć. Jeśli nikt nigdy nie weryfikuje zestawu sygnałów, zmęczenie alertami z czasem podkopie zaufanie.
Druga połowa pracy to szkolenia. Inżynierowie, analitycy i użytkownicy biznesowi muszą rozumieć, co oznaczają alerty i jakie działania powinni podjąć. Platforma monitorowania działa tylko wtedy, gdy ludzie potrafią ją interpretować bez zwoływania spotkania przy każdej zmianie.
Hurtownia jest niezawodna, gdy zespół potrafi szybko wyjaśnić jej awarie i zapobiec ich powrotowi.
Dlatego też observability stało się warunkiem wstępnym wiarygodnej analityki i AI. Model jest tak niezawodny, jak dane, które go zasilają, a dashboard jest tak użyteczny, jak pipeline, który za nim stoi. Organizacje, które budują kulturę monitorowania, nie tylko ograniczają przestoje, ale też szybciej podejmują decyzje, ponieważ mniej z nich wymaga wcześniejszej ręcznej weryfikacji danych.
Zespołom gotowym do wzmocnienia jakości danych, ich aktualności, śledzenia schematów i monitorowania biznesowego w ramach jednego modelu operacyjnego digna oferuje platformę observability działającą w bazie danych, która mieści się we własnym środowisku klienta. Sprawdź ją, jeśli szukasz praktycznego sposobu na monitorowanie zachowania hurtowni bez eksportowania wrażliwych danych poza Twój stack.
Aby zobaczyć, jak opisane tu kontrole terminowości działają bez ręcznie ustawianych harmonogramów dla każdej tabeli, zajrzyj do modułu Timeliness od digna, który uczy się typowego wzorca nadejścia danych dla każdej tabeli i wysyła alert, gdy ładowanie jest opóźnione lub go brakuje.
Najczęściej zadawane pytania
Czym jest monitorowanie hurtowni danych?
To ciągłe sprawdzanie hurtowni pod kątem opóźnionych ładowań, nieaktualnych danych, zmian schematu, spadku jakości i niskiej wydajności, tak aby problemy zostały wychwycone, zanim użytkownicy biznesowi zaczną działać na podstawie błędnych liczb. Dojrzałe programy obserwują także biznesowe KPI, ponieważ nagła zmiana metryki często jako pierwsza ujawnia problem z pipeline'em.
Czym różni się terminowość danych od ich aktualności?
Terminowość sprawdza, czy ładowanie dotarło wtedy, kiedy powinno, zgodnie z harmonogramem lub SLA. Aktualność sprawdza, jak stary jest w tej chwili najnowszy rekord. Zadanie może wykonać się na czas i mimo to załadować stare rekordy, a opóźnione zadanie może dostarczyć bieżące dane, dlatego każde z tych zjawisk wymaga osobnej kontroli.
Jakie metryki powinien śledzić program monitorowania hurtowni danych?
Zacznij od terminowości względem oczekiwanego harmonogramu, jakości na poziomie rekordów pod kątem kompletności, dokładności i spójności oraz wydajności, takiej jak czas odpowiedzi zapytań, przepustowość pipeline'ów i wykorzystanie zasobów. Dodaj metryki biznesowe, takie jak przychody czy liczba transakcji, ponieważ ujawniają problemy, których nie wychwytują techniczne kontrole kondycji.
Czy kontrole anomalii oparte na AI są lepsze od statycznych reguł?
Żadne z tych podejść nie wystarcza samodzielnie. Statyczne reguły sprawdzają się przy znanych rodzajach awarii i kontrolach compliance, ponieważ łatwo je wyjaśnić i audytować, ale w dużej skali ich utrzymanie staje się kosztowne. Kontrole oparte na AI uczą się punktu bazowego każdego zbioru danych i wychwytują nieoczekiwany dryf, dlatego konfiguracje produkcyjne zwykle łączą oba podejścia.
Dlaczego warto uruchamiać monitorowanie hurtowni danych wewnątrz bazy danych?
Wykonywanie w bazie danych utrzymuje kontrole obok danych, więc wrażliwe rekordy nigdy nie muszą być eksportowane do zewnętrznego systemu monitorowania. Ogranicza to przepływ danych, spełnia wymogi bezpieczeństwa i ładu danych w branżach regulowanych i zwykle oznacza mniej tarć podczas przeglądów bezpieczeństwa, przy zachowaniu alertów i trendów.



