Jak efektywnie uruchomić zapytanie w 2026 roku
|
6
min. czyt.

Można wdrożyć zapytanie, które zwraca wiersze, przechodzi testy, a mimo to sprawia kłopoty na produkcji. Awaria zwykle ujawnia się później, gdy dashboard działa wolno, liczba w uzgodnieniu się nie zgadza albo proces downstream niezauważenie przetwarza dane o niewłaściwej granulacji. Kto uruchamia zapytania wystarczająco często, ten wie, że „zakończyło się” to najniższa poprzeczka, a nie ta, która zapewnia wiarygodność hurtowni danych.
Spis treści
Dlaczego uruchomienie zapytania to coś więcej niż wykonanie SQL
Optymalizacja zapytań analitycznych za pomocą statystyk i projektowania predykatów
Poza składnią Luka walidacji semantycznej w monitorowaniu zapytań
Obsługa danych opóźnionych, zmieniających się lub niekompletnych w pracy z zapytaniami
Dlaczego uruchomienie zapytania to coś więcej niż wykonanie SQL
Kiedyś zapytanie traktowano jak linijkę tekstu wysłaną do bazy danych. Dla nowoczesnych systemów to zbyt wąskie spojrzenie, ponieważ baza danych sama wybiera ścieżki dostępu, kolejność złączeń i wykorzystanie zasobów, dochodząc do wyniku. Model relacyjny Edgara F. Codda z 1970 roku przesunął ten koncept w stronę żądań deklaratywnych, w których użytkownik określa oczekiwany wynik, a system decyduje, jak go uzyskać. System R firmy IBM przekształcił tę ideę w praktyczne rozwiązanie z kosztowym optymalizatorem zapytań, który przed wykonaniem porównywał alternatywne plany (historia IBM o Patricii Selinger).
Ta zmiana ma znaczenie za każdym razem, gdy zespół uruchamia zapytanie w hurtowni danych, operacyjnej bazie danych lub w procesie observability. Wynik zależy od wolumenu danych, wyników pośrednich, wolumenu skanowania oraz zasobów dostępnych w danym momencie, a nie tylko od tego, czy SQL jest poprawny składniowo. Dla zespołów zajmujących się observability i jakością danych zapytanie jest operacją, którą się mierzy, a nie tylko tekstem, który się przegląda. Dlatego platformy zbudowane wokół zachowania podczas wykonania, takie jak data observability w digna, skupiają się na tym, co zapytanie robi wewnątrz bazy danych, a nie wyłącznie na składni.
Praktyczna zasada: plan wykonania należy traktować jako część zapytania, ponieważ to właśnie tam najpierw widać koszty, presję na zasoby i dryf planu.
Dlaczego kontrola składni nie wystarcza
Kontrola składni mówi, że instrukcja jest poprawna. Nie mówi, czy odczytano zbyt wiele danych, czy złączenia wykonano w złej kolejności ani czy wynik nie wyglądał na tyle wiarygodnie, by prześlizgnąć się przez przegląd. To luka, na którą zespoły produkcyjne trafiają wciąż od nowa, zwłaszcza gdy sukces zapytania ocenia się wyłącznie po tym, że się zakończyło.
Drugim martwym punktem jest zachowanie historyczne. Ten sam SQL może działać inaczej, gdy przybywa danych, zmieniają się statystyki lub ścieżka złączenia staje się mniej selektywna. Historia standaryzacji wyjaśnia też, dlaczego zespoły nie mogą wiecznie polegać na zachowaniu jednego dostawcy: SQL ewoluował przez dekady w kolejnych rewizjach ANSI i ISO, pozostając wspólnym językiem systemów relacyjnych (historia standardu SQL według ANSI).
Standardowy proces uruchamiania zapytania
Najbardziej niezawodny proces produkcyjny zaczyna się, zanim baza danych wykona jakąkolwiek ciężką pracę. Najpierw należy zdefiniować wymagany wynik, a następnie pobierać tylko minimalny zestaw kolumn potrzebny do jego uzyskania. Dzięki temu zapytanie pozostaje skoncentrowane i nie przeciąga zbędnych danych przez kolejne złączenia i agregacje.
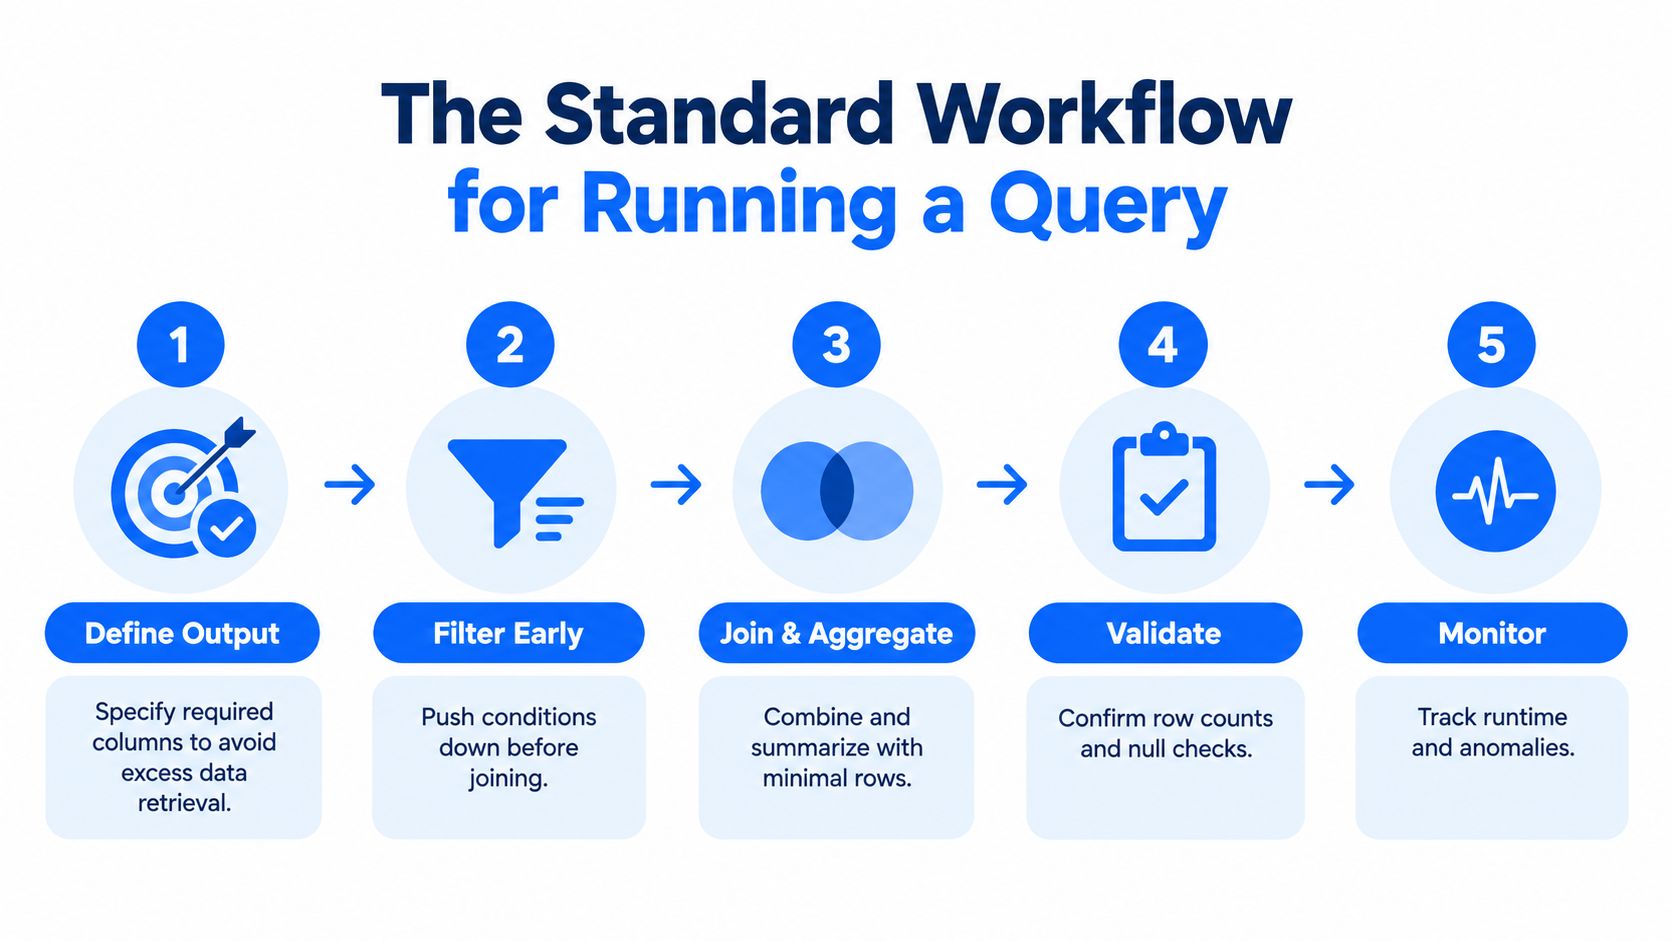
Krok 1 Zdefiniuj wynik
Definicja wyniku powinna obejmować oczekiwaną granulację, spodziewaną populację wierszy i wymagane kolumny. Jeśli pytanie biznesowe dotyczy dziennej aktywności klientów, nie należy odpytywać danych w granulacji konto-miesiąc w nadziei, że liczby później się zgodzą. Zapytanie, które żąda mniej, łatwiej zrozumieć, taniej wykonać i znacznie rzadziej przynosi niespodzianki.
Krok 2 Filtruj przed złączeniem
Warunki warto stosować jak najwcześniej, aby baza danych pracowała na mniejszej liczbie wierszy. Ten wzorzec jest zgodny z zaleceniem Microsoftu, by pobierać tylko potrzebne kolumny i ograniczać dane przed operacjami JOIN, a jeszcze ważniejszy staje się przy dużych lub nierównomiernie rozłożonych tabelach źródłowych (najlepsze praktyki wydajności Google BigQuery).
Krok 3 Przeanalizuj plan wykonania
Przegląd planu powinien obejmować kolejność złączeń, wolumen skanowania, szacunki kardynalności oraz każdy etap sortowania lub agregacji, który może stać się wąskim gardłem. Nie należy ufać wrażeniu „wygląda dobrze” w edytorze SQL. Trzeba sprawdzić, czego spodziewa się optymalizator, i porównać to z oczekiwanym obciążeniem.
Krok 4 Testuj na reprezentatywnych danych
Poprawione zapytanie należy uruchomić na realistycznych partycjach, a nie na zabawkowych próbkach. Zapytanie szybkie na wąskim wycinku może się załamać na bieżącym miesiącu, największym kliencie lub przy zimnym cache. Wynik trzeba zmierzyć względem budżetu opóźnień i zasobów ustalonego z góry.
Zapytanie na produkcji powinno być nudne. Nudne, czyli ograniczone, mierzalne i stabilne na partycjach, które zespół faktycznie odpytuje.
Krok 5 Zweryfikuj zachowanie w czasie wykonania
Metadane planu i zadania pozwalają ustalić, gdzie ucieka czas, a po każdej istotnej zmianie zapytanie należy uruchomić ponownie. W praktyce zapytanie jest „gotowe” dopiero wtedy, gdy zwraca poprawny wynik, mieści się w budżecie i zachowuje się spójnie na reprezentatywnych danych.
Zespołom, które potrzebują głębszego modelu operacyjnego, orkiestracja pipeline'ów dla obciążeń zapytaniami pomaga powiązać zapytanie z resztą przepływu danych, zamiast traktować je jako odizolowane polecenie.
Optymalizacja zapytań analitycznych za pomocą statystyk i projektowania predykatów
Obciążenia analityczne często pozostają niezauważone, dopóki nie zawiodą w spektakularny sposób. SQL jest poprawny, ale optymalizator dostaje błędny sygnał, bo klucze złączeń nie pasują do siebie, statystyki katalogu są nieaktualne albo predykat wymusza szersze skanowanie, niż to konieczne. Wytyczne IBM dotyczące strojenia wskazują jako powtarzające się ryzyka niezgodności typów danych, wyrażenia w predykatach złączeń, złączenia nierównościowe, zbędne złączenia zewnętrzne, nadmiarowe ograniczenia i niedokładne statystyki katalogu, a ta lista pokrywa się z tym, co zespoły widzą w rzeczywistych systemach (wytyczne IBM DB2 dotyczące strojenia zapytań).
Co psuje wydajność analityczną
Wyrażenia na kolumnach indeksowanych lub partycjonujących to częsta pułapka. Gdy kolumna zostanie opakowana w funkcję, predykat może przestać być sargable, co oznacza, że baza danych nie może użyć oczekiwanej ścieżki dostępu i skanuje więcej danych, niż potrzeba. Równie ważna jest walidacja typów danych, ponieważ niezgodny klucz złączenia może skierować optymalizator ku mniej wydajnemu planowi.
Tu przydają się także praktyczne materiały edukacyjne. Osobom rozwijającym własne umiejętności bazodanowe, które chcą podszlifować strojenie, przyda się zewnętrzna lektura build database projects without a degree, ponieważ opiera rozwój kompetencji na realnej pracy, a nie na teorii.
Zdyscyplinowana pętla walidacji
Najpierw należy uruchomić zapytanie raz w celu sprawdzenia poprawności, a następnie porównać szacowaną i rzeczywistą liczbę wierszy na każdym etapie. Potem warto przetestować zachowanie przy zimnym i ciepłym cache, zmierzyć czas wykonania i zużycie zasobów oraz zmieniać tylko jedną rzecz naraz. Ta sekwencja jest wolniejsza niż poprawianie SQL na ślepo, ale tylko tak można się dowiedzieć, czy zmiana poprawiła plan, czy jedynie przeniosła koszt w inne miejsce.
Solidna rutyna powinna obejmować:
Najpierw walidacja kluczy złączeń. Przed zmianą indeksów lub hintów trzeba upewnić się, że typy danych się zgadzają.
Sprawdzanie błędów szacowania. Jeśli szacunki liczby wierszy w planie są chybione, należy poprawić statystyki lub kształt predykatu, zanim obwini się sprzęt.
Pomiar zużycia zasobów. CPU, pamięć, liczba przeskanowanych bajtów oraz wolumen spill lub shuffle pokazują, czy zapytanie jest w dobrej kondycji.
Powtórzenie po każdej zmianie. Kilka zmian naraz ukrywa przyczynę poprawy lub regresji.
Zespołom standaryzującym strojenie zapytań przyda się przewodnik po optymalizacji zapytań SQL, ponieważ łączy projektowanie predykatów z rzeczywistą ścieżką wykonania, zamiast traktować optymalizację jak ćwiczenie z formatowania.
Poza składnią Luka walidacji semantycznej w monitorowaniu zapytań
Zapytanie może wykonać się pomyślnie, a mimo to być błędne w istotny sposób. Może zduplikować wiersze przez złączenie, pominąć rekordy, które dotarły z opóźnieniem, przypadkowo przesunąć granicę dat lub agregować w niewłaściwej granulacji, zwracając przy tym idealnie czysty zbiór wyników. Dlatego składnia i status wykonania same w sobie są słabymi sygnałami.
Niezależne badania nad bazami danych pokazują, że błędy szacowania kardynalności są powszechne i często stanowią główną przyczynę słabych planów zapytań (badania VLDB dotyczące zachowania zapytań i szacowania kardynalności). Ma to znaczenie, ponieważ założenia optymalizatora kształtują plan, a plan wpływa na wydajność, a czasem także na jakość wyniku, którą zakładamy.
Sukces wykonania a sukces semantyczny
Sukces wykonania oznacza, że silnik zakończył instrukcję. Sukces semantyczny oznacza, że zapytanie zwróciło właściwą populację, we właściwej granulacji i z właściwym znaczeniem biznesowym. To dwa różne testy, a zespoły produkcyjne potrzebują obu.
Monitorowanie zapytań, które kończy się na czasie wykonania, pomija najgroźniejsze awarie. Zapytanie może być szybkie, tanie i mimo to błędne. W finansach, ochronie zdrowia, telekomunikacji i sektorze publicznym taki błąd może skazić raporty, decyzje operacyjne lub dane wejściowe modeli, nie wywołując żadnego oczywistego incydentu.
Lepszym wzorcem produkcyjnym jest przypisanie oczekiwań do każdego krytycznego zapytania:
Oczekiwana granulacja. Trzeba wiedzieć, czy wynik ma być na poziomie klient-dzień, konto-miesiąc, czy jeszcze innym.
Sumy uzgodnieniowe. Sumy wyniku należy porównać z wiarygodną sumą kontrolną, jeśli taka istnieje.
Reprezentatywne przypadki brzegowe. Opóźnione dostawy, zduplikowane klucze i daty graniczne trzeba sprawdzać jawnie.
Bazowa linia zachowania. Bieżący kształt wyniku należy porównywać z wcześniejszymi uruchomieniami i obserwować dryf.
Podejście in-database w digna pasuje do tego modelu, ponieważ kontrole działają tam, gdzie znajdują się dane. Zespoły mogą więc weryfikować zachowanie bez wyprowadzania wrażliwych rekordów z hurtowni danych czy magazynu operacyjnego. To praktyczna przewaga, gdy celem jest observability, a nie kolejna kopia danych.
Obsługa danych opóźnionych, zmieniających się lub niekompletnych w pracy z zapytaniami
Zapytanie może zakończyć się bez błędów, a mimo to nie nadawać się do użytku produkcyjnego. Plik może dotrzeć po terminie, źródło może dosłać wiersze wstecznie, a producent danych może bez uprzedzenia zmienić ich strukturę. SQL nadal działa, ale wynik może już nie odpowiadać zamierzonemu wycinkowi biznesowemu. Zespoły polegające wyłącznie na kontrolach typu zaliczone lub niezaliczone zwykle dowiadują się o tym dopiero, gdy zmieni się dashboard albo proces downstream przetworzy błędny wynik.
Wytyczne Komisji Europejskiej dotyczące jakości danych traktują jakość jako zależną od celu i wymieniają dokładność, kompletność, spójność, unikalność, integralność, terminowość, pochodzenie oraz metody gromadzenia danych jako atrybuty jakości. Takie ujęcie lepiej pasuje do operacyjnej pracy z zapytaniami niż binarna flaga sukcesu.
Monitorowanie potrzebuje modelu ważności
Kontrole aktualności, pokrycia okresów, zmian schematu i kompletności nie powinny wywoływać tej samej reakcji. Opóźnione, ale poprawne ładowanie może zasługiwać na ostrzeżenie. Brakujący plik źródłowy powinien blokować dalsze wykorzystanie danych. Jeśli każdy problem jest krytyczny, zespoły przestają ufać alertom. Jeśli każdy jest tylko informacyjny, nikt nie reaguje wystarczająco szybko.
Skuteczna kontrola wynika z progów uwzględniających kontekst, a nie z jednej reguły zaliczone lub niezaliczone dla każdego zbioru danych.
Trudniej jest odróżnić dane opóźnione, ale poprawne, od danych brakujących. Pomagają historyczne wzorce napływu danych. Pomagają też sezonowe linie bazowe. Podobnie jak jasno wskazany właściciel każdej kontroli. Warto zachowywać dowody do analizy, bo pytania po incydencie są zwykle proste: co się zmieniło, kiedy się zmieniło i czy wynik nadal był bezpieczny w użyciu?
Gdzie kontekst wygrywa ze sztywnymi regułami
Jeśli źródło zwykle dostarcza dane wcześnie, ale raz w tygodniu się spóźnia, polityka powinna odzwierciedlać ten wzorzec. Jeśli zbiór danych jest korygowany później w ciągu dnia, monitorowanie musi dopuszczać przejściową niespójność, nie maskując prawdziwych awarii. To granica między trwałą kontrolą a kruchą automatyzacją.
Zespołom, które potrzebują konkretnej definicji aktualności, materiał metryki terminowości danych i ich monitorowanie podpowiada praktyczny sposób ustalenia zestawu reguł i modelu ważności alertów.
Opóźnione i zmieniające się dane wejściowe wymagają też kontroli semantycznych. Granulacja, populacja i znaczenie biznesowe mogą dryfować nawet wtedy, gdy aktualność wygląda na akceptowalną. Tu pomaga podejście in-database, ponieważ pozwala weryfikować te warunki tam, gdzie znajdują się dane, zamiast kopiować rekordy tylko po to, by je sprawdzić.
Praktyczne wnioski dla niezawodnego wykonywania zapytań
Zapytanie, które zwraca wynik bez błędów, wciąż może być błędne. Na produkcji niezawodne wykonanie zależy od współdziałania kontroli wydajności, kontroli terminowości i walidacji semantycznej, ponieważ szybki wynik o złej granulacji lub populacji to nadal porażka.
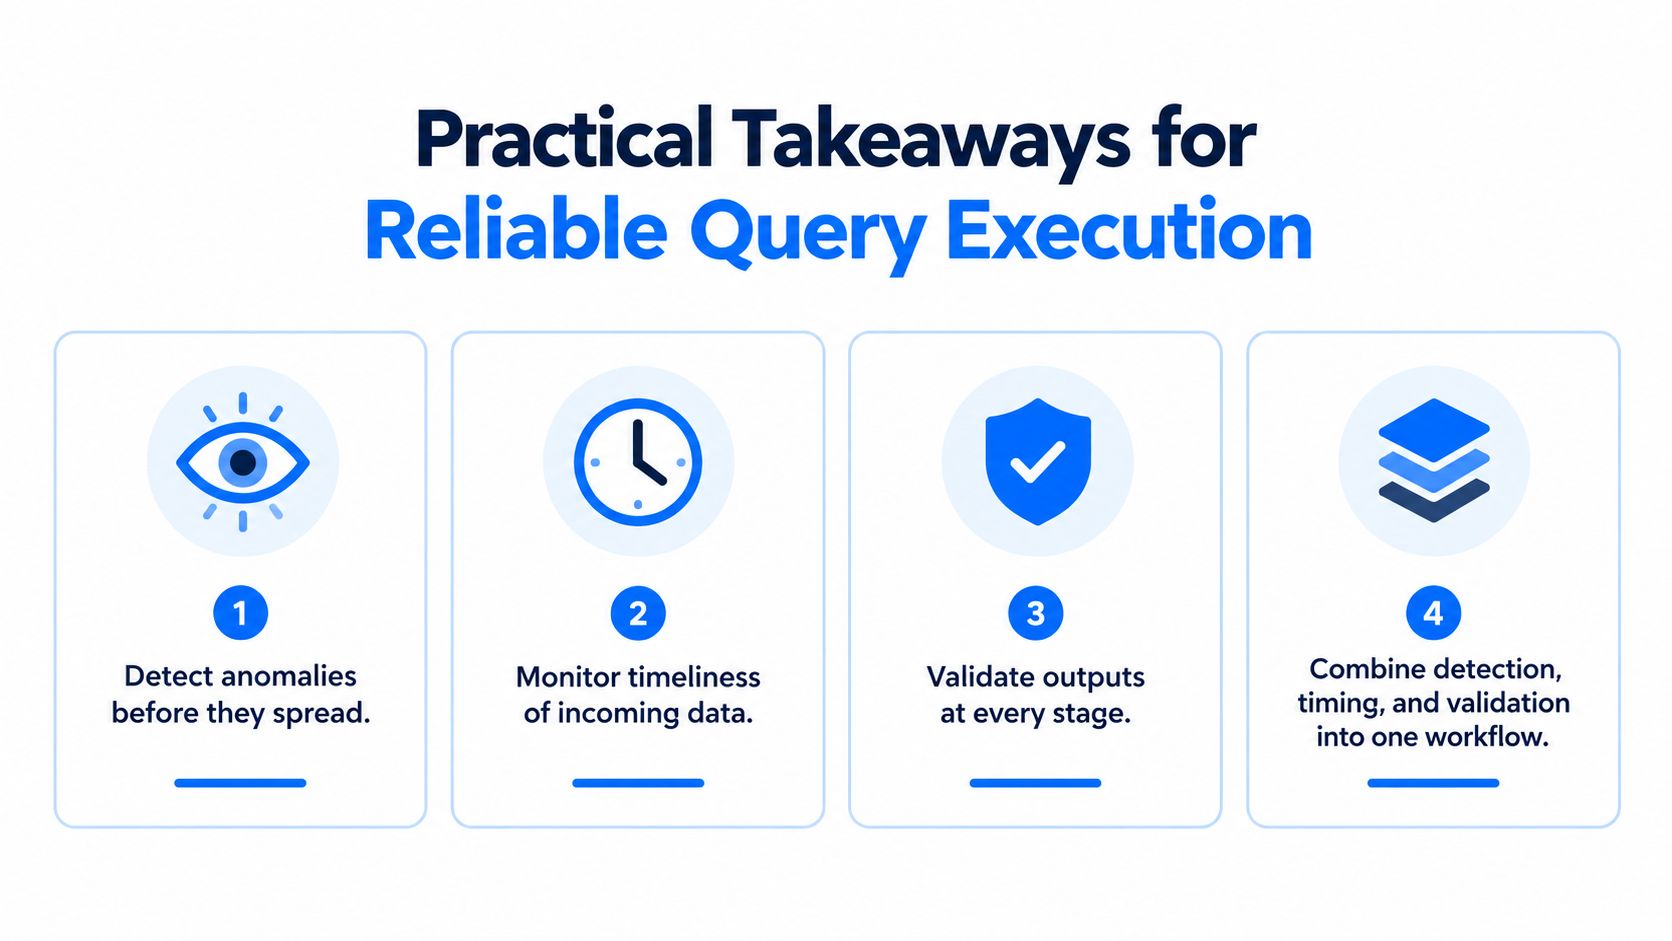
Co warto ustandaryzować
Należy zacząć od oczekiwanej granulacji i akceptowalnego okna opóźnień dla każdego ważnego zapytania. Warto zapisać linię bazową czasu wykonania, liczby przeskanowanych wierszy i kształtu wyniku, aby regresje były widoczne, gdy zmienia się zachowanie. Samo sprawdzanie, czy instrukcja się zakończyła, pomija dryf, który ma znaczenie.
Polityka powinna być na tyle prosta, by operatorzy mogli ją stosować pod presją. Trzeba określić, które awarie blokują użycie, które uruchamiają przegląd, a które są tolerowane przez krótki czas. Takie podejście łączy wykrywanie, walidację i governance, nie zamieniając każdego alertu w kryzys.
Co sprawdza się na produkcji
Wykrywanie anomalii służy do wychwytywania dryfu, kontrole terminowości do monitorowania dostaw danych, a walidacja do reguł biznesowych. Tam, gdzie to możliwe, kontrole te powinny działać w bazie danych, ponieważ kopiowanie danych gdzie indziej tylko w celu ich sprawdzenia zwiększa koszty i ryzyko. Jeśli hurtownia danych może testować zachowanie tam, gdzie dane już się znajdują, diagnoza jest szybsza, a alertom łatwiej zaufać.
W przypadku wydajności zapytań przegląd planu i porównanie z linią bazową powinny odbywać się w tej samej pętli. Gdy plan się zmienia, należy go przeanalizować. Gdy szacunki wierszy dryfują, trzeba porównać je z wartościami rzeczywistymi. Jeśli czas wykonania mieści się w budżecie, ale kształt wyniku się nie zgadza, należy to traktować jako problem z danymi, a nie udane uruchomienie.
Zespołom porównującym różne podejścia przyda się strojenie wydajności baz danych dla niezawodnych zapytań jako praktyczne uzupełnienie, ponieważ łączy zachowanie zapytań ze stabilnością obciążenia, a nie z pojedynczymi poprawkami.
Jeśli potrzebne jest monitorowanie zachowania zapytań, wczesne wykrywanie dryfu i walidacja wyników bez przenoszenia wrażliwych danych, zapraszamy na stronę digna. digna uruchamia kontrole wewnątrz hurtowni danych, dzięki czemu granulację, terminowość i dryf można weryfikować bez przenoszenia ani jednego rekordu.
Więcej o tym, dlaczego kontrole działające tam, gdzie znajdują się dane, są bezpieczniejsze i szybsze niż eksport rekordów do zewnętrznego narzędzia, można przeczytać w artykule o wykonywaniu kontroli jakości danych w bazie danych.
Najczęściej zadawane pytania
Co oznacza efektywne uruchamianie zapytania?
Efektywne uruchamianie zapytania oznacza, że zwraca ono poprawny wynik, mieści się w budżecie opóźnień i zasobów oraz zachowuje się spójnie na reprezentatywnych danych. Zakończenie bez błędu to tylko najniższa poprzeczka. Zapytanie może być szybkie i tanie, a mimo to błędne, jeśli agreguje w złej granulacji lub gubi spóźnione wiersze.
Dlaczego w SQL warto filtrować przed złączeniem?
Filtrowanie przed złączeniem sprawia, że baza danych pracuje na mniejszej liczbie wierszy, co zmniejsza wolumen skanowania i rozmiar wyników pośrednich. Warunki warto stosować wcześnie i wybierać tylko potrzebne kolumny. Efekt jest najsilniejszy przy dużych lub nierównomiernie rozłożonych tabelach źródłowych, co podkreślają też zalecenia BigQuery.
Co sprawdzić w planie wykonania zapytania?
Należy przeanalizować kolejność złączeń, wolumen skanowania, szacunki kardynalności oraz każdy etap sortowania lub agregacji, który może stać się wąskim gardłem. Następnie warto porównać szacowaną i rzeczywistą liczbę wierszy na każdym etapie, bo badania wskazują błędy szacowania kardynalności jako główną przyczynę słabych planów.
Dlaczego zapytanie wykonane pomyślnie może zwrócić błędne wyniki?
Sukces wykonania oznacza jedynie, że silnik zakończył instrukcję. Wynik może mimo to duplikować wiersze przez złączenie, pomijać spóźnione rekordy, przesuwać granicę dat lub agregować w złej granulacji. Takie błędy semantyczne wychwytują oczekiwania przypisane do zapytania: granulacja, sumy uzgodnieniowe i bazowa linia zachowania.
Jak opóźnione lub niekompletne dane powinny wpływać na monitorowanie zapytań?
Opóźnione lub niekompletne dane wymagają modelu ważności zamiast jednej reguły zaliczone lub niezaliczone. Spóźnione, ale poprawne ładowanie może zasługiwać tylko na ostrzeżenie, a brakujący plik źródłowy powinien blokować dalsze użycie danych. Historyczne wzorce napływu i sezonowe linie bazowe pomagają odróżnić dane spóźnione od brakujących.


