Dlaczego jakość danych jest ważna dla organizacji
|
8
min. czyt.

Zespół kierowniczy zaczyna poranek od znanej rutyny. Finanse sprawdzają pulpit przychodów, operacje kontrolują wolumeny realizacji, sprzedaż analizuje pipeline, a obsługa klienta przygotowuje się na zapotrzebowanie dnia. Po południu ktoś odkrywa, że jedno źródło dostarczyło dane z opóźnieniem, drugie zmieniło nazwę pola, a trzecie zawiera zduplikowane rekordy klientów. Pulpit wyglądał precyzyjnie, ale organizacja podejmowała decyzje na podstawie niepełnego obrazu.
Problemem rzadko bywa spektakularna awaria bazy danych. To brakujące pole, nieaktualny ekstrakt, niespójna definicja albo zmiana schematu, której nikt nie zauważył. Takie defekty wędrują do prognoz, raportów regulacyjnych, procesów obsługi klienta i systemów AI, zanim ktokolwiek powiąże je ze źródłem.
Dlatego pytanie, dlaczego jakość danych jest ważna dla organizacji, jest pytaniem biznesowym, a nie wyłącznie technicznym. Wiarygodne dane pozwalają ludziom decydować, działać, wyjaśniać i spełniać wymogi z pewnością siebie. Słabe dane zmuszają zespoły do kwestionowania raportów, powtarzania pracy, odkładania inicjatyw i bronienia liczb, których nie potrafią w pełni prześledzić. Ten przewodnik pokazuje, jak jakość danych buduje kontrolę organizacyjną nad decyzjami, zgodnością i ryzykiem AI oraz jak liderzy mogą uczynić z niej trwałą zdolność operacyjną. Praktyczny przegląd korzyści biznesowych znajdziesz w tekście o organizacyjnych korzyściach z jakości danych.
Spis treści
Wprowadzenie: dlaczego jakość danych kształtuje sukces organizacji
Jak organizacje budują wiarygodną jakość danych i observability
Wprowadzenie: dlaczego jakość danych kształtuje sukces organizacji
Prognoza może zawieść nawet wtedy, gdy obliczenia są poprawne. Załóżmy, że zespół planowania spodziewa się wzrostu zamówień i odpowiednio planuje zapasy, obsadę i transport. Prognoza opiera się na poprawnym modelu, ale jeden system regionalny przesyła wczorajsze transakcje z opóźnieniem, a inny rejestruje zwroty w zmienionej kategorii. Zespół planowania nie patrzy na bzdury. Patrzy na dane, które przestały odzwierciedlać firmę jako całość.
To rozróżnienie ma znaczenie. Większość decyzji w organizacji zależy od połączenia kilku systemów: danych klientów, zamówień, płatności, zapasów, interakcji serwisowych, danych kadrowych i informacji zewnętrznych. Defekt w jednym strumieniu może zmienić znaczenie połączonego wyniku. Finanse zobaczą przychód, który się nie uzgadnia, obsługa klienta skontaktuje się z niewłaściwą osobą, a zarząd spędzi spotkanie na sporze, czyj arkusz ma rację, zamiast zdecydować, co dalej.
Problemy z jakością przekraczają granice działów
Jakość danych dotyczy każdego zespołu, który korzysta z informacji:
Finanse używają ich do zamknięć okresu, planowania, kontroli i raportowania.
Operacje potrzebują kompletnych i terminowych rekordów, aby koordynować pracę.
Sprzedaż i marketing potrzebują spójnych danych klientów i kont, aby priorytetyzować szanse.
Obsługa klienta opiera się na poprawnych tożsamościach, historiach i szczegółach spraw.
Ryzyko i compliance wymagają możliwych do prześledzenia dowodów na spełnienie formalnych obowiązków.
Zespoły danych i AI potrzebują wiarygodnych danych wejściowych dla pulpitów, modeli i zautomatyzowanych procesów.
Zespół danych może wykryć defekt, ale konsekwencje zwykle ponosi biznes. Opóźniona dostawa zamienia się w przegapioną decyzję operacyjną. Zduplikowane konto zamienia się w niespójną obsługę klienta. Zmieniona nazwa kolumny może sprawić, że raport w dalszej części łańcucha pokaże pustą lub mylącą miarę, nie zgłaszając żadnego oczywistego błędu.
Zasada praktyczna: traktuj każdy krytyczny zbiór danych jako element procesu operacyjnego, a nie jako pasywny zasób techniczny.
Organizacje często zaczynają pracę nad jakością dopiero po widocznym incydencie. Raport się psuje, regulator prosi o dowody albo model zwraca nieprawdopodobny wynik. Taka reakcja jest zrozumiała, ale oznacza, że kierownictwo płaci za wykrycie, analizę, korektę i komunikację w najdroższym momencie cyklu życia.
Mocniejsze podejście zadaje pytania wcześniej. Kto jest właścicielem danych? Co oznacza „kompletny” w tym zastosowaniu? Jak świeże muszą być dane? Które zmiany powinny zatrzymać pipeline, a które jedynie wywołać ostrzeżenie? Gdy te odpowiedzi są jasne, jakość danych staje się czymś, czym organizacja może zarządzać, a nie tylko przedmiotem dyskusji.
Co jakość danych oznacza wewnątrz organizacji
Pomyśl o danych w firmie jak o systemie wodociągowym. Informacje powstają w wielu źródłach, przechodzą przez punkty uzdatniania i dystrybucji, aż w końcu docierają do kranu, z którego ktoś korzysta. Czysto wyglądająca szklanka nie dowodzi, że cały łańcuch dostaw jest zdrowy. Organizacja musi też wiedzieć, czy woda dotarła na czas, czy wyżej nie dostały się zanieczyszczenia i czy ciśnienie wystarcza do zamierzonego użycia.
Z jakością danych jest tak samo. Zbiór danych jest przydatny, gdy ma cechy wymagane przez konkretną decyzję lub proces. Miesięczny raport strategiczny zniesie krótkie opóźnienie, a proces antyfraudowy lub alert operacyjny już nie. Zbiór treningowy dla AI może wymagać solidnego pochodzenia danych i spójnych etykiet oprócz cech oczekiwanych na pulpicie.
Sześć wymiarów czyni jakość praktyczną
Zacznij od wymiarów, które mówią, czy dane mogą bezpiecznie obsłużyć dane zastosowanie:
Poprawność oznacza, że wartość odzwierciedla to, co reprezentuje w rzeczywistości. Aktualny adres klienta powinien wskazywać miejsce, w którym można go zastać.
Kompletność oznacza, że nie brakuje krytycznych informacji. Zamówienie bez identyfikatora produktu może istnieć w systemie, ale nie udźwignie wiarygodnej analizy produktowej.
Spójność oznacza, że powiązane systemy używają zgodnych wartości i definicji. Jeśli jeden zespół oznacza klienta jako aktywnego, a drugi prowadzi sprzeczny status, połączonego rekordu nie da się pewnie zinterpretować.
Aktualność oznacza, że informacja dociera i pozostaje bieżąca wtedy, gdy proces jej potrzebuje. Poprawna wartość dostarczona po oknie decyzyjnym bywa operacyjnie bezużyteczna.
Zgodność oznacza, że dane spełniają wymagane formaty, zakresy i reguły biznesowe. Data, identyfikator czy kategoria mogą być obecne, a mimo to łamać reguły konieczne do przetworzenia.
Unikalność oznacza, że organizacja nie liczy tego samego obiektu wielokrotnie. Zduplikowane rekordy klientów lub transakcji potrafią zaburzyć wolumen, wartość i priorytety.

Przydatność liczy się bardziej niż doskonałość
Żadna organizacja nie potrzebuje idealnych wartości we wszystkich polach, by działać. Użyteczne pytanie brzmi, czy dane są wystarczająco wiarygodne dla swojego celu, ze znanymi ograniczeniami i wyznaczonymi właścicielami. Proces obsługi klienta postawi na poprawność i kompletność danych tożsamości, a zarządczy raport trendów na spójność i porównywalność historyczną.
Dlatego wymagania jakościowe warto definiować razem z użytkownikami biznesowymi. Zapytaj, jaką decyzję dane wspierają, ile kosztowałby błąd, jak szybko trzeba wykryć problem i jakich dowodów potrzebują użytkownicy, by zaufać wynikowi. Znaczenie jakości danych staje się jaśniejsze, gdy zespoły łączą każdy wymiar z realnym procesem, zamiast traktować go jako abstrakcyjny wskaźnik.
Rzeczywisty koszt słabej jakości danych dla organizacji
Słaba jakość danych tworzy widoczne straty, takie jak błędne płatności czy nieudane raporty. Większy koszt zwykle przybiera postać narastającego tarcia. Analitycy ręcznie uzgadniają pliki, inżynierowie badają niewyjaśnione zmiany w pipeline'ach, a menedżerowie odkładają decyzje, dopóki zespoły nie zweryfikują liczb. Zespoły handlowe tracą zaufanie do danych, które powinny kierować ich działaniem.
IBM przywołuje badanie Gartnera, według którego organizacje tracą średnio 12,9 mln USD rocznie z powodu słabej jakości danych, co opisuje analiza IBM dotycząca kosztów słabej jakości danych. Ta sama analiza wskazuje, że 43% dyrektorów operacyjnych uznaje problemy z jakością danych za swój najważniejszy priorytet w obszarze danych. Ponad jedna czwarta organizacji szacuje roczne straty powyżej 5 mln USD, a 7% zgłasza straty rzędu 25 mln USD lub więcej.
Te liczby opisują skalę dużych przedsiębiorstw, ale mechanizm jest znany organizacjom każdej wielkości. Wadliwy rekord wymusza poprawki. Poprawki zjadają moce przerobowe, a ich brak opóźnia inicjatywy, które miały tworzyć wartość. Zespoły mogą też oszacować swoją ekspozycję za pomocą tego kalkulatora kosztów data downtime.
Rachunek wykracza poza naprawę
Opracowanie Anomalo dla kadry zarządzającej z 2024 roku podaje, że 95% kierownictwa zetknęło się z problemem jakości danych, który bezpośrednio wpłynął na wyniki biznesowe, zgodnie z raportem State of Enterprise Data Quality. Skutki mogą przybierać różne formy:
Praca ręczna: zespoły porównują ekstrakty, naprawiają rekordy i tłumaczą rozbieżności, zamiast ulepszać produkty lub usługi.
Utrata przychodu: błędne dane klienta, produktu lub konta mogą sprawić, że właściwa oferta, faktura albo kontakt nie trafią we właściwe miejsce.
Opóźnione decyzje: kierownictwo czeka na uzgodnienia, zanim zatwierdzi działania, premiery czy inwestycje.
Hamulec transformacji: programy modernizacyjne grzęzną, gdy stare definicje i nowe platformy dają sprzeczne wyniki.
Koszty kontroli: zespoły compliance i audytu poświęcają więcej czasu na zbieranie dowodów i badanie odstępstw.
Raport o zarządzaniu danymi CRM z 2025 roku wykazał, że 76% organizacji uznało, iż mniej niż połowa ich danych CRM jest poprawna i kompletna. Ten sam raport podaje, że 37% wskazało słabą jakość danych jako bezpośrednią przyczynę utraty przychodów, a 37% stwierdziło, że opóźniła ona kluczowe inicjatywy przychodowe, o czym informuje komunikat Validity o State of CRM Data Management 2025.
Dlaczego koszty się kumulują
Defekty danych rzadko zostają w systemie, w którym powstały. Brakujący identyfikator potrafi zepsuć złączenie, zaburzyć metrykę, zmienić prognozę i wpłynąć na decyzję kadrową lub inwestycyjną. Każdy kolejny zespół wprowadza wtedy własną korektę, zwielokrotniając pierwotny wysiłek.
Niezależne badania przytaczane w najnowszej literaturze wskazują średnie roczne straty rzędu 12,9 mln USD na organizację. Inne opracowania szacują, że złe dane potrafią pochłonąć 15–25% przychodu w wielu firmach przez poprawki, korygowanie błędów, utracone szanse i błędne decyzje, co omawia opublikowane badanie kosztów jakości danych.
Pytanie o inwestycję jest więc szersze niż koszt platformy jakościowej. Organizacje finansują dodatkowo powtarzalne prace korekcyjne, opóźnione decyzje, działania kontrolne i ryzyko powstające wtedy, gdy właścicielstwo, aktualność lub zmiany schematu pozostają niezauważone.
Jak słaba jakość danych podkopuje decyzje, zaufanie i AI
Pulpit finansowy pokazuje rosnące przychody, więc kierownictwo zatwierdza nowe rekrutacje. Później zespół odkrywa, że tabela źródłowa dotarła z opóźnieniem i pominęła najnowsze transakcje. Na ekranie nic nie wyglądało na zepsute. Decyzja i tak opierała się na niepełnych dowodach.
Raport może wyświetlać się normalnie, choć jego znaczenie się zmieniło. Zmieniona nazwa pola, zmodyfikowany schemat albo zaktualizowana definicja biznesowa potrafią przejść przez pipeline bez widocznego błędu. Efekt jest groźniejszy niż pusty raport, bo znajome liczby zachęcają do działania, zanim ktokolwiek to sprawdzi.
Zaufanie słabnie wtedy w całej organizacji. Kierownictwo kwestionuje oficjalne metryki, analitycy bronią liczb, których nie tworzyli, a zespoły prowadzą własne arkusze lub ustne wyjaśnienia, żeby wypełnić luki. Jakość danych stała się kwestią kontroli organizacyjnej, a nie tylko sprawą pulpitu.
Ciche awarie niszczą zaufanie
Na uwagę zasługuje kilka ścieżek awarii:
Nieaktualne dane sprawiają, że bieżąca sytuacja wygląda jak historia.
Dryf schematu zmienia pola, typy lub struktury, które odbiorcy mogą błędnie zinterpretować.
Niekompletna dostawa usuwa z miary część populacji lub okresu sprawozdawczego.
Niezauważone zmiany rozkładu sprawiają, że dane zachowują się inaczej niż linia bazowa używana przez raport lub model.
Niespójne definicje pozwalają dwóm wiarygodnym zespołom udzielić różnych odpowiedzi na to samo pytanie biznesowe.
Badania i materiały branżowe łączą złe dane z niższą trafnością decyzji, mniejszym zaufaniem do raportów i wolniejszą reakcją. Jedno ze źródeł ankietowych wskazało jakość danych jako drugą najczęściej wymienianą barierę w czerpaniu wartości z danych i analityki. Inne podało, że 91% liderów uznało, iż inwestycje w jakość danych pozytywnie wpłynęły na wzrost biznesu, co podsumowuje analiza jakości danych O'Reilly.
Te awarie tworzą też luki w kontroli. Jeśli nikt nie odpowiada za definicję, nie monitoruje świeżości ani nie przegląda zmian schematu, organizacja może nie umieć wyjaśnić, dlaczego liczba się zmieniła, ani wykazać, które dane wsparły decyzję.
AI podnosi poprzeczkę
Systemy AI wykorzystują dane ponownie, szybko i na dużą skalę. Model może uczyć się na niekompletnych rekordach, agent może odpytać przemianowaną kolumnę, a zautomatyzowany proces może zadziałać na nieaktualnym statusie. Wynik może brzmieć pewnie, choć jego podstawa jest błędna. Praktyczne wyjaśnienie tej zależności znajdziesz w tekście o tym, dlaczego modele AI zależą od jakości danych.
ISO/IEC 5259-5:2025 przedstawia nadzór nad jakością danych jako ramy organizacyjne obejmujące cały cykl życia danych na potrzeby analityki i uczenia maszynowego, co opisuje przegląd normy ISO/IEC 5259-5:2025. Pytanie dla zarządu wykracza więc poza poprawność pulpitu: kto nadzorował dane, jakie kontrole obowiązywały i czy dane pozostały przydatne do trenowania, wnioskowania oraz dowodów regulacyjnych?
Wniosek dla nadzoru: ryzyko AI zaczyna się wcześniej, tam gdzie zespoły definiują, zbierają, przekształcają, opisują i zatwierdzają dane, z których skorzysta system automatyczny.
Jakość działa jak warstwa sterowania łącząca poprawność operacyjną, zaufanie do decyzji, dowody zgodności i odpowiedzialność za AI. Monitorowanie wyłącznie wyników modelu albo dostępności pulpitu oznacza obserwowanie ostatniego etapu, gdy wcześniejsze awarie mogły już przejść niezauważone.
Jak organizacje budują wiarygodną jakość danych i observability
Reaktywne czyszczenie i proaktywne observability rozwiązują różne problemy. Czyszczenie naprawia znane defekty po tym, jak dotarły do odbiorcy. Observability pomaga zespołom zrozumieć, co się zmieniło, kiedy, które zasoby są objęte skutkami i czy zachowanie odbiega od oczekiwanej linii bazowej.
Trwały program używa obu podejść, ale przesuwa prewencję i wczesne wykrywanie bliżej źródła. Celem nie jest tworzenie nieskończonej liczby reguł. Celem jest wyrażenie ważnych oczekiwań wprost, ciągłe ich monitorowanie i kierowanie awarii do osób, które mogą je naprawić.
Zacznij od właścicielstwa i celu
Wyznacz właściciela dla każdej krytycznej domeny danych. Powinien on wspólnie z inżynierami danych, analitykami, zespołami ryzyka i użytkownikami operacyjnymi ustalić akceptowalną jakość dla procesów zależnych od tych danych.
Przydatny zapis właścicielstwa obejmuje:
Cel biznesowy: jaka decyzja, interakcja z klientem, kontrola lub model korzysta z tego zbioru?
Oczekiwania jakościowe: które pola muszą być kompletne, zgodne, spójne, unikalne, poprawne lub aktualne?
Poziom wpływu: co się stanie, jeśli zbiór będzie błędny albo spóźniony?
Ścieżka reakcji: kto prowadzi analizę, kto zatwierdza obejście i kto potwierdza rozwiązanie?
Dowody: które kontrole, informacje o pochodzeniu danych i zapisy incydentów potwierdzają nadzór?
Bez właścicielstwa monitoring staje się usługą powiadomień. Alerty przychodzą, ale nikt nie ma uprawnień ani kontekstu, by ocenić, czy problem ma znaczenie.
Porównaj reaktywne czyszczenie z kontrolą ciągłą
Reaktywne czyszczenie | Proaktywna jakość i observability |
|---|---|
Znajduje defekty po tym, jak zauważy je raport lub użytkownik | Wykrywa nietypowe zachowanie przed dalszym wykorzystaniem |
Skupia się na pojedynczych rekordach lub znanych regułach | Łączy walidację z sygnałami świeżości, wolumenu, pochodzenia i schematu |
Naprawia objawy w dalszej części łańcucha | Pomaga zespołom naprawiać problemy u źródła |
Tworzy jednorazowe wyjaśnienia | Buduje powtarzalne dowody na potrzeby nadzoru i audytu |
Mierzy incydenty po wystąpieniu zakłócenia | Śledzi wzorce i degradację w czasie |
Ciągłe kontrole powinny obejmować reguły biznesowe na poziomie rekordu, terminowość dostaw, zachowanie wolumenu i zmiany strukturalne. Wykonywanie sprawdzeń w bazie danych pozwala też zatrzymać dane w środowisku klienta, podczas gdy metryki i analizy działają tam, gdzie dane już się znajdują.
Wykorzystaj observability jako wspólną warstwę operacyjną
digna dostarcza modułową platformę jakości danych i observability, która działa w środowisku klienta. Jej możliwości obejmują wykrywanie anomalii, analizę historycznych metryk, monitorowanie Timeliness, walidację na poziomie rekordu, śledzenie zmian schematu, wykonywanie w bazie danych, wdrożenie prywatne lub on-premises oraz wspólny pulpit dla inżynierów danych, analityków i interesariuszy. Zespoły mogą dowiedzieć się więcej o data observability jako dyscyplinie operacyjnej, a następnie ocenić, które kontrole pasują do ich architektury i profilu ryzyka.
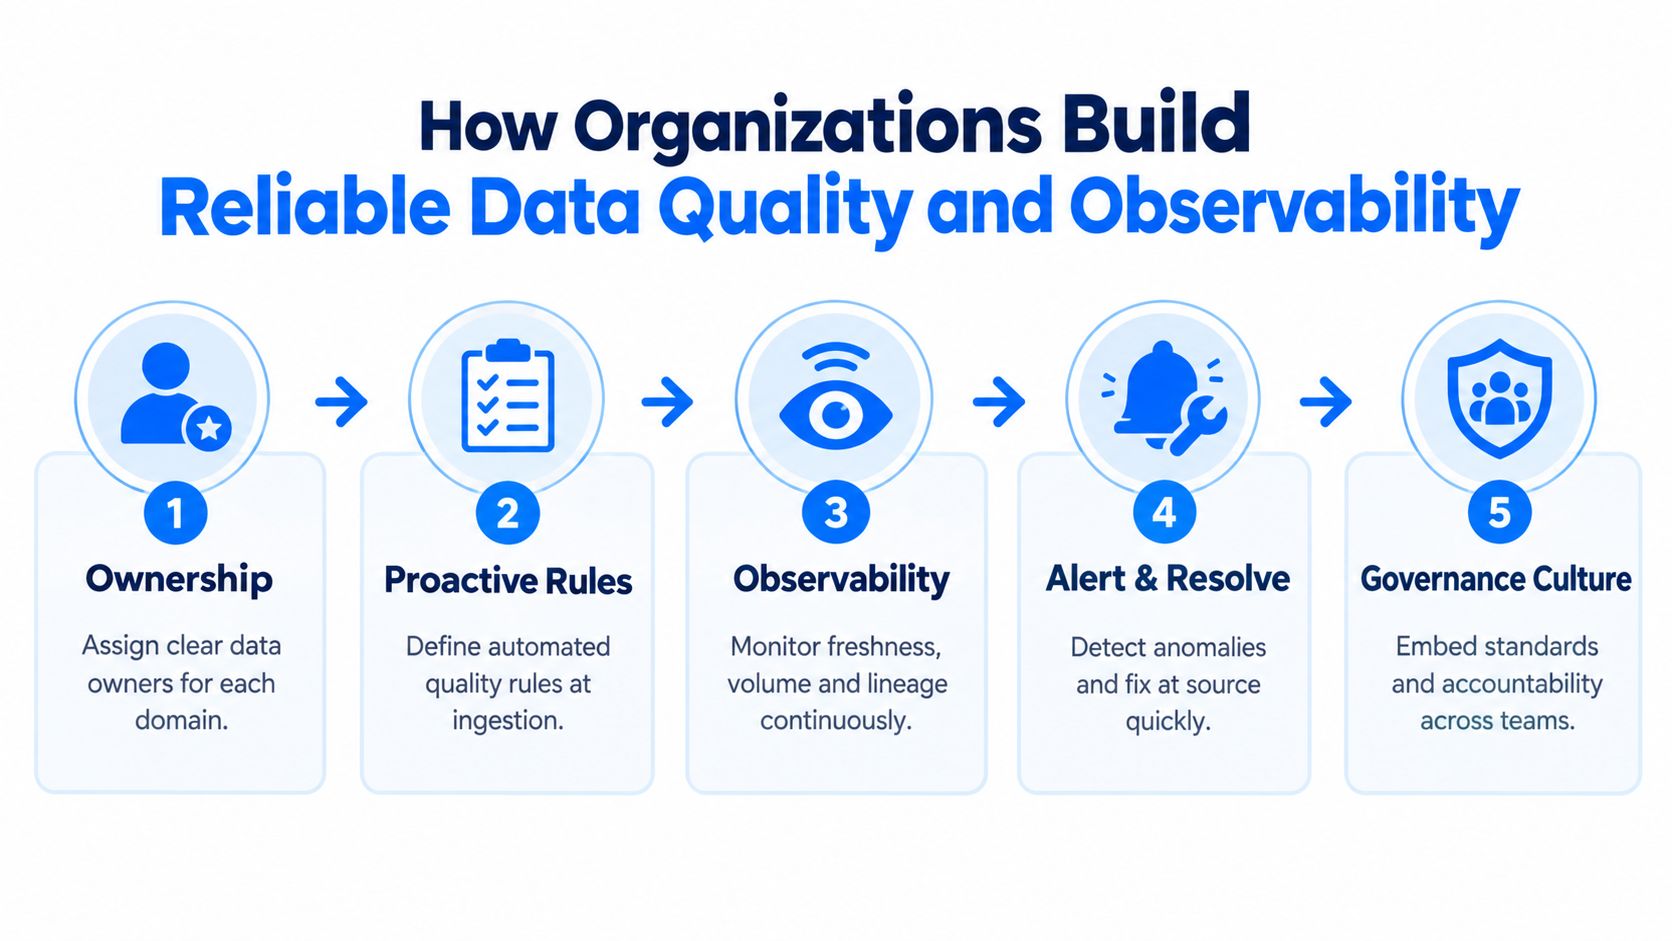
Platforma to tylko część programu. Liderzy nadal potrzebują jasnych definicji, uzgodnionych ścieżek reakcji i zachęt, które nagradzają prewencję zamiast cichej naprawy na końcu łańcucha. Observability daje ludziom widoczność. Nadzór daje im uprawnienia i odpowiedzialność.
Przykłady wpływu jakości danych w różnych branżach
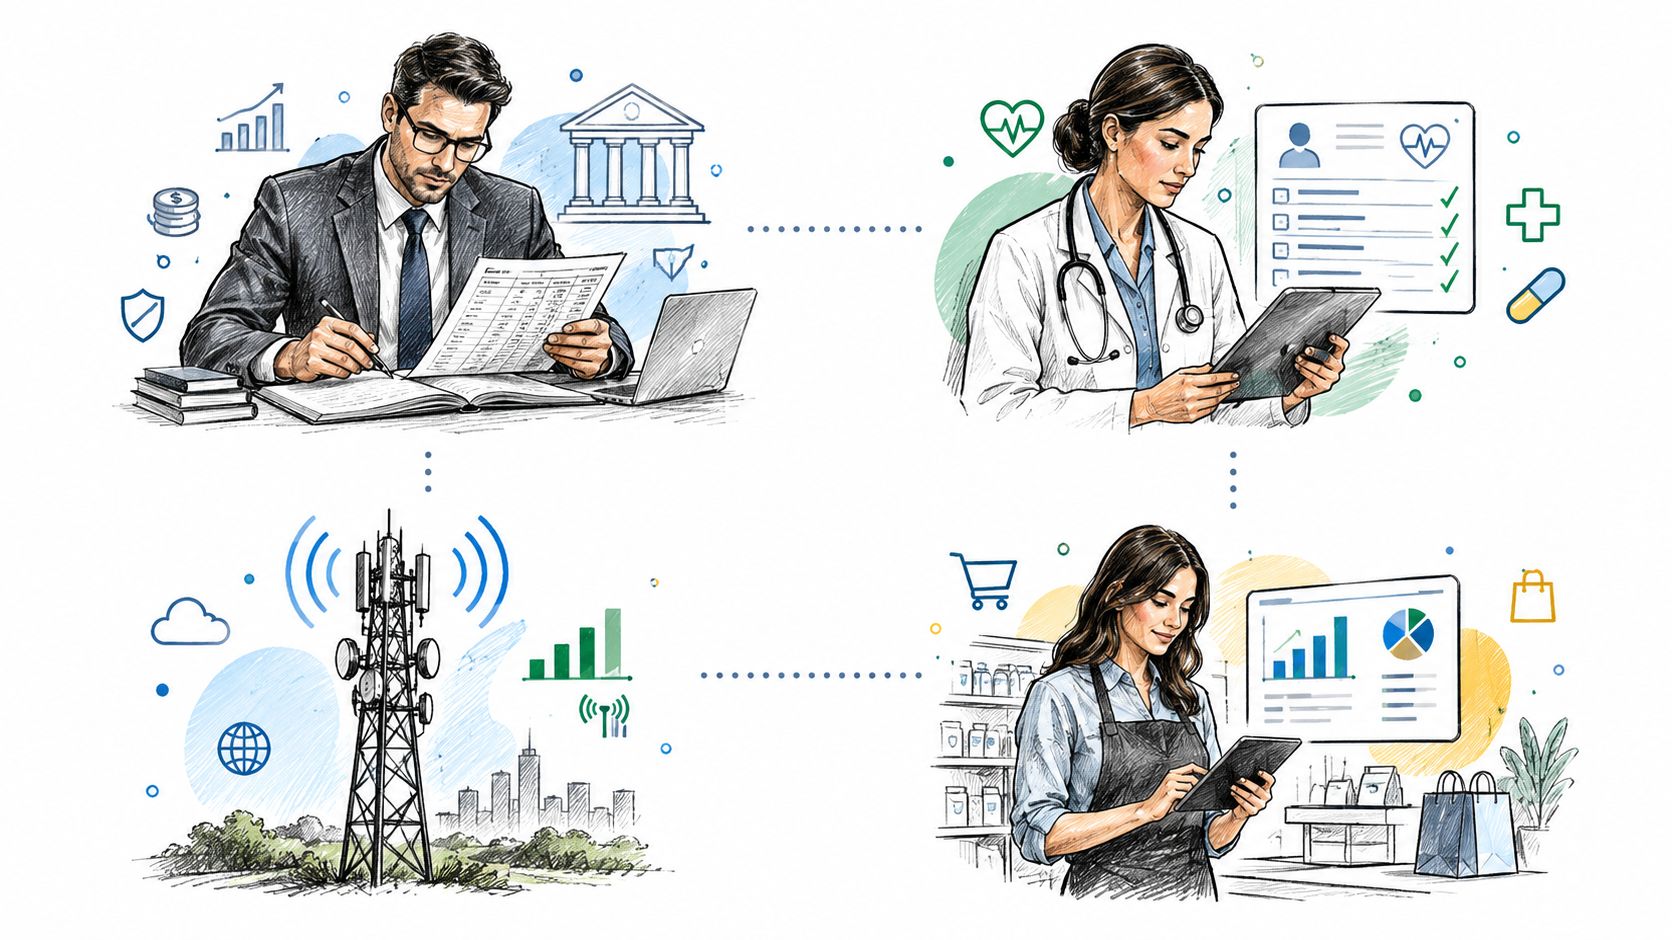
Te same wymiary jakości tworzą różne ryzyka w zależności od branży. Spóźniony strumień transakcji może zaburzyć raportowanie ryzyka w finansach, a brakująca wartość kliniczna może utrudnić koordynację opieki w ochronie zdrowia. Wzorzec kontroli pozostaje rozpoznawalny, ale skutek biznesowy i wymagane dowody się zmieniają.
Usługi finansowe
Bank może zależeć od danych transakcyjnych, klientowskich, ryzyka i regulacyjnych, które przechodzą przez kilka platform. Jeśli zmiana schematu zmieni typ pola albo strumień dotrze z opóźnieniem, zespoły raportowe uzgadniają liczby ręcznie, a zespoły ryzyka zastanawiają się, czy pracują na tej samej populacji. Kontrole jakości muszą walidować reguły biznesowe, śledzić dostawy, wykrywać nietypowe wzorce i zachowywać dowody pokazujące, co się zmieniło i jak organizacja zareagowała.
Ochrona zdrowia
Organizacje ochrony zdrowia łączą dane kliniczne, administracyjne, rozliczeniowe i operacyjne. Niespójne identyfikatory mogą rozdzielić powiązane zdarzenia, a niekompletne lub opóźnione informacje utrudniają zrozumienie sytuacji pacjenta albo epizodu opieki. Tutaj kompletność i spójność wspierają bezpieczną koordynację, a aktualność i możliwość prześledzenia danych wspierają procesy operacyjne i regulacyjne.
Telekomunikacja
Zespoły telekomunikacyjne pracują z dużymi wolumenami danych klientów, sieci, rozliczeń i użycia. Nagła zmiana liczby rekordów może wskazywać na problem z pipeline'em, zmianę w systemie źródłowym albo realną zmianę aktywności. Monitorowanie oczekiwanych dostaw, nietypowych zachowań i zmian strukturalnych pomaga odróżnić ruch biznesowy od awarii danych, zanim raporty lub procesy operacyjne zareagują błędnie.
Sektor publiczny
Instytucje publiczne często muszą łączyć dane z różnych departamentów, zachowując audytowalność i spójne definicje. Luka w pochodzeniu danych potrafi utrudnić wyjaśnienie, skąd wzięła się dana liczba. Walidacja, właścicielstwo i dowody mają znaczenie, ponieważ decydenci muszą uzasadnić nie tylko wynik, lecz także proces, który do niego doprowadził.
Zasada branżowa: właściwa kontrola jakości to ta, która jest powiązana z realną decyzją, obowiązkiem lub efektem usługi.
Te przykłady pokazują też, dlaczego jeden ogólnofirmowy wskaźnik rzadko opowiada całą historię. Zbiór danych może być akceptowalny dla ogólnej analizy trendów i nieprzydatny do regulowanego wyliczenia. Programy jakościowe powinny zatem klasyfikować dane według zastosowania, ryzyka i wymaganej reakcji, zamiast stosować jeden uniwersalny próg.
Budowanie trwałego podejścia do jakości danych
Trwały program jakości danych opiera się na trzech nawykach: właścicielstwie, ciągłej widoczności i odpowiedzialności biznesowej.
Właścicielstwo oznacza, że każdy krytyczny zbiór danych ma wskazaną osobę lub zespół odpowiedzialny za jego definicję, akceptowalny stan i ścieżkę rozwiązania problemu. Ta odpowiedzialność nie powinna znikać, gdy dane przechodzą z systemu operacyjnego do hurtowni, jeziora danych, pulpitu, modelu czy procesu AI.
Ciągła widoczność oznacza, że zespoły monitorują coś więcej niż reguły zaliczone–niezaliczone. Obserwują świeżość, wolumen, kompletność, zgodność, nietypowe zachowania i zmiany strukturalne. Zachowują też dość informacji o pochodzeniu danych i kontekście incydentów, by wyjaśnić, których odbiorców problem może dotyczyć.
Odpowiedzialność biznesowa oznacza, że miary jakości łączą się z wynikami. Zamiast raportować wyłącznie, że kontrola się nie powiodła, zespoły powinny wyjaśnić, czy awaria zagraża procesowi klienckiemu, kontroli finansowej, sprawozdaniu regulacyjnemu, prognozie albo zastosowaniu AI.
Praktyczna lista startowa wygląda tak:
Wybierz krytyczne zasoby: wskaż zbiory danych, które wspierają ważne decyzje i obowiązki.
Zdefiniuj przydatność: uzgodnij, co dla każdego zastosowania oznaczają poprawność, kompletność, spójność, zgodność, unikalność i aktualność.
Przypisz reakcję: ustal, kto otrzymuje alerty i kto może usuwać problemy u źródła.
Monitoruj w sposób ciągły: wykrywaj degradację, zanim dotrze do raportów, modeli lub działań automatycznych.
Oceniaj wartość: śledź mniejszą liczbę poprawek, szybsze rozwiązywanie problemów, mocniejsze dowody i większe zaufanie do analityki.
Główna lekcja jest prosta. Jakość danych nie jest ostatnim szlifem przed raportowaniem. To warstwa kontroli, która pomaga organizacji decydować odpowiedzialnie, wykazywać zgodność i korzystać z AI bez oddawania osądu niepewnym danym wejściowym.
digna pomaga organizacjom monitorować zachowanie danych, walidować rekordy, śledzić Timeliness, wykrywać zmiany schematu oraz obserwować metryki biznesowe i platformowe we własnym środowisku. Odwiedź digna, aby zobaczyć, jak modułowa platforma jakości danych i observability może wesprzeć bardziej wiarygodny fundament dla analityki i AI.
Model operacyjny, który zamienia te oczekiwania w ciągłe kontrole zamiast okresowych porządków, opisuje strona zarządzanie jakością danych.
Najczęściej zadawane pytania
Ile kosztuje organizację słaba jakość danych?
IBM przywołuje Gartnera ze średnią stratą 12,9 mln USD rocznie. Ponad jedna czwarta organizacji szacuje roczne straty powyżej 5 mln USD, a 7% podaje 25 mln USD lub więcej. Jednocześnie 43% dyrektorów operacyjnych uznaje jakość danych za swój najważniejszy priorytet w obszarze danych.
Dlaczego drobne defekty powodują tak duże szkody?
Ponieważ wędrują dalej. Brakujące pole, nieaktualny ekstrakt, niespójna definicja albo niezauważona zmiana schematu trafiają do prognoz, raportów regulacyjnych, procesów klienckich i systemów AI, zanim ktoś powiąże je ze źródłem. Widoczną stratą są poprawki; większą — narastające tarcie i opóźnione decyzje.
Czy jakość danych to to samo co data observability?
Odpowiadają na inne pytania. Czyszczenie naprawia znane defekty, gdy odbiorca już je zobaczył, a observability wyjaśnia, co i kiedy się zmieniło, których zasobów dotyczy i czy zachowanie odbiega od oczekiwanej linii bazowej. Trwały program korzysta z obu, ale przesuwa prewencję i wykrywanie bliżej źródła.
Od czego organizacja powinna zacząć?
Od właścicielstwa, nie od reguł. Wyznacz właściciela dla każdej krytycznej domeny danych, a następnie zapisz cel biznesowy, oczekiwania jakościowe dla poszczególnych pól, poziom wpływu przy danych błędnych lub spóźnionych oraz ścieżkę reakcji wskazującą, kto analizuje, kto zatwierdza obejście i kto potwierdza rozwiązanie.
Czy ryzyko wygląda inaczej w różnych branżach?
Wymiary jakości pozostają te same, skutki już nie. W finansach spóźniony strumień albo zmieniony typ pola wymusza ręczne uzgodnienia w raportowaniu ryzyka. W ochronie zdrowia niespójne identyfikatory rozdzielają powiązane zdarzenia i opóźniają koordynację opieki. To, jakie dowody trzeba zachować, wyznacza regulator, a nie pipeline.



