Błąd Data Validation: przyczyny, przykłady i sposoby naprawy
|
9
min. czyt.
Prawdopodobnie to widziałeś: odświeżanie pulpitu nawigacyjnego dobiega końca, liczby wyglądają wiarygodnie, a potem ktoś pyta, dlaczego wskaźnik rezygnacji (churn) nagle się zmienił. Analityk sprawdza wizualizację, SQL i zaplanowane zadanie. Kilka godzin później okazuje się, że problemem jest jedna nieprawidłowo sformatowana wartość, która pojawiła się na wczesnym etapie potoku danych i zmieniła sposób, w jaki system docelowy zinterpretował ten rekord.
Błąd z zakresu Data Validation to coś więcej niż odrzucona komórka arkusza kalkulacyjnego. Może to być brakujące pole, nieprawidłowa data, kod spoza dozwolonej domeny lub relacja, która nie istnieje. Praktycznym wyzwaniem jest znalezienie miejsca, w którym umowa (kontrakt danych) zawiodła, podjęcie decyzji, czy wiersz można bezpiecznie naprawić, oraz zapobieżenie ponownemu wystąpieniu tej samej wady.
Spis treści
Gdy jeden wadliwy wiersz psuje cały pulpit nawigacyjny
Co właściwie oznacza błąd Data Validation
Płytka weryfikacja
Głęboka weryfikacja
Główne wzorce stojące za niepowodzeniami walidacji
Brakujące wartości
Błędy formatu
Naruszenia zakresu
Błędy kodowania i domen
Naruszenia spójności
Przykłady na poziomie rekordów, które możesz zauważyć we własnych danych
Eksporty z arkuszy kalkulacyjnych
Pobieranie danych przez API
Rekordy w hurtowni danych
Dlaczego większość błędów walidacji zaczyna się na wcześniejszym etapie (upstream)
Naprawiaj kontrakt, a nie tylko dane wyjściowe
Praktyczny przepływ pracy do wykrywania i naprawiania błędów
Przechwytywanie
Pozyskiwanie (Ingestion)
Hurtownia danych
Konsumpcja
Kluczowe wnioski dla niezawodnych operacji na danych
Gdy jeden wadliwy wiersz psuje cały pulpit nawigacyjny
Zespół finansowy otrzymuje co noc plik CSV z portalu dostawcy. Rekordy wyglądają normalnie, dopóki jedno pole rezygnacji nie zawiera nieprawidłowo sformatowanej daty. Moduł ładujący hurtowni danych nie może przekonwertować go na datę, więc zapisuje NULL zamiast zatrzymać ładowanie.
Model rezygnacji traktuje brakującą datę rezygnacji jako osobny warunek. Ta pojedyncza konwersja zmienia przypisanie klienta do kohorty, a pulpit nawigacyjny kadry zarządzającej wykazuje nieoczekiwany wzrost. Potok danych zgłasza sukces, wykres się generuje, a wynik i tak jest błędny.
Analityk zaczyna od pulpitu nawigacyjnego i śledzi wynik przez trzy raporty, dwa widoki SQL i zadanie Airflow. Nieprawidłowo sformatowany wiersz źródłowy w końcu pojawia się w logu odrzuconych wartości. Pulpit nawigacyjny był tylko pierwszym widocznym symptomem.
Praktyczna zasada: Pomyślne uruchomienie potoku dowodzi, że przetwarzanie zostało zakończone. Nie dowodzi to, że każdy rekord spełniał reguły, na których opiera się biznes.
Walidacja musi zatem docierać do poziomu pojedynczego rekordu. Jedna nieprawidłowa wartość może zmienić agregaty, cechy uczenia maszynowego, raporty finansowe lub operacyjne przepływy pracy bez powodowania awarii systemu. Szeroko cytowane badanie porównawcze firmy Gartner szacuje, że słaba jakość danych kosztuje organizacje średnio 12,9 miliona dolarów rocznie (badanie porównawcze Gartnera), podczas gdy badania IBM z 2025 r. wykazały, że ponad jedna czwarta organizacji szacuje roczne straty na ponad 5 milionów dolarów, a 7% zgłasza straty przekraczające 25 milionów dolarów (badania IBM). Publikacja DCI whitepaper na temat ukrytych kosztów złych danych zawiera dalsze omówienie kosztów operacyjnych związanych ze słabą jakością danych.
Do zbadania sprawy potrzebny jest również kontekst. Anomalie danych (Data Anomalies) mogą reprezentować rzeczywiste zachowanie klientów, podczas gdy błąd walidacji oznacza, że wartość narusza oczekiwaną strukturę lub regułę. Arkusz kalkulacyjny może oznaczyć wartość za pomocą listy rozwijanej, import w przedsiębiorstwie może ją odrzucić ze względu na zarządzany schemat, a potok hurtowni danych może wymusić jej zmianę na wprowadzający w błąd NULL. Powtarzające się błędy w tych warstwach zwykle wskazują na wadę mapowania źródłowego, transformacji lub kontraktu, a nie na serię pechowych wierszy. Więcej informacji na temat odróżniania nietypowych wartości od błędów reguł można znaleźć w poradniku digna na temat Data Anomalies.
W przypadku zespołów publikujących pulpity nawigacyjne za pomocą Power BI pomocny może być przewodnik po łącznikach Power BI od Tutorial AI, który wyjaśnia warstwę raportowania. Konfiguracja łącznika nie naprawi nieprawidłowej wartości źródłowej. Niezawodna naprawa zaczyna się tam, gdzie rekord po raz pierwszy narusza swój kontrakt.
Co właściwie oznacza błąd Data Validation
Błąd z zakresu Data Validation występuje, gdy zaobserwowana wartość nie spełnia reguły, schematu, relacji lub oczekiwań biznesowych. Reguła może być prosta, np. „to pole musi zawierać datę”, lub relacyjna, np. „to zamówienie musi odwoływać się do istniejącego klienta”.
Pomyśl o walidacji jak o selekcji przy wejściu do klubu. Selekcjoner może najpierw sprawdzić, czy Twój dowód tożsamości ma odpowiedni format. Głębsza weryfikacja potwierdza, czy nazwisko znajduje się na liście gości, czy bilet uprawnia do wejścia na to wydarzenie i czy rezerwacja zgadza się z osobą, która ją przedstawia. Systemy danych działają w ten sam sposób.
Płytka weryfikacja
Sprawdzenie formatu odpowiada na pytanie, czy wartość może być poprawnie zinterpretowana:
2025-04-18wygląda na prawidłowy zapis daty.jdoe@przypomina pole e-mail, ale nie spełnia pełnego wzorca adresu e-mail.42może być prawidłową wartością liczbową.Closed Wonmoże nadal zostać odrzucone, jeśli dozwolonym kodem jestclosed_won.
Te kontrole zapobiegają błędom parsowania, ale nie określają, czy dany rekord ma sens w odpowiednim kontekście.
Głęboka weryfikacja
Walidacja na poziomie rekordu bada relacje i reguły biznesowe:
Czy
customer_ididentyfikuje klienta w wymiarze klienta?Czy rabat jest dozwolony dla tego segmentu klientów?
Czy suma zamówienia jest równa sumie jego pozycji?
Czy data zdarzenia następuje po utworzeniu konta?
Czy status należy do zatwierdzonej domeny dla tego przepływu pracy?
Lista rozwijana w arkuszu kalkulacyjnym, odpowiedź API taka jak HTTP 422, naruszenie ograniczeń w hurtowni danych oraz zestaw testów Great Expectations – wszystkie one realizują tę samą podstawową ideę na różnych warstwach. Każde z nich porównuje dane z uzgodnionym kontraktem.
Bank Światowy opisuje walidację za pomocą takich technik jak kontrole zakresu, kontrole wewnętrznej spójności oraz wykrywanie wartości odstających, kładąc nacisk na dokumentowanie walidacji w metadanych. Wskazówki te pojawiają się w jego wykładzie na temat walidacji danych. Błąd walidacji nie jest więc jedynie irytującym komunikatem. To dowód na to, że rekord, plik lub zestaw danych nie spełnia już założeń przyjętych przez kolejny system.
Lepsze wyniki uzyskasz, zadając osobno dwa pytania:
Jaka reguła nie została spełniona?
Która warstwa pozwoliła, aby nieprawidłowa wartość dotarła tak daleko?
Pierwsze pytanie pozwala naprawić rekord. Drugie zapobiega powtórzeniu się problemu.
Aby uzyskać szersze wyjaśnienie poprawności, wymiarów i pomiarów, porównaj tę definicję z wyjaśnieniem digna na temat poprawności danych (data validity).
Główne wzorce stojące za niepowodzeniami walidacji
Większość incydentów walidacyjnych mieści się w niewielkim zestawie wzorców strukturalnych. Klasyfikacja błędu w pierwszej kolejności pomaga wybrać odpowiednią metodę naprawy, zamiast traktować każdy odrzucony wiersz jako osobną zagadkę.
Bank Światowy wskazuje brakujące wartości, problemy z formatem, kwestie kodowania, kontrole zakresów, kontrole spójności oraz wykrywanie wartości odstających jako istotne elementy praktyki walidacyjnej. Wcześniejsze badania Society of Actuaries wykazały również, że błędy poprawności są częstsze i bardziej powszechne niż błędy dokładności, a brakujące wartości, błędy formatu danych i błędy kodowania należą do głównych problemów z poprawnością. Podsumowanie tych wskazówek znajduje się w badaniach jakości danych Society of Actuaries.
Wzorzec | Przykładowa błędna wartość | Naruszenie reguły |
|---|---|---|
Brakująca wartość |
| Wymagany identyfikator musi być obecny |
Błąd formatu |
| Wartość musi używać formatu daty możliwego do przeanalizowania |
Naruszenie zakresu |
| Wiek musi mieścić się w dozwolonym zakresie |
Błąd kodowania lub domeny |
| Wartość musi pasować do zatwierdzonej domeny |
Naruszenie spójności |
| Suma nagłówka musi być równa sumie szczegółów |
Brakujące wartości
Brakująca wartość staje się błędem, gdy pole jest wymagane do przetwarzania lub interpretacji. Pusty numer wewnętrzny telefonu może być akceptowalny, podczas gdy brak identyfikatora klienta może uniemożliwić powiązanie rekordu. Te błędy najczęściej pojawiają się w logach pozyskiwania danych, kontrolach NOT NULL lub raportach o nieoczekiwanie niepełnej populacji.
Błędy formatu
Błędy formatu występują, gdy system nie może zinterpretować wartości jako zadeklarowanego typu. Data zapisana jako zwykły tekst, kwota numeryczna zawierająca nieoczekiwany symbol lub adres e-mail bez domeny mogą przejść przez słabo kontrolowany eksport i wywołać błąd w API lub podczas konwersji typów w hurtowni danych.
Naruszenia zakresu
Kontrole zakresu wychwytują wartości, które są strukturalnie numeryczne, ale logicznie niemożliwe lub niedozwolone. Ujemny wiek, przyszła data urodzenia lub wartość procentowa powyżej dozwolonego maksimum mogą być składniowo poprawnymi liczbami. Dokumentacja Banku Światowego dotycząca walidacji danych wyjaśnia, w jaki sposób kontrole zakresu i wewnętrznej spójności pomagają zlokalizować błędy przed analizą lub użyciem produkcyjnym.
Błędy kodowania i domen
Domena to zestaw akceptowanych wartości dla danego pola. Pola kraju, statusu, typu produktu i kategorii ryzyka często ulegają awariom, ponieważ różne systemy używają innej pisowni, wielkości liter, skrótów lub przestarzałych kodów. Te błędy mogą nie wywołać awarii parsera, ale dzielą zliczenia i psują filtry.
Naruszenia spójności
Reguły spójności porównują pola w ramach tego samego rekordu lub między powiązanymi rekordami. Kraj wysyłki niezgodny z przypisanym regionem, faktura, której pozycje szczegółowe nie zgadzają się z sumą w nagłówku, czy transakcja powiązana z nieznanym klientem – to właśnie tego typu błędy. Użytkownicy biznesowi często zauważają je jako pierwsi, ponieważ wynik końcowy przeczy ich wiedzy o procesie.
Nawyk diagnostyczny: Nie zaczynaj od edycji wartości. Zacznij od nazwania naruszonego wzorca. Wzorzec zazwyczaj wskazuje na odpowiedzialną warstwę.
Przykłady na poziomie rekordów, które możesz zauważyć we własnych danych
Ta sama wada wygląda inaczej w zależności od tego, gdzie na nią natrafisz. Arkusz kalkulacyjny może wyświetlić podejrzany ciąg znaków, API może zwrócić ustrukturyzowaną informację o odrzuceniu, a test w hurtowni danych może zgłosić uszkodzoną relację. Jednak podstawowy problem może być identyczny.
Eksporty z arkuszy kalkulacyjnych
Eksport z systemu CRM zawiera następujący wiersz:
customer_email | phone | stage |
|---|---|---|
|
|
|
Adres e-mail nie przechodzi podstawowej kontroli strukturalnej, ponieważ brakuje w nim pełnej domeny. Numer telefonu może być użyteczny w jednym procesie, ale niespójny z innym procesem, który oczekuje znormalizowanego formatu, takiego jak (555) 123-4567. Wartości etapu closed-won, Closed Won i CLOSED_WON mogą oznaczać dla człowieka ten sam stan biznesowy, podczas gdy dla tabeli przestawnej będą to trzy różne kategorie.
Lista rozwijana mogłaby powstrzymać powstawanie nowych wariantów, ale nie znormalizuje historycznych wartości, które zostały już wyeksportowane. Nie wyjaśni również, czy różnicę wprowadził źródłowy CRM, szablon eksportu, czy ręczna edycja.
Pobieranie danych przez API
Interfejs API otrzymuje następujący ładunek (payload):
W tym przypadku customer_id narusza regułę pola wymaganego. order_total jest ciągiem znaków (string), mimo że kontrakt odbiorcy oczekuje liczby. Z kolei created_at nie jest prawidłową datą, ponieważ kombinacja miesiąca i dnia nie może zostać zinterpretowana jako rzeczywista data w kalendarzu.
Odpowiedź HTTP 422 jest przydatna, gdy wskazuje dokładnie pole i regułę, która uległa awarii. Jeśli informuje jedynie o „nieprzetwarzalnym podmiocie” (unprocessable entity), należy zbadać treść żądania, treść odpowiedzi, typ zawartości oraz specyfikację API. Pomocny kontekst debugowania dla takich przypadków zawiera przewodnik Postmana dotyczący błędów HTTP 422.
Rekordy w hurtowni danych
Tabela faktów w hurtowni danych zawiera wiersz z trzema osobnymi problemami:
order_datewystępuje przedcustomer_signup_date.customer_idnie wskazuje na żaden wiersz w tabelidim_customer.discount_percent = 150, co wykracza poza dozwolony zakres.
Pierwszy problem to błąd spójności czasowej. Drugi to błąd integralności referencyjnej. Trzeci to naruszenie zakresu. Żaden z nich nie jest jedynie problemem z formatowaniem i poprawienie formatu wyświetlania nie sprawi, że rekord stanie się wiarygodny.
Środowisko | Przykład pola | Błędna wartość rekordu | Klasa wady |
|---|---|---|---|
Arkusz kalkulacyjny |
|
| Format |
Ładunek API |
|
| Pole wymagane |
Ładunek API |
|
| Niezgodność typów |
Tabela faktów hurtowni |
| Nieznany klucz wymiaru | Referencyjny |
Tabela faktów hurtowni |
| Przed datą rejestracji | Czasowy |
Tabela faktów hurtowni |
|
| Zakres |
Analizowanie tych przykładów staje się łatwiejsze, gdy oddzielimy poprawność od wiarygodności (reasonableness). Wartość może być zgodna z typem danych, a jednocześnie wyglądać nieprawdopodobnie w danym kontekście. Różnicę tę wyjaśnia poradnik firmy digna na temat wiarygodności danych.
Dlaczego większość błędów walidacji zaczyna się na wcześniejszym etapie (upstream)
Naprawianie pojedynczych błędnych komórek daje poczucie produktywności, ponieważ liczba błędów natychmiast spada. Często jednak eliminuje to jedynie objaw, pozostawiając system generujący dane, kontrakt lub schemat bez zmian.
Lista rozwijana w arkuszu kalkulacyjnym kontroluje tylko to, co użytkownik może wprowadzić za pośrednictwem tego konkretnego interfejsu. Nie kontroluje wartości generowanych przez integrację CRM, eksport zbiorczy, klienta API, migrację bazy danych czy proces transformacji. Najsilniejsza walidacja znajduje się blisko miejsca, w którym dane są tworzone i wymieniane.
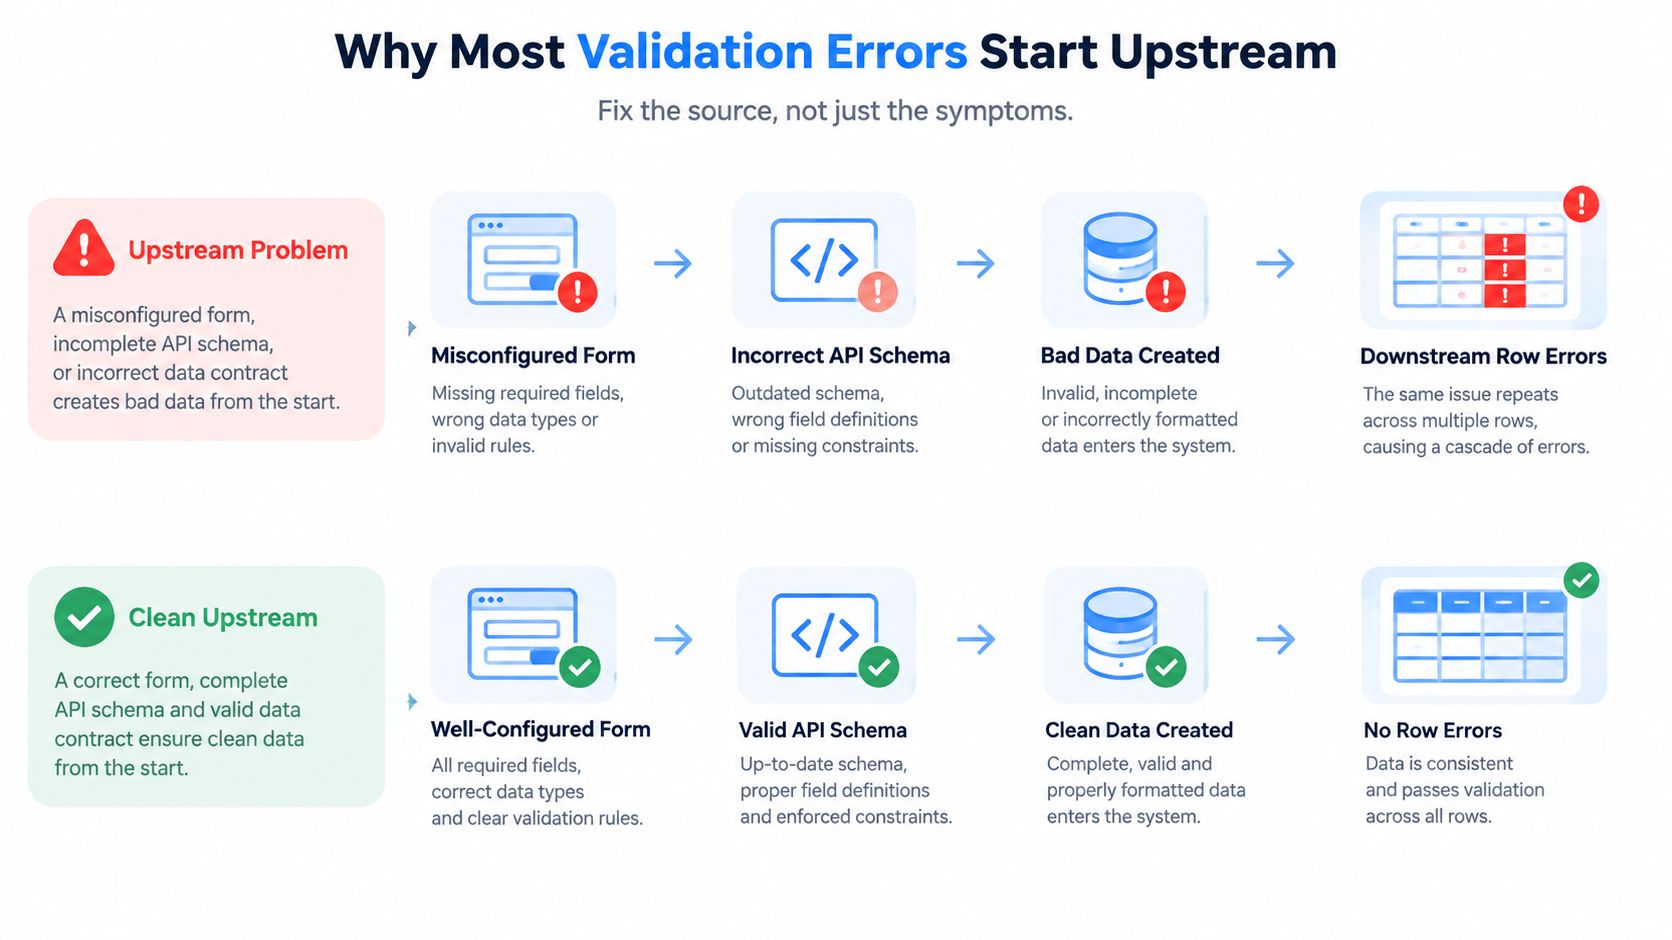
Rozważmy pole API, które zmienia nazwę z customer_id na account_id bez uwzględnienia wersji kontraktu. Transformacja odbierająca dane może uzupełnić pole customer_id wartością NULL dla każdego przychodzącego rekordu. Hurtownia danych zgłasza wtedy brakujące identyfikatory, złączenia na pulpitach nawigacyjnych tracą wiersze, a analitycy zaczynają ręcznie poprawiać wyniki. Powtarzający się błąd nie jest dowodem na niedbałe wprowadzanie danych. To dowód na to, że dwa systemy nie zgadzają się co do schematu.
Ten sam wzorzec pojawia się, gdy zmienia się szablon eksportu z systemu CRM, złagodzone zostaje ograniczenie bazy danych lub migracja usuwa regułę pola wymaganego. Zmiana w źródle może wygenerować tysiące błędów na późniejszych etapach, które wyglądają jak pojedyncze wadliwe wiersze.
Naprawiaj kontrakt, a nie tylko dane wyjściowe
Użyj wzorca błędu, aby wybrać odpowiednie działanie:
Zmieniona nazwa pola: Utwórz nową wersję ładunku i świadomie zaktualizuj system odbiorcy.
Pole opcjonalne, które musi istnieć: Oznacz pole jako wymagane w kontrakcie źródłowym i odrzucaj niepełne żądania.
Nieprawidłowa wartość numeryczna: Dodaj ograniczenie typu
CHECKlub równoważną walidację na poziomie źródła.Nierozpoznany status: Utrzymuj wspólną domenę lub wyliczenie (enumeration) zamiast polegać na zwykłym tekście.
Błędna relacja: Weryfikuj powiązane identyfikatory przed załadowaniem rekordu zależnego.
Przewodnik digna po pozyskiwaniu danych dostarcza przydatnego kontekstu, pozwalającego traktować pozyskiwanie danych (ingestion) jako kontrolowany proces przepływu danych, a nie zwykły etap przesyłania plików.
Test przyczyny źródłowej: Jeśli ten sam błąd walidacji pojawia się w wielu wierszach po zmianie źródła, zbadaj kontrakt przed przystąpieniem do czyszczenia rekordów.
Odrzucanie nieprawidłowych danych na etapie pozyskiwania jest zazwyczaj bezpieczniejsze niż zezwalanie na ich zapisanie jako NULL, pusty ciąg znaków lub wymuszona wartość domyślna. Jeśli odrzucenie nie jest możliwe, umieść wiersz w kwarantannie wraz z jego identyfikatorem źródłowym, błędem reguły i znacznikiem czasu pozyskania, aby odbiorcy na późniejszych etapach nie pomylili uszkodzonej wartości z rzeczywistą.
Praktyczny przepływ pracy do wykrywania i naprawiania błędów
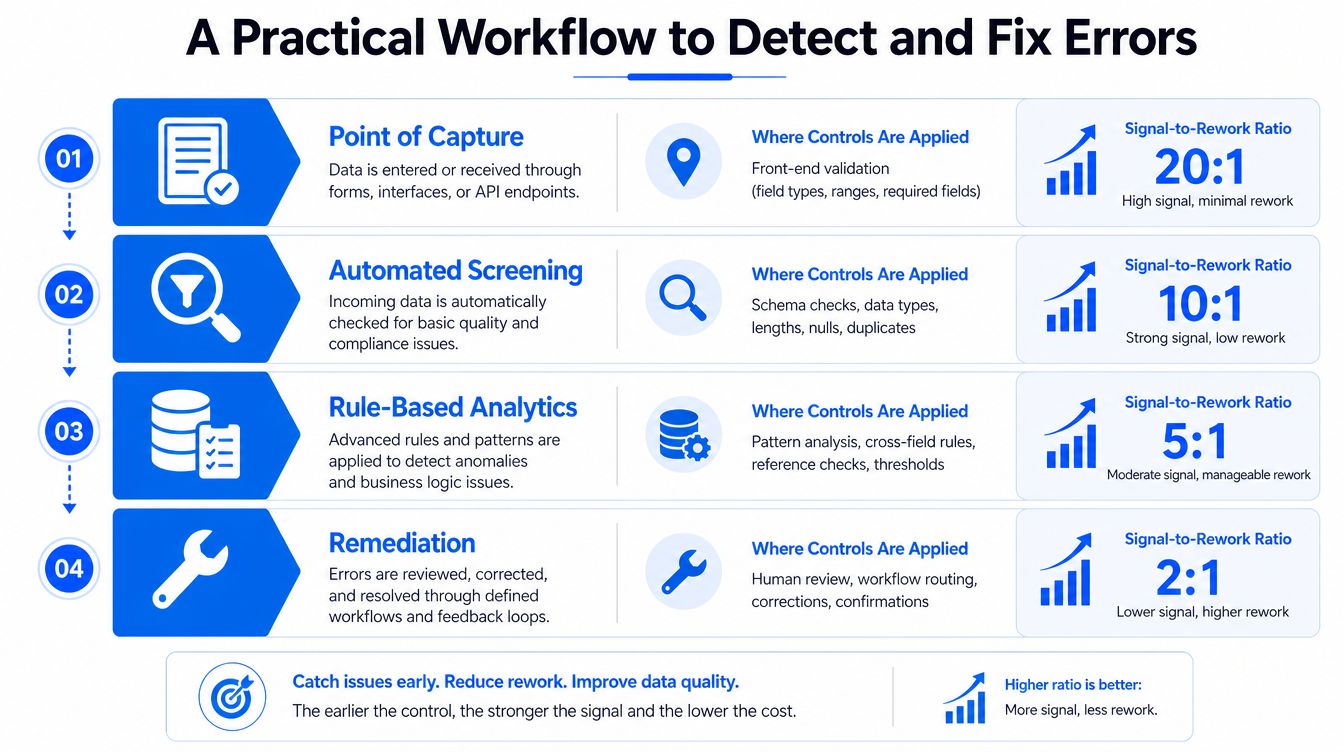
Niezawodny przepływ pracy umieszcza punkty kontrolne tam, gdzie dają one najwyraźniejszy sygnał i wymagają najmniej nakładu pracy przy poprawkach. Zacznij od przechwytywania danych, a następnie przejdź przez proces ich pozyskiwania, kontrole w hurtowni i samą konsumpcję.
Przechwytywanie
Weryfikuj typy, pola wymagane, dozwolone wartości oraz zakresy w formularzach, interfejsach API i źródłowych bazach danych. Maski wprowadzania danych mogą pomagać użytkownikom, podczas gdy ograniczenia schematu uniemożliwiają dostawcom danych przesyłanie wartości, których systemy na późniejszych etapach nie potrafią zinterpretować.
Źródłowa baza danych powinna wymuszać reguły, które mają znaczenie bez względu na to, kto zapisuje rekord. API powinno zwracać błędy na poziomie pól, informując klienta, co należy poprawić. Formularz powinien uniemożliwić wprowadzenie nieprawidłowej wartości przed jego wysłaniem, zamiast polegać na analityku, który miałby znaleźć ten błąd później.
Pozyskiwanie (Ingestion)
Traktuj każdy przychodzący plik lub ładunek jak kontrakt. Waliduj każdy rekord pod kątem oczekiwanego schematu, poddawaj kwarantannie błędy i generuj ustrukturyzowane zdarzenia o błędach zawierające plik źródłowy, identyfikator rekordu, pole, zaobserwowaną wartość oraz naruszoną regułę.
Nie nadpisuj oryginalnej wartości podczas czyszczenia. Zachowaj ją obok wartości znormalizowanej, aby zespół mógł sprawdzić, co dokładnie dotarło i jaka transformacja została przeprowadzona.
Hurtownia danych
Uruchamiaj ciągłe kontrole pod kątem wartości null, unikalności, integralności referencyjnej, świeżości danych, zmian dystrybucji i logiki między polami. Test hurtowni danych powinien odróżniać pojedynczy odrzucony wiersz od ogólnej awarii schematu oraz powinien zachowywać wystarczający kontekst, aby właściciel danych mógł odtworzyć dany problem.
Wskazówki Banku Światowego dotyczące wprowadzania i walidacji danych kładą nacisk na takie środki kontroli, jak ograniczanie opcji odpowiedzi i stosowanie kontroli opartych na zliczeniach w celu zmniejszenia liczby pomijanych lub nieprawidłowych elementów. Te zasady mają zastosowanie nie tylko w przypadku ankiet. Wymuszaj ograniczenia na wczesnym etapie, a następnie niezależnie weryfikuj powstały zestaw danych.
Konsumpcja
Pulpity nawigacyjne i modele potrzebują własnych asercji. Porównuj oczekiwaną liczbę wierszy, wykrywaj brakujące partycje, sprawdzaj pokrycie złączeń i oznaczaj metryki, które nagle się zmieniają bez powiązanego z tym wyjaśnienia dotyczącego jakości danych.
W przypadku edytowania formuł w arkuszach kalkulacyjnych walidacja może zachowywać się w nieoczekiwany sposób. Microsoft Q&A zauważa, że błędy formuł, takie jak #REF! lub #DIV/0!, mogą sprawić, że walidacja zostanie zignorowana, a operacje kopiowania i wypełniania mogą pomijać lub zmieniać oczekiwane zachowanie. Zapoznaj się z dyskusją firmy Microsoft na temat błędów walidacji wywołanych formułami, gdy lista rozwijana wydaje się poprawna, ale przetworzone komórki nadal zgłaszają błędy.
Zastosuj następującą kolejność naprawy:
W pierwszej kolejności naprawiaj kontrakty na wcześniejszych etapach (upstream). Popraw regułę źródłową, schemat, mapowanie lub zachowanie generatora danych.
W drugiej kolejności wprowadzaj poprawki w hurtowni danych. Izoluj, uzupełniaj wstecznie (backfill) lub normalizuj rekordy, gdy źródło nie może zostać natychmiast zmienione.
Oczyszczaj dane na etapie analizy tylko wtedy, gdy jest to absolutnie konieczne. Dbaj o to, aby transformacja była widoczna, udokumentowana i odwracalna.
W celu wdrożenia ciągłych kontroli łączących reguły na poziomie rekordów z szerszą obserwowalnością, zapoznaj się ze wskazówkami firmy digna dotyczącymi walidacji danych i ciągłej jakości danych. Platforma działa w środowisku klienta, przeprowadza obliczenia metryk w bazach danych klienta i może monitorować walidację, terminowość (Timeliness), anomalie oraz zmiany schematu bez wyprowadzania danych produkcyjnych poza to środowisko.
Kluczowe wnioski dla niezawodnych operacji na danych
Niezawodne operacje na danych zależą w mniejszym stopniu od pojedynczego, idealnego czyszczenia, a bardziej od powtarzalnej reakcji na powracające błędy. Skorzystaj z poniższej listy kontrolnej, gdy pojawi się alert dotyczący walidacji:
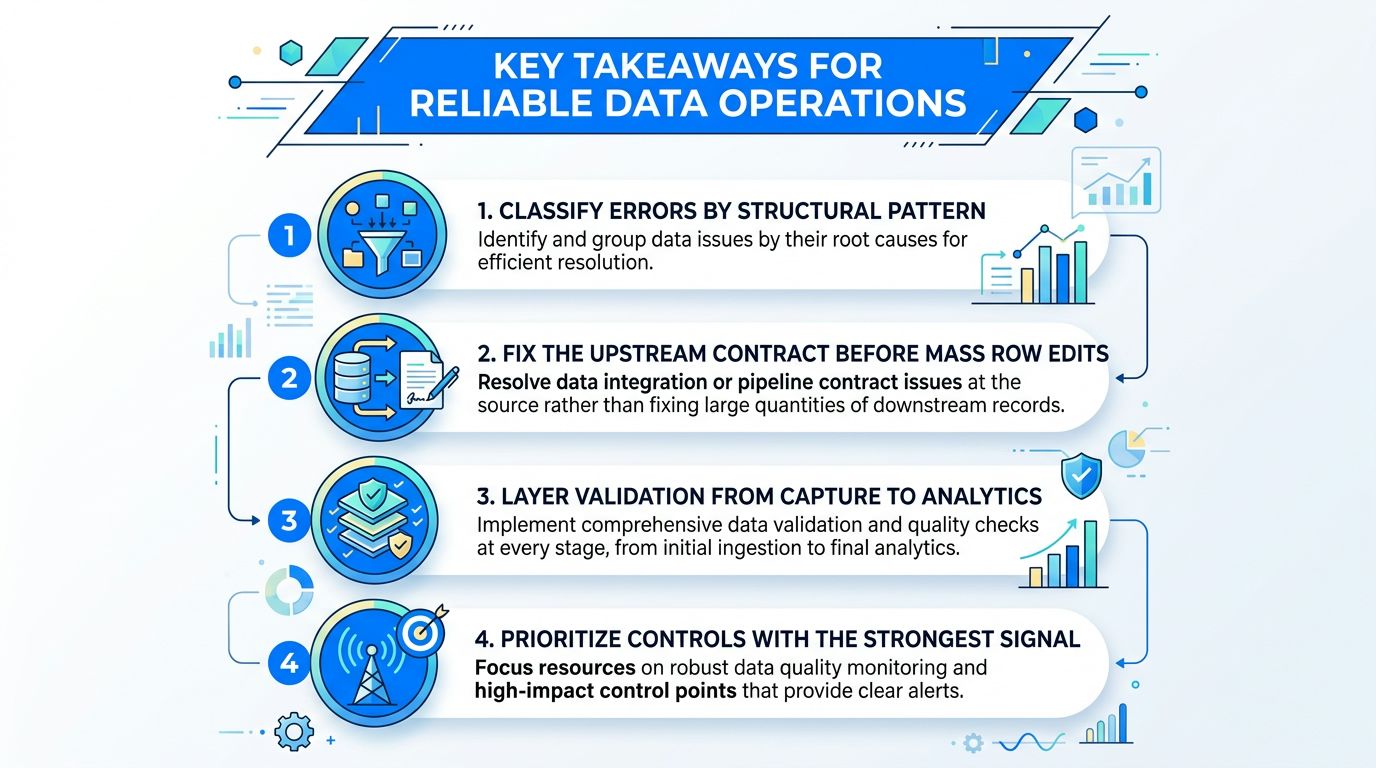
Sklasyfikuj błąd. Określ, czy wartość jest brakująca, nieprawidłowo sformatowana, poza zakresem, poza domeną, niespójna, czasowo niemożliwa czy referencyjnie niepoprawna.
Zlokalizuj pierwszy punkt awarii. Zidentyfikuj generator danych, eksport, mapowanie API, migrację lub transformację, które wprowadziły tę niezgodność.
Napraw kontrakt na wcześniejszym etapie (upstream). Zmień schemat, regułę pola wymagane, ograniczenie, mapowanie lub wersję ładunku przed przystąpieniem do edycji dużej liczby wierszy na późniejszych etapach.
Wprowadź wielowarstwowe kontrole. Waliduj na etapie przechwytywania, pozyskiwania, w hurtowni i podczas konsumpcji, aby niezauważona konwersja typów nie przeszła dalej bez ostrzeżenia.
Śledź powtarzalność błędów. Rejestruj pole, regułę, źródło, potok danych oraz trend błędów. Powtarzające się awarie wymagają prac inżynieryjnych, a nie ciągłego ręcznego oczyszczania.
Zachowaj dowody. Przechowuj odrzucone rekordy, wyniki reguł, znaczniki czasu i decyzje o naprawie na potrzeby dochodzenia i audytu.
Główna lekcja jest prosta: powtarzające się błędy walidacji zazwyczaj wskazują na uszkodzony proces, a nie na nieostrożnego użytkownika. Pojedynczy wiersz może być widocznym objawem awarii, ale powtarzające się wiersze ujawniają słabość kontraktu, schematu, mapowania lub monitorowania na wcześniejszym etapie.
Walidacja powinna być zatem obserwowalna. Zespoły muszą wiedzieć, które reguły zawodzą, gdzie dochodzi do błędów, czy awarie są odosobnione czy systemowe, oraz jakie zasoby na późniejszych etapach zależą od dotkniętych problemem danych. Taka widoczność zamienia dezorientującą rozbieżność na pulpicie nawigacyjnym w konkretny incydent inżynieryjny, który można rozwiązać.
digna pomaga zespołom ds. danych definiować reguły walidacji na poziomie rekordów, monitorować zmiany schematu, śledzić terminowość (Timeliness) i wykrywać nietypowe zachowania w hurtowniach i potokach danych, jednocześnie przechowując dane w środowisku klienta. Odwiedź digna, aby zobaczyć, jak możesz zastąpić powtarzające się oczyszczanie wiersz po wierszu identyfikowalnymi mechanizmami kontroli jakości danych i Observability.
Najczęściej zadawane pytania
Czym jest błąd walidacji danych?
Występuje, gdy obserwowana wartość narusza regułę, schemat, relację albo oczekiwanie biznesowe. To coś więcej niż odrzucona komórka arkusza: udany przebieg potoku dowodzi, że przetwarzanie się zakończyło, a nie że każdy rekord spełnił reguły, na których opiera się firma.
Czym różni się kontrola formatu od walidacji na poziomie rekordu?
Głębokością. Kontrola formatu pyta, czy wartość da się zinterpretować, więc 2025-04-18 przejdzie jako data, a jdoe@ nie spełni wzorca adresu e-mail. Walidacja na poziomie rekordu bada natomiast relacje: czy customer_id wskazuje istniejącego klienta, czy suma zamówienia równa się jego pozycjom?
Jakie wzorce błędów walidacji są najczęstsze?
Powtarza się niewielki zbiór: brakujące wartości, problemy formatu, błędy kodowania, nieudane kontrole zakresu, naruszenia spójności i wartości odstające. Bank Światowy wskazuje te same kategorie i podkreśla dokumentowanie walidacji w metadanych, aby reguła i jej uzasadnienie przetrwały dłużej niż jej autor.
Ile naprawdę kosztuje błąd walidacji?
Szeroko cytowany punkt odniesienia Gartnera określa koszt słabej jakości danych na średnio 12,9 mln USD na organizację rocznie. Badanie IBM z 2025 r. wykazało, że ponad jedna czwarta organizacji szacuje roczne straty powyżej 5 mln USD, a 7 % powyżej 25 mln USD.
Jak badać błąd walidacji?
Zadaj dwa pytania osobno. Która reguła zawiodła – to naprawia rekord – i która warstwa pozwoliła nieprawidłowej wartości zajść tak daleko – to naprawia potok. Odpowiedź tylko na pierwsze zostawia tę samą usterkę, by wróciła jutro.


