Dane gotowe na AI: od surowych danych do wiarygodnej AI
|
8
min. czyt.

Projekt AI często wygląda zdrowo aż do chwili, w której dotyka danych produkcyjnych.
Zespół ma pomysł na model, budżet, środowisko chmurowe i ludzi, którzy potrafią budować potoki. Potem praca zwalnia. Pola znaczą co innego w różnych systemach. Wczorajsza zmiana schematu zepsuła tabelę cech. Etykiety pochodzą z ręcznego procesu, któremu nikt do końca nie ufa. Dane istnieją, ale nikt nie umie z przekonaniem powiedzieć, czy są bezpieczne dla wyszukiwania, predykcji czy zautomatyzowanego działania.
To moment, w którym wiele zespołów odkrywa, że nie blokował ich wybór modelu. Blokowała je gotowość danych.
Globalne badanie z 2024 roku wyraźnie uchwyciło tę lukę. Tylko 12% organizacji stwierdziło, że ich dane mają jakość i dostępność wystarczające do skutecznego wdrożenia AI, mimo że 60% uznało AI za kluczowy wpływ na programy danych, o 46% więcej niż w 2023 roku. To samo badanie wykazało, że 64% wskazało jakość danych jako największe wyzwanie integralności danych, a 77% oceniło swoją jakość danych jako przeciętną lub gorszą (globalne badanie gotowości na AI).
Spis treści
Jak obserwowalność utrzymuje dane gotowe na AI w czasie działania
Podsumowanie: twoja droga do wiarygodnych danych gotowych na AI
Wprowadzenie: dlaczego projekty AI grzęzną przed modelem
W wielu zespołach danych powtarza się znajomy wzorzec. Produkt chce asystenta wsparcia. Ryzyko chce wykrywania anomalii. Operacje chcą prognoz. Inżynieria składa stos dość szybko, ale pierwszy poważny test obnaża problem. Nikt nie jest zgodny, która tabela jest wiążąca, czy ostatnie ładowanie jest kompletne ani czy etykiety odzwierciedlają wynik biznesowy, którego model ma się nauczyć.
Dlatego dane gotowe na AI to zwrot bardziej użyteczny niż „czyste dane”. Czystość brzmi jak jednorazowe zadanie higieniczne. Gotowość jest surowsza. Pyta, czy zbiór nadaje się do konkretnego zadania AI, w obecnych warunkach eksploatacji, z zaufaniem wystarczającym, by wesprzeć decyzje.
Jeśli widziałeś eksperymenty modelowe świetnie radzące sobie w notatniku i upadające po podłączeniu do żywych systemów, już znasz ten problem. Awaria zwykle nie jest tajemnicza. Tkwi w zdublowanych encjach, nieświeżych danych wejściowych, nieudokumentowanych transformacjach albo kruchych przekazaniach między zespołami. Praktyczny fundament zaczyna się od zrozumienia, dlaczego jakość danych ma znaczenie dla organizacji, ale AI podnosi poprzeczkę, bo dane muszą działać zarówno dla ludzi, jak i dla maszyn.
Zator zwykle zaczyna się wyżej w łańcuchu
Wiele zespołów nie zadaje złego pytania. Zadaje pytanie zbyt szerokie: „Czy nasze dane są gotowe na AI?”. Brzmi sensownie, ale ukrywa ważne szczegóły. Gotowe do wyszukiwania w dokumentach to coś innego niż gotowe do prognozowania popytu. Gotowe dla asystenta z człowiekiem w pętli to coś innego niż gotowe dla agenta, który uruchamia działania.
Projekty AI rzadko grzęzną z braku danych. Grzęzną, bo dostępne dane nie są dość wiarygodne dla dokładnie tego przepływu, który się buduje.
To rozróżnienie zmienia sposób oceny gotowości. Przestajesz traktować wolumen jako dowód. Zaczynasz sprawdzać przydatność, śledzalność i bezpieczeństwo w czasie działania.
Zaufanie musi przetrwać zderzenie z żywymi systemami
Historyczne kontrole jakości mają znaczenie, ale nie wystarczą. Zbiór treningowy może wyglądać na dobrze przygotowany i stać się niebezpieczny, gdy tylko zmienią się schematy, ładowania przyjdą z opóźnieniem albo logika powyżej w łańcuchu przesunie się bez uprzedzenia. W praktyce gotowość na AI mieszka w dwóch miejscach naraz:
Jakość przygotowania oznacza, że zbiór jest zdefiniowany, zweryfikowany i udokumentowany na tyle, by go użyć.
Zaufanie w czasie działania oznacza, że potrafisz wykryć, kiedy ten stan przestaje obowiązywać.
To właściwa perspektywa. Nie „czy mamy dużo danych?”, lecz „czy te dane udźwigną to zachowanie AI dzisiaj, z kontrolami, które wychwycą dryf, zanim model na jego podstawie zadziała?”.
Co naprawdę znaczą dane gotowe na AI
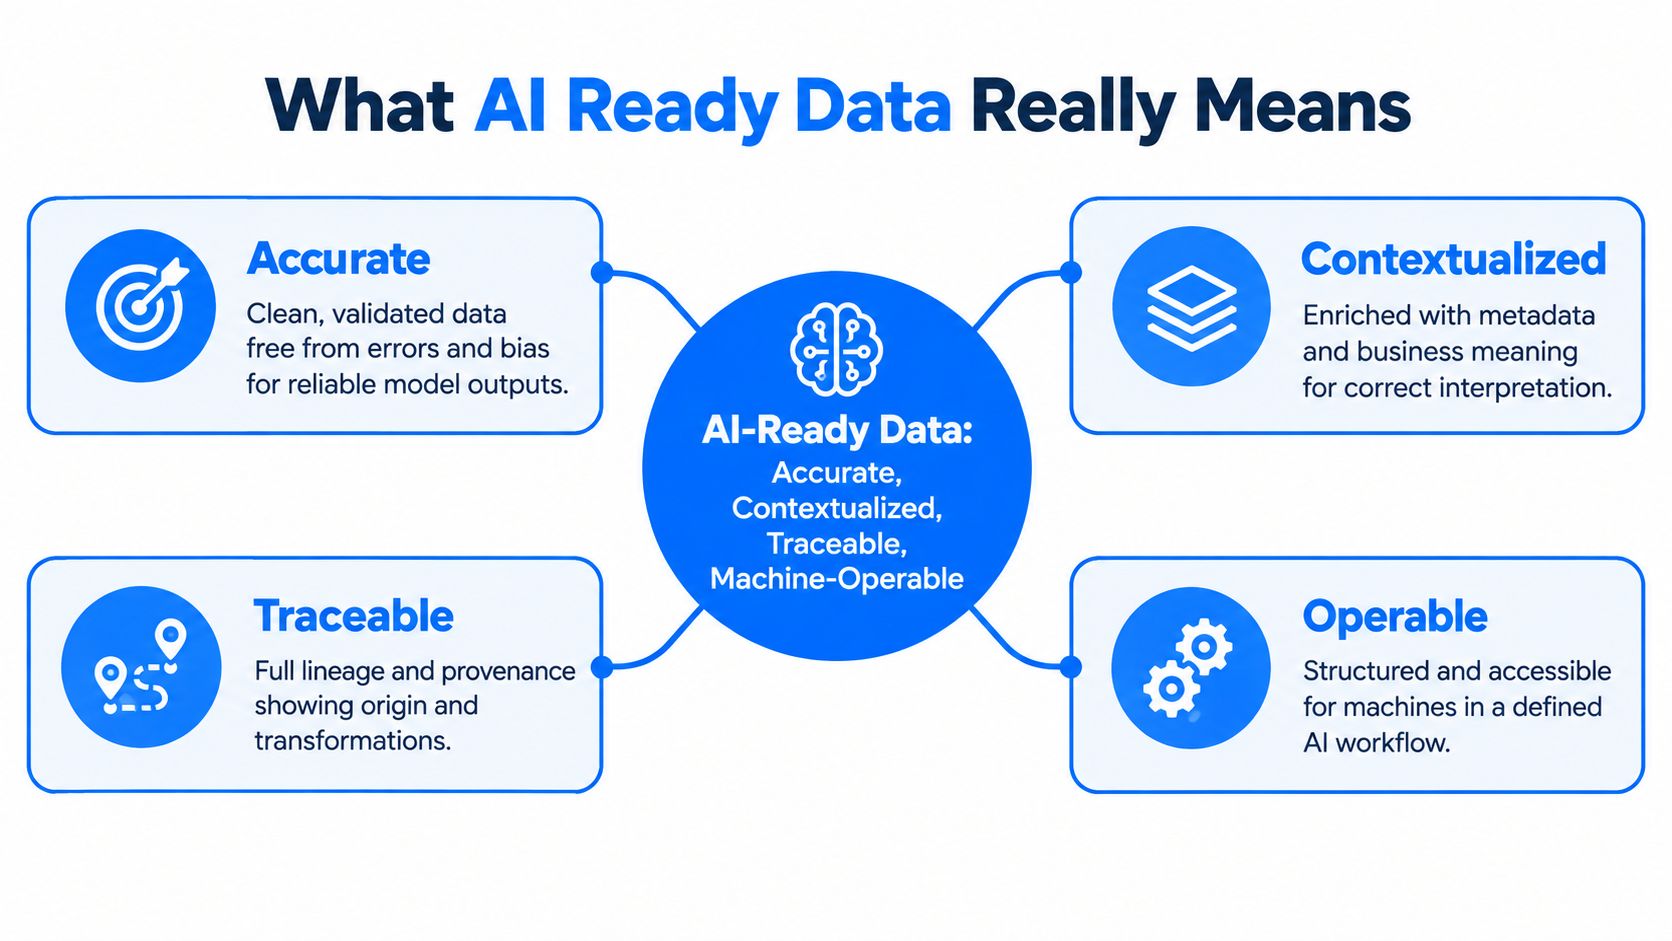
Dane gotowe na AI to nie po prostu dane z mniejszą liczbą wartości pustych i czystszymi wartościami. To dane, które maszyna potrafi zinterpretować, prześledzić i poprawnie wykorzystać w zdefiniowanym przepływie.
Pomaga porównanie z kuchnią. Surowe składniki w lodówce to nie to samo co składniki przygotowane pod przepis. Możesz mieć cebulę, pomidory i przyprawy, ale to nie znaczy, że obiad jest gotowy. Ktoś wciąż musi umyć, pokroić, odmierzyć, opisać i ułożyć wszystko pod konkretne danie. Z danymi jest tak samo. Przechowywanie to nie gotowość. Gotowość znaczy, że zbiór przygotowano pod określony rodzaj obliczeń.
Dokładność to dopiero pierwsza warstwa
Zacznij od jakości wartości — i słusznie. Złe wartości psują modele w oczywisty sposób. Błędne znaczniki czasu zniekształcają cechy sekwencyjne. Zdublowani klienci zawyżają ekspozycję. Niespójne etykiety zatruwają cele treningowe. Jeśli potrzebujesz solidnego przypomnienia, wymiary jakości danych to właściwa podstawa.
Ale sama dokładność nie czyni danych gotowymi na AI. Idealnie poprawna kolumna wciąż zawodzi, jeśli model nie potrafi rozpoznać, co ona znaczy, skąd pochodzi ani czy dotyczy bieżącego zadania.
Kontekst zamienia wartości w użyteczny sygnał
Dane stają się użyteczniejsze, gdy niosą metadane, które maszyny potrafią parsować, a nie tylko komentarze, które ludzie potrafią przeczytać. Niezależne wytyczne społeczności statystycznej ONZ i rządu Wielkiej Brytanii podkreślają, że zbiory gotowe na AI potrzebują metadanych czytelnych maszynowo, zapewnienia jakości, interoperacyjnych formatów i kontroli nadzoru. Ramy ONZ eksponują metadane wykonywalne maszynowo, kontrolę jakości, otwarte licencjonowanie, odpowiedzialny dostęp wspierany AI i ustrukturyzowaną współpracę. Wytyczne brytyjskie z 2026 roku mówią, że zbiór gotowy na AI musi spełniać standardy optymalizacji technicznej, dokładności, kompletności, spójności, metadanych, bieżącego monitorowania jakości i zgodności prawnej (wytyczne ONZ i Wielkiej Brytanii o danych gotowych na AI).
Brzmi abstrakcyjnie, dopóki nie przełożysz tego na pracę inżynierską:
Znaczenie biznesowe mówi zespołowi modelującemu, co reprezentuje pole.
Metadane techniczne mówią systemom, jak je sparsować i połączyć.
Kontekst użycia mówi odbiorcom, kiedy wypada z niego korzystać.
Śledzalne i obsługiwalne maszynowo znaczy bezpieczne na produkcji
Artykuł ekspercki z 2026 roku opisuje dane gotowe na AI jako dane wsparte ustrukturyzowanymi metadanymi, które umożliwiają automatyczne odkrywanie, uzgodnienie semantyczne, śledzenie pochodzenia i powtarzalne wykorzystanie obliczeniowe. Zauważa też, że metadane na poziomie zbioru muszą być dołączone i parsowalne maszynowo, bo od tego zależą interoperacyjność i śledzalność (ekspercka dyskusja o ustrukturyzowanych metadanych i pochodzeniu).
Reguła praktyczna: traktuj metadane, pochodzenie i proweniencję jako część kontraktu wejściowego modelu, a nie opcjonalną papierologię nadzoru.
To rdzeń definicji, której używam w pracy platformowej: dane gotowe na AI są dokładne, osadzone w kontekście, śledzalne i obsługiwalne maszynowo dla konkretnego zadania AI. Jeśli brakuje któregoś z tych elementów, model może nadal działać. Po prostu nie będzie godny zaufania.
Sześć filarów, które czynią dane gotowymi na AI
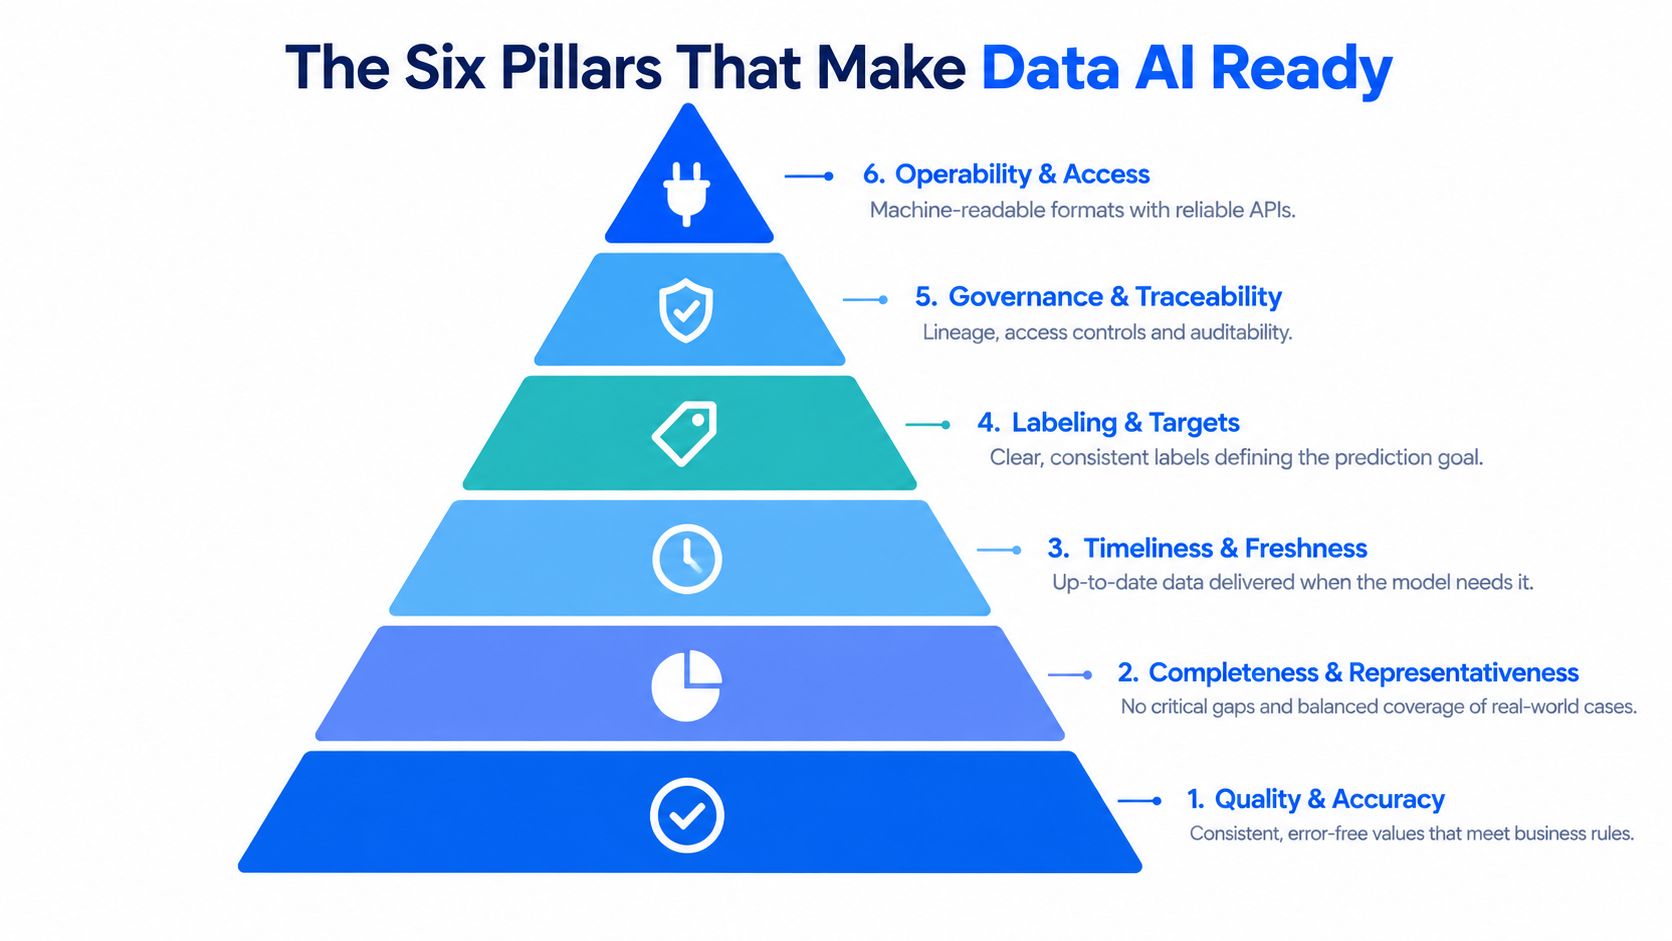
Praktyczna lista kontrolna wykracza poza „czyste i nadzorowane”. Sześć filarów jest użytecznych, bo obejmuje zarówno skuteczność modelu, jak i zaufanie operacyjne.
Jakość i dokładność
Zacznij od samych wartości. Czy rekordy są poprawne? Czy formaty są spójne? Czy daty, identyfikatory i pola kategoryczne przestrzegają reguł biznesowych?
To nie tylko ortodoksja zarządzania danymi. Badania empiryczne zbadały sześć wymiarów jakości danych w 19 popularnych algorytmach uczenia maszynowego do klasyfikacji, regresji i grupowania, właśnie po to, by wyjaśnić skuteczność przez jakość danych. Późniejsza praca o AI zorientowanej na dane wróciła do sześciu wymiarów: spójnej reprezentacji, kompletności, dokładności cech, dokładności zmiennej docelowej, unikalności i zrównoważenia klas docelowych (badania o wymiarach jakości danych i wynikach ML).
Praktyczny wniosek jest prosty. Duplikaty, źle oznaczone cele i niespójne reprezentacje zmieniają zachowanie modelu.
Kompletność i reprezentatywność
Kompletny zbiór wciąż może nie reprezentować świata, z którym zmierzy się twój model. Tu zespoły często się potykają. Sprawdzają liczbę wierszy i odsetek wartości pustych, a potem odkrywają, że model słabnie na rzadkich, lecz ważnych przypadkach.
Reprezentatywność pyta, czy dane zawierają zdarzenia, użytkowników, przypadki brzegowe i warunki eksploatacji, które system AI musi obsłużyć. Jeśli trenujesz klasyfikator zgłoszeń na dobrze sformułowanych ticketach, a produkcja zawiera skróty, wklejone logi i tekst wielojęzyczny, twoja czysta próbka nie jest dość reprezentatywna.
Użyteczna lista korporacyjna często obejmuje:
Pokrycie przypadków brzegowych ważnych dla biznesu, nie tylko ścieżki typowej
Zrównoważone przykłady tam, gdzie nierównowaga klas zniekształciłaby trening
Różnorodność źródeł gdy ta sama encja pojawia się w rozproszonych systemach
Timeliness i świeżość
Część danych jest poprawna, a mimo to bezużyteczna, bo przychodzi za późno. Dla AI liczy się to bardziej, niż wiele zespołów przypuszcza.
Model rekomendacji zbudowany na wczorajszym stanie magazynu może podsuwać niedostępne produkty. Sygnał oszustwa oparty na opóźnionych transakcjach traci wartość dokładnie wtedy, gdy liczy się szybkość. W systemach wyszukiwania nieświeża wiedza bywa groźniejsza niż wiedza brakująca, bo wynik wciąż brzmi pewnie.
Świeżość to nie przypis w SLA. Dla wielu przepływów AI jest częścią poprawności.
Etykietowanie i integralność zmiennej docelowej
Etykiety treningowe zasługują na własny filar, bo określają, co model uczy się optymalizować. Jeśli zespoły nie zgadzają się, co znaczy „odszedł”, „zatwierdzony” czy „wysokie ryzyko”, model zakoduje tę dwuznaczność.
Dobre etykietowanie to nie tylko spójność. To też zgodność operacyjna. Zmienna docelowa musi odzwierciedlać decyzję, którą biznes chce wesprzeć. Inaczej model świetnie nauczy się przewidywać zastępnik, którego nikt nie powinien używać.
Nadzór i śledzalność
Gdy wynik modelu wymaga wyjaśnienia, zespoły potrzebują pochodzenia szybko. Który system źródłowy dostarczył wartość? Jakie transformacje ją zmieniły? Kto zatwierdził zbiór do tego zastosowania?
Korporacyjne ramy jakości danych są tu przydatne, bo nadzór staje się praktyczny, gdy przypnie się go do konkretnych kontroli: własności, reguł dostępu, dowodów walidacji i historii pochodzenia. Bez śledzalności nawet mocny zbiór trudno audytować i trudno mu zaufać.
Obsługiwalność i dostęp
Ostatni filar bywa niedoceniany. Dane mogą mieć wysoką jakość i mimo to zawieść, bo tkwią w niewygodnych formatach, źle udokumentowanych wzorcach przechowywania albo kruchych przekazaniach.
Obsługiwalność znaczy, że dane są dostępne w formatach czytelnych maszynowo, osiągalne przez stabilne interfejsy i tak ustrukturyzowane, by potoki mogły je niezawodnie konsumować. W kategoriach produkcyjnych schematy, API, tabele i usługi metadanych przestają być hydrauliką i same stają się częścią gotowości na AI.
Gotowe do czego? Określ przydatność do swojego przypadku AI
Ogólna lista gotowości rozpada się w chwili, gdy porównasz różne zadania AI.
System wyszukiwania potrzebuje przeszukiwalnych dokumentów, strategii dzielenia na fragmenty, znaczników metadanych i pochodzenia. Model prognostyczny potrzebuje stabilnych szeregów czasowych, spójnej granulacji i wiarygodnych znaczników czasu. Przepływ autonomiczny potrzebuje jeszcze mocniejszych kontroli, bo może działać na danych bez ludzkiego przeglądu.
Gartner mówi to wprost. Liderzy muszą najpierw zdefiniować, co liczy się jako dane gotowe na AI, a te dane muszą być reprezentatywne dla przypadku użycia, z przypadkami brzegowymi, wartościami odstającymi i nieoczekiwanymi wzorcami potrzebnymi do wytrenowania lub uruchomienia modelu. Ta sama dyskusja zauważa, że organizacje często mylą skalę z jakością sygnału adekwatną do celu, podczas gdy obecne wytyczne podkreślają dane przeszukiwalne, kontekstowe i wiarygodne w zasobach ustrukturyzowanych, nieustrukturyzowanych i strumieniowych (Gartner o definiowaniu danych gotowych na AI według przypadku użycia).
Więcej danych nie odpowiada na właściwe pytanie
Zespoły często mówią: „mamy mnóstwo danych”. To może być prawda i wciąż nie mieć znaczenia.
Lepsze pytanie brzmi: która awaria zaszkodziłaby temu systemowi AI najbardziej? Jeśli system streszcza dokumenty polityk, nieaktualne wersje są dużym ryzykiem. Jeśli ocenia zdarzenia kredytowe, pochodzenie i status zatwierdzenia ważą więcej niż sama objętość tekstu. Jeśli zasila agenta operacyjnego, na środek wysuwają się świeżość w czasie działania i granice uprawnień.
Przypadek użycia AI | Najbardziej krytyczne kryteria gotowości | Typowa awaria przy ich braku |
|---|---|---|
Wyszukiwanie w dokumentach | Przeszukiwalne metadane, pochodzenie, wersjonowanie, kontrola dostępu | System zwraca nieaktualne lub ubogie kontekstowo treści |
Modelowanie predykcyjne | Reprezentatywne pokrycie, integralność zmiennej docelowej, spójność, kompletność | Model uczy się zniekształconych wzorców i pomija ważne przypadki |
Wsparcie decyzji w czasie rzeczywistym | Świeżość, Timeliness, stabilne schematy, dostęp o niskich opóźnieniach | Wynik odzwierciedla spóźnione lub niekompletne zdarzenia |
Przepływy autonomiczne | Nadzór, śledzalność, kontrole polityk, wykrywanie zmian | System podejmuje niebezpieczne działania na podstawie niewiarygodnych danych wejściowych |
Użyj krytycznych elementów danych, by zważyć listę kontrolną
Wielu zespołom pomaga zdefiniowanie krytycznych elementów danych, zanim zaczną stroić modele. Nie każde pole zasługuje na te same kontrole. Identyfikator klienta w procesie deduplikacji waży inaczej niż opisowe pole komentarza w wyszukiwaniu semantycznym.
Praktyczny sposób oceny przydatności to trzy pytania:
Jaka dokładnie decyzja lub wynik zależy od tych danych?
Który tryb awarii jest najmniej akceptowalny?
Które pola, metadane i ścieżki aktualizacji napędzają to ryzyko?
Gdy na nie odpowiesz, gotowość przestaje być hasłem i staje się specyfikacją inżynierską.
Jak w praktyce przygotować dane pod AI
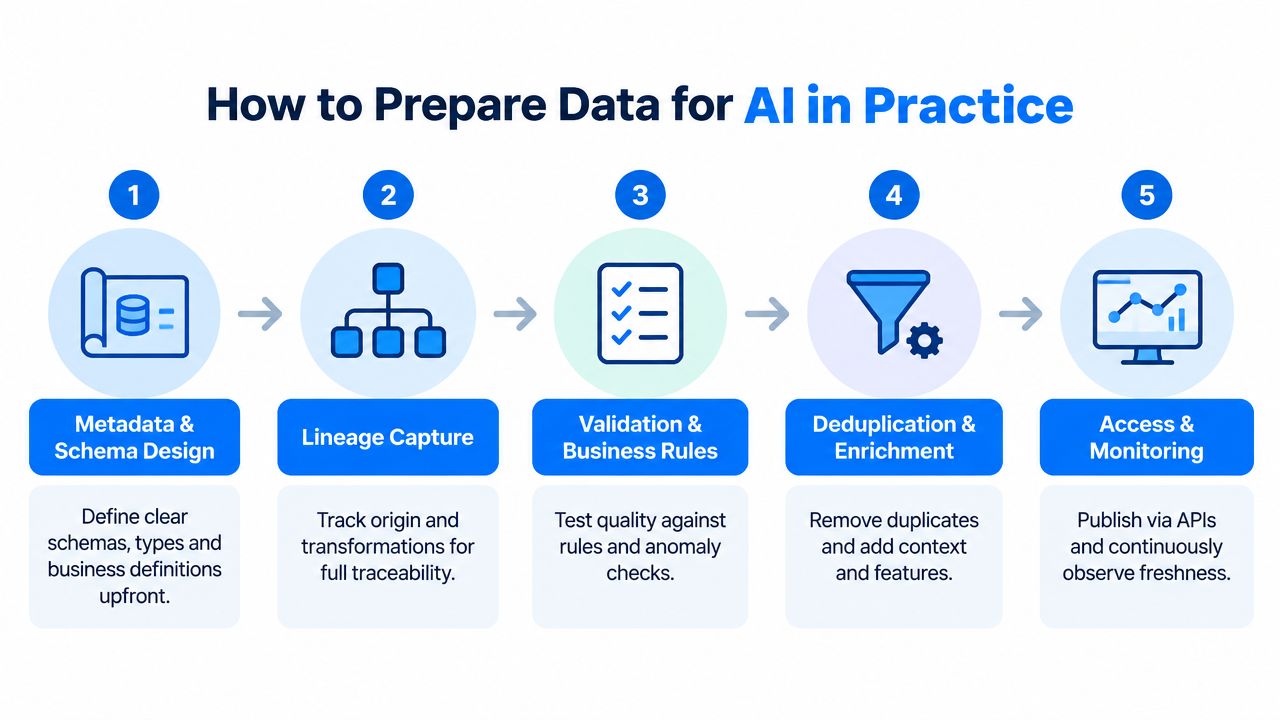
Przygotowanie działa najlepiej jako spójny przepływ, a nie stos oderwanych porządków. Kolejność ma znaczenie, bo wczesne decyzje projektowe rozstrzygają, ile zaufania zdołasz później zachować.
Zacznij od schematów i metadanych
Zanim zweryfikujesz wartości, zdefiniuj, czym zbiór ma być. To znaczy nazwy pól, typy, definicje biznesowe, własność, zatwierdzone użycie i oczekiwania co do odświeżania. Jeśli pole zmienia znaczenie bez zmiany nazwy, każdy model niżej w łańcuchu działa teraz z cichym ryzykiem.
Dobre metadane powinny odpowiadać zarówno na pytania ludzi, jak i maszyn. Człowiek powinien zrozumieć znaczenie biznesowe. Potok powinien umieć automatycznie sparsować strukturę, relacje i ograniczenia użycia.
Zapisz pochodzenie, póki transformacje są jeszcze widoczne
Pochodzenie najłatwiej zapisać w chwili, gdy dane się przemieszczają, a nie miesiące później przy audycie. Śledź, skąd dane przyszły, jakie złączenia i filtry ich dotknęły oraz które zadanie lub która osoba wypchnęła je do warstwy serwującej dla AI.
Najszybszy sposób na utratę zaufania do modelu to odkryć podejrzany wynik i nie mieć czystej drogi powrotnej do rekordów źródłowych.
To nie wymaga ogromnego programu nadzoru. Wymaga dyscypliny w projektowaniu potoków, logowaniu transformacji i rejestrowaniu zbiorów danych.
Sprawdź reguły biznesowe, zanim zwiększysz skalę treningu
Gdy definicje i pochodzenie już istnieją, zastosuj kontrole regułowe. Zweryfikuj identyfikatory, wymuś dozwolone zakresy, potwierdź integralność referencyjną i sprawdź etykiety wobec prawdy źródłowej tam, gdzie to możliwe.
Potem zajmij się problemami, które często mają nieproporcjonalny wpływ na modele:
Deduplikacja: usuń lub uzgodnij rekordy opisujące tę samą encję w sprzeczny sposób.
Przegląd braków: oddziel akceptowalne wartości puste od tych, które sygnalizują zepsuty dopływ danych.
Weryfikacja etykiet: sprawdź, czy wartości docelowe odpowiadają wynikowi operacyjnemu, na którym ci zależy.
Przegląd równowagi klas: zobacz, czy ważne kategorie są nieobecne, rzadkie albo przechylone.
Wzbogacaj zbiór, nie zasłaniając prawdy źródłowej
Wzbogacanie cech jest przydatne, ale może też zamazać pochodzenie, jeśli zespoły nie oznaczają wyraźnie pól pochodnych. Trzymaj osobno pola surowe, pola znormalizowane i cechy skonstruowane. To ułatwia diagnostykę, gdy zachowanie modelu staje się trudne do wyjaśnienia.
Opublikuj ścieżki dostępu i punkty monitorowania
Przygotowany zbiór powinien być odnajdywalny i konsumowalny. Zwykle oznacza to stabilną tabelę, API albo udokumentowaną ścieżkę serwowania z jasną własnością.
Oznacza też oprzyrządowanie zbioru przed wdrożeniem, a nie po pierwszym incydencie. Jeśli nie widzisz zmian w Timeliness, strukturze czy zachowaniu wartości, zbiór nie jest gotowy na produkcyjną AI.
Jak obserwowalność utrzymuje dane gotowe na AI w czasie działania
Przygotowanie doprowadza zbiór do linii startu. Obserwowalność utrzymuje go tam.
Liczy się to najbardziej w środowiskach regulowanych lub wrażliwych na prywatność, gdzie zespoły nie mogą eksportować danych do zewnętrznych narzędzi AI. Niezależne opracowania branżowe coraz częściej ujmują dane gotowe na AI jako dane odnajdywalne, nadzorowane, bezpieczne i użyteczne w rozproszonych systemach, przy czym zaufanie w czasie działania staje się centralne dla skalowania AI w przedsiębiorstwie, zwłaszcza w finansach, ochronie zdrowia, telekomunikacji i sektorze publicznym (IBM o wiarygodnych i nadzorowanych danych gotowych na AI).

Jak w praktyce wygląda zaufanie w czasie działania
W czasie działania nie pytasz już, czy historyczny zbiór wyglądał dobrze podczas przygotowania. Pytasz, czy dzisiejsze dane wejściowe wciąż odpowiadają warunkom, w których model albo agent uchodzi za bezpiecznego.
Zwykle wymaga to kilku kontroli działających razem:
Monitorowanie świeżości, by wychwycić ładowania spóźnione, brakujące lub nieoczekiwanie wczesne
Śledzenie schematu, by wychwycić zmiany strukturalne, zanim zawiodą systemy niżej w łańcuchu
Kontrole walidacyjne, by egzekwować reguły biznesowe na rekordach produkcyjnych
Monitorowanie zachowania, by wykryć nietypowe przesunięcia w rozkładach wartości lub wzorcach wierszy
Platforma taka jak oprogramowanie do obserwowalności danych digna jest przykładem tego wzorca. Działa wewnątrz środowiska klienta, liczy kontrole w bazie i łączy wykrywanie anomalii, monitorowanie Timeliness, walidację i śledzenie schematu, nie wymagając od dostawcy dostępu do danych produkcyjnych. Ten model wdrożenia ma znaczenie, gdy dane nie mogą opuścić własnej infrastruktury organizacji.
Metryki operacyjne są konkretne
Dryf schematu to nie mgliste zmartwienie. Jeden projekt referencyjny definiuje licznik zmian schematu na tabelę, obejmujący dodanie, usunięcie, zmianę nazwy, typu i dopuszczalności wartości pustych kolumn, i łączy to ze statystycznymi sygnałami dryfu, takimi jak odsetek wartości pustych i liczba wartości unikalnych, by oddzielić zmianę strukturalną od rozkładowej (metryki dryfu schematu i atrybutów).
Świeżość też jest mierzalna. Jeden projekt obserwowalności śledzi opóźnienie wykrycia dryfu jako średni czas między wystąpieniem zmiany schematu a jej wykryciem przez system. Śledzi też wskaźnik utraty danych i wskaźnik awarii potoków jako odsetki rekordów zniekształconych lub utraconych bądź zadań nieudanych (monitorowanie opóźnienia dryfu i sygnałów jakości potoków).
Monitorowanie wspierane AI ogranicza ręczną pracę nad progami
Ręczne progi kiepsko skalują się na setki zbiorów danych. Bigeye podaje, że jego wykrywanie anomalii uczy się historycznego zachowania zbioru i automatycznie wyznacza progi dla każdego atrybutu jakości danych, używając progów odchylenia standardowego opartych na historycznej średniej, by generować alerty bez ręcznego wysiłku (podejście Bigeye do wykrywania anomalii).
Databricks opisuje podobny kierunek korporacyjny. Jego monitorowanie automatycznie analizuje wzorce historyczne, by wykrywać anomalie w świeżości i kompletności tabel, a zarazem śledzi trendy statystyczne i anomalie w czasie w jednym systemie (monitorowanie lakehouse w Databricks).
Historyczna czystość pomaga w treningu. Obserwowalność w czasie działania rozstrzyga, czy produkcyjne wyniki AI pozostają godne zaufania.
Tę zmianę przechodzi teraz wiele zespołów. Gotowość na AI nie jest już tylko kamieniem milowym przygotowania danych. Jest warunkiem eksploatacji.
Podsumowanie: twoja droga do wiarygodnych danych gotowych na AI
Dane gotowe na AI to nie większa sterta rekordów. To dane przydatne do konkretnego zastosowania i wciąż wiarygodne, gdy żywe systemy wokół zaczynają się zmieniać.
To znaczy, że muszą spotkać się dwie dyscypliny. Po pierwsze, przygotować zbiory tak, by były dokładne, osadzone w kontekście, śledzalne i obsługiwalne maszynowo. Po drugie, utrzymać ten stan kontrolami działającymi na bieżąco, które wychwycą nieświeże dane wejściowe, zmiany schematu, brakujące rekordy i anomalie zachowania, zanim dotrą do modelu, agenta lub przepływu decyzyjnego.
Jeśli oceniasz własne środowisko, zachowaj praktyczność pierwszego przejścia:
Zdefiniuj wyraźnie przypadek użycia: wyszukiwanie, predykcja, wsparcie decyzji czy działanie autonomiczne
Wskaż krytyczne pola i etykiety: zwłaszcza te powiązane z ryzykiem biznesowym
Sprawdź duplikaty, braki i integralność etykiet: często psują jakość modelu szybciej, niż zespoły się spodziewają
Zweryfikuj świeżość i stabilność schematu: szczególnie dla systemów żywych lub niemal czasu rzeczywistego
Wymagaj pochodzenia i metadanych czytelnych maszynowo: by zespoły mogły ufać temu, co konsumuje model, i to audytować
Wybieraj obserwowalność wewnątrz środowiska, gdy dane nie mogą się przemieszczać: zwłaszcza w kontekstach regulowanych
Największym błędem jest traktowanie gotowości jak jednorazowego sprzątania. Bliżej jej do inżynierii niezawodności. Ustanawiasz kontrole, definiujesz akceptowalne warunki eksploatacji i patrzysz dalej. Tak surowe dane wejściowe stają się wiarygodną AI.
digna dostarcza korporacyjną platformę jakości i obserwowalności danych, która pomaga zespołom utrzymać wiarygodność danych dla AI we własnym środowisku, z kontrolami w bazie dla anomalii, Timeliness, walidacji i zmian schematu. Jeśli twoje obciążenia AI zależą od zaufania w czasie działania tak samo jak od początkowego przygotowania, odwiedź digna, by zobaczyć, jak ten model działa w praktyce.
Gotowość to ruchomy cel, nie certyfikat — zarządzanie jakością danych utrzymuje zbiór w formie odpowiedniej dla modelu, który już od niego zależy.
Najczęściej zadawane pytania
Co naprawdę oznaczają dane gotowe na AI?
Dokładność to dopiero pierwsza warstwa. Dane są gotowe na AI, gdy niosą też kontekst zamieniający wartości w użyteczny sygnał oraz gdy są śledzalne i obsługiwalne maszynowo — czyli model może je konsumować na produkcji bez człowieka składającego je wcześniej. Dokładne, ale pozbawione kontekstu dane i tak zatrzymują projekt.
Jakie są filary gotowości na AI?
Sześć: jakość i dokładność, kompletność i reprezentatywność, Timeliness i świeżość, etykietowanie i integralność zmiennej docelowej, nadzór i śledzalność oraz obsługiwalność i dostęp. Integralność etykiet zespoły pomijają najczęściej, a zepsuta kolumna docelowa unieważnia wszystko, co na niej wytrenowano.
Dlaczego projekty AI grzęzną, choć wyglądały zdrowo?
Bo zator zaczyna się wyżej w łańcuchu, nie w modelu. Projekt wygląda dobrze, dopóki nie dotknie danych produkcyjnych i zaufanie nie musi przetrwać zderzenia z żywymi systemami — spóźnionymi dopływami, zdryfowanymi schematami, niereprezentatywnymi próbkami. Model to zwykle ostatnie miejsce, w którym problem powstaje.
Czy więcej danych to odpowiedź na gotowość do AI?
Nie. Więcej danych nie odpowiada na właściwe pytanie. Gotowość to przydatność do konkretnego zastosowania, więc użytecznym ruchem jest wskazanie krytycznych elementów danych i zważenie listy kontrolnej w ich stronę, zamiast rozszerzania wolumenu na pola, których żaden model nie konsumuje.
Jak utrzymać dane gotowe na AI w czasie działania?
Gotowość się zużywa, więc potrzebuje monitorowania, a nie jednorazowej certyfikacji. Obserwuj na bieżąco świeżość wobec obiecanego okna, stabilność schematu, przesunięcia rozkładów i integralność etykiet. Monitorowanie wspierane AI pomaga, bo ogranicza ręczne strojenie progów, przez które statyczne reguły się starzeją.



