Czym jest plik Parquet i dlaczego zespoły go używają
|
9
min. czyt.
Parquet to otwartoźródłowy kolumnowy format pliku, który trzyma razem wartości tego samego typu i używa metadanych w stopce, by silniki zapytań czytały tylko potrzebne kolumny i pomijały nieistotne dane. Powstał jako wspólne przedsięwzięcie Twittera i Cloudery, ukazał się po raz pierwszy w lipcu 2013, a 27 kwietnia 2015 stał się projektem najwyższego poziomu Apache Software Foundation.
Jeśli tu jesteś, masz pewnie jeden z trzech problemów. Twoje zapytania do hurtowni zwolniły po tym, jak urósł zbiór danych. Twoje jezioro jest pełne eksportów CSV, które łatwo tworzyć i boleśnie skanować. Albo twój zespół już używa Parquet, ale wydajność wciąż skacze między „wystarczająco szybko” a „dlaczego ten pulpit się zawiesza?”.
To zamieszanie jest normalne. Większość wyjaśnień odpowiada na pytanie czym jest plik Parquet jednym zdaniem: „skompresowanym formatem kolumnowym”. To prawda, ale niepełna. W praktyce Parquet dotyczy metadanych, dyscypliny schematu i decyzji o układzie plików co najmniej tak samo jak kompresji.
Czysty zbiór Parquet potrafi wydawać się bezwysiłkowy. Zabałaganiony potrafi dać kosztowne skany, kruche zadania niżej w łańcuchu i dziwne zachowania, gdy schematy rozjeżdżają się między plikami. Dlatego inżynierowie danych jednocześnie kochają Parquet i na niego narzekają.
Spis treści
Wprowadzenie do Parquet dla nowoczesnej analityki
Znajoma scena: inżynierka analityki otwiera model, który kiedyś kończył się szybko, dokłada dwa kolejne miesiące danych i nagle każde zapytanie się wlecze. Surowe dane leżą w pamięci obiektowej. Część plików to CSV, część eksporty JSON, część Parquet. Zespół BI chce szybszych pulpitów. Zespół platformowy chce niższych kosztów skanowania. Nikt nie chce przepisywać każdego potoku.
I wtedy zwykle w rozmowie pojawia się Parquet.
Apache Parquet powstał jako otwartoźródłowy, zorientowany kolumnowo format pliku do wydajnego przechowywania i odczytu, z ideami projektowymi zainspirowanymi badaniami Google nad Dremelem. Wyrósł ze wspólnego przedsięwzięcia Twittera i Cloudery, ukazał się po raz pierwszy w lipcu 2013, a 27 kwietnia 2015 stał się projektem najwyższego poziomu Apache Software Foundation, jak podaje historia projektu Apache Parquet.
Dla nowoczesnej analityki urok jest prosty. Parquet organizuje dane tak, jak analitycy odpytują duże tabele. Większość obciążeń analitycznych nie czyta każdego pola każdego rekordu. Czyta podzbiór kolumn, nakłada filtry i agreguje.
Dlaczego zespoły przechodzą z surowych plików na Parquet
Eksport wierszowy taki jak CSV łatwo obejrzeć, ale zmusza silniki do brodzenia w danych, które często nie są potrzebne. Parquet zbudowano do innej roboty.
Odczyty skupione na kolumnach: sprawdza się, gdy zapytania dotykają kilku kolumn w wielu wierszach.
Efektywność przechowywania: wartości tego samego typu leżą razem, co pomaga kompresji działać lepiej.
Metadane przyjazne silnikom: czytelnicy mogą użyć metadanych pliku, by uniknąć skanowania nieistotnych części zbioru.
Haczyk polega na tym, że Parquet nie jest uniwersalnym domyślnym wyborem do wszystkiego. Świetnie nadaje się do skanów analitycznych. Nie zaprojektowano go jak silnika OLTP do częstych odczytów i aktualizacji pojedynczych wierszy.
Parquet pomaga najbardziej, gdy twój wzorzec dostępu jest szeroki i analityczny, a nie transakcyjny i wiersz po wierszu.
To rozróżnienie liczy się jeszcze bardziej w środowiskach lakehouse, gdzie wybór formatu pliku zazębia się z partycjonowaniem, ewolucją schematu i planowaniem zapytań. Jeśli eksploatujesz taki stos, warto powiązać decyzje o formacie z szerszymi praktykami utrzymania jakości danych w lakehouse.
Pytanie kryjące się za pytaniem
Gdy ludzie pytają, czym jest plik Parquet, zwykle chodzi im o coś bardziej praktycznego:
Czy przyspieszy moje zapytania?
Czy zmniejszy zużycie pamięci?
Czy pęknie, gdy schematy się rozwiną?
Czy powinienem używać go do każdego zbioru danych?
To są przydatne pytania. Pod koniec powinieneś umieć odpowiedzieć na nie precyzyjniej niż „Parquet jest skompresowany i kolumnowy”.
Jak działa przechowywanie kolumnowe, po ludzku
Pomyśl o arkuszu z kolumnami takimi jak customer_id, country, signup_date i revenue. Format wierszowy trzyma każdy rekord razem. Format kolumnowy trzyma razem wszystkie wartości customer_id, wszystkie wartości country i tak dalej.
Brzmi abstrakcyjnie, dopóki nie odniesiesz tego do zapytania.
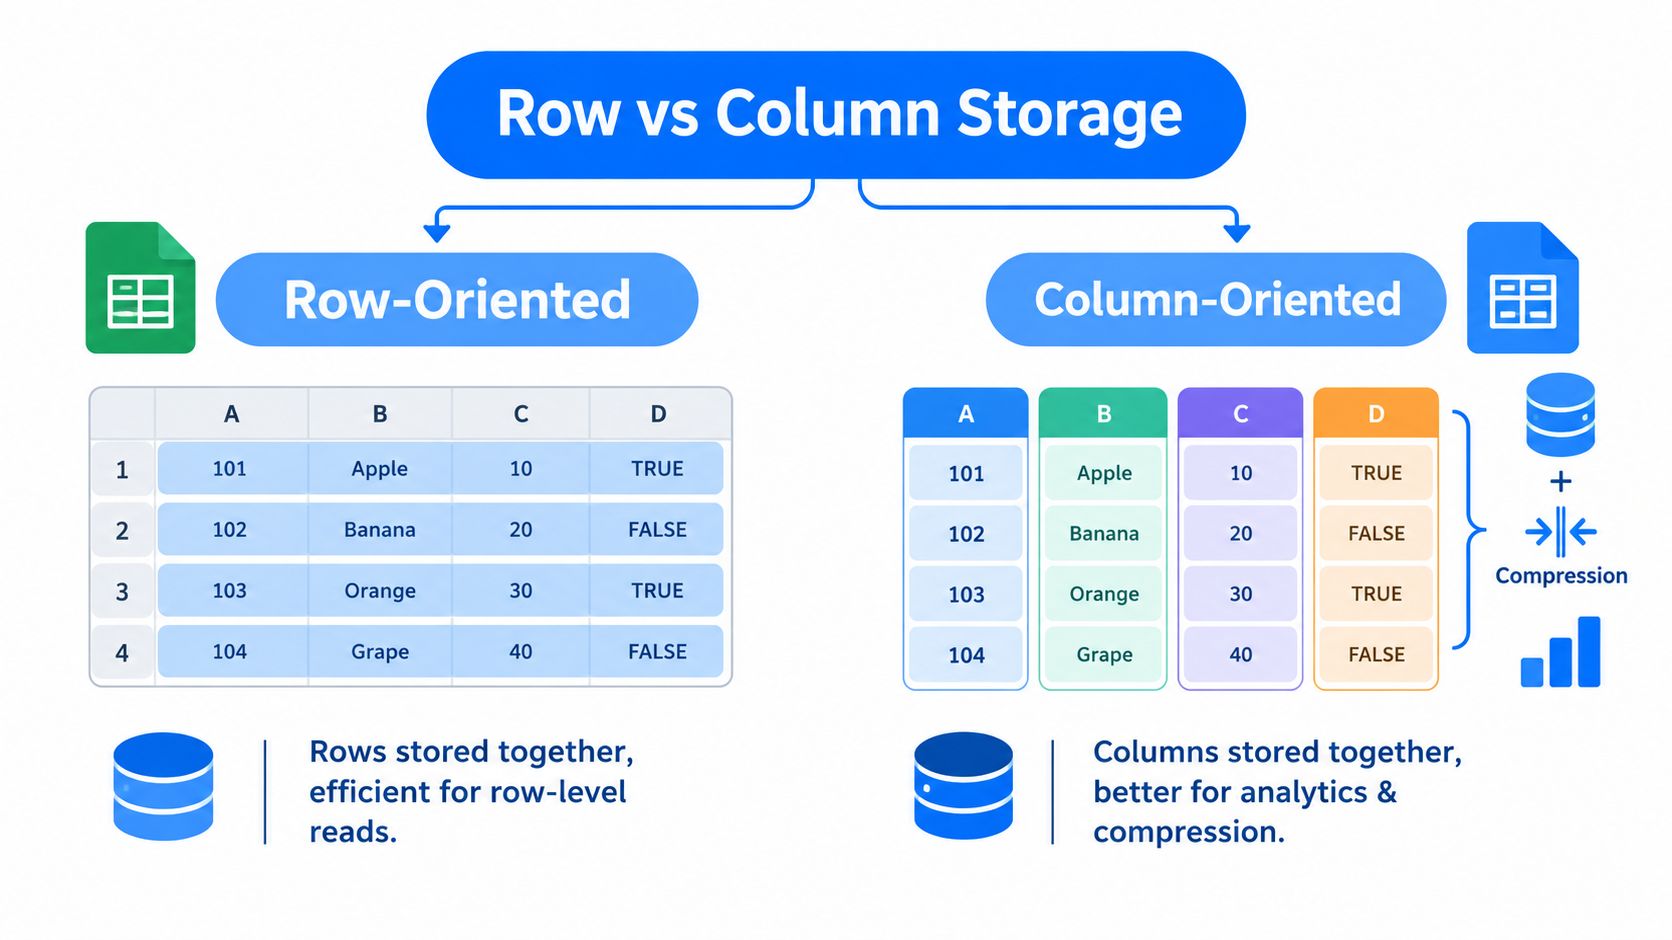
Przechowywanie wierszowe kontra kolumnowe
Załóżmy, że uruchamiasz:
select country, sum(revenue) from sales where signup_date >= ... group by country
Plik wierszowy zmusza silnik do odczytu każdego pełnego rekordu, łącznie z kolumnami, których twoje zapytanie nie używa. Plik kolumnowy pozwala silnikowi skupić się na country, revenue i signup_date.
To pierwsza wielka idea: przycinanie kolumn. Czytelnik całkowicie pomija nietknięte kolumny.
Druga wielka idea to kompresja. Gdy podobne wartości leżą obok siebie, kompresja zwykle działa lepiej. Kolumna pełna dat zachowuje się inaczej niż kolumna pełna tekstu, a kolumna z powtarzalnymi kategoriami inaczej niż swobodne pole notatek.
Dlaczego pomagają wartości tego samego typu
Parquet wspiera wbudowane kodowania kolumn i kodeki kompresji, a format dokumentuje kodeki takie jak Snappy, Gzip, LZO i Zstandard. Ponieważ wartości tego samego typu leżą razem, taki układ poprawia efektywność przechowywania i daje zespołom kompromis między kosztem CPU a rozmiarem pliku dla obciążeń analitycznych, jak opisuje dokumentacja kodowań Parquet.
Oto wersja praktyczna:
Powtarzalne wartości dobrze się kompresują: kody krajów, pola statusu, wartości logiczne.
Sekwencje liczbowe można kodować wydajnie: identyfikatory i znaczniki czasu często zyskują na wyspecjalizowanych kodowaniach.
Szerokie tabele zyskują na projekcji: jeśli twój pulpit potrzebuje 5 z 80 kolumn, silnik nie musi płacić za wszystkie 80.
Reguła praktyczna: jeśli twoi użytkownicy zwykle skanują wiele wierszy, ale tylko ułamek kolumn, przechowywanie kolumnowe pracuje z twoim obciążeniem, a nie przeciw niemu.
Gdzie rodzą się nieporozumienia
Wielu słyszy „kolumnowy” i zakłada, że Parquet jest automatycznie szybszy w każdym zastosowaniu. Nie jest.
Parquet jest zoptymalizowany pod skany analityczne, zwłaszcza gdy potrzebujesz kilku kolumn w wielu rekordach. Mniej naturalnie wypada przy dostępie wiersz po wierszu, częstych aktualizacjach czy obciążeniach, które nieustannie pobierają pojedyncze rekordy po kluczu.
Pomocny model myślowy jest taki:
CSV: łatwy do wytworzenia, trudny do wydajnego skanowania w skali
Wierszowe formaty binarne: lepsze do odczytu całych rekordów
Parquet: najlepszy, gdy zapytanie jest selektywne po kolumnach i duże po liczbie wierszy
Jeśli z tej sekcji zapamiętasz tylko jedno, niech będzie to: Parquet przyspiesza analitykę, bo zmienia to, co silnik musi przeczytać, a nie tylko dlatego, że zmniejsza pliki.
Wewnątrz pliku Parquet, od nagłówka do stopki
Gdy zrozumiesz ideę kolumnową, kolejnym krokiem jest anatomia pliku. Parquet staje się wtedy czymś więcej niż „CSV, ale skompresowanym”.
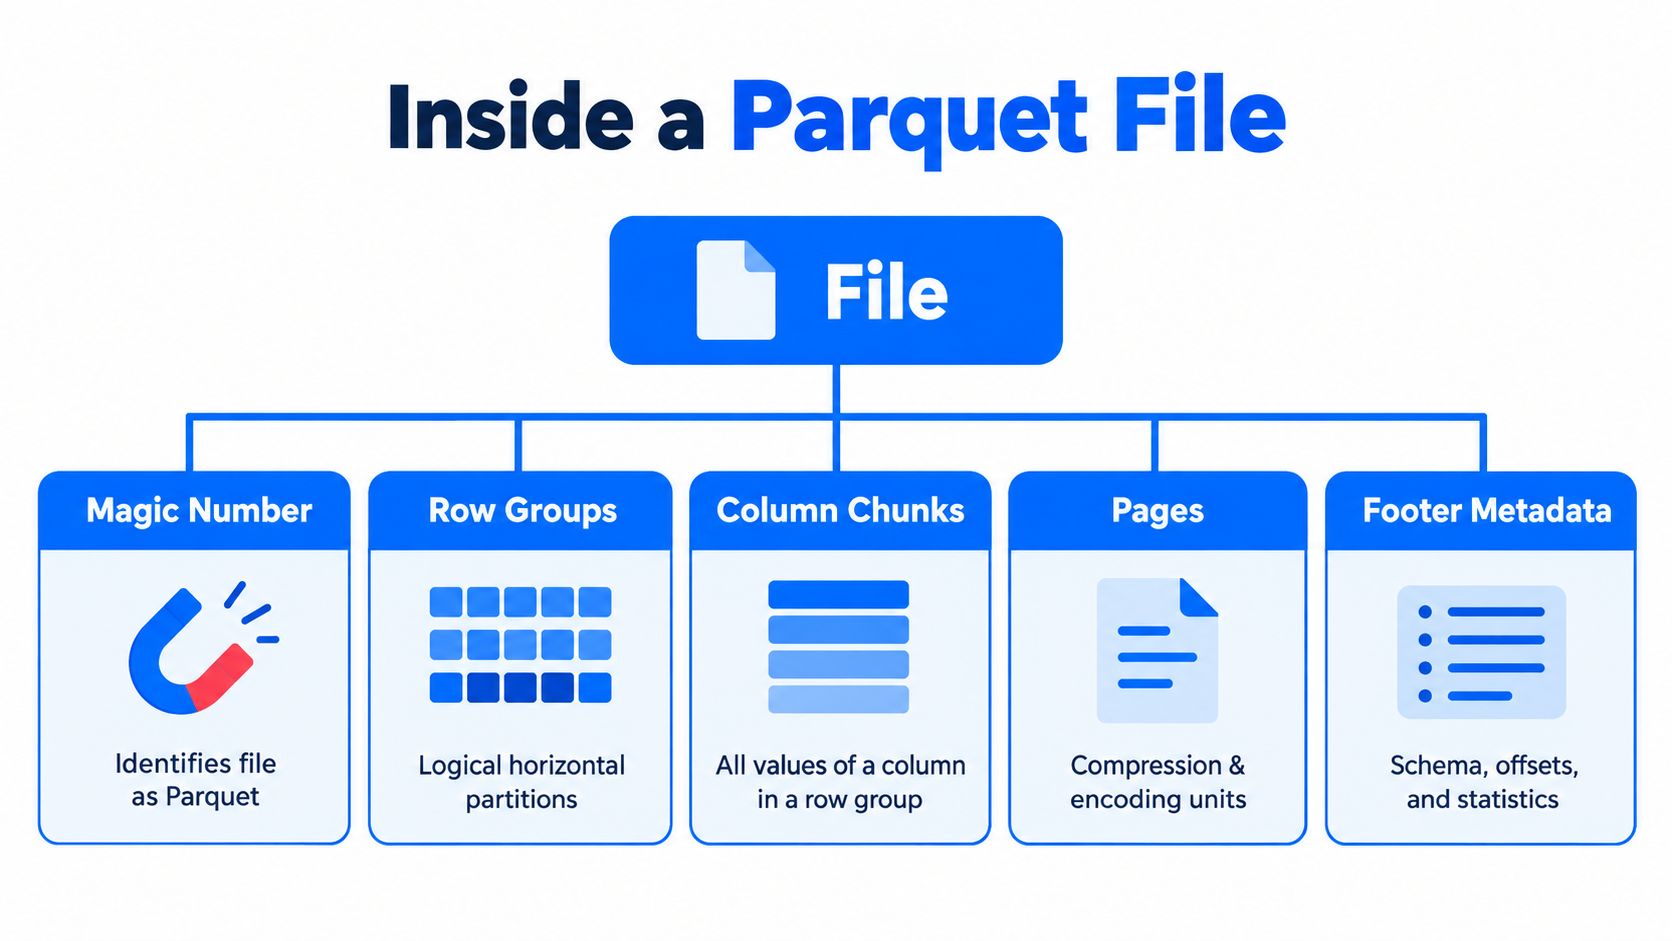
Plik Parquet zaczyna się 4-bajtową liczbą magiczną, PAR1, i zawiera metadane stopki, które zapisują schemat, położenie fragmentów kolumn, kodowania i statystyki. Ten projekt pozwala silnikom czytać tylko potrzebne kolumny i pomijać nieistotne grupy wierszy podczas skanów, zgodnie z dokumentacją formatu pliku Parquet.
Plik ma warstwy
Pomaga wyobrazić sobie plik Parquet jako pojemnik z zagnieżdżonymi częściami.
Nagłówek
Zaczyna się liczbą magiczną
PAR1.Sygnalizuje, że plik jest zgodny z formatem Parquet.
Grupy wierszy
Poziome partycje wewnątrz pliku.
Każda grupa wierszy zawiera dane dla wycinka wierszy.
Fragmenty kolumn
Wewnątrz każdej grupy wierszy każda kolumna jest zapisana osobno.
Zapytanie czytające trzy kolumny potrzebuje tylko fragmentów tych kolumn.
Strony
Mniejsze jednostki wewnątrz fragmentów kolumn.
Kodowania i kompresja są stosowane na tym poziomie.
Stopka
Przechowuje schemat i strukturalną mapę pliku.
Zawiera metadane o tym, gdzie leżą fragmenty i jak są zakodowane.
Dlaczego stopka tak bardzo się liczy
Stopka to część, którą wiele wprowadzeń bagatelizuje. To tu Parquet staje się inteligentny.
Prawdziwa siła Parquet mieszka w metadanych. Plik nie przechowuje tylko wartości. Przechowuje dość struktury, by pomóc silnikom uniknąć zbędnej pracy.
Te metadane mogą powiedzieć czytelnikowi, gdzie zaczyna się fragment kolumny, jak zakodowano wartości i jakie statystyki są dostępne do przycinania. Inaczej mówiąc, silnik nie otwiera pliku na ślepo i nie czyta, aż znajdzie to, czego szuka. Zaczyna z mapą.
Dla zespołów obsługujących wiele plików w jeziorze to właśnie dlatego praktyki zarządzania metadanymi tak bardzo się liczą. Szybka analityka zależy od uporządkowanej struktury plików, spójnych schematów i czytelnych metadanych, a nie od jednorazowego wyboru Parquet i pójścia dalej.
Co grupy wierszy robią w praktyce
Grupy wierszy to użyteczny kompromis. Czynią plik dość dużym dla wydajnych skanów, a wciąż podzielnym do pracy równoległej.
Załóżmy, że twoje zapytanie filtruje po kolumnie daty. Jeśli metadane wskazują, że grupa wierszy leży w całości poza zakresem filtra, silnik może ją pominąć. Jeśli zapytanie wybiera tylko podzbiór kolumn, może też zignorować niepotrzebne fragmenty kolumn w pasujących grupach.
Ta kombinacja to często miejsce, w którym Parquet wygrywa:
Pomiń kolumny, których nie potrzebujesz
Pomiń grupy wierszy, które nie mogą pasować
Dekoduj strony tylko tam, gdzie trzeba
Dlaczego anatomia pliku wpływa na eksploatację
Gdy Parquet zachowuje się źle, problemem rzadko jest „Parquet jest wolny”. Zwykle chodzi o jedno z tego:
zbyt wiele maleńkich plików
źle dobrane rozmiary grup wierszy
niespójne schematy między plikami cząstkowymi
słabe lub brakujące statystyki
kosztowne odkrywanie metadanych w dużych tabelach
Dlatego doświadczeni inżynierowie traktują Parquet jednocześnie jako format przechowywania i system operacyjny. Wnętrze pliku jest eleganckie. Trudne części zaczynają się na poziomie zachowania zbioru danych.
Kompresja, kodowania i kompromisy wydajności
Sporo efektywności Parquet bierze się z czegoś prostego: gdy wartości tego samego typu leżą razem, format potrafi zakodować je i skompresować mądrzej niż zwykły plik tekstowy.
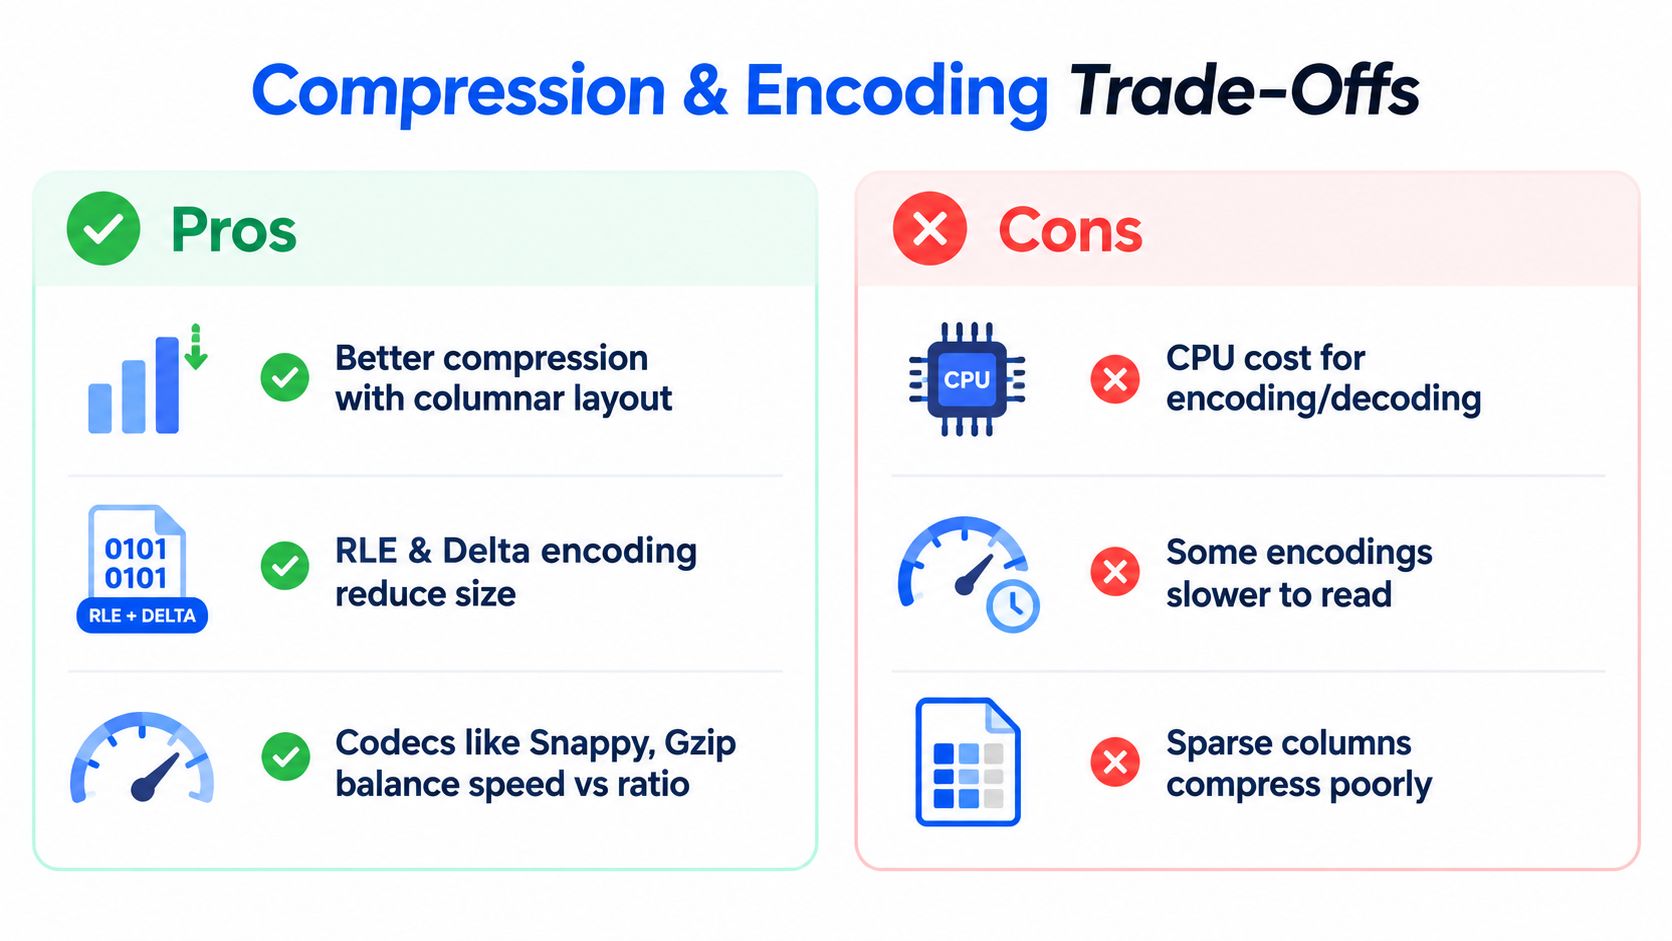
Kluczowy szczegół to miejsce, w którym się to dzieje. Parquet wspiera wiele mechanizmów kodowania i kompresji na poziomie stron. Format obejmuje kodowania takie jak PLAIN, RLE, DELTA_BINARY_PACKED, RLE_DICTIONARY i BYTE_STREAM_SPLIT oraz kodeki kompresji takie jak SNAPPY, GZIP, BROTLI, ZSTD i LZ4_RAW, jak podsumowuje referencja formatu Parquet.
Najpierw kodowanie, potem kompresja
Łatwy sposób, by o tym myśleć:
Kodowanie zmienia sposób reprezentacji wartości.
Kompresja zmniejsza zakodowane bajty.
Są ze sobą związane, ale to nie ta sama decyzja.
Kolumna tekstowa o niskiej kardynalności może skorzystać na obsłudze słownikowej. Szereg liczbowy może pasować do kodowania opartego na różnicach. Potem kodek taki jak Snappy czy ZSTD może jeszcze skompresować strony.
Kodowania i kodeki Parquet w skrócie
Mechanizm | Przykłady | Najlepsze do | Kompromis |
|---|---|---|---|
Kodowanie | PLAIN | Proste dane, szeroka zgodność | Mniej zwięzłe przy wartościach powtarzalnych |
Kodowanie | RLE | Wartości powtarzane lub o niskiej kardynalności | Mniej użyteczne, gdy wartości mocno się różnią |
Kodowanie | DELTA_BINARY_PACKED | Uporządkowane lub stopniowo zmieniające się dane liczbowe | Może dołożyć pracy przy dekodowaniu |
Kodowanie | RLE_DICTIONARY | Powtarzane wartości kategoryczne | Narzut słownika nie pomaga każdej kolumnie |
Kodowanie | BYTE_STREAM_SPLIT | Pewne układy liczbowe | Liczy się wsparcie czytelnika i dopasowanie do obciążenia |
Kodek | SNAPPY | Szybkie odczyty analityczne | Zwykle większe pliki niż przy cięższych kodekach |
Kodek | GZIP | Lepsze zmniejszenie rozmiaru pliku | Więcej CPU na kompresję i dekompresję |
Kodek | BROTLI | Zastosowania z agresywną kompresją | Może podnieść koszt obliczeń |
Kodek | ZSTD | Równowaga rozmiaru i szybkości w wielu obciążeniach | Wyniki zależą od wsparcia silnika i ustawień |
Kodek | LZ4_RAW | Scenariusze z szybką dekompresją | Stopień kompresji może być mniej agresywny |
Mniejszy nie zawsze znaczy szybszy
Zespoły często nadmiernie optymalizują nie to, co trzeba. Najmniejszy plik na dysku nie daje automatycznie najszybszego zapytania.
Jeśli kodek agresywnie ściska bajty, ale kosztuje więcej CPU przy dekodowaniu, całkowity czas może wzrosnąć. Z drugiej strony, jeśli większym ograniczeniem jest pamięć masowa albo transfer sieciowy, gęstsza kompresja może się opłacać.
W analityce zwycięskim wyborem jest zwykle ten, który zmniejsza łączną pracę pamięci, wejścia-wyjścia i CPU. Nie ten, który daje najmniejszy plik.
Dlatego liczy się testowanie. Silniki takie jak Spark, Trino, DuckDB i środowiska hurtowni inaczej reagują na rozmiary plików, strukturę stron i narzut dekompresji. Ten sam osąd pojawia się przy strojeniu zapytań w ogóle, nie tylko przy formatach plików, dlatego szersze nawyki optymalizacji SQL pozostają ważne także po wdrożeniu Parquet.
Jak to wypada wobec innych formatów
Kompresja to też dobre miejsce, by oddzielić Parquet od formatów pokrewnych:
CSV daje niewiele strukturalnego wsparcia dla wydajnej, typowanej kompresji.
Avro jest wierszowe, co zmienia, co dobrze się kompresuje i co wydajnie czyta.
ORC również jest kolumnowy i nastawiony na analitykę.
Delta dokłada zachowanie tabeli nad Parquet, zamiast zastępować jego układ przechowywania.
Tak więc Parquet bywa mniejszy i szybszy od CSV w analityce. Ale jego prawdziwa przewaga bierze się z połączenia układu, metadanych, kodowań i selektywnego odczytu.
Parquet w porównaniu z CSV, Avro, ORC i Deltą
Porównania formatów robią się mętne, gdy ludzie pytają: „który jest najlepszy?”. To zwykle złe pytanie. Dobre brzmi: który format pasuje do wzorca dostępu i modelu eksploatacji tego zbioru danych?
Zacznij od obciążenia, nie od lojalności
CSV wciąż jest powszechny, bo jest uniwersalny. Otworzysz go niemal wszędzie. Ale uniwersalność przychodzi ze słabym typowaniem, ubogimi metadanymi i kosztownymi skanami.
Avro sprawdza się lepiej, gdy zależy ci na wymianie wierszowej, potokach zdarzeń albo odczycie całych rekordów. ORC konkuruje z Parquet bardziej wprost w środowiskach analitycznych, zwłaszcza w stosach wyrosłych wokół optymalizacji w stylu Hive. Delta to znów coś innego: zwykle oznacza warstwę transakcji i zarządzania tabelami zbudowaną na plikach Parquet.
Wybór między Parquet, CSV, Avro, ORC i Deltą
Format | Układ | Idealne obciążenie | Ograniczenie, na które warto uważać |
|---|---|---|---|
Parquet | Kolumnowy | Skany analityczne po dużych danych tabelarycznych | Może stać się uciążliwy w eksploatacji przy dryfie schematu i słabym układzie plików |
CSV | Zwykły tekst zbliżony do wierszy | Prosta wymiana, szybkie eksporty, ręczny podgląd | Słabe typowanie, brak bogatych metadanych, nieefektywne duże skany |
Avro | Binarny, wierszowy | Potoki zdarzeń, serializacja, przetwarzanie całych rekordów | Mniej wydajny niż formaty kolumnowe przy analityce selektywnej |
ORC | Kolumnowy | Analityka w ekosystemach preferujących narzędzia ORC | Dopasowanie zależy od wsparcia silnika i standardów zespołu |
Delta | Warstwa tabeli nad Parquet | Obciążenia lakehouse wymagające semantyki tabeli i zarządzania danymi | Dokłada pojęcia operacyjne wykraczające poza sam format pliku |
Subtelne pytanie, które bywa pomijane
Wiele zespołów pyta, czym jest plik Parquet, wdraża go i na tym poprzestaje. Lepsze pytanie następcze brzmi: czy to obciążenie wciąż powinno używać Parquet domyślnie?
To pytanie liczy się dziś bardziej, bo format wciąż się rozwija. Dokumentacja projektu Parquet z 2026 roku pokazuje aktywne zmiany, w tym wsparcie dla Variant w wersji zapoznawczej i proponowany logiczny typ File dla ładunków nieustrukturyzowanych, co sygnalizuje wyjście poza klasyczne tabele analityczne. Te możliwości nie są jednak jeszcze szeroko dojrzałe w ekosystemie, więc dopasowanie do obciążenia liczy się bardziej niż domyślne rozwiązania dla wszystkich, jak zauważa dokumentacja wersji formatu Parquet.
Ma to praktyczne skutki w 2025 i 2026 roku. Zespoły coraz częściej wybierają format według wzorca dostępu:
skany analityczne po stabilnych danych tabelarycznych
wierszowy transport zdarzeń
operacje lakehouse zarządzane tabelarycznie
obciążenia półustrukturyzowane lub mocno korzystające z dostępu swobodnego
Dla zespołów platformowych na stosach lakehouse w stylu Databricks wybór formatu zazębia się też z decyzjami o nadzorze i niezawodności, takimi jak zarządzanie jakością danych dla środowisk Databricks.
Prosta reguła decyzyjna
Używaj Parquet, gdy dominującym wzorcem są odczyty analityczne po dużych zbiorach, a twoje narzędzia dobrze go wspierają. Zachowaj ostrożność, gdy obciążenie skłania się ku częstym aktualizacjom wierszy, mocno ewoluującym ładunkom półustrukturyzowanym albo wzorcom dostępu, którym bardziej zależy na odczycie swobodnym niż na szerokich skanach.
Parquet często jest mocnym domyślnym wyborem. Po prostu nie jest już jedynym rozsądnym.
Jak w praktyce badać i tworzyć pliki Parquet
Teoria pomaga, ale większość inżynierów prędzej czy później chce odpowiedzieć na trzy konkretne pytania:
Jaki schemat jest w tym pliku?
Ile ma grup wierszy?
Jakich wyborów kompresji lub kodowania użyto?
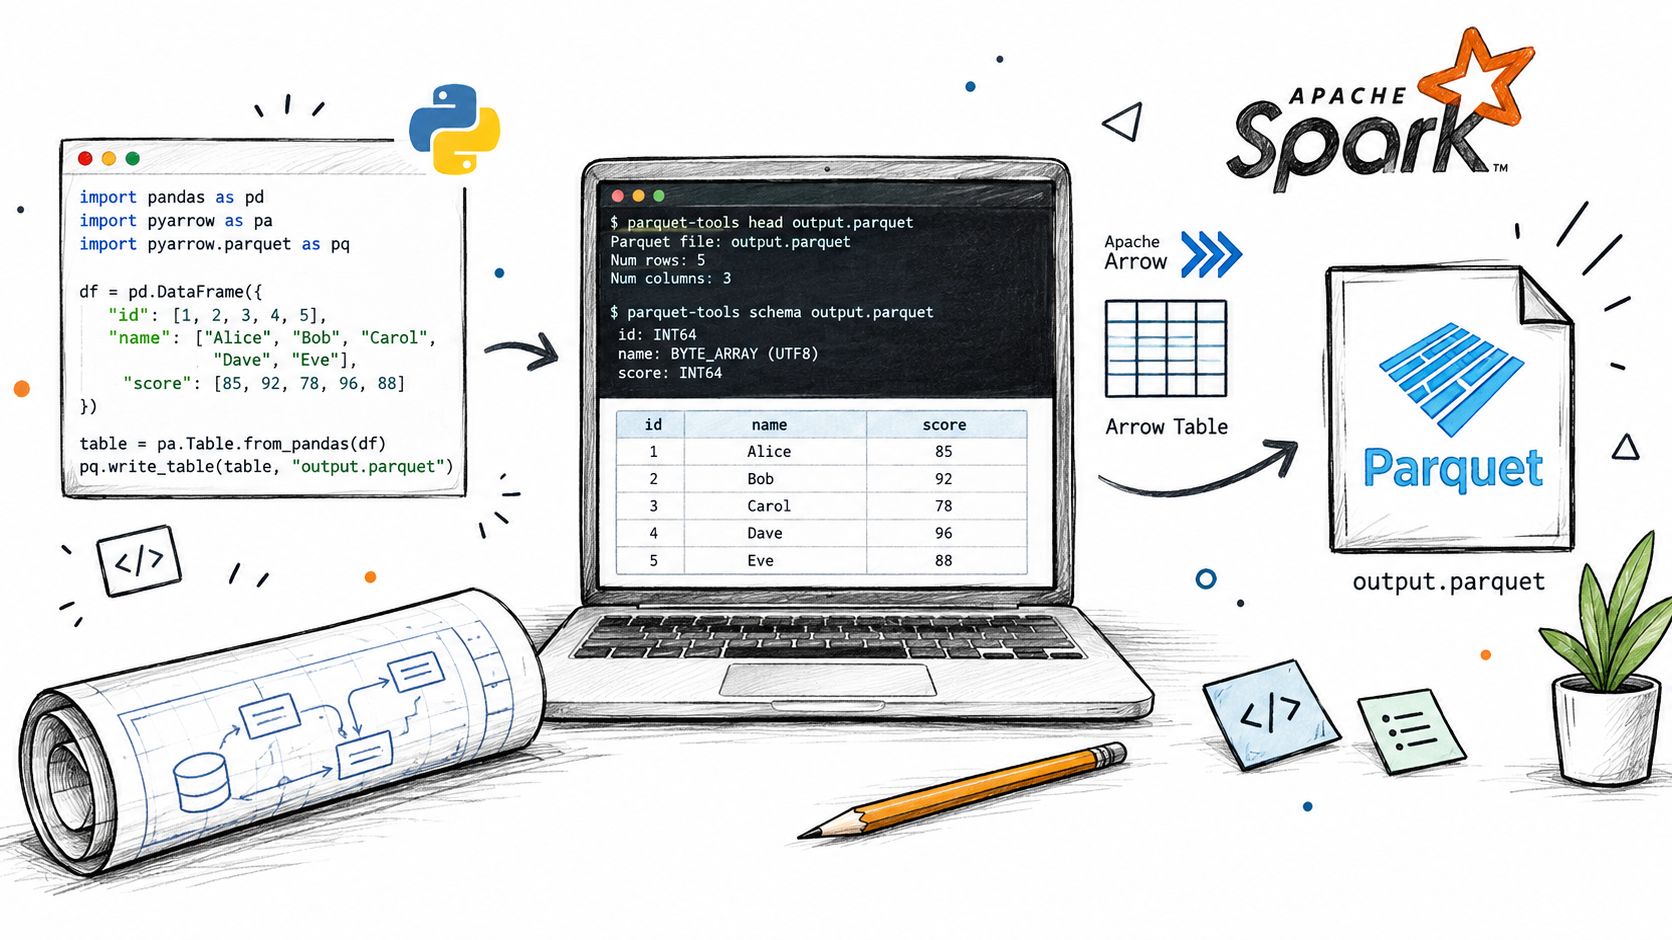
Badanie pliku
Lekki nawyk to obejrzeć Parquet, zanim zaczniesz debugować zachowanie zapytań niżej w łańcuchu.
Przy użyciu parquet-tools inżynierowie zwykle patrzą na schemat i metadane:
Przy użyciu PyArrow w Pythonie:
Przy użyciu Sparka:
Czego szukasz?
Kształtu schematu: czy nazwy i typy kolumn są takie, jakich oczekujesz?
Liczby grup wierszy: zbyt duża może wskazywać na nadmierne rozdrobnienie.
Szczegółów kompresji: przydatne, gdy zużycie pamięci i czas działania się nie składają.
Dopuszczalności wartości pustych i zmian pól: często pierwsza wskazówka przy awariach niżej w łańcuchu.
Zapis Parquet z Pythona i Sparka
Tworzenie Parquet jest zwykle proste. Szczegóły eksploatacyjne liczą się bardziej niż składnia.
Przy użyciu pandas i PyArrow:
Przy użyciu Sparka:
Te linijki to łatwa część. Ważniejsze pytania brzmią:
Czy zapisujesz sensowne rozmiary plików?
Czy partycje są zgodne z rzeczywistymi filtrami?
Czy wszyscy zapisujący produkują ten sam schemat?
Czy zadania dopisujące wprowadzają dryf?
Narzędzia to tylko połowa roboty
Zbiór danych może zawierać poprawne pliki Parquet i mimo to zachowywać się źle jako tabela. Dlatego zespoły często łączą przegląd plików z monitorowaniem zmian schematu, świeżości i zachowania danych. Do tej kategorii należą wbudowane w silnik narzędzia do metadanych, narzędzia katalogowe oraz platformy takie jak digna, która monitoruje zachowanie danych, waliduje rekordy, śledzi terminowość i wykrywa zmiany schematu wewnątrz środowiska klienta.
Jeśli plan zapytania wygląda rozsądnie, a wydajność wciąż skacze, obejrzyj pliki i metadane zbioru danych, zanim obwinisz silnik.
W praktyce najlepsza pętla diagnostyczna jest krótka: obejrzyj plik, obejrzyj układ tabeli, obejrzyj plan zapytania, a potem obejrzyj ewolucję schematu między partycjami lub partiami dopisań.
Dobre praktyki partycjonowania, ewolucji schematu i szybkości
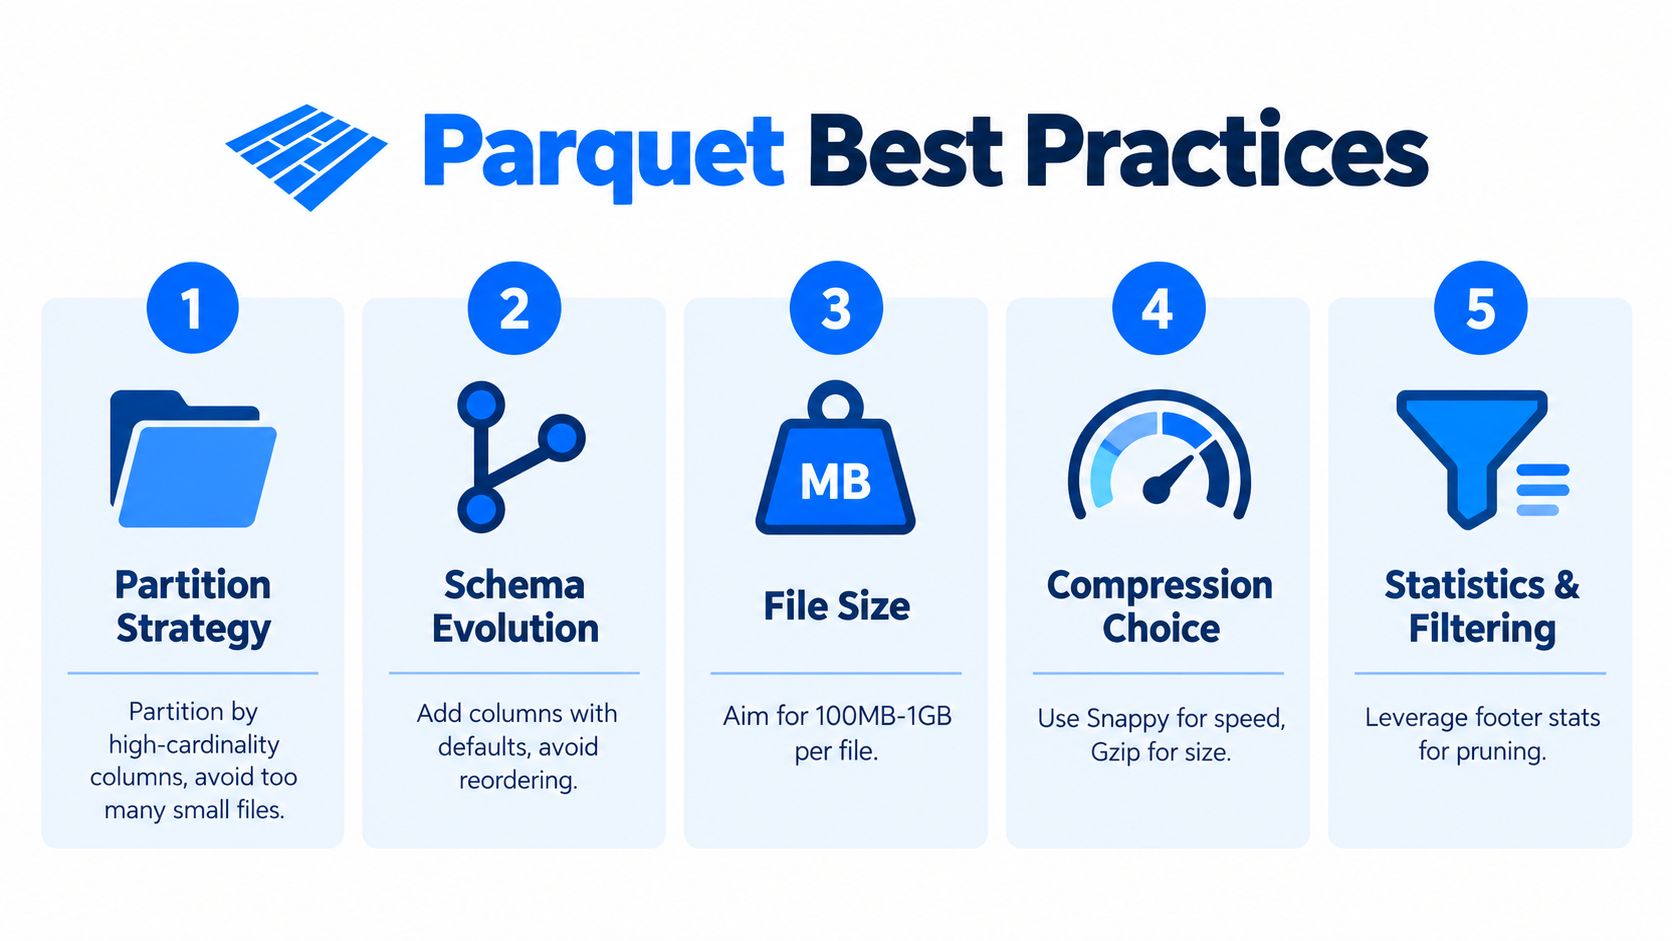
Większość problemów z „wydajnością Parquet” nie bierze się z samego Parquet. Bierze się z tego, jak zespoły zapisują, dopisują, partycjonują i rozwijają zbiory danych w czasie.
Traktuj układ jako część modelu danych
Specyfikacja Parquet zaleca duże grupy wierszy od 512 MB do 1 GB, co pomaga wyważyć efektywność skanowania i przetwarzanie równoległe dla dużych zbiorów analitycznych, zgodnie ze wskazówkami konfiguracyjnymi Parquet.
To zalecenie zaskakuje, bo wiele realnych zbiorów kończy rozdrobnionych na znacznie mniejsze kawałki. Małe pliki i maleńkie grupy wierszy tworzą narzut planowania, obsługi metadanych i szeregowania zadań.
Pomaga kilka praktycznych nawyków:
Partycjonuj z umiarem: partycjonuj po polach, po których ludzie filtrują. Zbyt wiele partycji tworzy rozlewisko plików i ból metadanych.
Celuj w zdrowe rozmiary plików: dość duże do wydajnych skanów, nie tak rozdrobnione, by dominowało planowanie.
Trzymaj spójnych zapisujących: pomieszane ustawienia zapisu między zadaniami często dają nierówną wydajność.
To w ewolucji schematu kryją się koszty
Często pomijany aspekt dyskusji o tym, czym jest plik Parquet, to fakt, że trudną częścią zwykle nie jest format pliku. Jest nią wydajny odczyt zbiorów o mieszanych schematach.
Apache Spark zauważa, że Parquet wspiera ewolucję schematu, ale scalanie schematów między plikami cząstkowymi jest stosunkowo kosztowne i domyślnie wyłączone, o ile nie zostanie wyraźnie włączone. To znaczy, że wiele realnych problemów z Parquet to problemy zarządzania metadanymi w jeziorach danych, zwłaszcza przy zbiorach ciągle dopisywanych, gdzie cichy dryf schematu może przy odczycie wywołać kosztowne skany całej tabeli, jak opisuje dokumentacja projektu Parquet.
Format pliku może być w porządku. Zbiór danych wciąż może być trudny do wydajnego odczytu, jeśli każda partia zapisuje nieco inny kształt.
Dlatego liczy się nadzór nad schematem. Zespoły potrzebują jasnego modelu dozwolonych zmian, wykrywania dryfu i wglądu we wpływ na odbiorców. Praktycznym punktem wyjścia jest wspólne rozumienie typów schematów i wzorców zmian, zanim potoki zaczną ewoluować niezależnie.
Jak wygląda dobra eksploatacja
Najzdrowsze zbiory Parquet mają zwykle kilka wspólnych cech:
Dyscyplina dopisywania: nowe dane lądują w przewidywalnej strukturze.
Przegląd schematu: dodane kolumny są zamierzone, a nie przypadkowe.
Świadomość metadanych: inżynierowie badają grupy wierszy, partycje i zachowanie skanów.
Kontrole Timeliness: spóźnione lub częściowe ładowania nie psują założeń niżej w łańcuchu.
Jeśli z tego artykułu zapamiętasz jedno, niech to będzie: Parquet jest mocny, bo pozwala silnikom unikać zbędnej pracy. Ale gdy twoje pliki są zbyt małe, partycje zbyt gęste, a schematy zbyt niespójne, silnik szybko traci tę przewagę.
Jeśli wydajność Parquet w twoim jeziorze wciąż zamienia się w problem dryfu schematu albo braku wglądu w metadane, digna pomoże monitorować zmiany strukturalne, terminowość, jakość na poziomie rekordów i szersze zachowanie danych bez wynoszenia danych poza twoje środowisko. Łatwiej wtedy wychwycić problemy operacyjne wokół zbiorów Parquet, zanim zamienią się w zepsute pulpity albo kosztowne skany. Więcej na digna.
Poprawny plik to jeszcze nie wiarygodny zbiór danych — obserwowalność danych pilnuje sygnałów o schemacie, świeżości i wolumenie, na które same metadane Parquet nie zareagują.
Najczęściej zadawane pytania
Czym jest plik Parquet?
Otwartoźródłowym kolumnowym formatem pliku, który trzyma razem wartości tego samego typu i używa metadanych stopki, by silniki zapytań czytały tylko potrzebne kolumny i pomijały nieistotne dane. Zaczął jako wspólne przedsięwzięcie Twittera i Cloudery, ukazał się po raz pierwszy w lipcu 2013 roku, a później stał się projektem najwyższego poziomu Apache.
Czym przechowywanie kolumnowe różni się od wierszowego?
Przechowywanie wierszowe trzyma razem wszystkie pola rekordu; kolumnowe grupuje wartości każdego pola w poprzek rekordów. Ponieważ wartości tego samego typu leżą obok siebie, kodują się i kompresują znacznie lepiej, a zapytanie dotykające trzech kolumn nigdy nie musi czytać reszty.
Dlaczego stopka tak bardzo się liczy?
Trzyma schemat i mapę tego, gdzie leżą grupy wierszy i fragmenty kolumn, więc czytelnik sięga do niej, zanim zdecyduje, co otworzyć. To czyni planowanie tanim przy skanach analitycznych — i sprawia, że uszkodzona stopka kosztuje nieproporcjonalnie dużo, bo strony danych mogą być nienaruszone, a mimo to nieosiągalne.
Czy mniejszy plik Parquet zawsze jest szybszy?
Nie. Mniejszy nie zawsze znaczy szybszy: agresywny kodek ścina bajty na dysku, ale dokłada CPU przy każdym odczycie, co może podnieść opóźnienie pulpitu zamiast je obniżyć. Wybierz najpierw kodowanie pod wzorzec wartości w kolumnie, a potem kodek pod kompromis między pamięcią a CPU.
Kiedy wybrać Parquet zamiast CSV, Avro, ORC czy Delty?
Zacznij od obciążenia, a nie od przywiązania do formatu. Parquet pasuje do powtarzanych skanów analitycznych po podzbiorze kolumn; Avro do zapisów wierszowych i wymiany zdarzeń; CSV pozostaje użyteczny do podglądu i prostych przekazań; Delta dokłada gwarancje transakcyjne, których sam Parquet nie daje.



