Co to jest zarządzanie jakością danych i dlaczego jest ważne
|
8
min. czyt.

Znasz już to uczucie. Pulpit nawigacyjny wygląda spokojnie, kierownictwo korzysta z niego na spotkaniach i nikt nie zgłasza skarg. Nagle niezauważona zmiana schematu u dostawcy przedostaje się przez pipeline płatności, dane o przychodach zaczynają dryfować, a błąd utrzymuje się na tyle długo, by wpłynąć na decyzje, zanim ktokolwiek go zauważy. To jest moment, w którym zarządzanie jakością danych przestaje być ćwiczeniem teoretycznym, a staje się systemem kontroli.
Zarządzanie jakością danych to ciągła praktyka upewniania się, że dane są odpowiednie dla ludzi i systemów, które z nich korzystają. W środowisku produkcyjnym oznacza to mierzenie, monitorowanie i naprawianie danych w miarę ich przemieszczania się przez potoki danych, modele, raporty i procesy operacyjne. Stary model oczyszczania danych od czasu do czasu nigdy nie sprawdził się w rzeczywistych przedsiębiorstwach, zwłaszcza gdy dane zaczęły zasilać analitykę, automatyzację i raportowanie regulowane.
Spis treści
Kiedy zaufane dane stają się obciążeniem
Dlaczego stary model zawodzi
Sześć wymiarów jakości danych
Co wykrywa każdy wymiar
Jak w praktyce działa zarządzanie jakością danych
Planuj, wykonuj, sprawdzaj, działaj w środowisku produkcyjnym
Od reguł statycznych do ciągłej Observability
Co zmienia się w praktyce
Wybór odpowiedniej architektury i narzędzi
Wybory architektoniczne i kompromisy
Priorytetyzacja tego, co najważniejsze
Jak ukierunkować program
Budowanie własnego programu jakości danych
Praktyczna ścieżka wdrożenia
Kiedy zaufane dane stają się obciążeniem
Dyrektor finansowy ufa pulpitowi nawigacyjnemu przychodów. Dział finansowy korzysta z niego od miesięcy, liczby zgadzają się przez większość dni, a raport trafia na cotygodniowy przegląd operacyjny bez żadnych kontrowersji. Następnie drobna zmiana schematu u dostawcy trafia do pipeline'u płatności, zadanie transformacji nadal się uruchamia, nie pojawia się żaden alert, a pulpit nawigacyjny pokazuje błędne dane przez trzy tygodnie, dopóki skarga klienta nie zmusi kogoś do bliższego przyjrzenia się sprawie.
Tego typu awaria jest dokładnie powodem, dla którego zarządzanie jakością danych istnieje jako dyscyplina, a nie zadanie porządkowe. Historyczny kontekst ma tutaj znaczenie. MIT uruchomił program Total Data Quality Management w 1988 roku, co pomogło ustanowić oparte na cyklu życia podejście do mierzenia, ulepszania i ciągłego monitorowania jakości danych. Fundamentalne badania podsumowane przez Harvard Business Review wykazały również, że tylko 3% danych firm spełniało podstawowe standardy jakości w oparciu o 195 pomiarów obejmujących kompletność, dokładność, spójność i terminowość (Timeliness), a także że 47% nowo utworzonych rekordów zawierało co najmniej jeden krytyczny błąd (Integrate.io).
Te liczby wyjaśniają przejście od oczyszczania danych do governance. Problem nie polega na tym, że zespoły nie wiedzą o istnieniu złych danych, ale na tym, że złe dane często ukrywają się, dopóki nie trafią dalej do odbiorców końcowych. Nowoczesne zarządzanie jakością danych musi działać z prędkością procesów przetwarzania danych (pipeline), ponieważ nieaktualny rekord, uszkodzone złączenie (join) lub zmiana schematu mogą sprawić, że zaufany pulpit nawigacyjny zacznie kłamać, nie uruchamiając przy tym tradycyjnego audytu wsadowego.
Dlaczego stary model zawodzi
Okresowe audyty sprawdzają się tylko wtedy, gdy firma może pozwolić sobie na opóźnienia. Obecnie rzadko tak jest. Uszkodzone źródło danych może skazić modele, warstwy raportowania i mechanizmy kontrolne na długo przed tym, jak wykryje to comiesięczny przegląd.
Praktyczna zasada: jeśli zestaw danych może wpływać na pieniądze, ryzyko lub opiekę nad pacjentem, kontrole jakości powinny odbywać się w potoku danych (pipeline), a nie w arkuszu kalkulacyjnym po fakcie.
Praktyczna granica między „czystymi danymi” a zarządzaną jakością danych jest prosta. Oczyszczanie ma charakter reaktywny, następuje po zauważeniu problemu. Zarządzanie jest ciągłe, mierzone i powiązane z wyraźnymi wymaganiami odbiorców. To właśnie różnica między naprawieniem problemu a zapobieganiem ukrytym awariom.
Sześć wymiarów jakości danych
Wiele zespołów mówi o jakości danych tak, jakby była to jedna rzecz. Tak nie jest. Zbiór danych może być akceptowalny dla jednego scenariusza użycia i bezużyteczny dla innego, dlatego ta dyscyplina opiera się na wielu wymiarach, a nie na jednej ocenie. Wskazówki techniczne zgodne z materiałami ISO i NPL traktują dokładność, kompletność, spójność, terminowość (Timeliness), identyfikowalność, dostępność i zgodność (Compliance) jako odrębne wymiary, które powinny być mierzone niezależnie, ponieważ ten sam zestaw danych może być odpowiedni dla jednego procesu pracy i nieakceptowalny dla innego (NPL guidance).
W codziennej pracy inżynieryjnej sześć wymiarów, które wdraża większość zespołów, przedstawiono poniżej.
Co wykrywa każdy wymiar
Dokładność dotyczy tego, czy dane odzwierciedlają rzeczywistość. Jeśli złączenie (join) duplikuje wiersze, obliczenie wartości życiowej klienta (LTV) może wyglądać wiarygodnie, będąc jednocześnie błędnym. Mierz to za pomocą kontroli integralności referencyjnej, uzgadniania danych i mechanizmów kontrolnych porównujących wartości oczekiwane z obserwowanymi.
Kompletność dotyczy brakujących informacji. Wartości null w polu segmentacji mogą wykluczyć ludzi z kampanii lub sprawić, że model nie uwzględni części populacji. Podstawowymi narzędziami są tutaj kontrole wskaźnika wartości null i walidacja pól wymaganych.
Timeliness (terminowość) określa, czy dane docierają wtedy, gdy są potrzebne w stosunku do opisywanego zdarzenia. Model wykrywania oszustw działający na nieaktualnych cechach (features) może podjąć błędną decyzję z dużym poziomem pewności. Freshness SLA, wykrywanie opóźnionego dostarczenia i progi oparte na wieku danych to praktyczne mechanizmy kontrolne.
Spójność oznacza, że ten sam obiekt nie zaprzecza sobie w różnych systemach. Jeśli system CRM i system bilingowy nie zgadzają się co do adresu klienta, procesy robocze będą ze sobą sprzeczne. Wykrywają to uzgodnienia między źródłami i reguły standaryzacji.
Poprawność (validity) sprawdza, czy wartości pasują do oczekiwanej domeny, formatu lub zestawu reguł. Po migracji źródła pole statusu może zacząć przyjmować wartości spoza zatwierdzonego typu wyliczeniowego (enum). Odpowiadają za to kontrole domenowe i walidacja formatu.
Unikalność dotyczy duplikowania rekordów. W opiece zdrowotnej zduplikowane rekordy pacjentów fragmentaryzują historię medyczną i utrudniają koordynację opieki. Typową obroną są logika deduplikacji, kontrole unikalnych kluczy i dopasowywanie tożsamości.
Wymiary jakości danych w skrócie | Jak są mierzone | Najbardziej wrażliwe scenariusze użycia |
|---|---|---|
Dokładność | Uzgadnianie danych, integralność referencyjna, sumy kontrolne | Finanse, bilingi, raportowanie dla zarządu |
Kompletność | Wskaźniki wartości null, kontrole pól wymaganych | Segmentacja, raportowanie regulacyjne, kliniczne procesy robocze |
Timeliness | Freshness SLA, progi wieku docierających danych | Oszustwa, operacje, analityka w czasie rzeczywistym |
Spójność | Porównanie między różnymi źródłami, reguły standaryzacji | Dane podstawowe (master data), operacje na klientach, raportowanie |
Poprawność | Kontrole typów wyliczeniowych (enum), kontrole zakresów, kontrole formatów | Systemy operacyjne, Compliance, automatyzacja |
Unikalność | Wykrywanie duplikatów, dopasowywanie tożsamości | Opieka zdrowotna, CRM, uzgadnianie tożsamości |
Jeśli chcesz głębszego podziału modelu wymiarów, warto porównać praktyczne podejście opisane w artykule o wymiarach jakości danych digna z własnym projektem kontroli.
Błąd, który widzę najczęściej, to zespoły tworzące jeden zagregowany wynik i nazywające to governance. To ukrywa kluczowe tryby awarii.
Właściwe pytanie nie brzmi: „Czy dane są dobre?”. Właściwe pytanie brzmi: „Dobre do czego i jak mierzone?”.
Jak w praktyce działa zarządzanie jakością danych
Zarządzanie jakością danych działa jako cykl życia, a nie jako bramka kontrolna. Norma ISO 8000-61:2016 ujmuje to jako pętlę Plan-Do-Check-Act (Zaplanuj-Wykonaj-Sprawdź-Działaj): zaplanuj strategię, wdróż procesy, monitoruj i mierz wydajność pod kątem wymagań, a następnie podejmij działania korygujące, aby stale się doskonalić (ISO 8000-61:2016). Ta struktura ma znaczenie, ponieważ zamienia jakość w stały rytm operacyjny, a nie jednorazowy projekt.
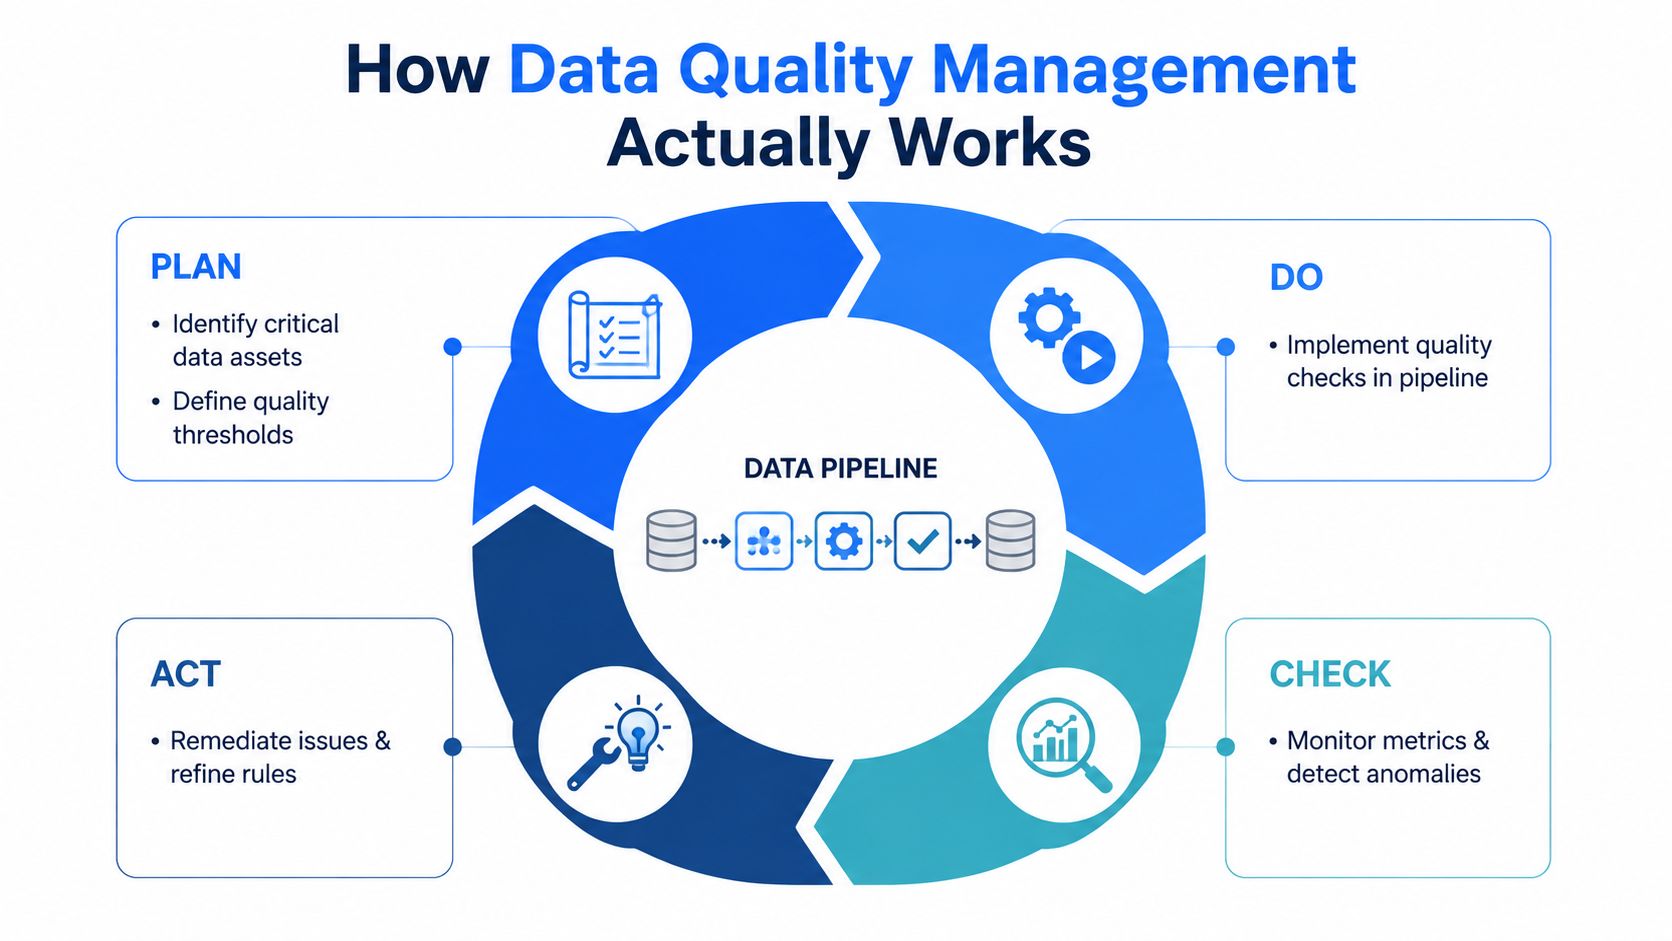
Planuj, wykonuj, sprawdzaj, działaj w środowisku produkcyjnym
Etap Plan (Zaplanuj) rozpoczyna się od zidentyfikowania krytycznych zasobów, zdefiniowania progów wraz z interesariuszami biznesowymi i przypisania odpowiedzialności. Norma ISO 8000-150:2022 koncentruje się na rolach i odpowiedzialnościach, co jest elementem, który wiele zespołów pomija, dopóki incydent nie udowodni, że nie mogą sobie na to pozwolić (ISO 8000-150:2022). Ktoś musi być właścicielem reguły, wyjątku i korekty.
Etap Do (Wykonaj) to miejsce, w którym odbywa się walidacja. W dobrze zarządzanych potokach danych (pipelines) oznacza to kontrakty schematów, kontrole zakresów, kontrole domenowe, kontrole wartości null i testy transformacji osadzone bezpośrednio w zadaniach, a nie dodawane później. Praktyczna implementacja może również opierać się na najlepszych praktykach inżynierii danych, w których orkiestracja, wersjonowanie i testowalność są wbudowane w proces pracy od samego początku.
Etap Check (Sprawdź) to ciągłe monitorowanie. Zarówno wytyczne ISO, jak i prace wdrożeniowe wspierają pomiary okresowe lub ciągłe, co jest krytyczne, ponieważ wiele błędów objawia się jako dryf, opóźnienie lub zmiana struktury, zanim staną się oczywistymi awariami (ISO 8000-61:2016, badanie wdrożeniowe MDPI). Alerty powinny klasyfikować stopień ważności, a nie tylko alarmować.
Etap Act (Działaj) to korygowanie. Błędne rekordy mogą być poddawane kwarantannie, naprawiane, gdy to możliwe, lub kierowane do ręcznego przeglądu, ale kluczem jest to, że każdy wyjątek potrzebuje udokumentowanej ścieżki i pętli zwrotnej do zestawu reguł. W ten sposób stewardzi danych, inżynierowie i analitycy współpracują ze sobą w harmonii, zamiast spierać się po fakcie.
Zasada operacyjna: nie buduj programu jakości, który tylko blokuje potoki danych. Zbuduj taki, który mówi zespołowi, co się nie udało, jak poważny jest to problem i co należy zrobić dalej.
Wybór platformy ma znaczenie, ale model operacyjny jest ważniejszy. Dobry system kontroli wcześnie wykrywa problem, ogranicza zasięg szkód i pozostawia ślad audytowy.
Od reguł statycznych do ciągłej Observability
Tradycyjne wsadowe kontrole jakości wykrywają błędy zbyt późno. Zanim codzienne asercje SQL zakończą się niepowodzeniem, odbiorcy końcowi mogą już podjąć decyzje, wytrenować modele lub opublikować pulpity nawigacyjne oparte na złych danych. Ostatnie publikacje z tej dziedziny wskazują na przejście w kierunku ciągłej walidacji, kontroli wspomaganych przez AI oraz governance dbającego o prywatność, ponieważ statyczne oczyszczanie nie pasuje do potoków danych działających na żywo, modeli i metryk biznesowych (DZone coverage).
To przesunięcie jest widoczne w narzędziach używanych przez zespoły. Zamiast ręcznego wpisywania każdego progu, nowoczesne warstwy observability automatycznie uczą się punktów odniesienia (baselines), obserwują anomalie i śledzą zmiany schematów. Monitorują również terminowość, dzięki czemu opóźnione dane ujawniają się jako problemy operacyjne, a nie niespodzianki biznesowe.
What changes in practice
Praktyczny stos technologii observability zazwyczaj obejmuje trzy obszary. Po pierwsze, wykrywanie anomalii wyszukuje statystyczne odchylenia od zachowania bazowego. Po drugie, śledzenie schematu wykrywa dodane kolumny, usunięte kolumny i zmiany typów, zanim wpłyną one na odbiorców. Po trzecie, monitorowanie terminowości (Timeliness) sygnalizuje opóźnione lub brakujące dostarczenia danych, dzięki czemu problem jest traktowany jako incydent, a nie zagadka.
Nie chodzi tylko o szybkość. Chodzi o kontekst. Kolumna może być technicznie obecna, ale semantycznie błędna, a tabela może przejść ogólną kontrolę poprawności, będąc jednocześnie zbyt nieaktualną, by jej zaufać. Warstwa observability daje sygnał, którego stary model audytu nigdy nie był w stanie dostarczyć, zwłaszcza gdy dane zaczynają zasilać agentów AI i zautomatyzowane decyzje.
Jeśli dopasowujesz to do swojego stosu produktowego, opis architektury dotyczący podejścia digna do Data Observability jest użytecznym punktem odniesienia pokazującym, jak ciągłe kontrole wpisują się w szersze monitorowanie.
Ciągła Observability nie zastępuje reguł, ale pozwala im przetrwać przy tempie pracy środowiska produkcyjnego.
Korzyść z wcześniejszego wykrywania jest widoczna natychmiast. Zamiast dowiadywać się o wadliwym załadowaniu danych po skargach ze strony biznesu, zespół widzi problem niemal w momencie jego pojawienia się i może zareagować, gdy zasięg szkód jest jeszcze mały.

Wybór odpowiedniej architektury i narzędzi
Niewłaściwie dobrany stos do zarządzania jakością danych zazwyczaj zawodzi na jeden z dwóch sposobów. Kontrole znajdują się zbyt daleko od danych i powodują opóźnienia lub też działają tak blisko systemów produkcyjnych, że obciążają operacje. Wykonywanie operacji bezpośrednio w bazie danych (in-database execution) utrzymuje walidację blisko hurtowni danych lub jeziora danych (lakehouse), co ogranicza przesyłanie danych i pasuje do środowisk wrażliwych na bezpieczeństwo, ale może zwiększyć zużycie zasobów obliczeniowych. Chmurowe platformy observability centralizują monitorowanie i zarządzane wykrywanie, ale mogą budzić obawy dotyczące lokalizacji i prywatności danych, jeśli niewłaściwe dane opuszczą bezpieczną strefę.
Wybory architektoniczne i kompromisy
Kompromisy w architekturze jakości danych | Najlepsze dla | Kluczowe kompromisy | Kwestie prywatności |
|---|---|---|---|
Wykonywanie w bazie danych | Hurtownie danych, jeziora danych (lakehouse), regulowane potoki danych (pipelines) | Mniejszy transfer danych, ściślejsza integracja, możliwy wzrost kosztów obliczeniowych | Doskonałe dopasowanie, gdy dane muszą pozostać w systemach kontrolowanych przez klienta |
Chmurowa observability | Zespoły potrzebujące zarządzanego monitorowania i współdzielonych pulpitów nawigacyjnych | Szybka konfiguracja, scentralizowany widok, możliwe obawy dotyczące lokalizacji danych | Wymaga dokładnego przeglądu pod kątem danych osobowych (PII), jurysdykcji i dostępu dostawców |
Dedykowane frameworki | Wysoce wyspecjalizowane wymagania dotyczące kontroli | Maksymalna elastyczność, wyższe koszty utrzymania inżynieryjnego | Mogą być zaprojektowane pod kątem ścisłej izolacji, ale ciężar utrzymania spoczywa wewnątrz firmy |
Stosy hybrydowe | Środowiska o mieszanym poziomie dojrzałości | Równowaga między szybkością a kontrolą, więcej pracy integracyjnej | Użyteczne, gdy wrażliwe kontrole pozostają lokalne, podczas gdy metadane są centralizowane |
Właściwa architektura zależy od przepisów, skali i dojrzałości operacyjnej. Zespoły z sektora finansowego, opieki zdrowotnej, telekomunikacji i sektora publicznego zazwyczaj potrzebują ściślejszej kontroli nad tym, gdzie uruchamiana jest walidacja, kto może widzieć wyniki i jak dokumentowane są wyjątki. Dla zespołów, które chcą mieć tę kontrolę we własnym środowisku, omówienie kompromisów w architekturze systemów danych pomaga określić, gdzie powinny być wykonywane walidacja, wykrywanie anomalii, monitorowanie terminowości (Timeliness) i śledzenie schematów.
Wybór platformy należy oceniać jako warstwę kontroli, a nie tylko zakup narzędzia. Jeśli zespół nadal musi eksportować dane w celu ich zbadania, traci się część korzyści. Jeśli platforma nie integruje się z orkiestracją, metadanymi i procesami obsługi incydentów, staje się kolejnym pulpitem nawigacyjnym, któremu ludzie przestają ufać. Praktyczny test jest prosty – czy kontrole wpisują się w procesy przetwarzania danych (pipeline) bez wymuszania dodatkowych przekazań, dodatkowych kopii lub dodatkowych ręcznych przeglądów.
Priorytetyzacja tego, co najważniejsze
Próba monitorowania każdej tabeli w ten sam sposób to najczęstsza przyczyna niepowodzeń programów jakości. Pojawia się zmęczenie alertami, inżynierowie wyciszają powiadomienia, a zespół przestaje wierzyć systemowi w kluczowych momentach. Lepszym schematem jest ustalanie priorytetów według krytyczności biznesowej, ponieważ tabela zasilająca raporty dla zarządu, dane wejściowe do modeli lub zgłoszenia regulacyjne zasługuje na inne standardy niż mało istotny zestaw danych na etapie przejściowym (staging).
Wyniki badań wskazują na powiązany problem: zespoły często wiedzą, że jakość ma znaczenie, ale nie zawsze wiedzą, jak dobrze testować dane. To sprawia, że priorytetyzacja jest jeszcze ważniejsza, ponieważ wymusza decyzje o tym, które kontrole są istotne, gdzie powinny znajdować się progi i jaki poziom fałszywych alarmów (false positives) jest akceptowalny (badanie porównawcze Synq).
Jak ukierunkować program
Zacznij od zmapowania powiązań danych (lineage), aby poznać obszar wpływu każdego zasobu. Jedno uszkodzone źródło może wpłynąć na pulpit nawigacyjny, prognozę i raport zgodności (Compliance), ale pilność naprawy nie będzie identyczna we wszystkich trzech przypadkach. Chodzi o to, aby sklasyfikować zestaw danych pod kątem jego wpływu na dalsze procesy, zanim zdecydujesz, co monitorować.
Wewnętrzne podejście planistyczne do krytycznych elementów danych stanowi przydatny punkt wyjścia dla tego typu selekcji.
Dane o przychodach i ryzyku: Wdróż kontrole w czasie rzeczywistym lub zbliżonym do rzeczywistego w polach, które wpływają na przepływ pieniędzy, ekspozycję na ryzyko lub dowody regulacyjne.
Dane wejściowe modeli: Monitoruj przede wszystkim świeżość danych, zmiany schematu i brakujące wartości, ponieważ nieaktualne lub błędnie sformatowane dane wejściowe szybko niszczą zaufanie do modeli.
Operacyjne zestawy danych: Stosuj progi odzwierciedlające tolerancję biznesową, a nie teoretyczną czystość.
Tabele analityczne o niskim wpływie: Zaakceptuj lżejszy monitoring, jeśli koszt ewentualnej awarii dla odbiorców końcowych jest niski.
Jeśli wszystko jest krytyczne, nic nie jest.
To jest praktyczny argument za zwrotem z inwestycji (ROI). Skupiony program kieruje uwagę inżynierów tam, gdzie koszt awarii jest najwyższy, pozostawiając mniej ważne tabele pod lżejszym nadzorem, bez udawania, że jest to słabością. Governance staje się silniejszy, ponieważ przestaje dążyć do uniwersalności na siłę.
Budowanie własnego programu jakości danych
Program, który ma przetrwać w środowisku produkcyjnym, potrzebuje etapów. Pierwszy etap to inwentaryzacja zasobów i bazowe umowy SLA. Drugi to automatyczna walidacja na granicach pozyskiwania (ingestion) i transformacji danych. Trzeci to wykrywanie anomalii, monitorowanie świeżości danych i uzgadnianie danych między źródłami. Czwarty to reagowanie na incydenty, eskalacja i ciągłe doskonalenie.
Przewodnik wdrożeniowy dotyczący zespołu ds. jakości danych digna pasuje do tego etapowego podejścia, ponieważ model zespołu ma tak samo duże znaczenie jak same reguły. Bez jasnej odpowiedzialności błędy pozostają bez reakcji i powracają pod nowymi nazwami.
Praktyczna ścieżka wdrożenia
Zacznij od zasobów niosących największe ryzyko biznesowe. Zdefiniuj, co oznacza „dobra jakość” wspólnie z biznesem, a nie tylko z zespołem inżynieryjnym, i zapisz te progi. Jeśli interesariusze nie mogą uzgodnić umowy SLA, program nie ma problemu z jakością, ma problem z wymaganiami.
Następnie dodaj punkty kontrolne w miejscach, w których dane wchodzą do systemu lub zmieniają strukturę. Kontrole schematów, progi wartości null i testy integralności referencyjnej stanowią pierwszą warstwę, ponieważ wychwytują najczęstsze awarie potoków danych (pipelines) bez powodowania niestabilności całego systemu. W dalszej kolejności wprowadź wykrywanie anomalii i kontrole terminowości (Timeliness), aby program mógł wychwytywać dryf, a nie tylko oczywiste naruszenia reguł.
Warstwa obsługi incydentów powinna być wręcz nudna – i jest to komplement. Alerty wymagają kierowania do odpowiednich osób, właściciele potrzebują instrukcji postępowania (runbooks), a naruszenia – ścieżek eskalacji. Celem nie jest tworzenie kolejnych zgłoszeń, lecz skrócenie czasu między wykryciem a naprawą.
Sukces powinien być widoczny w operacjach, a nie w hasłach reklamowych. Śledź średni czas do wykrycia (mean time to detection), średni czas do rozwiązania (mean time to resolution), udział krytycznych zasobów pod aktywnym monitoringiem oraz spadek liczby incydentów po stronie odbiorców danych. Te sygnały mówią, czy program rzeczywiście poprawia kontrolę, czy tylko generuje szum.
Sponsorzy projektu z poziomu kadry zarządzającej słuchają, gdy łączysz jakość z mniejszą liczbą cykli poprawek, szybszym trenowaniem modeli i mniejszą liczbą uchybień w audytach zgodności (Compliance). Przestają słuchać, gdy rozmowa pozostaje na poziomie abstrakcji.
Dobry program sprawia, że jakość staje się mierzalna, przypisana do konkretnych osób i powtarzalna. To właśnie różnica między funkcją platformy a dojrzałą dyscypliną w skali przedsiębiorstwa.
Jeśli wdrażasz lub wymieniasz program jakości danych, digna może pomóc Ci monitorować krytyczne zestawy danych w Twoim własnym środowisku za pomocą walidacji, wykrywania anomalii, kontroli terminowości (Timeliness) i śledzenia schematów w jednej warstwie operacyjnej. Odwiedź witrynę digna, aby zobaczyć, jak ciągłe kontrole mogą dopasować się do Twoich potoków danych (pipelines), Twojego modelu governance i systemów biznesowych, które zależą od zaufanych danych.
Najczęściej zadawane pytania
Czym jest zarządzanie jakością danych?
To ciągła praktyka dbania o to, by dane nadawały się dla ludzi i systemów, które je konsumują. Liczy się słowo ciągła, bo dyscyplina powstała właśnie dlatego, że okresowe sprawdzanie przestało wystarczać.
Skąd wzięła się ta dyscyplina?
MIT uruchomił w 1988 r. program Total Data Quality Management, który pomógł ustanowić podejście oparte na cyklu życia do mierzenia, poprawiania i ciągłego monitorowania jakości danych. To właśnie ujęcie cyklu życia odróżnia ją od zwykłego porządkowania.
Dlaczego model okresowych audytów się załamuje?
Bo działa tylko dopóty, dopóki biznes toleruje opóźnienie. Gdy decyzje zapadają w sposób ciągły na danych zmieniających się w sposób ciągły, audyt comiesięczny opisuje stan, który biznes już minął.
Gdzie powinny znajdować się kontrole jakości?
W potoku, a nie w późniejszym przeglądzie arkusza, ilekroć zbiór danych może wpływać na pieniądze, ryzyko albo opiekę nad pacjentem. Ten próg jest użytecznym filtrem, bo oddziela zbiory wymagające kontroli od tych, które wymagają jedynie uwagi.
Co czyni zaufane dane obciążeniem?
Zaufanie bez weryfikacji. Dyrektor finansowy ufający pulpitowi przychodów zadziała na jego podstawie szybciej, niż ktokolwiek zdąży go sprawdzić, przez co cicha usterka staje się decyzją, zanim proces jakości w ogóle zdąży się wykonać.



