Architektura Data Observability wyjaśniona w prosty sposób
|
8
min. czyt.

Pulpit nawigacyjny może świecić się na zielono, podczas gdy stojąca za nim decyzja jest już błędna. Potok zakończył działanie, hurtownia danych jest dostępna, a każde zaplanowane zadanie raportuje sukces, mimo to system źródłowy dostarczył opóźnione dane, zespół pracujący wcześniej w łańcuchu zmienił typ kolumny lub częściowe ładowanie usunęło rekordy. Zespół ds. finansów widzi wczorajsze przychody, zespół ds. operacyjnych przeacza rozwijający się problem, a funkcja AI konsumuje dane wejściowe, które nie odpowiadają już założeniom przyjętym podczas szkolenia.
Zespoły często zaczynają od dodawania kolejnych alertów. To podejście pomaga do momentu, gdy alert uruchamia się bez przypisanego właściciela, kontekstu lub jasnego obrazu wpływu na kolejne etapy procesu. Głębszy problem ma charakter architektoniczny: gdzie są uruchamiane obliczenia Observability, gdzie żyją metadane i jak system łączy sygnał techniczny z ludźmi i procesami biznesowymi, na które ma on wpływ?
Architektura Data Observability odpowiada na te pytania. Rozszerza tradycyjne monitorowanie infrastruktury o ciągłą widoczność w potokach danych, hurtowniach, jeziorach danych, pulpitach nawigacyjnych i danych wejściowych uczenia maszynowego. Kategoria komercyjna rozwija się błyskawicznie. Według jednego z szacunków branżowych na rok 2026 rynek Data Observability jest wyceniany na 3,51 miliarda USD, a prognozy przewidują 6,03 miliarda USD do 2031 roku, przy średnim rocznym tempie wzrostu (CAGR) na poziomie 11,42% w latach 2026-2031 (szacunek rynkowy Mordor Intelligence). Inny raport z 2026 roku wycenia rynek na 3,4 miliarda USD w 2026 roku, w porównaniu z 2,94 miliarda USD w 2025 roku (raport rynkowy Spherical Insights).
Praktyczna lekcja jest prosta. Niezawodna architektura powinna nie tylko informować o zmianie tabeli. Powinna pokazywać, co się zmieniło, czy zmiana jest oczekiwana, które zasoby na dalszych etapach od niej zależą oraz czy sygnał wpływa na raportowanie, operacje, governance czy AI. Zespoły, które chcą w ustrukturyzowany sposób pomyśleć o niezawodności, mogą również skorzystać z tego przewodnika, aby zmierzyć niezawodność danych.
Spis treści
Wprowadzenie: Dlaczego architektura Data Observability ma teraz znaczenie
Gdzie powinno być uruchamiane Observability i jak je wdrożyć
Od sygnałów technicznych do wpływu na biznes — rzeczywiste przykłady
Twoja mapa drogowa wdrożenia architektury Data Observability
Wprowadzenie: Dlaczego architektura Data Observability ma teraz znaczenie
Typowy incydent zaczyna się subtelnie. Zadanie pozyskiwania danych odbiera mniej rekordów niż zwykle, ale kończy się pomyślnie. Transformacja nadal działa, ponieważ schemat jest technicznie poprawny. Pulpit nawigacyjny odświeża się zgodnie z harmonogramem, więc jego wskaźnik stanu pozostaje zielony. Nikt niczego nie zauważa, dopóki lider nie zapyta, dlaczego wskaźnik biznesowy zmienił się w nieoczekiwany sposób.
Tradycyjne monitorowanie dobrze radzi sobie z odpowiadaniem na pytania operacyjne, np. czy serwer jest dostępny, czy zadanie się zakończyło lub czy proces zwrócił błąd. Systemy danych potrzebują więcej kontekstu. Dane zmieniają swój kształt, wolumen, dystrybucję, czas i znaczenie podczas przemieszczania się między etapami pozyskiwania, transformacji, przechowywania i konsumpcji. Potok może być sprawny operacyjnie, produkując jednocześnie dane niekompletne, nieświeże lub strukturalnie niezgodne z ich przeznaczeniem na dalszych etapach.
Martwy punkt ma zazwyczaj charakter architektoniczny
Nowoczesna architektura Data Observability powstała, ponieważ podstawowe metryki infrastruktury i monitorowanie wydajności aplikacji nie potrafiły wyjaśnić tych awarii. W miarę jak potoki stawały się bardziej rozproszone, zespoły dodawały kontrole jakości danych, pochodzenia (lineage), anomalii i zachowania w czasie rzeczywistym. Ta dyscyplina funkcjonuje obecnie jako warstwa architektoniczna służąca do zapewniania niezawodności i governance, a nie jedynie jako pulpit reakcji na incydenty.
To rozróżnienie ma znaczenie dla kilku grup:
Inżynierowie danych muszą znaleźć źródło awarii bez konieczności przeszukiwania niepowiązanych ze sobą narzędzi.
Inżynierowie analiz i programiści BI potrzebują pewności, że transformacje i pulpity nawigacyjne odzwierciedlają aktualne, strukturalnie poprawne dane wejściowe.
Liderzy governance potrzebują dowodów na to, że mechanizmy kontrolne są stosowane w sposób ciągły w hurtowniach, jeziorach danych i potokach.
Zespoły AI potrzebują możliwości śledzenia drogi od rekordów źródłowych przez cechy, dane treningowe aż po dane wejściowe modeli.
Architektura decyduje o tym, czy te grupy współdzielą jeden kontekst, czy też składają go ręcznie podczas incydentu. Centralna warstwa metadanych może łączyć własność, pochodzenie, historyczne zachowanie i użycie. Rozproszone wykonywanie może utrzymywać kontrole blisko systemów przechowujących dane. Alertowanie może wówczas przesyłać istotne zdarzenie, zamiast wysyłać wyizolowaną metrykę na ogólny kanał operacyjny.
Co umożliwia dobra architektura
Dobrze zaprojektowany system wykrywa zarówno znane, jak i nieoczekiwane rodzaje awarii. Deterministyczne kontrole mogą wymuszać jawne reguły, podczas gdy metody statystyczne mogą identyfikować nietypowe zachowania bez konieczności przewidywania każdego możliwego problemu. Rezultatem nie są z definicji idealne dane. To system informacji zwrotnej, który daje zespołom wcześniejsze dowody, szybszą diagnozę i wyraźniejszą podstawę do ustalania priorytetów naprawczych.
Architektura wpływa również na governance, przenośność i kontrolę kosztów. Przeniesienie danych do zewnętrznej usługi może uprościć niektóre analizy, ale może też wprowadzić dodatkowe problemy z dostępem, przemieszczaniem i infrastrukturą. Wykonywanie kontroli w ramach istniejącej hurtowni lub środowiska jeziora danych pozwala zachować lokalność danych, choć wymaga to starannego planowania uprawnień, obciążeń roboczych i obsługiwanych silników. Te kompromisy zasługują na taką samą uwagę jak lista monitorowanych metryk.
What Data Observability Architecture Really Means
Użyteczną analogią jest deska rozdzielcza samochodu. Tradycyjne monitorowanie może powiedzieć, czy silnik działa i czy pojazd ma zasilanie. Observability zapewnia bogatszy widok: prędkość, poziom paliwa, temperaturę, kontrolki ostrzegawcze i wystarczający kontekst, aby zrozumieć, dlaczego samochód zachowuje się niezgodnie z oczekiwaniami.

Zastosujmy tę analogię do platformy danych. Płaszczyzna danych to miejsce, w którym dane są generowane, przemieszczane, transformowane i przechowywane. Płaszczyzna sterowania definiuje harmonogramy, zasady, progi, przepływy pracy i reakcje. Warstwa metadanych wyjaśnia, czym jest każdy zasób, kto jest jego właścicielem, jak łączy się z innymi zasobami i jak zachowywał się w czasie.
Zdefiniuj pojęcie w trzech krokach
Po pierwsze, zidentyfikuj obserwowany system. Obejmuje on aplikacje źródłowe, zadania pozyskiwania, narzędzia transformacji, hurtownie danych, jeziora danych, pulpity nawigacyjne i dane wejściowe modeli. Observability musi podążać za danymi na całej tej ścieżce, a nie zatrzymywać się na pierwszym pomyślnym zadaniu.
Po drugie, zidentyfikuj sygnały. Metryki opisują mierzalne zachowania, takie jak czas przybycia, wolumen lub dystrybucja. Logi rejestrują zdarzenia i błędy. Sygnały predykcyjne wskazują na odchylenia od oczekiwanych wzorców. Pochodzenie i metadane dodają kontekst, który zamienia ostrzeżenie w ścieżkę badawczą.
Po trzecie, zidentyfikuj pętlę decyzyjną. Platforma gromadzi lub oblicza sygnały, ocenia je pod kątem reguł lub wyuczonych punktów odniesienia, wzbogaca zdarzenia o kontekst i kieruje działania do właścicieli lub przepływów pracy związanych z incydentami. Ta pętla odróżnia Observability od statycznego raportu jakości.
Dlaczego same narzędzia do oceny jakości nie wystarczą
Narzędzie do kontroli jakości danych może weryfikować, czy wartości są zgodne ze znanymi regułami. To cenne, ale nie wyjaśnia automatycznie, czy opóźniona tabela wpływa na raport regulacyjny, który zespół jest właścicielem źródła, ani czy takie samo zachowanie jest normalne dla danego harmonogramu dostaw. Observability łączy walidację z Timeliness, wykrywaniem anomalii, pochodzeniem i kontekstem operacyjnym.
Architektura powinna również pozostać niezależna od potoków, które obserwuje. Praktyczne wskazówki oddzielają platformę Observability od obserwowanego systemu danych, co pozwala platformie monitorować nowe i starsze środowiska bez konieczności przebudowy architektury (akademickie wytyczne architektoniczne). Ta niezależność pozwala zespołom stopniowo zwiększać pokrycie monitorowaniem, zamiast przeprojektowywać najpierw każdą hurtownię, jezioro czy przepływ orkiestracji.
Mówiąc prostym językiem, architektura Data Observability to układ procesów wykonywania, zbierania, metadanych, analiz i działał, który pozwala zespołowi zrozumieć bieżący i oczekiwany stan danych w ich pełnym cyklu życia.
Kluczowe warstwy i komponenty nowoczesnej architektury
Nowoczesna architektura działa najlepiej jako zestaw wyspecjalizowanych warstw. Każda warstwa odpowiada za inne zadanie, ale wszystkie współdzielą wystarczająco dużo metadanych i kontekstu zdarzeń, aby umożliwić diagnozę.

Systemy źródłowe i płaszczyzna danych
W tej płaszczyźnie powstają dane biznesowe i są wykonywane transformacje. Może ona obejmować operacyjne bazy danych, aplikacje SaaS, systemy strumieniowe, pamięć masową w chmurze, hurtownie i jeziora danych. Płaszczyzna danych powinna pozostać odpowiedzialna za zadania związane z przemieszczaniem i przetwarzaniem danych.
Ważnym wyborem projektowym jest to, czy obliczenia Observability są uruchamiane w tym miejscu. Wykonywanie w bazie danych (in-database) może obliczać metryki i przeprowadzać kontrole wewnątrz kompatybilnych źródeł danych, podczas gdy architektura zewnętrzna wyodrębnia informacje do analizy w innym miejscu. Utrzymywanie wykonywania blisko danych może ograniczyć niepotrzebne przemieszczanie danych i zachować istniejące granice bezpieczeństwa, ale zespoły nadal muszą zarządzać uprawnieniami i izolacją obciążeń roboczych.
Gromadzenie i pozyskiwanie
Warstwa gromadzenia zbiera dane telemetryczne i metadane z płaszczyzny danych. Może rejestrować statystyki tabel, zdarzenia w potokach, zmiany schematów, zachowanie zapytań, czasy dostarczenia, wyniki walidacji i aktualizacje pochodzenia. Celem nie jest kopiowanie każdego rekordu do systemu Observability, lecz zbieranie sygnałów i odniesień potrzebnych do zrozumienia zachowania.
Silna warstwa gromadzenia danych obsługuje zarówno modele zaplanowane, jak i sterowane zdarzeniami. Zaplanowane kontrole są przydatne w przypadku znanych okien dostaw. Zdarzenia są przydatne, gdy zmienia się schemat, kończy działanie potok lub źródło generuje odpowiednie przejście stanu.
Zcentralizowana orkiestracja i metadane
Warstwa kontrolna planuje kontrole, stosuje zasady, przechowuje konfigurację i koordynuje alerty. Warstwa metadanych wzbogaca każdy sygnał o własność, definicje, pochodzenie, użycie, środowisko i kontekst historyczny. Razem odpowiadają na pytania, na które surowe metryki nie są w stanie odpowiedzieć.
Warstwa ta powinna również obsługiwać starsze i zróżnicowane środowiska. Platforma, która rozumie tylko jedną hurtownię, pozostawia martwe punkty wokół systemów lokalnych (on-premises), wielu chmur lub starszych narzędzi orkiestracji. Celem architektonicznym jest wspólny model kontekstowy, a nie wymuszona jednolitość w każdym podlegĥym systemie.
Observability i działanie
Najwyższa warstwa prezentuje stan zdrowia, trendy, anomalie, incydenty i wpływ. Powinna pomóc osobie reagującej przejść od sygnału do decyzji:
Wykrywanie: Jakie zachowanie uległo zmianie?
Diagnoza: Jakie wcześniejsze zdarzenie lub transformacja może to wyjaśnić?
Wpływ: Które zbiory danych, pulpity nawigacyjne, modele lub procesy od tego zależą?
Działanie: Kto odpowiada za naprawę i jak należy śledzić zdarzenie?
Taka struktura jest zgodna z szerszymi wytycznymi dotyczącymi architektury systemów danych, w których granice między przetwarzaniem, orkiestracją, metadanymi i konsumpcję muszą pozostać wyraźne.
Reguła architektoniczna: Utrzymuj wykonywanie blisko danych, gdy governance i koszty wymagają lokalności, ale dbaj o odpowiednią centralizację kontekstu, aby osoby reagujące mogły zrozumieć wpływ na całą platformę.
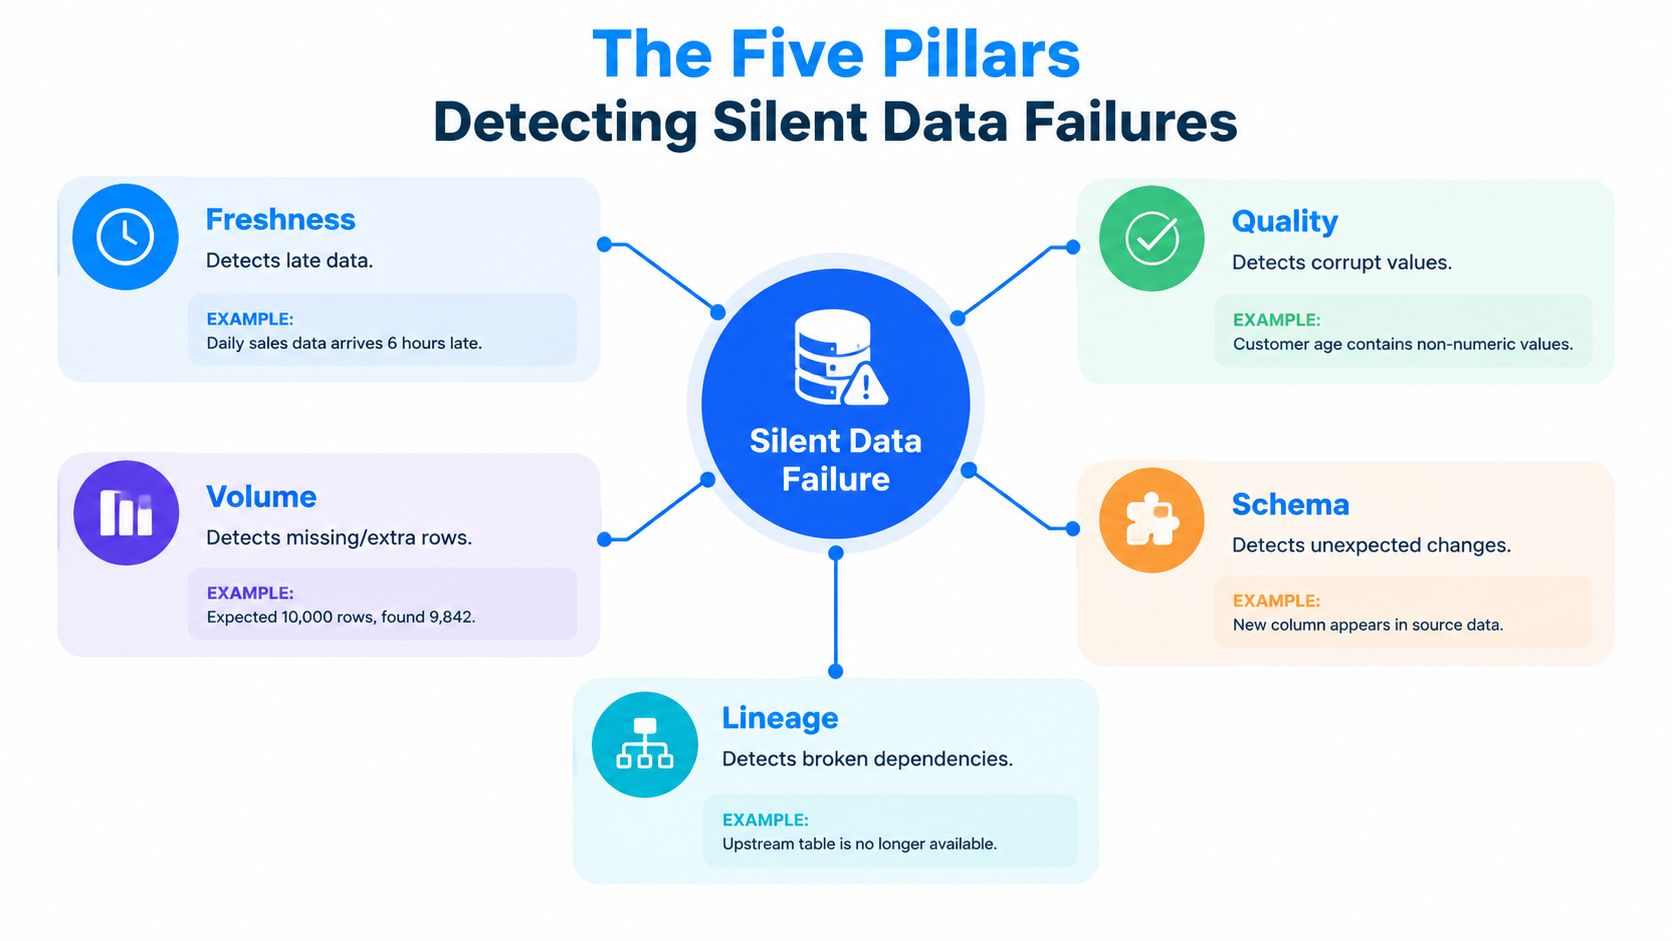
Pięć filarów wykrywających ciche błędy danych
Model pięciu filarów daje zespołom praktyczny punkt wyjścia: Freshness, jakość, wolumen, schemat i pochodzenie (lineage). Każdy filar odpowiada na inny rodzaj awarii. Doświadczone zespoły łączą deterministyczną walidację ze statystycznym wykrywaniem anomalii, ponieważ jawne reguły wychwytują znane naruszenia, podczas gdy analiza behawioralna może ujawnić nieoczekiwane przesunięcia.
Freshness
Filar Freshness odpowiada na pytanie, czy dane są wystarczająco aktualne do ich zamierzonego zastosowania. Nie ogranicza się to do sprawdzania, czy zadanie zostało uruchomione. Zadanie zakończone sukcesem może nadal dostarczyć dane z opóźnieniem, pominąć partycję lub opublikować niekompletny wyciąg danych.
Freshness oznacza Timeliness. Monitoruj napływ i przetwarzanie danych w odniesieniu do zachowań historycznych lub jawnych oczekiwań usługi, a następnie traktuj opóźnienia jako potencjalne awarie źródła lub pozyskiwania.
Użyteczna kontrola porównuje rzeczywisty czas przybycia z oczekiwanym harmonogramem. System powinien również odróżniać opóźnioną dostawę od wczesnej dostawy, gdy to rozróżnienie ma znaczenie. Zbyt wczesny plik może wskazywać na zmianę procesu źródłowego, nawet jeśli dane wydają się dostępne.
Jakość
Kontrole jakości weryfikują rekordy i wartości pod kątem oczekiwań biznesowych lub technicznych. Przyku0lady obejmują wymagane pola, prawidłowe zakresy, relacje referencyjne, dozwolone kategorie oraz spójność między powiązanymi zbiorami danych. Reguły te są szczególnie ważne w przypadku raportowania regulowanego i kluczowych operacyjnych przepływów pracy.
Jakość nie jest pojedynczym wynikiem punktowym. Zespoły powinny zdefiniować, które wymiary mają znaczenie dla każdego przypadku użycia, a następnie powiązać nieudane kontrole z odpowiednim zasobem i właścicielem. Reguła dla tabeli transakcji finansowych może różnić się od reguły dla zbioru danych o charakterze eksploracyjnym. Więcej szczegółów na temat organizowania tych wymiarów znajduje się w przewodniku digna opisującym wymiary jakości danych.
Wolumen
Kontrole wolumenu poszukują brakujących, powielonych lub nieoczekiwanie rozszerzonych danych. Zmiana liczby wierszy może wskazywać na niepełne ładowanie, przestój źródła, problem z łączeniem (join) lub uzasadnione zdarzenie biznesowe. Kontrola staje się bardziej użyteczna, gdy uwzględnia wzorce historyczne i zależności na dalszych etapach, zamiast stosować jeden uniwersalny próg.
Schemat
Monitorowanie schematu śledzi zmiany strukturalne, takie jak dodane lub usunięte kolumny, zmienione nazwy pól i zmienione typy danych. Często stanowi ono wczesne ostrzeżenie, ponieważ zmiany strukturalne mogą uszkodzić transformacje, pulpity nawigacyjne, kontrakty lub cechy modeli, zanim ktokolwiek zauważy widoczny błąd w raportach.
Zespoły powinny klasyfikować zmiany na oczekiwane i nieoczekiwane. Kontrolowana migracja może celowo dodawać kolumnę, podczas gdy zewnętrzne API może zmienić typ danych bez uprzedzenia. To samo zdarzenie wymaga różnego kierowania w zależności od własność, środowiska i sposobu wykorzystania na dalszych etapach.
Pochodzenie (Lineage)
Pochodzenie (lineage) pokazuje, jak dane przemieszczają się od źródła przez transformację do konsumpcji. Zamienia ono odosobniony alert w mapę wpływu. Jeśli tabela źródłowa ulega zmianie, pochodzenie może ujawnić, które tabele pochodne, raporty, metryki lub dane wejściowe AI zależą od modyfikowanego pola.
Kompleksowe Observability łączy zdarzenia źródłowe z wpływem na dalsze etapy w procesach pozyskiwania, transformacji, przechowywania i konsumpcji (badania nad Observability potoków). Bez śledzenia pochodzenia zespoły mogą szybko wykryć problem, ale nadal spędzać zbyt dużo czasu na decydowaniu, od czego zacząć.
Gdzie powinno być uruchamiane Observability i jak je wdrożyć
Potok może wykryć nieudaną kontrolę jakości, a mimo to stwarzać problemy z governance, kosztami lub przenośnością. Najważniejsza decyzja architektoniczna dotyczy tego, gdzie powinny znajdować się obliczenia, metadane i alerty, a nie tego, które kontrole włączyć. Architektury w bazie danych (in-database) wykonują kompatybilne kontrole wewnątrz hurtowni lub platformy danych. Architektury zewnętrzne wyodrębniają dane lub metryki do oddzielnej usługi w celu ich przetworzenia.
Wykonywanie w bazie danych może uruchamiać zadania wewnątrz systemów takich jak Databricks, SAP HANA lub Snowflake, utrzymując przetwarzanie wewnątrz hurtowni SQL zamiast przenosić dane na zewnątrz do analizy (wskazówki dotyczące pushdown observability). To podejście przypomina inspekcję towarów w fabryce: dane pozostają blisko swojego źródła, podczas gdy platforma przejmuje obciążenie pracą. Wykonywanie zewnętrzne tworzy scentralizowany model operacyjny, ale może wymagać szerszych uprawnień, konektorów i przemieszczania danych. Zespoły budujące swoją praktykę inżynierii platform danych powinny traktować tę decyzję lokalizacyjną jako element projektowania platformy.
Kryterium | Wykonywanie w bazie danych (In-Database) | Wykonywanie zewnętrzne |
|---|---|---|
governance | Kontrole działają w ramach istniejących granic dostępu do danych i zasad. | Odrębna usługa może wymagać uprawnień do wyodrębniania lub inspekcji danych. |
Przepływ danych | Metryki i walidacja mogą być obliczane tam, gdzies znajdują się dane. | Dane lub wyniki profilowania są przenoszone do zewnętrznej warstwy przetwarzania. |
Kontrola kosztów | Wykorzystuje moc obliczeniową hurtowni lub platformy, więc governance obciążeń roboczych ma znaczenie. | Dodaje oddzielne koszty infrastruktury lub usług, jednocześnie zmniejszając część pracy wewnątrz platformy. |
Przenośność | Działa dobrze, gdy obsługiwane silniki i wzorce SQL są spójne. | Może centralizować logikę w różnych systemach, ale może tworzyć zależność od usługi. |
Bezpieczeństwo | Wspiera lokalność danych i minimalizuje ekspozycję rekordów produkcyjnych. | Wymaga starannej kontroli wyodrębniania, przechowywania, szyfrowania i retencji. |
Wydajność | Korzysta z lokalnego dostępu do danych i optymalizacji silnika. | Może wprowadzać narzut związany z transferem, harmonogramowaniem lub serializacją. |
Operacje | Zespoły zarządzają wpływem obciążenia pracą w ramach każdej platformy. | Zespoły zarządzają konektorami, niezawodnością wyodrębniania i zewnętrzną wydajnością. |
Dopasowanie wdrożenia do środowiska
Opcje chmury prywatnej, VPC i instalacji lokalnych (on-premises) mają znaczenie, gdy przepisy dotyczące rezydentności danych, sieci lub zasady dostępu ograniczają wdrożenie. Organizacja podlegająca regulacjom może zainstalować system Observability w ramach własnego konta chmurowego, VPC lub centrum danych, utrzymując dane produkcyjne w zatwierdzonych granicach.
Przenośność zasługuje na taką samą uwagę. Otwarte i interoperacyjne podejścia, w tym wdrażanie OpenTelemetry, observability-as-code i konsolidacja narzędzi, są wskazywane jako priorytety w najnowszych opracowaniach dotyczących trendów w tej dziedzinie (trendy IBM w dziedzinie observability). Dla zespołów danych przenośność oznacza zachowanie metadanych, zasad, pochodzenia i historii operacyjnej przy zmianie platformy. Samo eksportowanie pulpitów nawigacyjnych nie pozwala zachować tego kontekstu operacyjnego.
Przed dokonaniem wyboru zadaj trzy pytania:
Czy platforma może obserwować każde kluczowe środowisko bez wymuszania migracji danych?
Kto płaci za moc obliczeniową zużywaną na profilowanie i wykrywanie anomalii?
Czy zespoły ds. governance mogą kontrolować procesy weryfikacji, uprawnienia, dane wyjściowe i model retencji?
Technicznie poprawny alert to za mało, jeśli architektura zwiększa ryzyko dostępu lub generuje nieprzewidywalne koszty. Wybierz rozwiązanie, które równoważy jakość wykrywania z lokalnością danych, przenośnością i kontrolą operacyjną.
Od sygnałów technicznych do wpływu na biznes — rzeczywiste przykłady
Alert dotyczący Freshness staje się bardziej użyteczny, gdy łączy się z procesem biznesowym. Alert dotyczący schematu staje się pilny, gdy dotyczy pola używanego w raporcie regulacyjnym lub funkcji AI. Sygnał dotyczący obciążenia roboczego platformy staje się operacyjny, gdy wyjaśnia, który zespół, wzorzec zapytania lub produkt danych zużywa zasoby.
To powiązanie wynika z połączenia pochodzenia (lineage), metadanych użycia, własności, definicji biznesowych i sygnałów observability w kontekstowy graf zależności. Graf nie zastępuje kontroli technicznych. Nadaje on każdej kontroli odpowiednie miejsce w modelu operacyjnym.

Usługi finansowe
Zbiór danych transakcyjnych może pomyślnie przejść podstawową kontrolę zakończenia potoku, jednocześnie naruszając regułę biznesową lub docierając po okienku raportowania. Data Quality Management łączy walidację, wykrywanie anomalii, śledzenie terminowości i monitorowanie schematów w celu zidentyfikowania problemu. Pochodzenie (lineage) pokazuje następnie, czy błędne rekordy zasilają obliczenia ryzyka, raportowanie regulacyjne czy uzgodnienia na dalszych etapach.
Priorytet reakcji powinien odzwierciedlać ten wpływ. Odchylenie w nieużywanej tabeli analitycznej nie jest równoważne zmianie strukturalnej w zbiorze danych wykorzystywanym w krytycznym procesie finansowym.
Opieka zdrowotna
Zespoły opieki zdrowotnej często potrzebują wiarygodnych danych klinicznych, operacyjnych i regulacyjnych w systemach o różnej strukturze własności i wzorcach dostarczania. Opóźniony wyciąg może opóźnić widok operacyjny, podczas gdy zmiana typu pola może uszkodzić integrację na dalszym etapie. Freshness, walidacja, śledzenie schematów i pochodzenie dostarczają różnych dowodów w ramach tego samego dochodzenia.
Architektura powinna zatrzymywać wrażliwe dane wewnątrz zatwierdzonych środowisk, jednocześnie udostępniając wystarczająco dużo metadanych, aby uprawnione zespoły mogły zrozumieć stan i odpowiedzialność.
Telekomunikacja i sektor publiczny
Platforma telekomunikacyjna może monitorować dane klientów i dane operacyjne pod kątem nietypowego wolumenu, dostępności lub zachowania dystrybucji. Organizacja sektora publicznego może traktować priorytetowo identyfikowalność, spójność i gotowe do audytu dowody w długotrwałych procesach przetwarzania danych. W obu przypadkach ważnym wyborem projektowym jest powiązanie zdarzeń technicznych ze zobowiązaniami serwisowymi i odpowiedzialnymi właścicielami.
Business Monitoring może również oceniać kluczowe wskaźniki efektywności (KPI) bezpośrednio na podstawie podlegĥych danych. Data Platform Observability dodaje do tego powiązany widok obciążeń roboczych, zużycia, dostępności i zachowania platformy. Observability staje się w coraz większym stopniu elementem zarządzania kosztami i strategii opartych na otwartych standardach, a nie tylko warstwą pulpitów nawigacyjnych.
Gotowość na AI
Zespoły AI potrzebują czegoś więcej niż tylko czystej tabeli w momencie szkolenia. Potrzebują śledzenia pochodzenia (lineage) od danych źródłowych przez transformacje, cechy, dane treningowe, aż po dane wyjściowe modelu. Jeśli zmienia się schemat źródłowy lub opóźnienie Freshness wpływa na potok cech, graf zależności powinien ujawnić, które dane wejściowe modelu mogą być nieświeże lub strukturalnie niezgodne.
Kluczowe pytanie nie brzmi już tylko: „Czy kontrola się powiodła?”. Brzmi ono: „Który wynik biznesowy, proces operacyjny lub dane wejściowe AI zależą od tego sygnału i kto może podjąć działania?”.
Twoja mapa drogowa wdrożenia architektury Data Observability
Zacznij od wąskiego zakresu i wyznaczenia jasnego właściciela. Szerokie wdrożenie bez ustalenia priorytetów generuje szum informacyjny, zanim zespół zdąży zrozumieć, jak reagować.
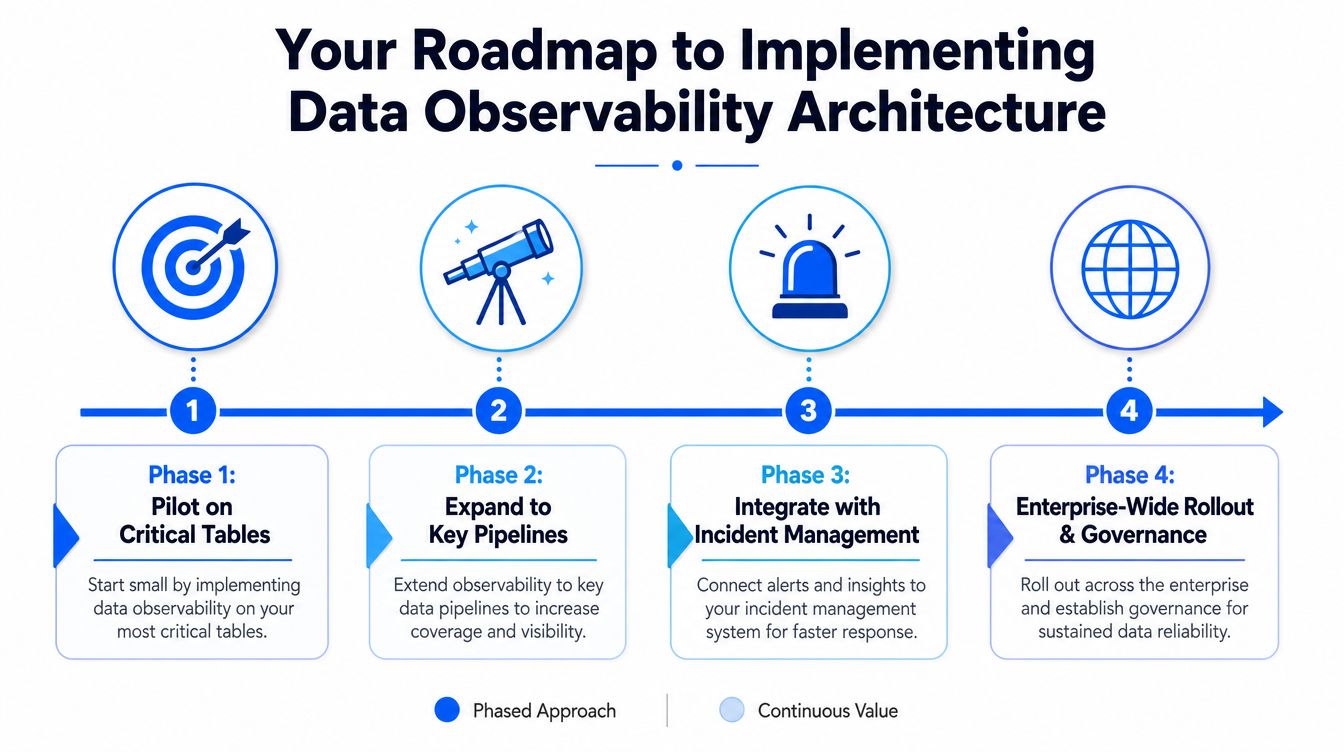
Faza pierwsza — pilotaż kluczowych tabel
Wybierz zbiory danych, które wspierają ważne procesy raportowania, operacji, governance lub AI. Określ oczekiwane zachowania w zakresie dostarczania, podstawowe wzorce wolumenu, wymagania dotyczące schematu oraz niewielki zestaw walidacji biznesowych. Przypisz właściciela do każdego alertu przed włączeniem powiadomień.
Faza druga — rozszerzenie na kluczowe potoki
Dodaj pokrycie na wcześniejszych i późniejszych etapach, aby zespół mógł śledzić awarie, zamiast widzieć tylko wyizolowane symptomy na poziomie tabel. Uwzględnij metadane pochodzenia, użycia i własności, a następnie porównaj wykonywanie w bazie danych (in-database) i zewnętrzne dla objętych zakresem środowisk.
Faza trzecia — powiązanie z zarządzaniem incydentami
Kieruj alerty do zespołów odpowiedzialnych za ich naprawę. Rejestruj zasoby, których dotyczy problem, podejrzewaną przyczynę, wpływ na biznes, status i rozwiązanie. Analizuj powtarzające się incydenty, aby wdrażać poprawki na poziomie architektonicznym zamiast powtarzać ręczne procedury naprawcze.
Faza czwarta — ustanowienie governance na poziomie przedsiębiorstwa
Ustandaryzuj zasady dotyczące Freshness, zmian schematów, walidacji, dostępu, retencji i eskalacji. Rozszerz wdrożenie na hurtownie, jeziora danych, potoki i środowiska lokalne (on-premises), kontrolując jednocześnie przenośność i zużycie mocy obliczeniowej. Modułowe wdrożenie może rozpocząć się od jednej funkcji i rosnąć w modelu opartym na opłacie podstawowej oraz opłacie za aktywną tabelę na moduł, zamiast wymagać uwzględnienia każdego przypadku użycia już na samym początku.
Zorientowany na użytkownika pulpit nawigacyjny powinien służyć inżynierom, analitykom i interesariuszom governance, oferując różne widoki tego samego podlegĥego kontekstu. Zespoły poszukujące praktycznych wskazówek mogą skorzystać z tych ram wdrażania jakości danych, aby zdefiniować własność, mechanizmy kontrolne i priorytety wdrażania.
Najsilniejsza architektura traktuje jakość wykrywania, governance, przenośność i kontrolę kosztów jako jeden spójny problem projektowy. Zacznij od kluczowego produktu danych, zmierz, jak dobrze zespół potrafi wykrywać i wyjaśniać awarie, a następnie rozszerzaj zakres dopiero wtedy, gdy model operacyjny będzie na to gotowy.
digna dostarcza platformę jakości i Observability danych dla przedsiębiorstw, oferującą wykonywanie w bazie danych, wykrywanie anomalii, monitorowanie terminowości, walidację, śledzenie schematów oraz monitorowanie biznesowe i platformy. Odwiedź stronę digna, aby przekonać się, jak architektura utrzymująca dane na miejscu może wspierać wiarygodną analitykę, governance i AI w Twoim środowisku danych.
Najczęściej zadawane pytania
Czym jest architektura data observability?
To układ wykonywania, zbierania, metadanych, analizy i działania, który pozwala zespołowi rozumieć bieżący i oczekiwany stan danych w całym cyklu ich życia. Użyteczna analogia to deska rozdzielcza w samochodzie: nie więcej wskaźników, lecz układ, który prowadzi do właściwego działania.
Dlaczego klasyczny monitoring nie wystarcza?
Bo odpowiada na pytania operacyjne: czy serwer jest dostępny, czy zadanie się zakończyło, czy proces zwrócił błąd. Żadne z nich nie wyjaśnia tabeli, która dotarła na czas, wykonała się poprawnie i mimo to niesie błędne wartości, a to właśnie ta awaria dociera do decyzji.
Gdzie powinny działać obliczenia observability?
To kluczowa decyzja projektowa w warstwie danych. Wykonywanie kontroli tam, gdzie powstają dane biznesowe, trzyma kontekst blisko awarii, unika zbędnego ruchu i najbardziej liczy się tam, gdzie prywatność i obciążenie operacyjne ograniczają to, co może opuścić środowisko.
Kto korzysta na dobrej architekturze observability?
Cztery grupy o różnych potrzebach: inżynierowie danych, którzy lokalizują awarię bez przeszukiwania rozłącznych narzędzi, analytics engineers potrzebujący pewności co do strukturalnie poprawnych wejść, liderzy governance potrzebujący dowodów ciągłego działania kontroli oraz zespoły AI potrzebujące prześledzenia drogi od rekordów źródłowych po wejścia modelu.
Jak duży jest rynek data observability?
Branżowe oszacowanie z 2026 r. wycenia go na 3,51 mld USD i prognozuje 6,03 mld USD do 2031 r., przy CAGR 11,42 % w latach 2026–2031. Wzrost odzwierciedla coraz silniejsze nakładanie się governance, niezawodności i odpowiedzialności operacyjnej, a nie przelotną modę na narzędzia.



