10 alternatyw dla Bigeye w obszarze Data Observability
|
7
min. czyt.

Wybór alternatywy dla Bigeye opartej wyłącznie na wykrywaniu anomalii powiela problem, który kupujący próbują rozwiązać. Większość ugruntowanych platform potrafi zidentyfikować nietypowy wolumen, świeżość, strukturę schematu lub zachowanie dystrybucji. Różnią się one znacznie bardziej pod względem tego, gdzie są uruchamiane kontrole, jak zespoły walidują rekordy, jak pokrywane są pochodzenie danych (lineage) i potoki, jak alerty trafiają do przepływów operacyjnych, jak skaluje się cennik oraz jak dużą kontrolę nad infrastrukturą zachowuje klient.
To rozróżnienie ma znaczenie, ponieważ zespoły zajmujące się Observability wciąż spędzają dużo czasu na reagowaniu po tym, jak użytkownicy napotkają wadliwe dane. Badanie przeprowadzone wśród liderów zarządzania danymi wykazało, że tylko 7% rozwiązuje problemy z danymi, zanim wpłyną one na użytkowników, podczas gdy 39% spędza 20–40% swojego czasu na naprawianiu problemów z potokami (pipelines). Z tego samego badania wynika, że 51% potrzebuje kilku godzin, a 36% kilku dni lub więcej na rozwiązanie pojedynczego incydentu, co sprawia, że zapobieganie, szybkość dochodzenia i dopasowanie wdrożeniowe są ważniejsze niż długa lista funkcji. (Podsumowanie raportu Kensu w CDO Magazine)
Poniższe porównanie ocenia dziesięć alternatyw dla Bigeye pod kątem praktycznych kryteriów korporacyjnych: lokalizacja danych, pokrycie anomalii, walidacja, Timeliness, monitorowanie schematu, wdrożenie, sygnały cenowe i nakład pracy związany z migracją. Odnosi się ono również do modułowych możliwości platformy digna, dzięki czemu zespoły mogą odróżnić szeroki pakiet SaaS do Observability od platformy działającej bezpośrednio w bazie danych (in-database), zaprojektowanej z myślą o chmurze prywatnej, VPC lub środowiskach lokalnych (on-premises).
Spis treści
1. digna
digna to najsilniejszy wybór, gdy kontrola wdrożenia i rezydencja danych idą w parze z pokryciem w zakresie Observability. Działa wewnątrz własnego środowiska klienta, w tym w chmurze prywatnej, VPC lub lokalnym centrum danych (on-premises), i wykonuje obliczenia metryk oraz kontrole bezpośrednio w bazach danych klienta. Ta architektura utrzymuje dane produkcyjne na miejscu, ogranicza niepotrzebny transfer danych i wspiera wymagania dotyczące governance w odniesieniu do wrażliwych danych finansowych, medycznych, telekomunikacyjnych oraz sektora publicznego. Wskazówki dotyczące monitorowania wewnątrz baz danych wspierają ten model, ponieważ kontrole mogą być uruchamiane tam, gdzie dane żyją, zamiast kopiowania wrażliwych rekordów w inne miejsca. (Wskazówki digna dotyczące monitorowania jakości danych)
Platforma łączy automatyczne wykrywanie z deterministycznymi kontrolami. Moduł Data Anomalies uczy się normalnego zachowania i stale identyfikuje nietypowe zmiany, nie wymagając od zespołów ręcznego tworzenia każdej reguły monitorowania. Timeliness uczy się oczekiwanych wzorców dostarczania i flaguje brakujące, opóźnione lub przedwczesne dostawy danych. Data Validation stosuje reguły biznesowe na poziomie pojedynczych rekordów, podczas gdy Schema Tracker wykrywa zmiany strukturalne, takie jak dodane lub usunięte kolumny oraz zmodyfikowane typy danych. Data Analytics dodaje analizę trendów historycznych i zmienności, co pomaga zespołom odróżnić jednorazowe zdarzenie od pogarszającego się wzorca niezawodności.
Gdzie digna sprawdza się najlepiej
Modułowa konstrukcja platformy digna pozwala zespołowi rozpocząć od jednej funkcji i rozszerzać ją w miarę dojrzewania modelu operacyjnego. Harmonogram (scheduler), katalog danych, integracje i funkcje współpracy są dostępne już od pierwszego wybranego modułu, a wspólny pulpit nawigacyjny zapewnia inżynierom danych, analitykom i interesariuszom spójny widok incydentów, trendów i statusów. Dostawca deklaruje, że czas od instalacji do pierwszych wniosków wynosi poniżej dwóch godzin – deklarację tę należy jednak zweryfikować pod kątem uprawnień kupującego, topologii bazy danych oraz audytu bezpieczeństwa.
Cennik opiera się na opłacie podstawowej oraz opłacie za aktywną tabelę i moduł. Model ten nie zawiera opłat za API, wolumen skanowania ani liczbę alertów, co daje działom zakupów wyraźniejszy sygnał dotyczący kosztów użytkowania niż cenniki zmieniające się przy każdym zapytaniu czy powiadomieniu. Kompromisem jest to, że bardzo duża liczba tabel może wymagać starannego oszacowania skali, a wdrożenie prywatne przenosi odpowiedzialność za infrastrukturę, uprawnienia i utrzymanie na klienta.
Praktyczna zasada: Wybierz digna, gdy przechowywanie danych we własnym środowisku jest priorytetowym wymaganiem, a następnie zweryfikuj całkowity koszt pod kątem aktywnych tabel i wybranych modułów przed podpisaniem umowy.
Zobacz platformę Data Observability digna, aby zapoznać się z architekturą i modelem modułowym.
Zalety: Wykonywanie operacji wewnątrz bazy danych, prywatne wdrożenie, oparte na sztucznej inteligencji monitorowanie anomalii i Timeliness, walidacja na poziomie rekordów, śledzenie schematu, wspólne przepływy pracy i licencjonowanie modułowe.
Wady: Cennik oparty na aktywnej tabeli i module wymaga dokładnego oszacowania przy dużych zasobach, a prywatne wdrożenie wymaga wewnętrznego zaangażowania operacyjnego.
2. Monte Carlo Data
Monte Carlo Data to wszechstronny pakiet Observability dla organizacji monitorujących hurtownie danych, jeziora danych (lakes), systemy ETL, zasoby BI oraz potoki AI czy agentowe. Jego zautomatyzowane monitory obejmują świeżość, wolumen, schemat i dystrybucję, podczas gdy wykrywanie anomalii oparte na uczeniu maszynowym identyfikuje odchylenia od oczekiwanego zachowania. Pochodzenie danych na poziomie kolumn i pulpitów nawigacyjnych (lineage) łączy incydenty z powiązanymi zasobami końcowymi, pomagając zespołom ocenić wpływ poza dotkniętą tabelą.
Platforma wspiera również reakcję operacyjną. Klasyfikacja incydentów i kierowanie alertów do narzędzi takich jak Slack, Jira i pokrewnych łączy wykrywanie z odpowiedzialnością i naprawą. To czyni Monte Carlo kandydatem dla dużych, nowoczesnych stosów technologicznych z wieloma konektorami i ugruntowanymi przepływami pracy. Kupujący powinni zweryfikować, czy lineage obejmuje konkretne kolumny, pulpity i etapy potoków używane przez ich zespoły.

Kompromis wobec kontroli wewnątrz bazy danych
Wyróżnikiem Monte Carlo jest szerokość operacyjna. digna przyjmuje inne podejście, uruchamiając kontrole bezpośrednio w bazach danych klientów i łącząc wykrywanie anomalii z modułami Timeliness, walidacji, śledzenia schematu i analizy historycznej poprzez modułowy interfejs. Decyzja zależy więc od modelu operacyjnego: Monte Carlo pasuje do zespołów stawiających na pierwszym miejscu lineage i pokrycie ekosystemu, podczas gdy digna jest odpowiednia dla zespołów wymagających, aby dane pozostały w ich środowisku.
Wdrożenie i migracja wymagają własnego wdrożenia próbnego (Proof of Concept). Zespoły powinny przetestować pokrycie złączy, dokładność lineage, przypisywanie alertów, reguły walidacji oraz nakład pracy potrzebny na przeniesienie istniejących monitorów z Bigeye. Cennik Monte Carlo nie jest publicznie dostępny, więc dział zakupów powinien poprosić o ofertę opartą na monitorowanym zakresie i wymaganiach integracyjnych.
Zalety: Szerokie pokrycie konektorów, pełny lineage od początku do końca, przepływy pracy incydentów i skala dostosowana do przedsiębiorstw.
Wady: Cennik ustalany indywidualnie, a szerokość funkcji może przewyższać natychmiastowe potrzeby mniejszego zespołu.
Zapoznaj się z tą alternatywą dla enterprise data observability od digna, aby porównać jej architekturę i podejście modułowe z szerszym modelem operacyjnym Monte Carlo.
3. Acceldata
Acceldata skierowana jest do heterogenicznych środowisk, w których jakość danych to tylko jeden z elementów niezawodności. Jej zakres obejmuje platformy danych, potoki, zadania, koszty i wydajność, w tym środowiska chmurowe, lokalne (on-premises), hybrydowe, Hadoop i szersze ekosystemy Big Data. To czyni ją szczególnie istotną dla zespołów platformowych modernizujących starszą infrastrukturę bez konieczności migracji każdego obciążenia na nową platformę przed rozpoczęciem wdrażania Observability.
Platforma organizuje operacje wokół modelu: obserwuj, wykrywaj, diagnozuj i działaj. W praktyce kupujący powinni ocenić, jak dobrze ten przepływ pracy łączy sygnały o jakości z wykonaniem potoków, zachowaniem platformy, governance i optymalizacją. Chmura Data Observability od Acceldata dodaje gotowe procesy i dokumentację, podczas gdy jej hybrydowe pozycjonowanie rozwiązuje powszechny problem narzędzi zorientowanych wyłącznie na chmurę.
Szerokie pokrycie a ukierunkowane wdrożenie
Acceldata może świetnie pasować do dużych zasobów z technologiami wielu generacji, ale jej szerokość może wykraczać poza to, czego potrzebuje mały zespół analityczny. Cennik jest ustalany przez dział sprzedaży, dlatego faza Proof of Concept powinna obejmować ocenę nakładu pracy wdrożeniowej, granic odpowiedzialności oraz kosztów aktywacji funkcji, których zespół może nie użyć od razu.
digna podchodzi do tego samego wyzwania korporacyjnego poprzez modułowość i wykonywanie operacji bezpośrednio w bazie danych. Jej moduły Data Anomalies, Timeliness, Data Validation, Schema Tracker i Data Analytics koncentrują się na zachowaniu i niezawodności danych, zachowując jednocześnie obliczenia wewnątrz baz danych klienta. Acceldata jest bardziej naturalnym kandydatem, gdy wydajność platformy, infrastruktura i governance muszą znajdować się w tym samym widoku operacyjnym. digna staje się bardziej przekonująca, gdy głównymi ograniczeniami są kontrolowane wdrożenie i stopniowe wdrażanie modułów.
Użyj narzędzi data observability od digna jako punktu odniesienia przy porównywaniu szerokości platformy z ukierunkowanym monitorowaniem rezydentnym w bazie danych.
Zalety: Obsługa środowisk hybrydowych i lokalnych, szeroka widoczność platformy oraz połączone Observability, governance i optymalizacja.
Wady: Zakres może być zbyt szeroki dla mniejszych zespołów, a cennik wymaga kontaktu z działem sprzedaży.
4. Anomalo
Anomalo to natywna dla AI platforma jakości danych, zbudowana wokół zautomatyzowanego wykrywania problemów przy minimalnym nakładzie pracy na pisanie reguł. Jej nienadzorowane podejście ma na celu identyfikowanie nietypowych zachowań w danych strukturyzowanych, półstrukturyzowanych i nieustrukturyzowanych, a następnie wspieranie badania przyczyn źródłowych. To sprawia, że jest atrakcyjna dla zespołów, które chcą szybko uzyskać pokrycie anomalii bez utrzymywania dużej biblioteki ręcznie tworzonych reguł kontrolnych.
Nacisk na ekosystem jest tu wyraźny. Głębokie integracje z Databricks, Snowflake i partnerami katalogowymi mogą zmniejszyć trudności z konfiguracją, gdy te systemy stanowią już fundament infrastruktury danych. Dostępne są opcje wdrażania korporacyjnego i umowy SLA, jednak kupujący nadal musi odróżnić wykrywanie anomalii od kontroli deterministycznej. Model może zidentyfikować, że zestaw danych zmienił się w nieoczekiwany sposób, podczas gdy kluczowa z punktu widzenia biznesu reguła nadal wymaga jawnego warunku walidacji.
Wykrywanie anomalii to nie cała warstwa kontrolna
digna pokrywa ten sam przypadek użycia niewymagający skomplikowanej konfiguracji za pomocą modułu Data Anomalies, ale dodaje oddzielne moduły dla Data Validation, Timeliness oraz Schema Tracker. Ten podział ma znaczenie dla zespołów, które potrzebują zarówno wyuczonych linii bazowych, jak i audytowalnych reguł biznesowych. Na przykład kontrola dryfu schematu (schema-drift) porównuje przychodzącą strukturę ze schematem bazowym lub docelowym i generuje alert, gdy kolumny lub typy danych ulegną zmianie. (Praktyczne wskazówki dotyczące wykrywania dryfu schematu)
Cennik Anomalo nie jest publiczny i wymaga kontaktu z działem sprzedaży. Opublikowane szczegóły dotyczące wersji samoobsługowych są również bardziej ograniczone niż u niektórych konkurentów SaaS, więc planowanie migracji powinno obejmować ocenę techniczną, przegląd bezpieczeństwa i analizę handlową, a nie tylko polegać na prezentacji produktu.
Zalety: Minimalny nakład pracy na pisanie reguł, szybkie wdrożenie ukierunkowane na anomalie, opcje wdrażania korporacyjnego i silne integracje z hurtowniami danych.
Wady: Cennik nie jest publiczny, a zespoły mogą potrzebować dodatkowych narzędzi do jawnego wymuszania reguł biznesowych oraz spełnienia wymagań dotyczących wdrożenia wewnątrz bazy danych.
5. Soda
Soda łączy ścieżkę open-source z zarządzanym produktem do Observability. Soda Core obsługuje kontrole i kontrakty danych (data contracts) jako kod, w tym definicje oparte na YAML i wbudowane testy, dzięki czemu inżynierowie mogą umieszczać walidację wewnątrz procesów tworzenia potoków i przepływów CI/CD. Soda Cloud dodaje monitorowanie metryk, historyczne analizy bazowe, wykrywanie anomalii, współpracę i przepływy pracy związane z governance.
Ten podwójny model zmienia podejście do migracji. Zespół może zacząć od interfejsu CLI i przepływu open-source, a następnie przejść do funkcji zarządzanych, gdy zajdzie potrzeba scentralizowanego monitorowania i współpracy. Taka ścieżka może zmniejszyć zależność od jednego dostawcy (vendor lock-in), ale zaawansowane Observability i governance wciąż są powiązane z zarządzanym produktem Cloud, a nie z samą warstwą open-source.
Gdzie znaczenie ma własność reguł
Soda pasuje do zespołów, które chcą, aby inżynierowie określali oczekiwania dotyczące jakości danych blisko kodu i orkiestracji. Jest mniej dostosowana do organizacji, które oczekują wyuczonego monitorowania anomalii i dostarczania danych bez konieczności utrzymywania rozbudowanych definicji testów. digna zapewnia obie te możliwości dzięki automatycznym modułom Data Anomalies i Timeliness, a także jawnym modułom Data Validation i Schema Tracker.
Świeżość (freshness) i terminowość (timeliness) powinny być testowane oddzielnie podczas migracji. Świeżość sprawdza, czy rekordy dotarły w oczekiwanym oknie czasowym, natomiast terminowość odpowiada na pytanie, czy dane stały się użyteczne w oknie decyzyjnym. (Wskazówki dotyczące kontroli jakości danych w przedsiębiorstwach) To rozróżnienie może ujawnić luki ukryte pod ogólnym monitorem „świeżości”.
Publiczny cennik Soda Cloud nie jest publikowany, więc kupujący potrzebują indywidualnej oferty opartej na źródłach, kontrolach, użytkownikach i zarządzanym zakresie.
Zalety: Próg wejścia w postaci open-source, kontrole jako kod, osadzanie w potokach i jasna ścieżka przejścia do zarządzanego Observability.
Wady: Zaawansowana współpraca i governance wymagają wersji Soda Cloud, a cennik Cloud jest ustalany przez dział sprzedaży.
Porównaj modele operacyjne w tej alternatywie dla Soda w zakresie jakości danych w przedsiębiorstwach.
6. Metaplane now part of Datadog
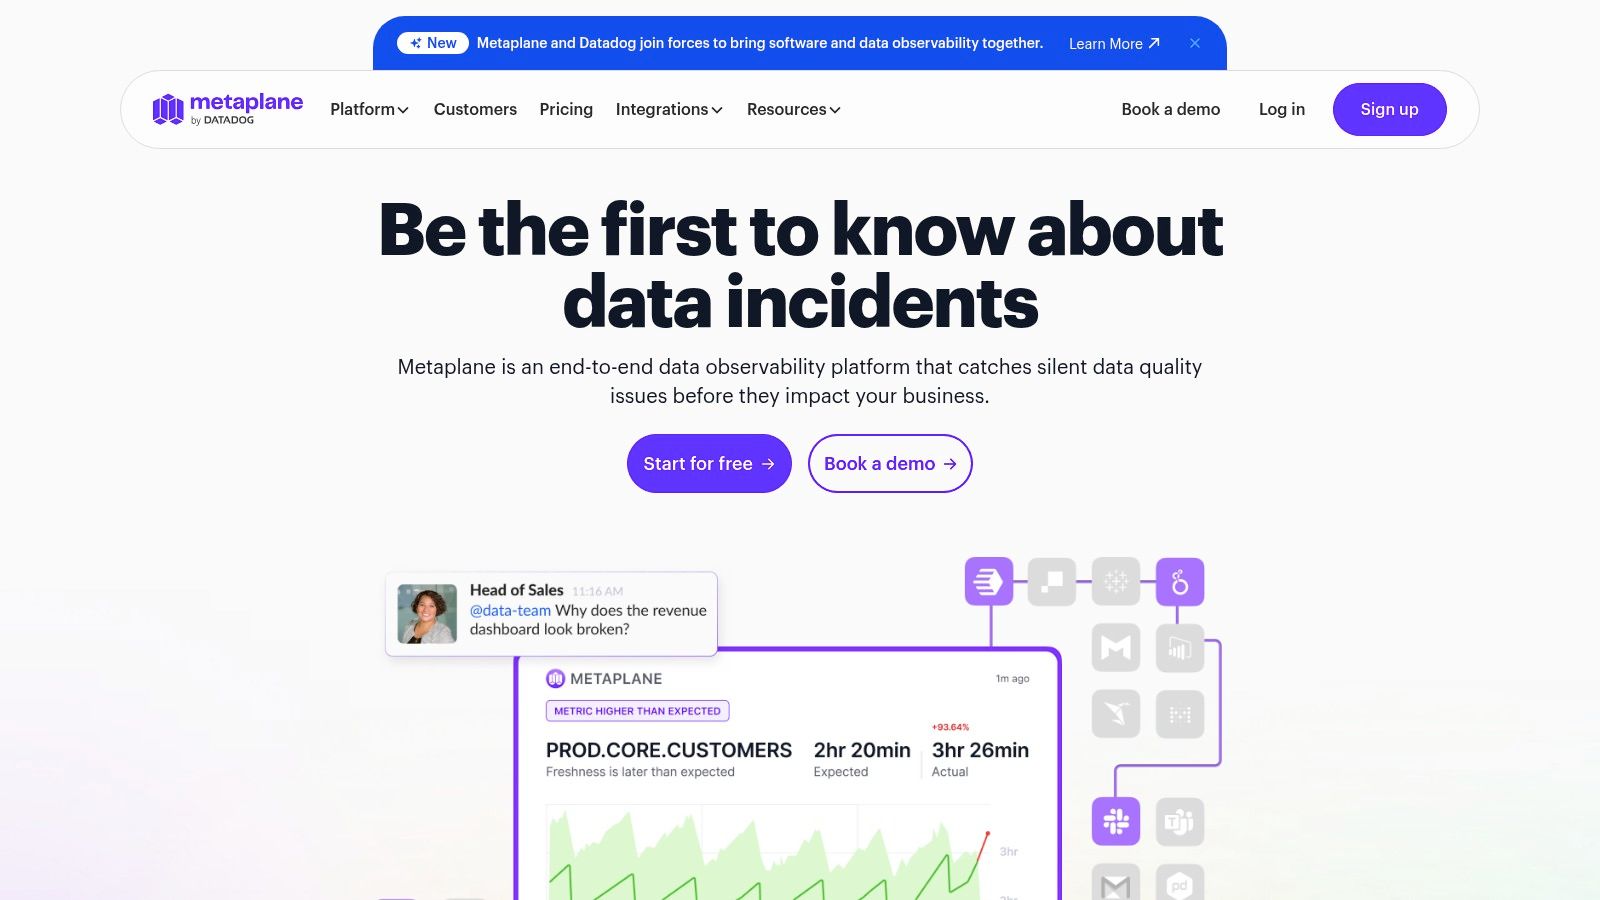
Metaplane koncentruje się na szybkim wdrożeniu SaaS dla nowoczesnych stosów technologicznych. Jego oparte na uczeniu maszynowym wykrywanie anomalii uwzględnia sezonowość i trendy, podczas gdy lineage na poziomie kolumn i analiza wpływu pomagają zespołom zrozumieć konsekwencje dla elementów końcowych. Procesy Data CI/CD wychwytują regresje w żądaniach pull request, a powiadomienia na Slacku lub Microsoft Teams łączą wykrywanie z istniejącą komunikacją inżynieryjną.
Opcja Snowflake Native App stanowi istotną różnicę architektoniczną. Utrzymuje ona dane w hurtowni i umożliwia rozliczenia za pomocą kredytów Snowflake, co może uprościć przegląd bezpieczeństwa i zakupy dla zespołów skoncentrowanych na technologii Snowflake. Nie jest to jednak to samo, co szeroka kontrola w chmurze prywatnej lub środowiskach lokalnych (on-premises). Kupujący posiadający heterogeniczne lub regulowane środowiska powinni sprawdzić, jak głębokość funkcji zmienia się poza ścieżką Snowflake.
Szybki start, węższy obwód korporacyjny
Darmowa ścieżka dostępu Metaplane wspiera eksperymentowanie, a model dostępu tylko do odczytu może ułatwić wstępne rozmowy o bezpieczeństwie. Kompromisem jest jednak szerokość funkcji. Może on nie zastąpić większego pakietu korporacyjnego, gdy zespoły potrzebują szerokiego governance, wielu modeli wdrażania lub głębokiego pokrycia starszych platform.
Punktem porównania z digna nie jest sama szybkość wdrożenia. Oferuje ona wykonywanie operacji wewnątrz bazy danych, wdrożenie w chmurze prywatnej lub on-premises, wspólny pulpit nawigacyjny oraz moduły pokrywające anomalie, terminowość, walidację, zmiany schematu i analizę historyczną. Zespoły powinny porównać czas potrzebny na podłączenie reprezentatywnego źródła, skonfigurowanie uprawnień, zbadanie alertu i przedstawienie dowodów na potrzeby governance.
Użytecznym punktem wyjścia jest to wyjaśnienie, czym zajmuje się platforma Observability, a następnie zweryfikowanie tych szczegółów pod kątem własnej hurtowni danych i stosu orkiestracji.
Zalety: Szybkie wdrożenie, darmowy pakiet startowy, dostęp tylko do odczytu, lineage, kontrole CI/CD oraz opcja wdrożenia natywnego dla Snowflake.
Wady: Pakiet jest węższy niż największe platformy korporacyjne, a możliwości różnią się w zależności od systemów danych.
7. IBM Data Observability by Databand
IBM Data Observability by Databand koncentruje się na niezawodności potoków i zadań. Monitoruje zadania, śledzi umowy SLA i ostrzega zespoły o awariach lub ryzykach dostarczenia danych w narzędziach do orkiestracji i hurtowniach. Wsparcie, proces zakupowy, dokumentacja oraz ramy kontraktowe IBM mogą mieć decydujące znaczenie dla regulowanych przedsiębiorstw, które już teraz standaryzują swoje usługi na rozwiązaniach IBM.
Ta opcja dotyczy w mniejszym stopniu lekkiej samoobsługi, a bardziej dopasowania Observability do ustalonego modelu operacyjnego przedsiębiorstwa. Zespoły powinny spodziewać się procesu zakupowego i wdrożeniowego ukształtowanego przez wewnętrzne standardy, wymagania dotyczące wsparcia i governance integracji. Takie doświadczenie może być odpowiednie dla organizacji, które cenią odpowiedzialność dostawcy i ciągłość umów bardziej niż szybką aktywację wersji próbnej.
Dopasowanie zależy od własności i procesów zakupowych
Cennik opiera się na umowie i w niektórych jednostkach SKU może wykorzystywać licencjonowanie oparte na jednostkach zasobów (resource-unit). To utrudnia bezpośrednie porównanie, chyba że kupujący zdefiniuje monitorowane zadania, środowiska, użytkowników, oczekiwania dotyczące wsparcia i założenia dotyczące odnowień przed poproszeniem o ofertę.
digna oferuje inną drogę. Jej modułowe licencjonowanie zaczyna się od jednego modułu i rozszerza się w zależności od aktywnej tabeli i modułu, podczas gdy architektura działająca bezpośrednio w bazie danych utrzymuje analizy w środowisku klienta. Praktyczne porównanie dotyczy zatem zorientowanego na IBM modelu niezawodności potoków oraz modułowego modelu jakości i Observability danych, który obejmuje moduły Data Anomalies, Data Analytics, Timeliness, Data Validation i Schema Tracker.
IBM jest rozsądnym kandydatem na krótką listę, gdy istniejące kanały wsparcia i zakupów IBM mają duże znaczenie. digna zasługuje na bliższą ocenę, gdy inżynierowie danych i zespoły ds. governance potrzebują jednego wspólnego interfejsu zarówno dla wyuczonych zachowań, jak i jawnych kontroli jakości.
Zalety: Wsparcie IBM, umowy korporacyjne, dokumentacja, spójność z governance oraz monitorowanie SLA potoków.
Wady: Proces może być mniej samoobsługowy, cennik opiera się na kontakcie z działem sprzedaży, z możliwym licencjonowaniem opartym na jednostkach zasobów w niektórych ofertach.
8. Lightup
Lightup łączy kontrole oparte na regułach z wykrywaniem anomalii przez AI, lineage, uzgadnianiem (reconciliation) i zarządzaniem incydentami. Podejście Zero-Config Auto Metrics ma na celu szybkie stworzenie podstawowego pokrycia, podczas gdy rekomendacje AI pomagają zespołom zidentyfikować obszary, w których dodatkowe monitorowanie może być przydatne. Integracje z Collibra, Alation, systemami zgłoszeniowymi i narzędziami alertowymi rozszerzają platformę na przepływy pracy związane z governance i incydentami.
Struktura planów Cloud i Enterprise stawia przed kupującym istotne pytanie o sposób wdrożenia, a nie tylko o funkcje. Wdrożenie w chmurze może zmniejszyć odpowiedzialność operacyjną, podczas gdy opcje korporacyjne lub hybrydowe mogą lepiej pasować do ograniczeń związanych z rezydencją danych i dostępem. Ocena powinna potwierdzić, gdzie odbywają się obliczenia metryk, jakie dane produkcyjne opuszczają środowisko oraz jak zarządzane są uprawnienia.
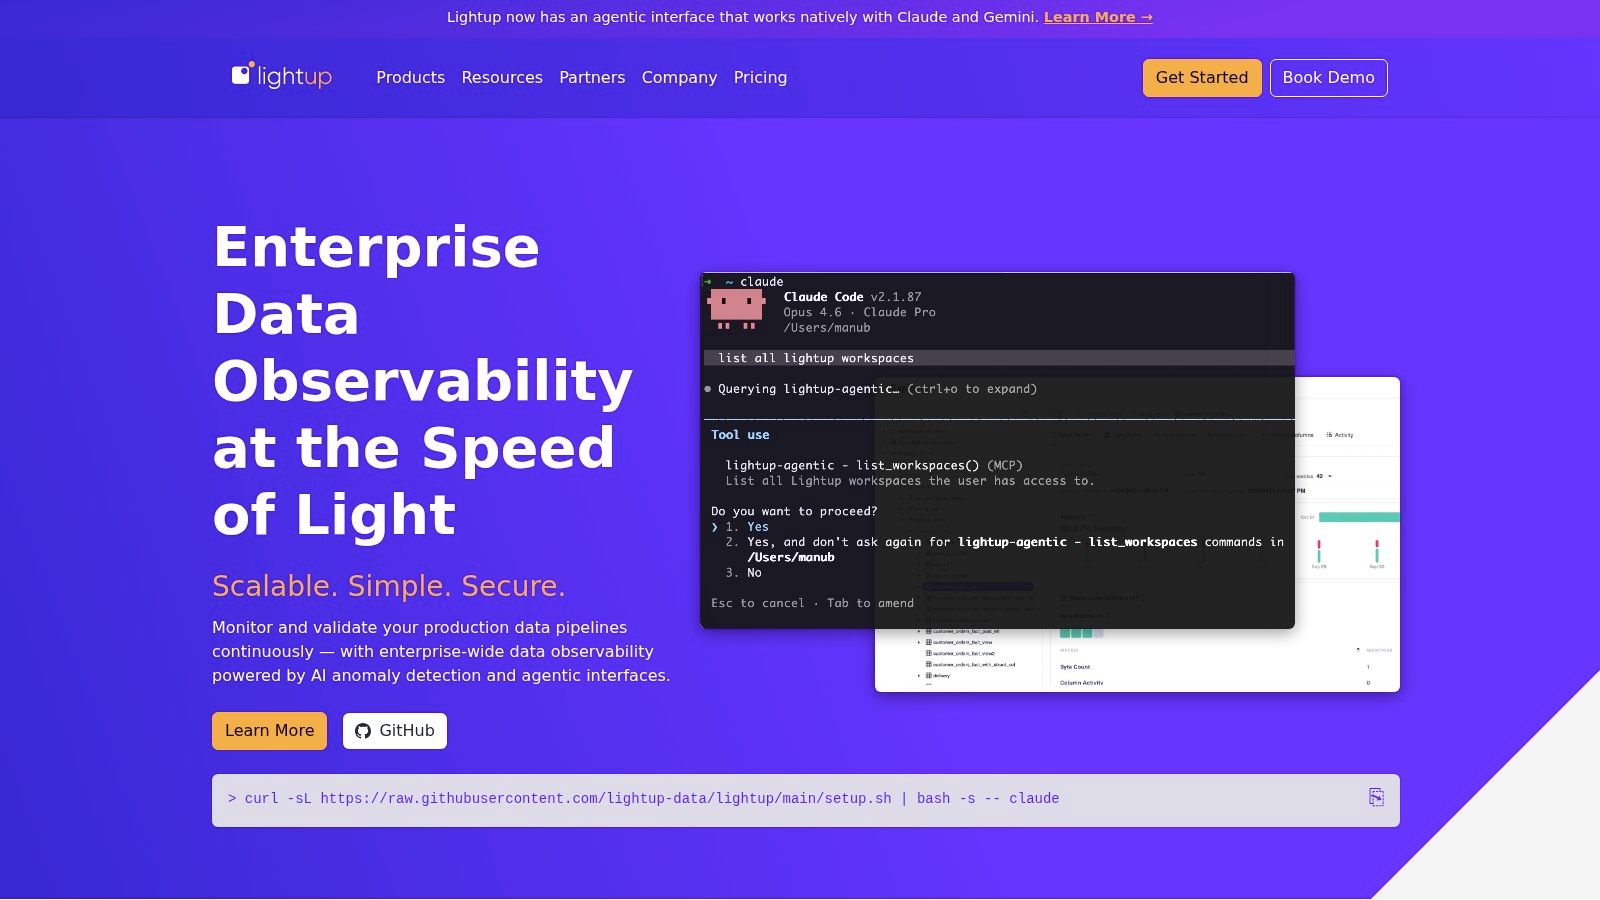
Auto-aktywacja kontra kontrolowane wdrożenie modułowe
Szybka aktywacja Lightup może skrócić czas do uzyskania pierwszego pokrycia. digna oferuje podobną koncepcję stopniowego wdrażania poprzez licencjonowanie modułowe, ale jej wyróżnikiem jest to, że kontrole i obliczenia metryk są wykonywane bezpośrednio w bazach danych klienta. Może to mieć większe znaczenie niż początkowa szybkość konfiguracji dla zespołów przetwarzających wrażliwe dane produkcyjne.
Brak publicznie dostępnego cennika sprawia, że oferta powinna jasno rozdzielać opłaty za platformę, monitorowany zakres, poziom wdrożenia, integracje i wsparcie. Kupujący powinni również sprawdzić, czy automatycznie generowane metryki dostarczają przydatnych incydentów, czy jedynie zwiększają szum informacyjny. Celem nie jest aktywacja każdego możliwego monitora. Chodzi o wczesne identyfikowanie awarii bez zmuszania inżynierów do analizowania zdarzeń o niskiej wartości.
Zalety: Szybka podstawowa konfiguracja, wykrywanie anomalii przez AI, lineage, uzgadnianie danych, integracje z governance oraz ścieżki wdrożenia Cloud lub Enterprise.
Wady: Cennik wymaga indywidualnego zapytania, a widoczność w ekosystemie jest mniejsza niż u największych liderów rynku.
9. Telmai
Telmai jest przeznaczony dla otwartych architektur i środowisk lakehouse zbudowanych wokół Iceberg, Hudi lub Delta. Jego pozycjonowanie jako no-code i low-code, wykrywanie anomalii bez reguł, monitorowanie dryfu, kontrole Timeliness, monitorowanie schematu oraz zapytania o problemy w języku naturalnym odpowiadają na potrzeby zespołów, które chcą szerokiego pokrycia bez ręcznego budowania każdego detektora.
Narzędzie Root-cause Investigator na platformie ma na celu wyjście poza pierwszy alert w kierunku wyjaśnienia przyczyny. Dostępność w AWS Marketplace może również uprościć wstępną próbę lub ścieżkę zakupową dla zespołów działających już w chmurze AWS. Ta wygoda nie zdejmuje jednak konieczności zamodelowania monitorowanego zakresu, odpowiedzialności wdrożeniowej oraz sposobu, w jaki platforma wchodzi w interakcję z otwartymi formatami tabel.
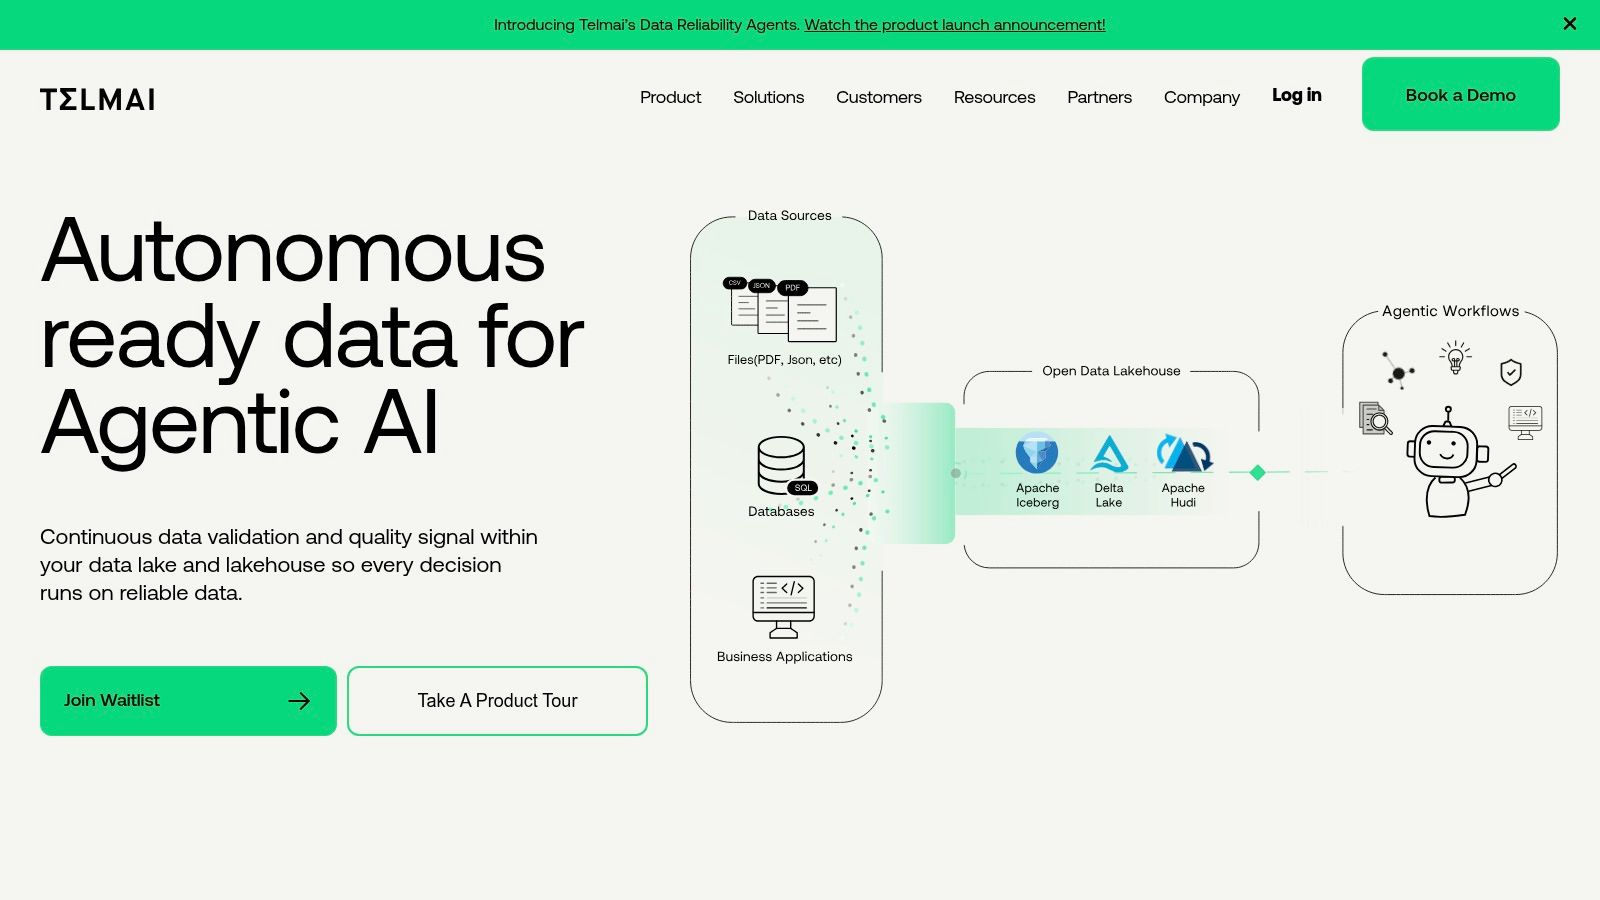
Otwarte formaty zmieniają test migracyjny
Telmai to silny kandydat, gdy otwartość środowiska lakehouse jest głównym wymaganiem architektonicznym. digna sprawdza się najlepiej, gdy zespół potrzebuje również wykonywania operacji wewnątrz bazy danych, prywatnego wdrożenia, walidacji na poziomie rekordów, wyuczonego przez AI monitorowania Timeliness oraz wspólnego interfejsu dla inżynierów, analityków i interesariuszy ds. governance.
Praktyka data observability zazwyczaj grupuje jakość, świeżość, lineage i zmiany schematu jako kluczowe sygnały monitorowania, przy czym kontrole w czasie rzeczywistym pomagają zapobiegać awariom analityki i sztucznej inteligencji na dalszych etapach. (Badania nad sygnałami data observability) Podczas wdrożenia próbnego (POC) porównaj nie tylko to, czy obie platformy wykrywają ten sam dryf, ale również czy każda z nich potrafi wyjaśnić problem w preferowanym języku operacyjnym zespołu.
Cennik Telmai nie jest publiczny i zależy od monitorowanego zakresu oraz sposobu wdrożenia. Jego obecność w społeczności jest również mniejsza niż u dostawców o dłuższym stażu rynkowym, dlatego kupujący powinni ocenić dokumentację, wsparcie wdrożeniowe i wewnętrzną odpowiedzialność za system.
Zalety: Świetne dopasowanie do lakehouse i otwartych formatów, pokrycie anomalii bez użycia reguł, badanie problemów w języku naturalnym i dostępność w AWS Marketplace.
Wady: Cennik zależny od indywidualnej wyceny, a obecność w społeczności jest mniejsza niż w przypadku ugruntowanych dostawców.
10. Kensu
Kensu używa wdrażalnych agentów do obserwacji danych w ruchu i w spoczynku. Takie podejście instrumentuje potoki tam, gdzie dane są używane, zbierając w czasie rzeczywistym informacje o lineage, schemacie i metrykach jakości w narzędziach takich jak dbt, Databricks lub Spark, Azure Data Factory oraz Snowflake. Może to zmniejszyć martwe punkty w środowiskach rozproszonych, gdzie monitor ograniczony tylko do hurtowni widzi cel, ale nie ścieżkę transformacji, która go wygenerowała.
Kontrole typu „bezpiecznik” (circuit-breaker) i przepływy pracy dla incydentów rozszerzają działanie Kensu poza pasywne powiadomienia. Wersja Community Edition i opcje wdrożenia próbnego mogą pomóc programistom ocenić model instrumentacji przed zaangażowaniem się w szersze wdrożenie. Kluczowym pytaniem przy migracji jest to, czy zespół chce osadzać agentów w potokach, czy woli kontrole, które wykonują się bezpośrednio w bazie danych.
Głębokość instrumentacji kontra wykonanie rezydujące w danych
Model Kensu „obserwuj tam, gdzie dane są używane” może ujawnić kontekst, który monitorowanie ograniczone tylko do tabel pomija. digna wybiera inną drogę z wykonywaniem operacji bezpośrednio w bazie danych, utrzymując obliczenia metryk i analizy wewnątrz baz danych klienta, jednocześnie pokrywając anomalie, analitykę, Timeliness, walidację i zmiany schematu poprzez oddzielne moduły.
Cennik Kensu nie jest publikowany i zazwyczaj opiera się na kontakcie z działem sprzedaży. Szczegóły na stronie internetowej są również skromniejsze niż u większych dostawców, a część materiałów dostarczana jest poprzez dokumentację lub kanały profesjonalne. Ocena powinna zatem obejmować przejście przez proces wdrożenia, uprawnienia agentów, zachowanie w przypadku awarii, odpowiedzialność za aktualizacje oraz przechowywanie dowodów.
Zalety: Instrumentacja potoków w czasie rzeczywistym, monitorowanie lineage i schematów, rozproszona widoczność oraz opcje oceny społecznościowej.
Wady: Cennik nie jest publiczny, a zespoły muszą ocenić narzut operacyjny związany z wdrażaniem i utrzymaniem agentów.
Top 10 alternatyw dla Bigeye: Porównanie funkcji
Dostawca | Kluczowe możliwości | Unikalne cechy oferty | Grupa docelowa | Wdrożenie i bezpieczeństwo | Cennik i wartość |
|---|---|---|---|---|---|
🏆 digna | Wykrywanie anomalii, Timeliness, Walidacja rekordów, Śledzenie schematu, Metryki i analityka w bazie danych | ✨ Wykonanie w bazie danych, nauka linii bazowych AI, modułowe wdrażanie, szybki czas do uzyskania wartości (TTV) ★★★★★ | 👥 Inżynierowie danych, BI/analityka, governance; finanse/ochrona zdrowia/telekomunikacja/sektor publiczny | Działa w infrastrukturze klienta (chmura prywatna/VPC/on-prem); dostawca nie ma dostępu do danych produkcyjnych | 💰 Przejrzysty cennik modułowy: podstawa + za aktywną tabelę/moduł; przewidywalny, ale zależny od skali |
Monte Carlo Data | Monitory świeżości, wolumenu, schematu i dystrybucji; lineage kolumn/pulpitów; przepływy pracy incydentów | ✨ Szerokie pokrycie konektorów/stosu; silne referencje korporacyjne ★★★★ | 👥 Duże przedsiębiorstwa ze zróżnicowanymi stosami technologicznymi i zespołami analitycznymi | Konektory chmurowe/SaaS dla hurtowni, jezior danych, ETL, BI | 💰 Cennik korporacyjny na zapytanie; może być zbyt obciążający dla małych zespołów |
Acceldata | Observability platform/potoków/zadań, koszty, wydajność, sprocesowane przepływy pracy | ✨ Obsługa środowisk hybrydowych/on-prem + skupienie na governance i optymalizacji ★★★★ | 👥 Duże, heterogeniczne środowiska; przedsiębiorstwa modernizujące Big Data | Opcje wdrożenia chmurowego, lokalnego i hybrydowego; kontrole korporacyjne | 💰 Sprzedaż prowadzona przez dział handlowy; dostosowane do dużych zasobów |
Anomalo | Nienadzorowane wykrywanie anomalii, analiza przyczyn źródłowych, integracje (Databricks/Snowflake) | ✨ Wykrywanie bez reguł, szybki czas do uzyskania wartości ★★★★ | 👥 Zespoły potrzebujące szybkiego wykrywania anomalii bez rozbudowanych reguł | SaaS z opcjami wdrażania korporacyjnego; silne integracje chmurowe | 💰 Na zapytanie; dostępne korporacyjne umowy SLA |
Soda | Kontrole/kontrakty jako kod (Soda Core OSS); Soda Cloud dla analizy bazowej i alertów | ✨ Wejście przez OSS (ponad 50 kontroli) → ścieżka migracji do zarządzanej chmury ★★★ | 👥 Programiści/inżynierowie chcący zacząć od OSS i osadzania w potokach | OSS (CLI) + zarządzana chmura; integracja z hurtowniami i orkiestratorami | 💰 Darmowy OSS; Soda Cloud = kontakt z działem sprzedaży w celu wyceny |
Metaplane (Datadog) | Wykrywanie anomalii ML, lineage kolumn, Data CI/CD, Snowflake Native App | ✨ Szybkie wdrażanie, darmowy poziom na zawsze, opcja natywna dla Snowflake ★★★★ | 👥 Małe i średnie zespoły, organizacje zorientowane na Snowflake, szybkie projekty próbne | SaaS + Snowflake Native App (dane pozostają w hurtowni) | 💰 Dostępny darmowy poziom; płatne plany / cennik Datadog |
IBM Data Observability (Databand) | Observability potoków/zadań, śledzenie SLA, integracje z orkiestracją i hurtowniami | ✨ Wsparcie IBM, dopasowanie zakupowe i korporacyjne/regulacyjne ★★★ | 👥 Przedsiębiorstwa regulowane i klienci standaryzujący rozwiązania na IBM | Wdrożenia korporacyjne, wsparcie i ramy produktowe IBM | 💰 Cennik kontraktowy/sprzedażowy; korporacyjny model zakupowy |
Lightup | Kontrole reguł + wykrywanie anomalii AI, lineage, uzgadnianie, zarządzanie incydentami | ✨ Metryki automatyczne Zero-config dla szybkiego pokrycia ★★★ | 👥 Zespoły chcące szybkiego automatycznego pokrycia i współpracy | Plany Cloud i Enterprise; opcje hybrydowe | 💰 Na zapytanie; jasny podział na plany Cloud i Enterprise |
Telmai | Observability jezior/lakehouse (Iceberg/Hudi/Delta), dryf/Timeliness/schemat, zapytania w języku naturalnym | ✨ Skupienie na otwartych formatach, zapytania o problemy w języku naturalnym, dostępność w AWS Marketplace ★★★ | 👥 Zespoły lakehouse, środowiska otwartych formatów, przygotowanie do GenAI | Wdrożenia chmurowe; opcja zakupów przez marketplace (AWS) | 💰 Cennik zależny od zakresu; wymagany kontakt z działem sprzedaży |
Kensu | Lineage oparty na agentach, metryki schematu i jakości, obserwacje i profilery w czasie rzeczywistym | ✨ Obserwacja w miejscu użycia danych; edycja Community/POC ★★★ | 👥 Zespoły potrzebujące instrumentacji w czasie rzeczywistym i oceny deweloperskiej | Wdrażanie agentów w potokach; telemetria w czasie rzeczywistym | 💰 Cennik sprzedażowy; wersja Community Edition do oceny |
Przekształć krótką listę w bezpieczną decyzję o migracji
Właściwa alternatywa dla Bigeye zależy w mniejszym stopniu od liczby monitorów pokazanych na prezentacji demonstracyjnej, a bardziej od tego, jak platforma zachowuje się w odniesieniu do rzeczywistej lokalizacji danych, modelu własności i procesu obsługi incydentów. Popyt rynkowy zmierza w tym kierunku. Jedno z badań rynkowych prognozuje wzrost kategorii data observability z 3,51 miliarda USD w 2026 roku do 6,03 miliarda USD do 2031 roku, przy oczekiwanej skumulowanej rocznej stopie wzrostu na poziomie 11,42% w tym okresie. (Badanie rynku data observability z 2026 roku) Sam wzrost nie wskazuje na właściwy produkt, ale pokazuje, że zespoły podejmują długoterminową decyzję dotyczącą infrastruktury, a nie kupują tymczasową warstwę alertów.
Zacznij od inwentaryzacji, a nie od karty ocen dostawców. Wypisz kluczowe tabele, potoki, pulpity nawigacyjne, modele i odbiorców operacyjnych. Oznacz, które zasoby zawierają wrażliwe dane, które systemy działają w sieciach prywatnych lub lokalnie (on-premises), a które obciążenia nie mogą tolerować kopiowania danych produkcyjnych. Następnie sklasyfikuj wymagane kontrole:
Pokrycie anomalii: Zidentyfikuj zachowania wymagające wyuczonych linii bazowych, w tym wolumen, dystrybucję, metryki biznesowe i sygnały platformy.
Wymagania dotyczące Timeliness: Zdefiniuj oddzielnie oczekiwane okna dotarcia i okna decyzyjne. Zbiór danych może dotrzeć w nominalnym przedziale świeżości, a mimo to minąć moment, w którym proces biznesowy go potrzebuje.
Reguły walidacji: Udokumentuj logikę biznesową na poziomie rekordów, kontrole regulacyjne, warunki uzgadniania i kontrole, które muszą pozostać jawne, a nie tylko dorozumiane.
Monitorowanie schematu: Określ, jak dodane kolumny, usunięte pola i zmiany typów powinny wpływać na odbiorców końcowych.
Przepływ pracy badania przyczyn: Zmierz, czy inżynier może przejść od alertu do dotkniętego zasobu, prawdopodobnej przyczyny, właściciela i naprawy bez przełączania się między rozłączonymi narzędziami.
Przetestuj finalistów na reprezentatywnych obciążeniach roboczych, a nie na czystej próbie danych. Uwzględnij tabelę o wysokiej wartości, opóźniony potok, planowaną zmianę schematu, nieoczekiwane przesunięcie dystrybucji i naruszenie reguły. Porównaj jakość alertów, czas dochodzenia, użyteczność lineage oraz nakład pracy wymagany do dostrojenia monitorów. Nie licz alertów jako sukcesu. Licz alerty, które prowadzą do jasnego działania.
Modelowanie kosztów wymaga takiego samego realizmu. Niektórzy dostawcy wyceniają usługi na podstawie monitorowanego zakresu, inni używają sygnałów o zużyciu zasobów, a digna stosuje opłatę podstawową plus cennik za aktywną tabelę i moduł, bez opłat za API, wolumen skanowania czy liczbę alertów. Poproś każdego dostawcę o zamodelowanie wzrostu przy użyciu Twoich aktywnych tabel, wybranych modułów, środowisk, integracji i wymagań dotyczących wsparcia. Istotne są tu dowody na zjawisko nadmiaru narzędzi (tool-sprawl): 46,7% organizacji uruchamia dwa do trzech narzędzi do Observability równolegle, podczas gdy tylko 7,4% polega na jednej, zunifikowanej platformie. (Podsumowanie niezależnego badania Observability) Konsolidacja może poprawić przejrzystość przepływu pracy, ale tylko wtedy, gdy zamiennik obejmuje kontrole, które zmuszały zespoły do dodawania narzędzi uzupełniających.
Mapowanie modułów digna zapewnia praktyczny punkt odniesienia do porównania:
Data Anomalies: Oparte na sztucznej inteligencji uczenie się linii bazowych i ciągłe wykrywanie anomalii bez ręcznej konfiguracji reguł.
Data Analytics: Analiza trendów historycznych, zmienności i statystyk służąca zrozumieniu niezawodności w czasie.
Timeliness: Wyuczone przez AI harmonogramy dostarczania, oczekiwane czasy dostarczenia, opóźnienia, brakujące dane i przedwczesne dostawy.
Data Validation: Wymuszanie reguł biznesowych na poziomie pojedynczych rekordów na potrzeby kontroli jakości, audytu i zgodności (Compliance).
Schema Tracker: Ciągłe wykrywanie dodanych lub usuniętych kolumn oraz zmian typów danych.
Wykonywanie operacji w bazie danych: Obliczanie metryk i analiza bezpośrednio w bazach danych klienta, co pozwala zachować dane na miejscu.
Opcje wdrożenia: Instalacja w chmurze prywatnej lub lokalnie (on-premises) wewnątrz chmury, VPC lub centrum danych klienta.
Wspólny pulpit nawigacyjny: Jeden interfejs dla inżynierów, analityków, zespołów ds. governance i innych interesariuszy.
Zawarte komponenty: Harmonogram (scheduler), katalog danych, integracje i funkcje współpracy dostępne od momentu wyboru pierwszego modułu.
Modułowe licencjonowanie: Rozpocznij od jednego modułu i rozbudowuj system w oparciu o aktywne tabele i moduły.
Dyscyplina migracji: Utrzymuj działanie Bigeye i wybranej alternatywy na tych samych reprezentatywnych obciążeniach roboczych wystarczająco długo, aby porównać wykrywanie, dochodzenie, zachowanie kosztów i nakład pracy związany z obsługą.
Udokumentuj kryteria wycofania migracji (rollback) przed jej rozpoczęciem. Zdecyduj, co stanowi niedopuszczalny szum alertów, pominięte incydenty, nieoczekiwane koszty obliczeniowe, nieudane integracje lub niewystarczające dowody dla governance. Postępuj etapowo, zaczynając od ograniczonego zestawu kluczowych zasobów i rozszerzając zakres dopiero po potwierdzeniu przez właścicieli, że nowy przepływ pracy działa. Wyłącz Bigeye dopiero wtedy, gdy zamiennik wykaże się odpowiednim pokryciem, obsługą incydentów, kontrolą dostępu i zachowaniem kosztów w środowisku produkcyjnym, a nie tylko po zatwierdzeniu umowy przez dział zakupów.
Najlepszym wyborem może okazać się Monte Carlo ze względu na szeroki lineage, Acceldata dla pełnostosowych środowisk hybrydowych, Soda dla kontroli jako kod, Metaplane dla szybkiego wdrożenia na nowoczesnym stosie, Telmai dla otwartych formatów lakehouse, Kensu dla opartej na agentach instrumentacji potoków lub IBM Data Observability by Databand dla operacji korporacyjnych zorientowanych wokół IBM. Może to być również digna, gdy decydującymi wymaganiami są prywatne wdrożenie, wykonywanie operacji bezpośrednio w bazie danych, modułowe wdrażanie, wyuczone monitorowanie anomalii i Timeliness, jawna walidacja oraz kontrola schematu. Dopasowanie zależy od architektury i modelu operacyjnego, dlatego krótka lista powinna kończyć się testem obciążenia roboczego i decyzją o odpowiedzialności za system, a nie ogólnym rankingiem.
digna łączy oparte na sztucznej inteligencji wykrywanie anomalii, monitorowanie Timeliness, walidację na poziomie rekordów, śledzenie schematów, analizę historyczną oraz wykonywanie operacji wewnątrz baz danych w Twoim własnym środowisku. Odwiedź stronę digna, aby ocenić modułową alternatywę dla Bigeye pod kątem wymagań dotyczących Twojej platformy danych, governance i niezawodności.
Najczęściej zadawane pytania
Jak porównywać alternatywy dla Bigeye?
Nie wyłącznie po wykrywaniu anomalii, bo to powiela problem, który kupujący próbuje rozwiązać. Oceniaj według praktycznych kryteriów korporacyjnych: lokalizacji danych, pokrycia anomalii, walidacji, Timeliness, monitoringu schematu, modelu wdrożenia, sygnałów cenowych i nakładu migracji.
Która alternatywa pasuje przy wymogach rezydencji danych?
digna jest najmocniejszym wyborem, gdy obok pokrycia observability liczy się kontrola wdrożenia i rezydencja danych, bo łączy automatyczne wykrywanie z kontrolami deterministycznymi i działa wewnątrz bazy. Kompromisem jest to, że wdrożenie prywatne wymaga wewnętrznej odpowiedzialności operacyjnej.
Jak Monte Carlo wypada wobec platformy in-database?
Wyróżnikiem Monte Carlo jest szerokość operacyjna: bogate pokrycie konektorów, lineage od końca do końca i przepływy incydentów odpowiednie dla dużych, nowoczesnych stosów. Decyduje model operacyjny: Monte Carlo pasuje zespołom stawiającym na lineage i ekosystem, a platforma in-database tym, które muszą zatrzymać dane u siebie.
Jak zwykle wygląda wycena observability?
Różni się na tyle, że zakupy powinny ją wymodelować. digna stosuje opłatę bazową plus opłatę za aktywną tabelę i moduł, co wymaga oszacowania przy dużych środowiskach, a kilku konkurentów, w tym Monte Carlo, nie publikuje cen i wymaga oferty opartej na monitorowanym zakresie i integracjach.
Ile czasu zespoły wciąż tracą na problemy z danymi?
Badanie liderów zarządzania danymi wykazało, że tylko 7 % rozwiązuje problemy, zanim dotkną użytkowników, a 39 % poświęca od 20 do 40 % czasu na naprawianie potoków. Ten reaktywny udział jest właściwym punktem odniesienia, który platforma zastępcza musi przesunąć.


