9 tipi di rilevamento delle anomalie spiegati
|
10
min di lettura

La maggior parte dei consigli sul rilevamento delle anomalie parte dagli algoritmi. È l'approccio sbagliato. Il rilevamento delle anomalie parte dalla giusta definizione di normalità.
Nessun metodo si adatta a ogni dataset, perché le anomalie si presentano in forme diverse. Un'anomalia puntuale è un singolo valore anomalo, come un improvviso picco di pagamenti falliti. Un'anomalia contestuale appare sbagliata solo nel suo contesto, come un volume di transazioni apparentemente normale che si presenta all'ora sbagliata. Un'anomalia collettiva è un pattern che riguarda più record o più intervalli temporali, come un batch in ritardo seguito da un'impennata di recupero. In pratica, i team devono anche distinguere i problemi univariati da quelli multivariati, perché una singola colonna che si comporta in modo strano è una cosa molto diversa da più campi che derivano insieme.
Questa distinzione ha radici profonde. Una recente rassegna storica fa risalire le prime riflessioni sulle anomalie nelle serie temporali a Bernoulli nel 1777, poi alla distinzione tra tipi di anomalia proposta da Fox nel 1972 e alla sua estensione da parte di Tsay nel 1988, mentre la pratica moderna continua a basarsi su anomalie puntuali, contestuali e collettive come categorie fondamentali (rassegna storica sul rilevamento delle anomalie nelle serie temporali). Resta il punto di partenza corretto per scegliere tra i principali tipi di rilevamento delle anomalie.
Una regola pratica funziona meglio di una ricetta universale. Usate la validazione deterministica per le condizioni note. Usate metodi statistici o per serie temporali quando il comportamento è misurabile e ricorrente. Usate il machine learning quando i pattern sono complessi, multivariati o cambiano troppo rapidamente per una logica statica. Piattaforme come digna combinano metodi statistici, machine learning, validazione, tempestività e monitoraggio dello schema all'interno dell'infrastruttura del cliente, quando questo modello operativo è importante.
Indice
1. Apprendimento statistico della baseline
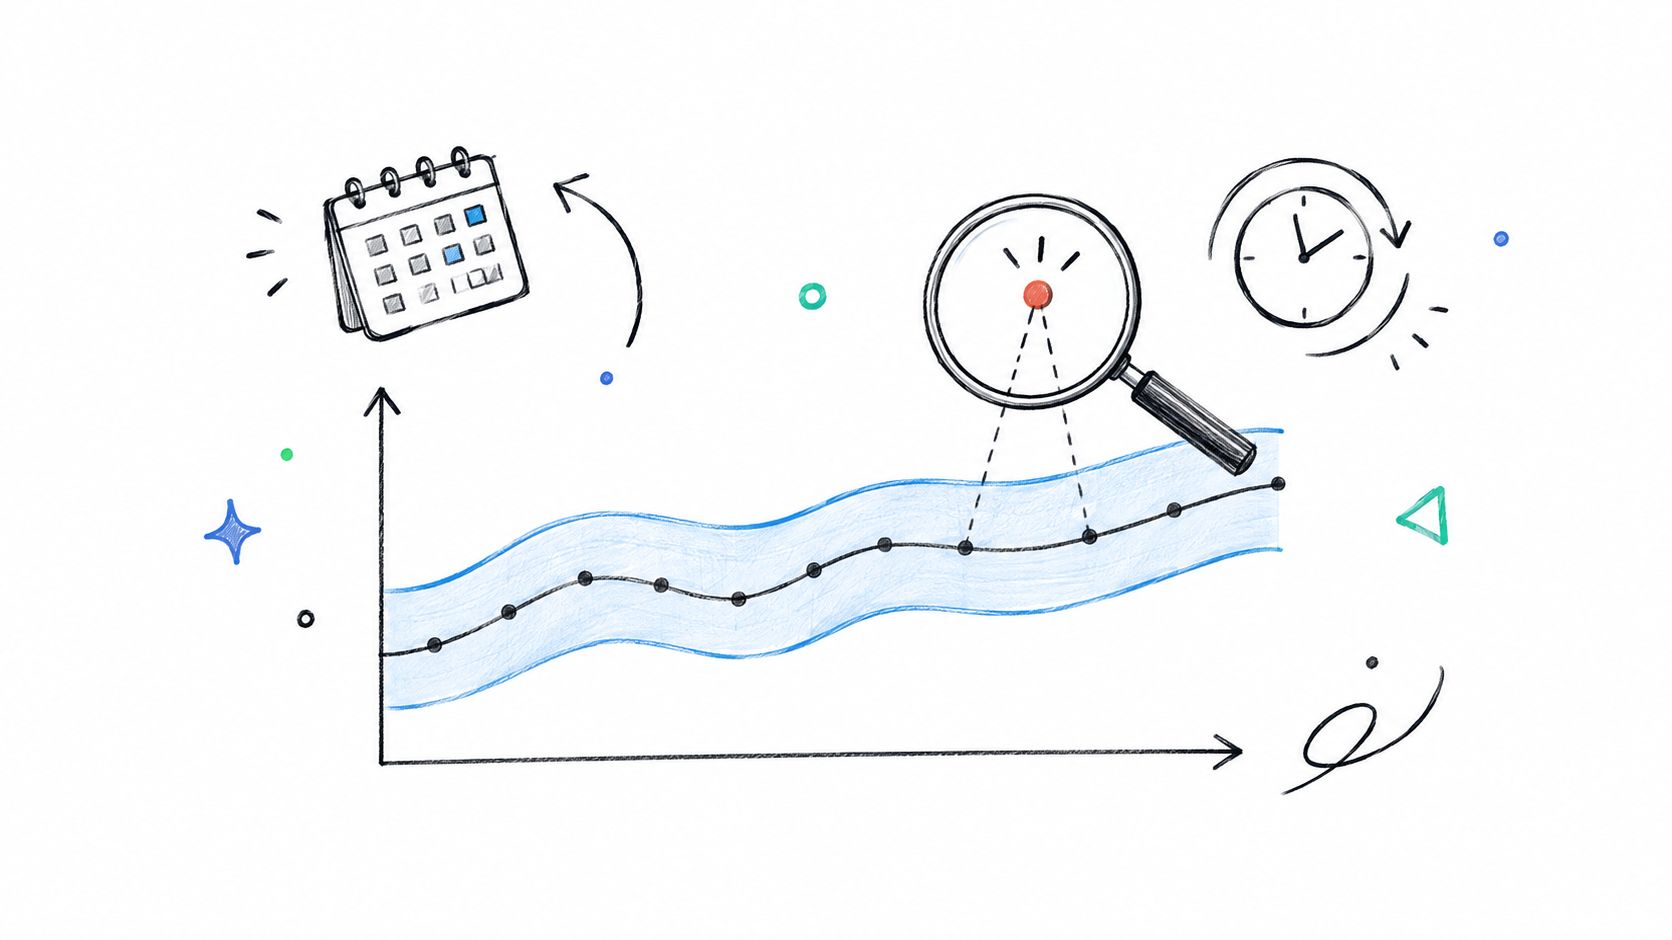
Alcuni team lo chiamano “rilevamento delle anomalie con l'AI”, ma l'idea utile è più semplice. Il sistema impara dallo storico che aspetto ha il comportamento normale, poi segnala gli scostamenti da quella baseline.
Questo metodo funziona meglio quando una metrica ha un comportamento riconoscibile nel tempo. Il numero di transazioni può salire nei giorni feriali e calare nel fine settimana. I dati dei sinistri possono arrivare a ondate prevedibili. Gli eventi dell'assistenza clienti possono avere un picco ogni mattina e poi stabilizzarsi. Un modello di baseline assorbe questi pattern meglio di una soglia statica.
Ecco l'intuizione visiva.
Su quali evidenze si basa
L'apprendimento della baseline si basa sul comportamento statistico osservato nel tempo. Invece di chiedersi “questo valore ha superato un limite fisso?”, si chiede “questo valore è insolito per questo dataset, in questo momento, alla luce del pattern recente?”.
Per questo è adatto alla data observability. Un team finance potrebbe osservare il volume giornaliero delle transazioni. Un team operativo in ambito sanitario potrebbe monitorare i flussi dei ricoveri. Una piattaforma dati di telecomunicazioni potrebbe tracciare i record di utilizzo in arrivo in ritardo. In ogni caso il modello apprende intervalli attesi, trend e variazioni ricorrenti.
Un concetto di base utile è la distribuzione dei dati nell'analisi delle anomalie. I team che comprendono dispersione, asimmetria e variazione attesa di solito calibrano le baseline in modo più efficace.
Regola pratica: affiancate all'apprendimento della baseline controlli deterministici sui dataset ad alto rischio. Il comportamento appreso intercetta le derive. Le regole intercettano le violazioni note.
Dove aiuta e dove ha difficoltà
Aiuta quando la “normalità” cambia nel tempo ma segue comunque un pattern. Ha difficoltà quando lo storico è troppo breve, quando il processo è cambiato la settimana scorsa o quando la metrica è per lo più rumore.
Esempi:
Finanza: deriva inattesa nel volume delle transazioni anche se nessuna soglia è stata superata
Sanità: variazioni insolite nell'attività dei pazienti tra le diverse strutture
Telecomunicazioni: tassi anomali di arrivo dei dati nelle pipeline di ingestione
Compromessi comuni:
Elevata interpretabilità: i team in genere vedono la banda attesa e possono spiegare perché è scattato un alert
Sensibilità a finestre di addestramento errate: i periodi di incidente possono contaminare la baseline
Migliore con controlli di supporto: i controlli di validazione e di tempestività aumentano la fiducia
2. Isolation Forest
Isolation Forest è un metodo di machine learning che sembra strano solo finché non si immagina che cosa fa. Continua a suddividere i dati in partizioni sempre più piccole in modo casuale. I punti che vengono isolati rapidamente hanno maggiori probabilità di essere anomalie.
Questo approccio lo rende utile per i dati ad alta dimensionalità. Se valutate molte feature contemporaneamente, i metodi basati sulla distanza possono diventare scomodi. Isolation Forest evita parte di questa complessità concentrandosi su quanto sia facile separare un punto dal resto.
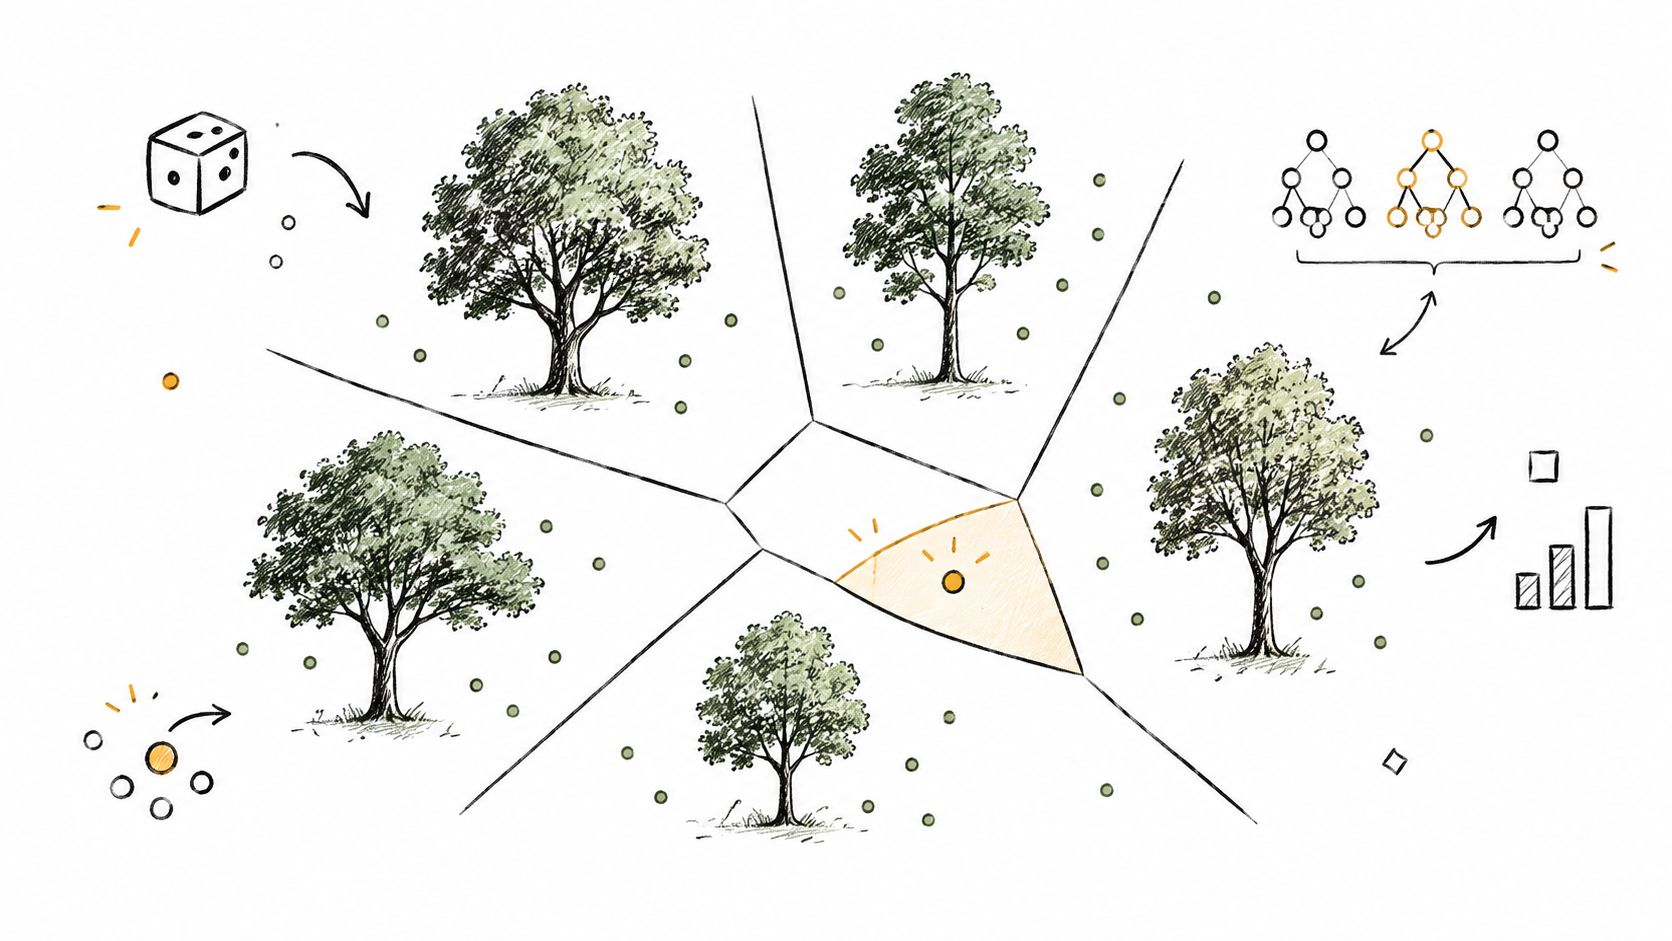
Come funziona in pratica
Il modello viene addestrato su dati non etichettati e crea molti alberi casuali. Un'osservazione normale di solito richiede più suddivisioni per essere isolata, perché si trova in una regione densa. Un'osservazione insolita viene separata in meno passaggi.
Per questo è un'opzione ragionevole quando non avete etichette e non volete scrivere a mano regole per ogni combinazione sospetta. Una banca potrebbe assegnare un punteggio alle transazioni in base a importo, categoria merceologica dell'esercente, orario, area geografica e canale. Un ospedale potrebbe analizzare combinazioni di indicatori operativi. Un team di telecomunicazioni potrebbe monitorare il comportamento della rete su più dimensioni.
Se volete prototipare il metodo in modo pratico, un workflow di rilevamento delle anomalie in Python è un punto di partenza comune.
Compromessi da tenere d'occhio
Isolation Forest può funzionare bene sui dati multivariati, ma non fa miracoli. La scelta delle feature conta ancora, così come la normalizzazione. Se una variabile domina l'intervallo, il modello può isolare i record sbagliati per il motivo sbagliato.
Buoni utilizzi:
Screening antifrode: combinazioni insolite di molti attributi delle transazioni
Monitoraggio operativo: comportamenti che sembrano normali su ogni singola metrica ma strani nel loro insieme
Esplorazione: grandi dataset non etichettati in cui servono candidati da revisionare
Partite dai parametri predefiniti, poi verificate gli alert reali con i responsabili di dominio. Un punto matematicamente insolito non è sempre un'anomalia rilevante per il business.
3. Metodi z-score e deviazione standard
Se vi serve una risposta semplice alla domanda “questo valore è insolitamente lontano dalla media?”, lo z-score è spesso il primo metodo da provare.
Misura quanto un punto dista dalla media in unità di deviazione standard. Sembra tecnico, ma la logica decisionale è semplice: se il valore è abbastanza lontano da ciò che è tipico, va segnalato.

Il caso d'uso ideale per gli z-score
Gli z-score sono utili quando la metrica è abbastanza stabile e la sua distribuzione si comporta in modo ragionevolmente regolare. Tra le tecniche di base più comuni per il rilevamento statistico delle anomalie ci sono z-score, IQR e medie mobili, e i team possono combinarle tramite votazione o punteggi ponderati per ridurre i falsi allarmi e migliorare il rilevamento (note pratiche sui metodi di rilevamento delle anomalie nelle serie temporali).
Ecco perché gli z-score compaiono ancora nel monitoraggio aziendale: sono facili da spiegare. Un team finance può segnalare importi di transazione insoliti. Un team di assistenza sanitaria può osservare misurazioni anomale dei parametri vitali. Un team dati può monitorare il numero di righe nei caricamenti ricorrenti.
Se dovete valutare con più attenzione se media e dispersione siano la sintesi giusta, questa guida su come descrivere la distribuzione dei dati offre un contesto utile.
Limiti e accorgimenti pratici
Il punto debole è il contesto. Uno z-score calcolato sui dati grezzi può non cogliere stagionalità, derive o distribuzioni asimmetriche. Una metrica di vendita giornaliera con un forte andamento settimanale può sembrare anomala ogni fine settimana se si ignora il contesto temporale.
Usate gli z-score con attenzione quando:
La metrica è stabile: numero di righe, dimensioni dei file, durate o importi con deriva limitata
Vi serve trasparenza: audit e revisioni con gli stakeholder sono più semplici con una matematica semplice
Volete un benchmark di riferimento: è un ottimo primo passaggio prima di modelli più pesanti
Brevi accorgimenti pratici:
Usate finestre mobili: sono più adatte a serie temporali il cui comportamento cambia
Preferite le varianti quando serve: le alternative basate sulla mediana gestiscono meglio gli outlier
Aggiungete regole di business: un valore statisticamente insolito può comunque essere accettabile dal punto di vista operativo
4. Local Outlier Factor
Alcune anomalie non sono estreme in senso globale. Sono strane solo rispetto ai dati vicini. È qui che diventa utile il Local Outlier Factor, o LOF.
LOF confronta la densità locale di un punto con la densità dei suoi vicini. Se il punto si trova in una regione più rarefatta rispetto ai record circostanti, il metodo lo considera sospetto. Questo lo rende adatto a dati raggruppati in cluster, in cui la “normalità” ha più modalità.
Perché la densità conta
Pensate all'utilizzo dei clienti nelle telecomunicazioni. Grandi utilizzatori, utenti occasionali e account aziendali possono formare gruppi distinti. Un record può sembrare normale rispetto all'intera popolazione ma risultare strano all'interno del proprio cluster. LOF è pensato proprio per questo tipo di confronto contestuale.
La stessa logica aiuta nel monitoraggio delle piattaforme. Un gruppo di job può girare tutto entro una certa fascia di latenza, mentre un'altra famiglia di pipeline gira in una fascia diversa. LOF può individuare un task anomalo rispetto ai suoi pari anche se in termini assoluti non sembra grande.
Adeguatezza pratica e compromessi
LOF dà il meglio quando i vicinati hanno un significato. Si indebolisce quando le dimensioni si moltiplicano e tutto diventa sparso. Nei dati ad alta dimensionalità, le relazioni tra vicini più prossimi possono diventare meno informative.
Scenari utili:
Telecomunicazioni: comportamenti insoliti dei clienti all'interno di coorti di utilizzo simili
Piattaforme dati: job anomali rispetto a job comparabili
Operazioni sanitarie: record che non rientrano nei pattern operativi vicini
Punti da ricordare:
Scegliete con cura la dimensione del vicinato: se è troppo piccola gli alert diventano nervosi, se è troppo grande il contesto locale scompare
Normalizzate prima le feature: i confronti di densità saltano quando una feature domina
Prevedete cicli di revisione: LOF trova spesso casi sottili che richiedono un'interpretazione di business
LOF di solito funziona meglio come parte di uno stack che come rilevatore isolato. Affiancatelo a un semplice filtro statistico o a una regola deterministica per ridurre il rumore in fase di revisione.
5. Reti neurali autoencoder
Gli autoencoder appartengono alla famiglia dei metodi di ricostruzione. Invece di fissare limiti espliciti o misurare la densità, imparano a comprimere e ricostruire i dati normali. Quando la ricostruzione riesce male, l'input potrebbe essere anomalo.
L'idea è potente quando il pattern è complesso e non lineare. È anche il punto in cui il rilevamento delle anomalie diventa più difficile da spiegare agli stakeholder non tecnici.
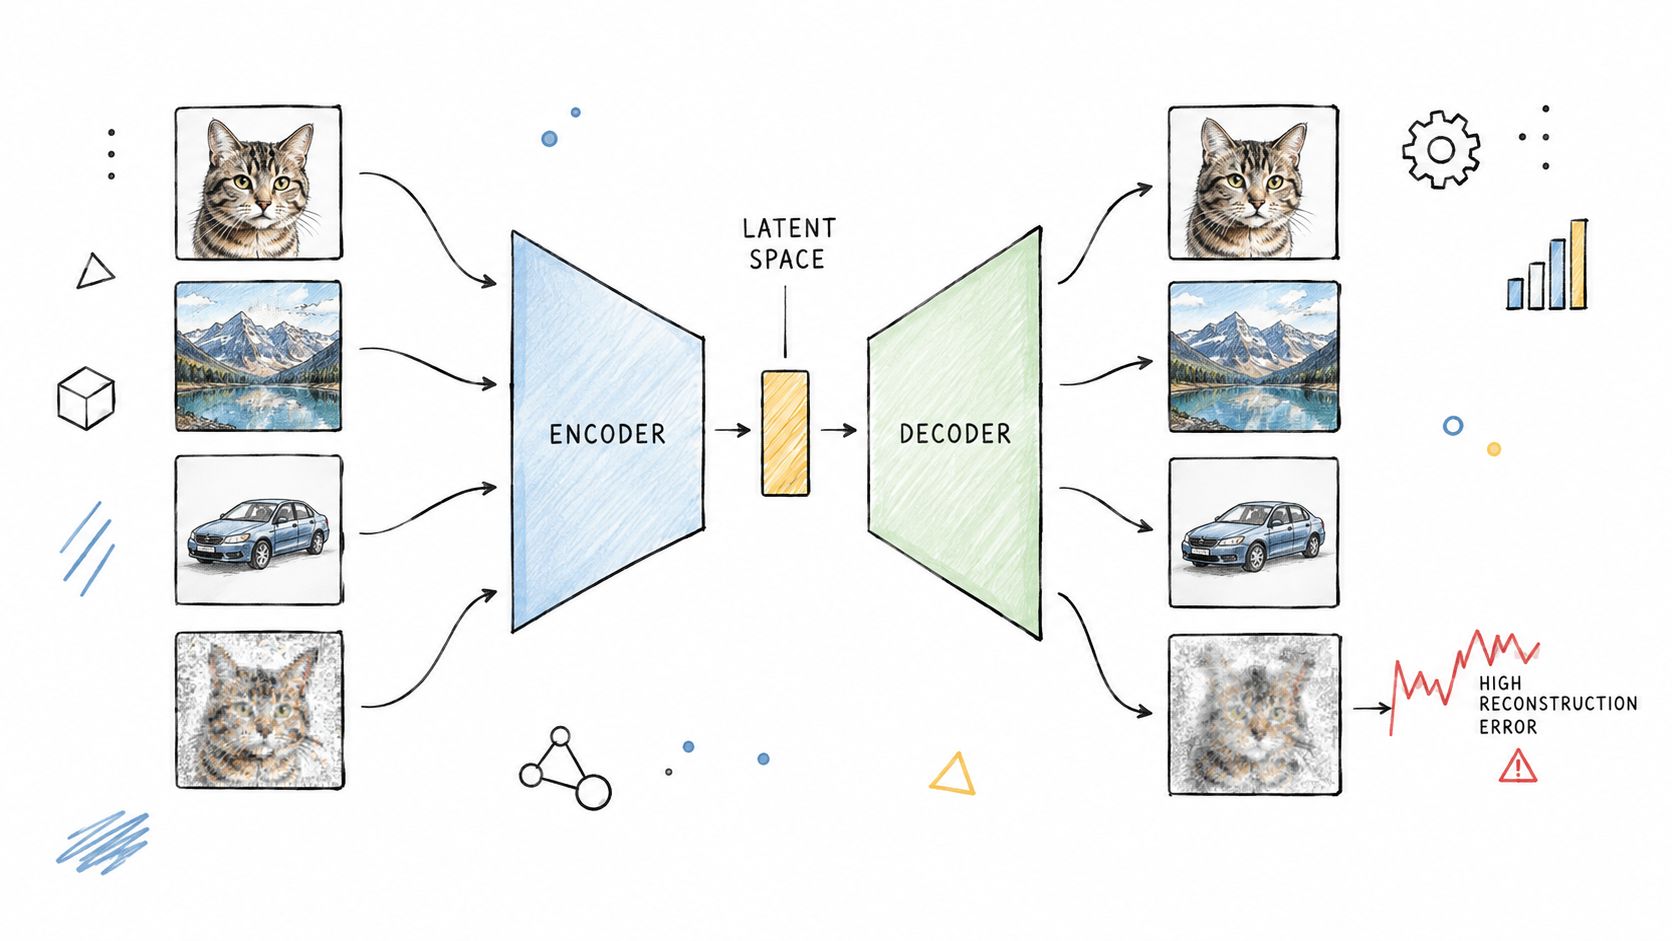
Dove la ricostruzione aiuta
Gli autoencoder sono utili quando il comportamento normale dipende da molte variabili che interagiscono e confini semplici non riescono a catturarlo. Un team finance potrebbe valutare comportamenti di pricing complessi. Un team sanitario potrebbe monitorare combinazioni provenienti da più dispositivi o sensori. Un team di telecomunicazioni potrebbe analizzare firme di traffico che non si separano nettamente con metodi lineari.
Nelle rassegne generali, i metodi di rilevamento delle anomalie vengono spesso raggruppati in approcci statistici, approcci di machine learning classico e metodi basati su reti neurali (rassegna di metodi statistici, di machine learning e di deep learning). Gli autoencoder rientrano a pieno titolo nel terzo gruppo.
Per i comportamenti legati al tempo, compaiono spesso all'interno di workflow di rilevamento delle anomalie nelle serie temporali più ampi, soprattutto quando le relazioni tra i segnali contano più di qualsiasi singola metrica.
I compromessi sono reali
Gli autoencoder possono catturare pattern che i metodi più semplici non vedono. Richiedono però dati di addestramento più puliti, più tuning e una disciplina operativa più rigorosa. Se il modello impara una “normalità” corrotta, l'errore di ricostruzione perde significato.
Usateli quando:
I pattern sono complessi: contano le interazioni non lineari
Le anomalie etichettate sono scarse: la ricostruzione non richiede molti esempi di guasto
Potete sostenere il modello: addestramento, riaddestramento e revisione delle soglie richiedono un responsabile
I metodi neurali trovano spesso anomalie preziose, ma raramente sostituiscono i controlli più semplici. I team hanno comunque bisogno di controlli spiegabili per la revisione degli incidenti e le discussioni con gli auditor.
6. One-Class SVM (Support Vector Machine)
One-Class SVM cerca di apprendere il confine attorno ai dati normali. Tutto ciò che cade al di fuori di quel confine appreso viene considerato insolito.
Questo lo rende concettualmente diverso da Isolation Forest. Isolation Forest si chiede quanto sia facile separare un punto. One-Class SVM si chiede se il punto ricada all'interno della regione accettata di comportamento normale.
Quando ha senso apprendere un confine
Questo metodo è utile quando i record normali formano una forma coerente, anche se non lineare. Le funzioni kernel permettono al modello di tracciare confini più flessibili, il che può aiutare con i pattern multivariati.
Alcuni esempi:
Servizi finanziari: transazioni che escono dal normale comportamento del cliente
Sanità: profili clinici insoliti su più misurazioni
Customer analytics: pattern di attività degli account che vanno oltre le norme conosciute
La sfida principale è la sensibilità. One-Class SVM può reagire fortemente alla normalizzazione delle feature, alla scelta dei parametri e ai dati di addestramento rumorosi. Sui dataset di grandi dimensioni può inoltre diventare computazionalmente costoso rispetto a metodi più leggeri.
Cosa devono aspettarsi i team
One-Class SVM è spesso una buona scelta per dataset strutturati di medie dimensioni, in cui l'apprendimento sulla “sola classe normale” si adatta al problema di business. È meno interessante quando servono spiegabilità immediata o un comportamento in produzione a bassa manutenzione.
Abitudini operative utili:
Normalizzate gli input: raramente è facoltativo
Mantenete feature significative: feature deboli distorcono il confine
Riaddestrate dopo le modifiche di processo: nuovi prodotti, canali o workflow possono spostare la regione normale
Se vi serve un modello più facile da discutere con auditor o responsabili operativi, la validazione deterministica o le baseline statistiche di solito sono la scelta migliore.
7. Decomposizione stagionale e ARIMA
Nel rilevamento delle anomalie il tempo cambia tutto. Un valore può sembrare sbagliato solo perché è comparso all'ora sbagliata, nel giorno sbagliato o dopo la sequenza sbagliata. La decomposizione stagionale e ARIMA sono pensati proprio per questo problema.
Questi metodi usano l'aspettativa temporale come evidenza. Si chiedono che cosa dovrebbe succedere dopo, dato lo storico della serie.
Il panorama dei benchmark mostra perché una scelta attenta del metodo è importante. ADBench ha valutato 30 algoritmi di rilevamento delle anomalie su 57 dataset, e l'UCR Time Series Anomaly Archive mette a disposizione 250 serie temporali selezionate per la ricerca, a conferma che la scelta dell'algoritmo dipende fortemente dalle caratteristiche del dataset (panoramica del benchmark ADBench e dell'archivio UCR).
Che cosa cercano
La decomposizione stagionale separa una serie in trend, stagionalità e componente residua. ARIMA modella direttamente la dipendenza temporale. Entrambi sono utili quando l'anomalia non è semplicemente “alta” o “bassa”, ma “inattesa per questo momento”.
Questo conta nelle operazioni reali. Un caricamento batch notturno che non arriva nei tempi previsti è un problema di tempestività. Un picco di attività dei clienti in un giorno festivo può essere normale se stagionalità e contesto degli eventi sono modellati correttamente. Un calo dei ricavi in un fine settimana tranquillo potrebbe non meritare un'escalation.
Questa famiglia di metodi è particolarmente rilevante per le anomalie collettive e di sottosequenza. Una recente rassegna osserva che molti incidenti in produzione non sono punti isolati ma anomalie collettive o di sottosequenza, e mette in evidenza il divario pratico nella scelta del metodo per casi come caricamenti in ritardo, schema drift e comportamenti delle pipeline su più segnali (rassegna sul rilevamento degli spostamenti sistemici e sui dati di osservabilità). Se lavorate al monitoraggio della consegna dei dati, questo divario vi suonerà familiare.
Un riferimento utile per l'implementazione è questa guida al rilevamento delle anomalie nelle serie temporali.
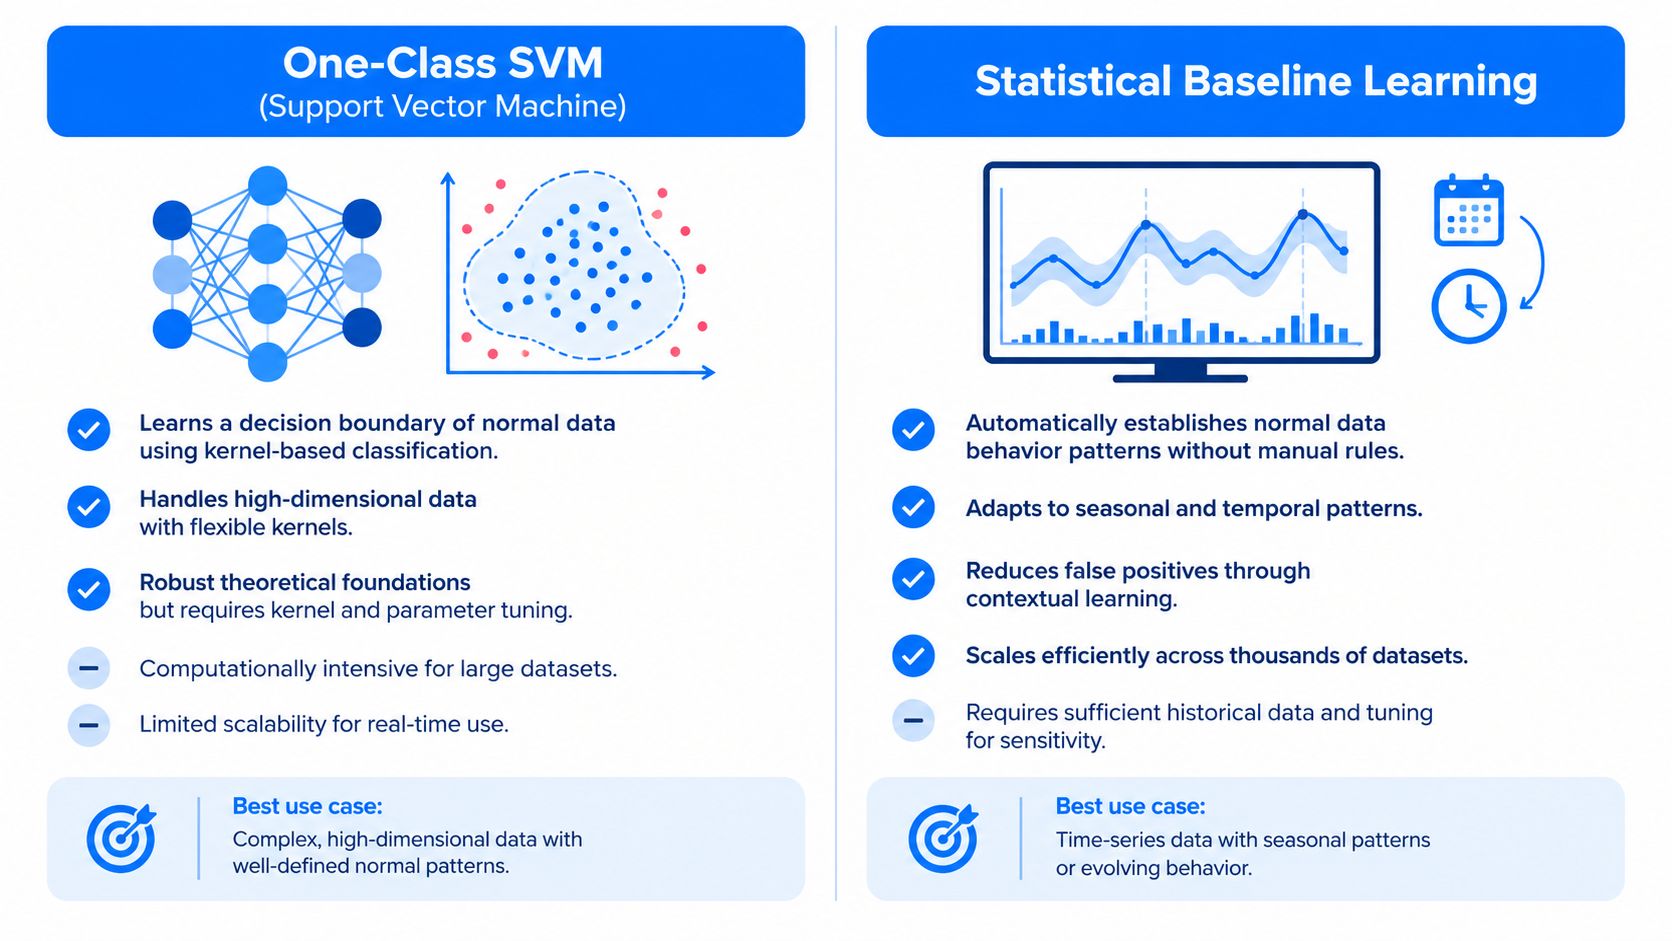
Ideali per la data observability
Questi metodi sono spesso la risposta giusta per:
Caricamenti mancanti o in ritardo: le finestre di arrivo attese contano più dei valori grezzi
Metriche di business stagionali: pattern giornalieri, settimanali o mensili determinano il comportamento normale
Derive nei processi ricorrenti: scostamenti graduali dalle tempistiche o dai volumi storici
Una pipeline in ritardo è spesso un'anomalia collettiva, non puntuale. I metodi che tengono conto del tempo la individuano prima delle soglie statiche.
8. Distanza di Mahalanobis
La distanza di Mahalanobis è uno degli strumenti statistici multivariati più utili, eppure molti team la trascurano. Misura quanto un punto è lontano dal centro dei dati tenendo conto di scala e correlazione.
Quest'ultimo aspetto è importante. Se due variabili di solito si muovono insieme, un record può sembrare perfettamente normale su ogni singola colonna ed essere comunque strano come combinazione.
Perché la correlazione cambia la risposta
Supponiamo che crescita dei ricavi, margine e rapporto di indebitamento seguano di solito una relazione nota per un certo segmento. Il record di un'azienda con valori ordinari su ogni metrica può comunque violare il consueto pattern multivariato. La distanza di Mahalanobis fa emergere questa incongruenza in modo più efficace della semplice distanza euclidea.
Questo la rende utile in finanza, nelle operazioni cliniche e nel monitoraggio della qualità dei dati. Un record sanitario può presentare valori singolarmente plausibili che, combinati, creano un profilo non plausibile. Una piattaforma dati può osservare metriche di qualità accettabili prese singolarmente ma sospette nel loro insieme.
Quando usarla
La distanza di Mahalanobis è un'ottima via di mezzo tra statistica semplice e machine learning completo. Resta interpretabile, ma gestisce la struttura multivariata meglio delle soglie per singola colonna.
Funziona meglio quando:
Le variabili sono correlate: la covarianza contiene informazioni utili
Vi servono controlli multivariati spiegabili: gli analisti possono verificare quali relazioni sono cambiate
I dati sono strutturati: le metriche stabili spesso si prestano meglio dei flussi di eventi grezzi
Le stime di covarianza possono diventare instabili in contesti rumorosi o ad alta dimensionalità. Una stima della covarianza per segmento e la segmentazione spesso ne migliorano l'affidabilità.
9. Validazione basata su regole e deterministica
Il consiglio più trascurato nel rilevamento delle anomalie è questo: se il business sa già che una condizione è inaccettabile, non addestrate un modello per riscoprirla.
La validazione basata su regole usa una logica esplicita. I campi obbligatori devono essere valorizzati. I valori di riferimento devono corrispondere a elenchi approvati. Le date devono rispettare vincoli di sequenza. Le condizioni normative devono essere rispettate esattamente. Non si tratta di un monitoraggio “all'antica”: è la forma di evidenza più chiara che si possa avere.
Il tipo di segnale più forte
Le regole usano una conoscenza di business esplicita anziché pattern dedotti. Se un file sanitario deve includere identificativi obbligatori, non serve a nulla chiedere a un modello statistico se gli identificativi mancanti sembrino insoliti: sono non validi. Se un processo finanziario richiede che gli importi restino entro un intervallo definito dalla policy, il controllo principale è un controllo deterministico.
Ecco perché i metodi basati su regole restano essenziali negli ambienti regolamentati e nei workflow di reporting critici. Offrono ai team piena verificabilità e un comportamento operativo stabile.
Esempi:
digna Data Validation: controlli a livello di record rispetto alle regole di business
Servizi finanziari: controlli legati a policy o vincoli normativi
Sanità: completezza dei campi obbligatori e coerenza logica
Settore pubblico: applicazione, pronta per l'audit, delle condizioni richieste sui dati
Dove finiscono le regole
Le regole sono precise, ma intercettano solo ciò che qualcuno ha pensato di definire. Non rileveranno un mix di clienti insolito, una deriva sottile di una metrica o una baseline che si sposta nei tempi di arrivo.
Rassegne recenti sottolineano che la valutazione pratica del rilevamento delle anomalie ha ancora bisogno di linee guida migliori in presenza di vincoli di privacy, deployment, spiegabilità e operatività, mentre la ricerca sull'osservabilità continua a evidenziare la difficoltà di ridurre il rumore su log, trace e metriche con un'automazione affidabile (rassegna sul rilevamento delle anomalie operativo, spiegabile e attento al deployment). La validazione deterministica aiuta a creare fiducia perché i team possono vedere esattamente quale condizione non è stata rispettata.
Usate le regole per:
Requisiti di business noti
Controlli di compliance e audit
Campi e record ad alto rischio
Percorsi di escalation chiari
Confronto tra 9 metodi di rilevamento delle anomalie
Metodo | 🔄 Complessità di implementazione | ⚡ Requisiti di risorse | 📊 Risultati attesi | 💡 Casi d'uso ideali | ⭐ Vantaggi principali |
|---|---|---|---|---|---|
Apprendimento statistico della baseline | Moderata, configurazione automatizzata, taratura della sensibilità | Bassi–medi, richiede dati storici, calcolo modesto | Rilevamento delle anomalie sensibile al contesto con meno falsi positivi | Monitoraggio continuo di KPI e qualità dei dati, metriche stagionali | Si adatta automaticamente a trend e stagionalità; scalabile; valore in tempi rapidi |
Isolation Forest | Moderata, addestramento degli alberi e tuning dei parametri | Bassi–medi, efficiente su dati grandi o ad alta dimensionalità | Rilevamento multivariato efficace in alta dimensionalità | Rilevamento delle frodi, dataset operativi ad alta dimensionalità | Efficiente, robusto rispetto alle feature irrilevanti, nessuna metrica di distanza necessaria |
Z-score e deviazione standard | Bassa, semplici calcoli statistici | Minimi, calcolo trascurabile | Segnalazioni di outlier rapide e interpretabili su singola metrica | Numero di righe, soglie su singola metrica, monitoraggio di primo livello | Estremamente rapido, trasparente, facile da verificare e implementare |
Local Outlier Factor (LOF) | Moderata–alta, scelta dei vicini e della metrica di distanza | Medi–alti, costoso con campioni grandi o alta dimensionalità | Rileva scostamenti di densità locale e outlier specifici dei cluster | Dataset con densità variabili o anomalie dipendenti dai cluster | Coglie il contesto locale; nessuna ipotesi di distribuzione globale |
Reti neurali autoencoder | Alta, progettazione dell'architettura e tuning degli iperparametri | Alti, GPU, utile un ampio set di addestramento etichettato/pulito | Rileva anomalie complesse non lineari tramite l'errore di ricostruzione | Pattern complessi ad alta dimensionalità, dati multisensore o temporali | Modella relazioni non lineari; scalabile su set di feature complessi |
One-Class SVM | Alta, scelta del kernel e tuning dei parametri | Medi–alti, memoria e calcolo crescono con la dimensione dei dati | Rilevamento basato su un confine; sensibile a normalizzazione e kernel | Dataset con una regione normale coesa e anomalie al di fuori | Confini decisionali flessibili con solide basi teoriche |
Decomposizione stagionale e ARIMA | Moderata, scelta dei parametri stagionali/ARIMA | Bassi–medi, richiede serie storiche lunghe | Componenti di trend/stagionalità interpretabili e anomalie previste | Serie temporali con forte stagionalità, tempestività delle pipeline | Pensato per dati temporali; decomposizione e previsioni chiare |
Distanza di Mahalanobis | Bassa–moderata, stima e inversione della covarianza | Bassi–medi, richiede campioni sufficienti per dimensione | Punteggi di outlier multivariati che tengono conto delle correlazioni | Controlli e monitoraggio di qualità multivariati su variabili correlate | Tiene conto di covarianza e scala; efficace per variabili correlate |
Validazione basata su regole e deterministica | Alta, scrittura e manutenzione manuale delle regole | Medi, impegno umano; calcolo ridotto | Esiti deterministici superato/non superato con piena verificabilità | Controlli normativi/di compliance e regole di business critiche | Pienamente trasparente, verificabile, applicazione esatta della logica di business |
Scegliete il metodo adatto al segnale
Il modo più pratico per comprendere i tipi di rilevamento delle anomalie è smettere di trattarli come fazioni rivali. Sono modi diversi di raccogliere evidenze.
Usate gli z-score quando una metrica è semplice, stabile e facile da sintetizzare con media e dispersione. Usate l'apprendimento della baseline quando il comportamento del dataset cambia nel tempo ma forma comunque un pattern atteso. Usate la decomposizione stagionale o ARIMA quando contano tempistiche, trend e ricorrenze, soprattutto per caricamenti mancanti, ritardi di consegna e attività di business con un ritmo giornaliero o settimanale. Usate LOF e la distanza di Mahalanobis quando il contesto deriva dai punti vicini o da variabili correlate. Usate Isolation Forest, One-Class SVM o gli autoencoder quando i dati non sono etichettati, sono multivariati e troppo complessi per una logica statica.
Il panorama dei metodi riflette questa varietà. Il rilevamento delle anomalie nelle serie temporali viene comunemente classificato in apprendimento non supervisionato, supervisionato e semi-supervisionato, e la stessa letteratura raggruppa i metodi nelle famiglie di previsione, ricostruzione, distanza, codifica, vicinato e probabilistica (panoramica VLDB delle famiglie di metodi di rilevamento delle anomalie nelle serie temporali). Un utile promemoria: la scelta dell'algoritmo deve partire dal segnale, non dal modello preferito.
Anche la direzione del mercato punta verso combinazioni operative più che verso strumenti isolati. Una previsione di settore stima che il mercato del rilevamento delle anomalie crescerà da 4,28 miliardi di USD nel 2024 a 9,25 miliardi di USD entro il 2032, e attribuisce la leadership nell'adozione del 2025 al software, con una quota dell'81,6%, e al deployment in cloud, con una quota del 72,8% (previsione del mercato del rilevamento delle anomalie). Questo non significa che ogni team debba correre verso uno stack solo cloud. Dimostra però che il rilevamento delle anomalie scalabile e orientato alla produzione è entrato nelle operazioni aziendali di tutti i giorni.
Per la data observability, la configurazione più solida di solito combina più metodi. Una regola deterministica può scartare i record impossibili. Un modello di baseline può rilevare derive graduali nel numero di righe o nei valori. Un rilevatore di tempestività può individuare i caricamenti in ritardo. Un monitor dello schema può intercettare le modifiche strutturali prima che i consumatori a valle vadano in errore. Questo design a livelli rispecchia il modo in cui si verificano gli incidenti: pochi guasti in produzione si annunciano con un unico segnale perfetto.
digna è un esempio concreto di questo approccio combinato. La sua piattaforma gira all'interno dell'ambiente del cliente e riunisce rilevamento delle anomalie basato sull'AI, validazione a livello di record, monitoraggio della tempestività, tracciamento dello schema, monitoraggio delle metriche di business e di piattaforma ed esecuzione in-database. Questa combinazione è importante per i team che hanno bisogno sia di un rilevamento adattivo sia di un'applicazione delle regole controllata e verificabile.
Usate questa checklist prima di scegliere un metodo:
Definite chiaramente l'anomalia: è un problema puntuale, contestuale, collettivo, univariato o multivariato?
Verificate lo storico dei dati: avete abbastanza storico pulito per apprendere il comportamento normale?
Misurate i falsi positivi: chi esaminerà gli alert e quale livello di rumore è accettabile?
Assegnate la responsabilità della risposta: quale team indaga su derive, regole non superate o ritardi di consegna?
Rivedete dopo ogni modifica di processo: riaddestrate, ricalibrate o riscrivete i controlli quando cambiano prodotti, pipeline o pianificazioni
Il metodo giusto è quello che si adatta al segnale, ai dati e alla realtà operativa che li circonda.
digna offre ai team dati un modo modulare per applicare questi approcci di rilevamento delle anomalie in produzione, dall'apprendimento della baseline basato sull'AI alla validazione deterministica, al monitoraggio della tempestività e al tracciamento dello schema. Poiché gira all'interno dell'ambiente del cliente ed esegue i controlli in-database, è adatta ai team che hanno bisogno di osservabilità con un forte controllo sugli spostamenti dei dati e sui workflow di revisione. Se corrisponde alla vostra configurazione, visitate digna.
Scegliere un metodo è la metà facile; mantenerlo calibrato mentre i dati cambiano è il vero lavoro, ed è lì che il monitoraggio continuo della qualità dei dati si guadagna il suo posto.
Domande frequenti
Da dove dovrebbe partire davvero il rilevamento delle anomalie?
Dalla giusta definizione di normalità, non dagli algoritmi. La maggior parte dei consigli parte dal metodo, ed è l'approccio sbagliato: lo stesso scostamento può essere un incidente in un dataset e una stagionalità attesa in un altro, e nessun modello risolve questa questione al posto vostro.
Qual è la differenza tra baseline statistiche e Isolation Forest?
L'apprendimento statistico della baseline modella il comportamento atteso a partire dallo storico e segnala gli scostamenti. Isolation Forest invece isola i punti facili da separare dal resto, un approccio che scala bene sui dati ad alta dimensionalità ma offre meno intuizione sul perché un punto sia stato segnalato.
Quando conviene usare gli z-score anziché i metodi basati sulla densità?
Gli z-score sono adatti a distribuzioni su singola variabile approssimativamente normali, in cui lo scostamento dalla media è significativo. Il Local Outlier Factor si guadagna il suo posto quando la densità conta: quando un punto è normale a livello globale ma insolito rispetto ai suoi vicini immediati, cosa che gli z-score non possono vedere.
Quali metodi sono adatti ai dati in serie temporale?
La decomposizione stagionale e ARIMA, perché separano trend e stagionalità dalla componente residua e cercano gli scostamenti in ciò che resta. Si adattano bene alla data observability, dove un picco di lunedì è routine e lo stesso picco di mercoledì no.
I controlli basati su regole contano ancora accanto al ML?
Sì: la validazione deterministica è il tipo di segnale più forte, perché è spiegabile e verificabile in un modo in cui il punteggio di un modello non lo è. Le regole finiscono dove iniziano le incognite sconosciute, ed è proprio lì che subentrano i metodi comportamentali.


