Piattaforma di AI governance: capacità chiave e controlli sui dati
|
6
min di lettura

Il consiglio più diffuso su una piattaforma di AI governance è sbagliato in partenza. Ai team si dice di iniziare da policy, approvazioni e checklist dei framework, sperando che il livello operativo segua in un secondo momento. Nella pratica, la governance fallisce quando si ferma alla documentazione e non arriva mai ai dati, al runtime e alla traccia di evidenze che dimostra che i controlli funzionano ancora dopo il deployment.
Una piattaforma di AI governance efficace non è una cartella di standard né una coda di ticket per le approvazioni. È un livello operativo che mantiene chiare le responsabilità, aggiornate le misurazioni e attivi i percorsi di escalation mentre modelli, agenti e pipeline di dati continuano a cambiare. Per questo le implementazioni più solide somigliano meno a repository statici di compliance e più a sistemi di osservabilità permanenti legati alle decisioni sul rischio.
Indice
Ridefinire la piattaforma di AI governance
Il primo errore è considerare la governance qualcosa da completare prima del lancio. L'AI RMF 1.0 del NIST è stato pubblicato il 26 gennaio 2023 come framework volontario e intersettoriale costruito attorno a Govern, Map, Measure e Manage, seguito il 30 marzo 2023 da un Playbook di accompagnamento sviluppo del NIST AI RMF. Questa struttura è importante perché inquadra la governance come un modello operativo continuo, non come un'approvazione una tantum.
La governance deve sopravvivere alla produzione
Una piattaforma che si limita ad archiviare policy non può dimostrare nulla sul comportamento in runtime. Non può indicare chi è responsabile di un modello in produzione, quali dati ha consumato, se gli output hanno subito una deriva o quando un intervento umano ha modificato il risultato. Sono proprio le domande che prima o poi pongono autorità di vigilanza, auditor e team interni di gestione del rischio, e richiedono evidenze con marca temporale, non un PDF con le policy.
Regola pratica: se un controllo non può essere monitorato dopo il deployment, è una dichiarazione di intenti, non un controllo.
Il modello della piattaforma deve preservare le responsabilità, mantenere aggiornati gli inventari, registrare gli incidenti, validare i dati e conservare le evidenze di audit come parte dell'operatività quotidiana. Per i team multinazionali, l'impostazione volontaria e tecnologicamente neutrale del NIST offre inoltre un modello di controllo interno comune, applicabile in diverse giurisdizioni.
Che cosa fa nella pratica una piattaforma di osservabilità è rilevante qui, perché AI governance e osservabilità affrontano lo stesso schema di guasto da angolazioni diverse. Una definisce le responsabilità, l'altra dimostra che cosa è successo. Una vera piattaforma deve fare entrambe le cose.
Le capacità chiave della AI governance moderna
Le quattro funzioni del NIST contano solo quando la piattaforma le trasforma in controlli che operano ogni giorno. Govern significa responsabilità, policy e accountability. Map significa conoscere scopo previsto, classe di rischio, utenti interessati e dipendenze. Measure significa testare il comportamento con metodi documentati. Manage significa gestire escalation, rimedi e conservazione delle evidenze PDF del NIST AI RMF.
Che cosa deve collegare la piattaforma
Un sistema maturo collega ogni modello in produzione al suo scopo previsto, al responsabile, alla classificazione del rischio, alla data lineage, ai risultati delle valutazioni, ai limiti noti e allo stato delle azioni correttive. Questo collegamento trasforma l'inventario AI in un registro operativo invece che in un foglio di calcolo. Senza di esso, i team non riescono a rispondere rapidamente a una domanda di base: questo modello può continuare a funzionare nel contesto attuale?
La misurazione è altrettanto importante. Il NIST afferma che la misurazione del rischio AI può essere quantitativa, qualitativa o mista, e dovrebbe includere test del software, valutazione delle prestazioni, documentazione dell'incertezza, confronto con benchmark e reporting formale. In termini di piattaforma, ciò significa registri versionati, pipeline di valutazione ripetibili, alert basati su soglie e workflow di revisione che restano attivi dopo il deployment.
Una piattaforma che non misura mai la deriva dopo il lancio finirà per confondere la stabilità con la fortuna.
La telemetria di produzione deve includere segnali su cui la governance può agire, come proxy di accuratezza, indicatori di deriva, errori di resilienza, tempi di risposta e tassi di override. Questi segnali dovrebbero essere associati a tolleranze predefinite e a procedure di escalation. Lo scopo non è creare più dashboard, ma rendere ogni alert riconducibile a un responsabile e a un percorso di risposta.
Per l'aspetto della misurazione, incluso come distinguere una vera deriva del modello dalle modifiche ai dati a monte, consultate la nostra guida pratica al rilevamento della model drift.
I controlli di osservabilità della data quality si inseriscono naturalmente in questo livello, perché monitorare i modelli senza monitorare i dati lascia un punto cieco. La maggior parte dei guasti in runtime nasce a monte, nei record, negli schemi o nella tempestività, non nell'algoritmo stesso. La piattaforma deve vedere entrambi.
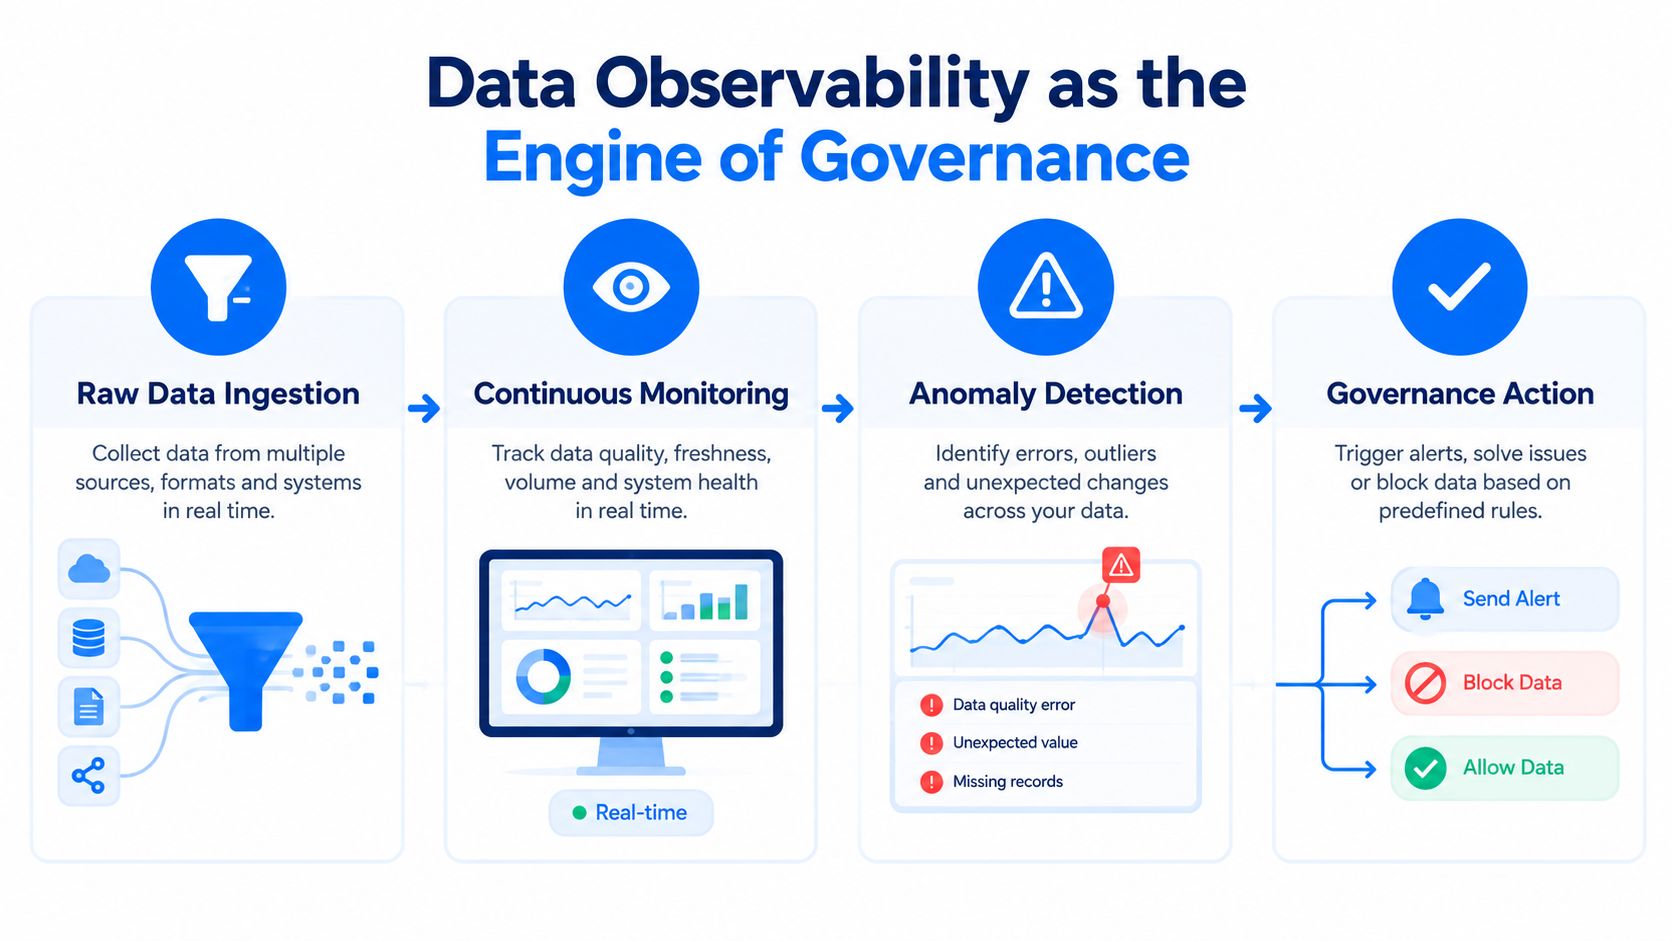
La data observability come motore della governance
Il modo più chiaro di pensare al rischio dei modelli è smettere di dare subito la colpa al modello. Negli ambienti regolamentati, il problema nasce spesso dai dati che lo alimentano e si manifesta più tardi come una previsione errata, una decisione sbagliata o una lacuna nell'audit. Per questo le piattaforme di governance hanno bisogno di osservabilità in-database, non solo di moduli di revisione dei modelli.
Perché contano le modifiche ai dati a monte
L'articolo 16 dell'AI Act europeo richiede documentazione, registrazioni, monitoraggio e meccanismi di controllo che consentano alle autorità di valutare la conformità, mentre i sistemi ad alto rischio necessitano anche di una documentazione tecnica che copra prestazioni, limiti, evidenze dei test e strategia di monitoraggio Articolo 16 dell'AI Act europeo. Se i dati sottostanti cambiano e la piattaforma non se ne accorge, la documentazione diventa obsoleta anche se il codice del modello non è mai cambiato. È un fallimento della governance, non un semplice disagio per il team dati.
I controlli pratici sono semplici, ma devono essere eseguiti in modo continuo. Il tracciamento degli schemi intercetta campi aggiunti, rimossi o modificati prima che report o modelli a valle li utilizzino. Il monitoraggio della tempestività individua caricamenti mancanti, arrivi in ritardo e anomalie nelle consegne. La validazione a livello di record intercetta violazioni delle regole di business che i benchmark sintetici non fanno emergere. Quando questi controlli vengono eseguiti nell'ambiente del cliente e all'interno del database, i record di produzione restano dove sono e la catena delle evidenze rimane intatta.
Perché l'esecuzione in-database cambia il modello delle evidenze
Questa distinzione è importante nei settori regolamentati, soprattutto quando la governance deve dimostrare che cosa è successo senza copiare dati sensibili in un'altra piattaforma. L'esecuzione in-database riduce gli spostamenti, preserva la residenza dei dati e mantiene le evidenze dei controlli più vicine alla fonte. Rende inoltre più credibile la validazione continua, perché i controlli vengono eseguiti dove risiedono i dati, non su estrazioni obsolete.
Un'analisi indipendente riportata dalla MIT Sloan Management Review ha stimato che la scarsa qualità dei dati può costare alla maggior parte delle aziende tra il 15% e il 25% del fatturato, mentre solo il 3% delle raccolte di dati esaminate rientrava in un margine di errore accettabile, quasi il 50% dei record appena creati conteneva errori critici e i knowledge worker potevano dedicare fino al 50% del loro tempo a problemi di routine legati alla qualità dei dati MIT Sloan Management Review. Questi dati spiegano perché la governance deve sorvegliare in modo continuo record operativi, dataset analitici e pipeline.
Il framework di data observability è importante perché la catena delle evidenze deve mostrare dati di origine, versione del modello, contesto di deployment, eventi di monitoraggio, incidenti e azioni correttive come un unico record collegato. Nella pratica, questo evita che la documentazione di compliance si allontani dalla realtà.
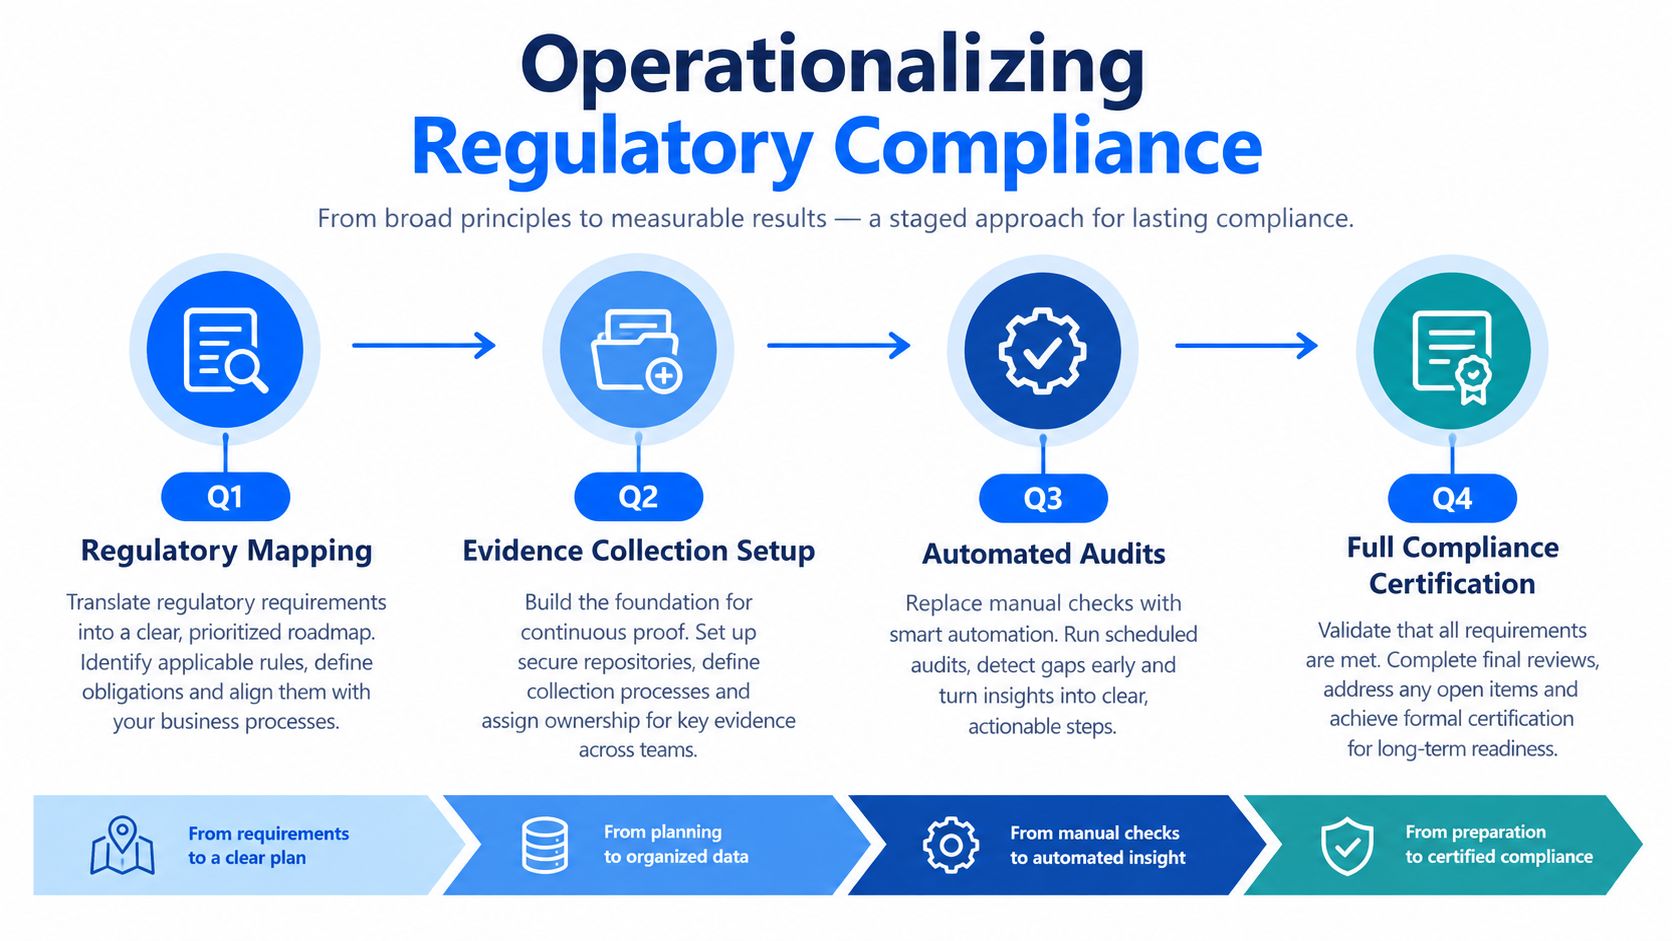
Rendere operativi compliance normativa ed evidenze
L'AI Act europeo trasforma la governance in una disciplina operativa, non in un promemoria sulle policy. È entrato in vigore il 1° agosto 2024, con obblighi scaglionati che si sono applicati dal 2 febbraio 2025 e dal 2 agosto 2025 e che si applicheranno dal 2 agosto 2026, dal 2 agosto 2027, dal 2 dicembre 2027 e dal 2 agosto 2028 a seconda dell'obbligo e della classe del sistema calendario dell'AI Act europeo. Questa sequenza obbliga i team a integrare controlli, tracce di evidenze e finestre di rivalutazione nella piattaforma stessa.
Trasformare le scadenze in cicli di controllo
La mossa pratica è trattare ogni scadenza normativa come un trigger di workflow. La classificazione viene per prima, perché l'organizzazione deve sapere se un sistema è di uso generale, ad alto rischio o soggetto a obblighi di trasparenza. La piattaforma può quindi associare a quella classe la documentazione richiesta, le evidenze dei test e la cadenza di revisione.
Per i sistemi ad alto rischio, l'articolo 10 richiede che i dataset di addestramento, validazione e test siano pertinenti, sufficientemente rappresentativi e, nella misura del possibile, privi di errori e completi rispetto allo scopo previsto Articolo 10 dell'AI Act europeo. Una piattaforma di governance ha quindi bisogno di versioni immutabili dei dataset, registrazioni della provenienza, risultati dei test di data quality, analisi per sottogruppi o scenari ove opportuno e una chiara cronologia delle modifiche. Una valutazione una tantum non resisterà alla deriva dei dati a monte.
La compliance diventa fragile nel momento in cui le evidenze vivono in email, fogli di calcolo ed esportazioni improvvisate.
Lo schema più solido è una catena di evidenze che parte dai dati di origine e termina con l'azione correttiva. Ogni rilascio di un modello dovrebbe riportare la versione del dataset, le mitigazioni approvate, il protocollo di valutazione e lo stato del monitoraggio. Ogni incidente dovrebbe ricollegarsi al caso d'uso interessato, alla modifica dei dati o del modello che lo ha preceduto e alla decisione presa dal team responsabile.
I team che cercano un modo pratico per preparare i workflow di sviluppo alla revisione possono usare questo approccio per anticipare la preparazione all'audit nel ciclo di delivery, prima che le evidenze si frammentino tra sistemi diversi. Il vantaggio è meno rilavorazione quando governance e ingegneria condividono la stessa traccia di controllo.
Il supporto ai workflow di compliance per la AI governance trova posto qui, perché la compliance scala solo quando le evidenze vengono generate durante l'operatività, non ricostruite a posteriori. Se la piattaforma non riesce a mantenere la tracciabilità tra eventi di dati, modelli e deployment, la documentazione diventerà obsoleta prima del successivo ciclo di revisione.
Governare l'AI agentica senza creare colli di bottiglia
Gli agenti autonomi mettono in luce il punto più debole della maggior parte dei programmi di governance: la coda delle approvazioni. Un organo di revisione centralizzato può gestire una manciata di lanci di modelli, ma va in sovraccarico quando gli agenti iniziano a invocare strumenti, concatenare azioni e modificare i propri percorsi di esecuzione. La risposta non sono più riunioni, ma un migliore controllo in runtime.
Che cosa deve includere la supervisione continua
La telemetria minima per i sistemi agentici è diversa dal monitoraggio di modelli statici. La governance deve tracciare permessi, utilizzo degli strumenti, interventi umani, obiettivi che cambiano e le evidenze delle decisioni lungo i passaggi del workflow. Deve inoltre distinguere le azioni a basso rischio che possono procedere automaticamente da quelle che richiedono un'escalation.
Deloitte riporta che solo un'azienda su cinque dispone di un modello di governance maturo per gli agenti AI autonomi, mentre il sondaggio di SAP ha rilevato che il 38% non dispone di processi human-in-the-loop per la supervisione degli agenti Deloitte, State of AI in the Enterprise. Questi numeri corrispondono a ciò che molti team di piattaforma vedono nella pratica: troppa capacità di revisione viene spesa per approvare attività di routine, mentre troppo poca attenzione va al comportamento in runtime.
Un design migliore utilizza controlli basati su soglie. Le azioni a basso rischio possono procedere automaticamente finché restano entro i limiti delle policy approvate. Le azioni a rischio più elevato attivano revisione umana, logging ed escalation. Questa struttura preserva la velocità senza trasformare il team di governance in un collo di bottiglia permanente.
Perché l'osservabilità batte l'approvazione centralizzata
L'AI agentica cambia contesto rapidamente. Un workflow sicuro ieri può diventare rischioso quando cambia un permesso su uno strumento, si sposta una fonte dati o un obiettivo viene riscritto. I tradizionali comitati di approvazione raramente vedono questi cambiamenti in tempo. L'osservabilità in runtime sì, perché sorveglia la configurazione attiva, i dati in ingresso e le azioni che ne risultano.
La governance degli agenti funziona quando la piattaforma può mostrare chi ha fatto cosa, con quali permessi, su quali dati e secondo quale regola di fallback.
È anche qui che la data observability diventa più di un optional. Se un agente consuma dati obsoleti, malformati o incompleti, l'output di business può sembrare intenzionale pur essendo sbagliato. Monitorare output di business insoliti, variazioni nella tempestività e modifiche agli schemi fornisce alla governance il contesto necessario per decidere se l'agente debba continuare a funzionare.
Deployment e sicurezza per i settori regolamentati
Nei settori finanziario, sanitario, delle telecomunicazioni e nel settore pubblico, la posizione del deployment fa parte della progettazione dei controlli. Se una piattaforma di governance richiede che i dati di produzione escano dall'ambiente del cliente, l'architettura è già in contrasto con i requisiti di residenza, riservatezza ed evidenza. Lo schema più sicuro è eseguire i controlli all'interno del cloud, della VPC o del data center del cliente.
Perché lo spostamento dei dati cambia il rischio
Una piattaforma che accede ai dati di produzione tramite API esterne o elaborazione remota eredita gli oneri di compliance dei dati che vede. Questo può complicare contemporaneamente la revisione di sicurezza, la revisione privacy e il procurement. Al contrario, l'esecuzione nell'ambiente mantiene locali i record sensibili e riduce il raggio d'impatto dello strumento di governance stesso.
digna è un'opzione di piattaforma che viene eseguita nell'ambiente del cliente con elaborazione in-database, in linea con il modello di deployment privato richiesto da molti team regolamentati. Il punto importante non è il marchio, ma lo schema di deployment, perché le evidenze di governance sono affidabili solo quanto il sistema che le ha raccolte.
Anche l'architettura dovrebbe essere modulare. Raramente i team hanno bisogno di tutti i controlli fin dal primo giorno, e imporre un rollout completo della piattaforma può rallentarne l'adozione. Un licensing stabile rispetto all'utilizzo è utile quando l'obiettivo è partire da un singolo ambito di controllo ed espandersi man mano che il programma matura, senza riprogettare il procurement ogni volta che emerge un nuovo caso d'uso.
I controlli di protezione dei dati dei clienti sono importanti perché gli stessi strumenti di governance possono diventare soggetti rilevanti ai fini della compliance se si trovano troppo vicini ai record di produzione. Negli ambienti regolamentati questo rischio non è teorico: incide su come la piattaforma viene implementata, revisionata e sottoposta ad audit.
Costruire la vostra roadmap di AI governance
La via più rapida per uscire da una governance frammentata è partire contemporaneamente da inventario e telemetria. Se documentate soltanto i sistemi, vi sfugge il comportamento in runtime. Se monitorate soltanto il comportamento in runtime, vi sfuggono accountability, classificazione e responsabilità. Una roadmap seria deve unire entrambi.
Partite da ciò che potete dimostrare
Iniziate assegnando un responsabile per ogni caso d'uso, non per ogni modello. Registrate poi per ciascun caso d'uso le fonti dati, lo scopo previsto, la classe di rischio e il processo di business a valle. A partire da qui, definite quali evidenze devono esistere quando il sistema funziona normalmente, quando subisce una deriva e quando si guasta.
Aggiungete poi i controlli che rendono visibili i cambiamenti. Il monitoraggio degli schemi intercetta le rotture strutturali. Il monitoraggio della tempestività individua dati in ritardo o mancanti. Le regole di validazione intercettano le violazioni delle regole di business. I workflow di gestione degli incidenti conservano che cosa è successo e chi è intervenuto. Questi quattro elementi offrono alla governance una base fattuale invece di una ricostruzione narrativa.
Se una revisione di governance dipende dal fatto che le persone ricordino che cosa è successo, il sistema è troppo debole per essere affidabile.
L'ultimo passo è la progettazione dell'escalation. I problemi di bassa gravità dovrebbero essere instradati automaticamente ai responsabili operativi. Quelli di alta gravità dovrebbero sospendere il deployment, aprire una revisione e preservare la traccia delle evidenze. In questo modo la governance resta attiva senza trasformarsi in un controllo manuale permanente.
Una piattaforma di AI governance pratica dovrebbe aiutare i team a mantenere gli inventari sempre aggiornati, allineare i controlli alle normative e documentare le modifiche senza dover cercare tra strumenti scollegati. Dovrebbe inoltre supportare il livello tecnico che dimostra che il comportamento di dati e modelli rientra ancora nelle tolleranze. È questa combinazione a rendere la governance verificabile, scalabile e utile.
Se volete passare dai documenti di policy alle prove in runtime, digna offre ai team dati il livello di osservabilità di cui la AI governance ha bisogno, con monitoraggio in-database, tracciamento degli schemi, validazione e controlli di tempestività all'interno dell'ambiente del cliente. Se volete collegare le evidenze sui dati ai workflow di governance senza spostare i record di produzione, visitate digna e valutate come si integra nel vostro stack di controllo dell'AI.
Domande frequenti
Che cos'è una piattaforma di AI governance?
È un livello operativo che mantiene attivi responsabilità, misurazione ed escalation dopo il deployment, non una cartella di policy. Collega ogni modello in produzione al suo scopo previsto, al responsabile, alla classe di rischio, alla data lineage, ai risultati delle valutazioni e allo stato delle azioni correttive, così che i team possano dimostrare che i loro controlli funzionano ancora in produzione.
Che relazione c'è tra il NIST AI RMF e una piattaforma di AI governance?
L'AI RMF 1.0 del NIST, pubblicato a gennaio 2023, organizza la gestione del rischio AI in quattro funzioni: Govern, Map, Measure e Manage. Una piattaforma le trasforma in controlli quotidiani - responsabilità e policy, classificazione del rischio e dipendenze, test documentati ed escalation con conservazione delle evidenze.
Perché la data observability è importante per la AI governance?
La maggior parte dei guasti in runtime nasce a monte, nei record, negli schemi o nei caricamenti in ritardo, e non nel modello stesso. Se i dati cambiano e nessuno se ne accorge, la documentazione del modello diventa obsoleta anche se il codice non è mai cambiato. Tracciamento degli schemi, monitoraggio della tempestività e validazione a livello di record mantengono aggiornate le evidenze.
Che cosa richiede l'AI Act europeo per i dati di addestramento e di test?
Per i sistemi ad alto rischio, l'articolo 10 richiede che i dataset di addestramento, validazione e test siano pertinenti, sufficientemente rappresentativi e, nella misura del possibile, privi di errori e completi. Nella pratica ciò significa versioni immutabili dei dataset, registrazioni della provenienza, risultati dei test di data quality e una chiara cronologia delle modifiche.
Come possono i team governare l'AI agentica senza rallentarla?
Sostituendo la coda centrale delle approvazioni con controlli basati su soglie. Le azioni a basso rischio entro i limiti delle policy approvate procedono automaticamente, mentre quelle a rischio più elevato attivano revisione umana, logging ed escalation. L'osservabilità in runtime di permessi, utilizzo degli strumenti, override e dati in ingresso mostra quando un workflow un tempo sicuro è diventato rischioso.


