Come valutare la qualità dei dati: guida pratica per i team
|
6
min di lettura

Si percepisce il calo della qualità dei dati molto prima che qualcuno apra un ticket. La dashboard si è aggiornata, la pipeline ha segnalato successo, eppure i numeri non tornano con finance, sales o con ciò che il business si aspettava. Di solito è in quel momento che i team capiscono che il problema non è se i dati sono arrivati, ma se ci si può fidare di loro.
La maggior parte dei team parte da controlli di freschezza e tassi di valori nulli perché sono facili da automatizzare. Questi controlli contano, ma non dicono se una colonna ha cambiato significato da un giorno all'altro, se una fonte ha iniziato a duplicare i record o se un dataset dall'aspetto pulito è comunque sbagliato per la decisione che supporta. Ecco perché valutare la qualità dei dati va trattato come un workflow diagnostico, non come una spia di stato, e perché un report errato può derivare anche da un caricamento “riuscito”.
Indice
Perché la maggior parte dei controlli di qualità dei dati non coglie il vero problema
Una mattina tipica inizia con una pipeline verde e un thread Slack rosso. Il caricamento è terminato, le tabelle del warehouse sono popolate e la dashboard dei ricavi sembra a posto a prima vista, finché qualcuno nota che il totale non torna perché una fonte ha cambiato il tipo di una colonna o una regola di business non corrisponde più al nuovo formato. La pipeline non è fallita, ma il livello decisionale sì.
È proprio questo divario il motivo per cui il successo della pipeline e la qualità dei dati non sono la stessa cosa. Un job completato dimostra solo che dei byte sono stati spostati, non che i record significhino ancora ciò che significavano ieri. Se i vostri controlli si fermano a freschezza e conteggio dei nulli, vi sfuggiranno problemi di accuratezza, contraddizioni tra tabelle e schema drift che compromettono il reporting a valle senza preavviso.
Regola pratica: se una metrica può essere sbagliata pur sembrando presente, le serve un controllo di qualità che vada oltre la semplice esistenza.
I team si scottano quando confondono la data observability con la valutazione della qualità. L'observability vi dice che qualcosa è cambiato nel flusso, mentre la valutazione chiede se i dati sono ancora adatti all'uso. La differenza conta negli ambienti regolamentati e nei workflow di AI, dove dati tecnicamente puliti possono comunque essere pericolosi sul piano operativo.
Il miglior modello mentale interno è semplice: dati presenti non significa dati affidabili. È questa la linea che i vostri alert devono difendere. Se state analizzando il divario tra dashboard rumorose e controlli su cui agire, questa prospettiva ricchi di dati, poveri di informazioni è un utile complemento, perché descrive esattamente la modalità di errore con cui molti team convivono ogni giorno.
Definire i dataset critici e le dimensioni della qualità
Decidete che cosa conta prima di scrivere anche un solo controllo. Non tutte le tabelle meritano lo stesso livello di attenzione e non tutti i campi comportano lo stesso rischio. Il perimetro giusto è l'intersezione tra impatto sul business e dipendenza a valle, quindi la prima domanda è sempre: “Che cosa si rompe se questo valore è sbagliato?”
In un ambiente regolamentato, delimiterei prima il dataset attorno ai workflow critici e poi individuerei gli attributi che controllano davvero quei workflow. Di solito si tratta di identificativi, timestamp, chiavi esterne, campi di stato, codici normativi e qualsiasi valore che confluisce in un KPI, un report o un modello. Una volta nominati, definite le sei dimensioni come requisiti misurabili, non come ideali astratti.
Dimensione | Che cosa misura | Tipo di soglia tipico | Esempio di errore |
|---|---|---|---|
Completezza | I valori obbligatori sono presenti | Rigida sui campi obbligatori, più flessibile sul testo facoltativo | Manca un ID cliente obbligatorio |
Unicità | I record non sono duplicati | Di solito tolleranza zero sui campi chiave | La stessa transazione arriva due volte |
Coerenza | I valori non si contraddicono tra sistemi o tabelle | Controlli di riconciliazione tra fonti | Lo stato dell'ordine differisce tra warehouse e fatturazione |
Validità | I valori rispettano formati, intervalli o regole consentiti | Superato o non superato in modo netto su pattern definiti | Un codice fiscale ha un formato errato |
Accuratezza | I valori corrispondono a dati di riferimento affidabili o alla realtà | Riconciliazione con fonti autorevoli | Un codice prodotto esiste, ma rimanda all'articolo sbagliato |
Tempestività | I dati sono abbastanza freschi per l'uso previsto | Finestre di freschezza o aspettative di consegna | Un file giornaliero arriva dopo la scadenza del reporting |
La trappola è ridurre tutto questo a un unico punteggio. Un dataset può essere quasi completo e comunque inutilizzabile se i valori validi sono sbagliati o obsoleti. Per questo le soglie dovrebbero essere ponderate in base al rischio, con tolleranza zero per qualcosa come un identificativo normativo non valido e una certa flessibilità per un campo descrittivo non essenziale.
Un buon documento di perimetro sta in una pagina. Se non sa dire quali tabelle contano, quali campi sono critici e perché ogni dimensione viene controllata, il programma scivolerà in un teatro di caselle spuntate.
Se vi serve un modo pratico per individuare i campi critici e collegarli a un responsabile, gli elementi di dati critici sono il punto di partenza giusto. Per i team che definiscono il perimetro insieme tra governance e ingegneria, questo allineamento evita molte discussioni a valle.
Applicare la metodologia di valutazione per fasi
Il modo più pulito per valutare la qualità dei dati è mettere in sequenza il lavoro, non improvvisarlo. L'ordine conta perché ogni fase alimenta la successiva e saltarne una trasforma l'intero processo in congetture. Iniziate dal profiling, poi definite le regole, impostate le soglie, eseguite le query e analizzate i risultati.

Profilare prima di prescrivere
Profilate prima il dataset. Osservate tassi di nulli, tassi di duplicati, intervalli di valori, formati e relazioni referenziali, perché questi pattern vi dicono dove si trovano i difetti reali. Senza questa baseline finirete per scrivere regole basate su supposizioni anziché su evidenze.
Poi traducete i requisiti in test specifici per la dimensione che state misurando. Un campo data ha bisogno di una regola di formato e di una regola di intervallo. Una chiave esterna ha bisogno di un controllo referenziale. Un codice normativo può richiedere un pattern rigoroso più una riconciliazione con la fonte di verità.
Impostare soglie che riflettano il rischio
Le soglie di avviso e di errore non dovrebbero coincidere. Un campo che alimenta una dashboard può tollerare un piccolo tasso di difetti, mentre un campo che guida il reporting di compliance di solito no. È su questa distinzione che falliscono troppi programmi, perché trattano ogni difetto allo stesso modo.
Calcolate i risultati a livello di record, campo, tabella e dominio, poi seguitene l'andamento nel tempo. Un singolo passaggio non dice quasi nulla. Un tasso di difetti in peggioramento vi segnala che una fonte è cambiata, che un contratto si è rotto o che un team a monte ha cambiato comportamento. È qui che la metodologia diventa operativa anziché decorativa.
L'obiettivo è intercettare presto il caso brutto, quello in cui un dataset è completo al 99% ma resta sostanzialmente sbagliato. Se vi serve un riferimento sulla terminologia di questo approccio, la definizione di valutazione della qualità dei dati è un utile complemento.
Campionamento, validazione e reporting onesto
Un risultato senza contesto è un rischio. Se avete campionato 100 record, non dovreste mai riportare la metrica come se derivasse da una scansione completa della popolazione, perché l'incertezza fa parte del risultato. Conservate numeratore, denominatore, finestra di osservazione, definizione della popolazione e metodo di campionamento per ogni metrica, poi riportate gli intervalli di confidenza quando il risultato è stimato da un campione, come sottolineano le linee guida di misurazione del NIST nella trattazione dell'incertezza (NIST SP 800-55).

Riportare la distribuzione, non solo il punteggio
Una stima di completezza basata su 100 record campionati non equivale alla stessa percentuale calcolata su 100.000 record. La prima può essere utile, ma è molto meno stabile e molto più facile da fraintendere. Monitorate media, deviazione standard, quantili e valori mancanti per segmento, così da vedere dove si concentra il problema.
Questa segmentazione conta perché i punteggi aggregati nascondono i guasti locali. Una tabella può sembrare a posto nel complesso mentre un paese, un sistema sorgente o un segmento di clienti sta crollando. Se non conservate la suddivisione, vi sfuggirà la causa principale operativa e perderete tempo a discutere del numero complessivo.
Non confondere le modalità di errore più comuni
La validità non è l'accuratezza. Un valore può avere il formato giusto ed essere comunque sbagliato. Anche i dati in ritardo non sono dati mancanti, e l'imputazione automatica può far sembrare migliore la completezza danneggiando la tracciabilità.
Per questo il report dovrebbe dichiarare l'incertezza, non nasconderla. Un buon risultato di qualità vi dice che cosa è stato controllato, come, quanto potete fidarvi e quali parti della popolazione richiedono attenzione.
Per i team che costruiscono la parte di acquisizione di questo workflow, sfogliare i blocchi di acquisizione dati è un riferimento utile per ragionare su disciplina e struttura degli input, soprattutto quando i sistemi sorgente sono disordinati. Il problema operativo di solito non è la matematica, ma ottenere input affidabili fin dall'inizio.
Potete anche mappare i controlli su regole esplicite e logiche di revisione con regole di validazione dei dati, controlli e data quality continua, ed è lì che il reporting smette di essere astratto e inizia a supportare una vera remediation.
Scegliere il giusto mix di strumenti e automazione
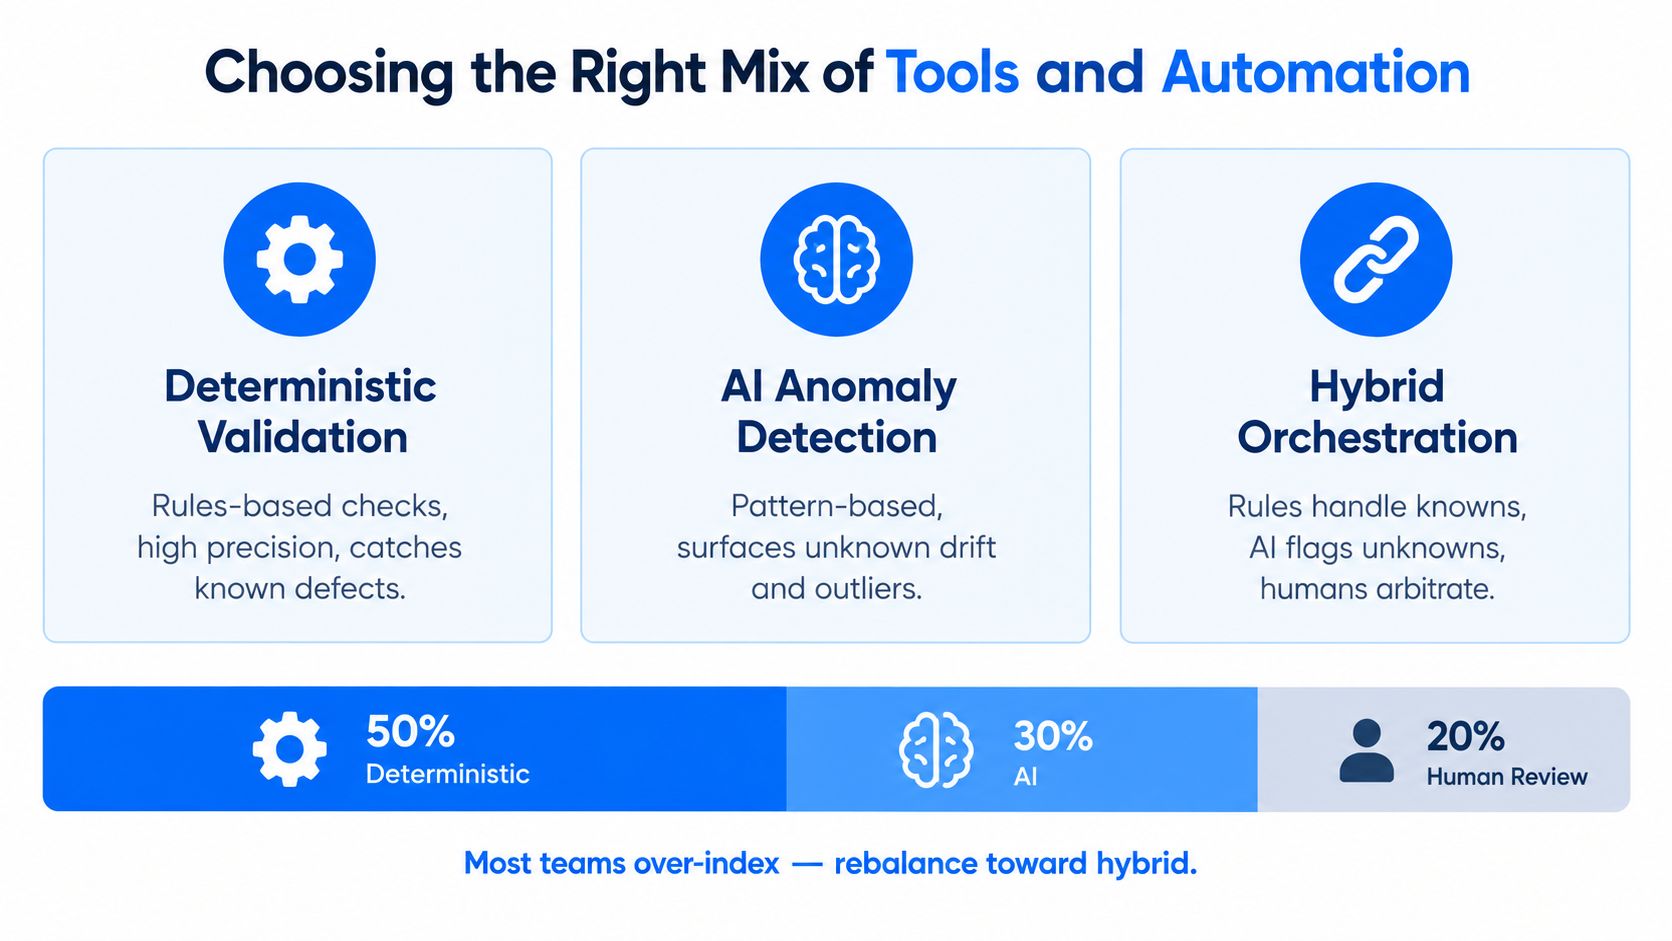
I buoni programmi non puntano tutto su un solo tipo di segnale. La validazione deterministica individua i difetti noti, la rilevazione di anomalie basata su AI individua pattern sconosciuti e i controlli di schema e tempestività intercettano i guasti silenziosi prima che si propaghino. Usate tutti e tre, ma assegnate a ciascuno il problema che gestisce meglio.
Abbinare il segnale alla modalità di errore
La validazione basata su regole è lo strumento giusto quando il requisito è esplicito e verificabile. Se un codice fiscale deve seguire un formato o una chiave esterna deve esistere, scrivete la regola e rendete il risultato riproducibile. È l'evidenza che vogliono gli auditor ed è il modo più rapido per impedire che difetti noti entrino nel vostro patrimonio di dati.
La rilevazione di anomalie statistica o basata su AI va usata dove il problema è una deriva di comportamento. Uno spostamento nei pattern di volume, distribuzione o tempistiche può non violare alcuna regola rigida, ma indicare comunque un cambiamento della fonte, un problema in un processo a monte o un'ipotesi non più valida. In questi casi le baseline apprese superano i controlli statici, perché un insieme di regole non può prevedere ogni nuova modalità di errore.
Non trascurare il monitoraggio di struttura e consegne
Le modifiche di schema e i controlli di tempestività meritano un posto proprio nello stack. Un cambio di tipo di colonna, un campo aggiunto o una consegna in ritardo possono compromettere i consumatori a valle prima che scatti qualsiasi regola a livello di riga. Sono controlli di base, ma risparmiano molti problemi in produzione.
Il compromesso riguarda governance e collocazione. L'esecuzione in-database riduce lo spostamento dei dati e mantiene il controllo più vicino ai dati, aspetto importante negli ambienti regolamentati. Anche l'adozione modulare aiuta, perché i team devono partire da un percorso critico ed espandersi, invece di acquistare una piattaforma gigantesca che non metteranno mai pienamente in esercizio.
Non vi serve un unico strumento miracoloso. Vi serve uno stack adatto al profilo di rischio dei dati, al carico di compliance del team e al tipo di guasti che la vostra azienda incontra. Se state confrontando fornitori o definendo uno standard interno, gli strumenti di data quality sono un punto di riferimento pratico per questa valutazione.
Quando dati puliti non significa dati sicuri
Un dataset può superare ogni controllo convenzionale ed essere comunque pericoloso per la decisione che alimenta. Nel lavoro con l'AI diventa evidente in fretta, perché la domanda non è solo se i dati sono puliti, ma se sono pertinenti, rappresentativi e adeguati al gruppo interessato. L'articolo 10 dell'AI Act dell'UE richiede che i dati di addestramento, validazione e test dei sistemi ad alto rischio siano pertinenti, sufficientemente rappresentativi, il più possibile completi e privi di errori, e statisticamente adeguati ai gruppi e ai contesti interessati (AI Act UE, articolo 10).
La pulizia tecnica non dimostra l'idoneità all'uso
Il modello standard a sei dimensioni qui non basta. Potete avere dati completi, validi e unici che comunque sottorappresentano un gruppo minoritario, trascurano un'area geografica rilevante o riflettono un contesto operativo superato. Un dataset del genere può sembrare tecnicamente solido ed essere comunque pericoloso sul piano operativo.
La soluzione pratica è aggiungere alla documentazione della valutazione la copertura dei sottogruppi, lo spostamento della distribuzione e la documentazione dell'uso previsto. In sanità, finanza, telecomunicazioni e servizi pubblici non è una preoccupazione teorica. I punteggi di qualità aggregati possono sembrare accettabili mentre la copertura o i tassi di errore di singoli gruppi restano inaccettabili.
Trattare la rappresentatività come un requisito operativo
La rappresentatività deve diventare misurabile, altrimenti resta un discorso vago. I team hanno bisogno di soglie esplicite per la copertura dei sottogruppi, di regole chiare su quando una deriva è un cambiamento legittimo della popolazione e di una traccia del perché il dataset è adatto a una determinata decisione. È l'unico modo per distinguere una popolazione che cambia davvero da un bias di campionamento dannoso.
Qui conta anche la responsabilità. Qualcuno deve decidere se i dati corrispondono ancora al caso d'uso, non solo se i controlli sono stati superati. Se il dataset è pulito ma non adatto, la risposta giusta è fermare il workflow, non festeggiare la dashboard.
Riportare i risultati e rendere operativo il workflow
Il report dovrebbe dire agli stakeholder che cosa è stato controllato, che cosa è fallito, quanto il team è sicuro del risultato e chi è responsabile della prossima azione. Includete perimetro, dimensioni testate, soglie, suddivisioni per segmento, risultati con la relativa incertezza, stato della remediation e un responsabile chiaro per ogni problema irrisolto. Se vi serve un riferimento pratico per i modelli di documentazione operativa, le guide pratiche di Trupeer Inc. sono un modello utile per rendere leggibili i passaggi di un processo senza complicarli troppo.
Mantenere il workflow ripetibile
I programmi più affidabili trasformano la valutazione in un calendario, non in un progetto una tantum. Pianificate valutazioni ricorrenti, versionate regole e soglie, impostate alert sul peggioramento e rivedete i risultati con gli stakeholder a cadenza regolare. Ciò è in linea con il modello di governance della ISO 8000, in cui le norme vengono riesaminate ogni cinque anni e il controllo qualità fa parte della gestione continua, non di un singolo evento di certificazione (ISO 8000-1:2022).
Checklist per il runbook: delimitate i dataset critici, profilate i dati, definite le regole, impostate soglie di avviso e di errore, eseguite le query, seguite l'andamento dei risultati, riportate l'incertezza e ripetete la valutazione secondo un calendario.
Evitate le dashboard di facciata. Evitate le valanghe di alert. Entrambe portano allo stesso risultato: le persone smettono di fidarsi del programma. Un workflow di qualità funziona solo quando i segnali sono abbastanza specifici da poter agire e abbastanza stabili da supportare contemporaneamente audit, ingegneria e analytics.
Se cercate una piattaforma che venga eseguita nel vostro ambiente e combini validazione a livello di record, monitoraggio della tempestività, tracciamento dello schema e rilevazione di anomalie, digna è un'opzione da valutare per questo modello operativo. Visitate digna per scoprire come il suo approccio alla data quality e alla data observability si adatta a dataset critici, ambienti regolamentati e workflow pronti per l'AI.
Per la parte di questo stack basata su baseline apprese, scoprite come il modulo digna Data Anomalies rileva variazioni di volume, distribuzione e tempistiche che nessuna regola scritta a mano aveva previsto.
Domande frequenti
Come si valuta la qualità dei dati passo dopo passo?
La qualità dei dati si valuta in una sequenza fissa: delimitare i dataset critici, profilare i dati, definire regole per dimensione, impostare soglie di avviso e di errore, eseguire le query e seguire l'andamento dei risultati. Il profiling viene per primo perché tassi di nulli, duplicati e intervalli di valori mostrano dove si trovano davvero i difetti, così le regole si basano su evidenze.
Quali sono le sei dimensioni usate per misurare la qualità dei dati?
Le sei dimensioni sono completezza, unicità, coerenza, validità, accuratezza e tempestività. Ciascuna dovrebbe essere un requisito misurabile con un proprio tipo di soglia, per esempio tolleranza zero sui campi chiave duplicati o una finestra di freschezza per un file giornaliero che deve arrivare prima della scadenza del reporting.
Perché una pipeline riuscita può comunque consegnare dati errati?
Un job completato dimostra solo che dei byte sono stati spostati, non che i record significhino ancora ciò che significavano ieri. Una fonte può cambiare il tipo di una colonna o iniziare a duplicare i record mentre il caricamento resta verde, quindi i controlli limitati a freschezza e conteggio dei nulli non colgono problemi di accuratezza, contraddizioni tra tabelle e schema drift.
Come vanno riportati i risultati di qualità ottenuti da un campione?
I risultati campionari dovrebbero sempre indicare la propria incertezza. Conservate numeratore, denominatore, finestra di osservazione, definizione della popolazione e metodo di campionamento per ogni metrica e riportate gli intervalli di confidenza, perché una stima di completezza su 100 record campionati è molto meno stabile della stessa percentuale calcolata su 100.000 record.
I dati puliti sono sempre sicuri per l'AI?
No, i dati puliti possono essere pericolosi se sottorappresentano un gruppo, trascurano un'area geografica o riflettono un contesto superato. L'articolo 10 dell'AI Act dell'UE richiede che i dati di addestramento ad alto rischio siano pertinenti e sufficientemente rappresentativi, quindi le valutazioni dovrebbero aggiungere copertura dei sottogruppi, spostamento della distribuzione e documentazione dell'uso previsto.


