Da timestamp a datetime: guida completa alla conversione
|
6
min di lettura

1700000000 non è un datetime, è un timestamp macchina. Per convertirlo in sicurezza, identificate prima l'unità, normalizzate in UTC e poi presentate il risultato con un contesto di fuso orario esplicito, altrimenti corromperete il record.
Una dashboard rotta alle 8:05 del mattino di solito non sembra affatto rotta. Il grafico si carica, il batch termina e l'export di fatturazione arriva puntuale, ma un team legge i secondi come millisecondi, un altro presume l'ora locale e un terzo formatta un istante senza conservare il valore originale. È in questo divario tra timestamp macchina e datetime leggibili dalle persone che si nasconde la maggior parte dei problemi di produzione.
Indice
Perché le conversioni dei timestamp falliscono in produzione
Precisione, rilevamento delle unità e perdita silenziosa di dati
Perché le conversioni dei timestamp falliscono in produzione
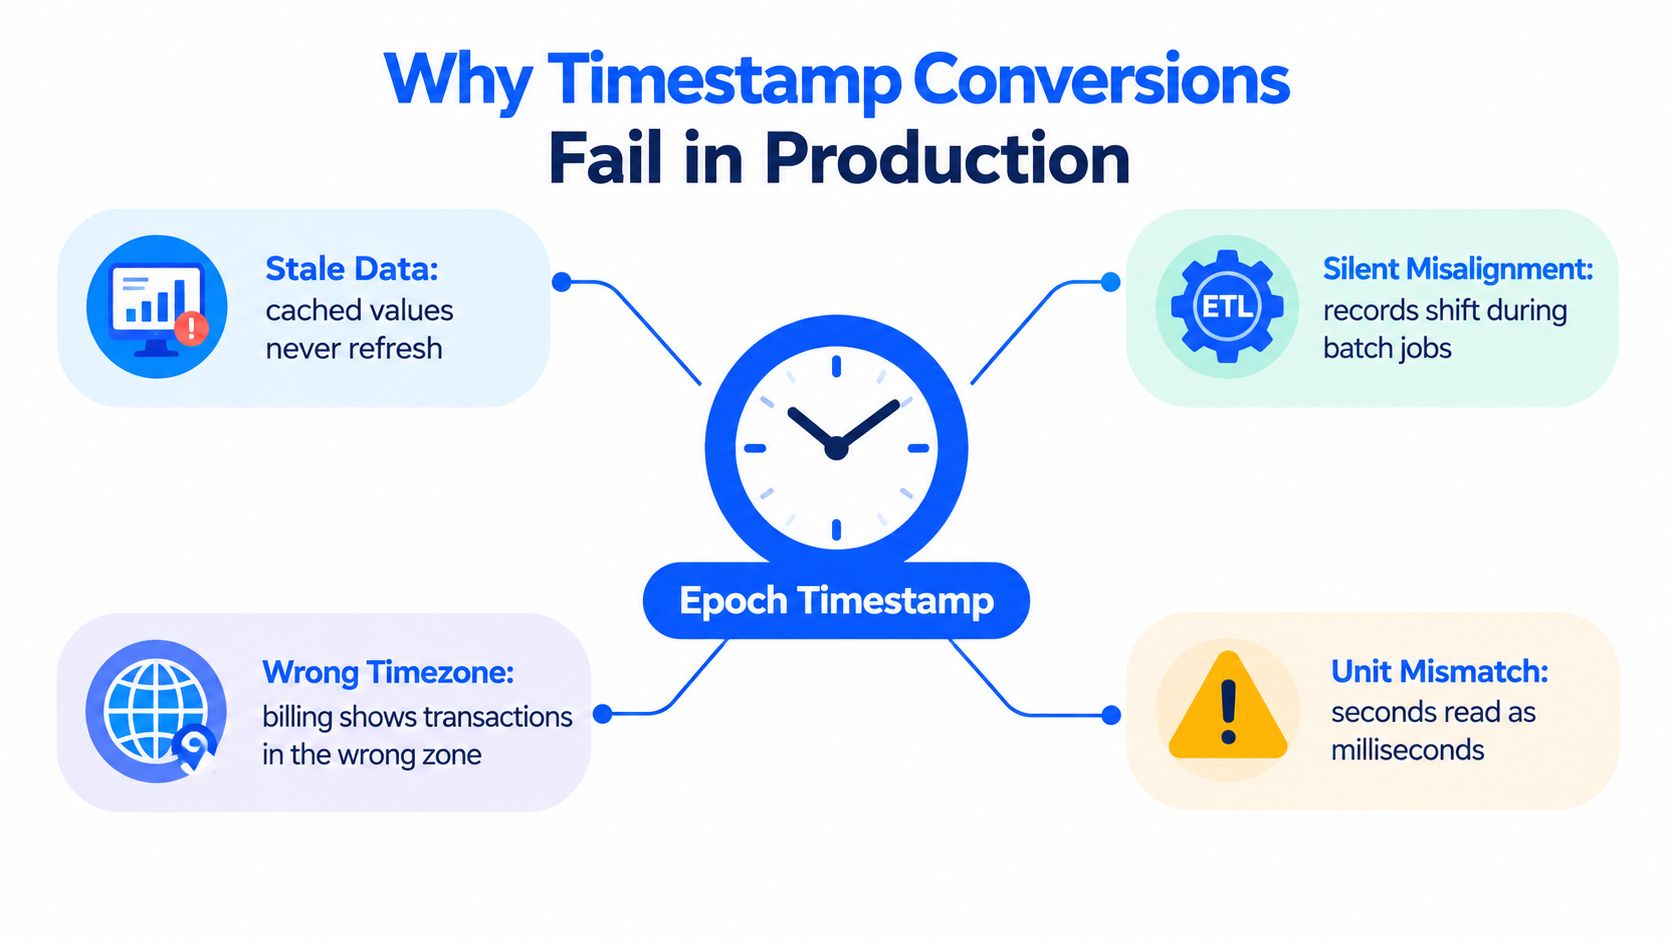
Una dashboard che mostra i numeri di ieri, un'esecuzione ETL che sposta i record di un giorno o un estratto di fatturazione che finisce nella regione sbagliata indicano di solito un unico problema di fondo: il significato ambiguo del timestamp. Un timestamp Unix identifica un istante rispetto all'epoch Unix, cioè le 00:00:00 UTC del 1° gennaio 1970, ma il numero in sé non dice come visualizzarlo. Le stesse cifre possono diventare il momento sbagliato se un sistema legge secondi e un altro millisecondi, oppure se il fuso orario locale di un server si insinua nel passaggio di conversione. La convenzione Unix tratta inoltre ogni giorno civile come esattamente 86.400 secondi logici, così l'aritmetica resta semplice, ma i secondi intercalari e le regole dei fusi orari contano ancora quando il risultato viene mostrato alle persone. (Riferimento NASA sui secondi intercalari)
Che cosa si rompe per primo
Il primo guasto è di solito un errore di unità. Un valore che andrebbe interpretato in secondi viene letto come millisecondi, e il datetime risultante cade vicino al 1970 o ben al di fuori dell'intervallo atteso. Il secondo guasto è la deriva del fuso orario: il timestamp viene decodificato correttamente, ma visualizzato nel contesto locale sbagliato.
Regola pratica: trattate il valore numerico grezzo come fonte di verità e il datetime formattato come livello di presentazione.
Il terzo guasto si nasconde nello scambio tra sistemi. Un servizio scrive in UTC, un altro legge un valore naive come ora locale, e la pipeline «funziona» comunque, perché l'output sembra abbastanza plausibile da superare un'occhiata veloce. Il quarto guasto riguarda la gestione dei secondi intercalari, perché il normale tempo POSIX ignora i secondi UTC inseriti e non può rappresentare 23:59:60 in modo univoco. Il rischio non riguarda solo le visualizzazioni. Emerge nelle chiusure di fatturazione, nelle timeline degli incidenti e in qualsiasi dataset in cui l'ordine conta. Perché i primi guasti di una pipeline spesso all'inizio sono invisibili offre un modo utile di ragionare su questi errori silenziosi nei flussi di dati adiacenti.
Com'è un modello mentale corretto
La sequenza corretta è semplice, ma ogni passaggio conta. Primo, identificate l'unità e il contratto semantico. Secondo, normalizzate in un istante assoluto. Terzo, presentate quell'istante in UTC o in un fuso civile con nome solo quando l'output è necessario. Se saltate uno di questi passaggi, non state più convertendo un timestamp in datetime, state tirando a indovinare.
Convertire i timestamp nei sistemi più comuni
Le conversioni più sicure sono quelle che rendono evidenti nel codice l'unità e il fuso orario. Python, JavaScript e SQL hanno ciascuno i propri valori predefiniti, ed è proprio lì che nascono i bug di produzione. Se standardizzate una conversione esplicita e consapevole del fuso orario, lo stesso valore grezzo resta riproducibile tra server, job e notebook.
Python
La libreria standard di Python offre uno schema pulito: datetime.fromtimestamp(value, tz=timezone.utc) per una conversione consapevole dell'UTC, poi astimezone(target_zone) solo quando serve un fuso locale con nome. Se omettete tz, Python usa l'ora locale della piattaforma e restituisce un datetime naive, ed è così che lo stesso codice inizia a comportarsi in modo diverso da un host all'altro. Per questo il passaggio esplicito a UTC è l'impostazione predefinita più sicura. Anche la documentazione ufficiale di datetime descrive la distinzione tra naive e aware e l'uso consigliato di timezone.utc. (Documentazione datetime di Python)
JavaScript
L'oggetto Date di JavaScript memorizza i millisecondi dall'epoch Unix, quindi i secondi Unix vanno moltiplicati per 1.000 prima della conversione. L'operazione inversa richiede una divisione per 1.000, e conviene preservare la precisione frazionaria quando conta. L'altra trappola è la scelta dell'accessor, perché la memorizzazione basata su UTC non impedisce agli accessor locali di leggere attraverso il fuso orario della macchina host. Il riferimento MDN di Date (in inglese) ricorda bene di mantenere esplicita questa distinzione.
SQL e motori di data warehouse
I motori SQL variano, quindi l'abitudine più sicura è verificare il tipo di destinazione e il comportamento del fuso orario invece di presumere che un motore si comporti come un altro. PostgreSQL distingue la precisione dei timestamp e supporta la risoluzione frazionaria, mentre ClickHouse espone funzioni separate per secondi, millisecondi e microsecondi. In pratica, l'importante non è memorizzare ogni nome di funzione, ma assicurarsi che il tipo memorizzato corrisponda all'unità di origine e che il fuso orario di visualizzazione sia scelto intenzionalmente. La documentazione PostgreSQL su date e orari è particolarmente utile quando dovete ragionare su precisione e frazioni di secondo. (Tipi di data e ora di PostgreSQL)
Per i team che lavorano tra formati di file diversi e data ingestion nel warehouse, i formati di file Parquet contano, perché i campi timestamp attraversano spesso sistemi con aspettative di precisione diverse. Un datetime che sembra corretto in un motore può perdere significato quando un parser a valle presume un'unità diversa o tronca le frazioni di secondo.
Gestione dei fusi orari oltre la conversione di base
La decodifica dell'epoch e la conversione del fuso orario risolvono problemi diversi. La decodifica risponde a quale istante rappresenta il record. La conversione risponde a come quell'istante debba apparire in un luogo e in un contesto storico specifici. I sistemi che confondono questi passaggi creano date locali che sembrano corrette in un ambiente e sbagliate in un altro. Il database dei fusi orari IANA esiste perché la storia dei fusi orari cambia a seconda del luogo e nel tempo. Registra le regole dell'ora locale e le aggiorna quando i governi modificano offset e politiche sull'ora legale.
Perché gli offset fissi falliscono
Un offset fisso cattura un momento, ma non le regole che stanno dietro a quel momento. America/New_York non equivale a UTC-5, perché il fuso con nome include il comportamento dell'ora legale e i cambiamenti storici, mentre l'offset no. Se memorizzate solo l'offset, perdete l'identità del luogo insieme ai cambiamenti di regole a esso collegati.
Python gestisce correttamente questo aspetto con tzinfo, che tiene insieme offset e comportamento del fuso. Lo schema più sicuro è decodificare prima in UTC e poi convertire in un fuso con nome al confine della visualizzazione. Applicare un'etichetta di fuso orario a un datetime naive è una reinterpretazione, non una conversione.
Un orario locale può ripetersi durante il ritorno all'ora solare e sparire durante il passaggio all'ora legale.
Perché JavaScript richiede più attenzione
L'oggetto Date di JavaScript è internamente basato su UTC, ma i suoi normali accessor dei componenti usano il fuso orario locale della macchina host. Un notebook di debug su un portatile e un container di produzione in un'altra regione possono mostrare campi locali diversi per lo stesso istante. Il timestamp resta corretto. Cambia il percorso di visualizzazione, e tanto basta per creare bug confusi. Per pipeline deterministiche, usate accessor UTC o una libreria consapevole dei fusi orari, e non affidatevi alle impostazioni predefinite della macchina.
La verificabilità fa parte della gestione dei fusi orari
Lavorare con i fusi orari non significa solo formattare. I sistemi che gestiscono finanza, sanità o reporting transfrontaliero devono conservare insieme l'istante originale, il fuso scelto e lo stato della conversione, come campi di metadati che viaggiano con il record e non accanto a esso in una nota del notebook o in un commento di un ticket.
Questa separazione conta in produzione. Se manca l'istante originale, non potete dimostrare che cosa è stato ricevuto. Se manca lo stato della conversione, non potete capire se un valore è stato normalizzato, visualizzato o reinterpretato in seguito.
Precisione, rilevamento delle unità e perdita silenziosa di dati
Una conversione da timestamp a datetime può cambiare più della sola visualizzazione. Può distruggere la precisione, far collassare l'ordine degli eventi e nascondere la differenza tra due record avvenuti nello stesso secondo visualizzato ma non nello stesso istante. Per questo il rilevamento dell'unità va trattato come un contratto di schema, non come un'ipotesi basata sul numero di cifre. Le pratiche di accuratezza nella qualità dei dati diventano qui particolarmente rilevanti, perché una scelta di precisione sbagliata sembra comunque «valida» ai sistemi a valle.
Perché contare le cifre è una trappola
Un intero lungo non vi dice se la fonte usa secondi, millisecondi, microsecondi o nanosecondi. Un valore di 13 cifre può essere in millisecondi in un feed, mentre un altro sistema può usare una scala del tutto diversa. Se dividete per 1.000 perché il numero «sembra» in millisecondi, potete creare un datetime plausibile ma sottilmente sbagliato.
PostgreSQL supporta una precisione dei timestamp da zero a sei cifre frazionarie, il che basta a mostrare perché la questione conta. Se la vostra fonte contiene microsecondi e la destinazione memorizza solo valori al secondo, perdete informazioni sull'ordine anche se il risultato si visualizza in modo pulito. Questa perdita può incidere su deduplicazione, misurazione della latenza, correlazione degli incidenti e audit trail.
Che cosa conservare
Memorizzate il valore numerico originale. Memorizzate l'unità di origine. Memorizzate la precisione di destinazione. Poi visualizzate il datetime leggibile solo dopo che questi valori sono espliciti. Se la fonte usa frazioni di secondo, conservatele in una forma che non arrotondi tramite virgola mobile, a meno che il vostro sistema possa tollerare questa perdita.
L'output leggibile è utile alle persone, ma può nascondere la verità operativa: due eventi erano distinti.
Anche i timestamp in stile POSIX meritano una formulazione attenta. Sono comodi per l'aritmetica perché ogni giorno è trattato come 86.400 secondi, ma non sono un orologio fisico perfetto e non contano separatamente i secondi intercalari. Questa distinzione conta nei sistemi di data observability, dove la pipeline può dover distinguere «lo stesso secondo visualizzato» da «lo stesso evento sottostante».
Costruire una pipeline di timestamp per la produzione
Una pipeline di produzione dovrebbe procedere ogni volta nello stesso ordine. Prima eseguite il parsing del valore grezzo e confermate l'unità di origine. Validate ordine di grandezza, precisione e nullabilità rispetto al contratto. Normalizzate in UTC. Convertite in un fuso locale con nome solo per la presentazione. Emettete un formato esplicito come ISO 8601 con Z o un offset. Questa sequenza impedisce che lo stesso record cambi significato mentre passa da un servizio all'altro.

Il workflow che regge in produzione
Partite dal contratto prima di toccare il formatter. Un campo timestamp dovrebbe dichiarare se è in secondi, millisecondi o un'altra unità, e se rappresenta UTC o un'ora civile locale. Inserite questa dichiarazione nella documentazione dello schema, nei controlli della pipeline e nelle fixture di test, così che parser e revisore valutino la stessa cosa.
Normalizzate l'istante prima di qualsiasi formattazione per la visualizzazione. JavaScript richiede una moltiplicazione o divisione esplicita attorno alla memorizzazione in millisecondi di Date. Python dovrebbe creare prima datetime UTC aware. SQL dovrebbe usare tipi consapevoli del fuso orario ed evitare cast silenziosi che dipendono dalle impostazioni di sessione. Solo dopo dovreste convertire nel fuso orario di business, e solo se un consumatore a valle ha bisogno di una presentazione locale.
I team che confrontano componenti di orchestrazione e warehousing possono usare i componenti di una pipeline di dati moderna come riferimento per le parti in movimento. La regola pratica è più semplice: ogni passaggio dovrebbe portare con sé il valore grezzo, l'unità di origine, il fuso orario di presentazione e il risultato della validazione. Così il troubleshooting resta possibile senza rieseguire l'intera pipeline.
Il timestamp numerico originale non dovrebbe mai sparire solo perché un datetime è stato visualizzato in un report. Conservate entrambi. Uno è il campo di audit, l'altro il livello di visualizzazione. I controlli di qualità delle pipeline di dati sono più solidi quando entrambi sopravvivono a ogni passaggio.
Validare le conversioni con test sui casi limite
I bug dei timestamp emergono ai margini. Valori che sembrano corretti in una demo veloce spesso falliscono in produzione, quindi la suite di test deve colpire di proposito i casi scomodi. Includete zero, valori negativi precedenti all'epoch, frazioni di secondo, null, stringhe non numeriche e timestamp vicini ai cambi dell'ora legale. La stessa suite dovrebbe coprire anche le date massime supportate vicino ai limiti del sistema e verificare che gli accessor UTC di JavaScript restino coerenti con quelli locali nei diversi ambienti. Le pratiche di test della qualità dei dati sono più solide quando esplorano i casi difficili, non solo il percorso ideale.
Che cosa testare per primo
Zero e valori precedenti all'epoch: verificate che la pipeline gestisca
0e i timestamp negativi in modo coerente, oppure li rifiuti con un motivo chiaro.Precisione frazionaria: verificate che microsecondi o millisecondi sopravvivano alla conversione quando il contratto di origine li richiede.
Momenti di cambio dell'ora: testate orari locali ripetuti e saltati, così che il livello di visualizzazione non etichetti male l'istante.
Input null e non numerici: verificate che la pipeline rifiuti i record errati senza tirare a indovinare.
Timestamp al limite superiore: controllate l'intervallo di datetime più ampio che il vostro database, il runtime del linguaggio o il formato di serializzazione possono gestire.
Che cosa registrare nei log
Registrate l'unità di origine, i metadati del fuso orario di origine, l'istante UTC normalizzato, lo stato di validazione e l'eventuale motivo dell'errore. Questi metadati rendono riproducibile l'analisi degli incidenti, soprattutto quando un ambiente aggiorna i dati dei fusi orari mentre un altro resta indietro. Il database IANA cambia nel tempo, quindi la riproducibilità dipende dalla consapevolezza delle versioni tanto quanto dalla correttezza del codice.
Una conversione che non si può riprodurre a partire dai log non è stata validata.
Un controllo finale dovrebbe confrontare il valore originale con il datetime visualizzato dopo un round trip, dove supportato. Se l'istante restituito cambia, il percorso di conversione sta ancora perdendo informazioni. Conservare il timestamp grezzo accanto al datetime semplifica molto la revisione di audit, perché un campo preserva il valore macchina e l'altro mostra la forma leggibile.
Se volete che questi contratti sui timestamp - unità, intervallo plausibile, precisione e nullabilità - vengano applicati a ogni caricamento e non solo nelle suite di test, digna Data Validation li esegue come regole direttamente all'interno del vostro database.
Domande frequenti
Come si converte un timestamp Unix in datetime in Python?
Usate datetime.fromtimestamp(value, tz=timezone.utc) per ottenere un datetime consapevole dell'UTC, poi chiamate astimezone() con un fuso ZoneInfo come America/New_York solo quando vi serve la visualizzazione locale. Senza tz, Python usa l'ora locale dell'host e restituisce un datetime naive, quindi i risultati cambiano da un server all'altro.
Perché il mio timestamp convertito mostra una data del 1970?
Una data vicina al 1970 indica quasi sempre un errore di unità: un valore in secondi è stato letto come millisecondi, così l'istante cade subito dopo l'epoch Unix, le 00:00:00 UTC del 1° gennaio 1970. Confermate l'unità di origine dal contratto di schema invece di dedurla dal numero di cifre.
America/New_York equivale a UTC-5?
No. UTC-5 è un offset fisso che descrive un singolo momento, mentre America/New_York è un fuso IANA con nome che include le regole dell'ora legale e i cambiamenti storici. Se memorizzate solo l'offset, perdete l'identità del luogo e ogni cambiamento di regole collegato, e gli orari locali iniziano a slittare.
Che cosa deve memorizzare una pipeline di timestamp oltre al datetime formattato?
Conservate il valore numerico originale, l'unità di origine, la precisione di destinazione, il fuso orario usato per la visualizzazione e il risultato della validazione. Il valore grezzo è il campo di audit e il datetime è solo il livello di presentazione, quindi entrambi devono accompagnare il record in ogni passaggio della pipeline.
Quali casi limite devono coprire i test di conversione dei timestamp?
Partite da zero e dai valori negativi precedenti all'epoch, dalle frazioni di secondo, dai null e dalle stringhe non numeriche, oltre ai momenti di cambio dell'ora in cui gli orari locali si ripetono o scompaiono. Aggiungete date vicine ai limiti del database o del runtime e verificate che un round trip restituisca lo stesso istante.


