Quali sono gli obiettivi per garantire l'integrità dei dati
|
6
min di lettura
Un team finance può pubblicare un report trimestrale con grafici curati, totali riconciliati e l'approvazione del management, e basarlo comunque su una tabella il cui significato è cambiato durante un aggiornamento della pipeline. Una colonna rinominata, un file mancante o una correzione sovrascritta possono far sì che una metrica considerata affidabile descriva l'evento di business sbagliato. Quando qualcuno se ne accorge, gli stessi dati potrebbero già alimentare una dashboard operativa, una funzionalità di AI e una segnalazione regolamentare.
Ecco perché la risposta alla domanda quali sono gli obiettivi per garantire l'integrità dei dati non può fermarsi a “mantenere i dati accurati”. Un programma efficace deve preservare accuratezza, completezza, coerenza, tracciabilità, sicurezza e recuperabilità. Deve anche produrre evidenze che queste proprietà siano sopravvissute a trasformazioni, correzioni, modifiche di schema e gestione degli incidenti.
Indice
Perché l'integrità dei dati è un insieme di obiettivi, non una singola casella da spuntare
Come cambiano gli obiettivi tra casi d'uso regolamentari, operativi e di AI
Il compromesso che la maggior parte delle guide sull'integrità trascura
Perché l'integrità dei dati è un insieme di obiettivi, non una singola casella da spuntare
L'integrità dei dati viene spesso trattata come una spia di stato: verde significa affidabile, rosso significa guasto. Le piattaforme dati reali non funzionano così. Un dataset può contenere valori accurati ma non avere un audit trail, arrivare in ritardo ma restare completo, oppure superare i controlli strutturali pur usando una definizione di business incoerente.
Prendiamo una tabella dei ricavi trimestrali. I valori possono essere corretti per i record arrivati, ma un file regionale non è mai stato caricato. Il report ora è incompleto. Se un sistema sorgente ha cambiato net_revenue per rappresentare i ricavi dopo una rettifica diversa, la tabella è anche incoerente con i periodi precedenti. Se nessuno è in grado di stabilire quando è avvenuta la modifica o quale trasformazione l'ha applicata, il team non può difendere il risultato.
È questa la distinzione pratica tra qualità dei dati e integrità dei dati. La qualità chiede se le informazioni sono adatte a un determinato uso. L'integrità chiede se sono rimaste affidabili, controllate e spiegabili lungo tutto il loro ciclo di vita.
Regola pratica: un controllo di qualità superato vi dice come appaiono i dati adesso. Le evidenze di integrità vi aiutano a spiegare come ci sono arrivati.
Gli obiettivi formano quindi una struttura a livelli:
Accuratezza: i valori rappresentano l'evento sottostante.
Completezza: record, campi ed evidenze necessari non sono scomparsi.
Coerenza: la stessa definizione e le stesse regole valgono tra i sistemi e nel tempo.
Tracciabilità: le persone possono ricostruire chi ha cambiato cosa, quando e perché.
Sicurezza: gli accessi o le modifiche non autorizzati vengono impediti o rilevati.
Recuperabilità: l'organizzazione può ripristinare e verificare uno stato affidabile.
Questi obiettivi supportano contemporaneamente analytics, AI, reporting finanziario, operations e conformità. La domanda giusta non è se un dataset abbia un unico punteggio di integrità, ma quale obiettivo è esposto a ogni passaggio di consegne e quali evidenze dimostrano che il controllo ha funzionato.
Il concetto alla base degli obiettivi di integrità dei dati
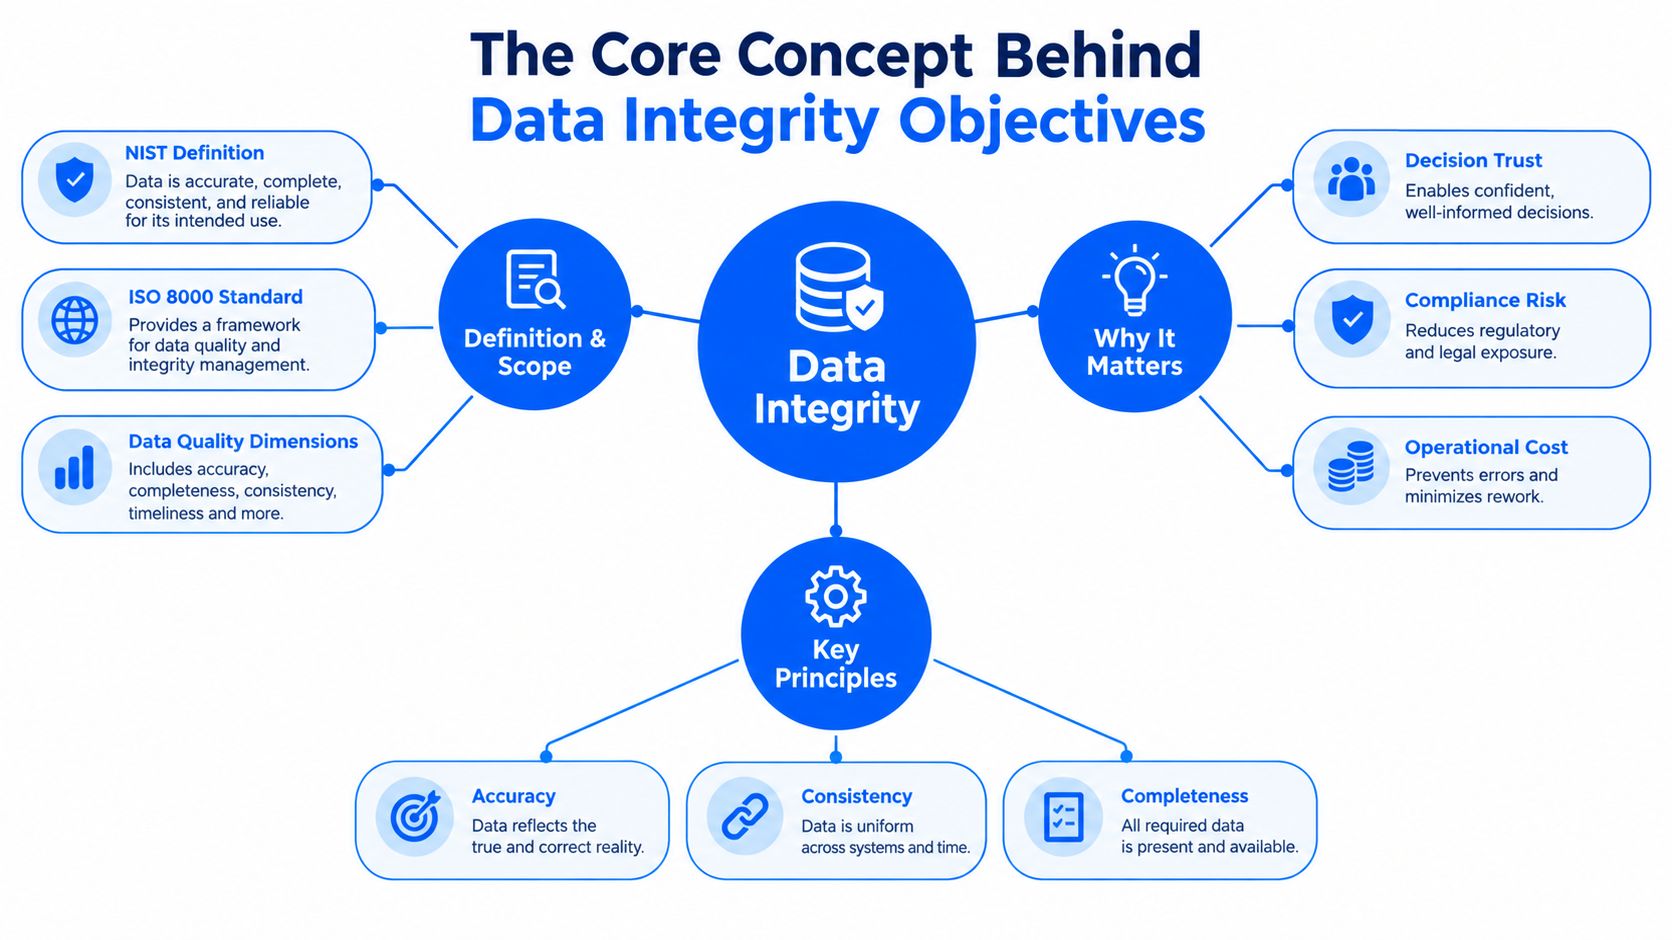
Il NIST definisce l'integrità come la proprietà per cui i dati non sono stati alterati, distrutti o persi con mezzi non autorizzati o accidentali, collegandola anche ad autenticità e non ripudio. In parole semplici, il record dovrebbe continuare a rappresentare ciò che è accaduto e l'organizzazione dovrebbe essere in grado di dimostrarlo.
Le dimensioni della qualità dei dati aiutano a descrivere se le informazioni sono utilizzabili, ma l'integrità aggiunge il controllo lungo il ciclo di vita. Un valore può sembrare plausibile in un warehouse ed essere comunque inaffidabile se ne mancano la fonte, il timestamp, la trasformazione o lo storico delle correzioni.
Trasformare ALCOA in controlli quotidiani
Le linee guida della FDA descrivono l'integrità dei dati attraverso i cinque attributi ALCOA: attribuibile, leggibile, registrato contestualmente, originale o copia conforme, e accurato. Questi termini diventano più utili quando vengono tradotti in domande a cui un team dati può rispondere.
Attribuibile: siete in grado di identificare la persona, il sistema, lo strumento o il servizio che ha creato o modificato il record?
Leggibile: un revisore autorizzato può leggere e interpretare in seguito il record e i suoi metadati?
Contestuale: l'evento è stato registrato nel momento in cui si è verificato, anziché ricostruito a memoria?
Originale: conservate il record sorgente o una copia conforme verificata, non solo un output trasformato?
Accurato: il valore descrive fedelmente l'evento sottostante?
Un evento in streaming che arriva in ritardo illustra la differenza tra il momento dell'acquisizione e il momento dell'evento. Registrarli entrambi aiuta i revisori a capire se la fonte ha generato l'evento in ritardo, se la rete lo ha rallentato o se il processo di ingestione è fallito.
L'integrità è più ampia di “i dati sembrano corretti”. Comprende le evidenze che circondano i dati, i controlli che li proteggono e la capacità di ricostruire la sequenza degli eventi dopo una correzione o un incidente.
Gli obiettivi principali che ogni programma deve coprire
Le linee guida della FDA descrivono l'integrità dei dati come completezza, coerenza e accuratezza dei dati e si aspettano che i record siano attribuibili, leggibili, registrati contestualmente, originali o copie conformi, e accurati: i cinque attributi ALCOA. Questi attributi costituiscono una base solida, ma le pipeline enterprise hanno bisogno anche di controlli per sicurezza, tracciabilità e ripristino.
Sei obiettivi in termini pratici
Accuratezza significa che un valore rappresenta l'evento che dichiara di rappresentare. Se una fattura viene registrata con una conversione di valuta errata, un controllo di intervallo può intercettare un risultato non plausibile, ma solo una validazione basata su regole di business o una riconciliazione può stabilire quale dovrebbe essere il valore corretto. Segnali utili sono i controlli sui record falliti, le distribuzioni inattese e le discrepanze rispetto a una fonte affidabile.
Completezza significa che record, campi ed evidenze di supporto necessari sono presenti. Un caricamento di file riuscito può comunque essere incompleto se la fonte ha prodotto solo una parte dell'estrazione prevista. Alert sui caricamenti mancanti, confronti del numero di righe, controlli sui valori nulli e controlli su test falliti o ripetuti aiutano a far emergere la lacuna.
Coerenza significa che un concetto di business mantiene lo stesso significato tra i sistemi e nel tempo. Un valore di stato come “attivo” non dovrebbe significare “pagato” in un'applicazione e “non annullato” in un'altra. Tracciamento dello schema, controlli sui dati di riferimento e riconciliazione tra sistemi forniscono evidenze quando le definizioni derivano.
Tracciabilità significa che i revisori possono ricostruire la storia del record. Un analista finance che corregge un valore dovrebbe lasciare disponibili per la revisione il valore originale, il motivo, il timestamp, l'identità e la versione risultante. Audit log, lineage, cronologia delle versioni e contesto delle modifiche forniscono questa traccia.
Sicurezza protegge i dati da accessi, modifiche, perdite e distruzioni non autorizzati. Accesso basato sui ruoli, privilegio minimo, log protetti e monitoraggio delle modifiche riducono la probabilità che un'azione non autorizzata diventi una modifica invisibile dei dati.
Recuperabilità significa che il team può ripristinare uno stato affidabile e dimostrare che è affidabile. Le linee guida del NIST richiedono la capacità di ripristinare i dati all'ultimo stato valido noto, di identificare il backup corretto e non contaminato e di determinare l'identità e la tempistica delle alterazioni. I backup da soli non bastano se il ripristino non è stato testato o se il team non sa identificare quale versione è sicura.
Obiettivo | Come si manifesta il problema | Controllo rappresentativo |
|---|---|---|
Accuratezza | Una metrica rappresenta il valore di transazione sbagliato | Validazione a livello di record e riconciliazione |
Completezza | Manca un file sorgente o un record obbligatorio | Monitoraggio di freschezza, caricamenti, numero di righe e valori nulli |
Coerenza | Un sistema interpreta un campo in modo diverso | Tracciamento dello schema e regole di business condivise |
Tracciabilità | Un valore corretto non ha una storia documentata | Audit trail immutabile e lineage |
Sicurezza | Un utente non autorizzato modifica una tabella critica | Controlli di accesso e log delle modifiche protetti |
Recuperabilità | Un backfill errato sovrascrive uno storico affidabile | Backup versionati e test di ripristino |
Questi obiettivi si sovrappongono, ma non si sostituiscono a vicenda. Un dataset sicuro può comunque essere incompleto e un dataset recuperabile può comunque contenere una logica di business inaccurata.
Gli obiettivi passo per passo in una pipeline di dati reale
Prendiamo un flusso giornaliero dei ricavi da un sistema di fatturazione. La fonte invia le transazioni a un warehouse, dove le trasformazioni preparano un dataset per una dashboard di business intelligence.
In fase di ingestione, l'accuratezza parte dalla validazione di tipi, valute, identificativi e regole di business. Un record con importo negativo potrebbe essere valido per un rimborso, quindi la regola ha bisogno di contesto di business anziché di un controllo semplicistico “solo valori positivi”. La completezza entra in gioco quando il file arriva con meno record del previsto o quando la consegna è in ritardo. La pipeline dovrebbe distinguere un giorno lavorativo senza attività da un trasferimento fallito.
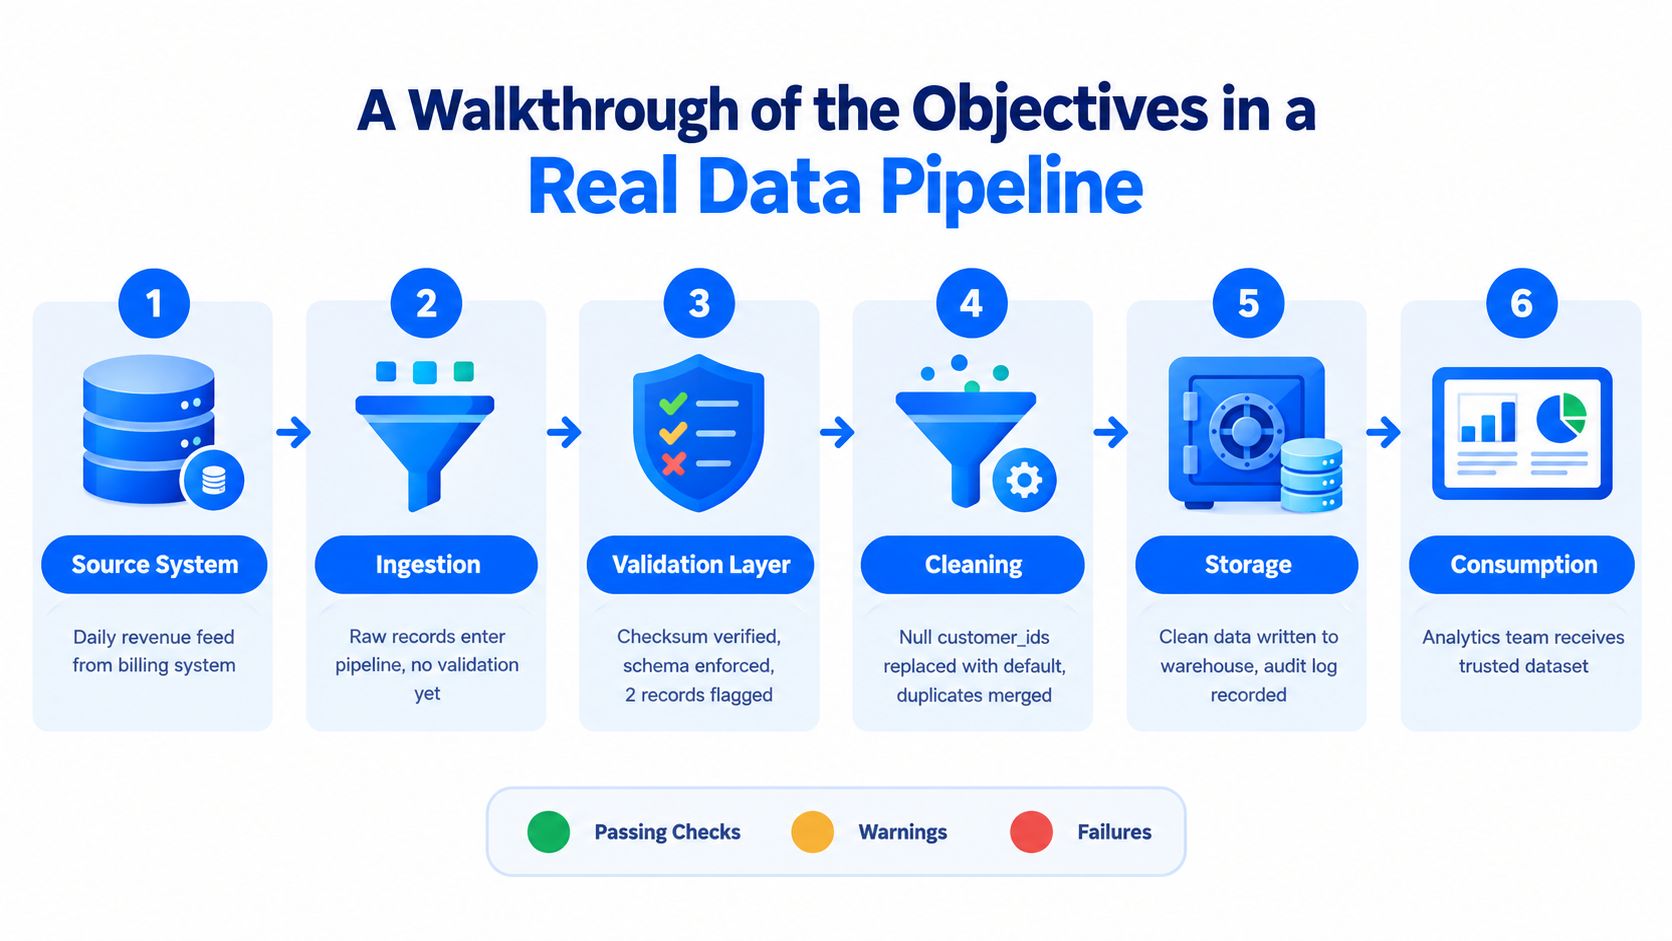
Poi una modifica dello schema sorgente rinomina una colonna. La trasformazione viene comunque eseguita, ma mappa il campo sbagliato nella dashboard. La coerenza richiede il rilevamento dei cambiamenti strutturali e semantici, non semplicemente lo stato di un job riuscito. I team che progettano questi passaggi possono anche consultare una guida all'architettura delle pipeline di dati per rendere espliciti ownership e punti di controllo.
Successivamente, un analista finance individua una correzione legittima e aggiorna un valore. La tracciabilità richiede valore originale, nuovo valore, motivo, identità e timestamp. Senza questo contesto, un revisore successivo non può capire se la modifica ha corretto un problema di fatturazione o ha mascherato un processo fallito.
Poi cambia il ruolo di un analista. I controlli di sicurezza determinano se quella persona può ancora visualizzare o modificare i campi sensibili. L'accesso dovrebbe seguire il ruolo attuale, non un vecchio permesso che resta attivo a tempo indeterminato.
Infine, un backfill errato sovrascrive tre giorni di dati nel warehouse. La recuperabilità richiede una versione valida nota, evidenze di backup protette e un modo per identificare cosa è cambiato. Anche la guida pratica del NIST sottolinea l'importanza di determinare l'identità e la tempistica delle alterazioni, quindi ripristino e indagine appartengono allo stesso processo operativo.
Per i team che raccolgono informazioni esterne prima che entrino in una pipeline, una web scraping API può essere valutata insieme ai controlli su validazione, provenienza e modifiche alla fonte. L'acquisizione non elimina la necessità di verificare ciò che è arrivato.
Come cambiano gli obiettivi tra casi d'uso regolamentari, operativi e di AI
I controlli di integrità dovrebbero essere commisurati alle conseguenze di un errore e al modo in cui le persone consumano i dati. Un report regolamentare ha bisogno di evidenze durature e di verificabilità. Un KPI operativo in tempo reale può dare priorità a un rilevamento tempestivo e a uno stato di freschezza chiaro. Un dataset di addestramento per l'AI ha bisogno di provenienza, controlli di rappresentatività, versionamento e di un modo per identificare input obsoleti o semanticamente modificati.
L'articolo 5 del GDPR dell'UE richiede che i dati personali siano esatti e, se necessario, aggiornati, e che il trattamento garantisca un'adeguata sicurezza, compresa la protezione da trattamenti non autorizzati o illeciti e da perdita, distruzione o danno accidentali. Questo obbligo rende importanti i workflow di correzione, i controlli di accesso e le evidenze sugli incidenti per i prodotti basati su dati personali, non solo per i report di conformità.
Caso d'uso | Obiettivi dominanti | Latenza accettabile dei controlli | Revisione umana |
|---|---|---|---|
Report regolamentare | Accuratezza, completezza, tracciabilità, sicurezza, recuperabilità | Prima dell'invio e dopo modifiche rilevanti | Necessaria per eccezioni, correzioni e approvazione |
KPI operativo | Tempestività, accuratezza, coerenza, disponibilità | Vicino al punto di ingestione o di pubblicazione | Concentrata su anomalie e interruzioni rilevanti |
Dataset di addestramento per l'AI | Provenienza, completezza, coerenza, accuratezza, recuperabilità con versionamento | Prima del rilascio del dataset e dopo modifiche alla fonte o allo schema | Necessaria per etichettatura, esclusioni, drift e usi sensibili |
I controlli non dovrebbero essere identici. Una metrica operativa in ritardo può essere più dannosa di un record temporaneamente trattenuto, se i team la usano per rispondere a un evento in corso. Un dataset regolamentare può tollerare una finestra di revisione più lunga, ma deve conservare i record originali e le evidenze delle decisioni.
La distinzione tra conformità e governance è utile in questo caso. La conformità definisce gli obblighi da rispettare. La governance assegna ownership e regole operative, così i team possono rispettare quegli obblighi in modo costante.
Tradurre gli obiettivi in pratiche operative
Gli obiettivi diventano utili quando ciascuno ha un controllo osservabile e un responsabile. Lineage e audit trail supportano la tracciabilità registrando fonti, trasformazioni, versioni, identità e timestamp. La validazione a livello di record supporta accuratezza e coerenza testando valori esatti, intervalli, elenchi di riferimento, gestione dei valori nulli e relazioni tra colonne.
La completezza richiede più di un controllo sul numero di righe. Il monitoraggio della tempestività può identificare caricamenti mancanti, arrivi in ritardo e pattern di consegna inattesi. Il tracciamento dello schema può far emergere colonne aggiunte o rimosse e modifiche dei tipi di dati prima che un consumatore a valle cambi significato senza preavviso.
Il rilevamento delle anomalie aggiunge un ulteriore livello. Le regole deterministiche intercettano i guasti noti, mentre le baseline comportamentali possono evidenziare volumi, distribuzioni o metriche di business insoliti che una regola fissa non prevede.
Una mappa pratica dei controlli
Accuratezza: validate i record rispetto alle regole di business e riconciliate i totali critici.
Completezza: monitorate gli arrivi previsti, i campi obbligatori e i record falliti o rifiutati.
Coerenza: tracciate schemi, valori di riferimento, definizioni e relazioni tra sistemi.
Tracciabilità: conservate lineage, eventi di audit, versioni e motivazioni delle modifiche.
Sicurezza: applicate il privilegio minimo, log protetti e modifiche degli accessi verificabili.
Recuperabilità: mantenete backup versionati e testate il ripristino a uno stato valido noto.
La guida pratica del NIST individua risultati come il ripristino dell'ultima configurazione valida nota, l'identificazione del backup corretto, la determinazione di cosa è cambiato e quando, e la correlazione di un'alterazione con gli eventi collegati. Un team piccolo può partire dalle tabelle a più alto rischio, per poi estendere la copertura man mano che ownership ed evidenze migliorano.
Una piattaforma come quella descritta nell'approccio di digna all'implementazione della qualità dei dati può combinare rilevamento delle anomalie, validazione, monitoraggio della tempestività e tracciamento dello schema. La scelta progettuale importante non è scegliere una singola funzionalità, ma collegare segnali statistici, regole deterministiche, consapevolezza strutturale ed evidenze di ripristino allo stesso data product.
Il compromesso che la maggior parte delle guide sull'integrità trascura
Più controlli non producono automaticamente più integrità. Troppi alert generano affaticamento, una validazione lenta può rendere le informazioni inutilizzabili e un accesso troppo restrittivo può spingere gli analisti verso copie non governate.
Un sondaggio globale su oltre 550 professionisti di dati e analytics ha individuato nella qualità dei dati la principale sfida per l'integrità dei dati. Solo il 12% ha dichiarato che i propri dati erano pronti per l'AI, e la carenza di competenze e di personale era il principale ostacolo al miglioramento della qualità, secondo l'analisi del sondaggio di Precisely.
L'obiettivo pratico sono dati affidabili a una velocità e a un costo adeguati. Classificate i controlli in base a impatto sul business, requisiti di freschezza, esposizione regolamentare e uso previsto. Una checklist sull'arricchimento dei dati di looot può aiutare i team a esaminare i passaggi di arricchimento senza dimenticare provenienza, validazione e ownership.
FAQ e checklist rapida degli obiettivi di integrità
Come possiamo dimostrare che i dati sono rimasti affidabili dopo una modifica della pipeline?
Conservate schemi versionati, lineage, eventi di audit, risultati delle validazioni, timestamp, ownership e contesto delle modifiche. Per una modifica rilevante, confrontate il comportamento prima e dopo la modifica, documentate i record interessati e conservate le evidenze insieme alla registrazione del rilascio o dell'incidente.
Come dovrebbe dare priorità ai controlli un team piccolo?
Iniziate dai dataset che supportano il reporting regolamentare, le operations critiche o i modelli ad alto impatto. Applicate lì per primi i controlli su freschezza, validazione, schema, accessi e ripristino, poi espandete in base al rischio osservato invece di cercare di monitorare ogni tabella allo stesso modo.
In cosa differiscono gli obiettivi di integrità dai KPI di qualità dei dati?
Un KPI di qualità misura una proprietà, come completezza o validità, in un determinato momento. Un obiettivo di integrità chiede anche se il risultato è attribuibile, protetto, spiegabile e recuperabile lungo tutto il ciclo di vita.
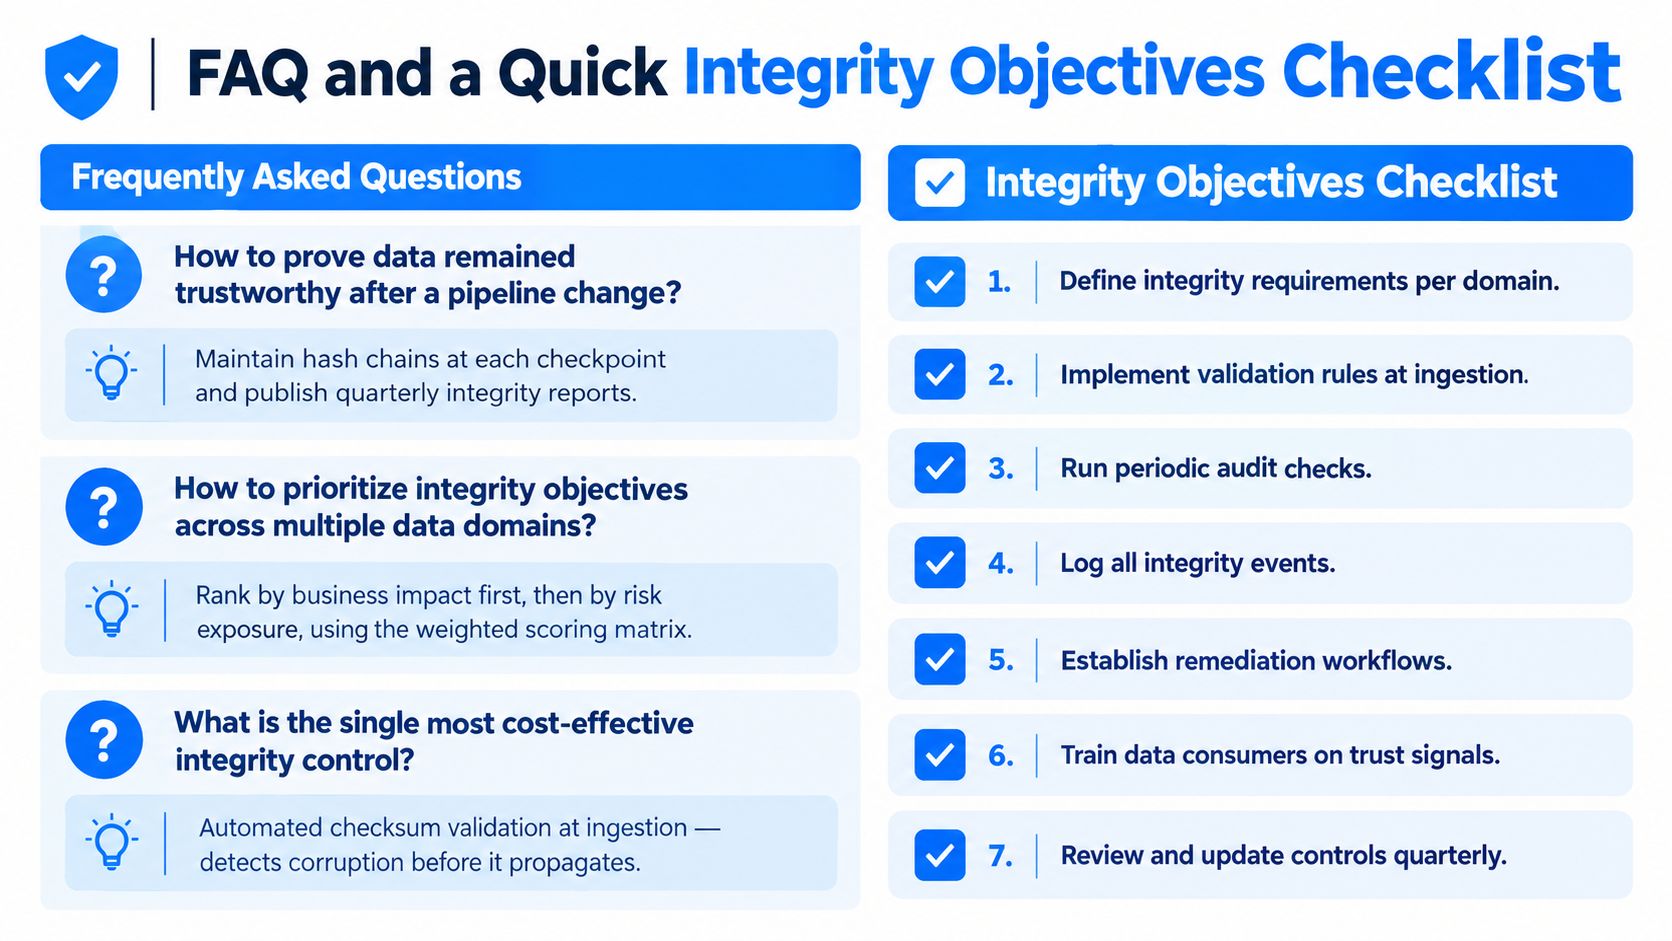
Usate questa checklist per un data product critico:
Accuratezza: validate i valori rispetto alle regole di business.
Completezza: rilevate record, campi e caricamenti mancanti.
Coerenza: monitorate definizioni, schemi e significato tra i sistemi.
Tracciabilità: registrate chi ha cambiato cosa, quando e perché.
Sicurezza: limitate gli accessi e rilevate le modifiche non autorizzate.
Recuperabilità: testate il ripristino a uno stato valido noto e verificato.
digna aiuta i team dati a monitorare il comportamento dei dati, validare i record, tracciare la tempestività, rilevare le modifiche di schema e analizzare le anomalie all'interno del proprio ambiente. Visitate digna per collegare questi controlli tra le pipeline e i dataset che supportano il vostro reporting, le vostre operations e i vostri casi d'uso di AI.
Una volta definiti questi obiettivi, il passo successivo è verificarli in modo continuo sulle pipeline in produzione. La nostra guida pratica al monitoraggio dell'integrità dei dati mostra come trasformare gli obiettivi di accuratezza, completezza e coerenza in controlli automatici.
Domande frequenti
Quali sono i principali obiettivi per garantire l'integrità dei dati?
I principali obiettivi sono accuratezza, completezza, coerenza, tracciabilità, sicurezza e recuperabilità. Ciascuno copre un tipo di guasto diverso, quindi un dataset può essere sicuro ma incompleto, o recuperabile ma logicamente errato. Un programma efficace ha bisogno di un controllo osservabile e di evidenze per tutti e sei, non di un unico punteggio di integrità.
Cosa significa ALCOA nell'integrità dei dati?
ALCOA sta per attribuibile, leggibile, registrato contestualmente, originale o copia conforme, e accurato (dall'inglese attributable, legible, contemporaneous, original, accurate). Questi cinque attributi provengono dalle linee guida della FDA. Per i team dati diventano domande pratiche, ad esempio se siete in grado di identificare la persona o il servizio che ha modificato un record e se il record sorgente viene conservato.
Perché i backup non bastano a rendere i dati recuperabili?
I backup sono utili solo se sapete quale versione è affidabile e se il ripristino è stato effettivamente testato. Le linee guida del NIST chiedono ai team di ripristinare l'ultimo stato valido noto, scegliere il backup corretto e non contaminato e determinare chi ha modificato i dati e quando, quindi ripristino e indagine appartengono a un unico processo.
In cosa differiscono gli obiettivi di integrità dei dati per i report regolamentari e per i dati di addestramento dell'AI?
I report regolamentari danno peso a tracciabilità, evidenze durature e approvazione umana prima dell'invio. I dataset di addestramento per l'AI hanno bisogno di provenienza, recuperabilità con versionamento e nuovi controlli dopo ogni modifica della fonte o dello schema. I KPI operativi sono ancora diversi e privilegiano un rilevamento rapido e uno stato di freschezza chiaro vicino al punto di ingestione.
Aggiungere più controlli di integrità dei dati può peggiorare le cose?
Sì, accumulare controlli può ridurre la fiducia invece di aumentarla. Troppi alert causano affaticamento, una validazione lenta può rendere i dati inutilizzabili e regole di accesso rigide spingono gli analisti verso copie non governate. Un approccio migliore è classificare i controlli in base a impatto sul business, esigenze di freschezza, esposizione regolamentare e uso previsto.


